我们公司为 Looker(Looker)付约 15 万美元年费,约 300 个席位;3 名数据平台工程师在约 500 人的公司里,每周多数时间维护雪花(Snowflake)等底层数据管道。2 月,有人用一下午做了个托管 HTML 文件的工具;8 个月后,它的周用户已和 Looker 相当或更多,而 Looker 用量降了三分之一。科技影响者称软件已死、软件即服务(SaaS)会被 AI 消灭;我们能否用一堆 HTML 文件取代 15 万美元的企业商业智能(BI)工具?
正文
和很多公司一样,我们也在为 Looker 付费。按平均 Looker 许可费算,大概 15 万美元一年,约 300 个席位。我们是公司里 3 名数据平台工程师,公司大约 500 人,每周大部分时间都花在不起眼的事情上:保证 Snowflake 有数据喂进去,照看一个已经超过 2,000 个模型的 dbt 项目,以及维护底层的 Airflow、Airbyte、DataHub 和 Kubernetes 管道。
2 月,我们其中一人利用业余时间做了个托管 HTML 文件的东西。那只用了一个下午。8 个月后,它在公司里的每周用户已经和 Looker 一样多,甚至可能更多,而 Looker 的使用量下降了三分之一。
科技圈的意见领袖一直在发帖说软件已死,有些人说他们已经取消并用 vibe coding 替代了所有 SaaS 订阅。他们说 AI 会杀死 B2B SaaS。
自托管 GitHub 仓库占比
与此同时,Hacker News 上的“slop”
左:自称“self-hosted”的新 GitHub 仓库占比。右:Hacker News 评论中提到“slop”的占比。
“Slop”变好了
一年前,我觉得大部分 AI 输出都是 slop,而且确实如此。我们做过几个“与数据聊天”的 demo,在只有 4 张表的玩具 schema 上看起来很棒,但在我们这个规模上从来没真正跑通过。SQL 能无错运行,但数字是错的。这反而更糟。
后来,搭载 Opus 4.5 的 Claude Code 变得非常强。是真的非常强。1 月初,它在全公司的采用率直线上升。它能在我们的仓库里工作,使用我们的工具。而且,它能在回答前先跑一个查询来核对数字。这比得到一个听起来聪明的回复重要得多。几周内,财务、运营和市场部门里那些从没打开过终端的人,整天都在写 prompt。突然之间,所有人都在 prompting,没人再点来点去了。
大概同一时间,Claude 开始大量产出 HTML。你要一份分析,它会给你一个带图表的单文件,说实话,其中有些页面比我们的 Looker 仪表盘还好看。问题是这些文件会躺在某些人的“下载”文件夹里。要分享,就只能在 Slack 里附上文件然后祈祷。这还远早于 Anthropic 在 2026 年 6 月为 Team 和 Enterprise 推出可分享 artifacts,我们真的很需要一种方式来分享这种新型仪表盘。
有一天,我们团队的 Maddy 说,干脆把它们都放到一个带内网域名的 web 服务器上。当天结束时,她已经 vibe code 出了整个东西:一个小服务,把文件存到 S3,前面挂上 SSO,还有(一些)测试。我们已经在 Kubernetes 上跑所有东西,所以部署一个服务基本就是加一个 Terraform module 和一个 Helm chart。这些现成的基础设施让整件事容易了很多。
她写了个小的 Python 脚本,并打包进一个 Claude plugin。用户让自己的 Claude 写好 HTML,脚本就把它推上去(在 SSO 后面),公司里任何人都能打开链接。一开始,这些文件只是纯静态 HTML。3 月我们想,干嘛不呢,于是用查看者的 Snowflake OAuth token 加了一个实时查询 API:这是今年最棒的决定。
结果我们根本不需要写权限模型。Snowflake 一直都有一个。它有我们维护了多年的角色,如果 Snowflake 说你不能读销售表,那么这个仪表盘也不能。到 4 月,Snowflake OAuth 成了唯一的登录方式。
人们喜欢它,原因让 BI 行业有点难堪:这些仪表盘看起来确实不错。
Looker 的一个瓦片就是一个盒子,图表类型固定、配色固定,长得和以往任何 Looker 瓦片一样。丑,而且没有个性。
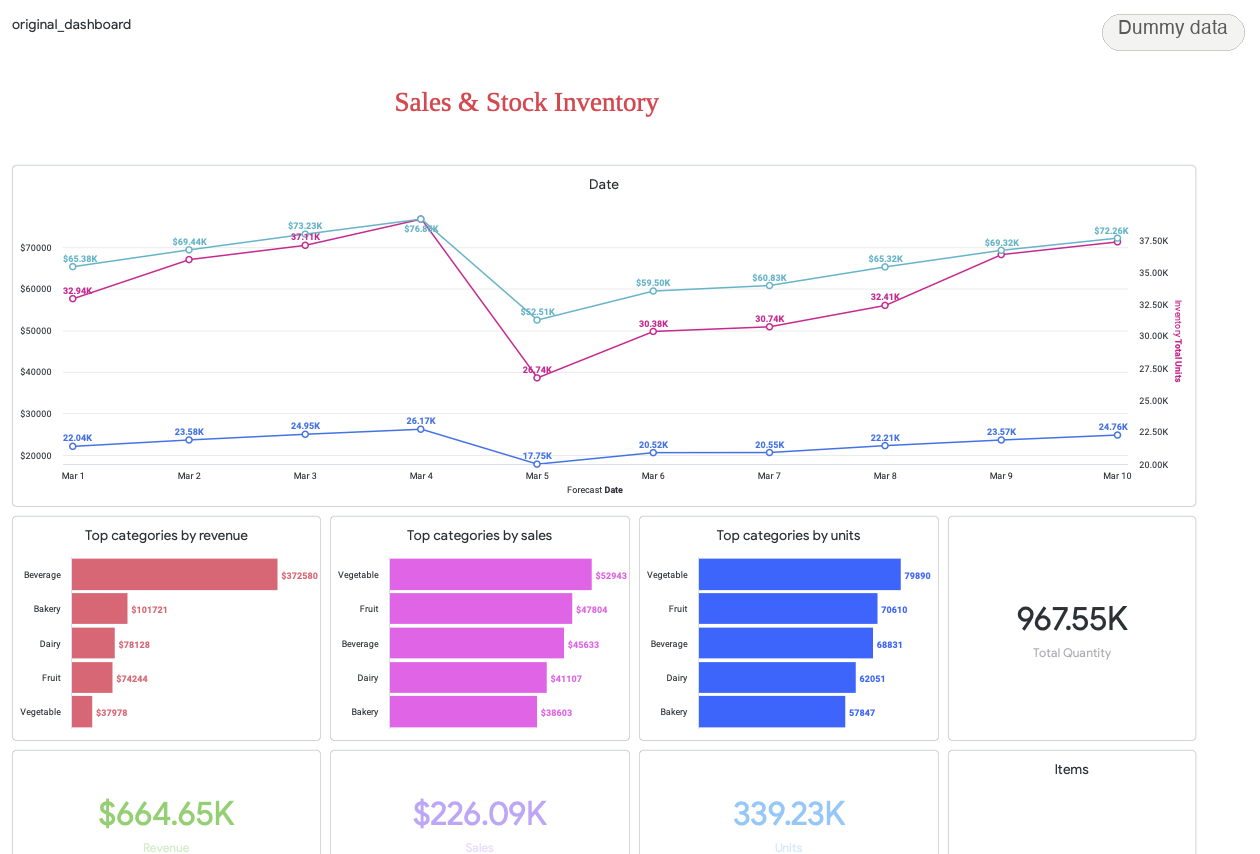
固定瓦片、丑陋的 Looker 仪表盘
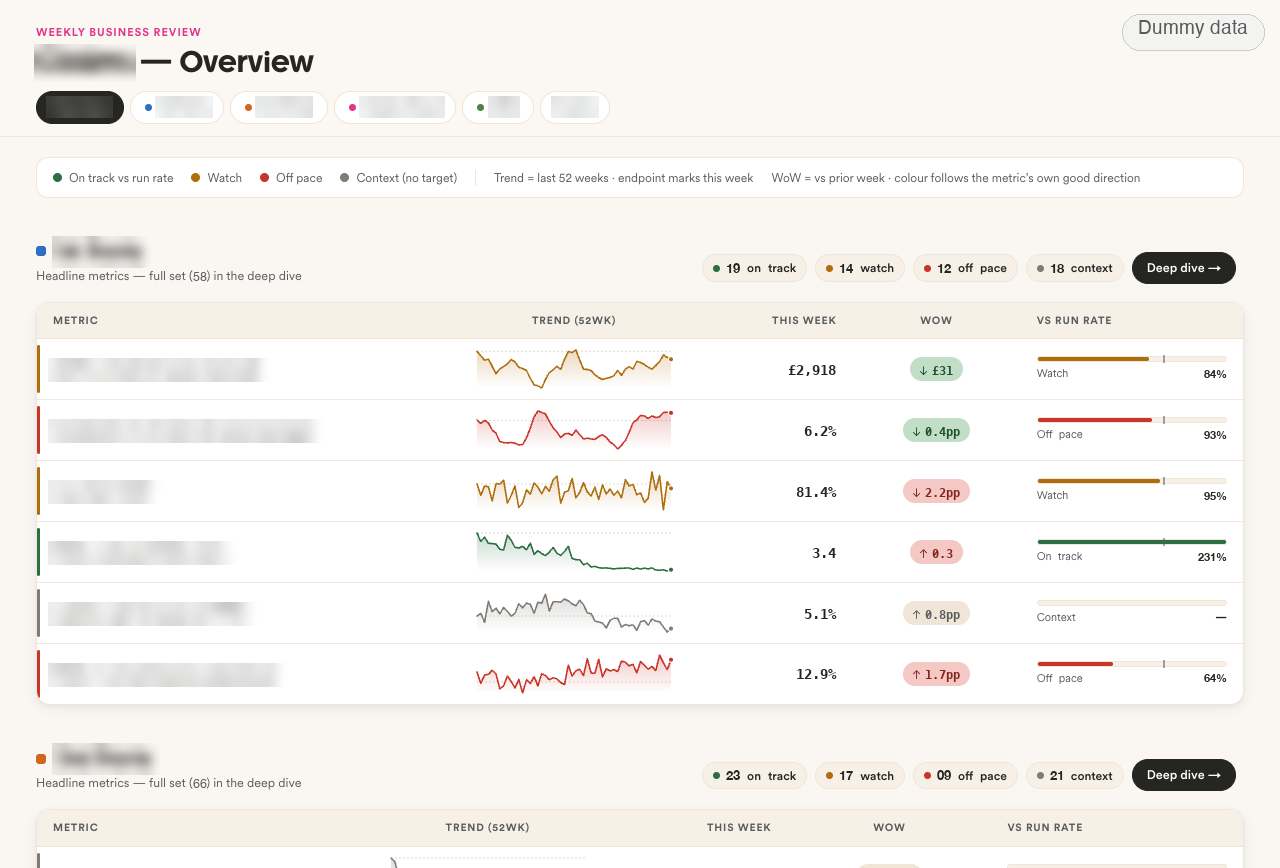
自由格式的 LLM 生成 HTML,不到 1 分钟
去掉死板的固定瓦片后,我们的用户可以生成自由格式的 HTML,并不断 prompt 直到它看起来整洁。他们很喜欢。邮件和 Slack 导出在 4 月上线,参数在 5 月上线,每周查看人数从 3 月的 23 人涨到 6 月的 136 人。高管团队开始互相发链接。人们还把这个工具变成了自己的东西。他们找到了我们从未想过的用例,让仪表盘按计划自动重新生成,加了按钮,做出了一些任何 BI 工具都不会允许的狂野设计和 UX。
此时的安全性非常糟糕。是真的非常糟糕。仪表盘的 JavaScript 和你的会话在同一个 origin 上运行,没有任何权限控制,每个员工都能读到每一个仪表盘。它基本上就是一个巨大的 XSS 漏洞:任何仪表盘都能以打开它的人的身份执行代码,并以那个人的名义把数据取出来。我们知道这一点,但还是上线了,因为它是内网,在 VPN 和 SSO 后面,而且没有别的东西能做这件事。
Claude 写页面,平台负责托管,查询以查看者身份运行。
那我们就正式做了
在我们团队里,“咱们干脆自己做个 BI 工具”一度是个内部玩笑。这个玩笑开了几个月,直到我们明显陷得太深。我们在一个月度 vibe coding 堆出来的东西上,背着一套自己都不满意的安全模型,而且公司一半人在用。我们不再开玩笑了,而是认真地说:我们来做一个 BI 工具。我们站到白板前,主要是为了搞清楚怎么修安全模型,并约定哪些东西不能丢:还是同一个 S3 bucket,不迁移,已经在使用的人不能受影响,发布还要和以前一样简单。
大家唯一达成共识的是:任何人仍然可以用一条 prompt 推送任何 HTML,没有审核步骤,没有模板,也没有一堆批准过的组件列表。这一点我们依然会坚持。
你在人和他们的仪表盘之间每加一道约束,就会把他们赶回“下载”文件夹。
真正重要的治理已经在上游发生了,在 dbt 模型和 Snowflake 角色里。所以仪表盘本身可以保持松散、快速,并且想多好看就多好看。
有 4 个问题要解决。
一个连接器,而不是一个脚本。 上传脚本之前被复制到 2 个仓库和一个 plugin 里,每份拷贝都有点不一样。我们用全公司统一的一个远程 MCP connector 替换了所有版本,这样 claude.ai、Claude Code、Claude in Slack 和我们自己的 analyst agent 都调用同一套工具。这个 connector 会带上你的 Snowflake token,API 用 SELECT CURRENT_USER() 检查你是谁。AI 上传的任何东西都会先成为草稿,必须有人点击 Publish。
Claude 写仪表盘;提出需求的人拥有它,归属在他自己的 Snowflake 身份下。
把每个仪表盘都当成恶意的。 这部分是我们真正需要思考的。整个产品在设计上基本就是 XSS:任何人都能上传在同事浏览器里运行的 JavaScript,没人事先审核,而那位同事可能是 CFO。我们没法屏蔽 XSS,因为 XSS 就是产品本身,所以我们的任务是确保它碰不到任何东西。出于这个原因,我们的安全模型从“我们假定它是恶意的”开始。每个仪表盘都运行在一个独立 origin 的沙箱 iframe 里,拿不到 cookie,并且有严格的 CSP。它唯一能对话的是父页面,通过 postMessage;父页面会检查消息是谁发的,附上会话并调用 API。内容 token 有效期一小时,只对某一个仪表盘、某一个查看者和某一个 host 有效。
仪表盘代码永远碰不到凭证,每个查询都以正在看它的人的身份运行。
沙箱保护了浏览器。我们还做了一个独立的 metadata 服务,异步读取仪表盘的每一个新版本。它会抽出整个 HTML 和 Snowflake 查询,检查页面加载了哪些脚本、把数据发到哪里。然后一组规则来判定这些事实。大多数规则只做报告。它们会标记出读取原始数据而不是 dbt 模型的仪表盘、没有固定版本的脚本,或者 90 天没人打开过的仪表盘。有些规则可以拦截仪表盘:来自一个这里没人用过的包的脚本,或者 WebRTC 连接——这是 CSP 挡不住的唯一出口。被拦截的仪表盘不会加载。查看者会看到警告,必须接受后页面才会运行。
检查在发布后运行,所以没人需要等它们。
让 Snowflake 负责身份和权限。 每个查询都用查看者自己的 token 运行。分享仪表盘永远不会分享数据访问权限。这既是安全特性,也是偷懒特性:我们从来不需要建设或维护数据权限,因为每个登录的人本来就有带着正确角色的 Snowflake 用户。
内容管理。 这部分我们大概 vibe code 了一周,几乎不需要设计。空间、文件夹和分享直接抄了 Google Drive,因为所有人都已经知道 Google Drive 怎么用:viewer、editor 和 owner,权限沿文件夹树向下流动,最强的权限胜出。版本按内容哈希存储,恢复一个版本会得到一份草稿。然后是搜索、点赞、定时导出,以及每小时从 HR 系统同步的团队。相比之下,安全模型才是几乎所有真正思考所在的地方。
开发花了我们几周时间,然后我们做到了。
接着它扩散开了。人们开始在 Slack 讨论串里 @Claude,然后拿回一个仪表盘。我们的 analyst agent 会发布自己的仪表盘,一些仓库直接从 CI 发布,而大多数人只是从自己的 Claude 发布,所以每个仪表盘最后都有点像做它的那个人。如今它无处不在。
325 次 commit,大约 74,000 行代码(其中 20,000 行是测试),以及大约 6.4k 美元的 Claude tokens。
这就是我们这边全部的账单:8 个月,3 名工程师利用业余时间做,加上几个朋友提了 PR。Claude 写了大部分代码。我们负责在白板前讨论、吵了很多次,并 review 了所有东西。
一个仪表盘 0.5 美元,这对 BI 意味着什么?
每周使用人数
Looker 的使用量是慢慢流失的,而不是崩塌。我们并没有把所有东西都迁走:有些团队仍然活在 Looker 里,它的一些仪表盘还没有替代品。让人们改用这个而不是 Looker 的原因是,做仪表盘不再昂贵了。这让我们好奇:到底有多便宜?用 token 付费而不是用工程时间付费的好处是,它更容易衡量。
这里我们用 analyst agent 作为代理,因为它是我们可以精确衡量的构建者。每次运行都会记录它的 token 和成本,每次发布都能追溯到生成它的那次运行。
我们发现,从第一个问题到成品页面,每个仪表盘大约消耗 agent 100 万个 token。在我们把它迁移到 Opus 5.5 后,一个仪表盘的成本从大约 2.50 美元降到了大约 0.50 美元。agent 做的是同样的工作;只是 token 变便宜了。这才是真正的故事:现在构建软件的花费就是 token 的花费,而这个价格还在持续下降。
BI 工具主要就是一种把查询变成图的方式,而现在一张图大约只花 0.5 美元的 token。为这部分价值去证明 15 万美元许可费的合理性,已经很难了。
每周仪表盘成本
那到底是自建还是买?
这是从 2 月第一次 commit 到现在的整体账单。
自建的总支出(我们花的所有钱):8 个月(2026 年 2 月到 10 月),8.3k 美元,便宜 12 倍。
Looker 许可费:按 15 万美元均价算 8 个月,10 万美元。
其中 Claude tokens 花了 6.4k 美元,AWS 花了 1.9k 美元。
现在它有了自己的数据库,在 AWS 上一年大约花 6k 美元;再加上我们为了持续加功能而花在 Claude 上的钱,7 月以来大约是每月 1.3k 美元。算下来一年大约 20k 美元,对比 Looker 的 150k 美元,而这 20k 美元里大部分是我们用来做新东西,而不是维持系统运行。
我们买 Looker 时,买的是 4 样东西:画图的 UI、权限模型、语义层,以及一个托管它的地方。现在 Claude 一个仪表盘一个仪表盘地把图给画了。
Snowflake 一直都有权限,dbt 有语义,而托管一些 HTML 文件大约每月 500 美元。
把这些去掉,剩下的就是一张 15 万美元的发票。
我们也不是唯一这样做的。你越来越常听到:扎实、成熟的公司取消非常昂贵的分析订阅。Amjad Masad 向 Platformer 讲过 Replit 的同样故事:一旦他能自己 join 仓库到生产 Postgres 并亲自把报告做出来,他们就“取消或缩减了大部分分析产品”。
在我们这个案例里,围绕现有栈做一个仪表盘工具,花费只是我们付给 Looker 的一小部分。对我们来说,重要的部分已经在 dbt 和 Snowflake 里了:模型、权限和数据。Looker 坐在这些上面,把它们变成仪表盘。我们发现,可以替代的就是这一部分。
上面的账单还漏掉了最大的成本,也就是我们自己:3 名工程师在这件事上花了 8 个月,这还是在一个数据平台团队所有其他工作之外——管道、dbt 项目、仓库、Kubernetes 集群、on-call。这些事一件都没停。我们没法给这些小时数一个诚实的数字,因为它们分散在我们做的所有其他事情里。如果你需要专门雇一个团队来做这个,算法就完全不同了。
如果你已经有一个可以基于其构建的扎实平台,还有一个熟悉它的团队,剩下的工作主要就是 Claude 的时间,而 Claude 的时间很便宜。
我认为分界线是规模。AWS 和 Snowflake 卖的是没人能 vibe code 出来的东西:数据中心、按 PB 计价的存储,以及因为数百万其他客户共享而变得便宜的计算。我觉得 BI 特别容易被冲击,因为它的很多价值(至少对我们而言)就在于构建和呈现仪表盘。Claude 现在能以极低的成本做到这件事。真正有规模优势的产品是另一回事,但如果更多公司开始自己替换 BI 栈里的某些部分,我不会感到惊讶。
那 Claude Dashboards 呢?
Anthropic 在 10 月 8 日宣布 Claude Dashboards 进入 beta,比这篇文章上线早一周。所以显而易见的问题是:我们是不是应该等一等,直接买那个?
其实不行。我们 8 个月前就开始了,那时候它还不存在。如果今天从零开始,说实话,我们可能会先看看它。它是 AI 原生的,也没有 Looker 的那些渲染问题。如果你的团队今天什么都没有,那它大概是正确的选择。
对我们来说,仪表盘只是其中一部分。这个工具已经接进我们团队现有的工作方式:它和我们的 agent control plane、分析平台以及 Slack 通信,还有一堆我们自己搭建的工作流。Claude Dashboards 可能覆盖其中一部分,但我们仍然得搞清楚怎么把这一切连起来。而且如果某个功能变了或者涨价了,我们还得去应对。
所以答案还是一样。如果你需要的是贴合你业务的软件,而且你已经有一个能跑它的平台和一支专门的团队,那就自己建——除非护城河是规模。
评论
讨论整体偏质疑和嘲讽,多数人认为用 Codex/Claude 把 BI 看板迁移成静态 HTML 只解决了最表层的渲染问题,却低估了工程维护、权限、指标一致性和决策支持等隐性成本,省下的授权费远没有文章宣称的那么可观。少数有成功经验的开发者则反驳:只要底层数据、ETL 和建模扎实,替换 Looker 之类工具确实能在几周内省下每年数万到数十万美元,而分歧主轴正在于 BI 的核心价值到底是画图表,还是语义层、治理与决策流程。
认为成本节省被严重高估,工程与维护才是大头
- 文章只按 token 成本(约一张图五毛)得出能省下高额授权费的结论,但没算工程团队重建、持续维护、安全治理与 CVE 修复等人力投入;把这些计入后,节省幅度可能只有约一半,远没有那么夸张。(较多人)
- > 如果算进工程团队重建和维护工具所投入的时间与薪水,而不是只算 token,最终大概只有 50% 的成本节省;仍然划算,但绝不像文章说的那么便宜。(@ekreloff)
认为只要数据和建模扎实,BI 工具本来就容易替换
- 多人分享成功案例:用 Codex/Claude 把 Looker 看板迁移成 HTML/git 仓库,或先用 Hex 这类更便宜工具过渡,再自建代理式 BI;有人甚至在十多年前就用 PHP+SQL 页面替代 BI,还用 BigQuery 定时查询替代昂贵的数据管道。只要有像样的 ETL、数据建模和数据层,渲染层并不难替代,确实能省下每年数万到数十万美元授权费。来自 Retool 的从业者还称,很多 CRUD 型 SaaS(BI 也算)会被公民开发应用取代,但前提是工程侧先搭好集中式数据连接、认证与授权等平台能力。(较多人)
- > 如果 ETL 打理好、数据建模被当成一等公民,自建 BI 甚至代理式 BI 都相对容易。(@armcat)
认为难点在定义指标、语义层与决策支持,而非渲染图表
- BI 工具的价值不在把查询变成图,而在帮分析师梳理混乱内部环境、定义该衡量什么、保证大家看的是对的数字。即便有语义层,指标上板仍可能出错,所以分析师仍不可少;如果用户只想要同一数据的不同视角,如何集中托管、去重、保证正确性才是瓶颈。把决策问题寄托在更容易生成的图片上,反而可能更糟。(较多人)
- > 把 BI 简化成“把查询变成图片”很天真;企业真正难的是定义该衡量什么、如何用指标改进业务,生成图片更容易反而可能让决策更糟。(@bushido)
认为放任 AI 生成看板会制造大量一次性重复页面和低质量可视化
- 低门槛生成会让人复制出略有不同的同一数据版本,难以集中去重;看板可能过时且无人察觉,指标由 AI 决定更是坏决定。当前模型做可视化质量也很差,图表堆砌、配色糟糕、缺乏叙事,省下的授权费可能换来一堆无法维护的氛围编码页面。(较多人)
- > 多数人其实并不想折腾自助式 BI,文章里的工具会让人造出略有不同的同款页面,而且 Claude 的可视化很差,图表堆满、配色糟糕、缺乏叙事价值。(@phone_book)
认为静态 HTML 分享跳过了权限层和运行时动态取数
- 第一版直接分享输出 HTML,本质上绕开了 Snowflake/Looker 原本的细粒度权限;如果销售数据分析页面被无权查看的人打开,就会泄露数据。更一般地,很多看板需要按当前登录用户、用户组或组织层级动态运行查询并实时生成图表,而不是托管一份所有人看到同样内容的静态页。(少数人)
- > 第一版直接分享输出 HTML,本质上跳过了权限层;如果有人能把销售数据分析页面分享给无权查看的用户,这个决定很危险。(@fidrelity)
有价值的补充
- 有人用 Claude 给自己的 TensorBoard 日志阅读器增删功能,认为这种随时能改的灵活性很好;TensorBoard 本身已近乎停止维护,本地监控工具反而更合口味。(@deepsquirrelnet)
- 有从业者提醒,把 LLM 直接放到十万级表的 Snowflake/Databricks schema 上并不奏效,仍需要语义层;LLM 像“垃圾内容炮”,你让它用数据证明某个结论,它就会拼出足以证明该结论的应用或可视化。(@dvdhsu)
- 更关键的是沉淀用户大量提示与查询,把它们转成语义定义、知识库文件和图表引擎规则的改进,形成基于使用数据自我优化的数据模型;图表本身确实可以换成 Claude 生成的 HTML。(@serguei)
- 多年前就有人用 GCP BigQuery 定时查询替代昂贵的 Snowplow;后来数据团队引入 dbt 导致成本爆炸、数据变乱,于是自己的数据被圈起来继续用简单查询,奉行 KISS。(@1a527dd5)
- 若一定要替代,有人建议基于 dbt 图表来做,而不是另写一套氛围编码的混乱实现。(@iamacyborg)