过去一周,大量严重和危急的软件漏洞影响了数千个主要网站,让人们陷入恐慌。软件安全领域究竟发生了什么,我们能做些什么?要弄清眼前的状况,就得先弄懂这些漏洞。作者并非网络安全专家,因此不会亲自展开血腥的技术细节,而是链接外部解释,因为那些人总会做得更好。
正文
过去一周,一批严重和关键的软件漏洞接连出现,影响到数千个主要网站,让人陷入恐慌。这到底是怎么回事,我们又能做些什么?
漏洞
如果想了解当前软件安全领域在发生什么,就需要弄懂这些漏洞是怎么回事。我不是网络安全专家,因此会链接外部说明,而不自己深入那些血淋淋的技术细节——这些人肯定比我讲得更清楚。
PHP2Shell —— CVE-2026-109618 和 CVE-2026-109619(也就是“新闻里的那个大事件”)
两个不同的安全团队——一个来自加州安全公司 Calif(作为 OpenAI“Patch the Planet”项目的一部分),另一个来自以色列-美国云安全公司 Wiz(据说属于 Google Cloud)——都在 PHP 中发现了这两个远程代码执行(RCE)漏洞。他们都使用了前沿 AI 模型(也就是大语言模型,具体是 GPT-5.6 Sol/Gemini 4 Argon)来发现漏洞并构造利用代码。
有意思的是,其中一个漏洞(CVE-2026-109618)早在 2024 年 PHP 基金会的一次安全审计中就被发现了(该审计由 Sovereign Tech Agency 资助,而它恰好也是目前开源领域最值得关注的事情之一),但他们基本忽略了它,因为有更重要的担忧,且无法就修复方案达成一致。理由是没人能真正搞明白如何基于这个理论问题构造出实际可用的利用代码。
大语言模型很擅长的一件事,就是把一个理论上的安全漏洞——哪怕只是对问题可能是什么的模糊描述——变成一个完整的利用程序。近几个月这成了个大问题:任何安全补丁的通知一出来,人们就会立刻把大语言模型对准代码库,智能体能非常快速地阅读 diff,直到找到看起来像安全补丁的改动,然后反向定位到它覆盖的漏洞,一路推到利用代码。
事实上,这一过程快到我认为现在可以合理地说:你宣布安全补丁的那一刻,就应被视为完整利用代码尚未被公开或私下传播的最后一个可能日期。
这个 PHP2Shell(现在漏洞似乎都自带营销部门了,就这么包装宣传)估计影响超过 70% 的互联网,数千网站受到影响,从维基媒体基金会、DeviantArt,到英国政府和日本银行系统的大部分,再到 BBC《The Traitors》节目网站。漏洞确实会被发现,但通常不会导致半个互联网关掉服务器,所以到底怎么回事?
要理解这一点,我们来看 PHP Group 的原始公告:
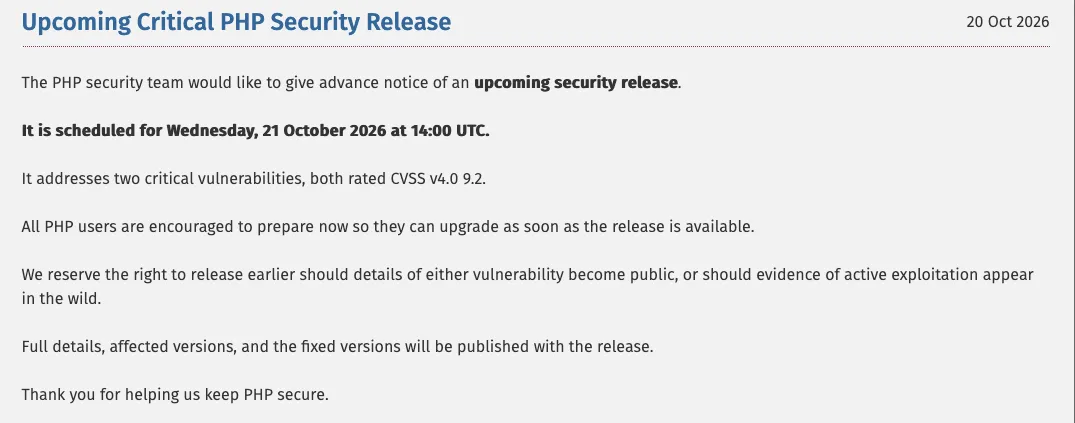
一位叫 petecooper 的人在 Hacker News 上发帖谈这些 CVE,似乎完全不知道还有 embargo(保密期)。这(以及其他疑似泄露)促使 PHP Group 匆忙发表声明,并把补丁从 22 日星期四提前到 21 日星期三。不过,补丁仍然要到第二天才可用。这次无意泄露包含了 10.0 的 CVSS 评分(也就是“很糟”,尽管奇怪的是实际评分是 9.2)。
消息几乎立刻像野火一样蔓延,人们开始恐慌。尽管这些漏洞是由“负责任的安全研究人员”在“体面的公司”发现的,但在安全补丁真正发布时,它已经在野外被利用了。不过,关于补丁发布前是否真的出现了可用的攻击尝试,存在一些讨论和分歧。
PHP 基金会指责 Calif 和一家叫 Chainguard 的公司,称 Calif 泄露了一段利用代码的视频(配着奇怪的背景音乐和一个跳舞的动漫女孩),而 Chainguard 在保密期结束前 6 小时就发布了修复方案,两者都让攻击者抢在了系统管理员前面。时间线很混乱,但看起来大约 17 小时内,多个相互关联的事情都出了问题。
关于 AI 是否真的是彻底改变计算机安全的游戏规则改变者,有很多讨论。大型 AI 公司(它们确实很大)显然希望你认为是的。有些人认为 PHP2Shell 被夸大了,因为大语言模型往往对漏洞过于偏执,会给出基于错误假设的“利用代码”(比如假设服务器会通过某个已有的文件包含漏洞运行你上传的 PHP 代码),或者以某种方式作弊。正如 LiveOverflow 指出,大语言模型很容易生成证明不了任何问题、也根本不能用的“利用垃圾”,但这并不代表漏洞不真实,也不代表用 AI 不容易利用它。你可能会有 1 万条没用的垃圾利用代码,但只要有一条能用,那就够了。也许我们现在必须习惯先蹚过这些垃圾,才能找到重要的东西。
另一些人指出,很多政府(英国、欧盟、日本、美国)过于激动,发布紧急公告要求大家立即拔掉电脑网线,所以人们恐慌了。我觉得大家恐慌的原因是,每个人多少都知道 PHP 极其不安全,却还在用它,因此他们本来就对坏消息很敏感,容易反应过度。而且这事其实也确实相当糟糕,所以也许恐慌反而是对的反应?
我从这件事得到的最重要一点是:因为有了大语言模型,从“嘿,我听说这个项目里有个严重的 RCE”到“已经出现针对该漏洞的复杂、自动化、协同攻击”,时间从几周/几个月缩短到了几小时/几分钟。大量不能用的利用垃圾只说明,真正专业的知识仍然是必需的——如果你不知道自己在看什么,就无法判断 AI 是作弊了还是做了错误假设。
eMudhra(CVE-2026-111943,Golang 响应)
同一天(2026 年 10 月 20 日),Mozilla 宣布将屏蔽由印度证书颁发机构 eMudhra 签发的 8 个中间证书。此前,一位只知道叫 “Wayne” 的化名安全研究人员向 Mozilla、Apple、Google、Microsoft 等多家大型科技公司报告说,这家证书机构为其中间证书使用的私钥质量低得可笑。安全的密钥可能是一个 100 位的数字,而 eMudhra 用的却是 “115”、“56” 和 “4” 这样的密钥。他们肯定是在遵循 RFC 1149.5:

图片说明:RFC 1149.5 将 4 定为 IEEE 认证的标准随机数。来自 xkcd #221,采用 CC BY-NC 2.5 许可。
没有迹象表明这是利用 AI 或大语言模型发现或利用的,不过研究人员 Scott Helme 指出,只要给一个提示词,Claude 就能恢复这些中间证书的私钥。
截至撰写时(10 月 23 日),eMudhra 已宣布将退出证书颁发机构领域。与此无关的是,一位农民在得知马跑了之后,宣布他已经关上了马厩的门。
Railway 漏洞
第二天,云服务商 Railway 宣布,他们发现黑客曾访问并甚至解密了其平台上的环境变量,而这些变量通常保存着数据库凭证、API 密钥等机密。他们在声明中说,认为这是一场协同行动的一部分,目标是入侵提供 AI 推理的公司。
最终目标是什么?截至撰写时(10 月 23 日),我们几乎没有信息可依。这个“未授权第三方”(官方声明里总能把“一些随便什么人进了我们电脑”说得像是服务条款协议,也许这样他们觉得人们就不会注意)是试图监视使用 AI 推理的人,看他们在做什么,甚至窃取新模型或研究成果?还是说,他们想建立一个被入侵的推理服务商网络,用于自己邪恶的生成式 AI 目的(比如找更多 PHP 漏洞)?
GitLab(CVE-2026-97229 和 CVE-2026-110264)
2026 年 10 月 12 日,GitLab 警告其 CI/CD 的正则表达式解析中存在一个最高严重性漏洞,攻击者可利用特制正则表达式执行任意代码(又是一个 RCE)。该漏洞 CVSS 评分为 10.0,这是可能的最高分,意思是“几乎坏到不能再坏”。随后在 10 月 21 日,又出现了另一个正则表达式整数溢出 RCE,同样是 10.0 分。需要注意的是,GitLab 这里使用的是 CVSS 3.1,而 PHP 使用的是 CVSS 4.0,两者评分指标不同,因此不能直接比较这两个分数。
这紧接着上个月又一个 10.0 分的 CVE(CVE-2026-85706),那次与路径遍历有关。所有这三个漏洞都是通过 GitLab 的 HackerOne 漏洞赏金计划报告的。当大家发现大语言模型能研究漏洞并编写利用代码时,有很多声音说要关掉漏洞赏金计划,因为它们不再有意义了。我敢肯定 GitLab 现在很庆幸没那么做。
尽管 GitLab 在学术界、政府和私营公司中使用非常广泛,这件事似乎没有引起那么多关注。GitLab 的 CVE 显然非常严重,对私营公司尤其如此,因为他们大量重要的知识产权都存在里面,泄露可能是灾难性的。公司通常把 GitLab 实例放在 VPN/防火墙后面,不对外公开,这大大降低了相关风险。也不完全清楚这些 CVE 是否需要特定条件,比如公开可访问的项目、用户自我注册等。看起来 CVE-2026-110264 至少需要一个公开项目,但我找不到早期那个 CVE 的条件信息。没有迹象表明这些是用 AI 或大语言模型发现的。它们可能是,但目前没有理由这么认为。
musl libc 漏洞
10 月 21 日,musl 的 libc 中与正则表达式相关的一个漏洞被公布(libc 里居然有正则表达式?显然……),它至少会导致拒绝服务,甚至可能代码执行。据我所知,这在时间上完全是巧合,与 GitLab 那两个漏洞无关——尽管两者似乎都是解析不可信正则表达式时的整数溢出,而且其中一个还是同一天报告的。谁知道正则表达式引擎居然是这么大的安全问题——正则表达式是新的字体渲染吗?GitLab 的两个漏洞都是由一位叫 Johan Carlsson(joaxcar)的瑞典人发现的,而 musl 漏洞则由一位自称“开源巫师”的法国人 Julien Voisin 报告。
LiteLLM
啊,我的老朋友 LiteLLM。这证明了,当你由金属制成、身高 200 英尺时,闪电确实可能劈中两次。当有人问你有没有听说 2026 年 LiteLLM 那起大入侵事件时,你还得反问“哪一次?”,这可不是好兆头。幸运的是,整个 PHP2Shell 和其他事件吸走了大部分注意力,所以尽管这次和 3 月那次一样糟,却没有得到同样的关注。
这一次,问题出在 Python Package Index(PyPI)和 Docker 镜像上的恶意版本。可能有人不记得了,LiteLLM 在 3 月发生过非常相似的事:当时 PyPI 上的 litellm 包被上传了恶意版本,利用 .pth 文件自动加载恶意代码(是的,那次很糟)。
这次入侵同样利用了 .pth 文件,还利用了 sitecutomize.py 文件来自动加载恶意负载,并在 Python 解释器启动的预加载阶段运行。根据 Wiz 的分析,该负载有“强烈的 LLM 辅助开发迹象”——比如过于冗长的变量名、过度防御的错误处理、脆弱的边界情况,以及大量写着“this is where it really bites”、“it’s worth sitting with that”、“lean into that”和“that stays yours”的注释。
根据 LiteLLM 的说法,事件之所以发生,是因为攻击者拿到了 GitHub CLI 的凭据,从而能运行 CI 任务。LiteLLM 指出,Claude Code 有时会把用户的 GitHub CLI OAuth token 嵌入响应体中,这可能导致它们出现在 LiteLLM 日志里。
PingCAP
2026 年 10 月 19 日,一家开发名为 TiDB 数据库的企业软件公司 PingCAP 披露了“对 PingCAP 的未授权访问”,并称“没有证据表明 TiDB 中存储的数据受到影响”。与此同时,一个叫 FulcrumSec(又称“Threatspians”)的网络勒索组织声称他们已从 PingCAP 窃取了 10.6 TB 数据,并公开发布了一个 200 GB 数据的种子,作为“第一阶段发布”(续集得先让人入坑)。
他们还公布了所取数据的完整细节,以及 PingCAP 一些极好的安全实践,包括把客户的 AWS 秘密访问密钥放进 Jira 工单里,以及在 Jira 工单里附上大量未脱敏的日志,其中包含 OpenAI、Anthropic、Gemini、xAI 的 API 密钥。哎呀。如果你愿意访问那个勒索组织的网站,他们会写一篇相当有意思的分析。
对 PingCAP 来说,好消息是:找不到数据被窃取的证据其实极其容易。事实上,我现在就在免费为成千上万家公司做这件事。我肯定这里面藏着个商业计划。你要做的就是别去查(参见:U+1F648)。说句公道话,我觉得他们的论点是:TiDB 实例内部的数据没有被泄露。如果是这样,10.6 TB 似乎数据量有点太大了。显然仍有大量客户数据。
Linux 漏洞被误发到错误的群聊
Linux 内核开发完全通过邮件列表进行。自然,其中一些涉及安全敏感内容,因此是私密的。在 2026 年 10 月 21 日至 22 日的夜间,Trend Micro 旗下的软件漏洞计划 Zero Day Initiative(ZDI)把一批高严重性(CVSS 9.0 以上)的 CVE 报告发到了公开邮件列表,而不是私密列表。自然地,人们假定任何有大语言模型和满腔梦想的人都能在几分钟内把这些报告变成活跃的利用代码。如今人们严肃对待这类事的程度,仍然很有意思。
这是新常态吗?
我觉得可以说,最近几天这些网络安全事件和安全公告异常活跃。Hacker News 上关于这些事件的讨论中,很多评论者说这不算什么,而且只会变得更糟。说实话,我还没决定。老实说,如果 4 年前你问我大语言模型能走多远,我绝不会猜到它们现在能这么强。即便如此,人们确实容易对这些公告过于激动,并认为我们将生活在一个没有任何软件安全、所有人都脆弱的世界里。
需要看到的是,虽然网上很多讨论围绕 AI 和大语言模型,但这些披露中只有一部分是用大语言模型研究或构造的。像 PingCAP 这种我们还不知道,但有明确证据表明许多犯罪和国家背景的组织正在利用 AI 进行更多、更快的入侵。他们为什么不呢?它似乎很擅长这个。许多漏洞其实是老套的软件漏洞,靠人类肉身手指发现并编写的,但网络讨论总聚焦在刺激、可怕的新事物上。为什么不呢?
你能理解为什么像 NHS England 这样的组织决定把他们所有的开源代码转为私有(尽管那是个愚蠢的决定)。当这些大语言模型强到任何人都能把智能体对准一些开源代码、找出大量漏洞,并写出完整利用代码时,这让很多人担忧。那么解决方案是什么?
我们能做些什么?
NHS 的做法:把所有东西都闭源。(也就是“马达加斯加做法”)
优点:
- 你的代码不再在网上,别人就不能把大语言模型对准它,去分析每一次提交中的安全修复、找出大量此前未知的关键漏洞等等。
缺点:
- 每有一个开源仓库下线,开源社区和计算的未来就都更糟一点。
- 你不可能把世界上所有代码库都闭源——有些东西,比如编程语言(它们常常是关键漏洞的源头),依赖开源才能运作。把 Python 变成闭源项目对计算世界将是灾难性的。
- 它只是“在有人泄露之前”是闭源的。而最终很可能有人会泄露。一旦泄露,你也就失去了多年来公开审视代码库所维持的清洁和安全。
- 有时你用的编程语言里,这根本不重要,比如 Python 和 Java,你可以从字节码中恢复源代码。
- 大语言模型甚至能相当有效地逆向编译后的二进制文件。
- 如果代码曾经在网上过,那个旧版本就还在。你得假设某个地方有人存着它。Shellshock 从 1989 年到 2014 年一直存在于 GNU Bash 中才被修复,而 Bash 是地球上最广泛使用的程序之一。
- 这让我难过 :(
AI 拥抱者的做法:打不过就加入。 换句话说,如果我们已经用更大、更快、花钱更多、模型更好的方式在我们的代码上跑过更好的 LLM,他们就不能用 LLM 来找漏洞了。
优点:
- 让几位非常富有的科技 CEO 非常高兴。
- 会找出大量漏洞。
缺点:
- 让几位非常富有的科技 CEO 非常高兴。
- 会找出大量漏洞。(总得有人去修。)
- 花很多钱。
- 即使 AI 让这变容易了,要妥善做这些事仍然需要专业知识和深厚技术能力(至少目前是)。
乐观者的做法:普遍采用更好、标准化的漏洞报告、处理和缓解方法,随后所有公司都拥有顶级的安防态势、充分理解的风险、文档完善的流程等等。
优点:
- 想法很美好。
- 为什么别人没想到呢?
- 哎呀,我们真聪明。我们这就解决了吗?
缺点:
- 我们并不生活在这样的世界里。我们永远不会生活在这样的世界里。
- 我提过这其实相当难吗?而且可能不可能?
- 昂贵。
有一些容易取得的改进,比如“绝不在补丁准备好安装之前公布关键漏洞的细节”,但这次是无意泄露让官方公告前大家就知道了漏洞。也许连这都要求太高了。这次是一系列来自多个人员和公司的错误,导致或加速了利用代码在补丁可用前几小时就被活跃使用,于是所有人纷纷把服务器下线。AWS 后来表示,他们在 10 月 17 日就看到有人尝试这个漏洞,比任何泄露都早。
即便是像 minimum release age(最低发布时长)这样在 shalk/debug、Shai-Hulud 和 3 月 LiteLLM 事件后流行起来的做法,也意味着修复广泛利用漏洞的大更新几天内打不上,给攻击者充足时间把你黑得粉碎。至少,我们或许需要更好的客户端管理,避免所有人恐慌并把服务器全下线。
也许我们只需要接受:如果你把什么东西暴露在更广泛的互联网上,它就会被黑,并据此规划。也许错的是我们的预期。
结论
这里肯定有一个关于 AI 和安全的故事。它正在改变软件世界,目前还不清楚这是变好还是变坏。金钱有一种扭曲真相的方式,就像物质扭曲时空;AI 里有足够多的钱,足以造成相当于中等质量黑洞的真相扭曲。有大量资金砸在 AI 上,它们都想让你相信,它会改变你生活的一切,包括软件和安全。当然,这不代表那不是真的。
有人说,自动化分析工具在 2010 年代曾导致大量新漏洞被发现,现在同样的事又在上演。我觉得这在性质上不同,但也许会有一个初期漏洞报告升级的阶段,之后一切平息,恢复原样。我怀疑不会。也有人说,这之所以发生,是因为最初所有垃圾代码都是人类写的——等 AI 从头开始写所有代码,就不会有漏洞了,因为大语言模型比人类更擅长写安全代码。我不信这个论点。
虽然我不对未来做太多预测(因为我不想 12 个月后不可避免地被打脸时像个傻子),但我要说:软件行业将会改变,开源也将会改变;作为软件社区成员,我们有集体责任确保这种改变是为了我们所有人的利益,而不是特殊利益和私有企业。
评论
讨论在“近期漏洞与利用潮是否会成为永久新常态”上明显分裂:较多人认为这只是 AI/LLM 开始规模化审查代码、集中清掉多年历史漏洞的过渡期,潮水终会退去;另一边则有人坚持攻防节奏和从发现到被利用的时间窗口已被永久压缩,或警告 AI 生成代码本身会带来更多不安全。与此同时,不少人对“已在野利用”和所谓 AI 漏洞报告表示怀疑,认为很多只是扫描、夸大或低质拼凑物。
认为这只是 AI 清理历史漏洞的过渡期,漏洞潮终会回落
- 当前集中暴露的严重漏洞大多是人写的旧代码里积压多年的问题;等 LLM 把存量挖完,新代码又被 AI 做安全审查,公开漏洞会大幅减少,甚至趋近于零。多数软件成熟后基本就写完了,未来大平台可能提供更强的 Dependabot 2.0 式自动修补和夜间 AI 渗透测试;有人估计危机期上限约 18 个月,短期还会更糟,但不会永远持续。(较多人) > 我们现在其实是在用 AI 清理多年积压的漏洞,等局面稳定后,评估代码安全的能力将从少数专家扩散到所有人。(@roenxi)
认为这就是新常态,或攻防节奏已被永久改变
- LLM 能以人类无法企及的速度迭代和测试,会不断挖出漏洞;即便未来漏洞数量回落,发现到大规模利用之间的窗口也显著变短,而且大厂能提前获知、中小防守者被动挨打,这种不对称和高压节奏不会消失。AI 生成的代码本身安全性差,也会让情况恶化。(少数人) > 就算漏洞被找完,发现到被大规模利用的时间窗口也已大幅缩短,而且不会很快恢复;没进大厂提前通知名单的人只能自认倒霉。(@thaumaturgy)
认为这不过是一直以来的“老常态”,并非新现象
- 主流开源项目爆出可利用漏洞、扫描型僵尸网络、PyPI/NPM 恶意包、创业公司被入侵、CA 出问题,这些事过去一直都在发生;近期只是几起事件撞在一起,疏于打补丁和运维也早已是常态。大家本就该为这些风险做好准备。(少数人) > 这些事过去一直都有,真要说不幸,只是几起事件恰好撞在一起;就算频率真变高,你也早该做好准备了。(@csande17)
质疑“已在野利用”和 AI 漏洞 hype,认为概念验证多为低质噪音
- 文章引用的“被利用”很多只是扫描或探测,并不等于真正攻击;那个 PHP2Shell 漏洞已知多年且利用难度高,已出现的安全验证被专家视为 AI 拼凑的低质垃圾,和 Log4j 不在一个量级。大量 LLM 辅助漏洞报告是噪音、夸大甚至假数据,反而淹没真正的问题。(少数人) > 文章引用的博客只是在自夸检测到利用,读完却看不到真正的攻击;难道扫描和探测现在也算已在野利用了?(@dotdi)
主张通过简化架构、削减攻击面和转向内存安全语言来应对
- 软件已成“不安全分形”,连操作系统和浏览器维护者都可能开始精简代码;唯一可 tractable 的办法是减少攻击面。应去掉花哨但难维护的依赖,甚至牺牲体验来简化架构。内存安全和正确性会变得更重要,Rust 等能消除最易被远程利用的一类问题,成熟代码基会更受重视,C++ 的复杂度可能被进一步淘汰。(较多人) > 漏洞挖掘的加速反而证明 Rust 这类内存安全语言有多重要,它挡住了最容易被远程利用的那类问题;我也希望 LLM 成为压垮 C++ 的又一根钉子。(@jmyeet)
批评延迟披露,安全细节应立即公开
- 为了防恶意利用而拖延披露,对所有其他防守者极不公平;既然一个 LLM 能发现漏洞,别的 LLM 也能,隐瞒没有意义。应先立刻告知公众漏洞与细节,再谈修复,这种“先藏起来”的闭源思维令人反感。(少数人) > 用“先藏起来不让坏人知道”的策略极度不公平;如果连一个 LLM 都能找到漏洞,别的 LLM 当然也能,拖延到底有什么意义?(@shevy-java)
主张程序员主动用 LLM 审查自己的代码
- 哪怕不认同用 LLM 写代码,也应把它跑在自认为“完美”的成熟代码上;作者亲测 LLM 在自己老包里找出了问题,说明 LLM 已成代码审查的颠覆性力量,能发现人类很难独立找到的 PHP2Shell 类问题,程序员应借此“封死舱门”。(少数人) > 我让 LLM 审查自己写的成熟包,本以为完美,它却找出了问题;程序员无论如何都该让 LLM 跑一遍自己的代码,把舱门封死。(@ChrisMarshallNY)
有价值的补充
- 用正则引擎校验不可信输入一直是安全噩梦,任何实现过正则引擎的人都清楚这一点。(@swiftcoder)
- eMudhra 宣布退出证书颁发机构(CA)业务,被讽为“马已经跑了才关上马厩门”,是事后补救的典型。(@aeon_ai)
- 有 MIT 团队曾忽视避免使用 PHP 的建议,仍用 PHP 构建管理界面;如今该设备已部署在采矿、交通、医疗等关键行业,相关公司还被大型网络设备厂商收购。(@entropicabyss)