当有传言称某台笔记本电脑的图形处理器(GPU)能访问超过 100 GiB 内存时,我就开始设想能在上面构建什么,以及花大量时间折腾优化。我很支持开放权重模型,想在笔记本上本地运行,并尝试强化学习(RL)、量化和微调。我已在抱抱脸(Hugging Face)发布自制的 GGUF 量化模型,过去一个月下载量超过 160,000 次。因此,发现它官方仅支持视窗(Windows)时我有些不快;讨厌 Windows 的理由很多,包括隐私等。
正文
太长不看:微软真讨厌。Arch Linux 能跑起来,7-Zip 上追平 Windows,向操作系统和 CUDA 报告的同样是 116.0 GiB 内存池。我最初的启动盘配置和补丁在这里。这台机器是 ASUS ProArt P16 H7607BA-SE033W:128 GB 内存、6,144 CUDA 核心和 2 TB SSD 的版本。
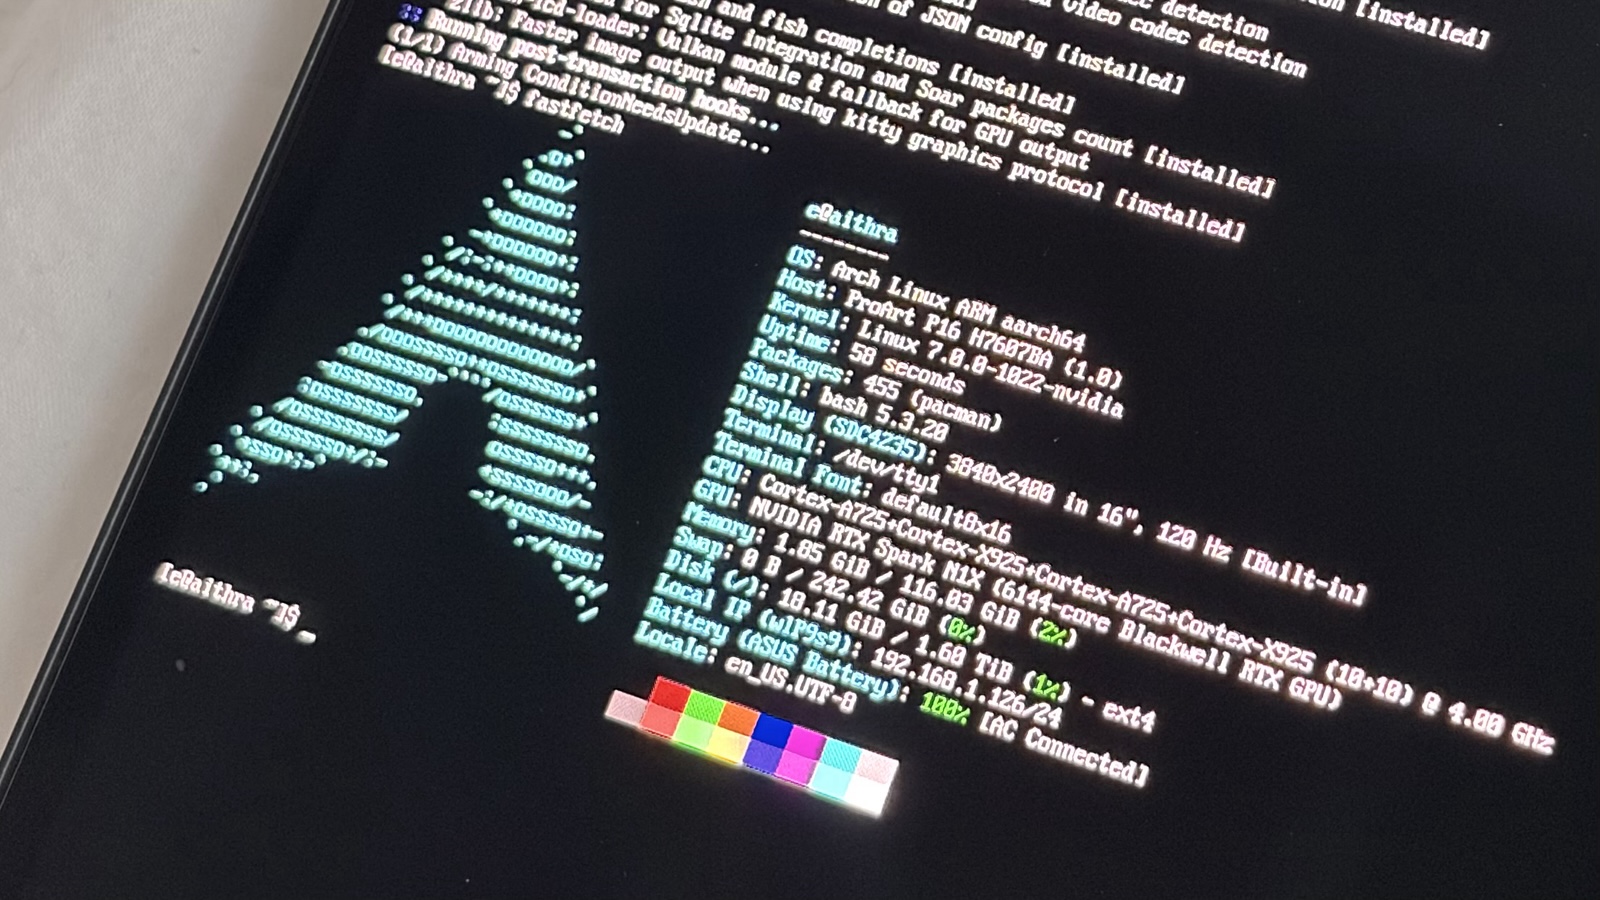
当有传言说会出现一台 GPU 能访问超过 100 GiB 内存的笔记本时,我就开始想能在上面做些什么、又能花多少时间去做各种优化。我很支持开放权重模型。能在笔记本上本地跑模型,折腾 RL、量化和微调会很爽。我已经在 Hugging Face 上发布我自己的 GGUF 量化版本,过去一个月下载量超过 160,000 次。
所以当我发现官方只支持 Windows时,就不太开心了。讨厌 Windows 的理由有很多,比如安装时的隐私让步(包括强制登录微软账户)、等了多年才把任务栏放回侧边,还有广告。道理大家都懂,我就不展开了。
Arch 是我偏好的发行版,所以自然从这里入手。这个构建基于 Arch Linux ARM,并在之上加入了硬件支持。
NVIDIA 一直在为 Ubuntu 做内核工作,这给了我起点。我吸收了这部分,修复了获得控制台所需的 ACPI override 分配和 framebuffer 映射,并从笔记本自己的表里推导出 ACPI override(感谢 astra <3)。NVIDIA 驱动和 ASUS 扬声器固件来自互联网上的官方渠道(电脑公司别告我)。键盘支持需要打过补丁的 hid-asus,音频则需要独立的 machine driver。
我把这些做进了一个可启动 U 盘,并扩展了上游 Archinstall 4.5 来安装硬件支持。这个仓库里有构建脚本和补丁,包括导出你自己的 ACPI 表、以及从 ASUS 驱动包里本地提取扬声器固件的步骤。我这边运行的固件是 H7607BA.300。
构建输入做了哈希固定。我周末拼好的硬件包用我的 Arch Linux 软件包维护者密钥签名,ACPI override 来自笔记本自身。
屏幕分辨率是 3840 × 2400、120 Hz,我用 NetworkManager、PipeWire,以及带 NVIDIA CDI 的无 root Podman。安装器用 IgnorePkg 锁定内核、NVIDIA、电源管理和固件包,普通软件包则继续从 Arch Linux ARM 更新。
CPU 性能
我在 10 月 19 日于原生 Arch Linux ARM 上跑了这套测试,内核是 7.0.0-1022-nvidia,NVIDIA 驱动是 615.78.08。笔记本接电,并选择性能模式。CPU 对比用的是已发布的 Windows 结果。
CPU 测试用的是原生 ARM64 7-Zip 26.04,字典固定为 32 MiB。每个线程数先跑一次热身,再测三遍取中位数:
| 线程数 | 压缩速度(MiB/s) | 解压速度(MiB/s) | | --- | --- | --- | | 1 | 6.18 | 118.26 | | 20 | 141.77 | 1,629.60 |
StorageReview 测试了一台 128 GB 的 HP OmniBook Ultra 16,搭载相同的 20 核 N1X,运行原生 Windows ARM64 二进制文件。他们以 GIPS 报告 7-Zip 评分,所以我把原始日志里的 MIPS 除以 1,000 来对齐。数值越高越好。
| 7-Zip 工作负载 | 我的 ProArt,Linux(GIPS) | HP OmniBook,Windows(GIPS) | 差异 | | --- | --- | --- | --- | | 单线程压缩 | 7.221 | 7.31 | -1.2% | | 单线程解压 | 10.779 | 10.87 | -0.8% | | 20 线程压缩 | 165.754 | 157.9 | +5.0% | | 20 线程解压 | 148.471 | 144.5 | +2.7% |
单线程基本打平。20 线程全开时,我的 Linux 配置压缩领先约 5%,解压领先约 3%。HP 的评测没有说明 7-Zip 版本或字典大小,所以这些百分比只是比较两台笔记本的整体设置。
ComputerBase 也测试了一台搭载 20 核 N1X 的 ProArt P16。换算成 GIPS 后,它的 Windows 7-Zip 分数是 155.774;我三次运行的总分中位数是 157.084。它的结果落在我三次运行的 155.759 到 157.193 GIPS 区间内。那台机器是 64 GB 配置,跑的是 7-Zip 26.00,图表没给出字典大小。
内存划分
内存才是更大的亮点。我的 Linux 运行把 116.0 GiB 同时作为系统 RAM 和 CUDA 的总量来报告,来自同一物理内存池。Windows 则把内存划分成 GPU 专用、共享和仅 CPU 的区域。CPU 负载不能使用 GPU 专用区域,GPU 分配也不能使用仅 CPU 区域。
Windows 的 NVIDIA 应用允许你更改专用预留并重启;Frandroid 的 128 GB ProArt P16 达到了 96 GiB。CUDA 可以通过从共享内存分配突破这个限制,但受 Windows 内存预算约束。
在 91 GiB 专用预留下,Frandroid 的 Windows 设置报告 CUDA 总量为 109.7 GiB(含共享内存)。我的 Linux 设置报告 116.0 GiB,多出约 6.3 GiB。我关心的是,这大块内存也能留给 CPU 工作,而不需要在负载之间拖预留滑块并重启。
本地运行 Qwen
我用 vLLM 和 B12X CUDA 内核,在一个原生 ARM64 容器里运行 NVIDIA 的 Qwen3.8-Flash-Next-FP4-Local 检查点,采用混合量化和 FP8 KV 缓存。这次运行关闭了 thinking。
加载模型前,Linux 报告有 110.9 GiB 可用内存。vLLM 记录模型加载用了 68.2 GiB,又给 KV 缓存分配了 21.1 GiB。也就是说,这台笔记本上将近 90 GiB 都分给了模型和 KV 缓存。
首次请求前的模型加载和编译花了大约 16 分钟。下面的计时从热身之后开始。PLE 嵌入表由磁盘支持,会受益于预热好的页缓存;其他组件使用 CPU offload。CUDA 负责推理,模型有一部分在 GPU 内存之外。
我让 Qwen 做三件事:审查两个有 bug 的 Python 辅助函数、在一份长事件日志里找出一次失败操作、以及把一条支付备注转成 JSON。每个任务在热身后跑三次,都有已知答案用来核对。我想知道要等多久,以及它是否返回了正确的字段。
| 任务 | 输入 token 数 | 首个 token 中位数(秒) | 完整响应中位数(秒) | 检查通过 | | --- | --- | --- | --- | --- | | Python 代码审查 | 208 | 0.316 | 4.008 | 3/3 | | 在 128 条记录的事件日志中找出失败项 | 9,775 | 4.532 | 5.768 | 3/3 | | 支付备注提取 | 87 | 0.256 | 2.035 | 3/3 |
事件日志任务读了近 10,000 个 token,在 6 秒内返回了正确的请求、原因和下一步动作。它的答案只有 39 个 token 长,整个请求算下来是 6.8 tokens/s。大部分等待都花在处理提示上,所以对这个任务来说,响应时间比 tokens/s 更有参考价值。
对于代码审查,我用 (output tokens − 1) / (response time − time to first token) 估算生成速度,两个时间都以秒为单位。这包含了流式开销。Frandroid 在它的 Windows ProArt 上运行了 Qwen3.8-Flash-Next 编码任务:
| 系统 | 量化与运行时 | 生成速度(tokens/s) | | --- | --- | --- | | 我的 ProArt P16,Linux | FP4-Local,vLLM B12X | 30.9(3 次中位数) | | Frandroid 的 ProArt P16,Windows | UD-IQ4_XS,llama.cpp | 29.4 和 31.4 |
两台 ProArt 的设置都在 30 tokens/s 左右。推理时,Frandroid 用了 85 GiB 专用预留和 262,144 token 的上下文上限;我的上下文上限是 32,768 token。提示、量化、运行时和计时方法都不同。这是比较两个可用的配置,并不能单独隔离出操作系统的影响。
我还一次性发送了四个代码审查。这批请求的中位数完成时间是 5.314 秒,四个请求合计产出 86.6 output tokens/s。这个速率包含提示处理和响应开销。三轮批次里,全部 12 个答案都通过了检查。
然后我让它以一次一个请求的方式循环处理这三个任务,持续十分钟。它完成了 150 个请求,每种 50 个,所有答案都通过检查。代码审查的响应中位数是 4.036 秒,日志任务是 5.921 秒,提取任务是 2.046 秒。比较每个任务的前十次和后十次重复,响应中位数增长不到 1.6%。
全部 171 个被测量的响应都通过了检查。这是三个提示在确定性解码下重复运行的结果;代码审查检查会验证回归输出。我保留了每一个答案和原始事件流,并对照摘要做了核对。
评论
讨论气氛以质疑和挑刺为主:多数人怀疑这类 RTX Spark 笔记本的实用场景、性价比、本地 AI 性能,以及 Windows 强制账户与登录体验;只有少数人从大内存成交价或纯玩笑角度认为部分唱衰/抱怨被夸大。分歧主轴在于“它到底解决了什么真问题、值不值”,以及“强制微软账户是真实痛点还是被夸大的麻烦”。
质疑高价 RTX Spark 笔记本的实用场景
- 认为目前看不到强需求:同价位能买到 AMD Ryzen 大内存迷你主机,再远程连接更便宜、更小、续航更好的笔记本;微软本身也有同芯片的非笔记本形态 Surface RTX Spark Dev Box。常被拿来营销的“飞机上写代码”场景也站不住:电源适配器可能在经济舱跳闸,电池撑不住长时间本地 AI,未来飞机联网变好(Starlink 等)会削弱离线场景;游戏则不如 Asus Zephyrus 等独显本。(较多人)
认为文章/硬件体验缺乏可学到的实质收获
- 有人反问“到底学到了什么、克服了什么挑战”,认为买酷硬件本身并不令人受启发,顶多只有 Arm64 形态或新硬件信息值得看。(少数人) > 到底学到了什么、克服了什么挑战?硬件是买了,但这样的消费过程挺无感的。(@hypfer)
认为开发者更该选 DGX Spark(Ubuntu)而非 Windows 版 RTX Spark
- 已有 DGX Spark(Ubuntu)的用户表示,操作系统对开发者影响很大,DGX Spark 的软件栈和体验更成熟,因此不理解为什么要选 Windows 版 RTX Spark。(少数人) > 既然已有 Ubuntu 的 DGX Spark,为什么要换成 Windows 版?DGX Spark 的栈和体验都更成熟。(@jasoneckert)
质疑本地 AI 推理性能与散热表现
- 指出 Qwen 3.8 Flash Next 只有约 30 tok/s,而现在借助专用推理引擎,24GB 显卡配合内存卸载都能达到约两倍速度,推测瓶颈可能是散热限制,并进一步质疑其在稠密模型上的表现。(少数人)
指出苹果 M3 MacBook 早就有超大统一内存,相关叙事不该忽略
- 反驳“笔记本首次让 GPU 访问超 100GiB 内存”的隐含说法:约三年前 M3 MacBook 就已有超过 100GiB 统一内存,只是当时不能运行 Linux;无论如何,Apple silicon 的存在不应被完全忽略。(少数人) > 三年前 M3 发布时就有这种笔记本了,难道你们不把 MacBook 当笔记本吗?(@LoganDark)
认为强制微软账户和登录体验是真实痛点
- 有人不愿把云账户绑定到桌面操作系统,直接质疑这类 Windows 笔记本是否必须使用微软账户;这代表对被强制上云的抵触。(较多人)
- 更激烈的批评认为,用自己的硬件却被强制登录本身就是问题,而微软登录流程充满坏重定向、死链、按钮循环,最后还要过 CAPTCHA;为应用配置 Microsoft SSO 的开发者门户体验被形容为极其糟糕。(少数人)
- 补充事实指出,能否绕开取决于系统版本:多数厂商机预装 Windows Home,Home 版强制要求账户且替代方案越来越少;只有 Pro 版才有较简便的本地账户路径。(较多人)
调侃注册微软账户本就省事,抱怨登录体验有点被夸大
- 以玩笑口吻表示,微软账户注册免费且简单,若只是去注册一个账户,原本会比折腾登录或抗拒更快更省事,暗指部分抱怨有点多余。(少数人) > 其实只要简单注册一个微软账户,事情会更快也更省事。(@dark-star)
认为若只看重大内存,部分机型其实有性价比
- 有人以 HP 版 128GB 约 3.8k 的成交价为例,称在这个内存容量和价位上还没见过更好的选择,暗示不能只按更高价的 6k 版本否定其大内存价值。(少数人)
有价值的补充
- Windows Pro 建立本地账户的绕行路径:通过“工作或学校账户”改为“加入域”,再设置密码与安全问题即可;而多数出厂机预装的是 Home 版,Home 强制要求微软账户且替代方案越来越少。