布隆过滤器(Bloom filter)是一种概率数据结构,用于快速判断键是否在集合中,答案只能是肯定不在或可能在。使用时先按负载和硬件选定可接受的假阳性率,再添加键并查询。它内存占用少、计算开销低,数据库查行前先查内存中的布隆过滤器,可省下大量慢速磁盘 IO。我们在 Bluesky 后端也大量使用它,每秒可为 Scylla 数据库省下数百万次查询。
正文
概述
布隆过滤器(bloom filter)是一种概率型数据结构,用来快速且低成本地回答“键 X 是否在这个集合里”,答案只能是“肯定不在”或“可能在”。你先根据负载和硬件选一个可接受的误判率,把键加入集合,之后再查询它们是否存在。
相比集合的基数,布隆过滤器占用的内存很小,计算也非常便宜,因此常用于高性能数据系统。例如,数据库可以在内存中保留一个布隆过滤器,在真正读盘查找行之前先查它,从而省下大量很慢的磁盘 I/O。
我们在 Bluesky 后端也大量使用它们。借助布隆过滤器,我们在查询 block、mute、label 等数据时,每秒能为 Scylla 数据库省下数百万次查询。比如,我们经常不用查数据库就能回答“用户 X 是否拉黑了用户 Y”。
以下是我们生产环境中最近几天部分布隆过滤器的正向命中率:
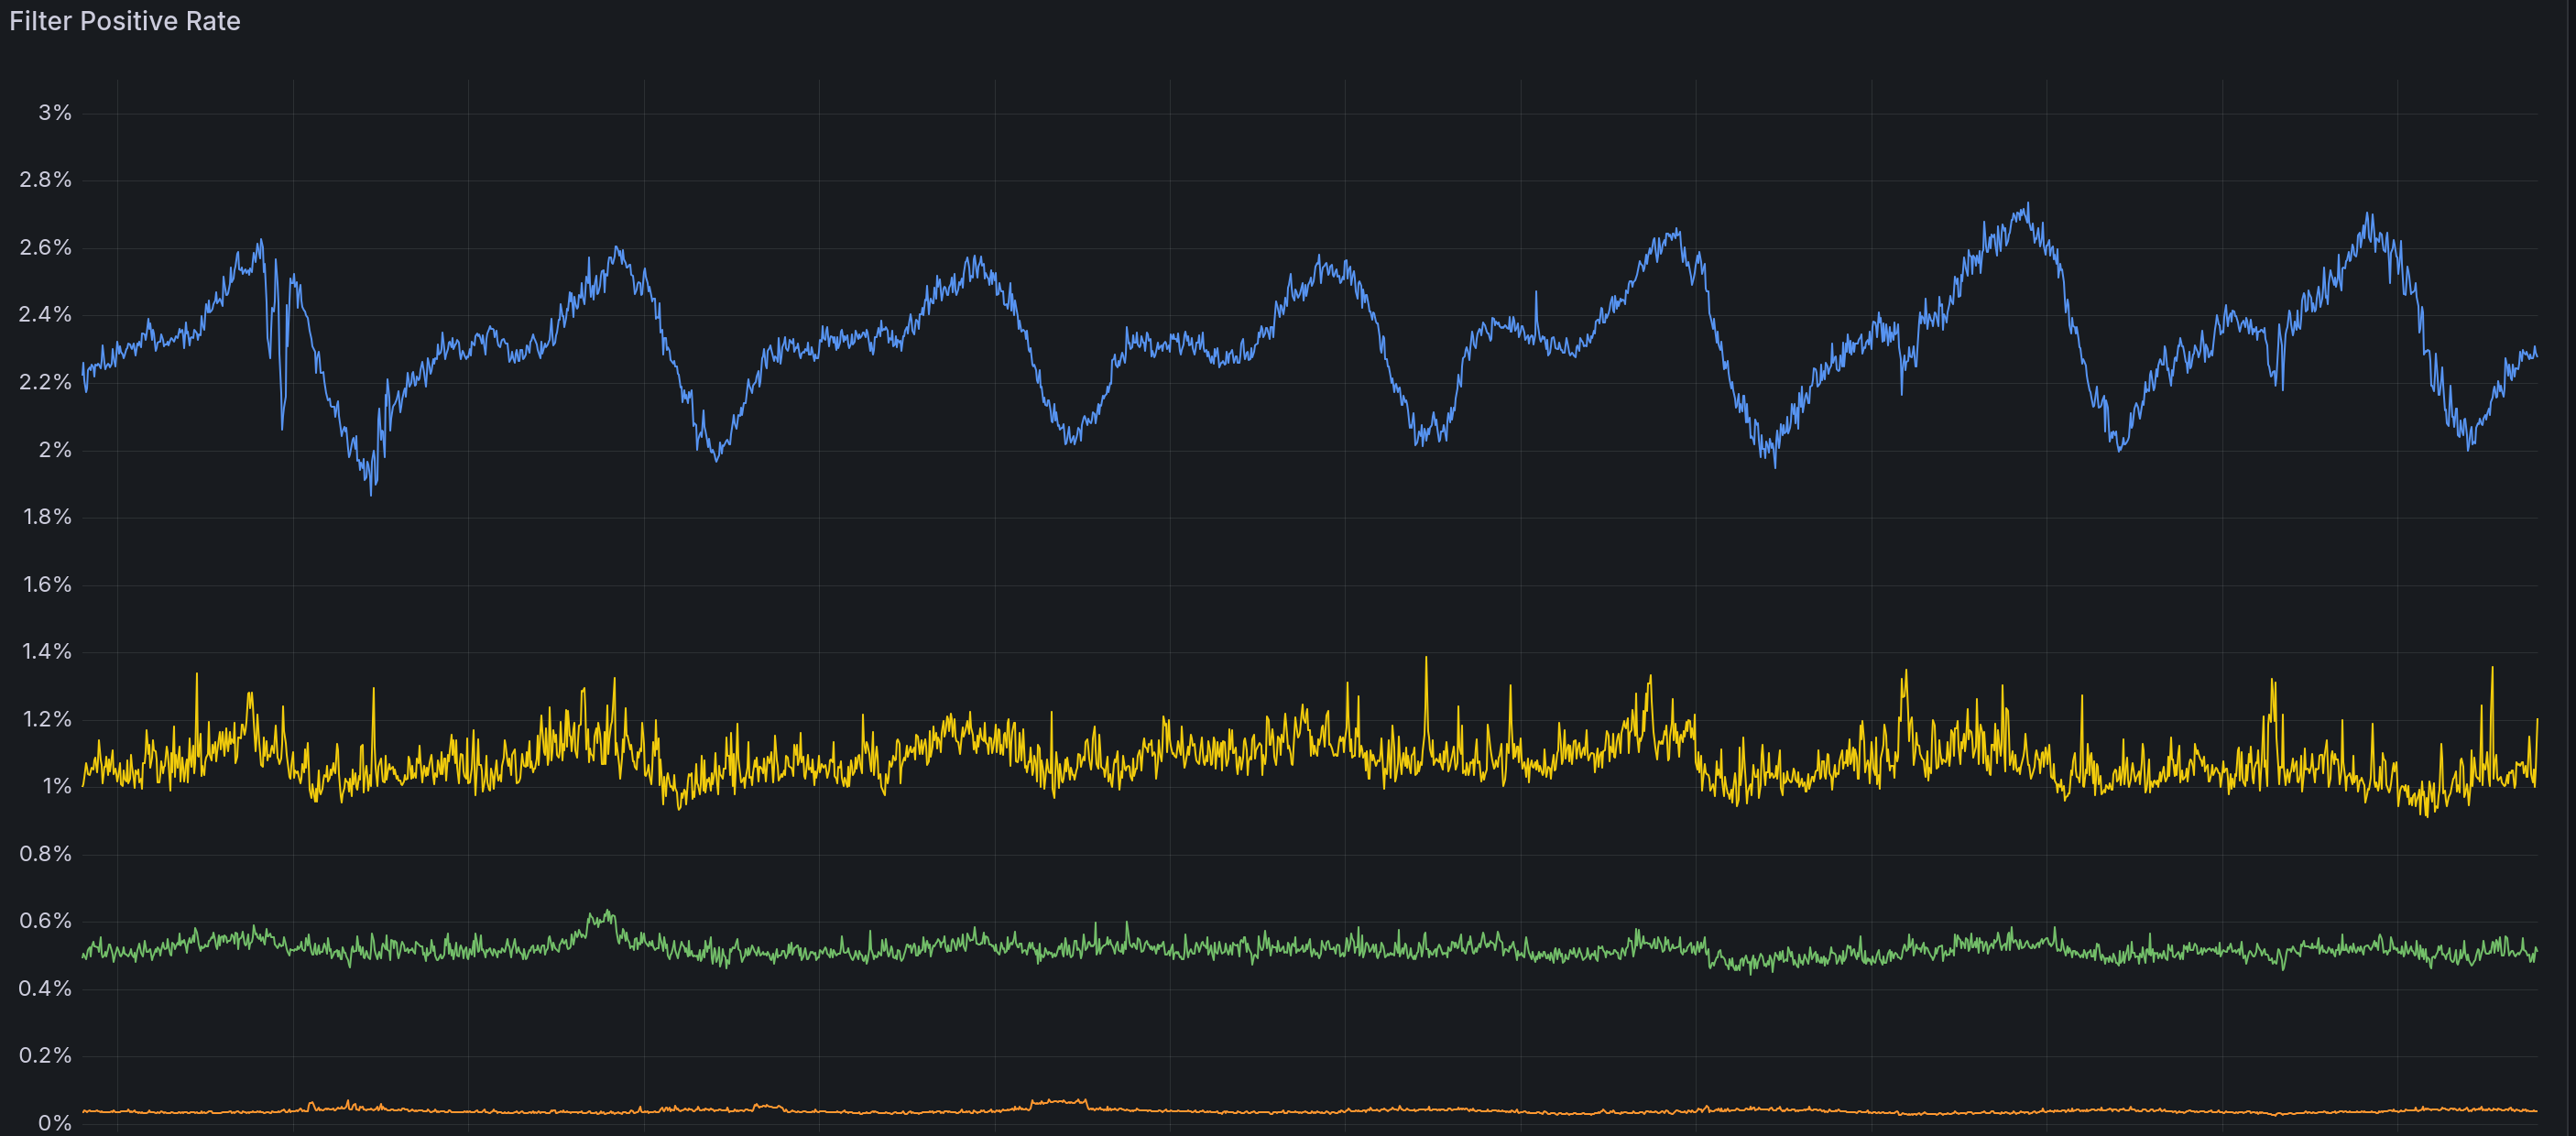
上面黄线的正向率约为 1%,这意味着 99% 的情况下,我们可以完全跳过数据库查询。这对我们扩展站点规模并低成本运营起到了关键作用。
传统布隆过滤器
布隆过滤器是一个位数组,加上 k 个哈希函数。你需要事先确定数组大小和 k,并让其适合你的负载,以达到特定的误判率。
要加入一个键,就用 k 个哈希函数分别计算,并把这些位置的位都设为 1。
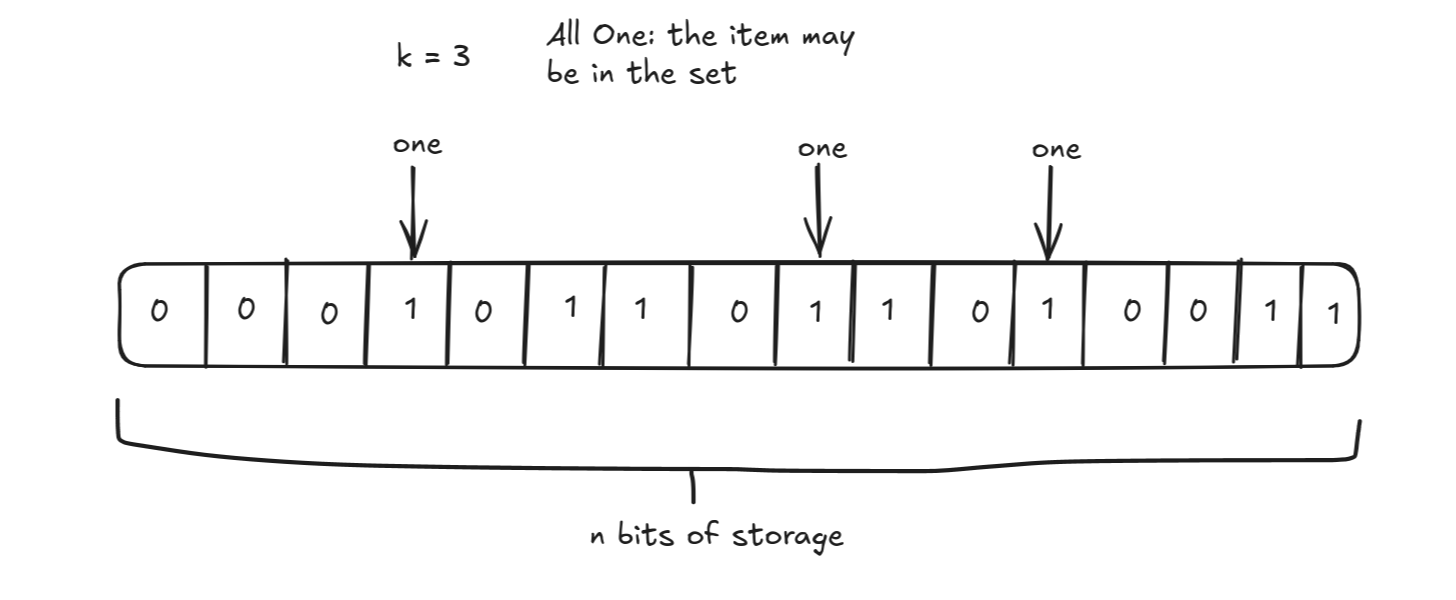
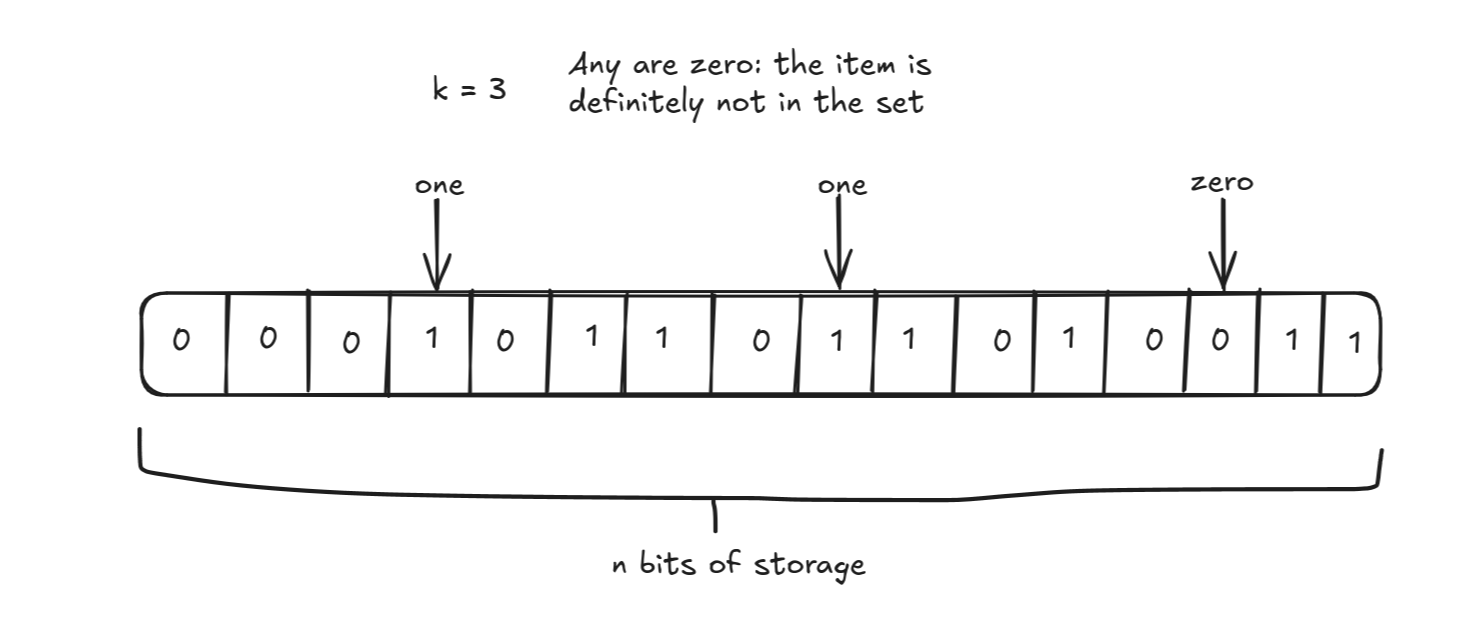
要检查一个键是否在集合中,也把它哈希 k 次,并检查位数组中对应的每个位置。如果有任何一位是 0,说明该键从未被加入;如果所有位都是 1,那它可能在集合中。
下面是一个“可能存在”的例子:
以及“肯定不存在”的例子:
很简单!
双重哈希
虽然比读盘便宜得多,但对极高性能系统来说,每个键计算 k 个独立哈希仍然有点贵。
2008 年,Kirsch 和 Mitzenmacher 发表了一篇论文,证明两个哈希就能得到同样的输出。其中的数学远超我的理解,但如果把第 i 个位置推导为 (hash1 + i * hash2) % n,那么误判率实际上和使用 k 个独立哈希相同。真是松了口气!
bits-and-blooms/bloom 是用 Go 实现的双重哈希布隆过滤器,由 Daniel Lemire 维护。它跑两次 128 位 murmur3,得到四个 64 位值,再把它们组合出全部 k 个位位置。我们在 Bluesky 生产环境用了它很长时间。
在 Bluesky 后端,我们基本上每次进程启动时都会执行 SELECT * FROM blocks、mutes、list items 等查询,并把所有条目加入布隆过滤器。同时还有一个实时的 atproto firehose 消费者不断向布隆过滤器插入条目,即使在进程启动期间也是如此,因此如果不小心就会出现竞态条件。
问题在于 bits-and-blooms 库本身不是线程安全的,因此我们必须用互斥锁(mutex)把所有布隆过滤器访问包起来,否则会出现数据竞争。pprof 显示,互斥锁争用实际上是进程启动时的瓶颈。一次部署曾因此要花 90 分钟才能完全上线!
于是我的同事 Jasmine 分叉了该库,创建了 atomic-bloom,它使用 atomic CPU 指令完成同样的逻辑,但无需互斥锁且是线程安全的。这大幅减少了争用,也比基于互斥锁的方案快得多。我们的部署时间从 90 分钟降到大约 15 分钟,从而能更快、更自信地发布。
单次哈希
还能更进一步吗?对 Bluesky 来说,答案是不能。我们最初的问题是争用,而不是哈希函数数量或其他因素;按照阿姆达尔定律(Amdahl's Law),再减少哈希函数也不会带来有感知的加速。不过,继续深入并学点新东西仍然很有意思!
在研究布隆过滤器技术时,我们看到了 Lu 等人发表的一篇论文,它用了更多数学方法,展示如何只用单次哈希实现布隆过滤器。
其原理大致如下:
- 不用一整块大位数组,而是把它分成 k 个固定大小的数组分区;
- 每个分区大小不同,且所有大小两两互质(pairwise coprime),即任意两个大小除了 1 之外没有公因数;
- 对给定键只做一次哈希,得到 hash;
- 分区 p 中的位位置是 hash % sizep,其中 sizep 为该分区大小;
- 因为有 k 个分区,单次哈希就能得到 k 个待检查的位位置;
- 这些 k 个位位置可以像其他布隆过滤器类型一样使用!
有了这项技术,我开发了 jcalabro/gloom,一个用 Go 实现的单次哈希布隆过滤器(OHBF)。它已经在 Bluesky 后端稳定运行了 9 个月,表现相当不错,也被我们的高性能同步服务 jetstream 使用。
使用时,先创建一个线程安全的原子布隆过滤器,指定预期容量为一百万、目标误判率约 1%;随后可以并发地对大量字符串键先做存在性测试,再加入集合。由于这些键其实并未加入,任何被判定为存在的情形都是误报。
要检查某个键时,先计算它的 128 位哈希(xxh3.Hash128):用高 64 位对 numBlocks 取模来选择 block,低 64 位作为实际要检查的 h。随后按下面的方式检查布隆过滤器:
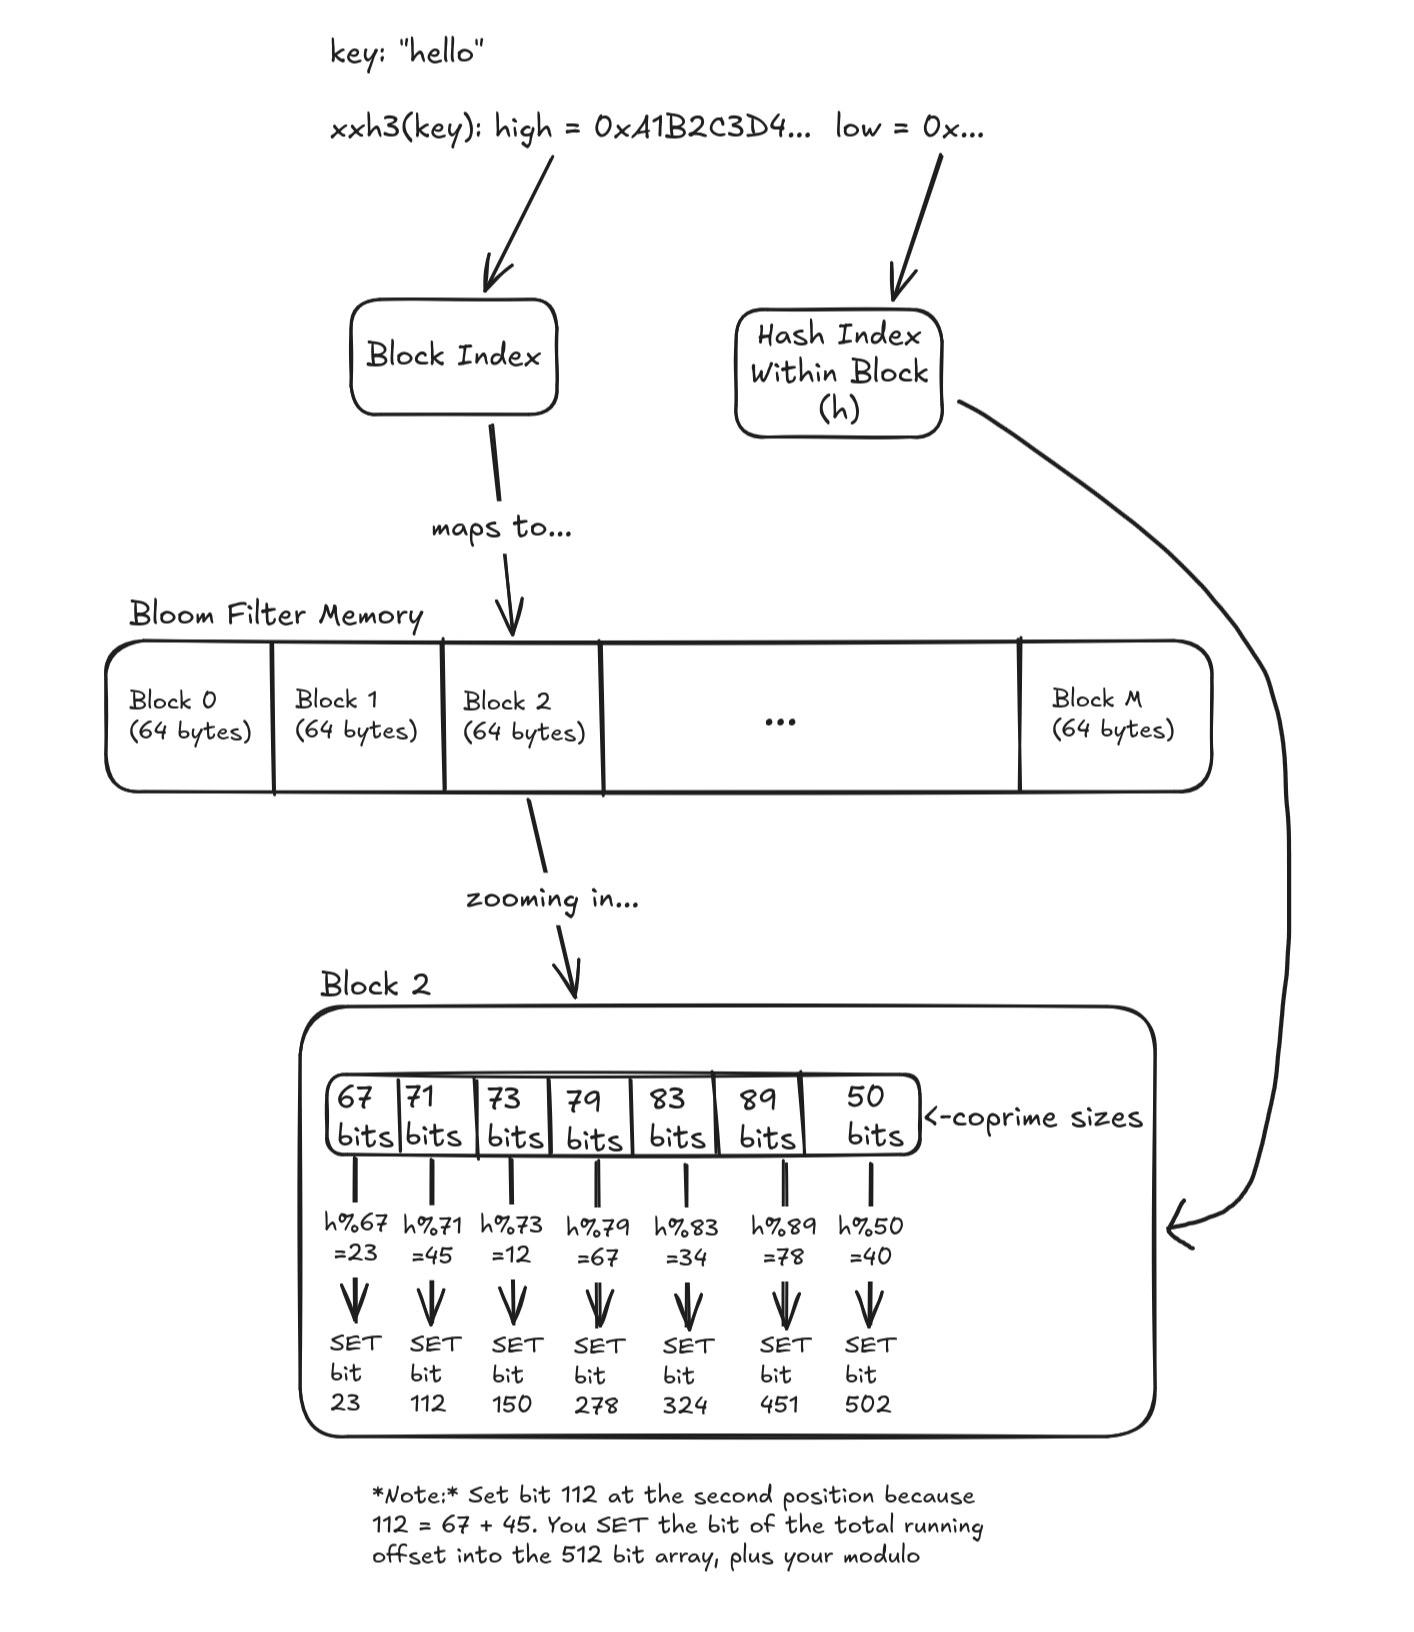
除了只用单次哈希,它还做了一些性能优化。首先,我们把布隆过滤器拆成许多 64 字节的 block,以匹配常见的 CPU 缓存行大小。其次,由于 Go 的分配器不保证这些 block 的分配是缓存对齐的,我们会稍微超量分配,并用 unsafe 确保对齐。这两项技术结合起来,保证最坏情况下一次布隆过滤器查找只会发生一次缓存未命中。
还有一项来自 Daniel Lemire 的优化:可以用一条 MUL 指令选择要检查的 block,而不用取模(modulo)——取模需要昂贵的除法指令。
最后一项有意思的优化是 ShardedAtomicFilter。在 Bluesky,我们有一大批顶级裸金属服务器。为了尽量榨出这些系统的性能,最好避免多个核争抢同一份数据。ShardedAtomicFilter 把写入分散到多个后端过滤器分片上,从而降低争用的可能性。
结论
布隆过滤器(以及 roaring bitmaps)让世界运转。
评论
讨论气氛务实,技术权衡压倒单纯叫好:有人称赞这是比 Miztenmacher 更进一步的单哈希优化,也有人只简单留言「好文」;但主要分歧很快转向代价与必要性——批评者警告分区会牺牲空间效率,资深哈希实现者则认为保持 2 的幂表并混合哈希值即可,不必采用文中那套复杂做法。
认为该单哈希优化比 Miztenmacher 更巧妙且可能支持过滤器合并
- 有人此前没见过这篇单哈希论文,认为它比 Miztenmacher 更进一步、很不错,还想看不同输入规模下的基准数据,并初步判断只要新规模不超过过滤器容量,该做法也能支持过滤器合并;另有人只用「好文」表达认同。(认可度:较多人) > 这个单哈希方案既是对 Miztenmacher 的酷优化,也可能支持过滤器合并(@gwittel)
警告分区会牺牲空间效率并抬高热点分区误报率
- 分区会造成各分区占用率不均;目标误报率越低,牺牲空间效率的问题越明显。若接受低占用率,过滤器整体会被迫变大;若不想变大,则几乎必然出现热点块,使特定分区的误报率升高。(认可度:少数人) > 分区牺牲了不可忽略的空间效率,且误报率目标越低损失越严重(@FreakLegion)
认为不必采用该复杂方案,2 的幂表加混合哈希即可
- 只需保持大小为 2 的幂的表,再对哈希值做轻微混合来生成后续每个位索引即可,不需要文中的做法;发言者自称是 MurmurHash/SMHasher 的作者,并在自己的布隆过滤器与 cuckoo 哈希表中用过此法。(认可度:少数人) > 不必这么做,保持 2 的幂大小的表并轻微混合哈希值来取后续位索引即可(@aappleby)
有价值的补充
- cperciva 指出,计算每个键的 k 个独立哈希是否昂贵,取决于布隆过滤器有多大;大多数哈希值位数很多且各位相互独立,因此往往一次哈希计算再按位切片,就能低成本得到多个索引,不能一概说「k 个独立哈希很贵」。