今天,名之梦(MiniMax)正式推出 MiniMax M3.1 Flash。曾在匿名运行期间处理超过 200 万亿 token 的太空兔(Space Bunny)是 MiniMax M3.1 Flash 的早期版本。作为新一代 Flash 模型,M3.1 Flash 在智能体任务、编程、计算机使用(Computer Use)和网络安全上实现代际跃升,在线推理速度提升至近三倍,使用成本降低 70%。
正文
今天,我们正式推出 MiniMax M3.1 Flash。
匿名运行期间处理了超过 200 万亿 token 的 Space Bunny 🐰,正是 MiniMax M3.1 Flash 的早期版本。
作为新一代 Flash 模型,M3.1 Flash 在智能体任务、编程、Computer Use 和网络安全方面实现了一代跨越,同时让在线推理速度提升至近三倍,使用成本降低 70%。
各项能力全面提升
M3.1 Flash 在广泛的基准测试中均有提升,在复杂智能体任务(cowork)、Computer Use、软件开发(编程)和网络安全方面达到了领先模型的水平。
复杂任务与自动化:
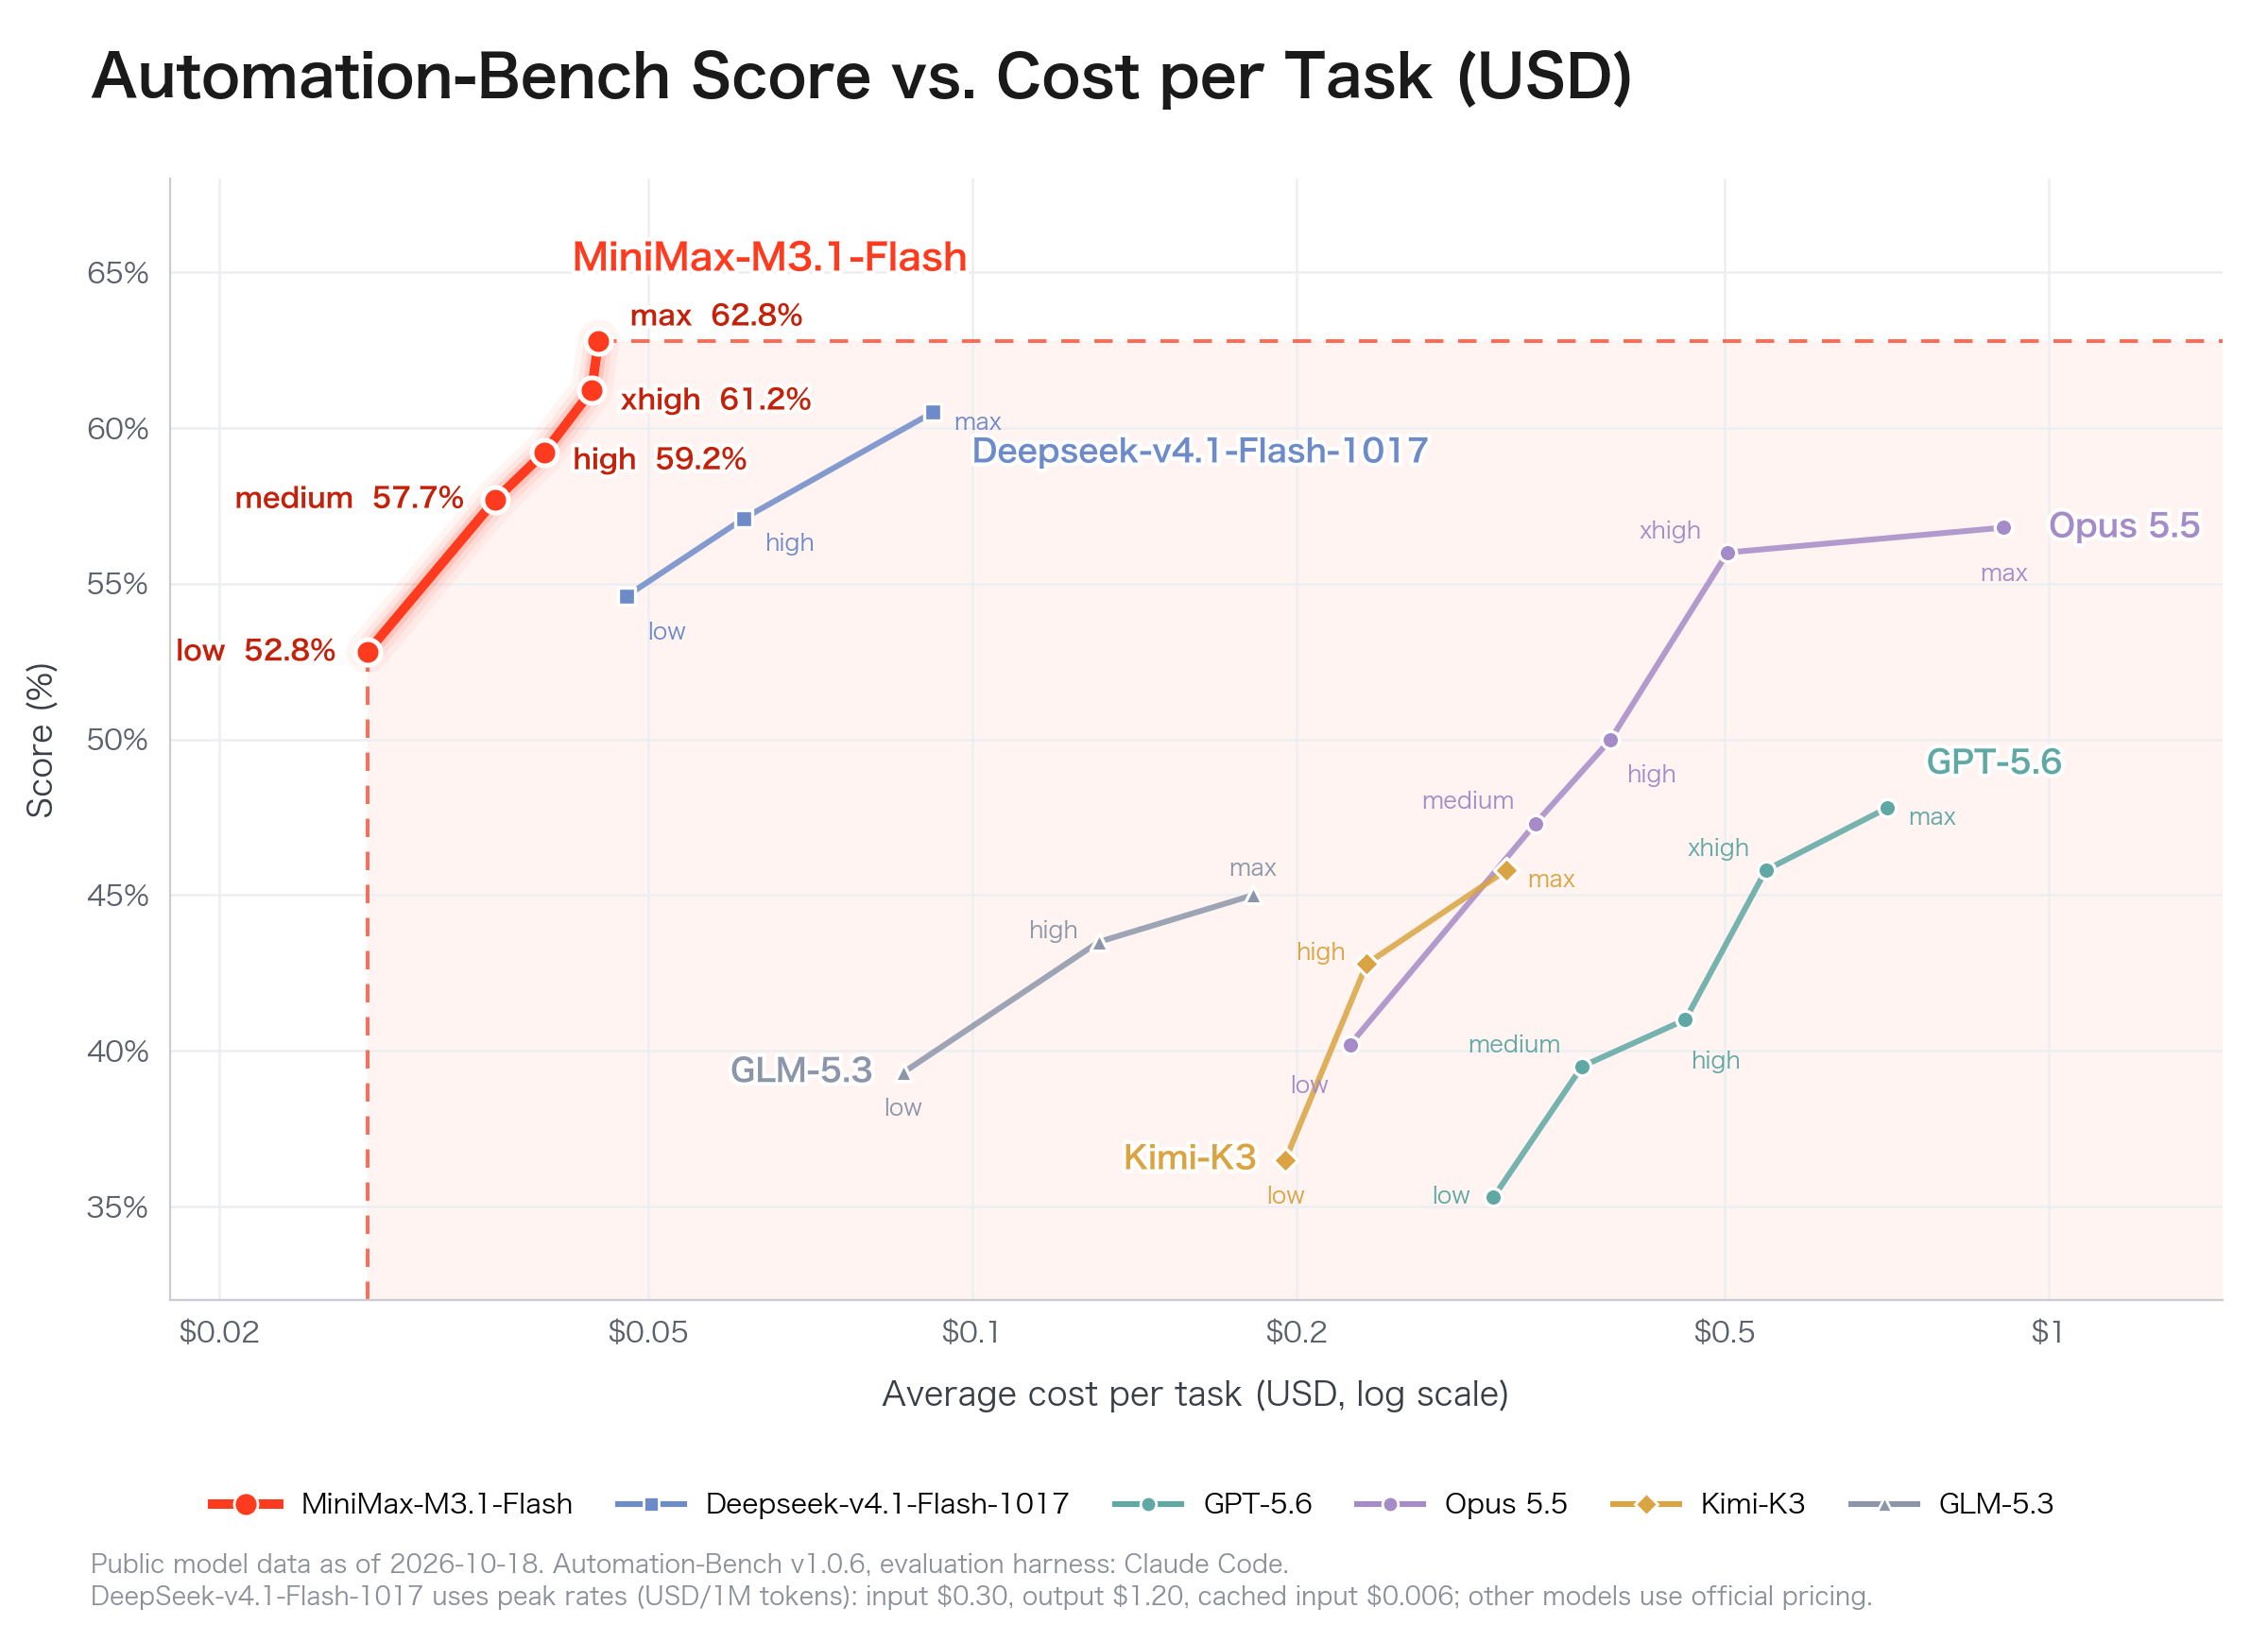
- M3.1 Flash 在 AutomationBench-AA 上名列前茅,能够跨 SaaS 系统完成真实的企业工作流,端到端解决销售、营销、运营、客服、财务和人力资源等实际问题。
- 在 BankerToolBench 上得分 76.2,擅长多步规划、保持文档与文件的一致性、财务合规以及链式工具调用等复杂的现实挑战。
编程与软件工程:
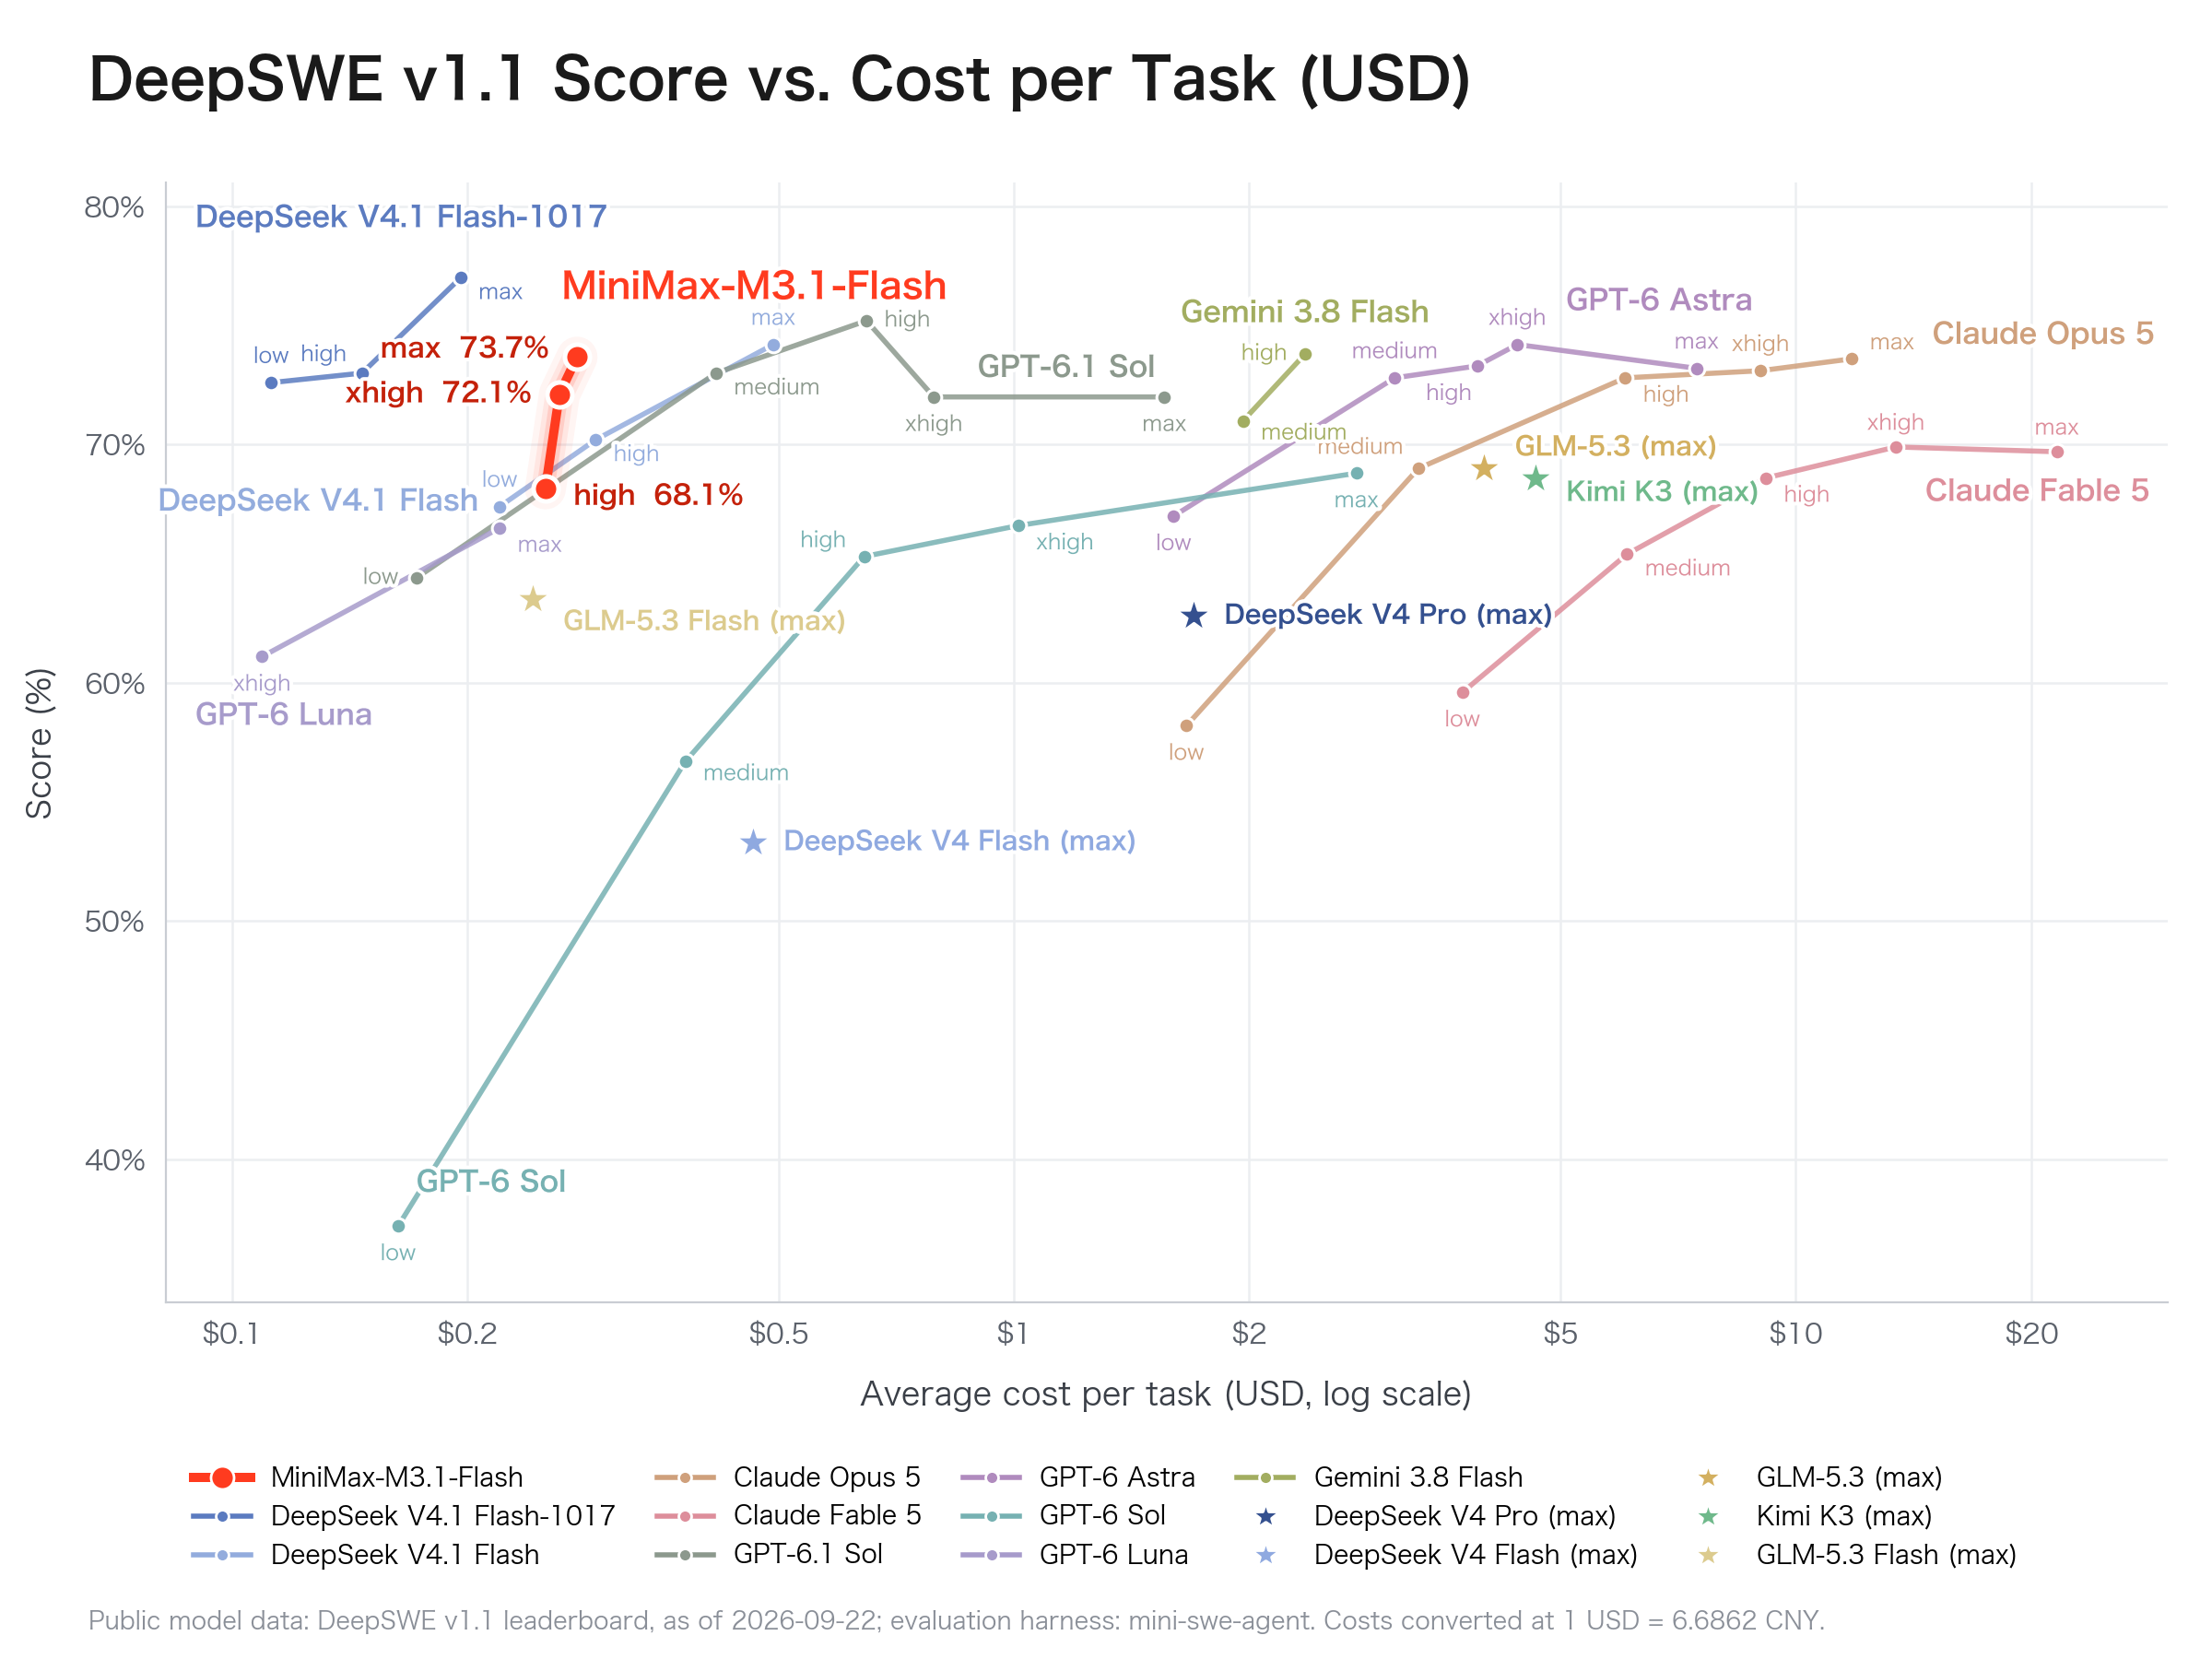
- 在 DeepSWE v1.1 上达到 73.7%,与顶级模型同列。DeepSWE 关注复杂的软件任务,要求模型独立理解代码、开发功能、修复问题并通过测试验证工作。M3.1 Flash 在长步骤序列中表现出很强的执行力,以更低的成本支持复杂的软件开发工作流。
Computer Use:
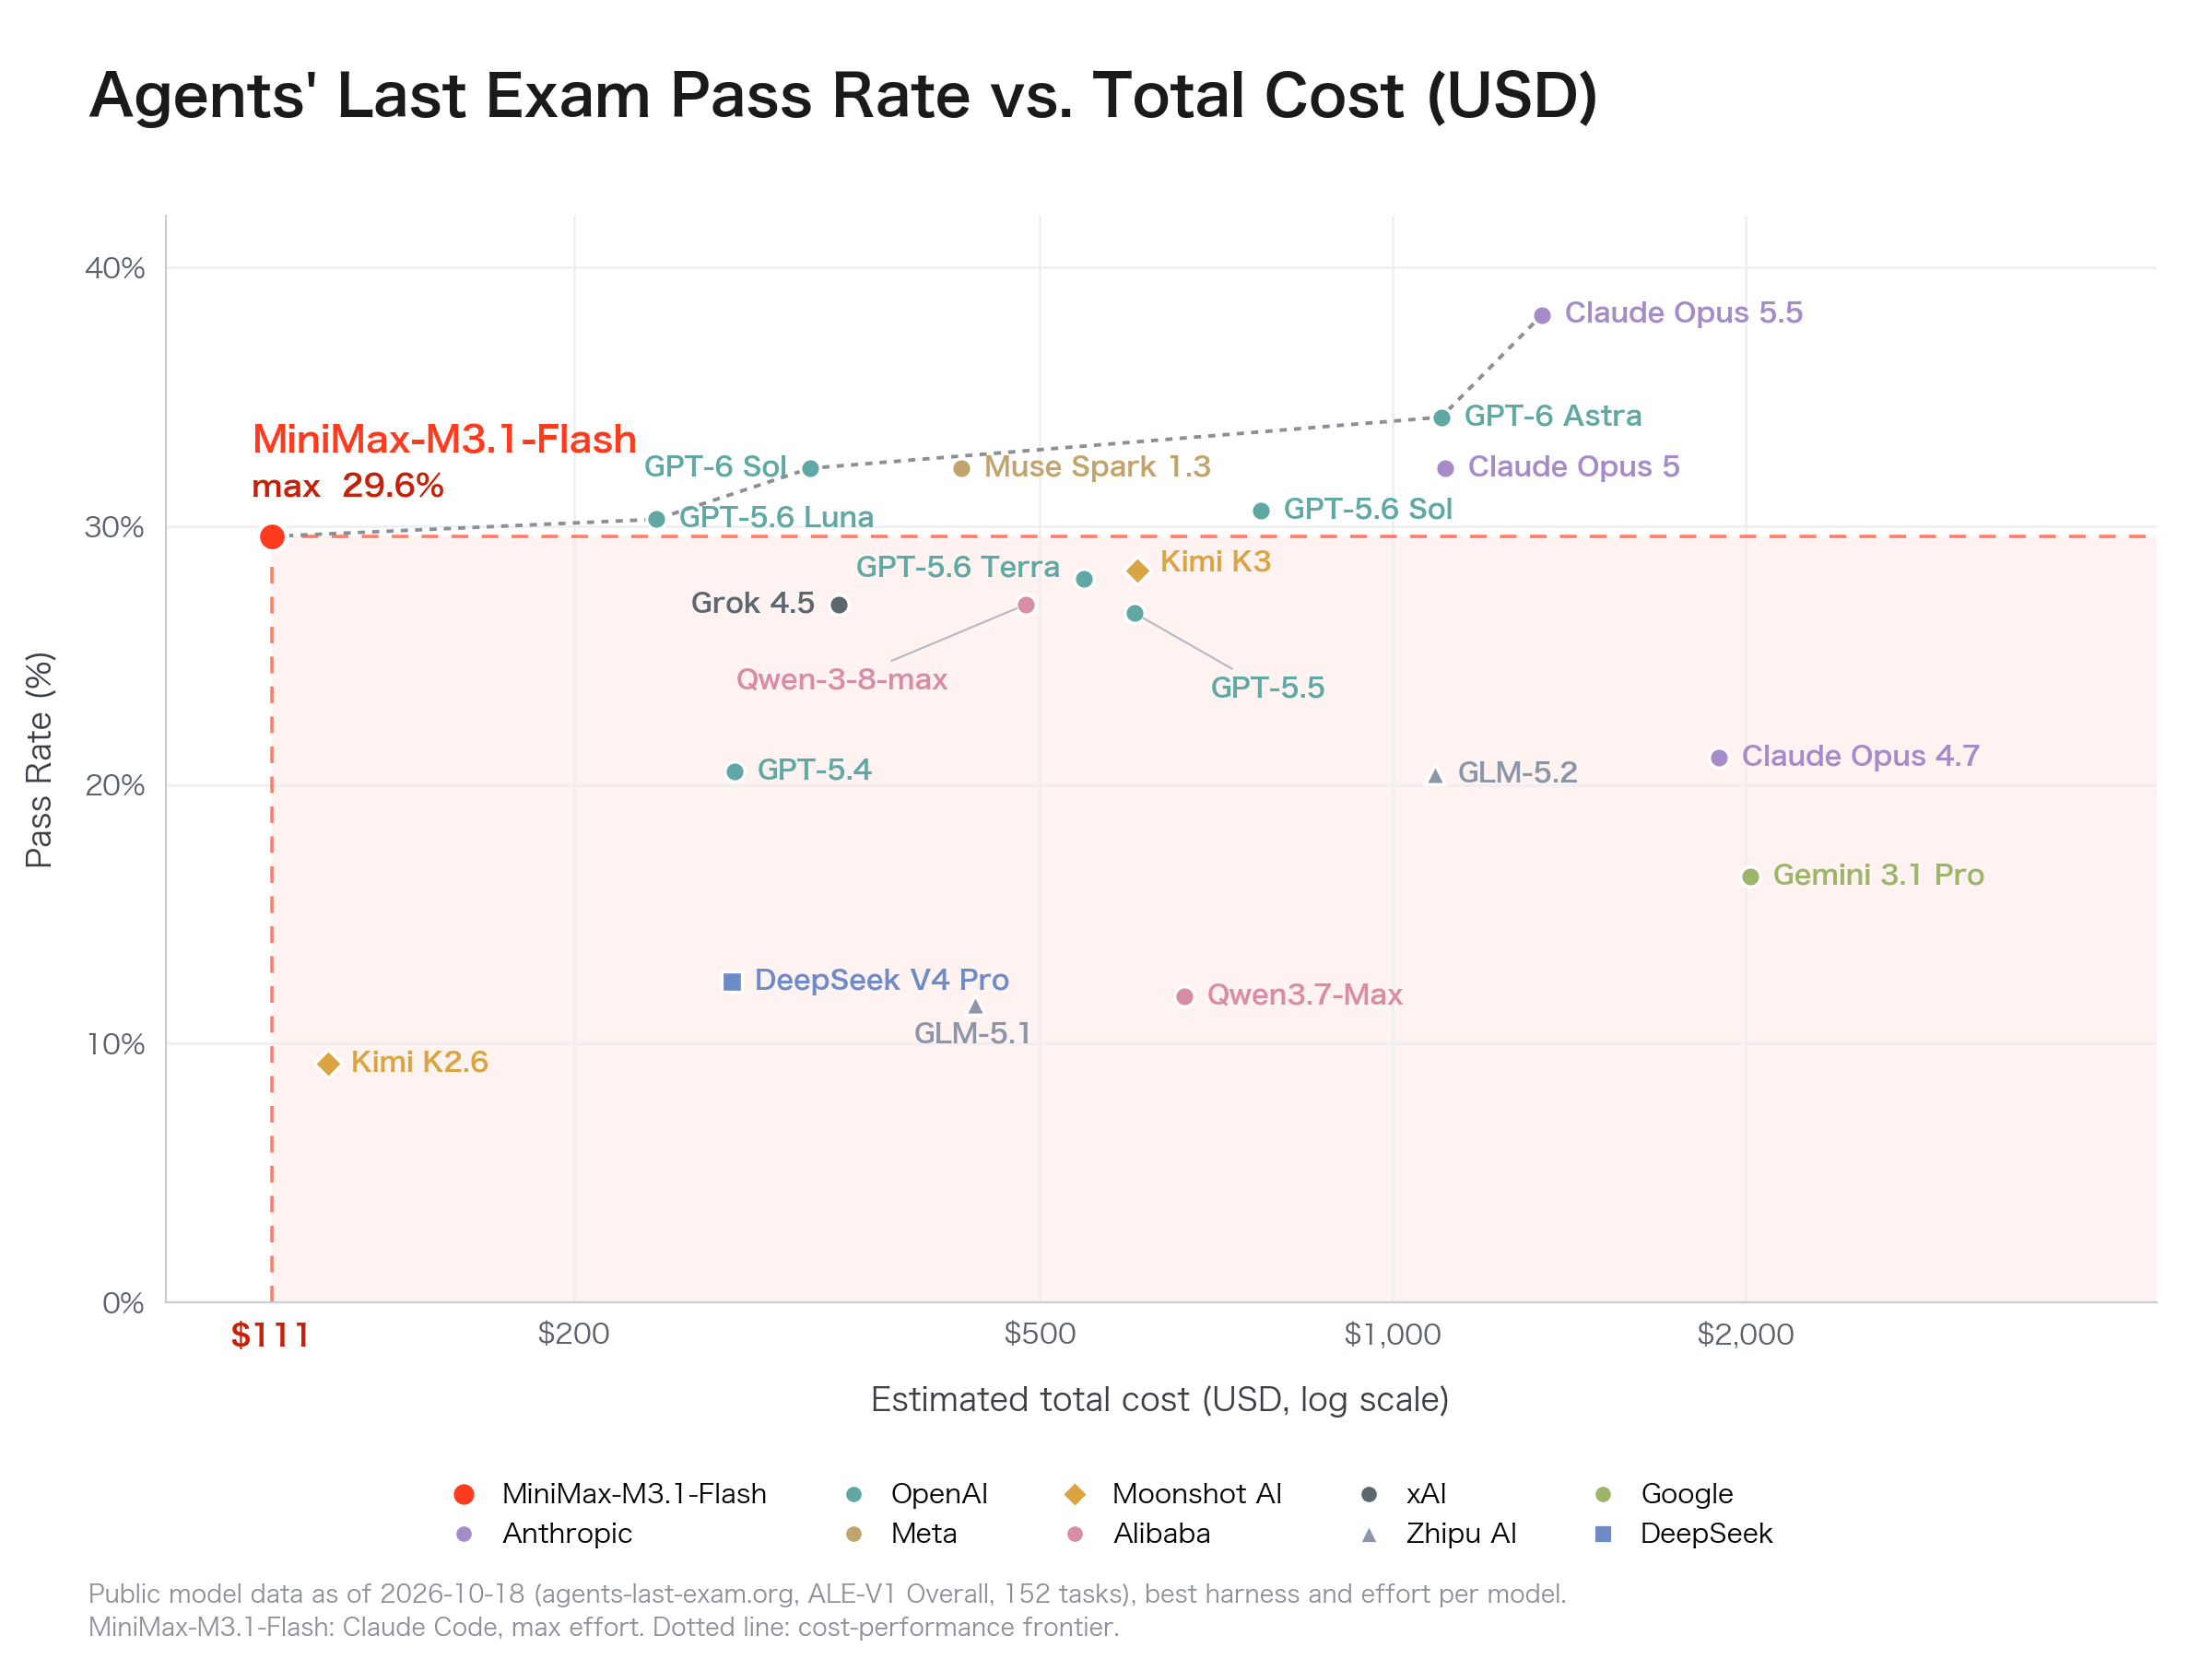
- 在衡量 AI 操作计算机与跨应用任务执行能力的 OSWorld V2 上得分为 61.7 分,在评估真实专业工作与复杂任务表现的 Agents’ Last Exam (ALE) 上得分为 29.6 分。两项基准测试中,它均位列中国模型第一。
- M3.1 Flash 在与真实环境交互、使用工具和执行长序列任务方面能力突出,不再只是理解任务,而是采取行动并交付结果。
网络安全:
- 在 CyberGym 上取得 82% 的优异成绩,展现出漏洞发现与验证方面的领先能力。
- 在我们内部安全专家的深度评估中,该模型在代码审计、漏洞修补、渗透测试、恶意软件分析和逆向工程方面表现突出,能够高效、低成本地支持构建复杂的安全系统。
我们通过更激进的稀疏化进一步优化了 M3.1 Flash 的推理效率。在日常使用中,输出速度可达 200+ TPS(tokens per second),中位数(P50)速度也稳定达到 170+ TPS。
定价:最具性价比
在智能体任务上,该模型的总体使用成本比前代低 70%。
每 100 万 token 的统一价格:输入 $0.15 · 输出 $0.60 · 缓存输入 $0.015。
重新定义智能体任务的能力与成本
在三项基准测试中——用于复杂智能体任务执行的 Automation-Bench、用于真实场景编程的 DeepSWE,以及用于具有经济价值的真实任务中计算机操作的 Agents’ Last Exam (ALE)——M3.1 Flash 以极低的任务成本提供了与顶级模型相当的性能,树立了极具竞争力的性能与成本新标准。
M3.1 Flash 现已通过 MiniMax API、M Plan 和 MiniMax Code 提供。模型权重将稍后发布。
Flash 代表了我们在效率与能力平衡上的持续探索。推动智能边界的 Pro 也将随后推出。
评论
讨论气氛以质疑为主:多数人认为 MiniMax 这款新 Flash 模型的 benchmark 成绩被“刷榜”美化,实际作为“Space Bunny”免费试用时并未留下好印象,真实编码表现不如 DeepSeek V4.1 Flash 1017、GLM 5.3 Flash 或 Qwen 3.8-flash-next。少数人则肯定其成本下降与推理加速,期待它继续把性价比前沿往上推;同时也有人厌烦厂商千篇一律的“又强又便宜”宣传、闭源模型后期被削弱,以及 Hacker News 上的重复发帖。
认为新模型跑分被美化,实际表现和历史口碑都不值得信赖
- 该模型此前以“Space Bunny”代号在 OpenCode Go 作为免费 stealth 模型放出,但用户试用后普遍因严重错误回流到 DeepSeek V4 Flash、Qwen 3.8-flash-next 等;deepswe、terminalbench 分数与真实 OpenCode 体验并不一致(较多人) > 跑分高并不等于好用,现在的激励已经让 benchmark 分数几乎失去意义。(@DCKing)
- 有对比认为它在 deepswe 上不如 DeepSeek V4.1 Flash 1017,若推理价格不能砍半就没有竞争力,训练算力像是白费;甚至有人怀疑是否存在 MiMo 2.6 Pro 全面更优的场景(少数人)
- 回顾 MiniMax 前几代,M2.7 授权糟糕、M3 仅算“平平”,因此即便新模型有改进,用户也怀疑它是否真能摆脱“失望”印象;只是相对标准下,若 M3.1 早几个月发布本来会算突破(少数人)
肯定成本下降与推理加速,认为性价比前沿继续左移
- 新模型定价较前代 M3 明显下调,输入与缓存成本减半,官方说的约 70% 成本降幅大体站得住;这被认为主要是为对标 DeepSeek V4.1,但其缓存价格仍没打过对方(较多人) > 为了贴近 DeepSeek V4.1 的价格,这次约 70% 的成本降幅很可观,只是缓存成本还是没赢。(@minimaxir)
- 若“Flash”意味着参数量从上代约 428B 缩小到约 150B,量化后有望在 DGX Spark、128GB Mac 或新 AMD AI 系统上本地运行;再加上 3 倍推理速度,对消费级硬件会很有吸引力(少数人)
- 已有人用 DeepSeek Flash 1017 以极低成本替代 Claude 订阅完成整个项目,因此对 MiniMax 新模型在美区 provider 上线后也感到期待(少数人)
认为厂商“又强又便宜”的宣传缺乏独立验证,闭源对比也无意义
- 每次发布都自称最强且更便宜,却几乎无人独立复核;与 GPT-5.6、Opus 等闭源模型比也没意义,因为它们常发布后被削弱、表现波动大,有时像马尔可夫生成器,自托管才知跑的是什么(较多人) > 和闭源前沿模型比没什么意义,它们发布后经常被削弱,某天还正常,另一天就像马尔可夫生成器一样蠢。(@varispeed)
- 有人觉得这类公告本身已不值得评论,因为下一天总会出现下一个“更好更便宜”的模型;社区也厌烦 Hacker News 上的重复发帖(少数人)
有价值的补充
- 价格细节:新模型调用价为输入 $0.15、输出 $0.60、缓存读取 $0.015(按每百万 token 计),前代 MiniMax M3 为 $0.30、$1.20、$0.06;输入和缓存读取各降一半,使“整体使用成本降约 70%”大体合理。DeepSeek V4.1 输入/输出同价但缓存读取仅 $0.003,所以新模型仍没在缓存成本上打平。(@minimaxir)
- 规模与部署推测:上一代 MiniMax M3 约 428B 参数;因新版本叫 Flash 且宣称推理快 3 倍,可能缩到约 150B,量化后可在 DGX Spark、128GB Mac 或新 AMD AI 系统上运行。(@terhechte)
- 背景对照:该模型之前的 stealth 代号是“Space Bunny”;作为对照,GLM 5.3 Flash 的 stealth 名“Ox Alpha”曾收获不少好评,而“Space Bunny”则因错误过多被弃用。Hacker News 版主也关联了此前猜测 Space Bunny Alpha 身份的旧帖。(@DCKing、@walrus01、@dang)