“这只是时间戳”,最流行密码学标准之一的起源之谜已被解释。椭圆曲线数字签名算法(ECDSA)是最广泛使用的椭圆曲线密码学标准,美国国家标准与技术研究院(NIST)在2000年将其纳入联邦信息处理标准 186-2 数字签名标准(FIPS 186-2 Digital Signature Standard),其中的 seed 参数的哈希值用于定义曲线系数 b。这些 seed 由美国国家安全局(NSA)提供且来源不明,例如 NIST P-256 曲线的 seed 为 C49D3608 86E70493 6A6678E1 139D26B7 819F7E90,无人知其来历。
正文
ECDSA 是使用最广泛的椭圆曲线密码学标准。NIST 在 2000 年将其采纳为 FIPS 186-2 数字签名标准的一部分,该标准列出了一组不同规模和安全等级的标准椭圆曲线。对于基于素数域和二进制域的曲线,规范中公布了一个“seed”(种子)参数,其哈希值用于定义曲线的系数 b。这些种子的来源一直是个悬而未决的问题,因为它们由 NSA 提供,且没有任何解释或理由。例如,NIST P-256 曲线的种子是 SEED = C49D3608 86E70493 6A6678E1 139D26B7 819F7E90,但没有任何关于其来源的信息。
Neal Koblitz 和 Alfred Menezes 写了一篇关于这一争议的出色综述《A Riddle Wrapped in an Enigma》,讨论了围绕这些种子值的历史和疑虑。这一谜团引发了一场业余调查,试图找出种子的来源,也有人悬赏寻找能够找到它们的人。
最流行的说法是,NSA 长期雇员 Jerry Solinas 用一个幽默口令的哈希值生成了这些种子。他 2015 年说:
“我认为用的是计数器,而不是多次哈希,但我不知道细节。信息大概是‘Give Bob and Jerry a raise’(给 Bob 和 Jerry 加薪)或‘Bob and Jerry rule’(Bob 和 Jerry 做主)之类。实际上是 Bob Reiter 写的代码,他也不记得细节了。我们也没能找到那么久以前的档案。如果它们还存在,无疑正躺在约柜附近的某个硬盘里。”
Jerry Solinas,2015
不幸地是,Jerry 于 2023 年去世,当时的其他同事也没有回应,因此这些种子最初是如何生成的仍是个未解之谜。
Claude 找到了种子
几名 Anthropic 员工曾根据“种子是某个幽默短语的哈希值”这一线索追查,但没有成功。这个说法后来被证明是错的。2026 年 10 月,一位好奇的 Anthropic 员工询问内部研究模型,能否在不点明该线索的情况下弄清楚这些种子是如何生成的。
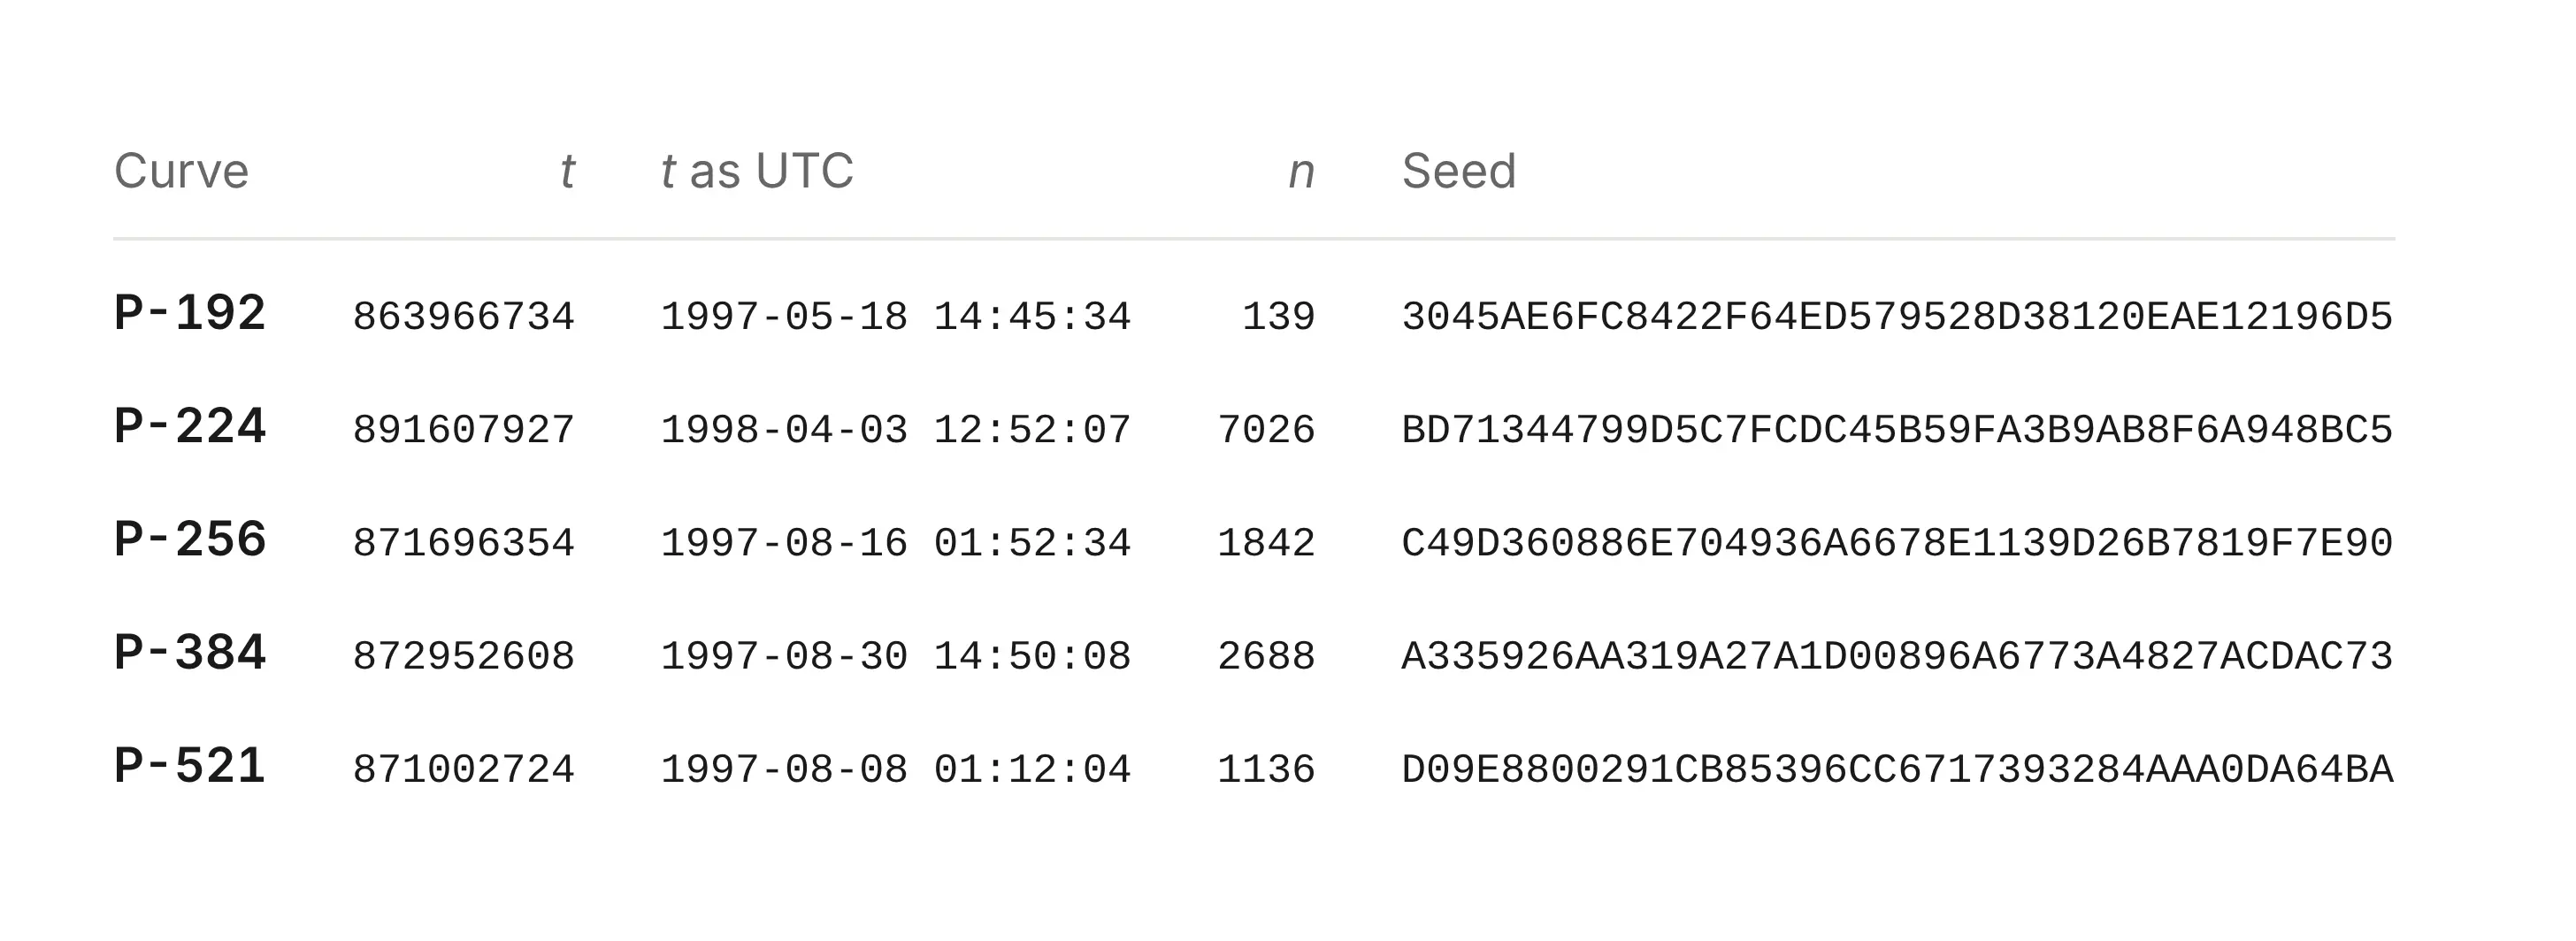
不到半小时,Claude 就发现了 NIST P-192、P-224、P-256、P-384 和 P-521 种子的来源。它们根本不是任何哈希算法的结果,而是 C 库 lrand48 随机数生成器的输出,只不过是用 Unix 时间戳作为种子初始化的!
所用算法会从以 Unix 时间戳(t)初始化的随机数生成器(RNG)中采样字节,进行若干次迭代(n)。每次迭代抽取 20 字节作为一个候选种子。因此,前 20 字节是候选 1,接下来 20 字节是候选 2,依此类推。例如,P-256 需要 1842 次迭代才能输出标准化的种子。
这意味着什么
这并不是密码学破解、新攻击或 ECDSA 曲线的弱点。事实上,这让我们更有信心认为这些曲线在选择时没有任何后门或故意留下的弱点。多年来,人们一直怀疑 NIST 曲线参数的来源。这些参数被提交给 NIST 时没有说明是如何选择的,让人怀疑它们是否被特意选中以植入后门。这些发现使那种可能性大大降低。种子的生成方式非常简单:一个常见的伪随机数生成器,用时钟初始化,现在任何人都可以复现。这大大减少了被暗中做手脚的空间,也让我们可以确信这些参数是安全的。
它是如何被发现的
根据传言构造的短语搜索一无所获。Claude 换了个角度:预测生成这些曲线的软件当初必须如何工作。它猜测该软件使用了 1990 年代 C 库中附带的伪随机数生成器(PRNG)。这些老式 PRNG 非常弱,其输出可以被识别出来。识别出输出就能揭示使用的是哪个 PRNG,并可能恢复其初始化状态。
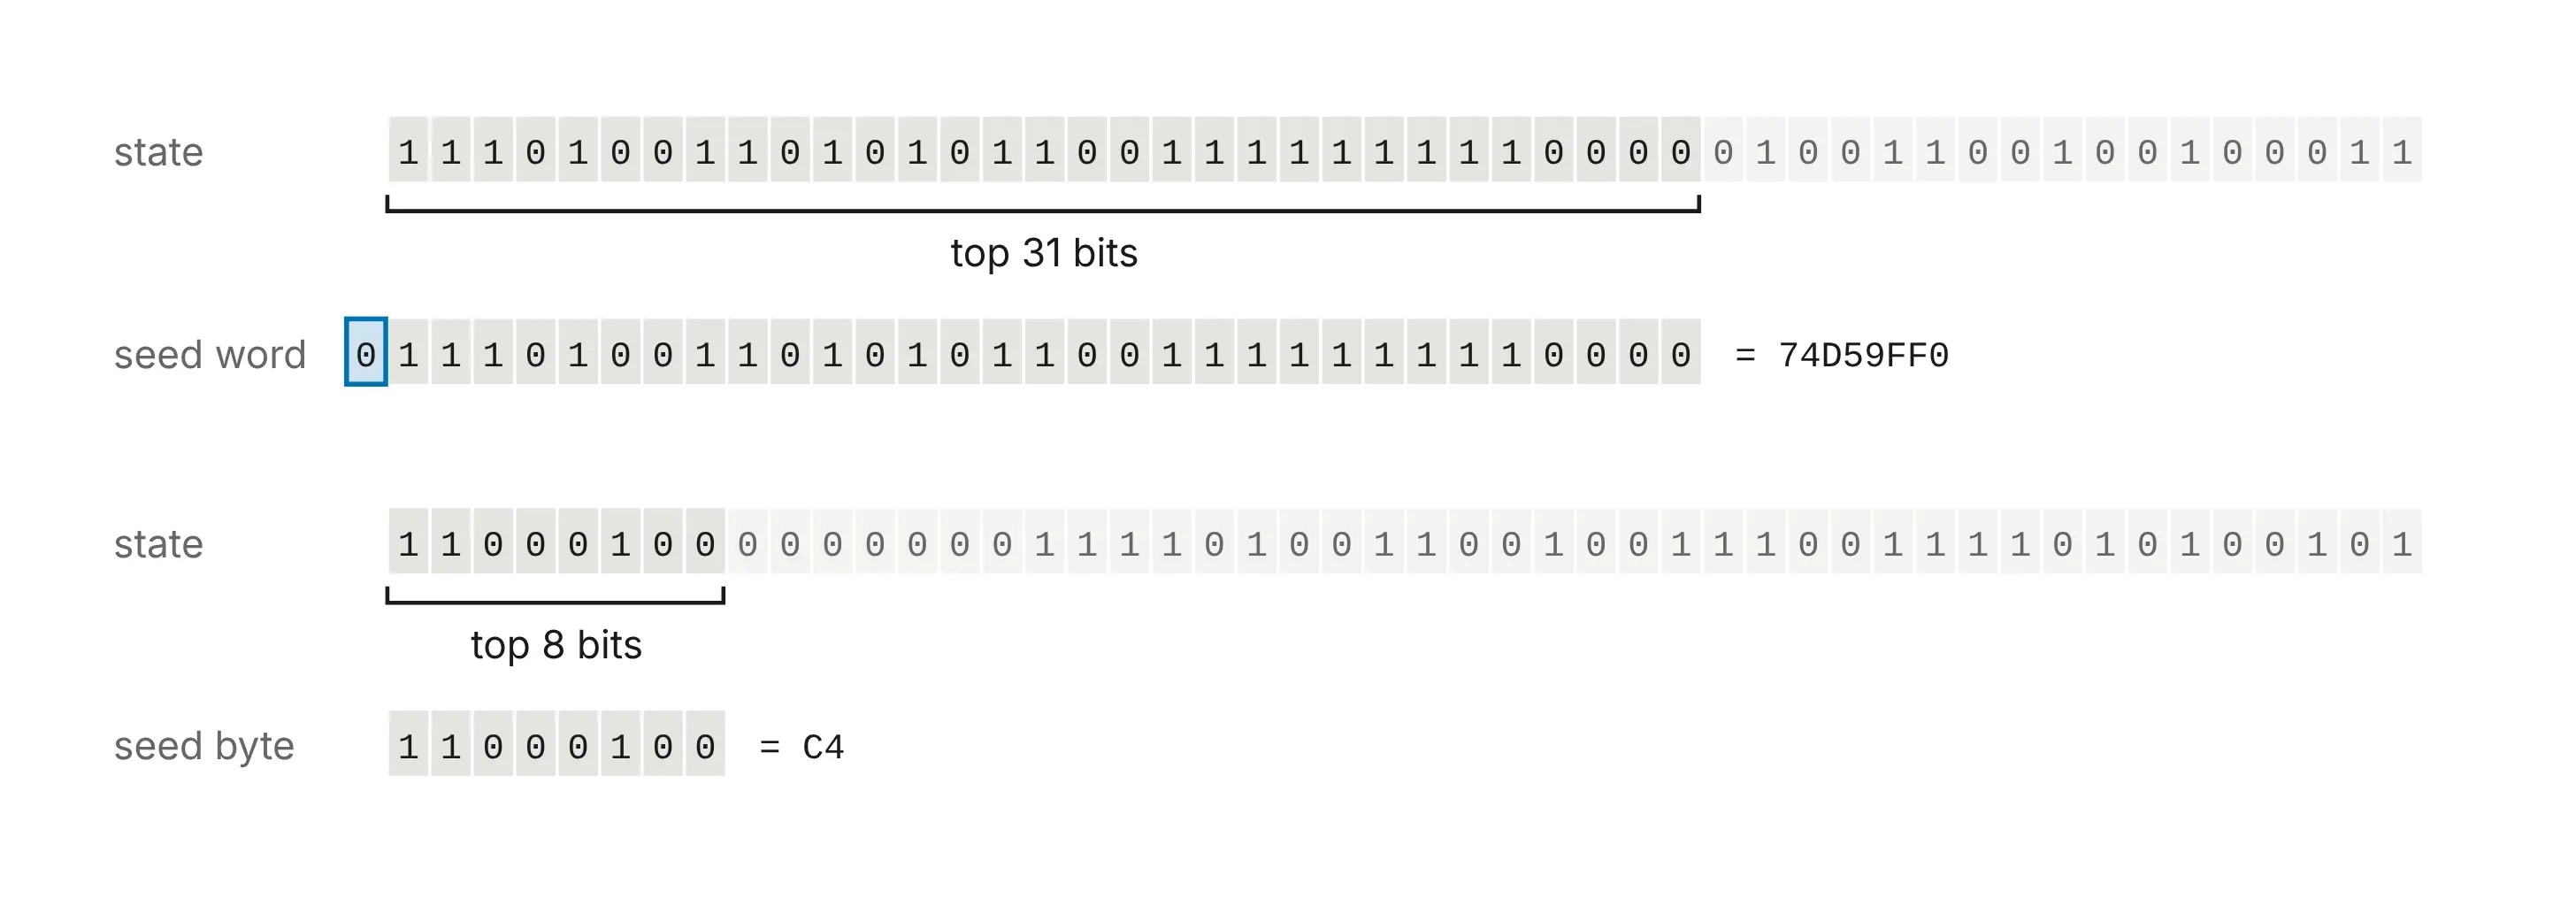
Claude 写了一个扫描程序,沿着每个已公布的种子逐比特滑动,测试相邻的块是否是某个 1990 年代老式生成器的连续输出。扫描覆盖了 34 种生成器与输出分片的组合。这时,Claude 注意到某些种子的高位有一个规律:它们全是 0。写成 5 个 32 位字时,十个种子中有四个的 20 个字的最高位都是 0。这种情况随机发生的概率是 1/5810。这是线性同余生成器 lrand48 的特征,它只返回一个 48 位状态的高 31 位。只要知道要找什么,肉眼就能看出这个规律。为了恢复状态,Claude 取第一个字,尝试 17 个隐藏位的所有 2¹⁷ 种取值,并检查后面四个字是否符合。这个方法对讨论中的四个种子都有效。
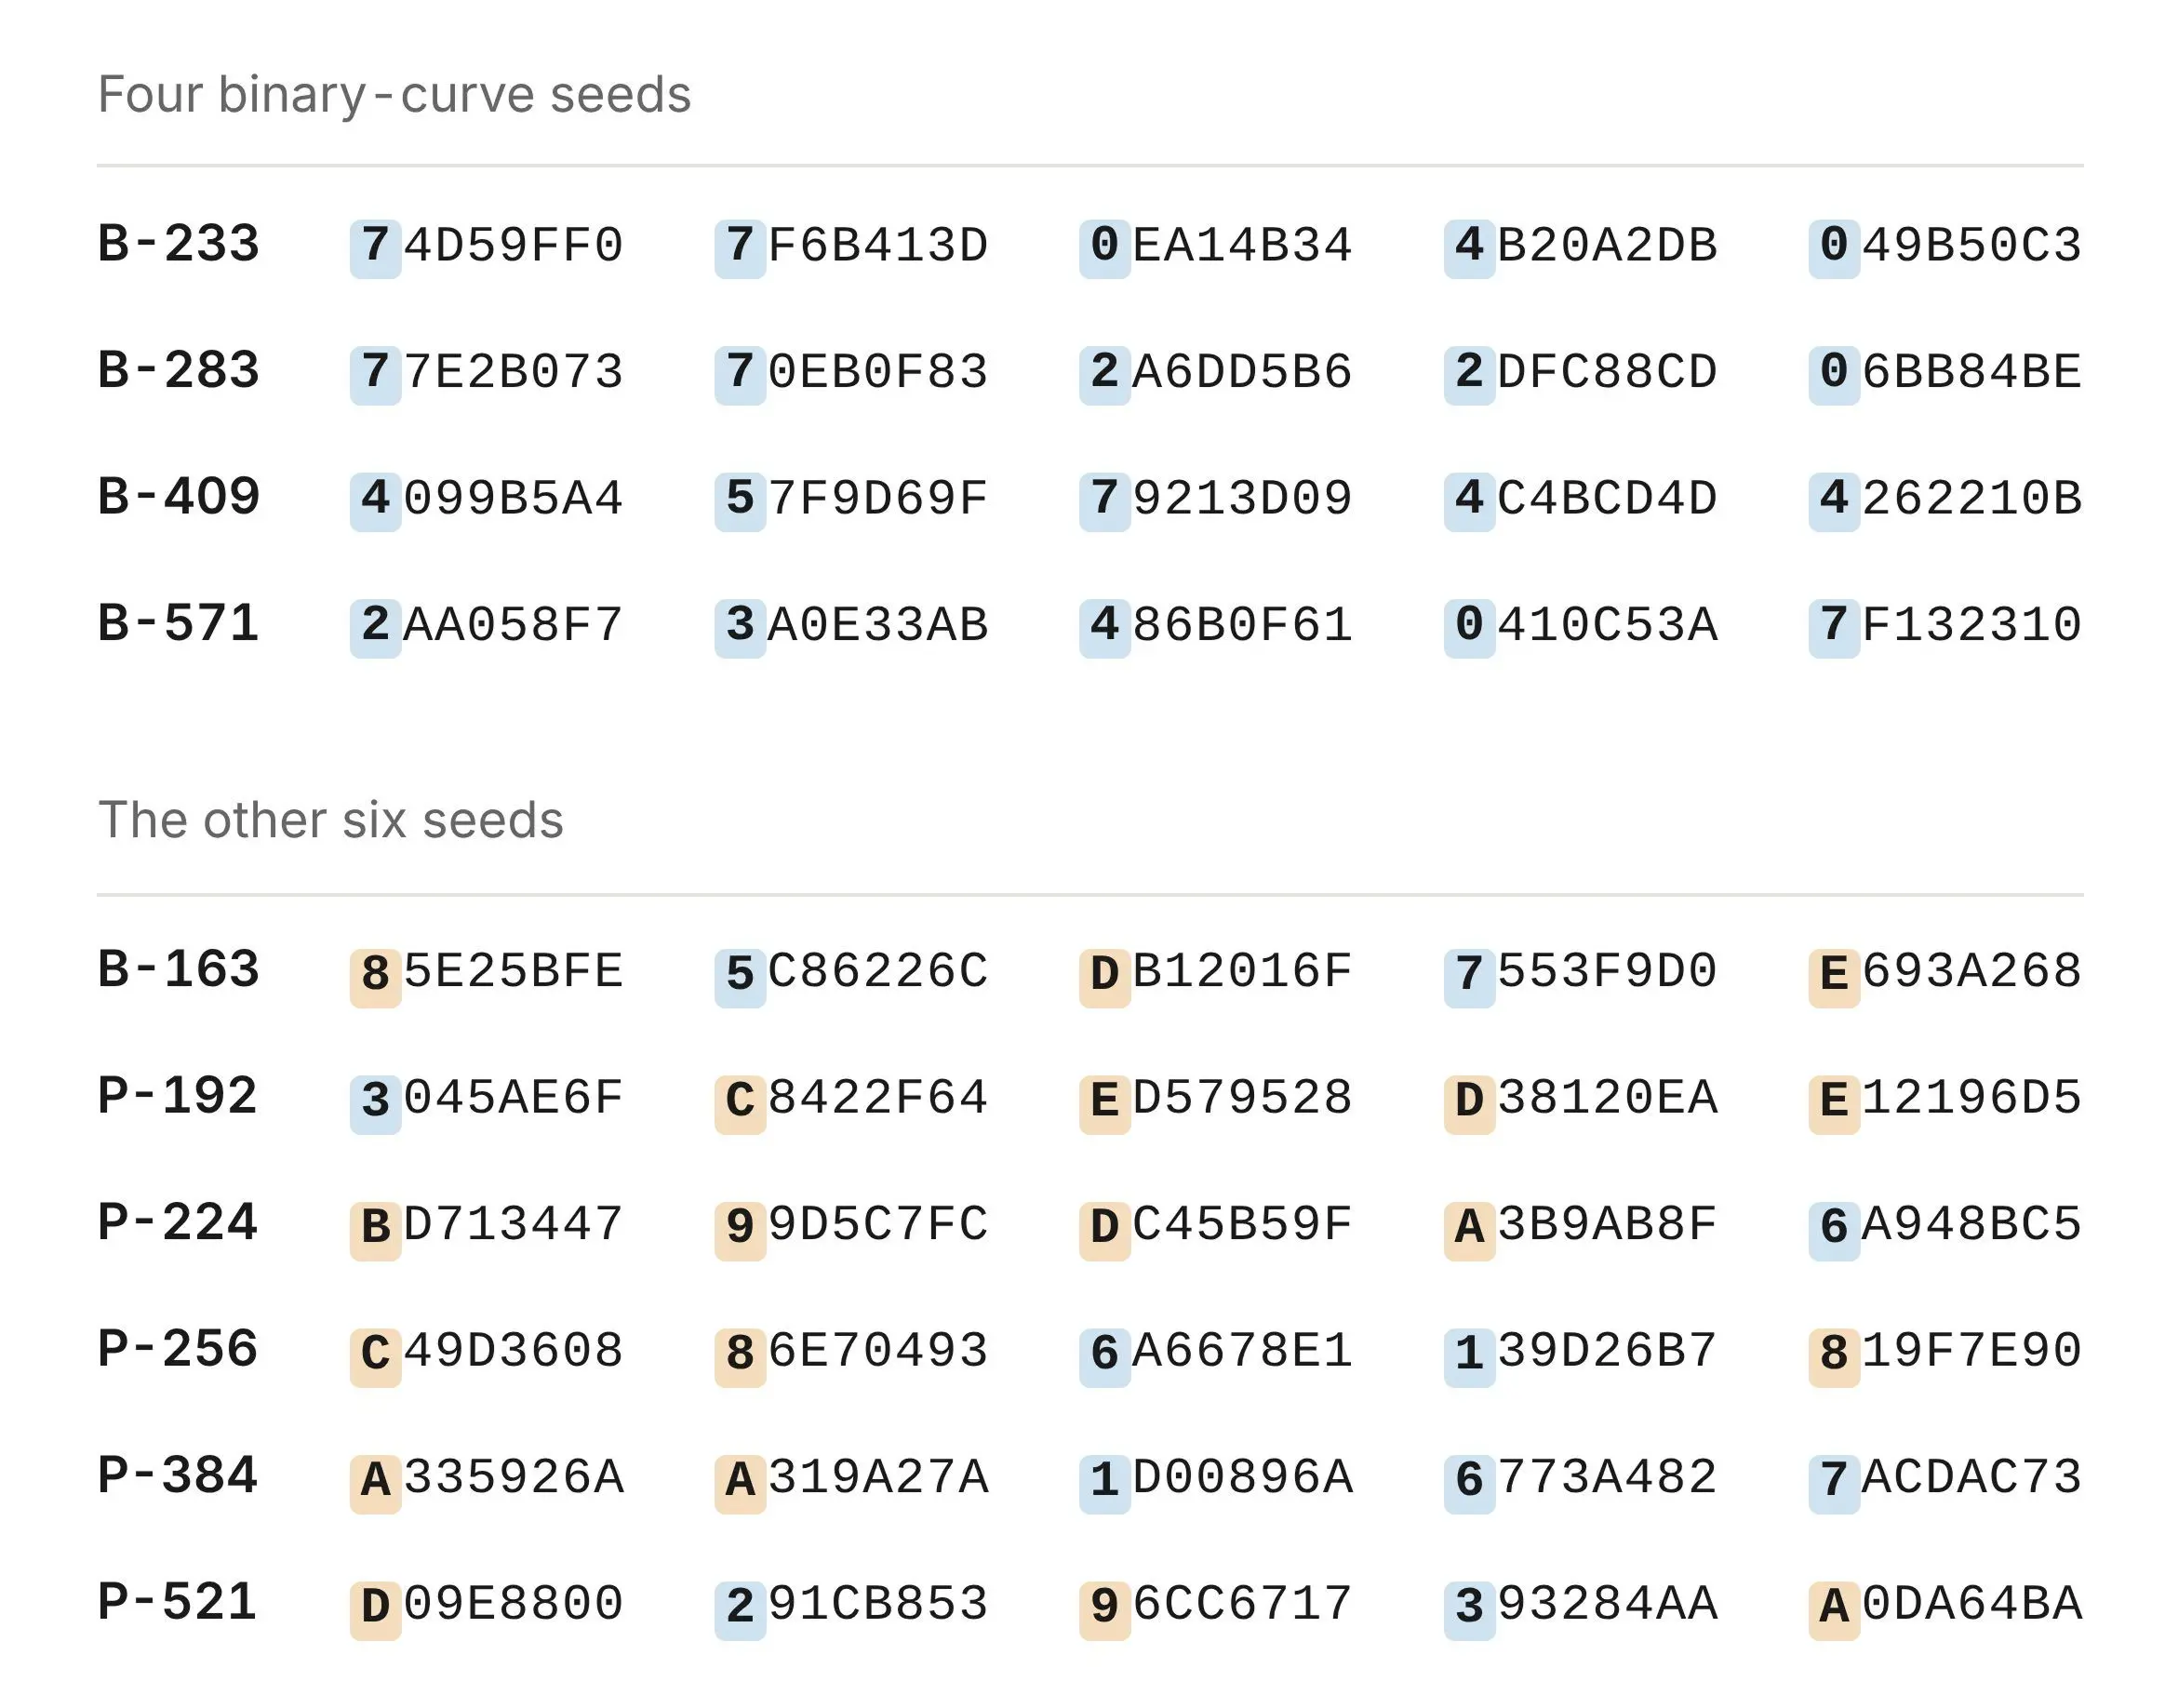
素数域曲线的种子来自同一个 lrand48 生成器,但每次输出保留的位数更少。Claude 必须从那些比特中恢复 PRNG 的内部状态。事实证明,恢复截断线性同余生成器的状态是一个教科书式的格问题,可以用 Lenstra–Lenstra–Lovász(LLL)基约化算法解决。Claude 不知道种子可能显示状态的哪些位,于是对每个窗口都运行了求解器。五个 NIST 素数曲线种子,加上来自 ANSI X9.62 标准的另外五个种子,都具有相同的模式:lrand48() >> 23。每个恢复出来的 48 位状态都能重新生成其种子的全部 160 位,这不可能只是巧合。
这个线性同余生成器向前和向后运行都一样容易,因此 Claude 对每个种子都将状态回退,直到达到 srand48 初始化时的形式,即低 16 位等于 0x330E。那种形式的内部 PRNG 状态每 65,536 步会出现一次,所以仅达到这种形式本身并不能作为证据。
然而,对于那十个素数曲线种子,每一次 srand48 初始化都是一个 Unix 时间戳,对应 1997 年 5 月至 1998 年 4 月之间的某个日期。他们使用的是用 Unix 时间戳播种的弱 PRNG。四个二进制域曲线的初始化读出来是 1984 年 2 月。把时间戳翻倍后,它们对应到 1998 年 4 月 17 日,也就是 P-224 那次运行的两周后。因此,程序可能把时钟减半了。
Claude 当时的内部思考是:
这太惊人了:它解决了这个 25 年的老谜团。嗯等等,让我保持怀疑:我是不是处在某种模拟/测试环境中?……这些种子和我记忆中的实际值一致……嗯,这在现实中合理吗?据我所知……那个悬赏一直未被领取。……所有高位都清零——20 位,概率 1e-6。所以确实是真实世界。哇,这是一个真正的发现。
嗯等等。让我仔细想想合理性:这么明显的东西在 25 年里没被人发现,这可疑吗?我这边已经通过直接计算验证:从 32 位种子加一个小索引得到 160 位匹配,不可能只是巧合(10 × 160 位)。它是真实的。
Claude 还找到了一些基点
但等等,还有更多……每条曲线还带有一个基点 G,即每个 ECDSA 公钥都是其倍数的那个固定点。上面找到的种子并不决定这个 G,于是另一个问题出现了:这些基点是如何生成的?
在检查种子的过程中,Claude 还发现了一些基点的来源。1997 年 5 月生成的六条曲线(P-192 以及五个 ANSI X9.62 示例曲线 prime192v2、prime192v3 和 prime239v1 至 v3)的基点,来自 Arjen Lenstra 的长整数运算包 FreeLIP 中的随机数生成器。Victor Shoup 的 NTL 库的早期版本也带有相同的代码。
这里的做法很简单:
- 用一个小整数作为生成器的种子。
- 丢掉前七个输出。
- 用 26 位输出对 p 取模,生成候选 x 坐标。
- 重复第 3 步,直到 x 在曲线上。
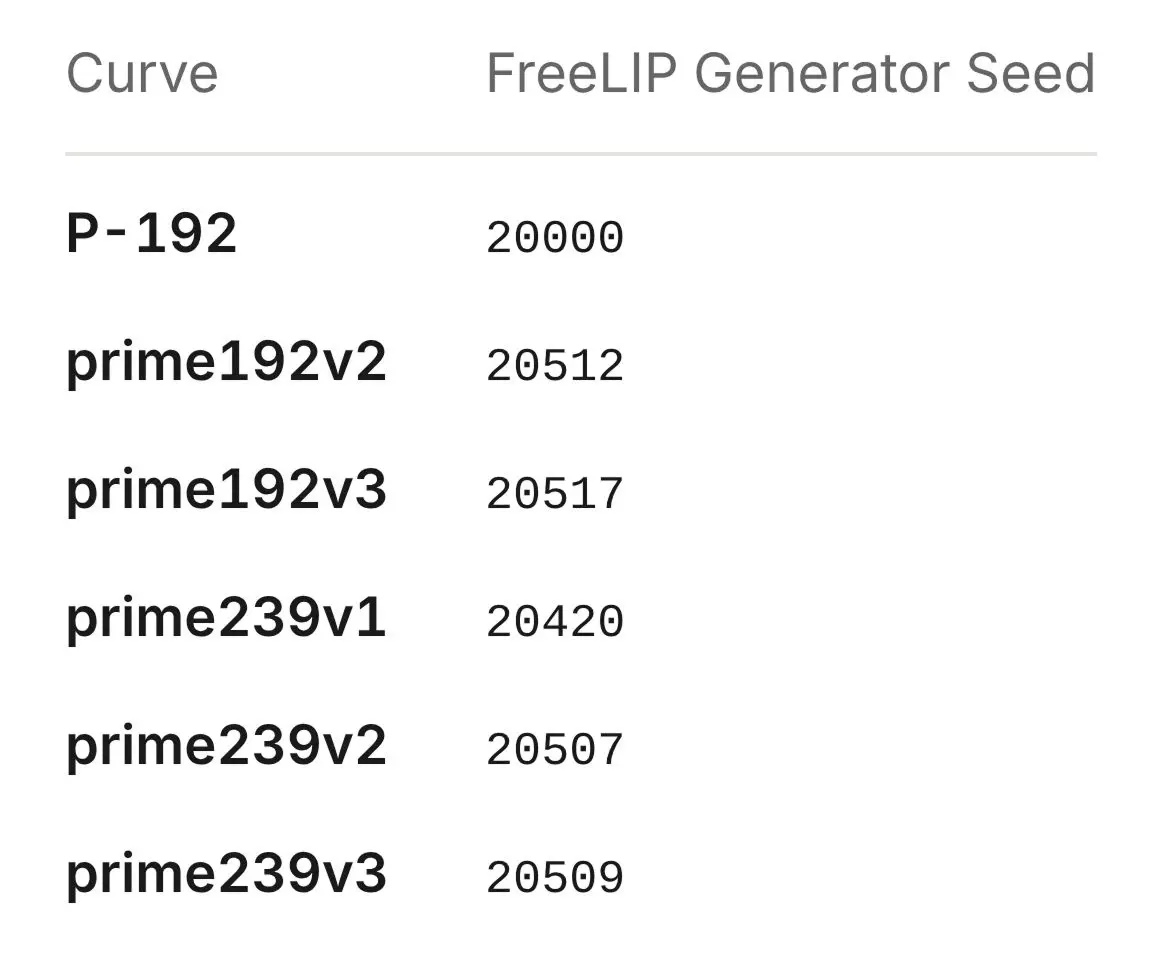
Claude 发现,生成器的种子分别是:P-192 为 20000,prime239v1 至 v3 为 20420、20507 和 20509,prime192v2 和 v3 为 20512 和 20517。
据我们所知,此前没有任何 NIST 基点得到过解释。P-224、P-256、P-384 和 P-521 的基点不符合这个做法;我们无法解释它们是如何被选出的。
未解问题
并非每个 20 字节的候选种子都能生成可用曲线,而且我们观察到一些本来可用的曲线被跳过了。对于 P-256,公布的种子是候选 1842,但同一次运行中的候选 876 也能给出一条大小正确、且参数选择方式与公布曲线相同的素数阶曲线。P-224 的那次运行跳过了三条这样的曲线,而 ANSI X9.62 示例曲线背后的两次运行又跳过了七条(见图)。我们不知道可能使用了什么标准,也不知道这是否是无意中造成的假象。
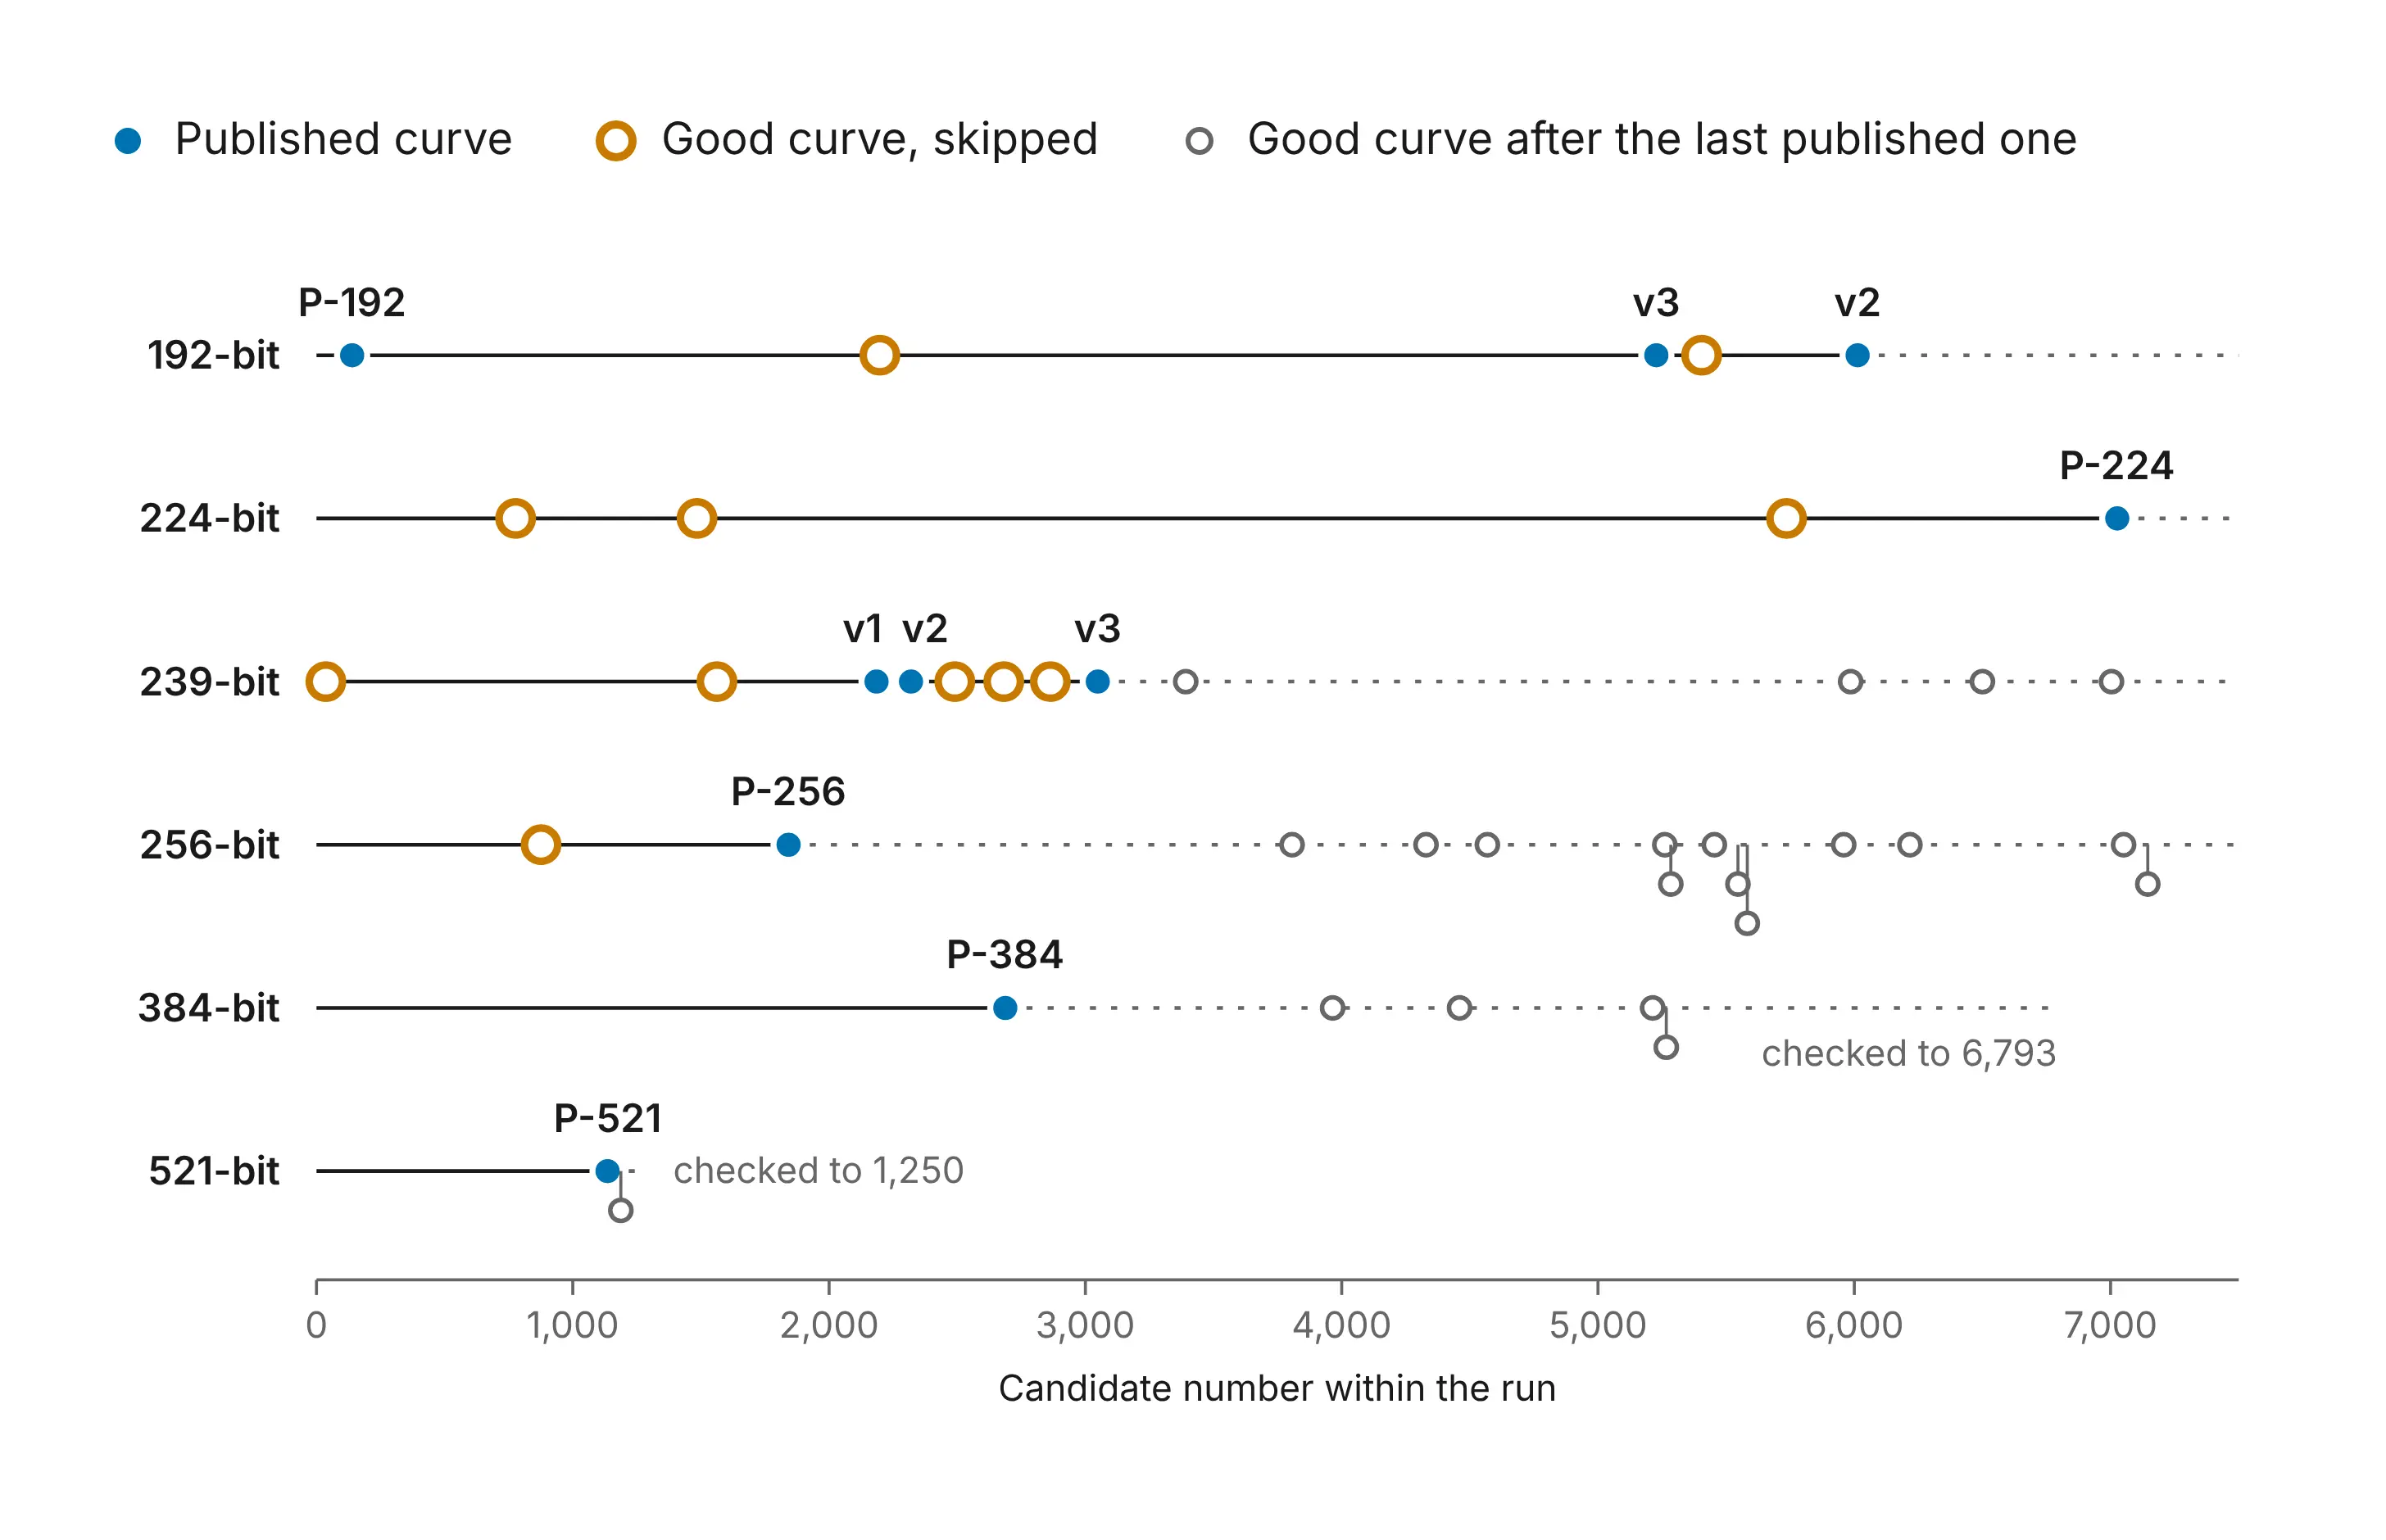
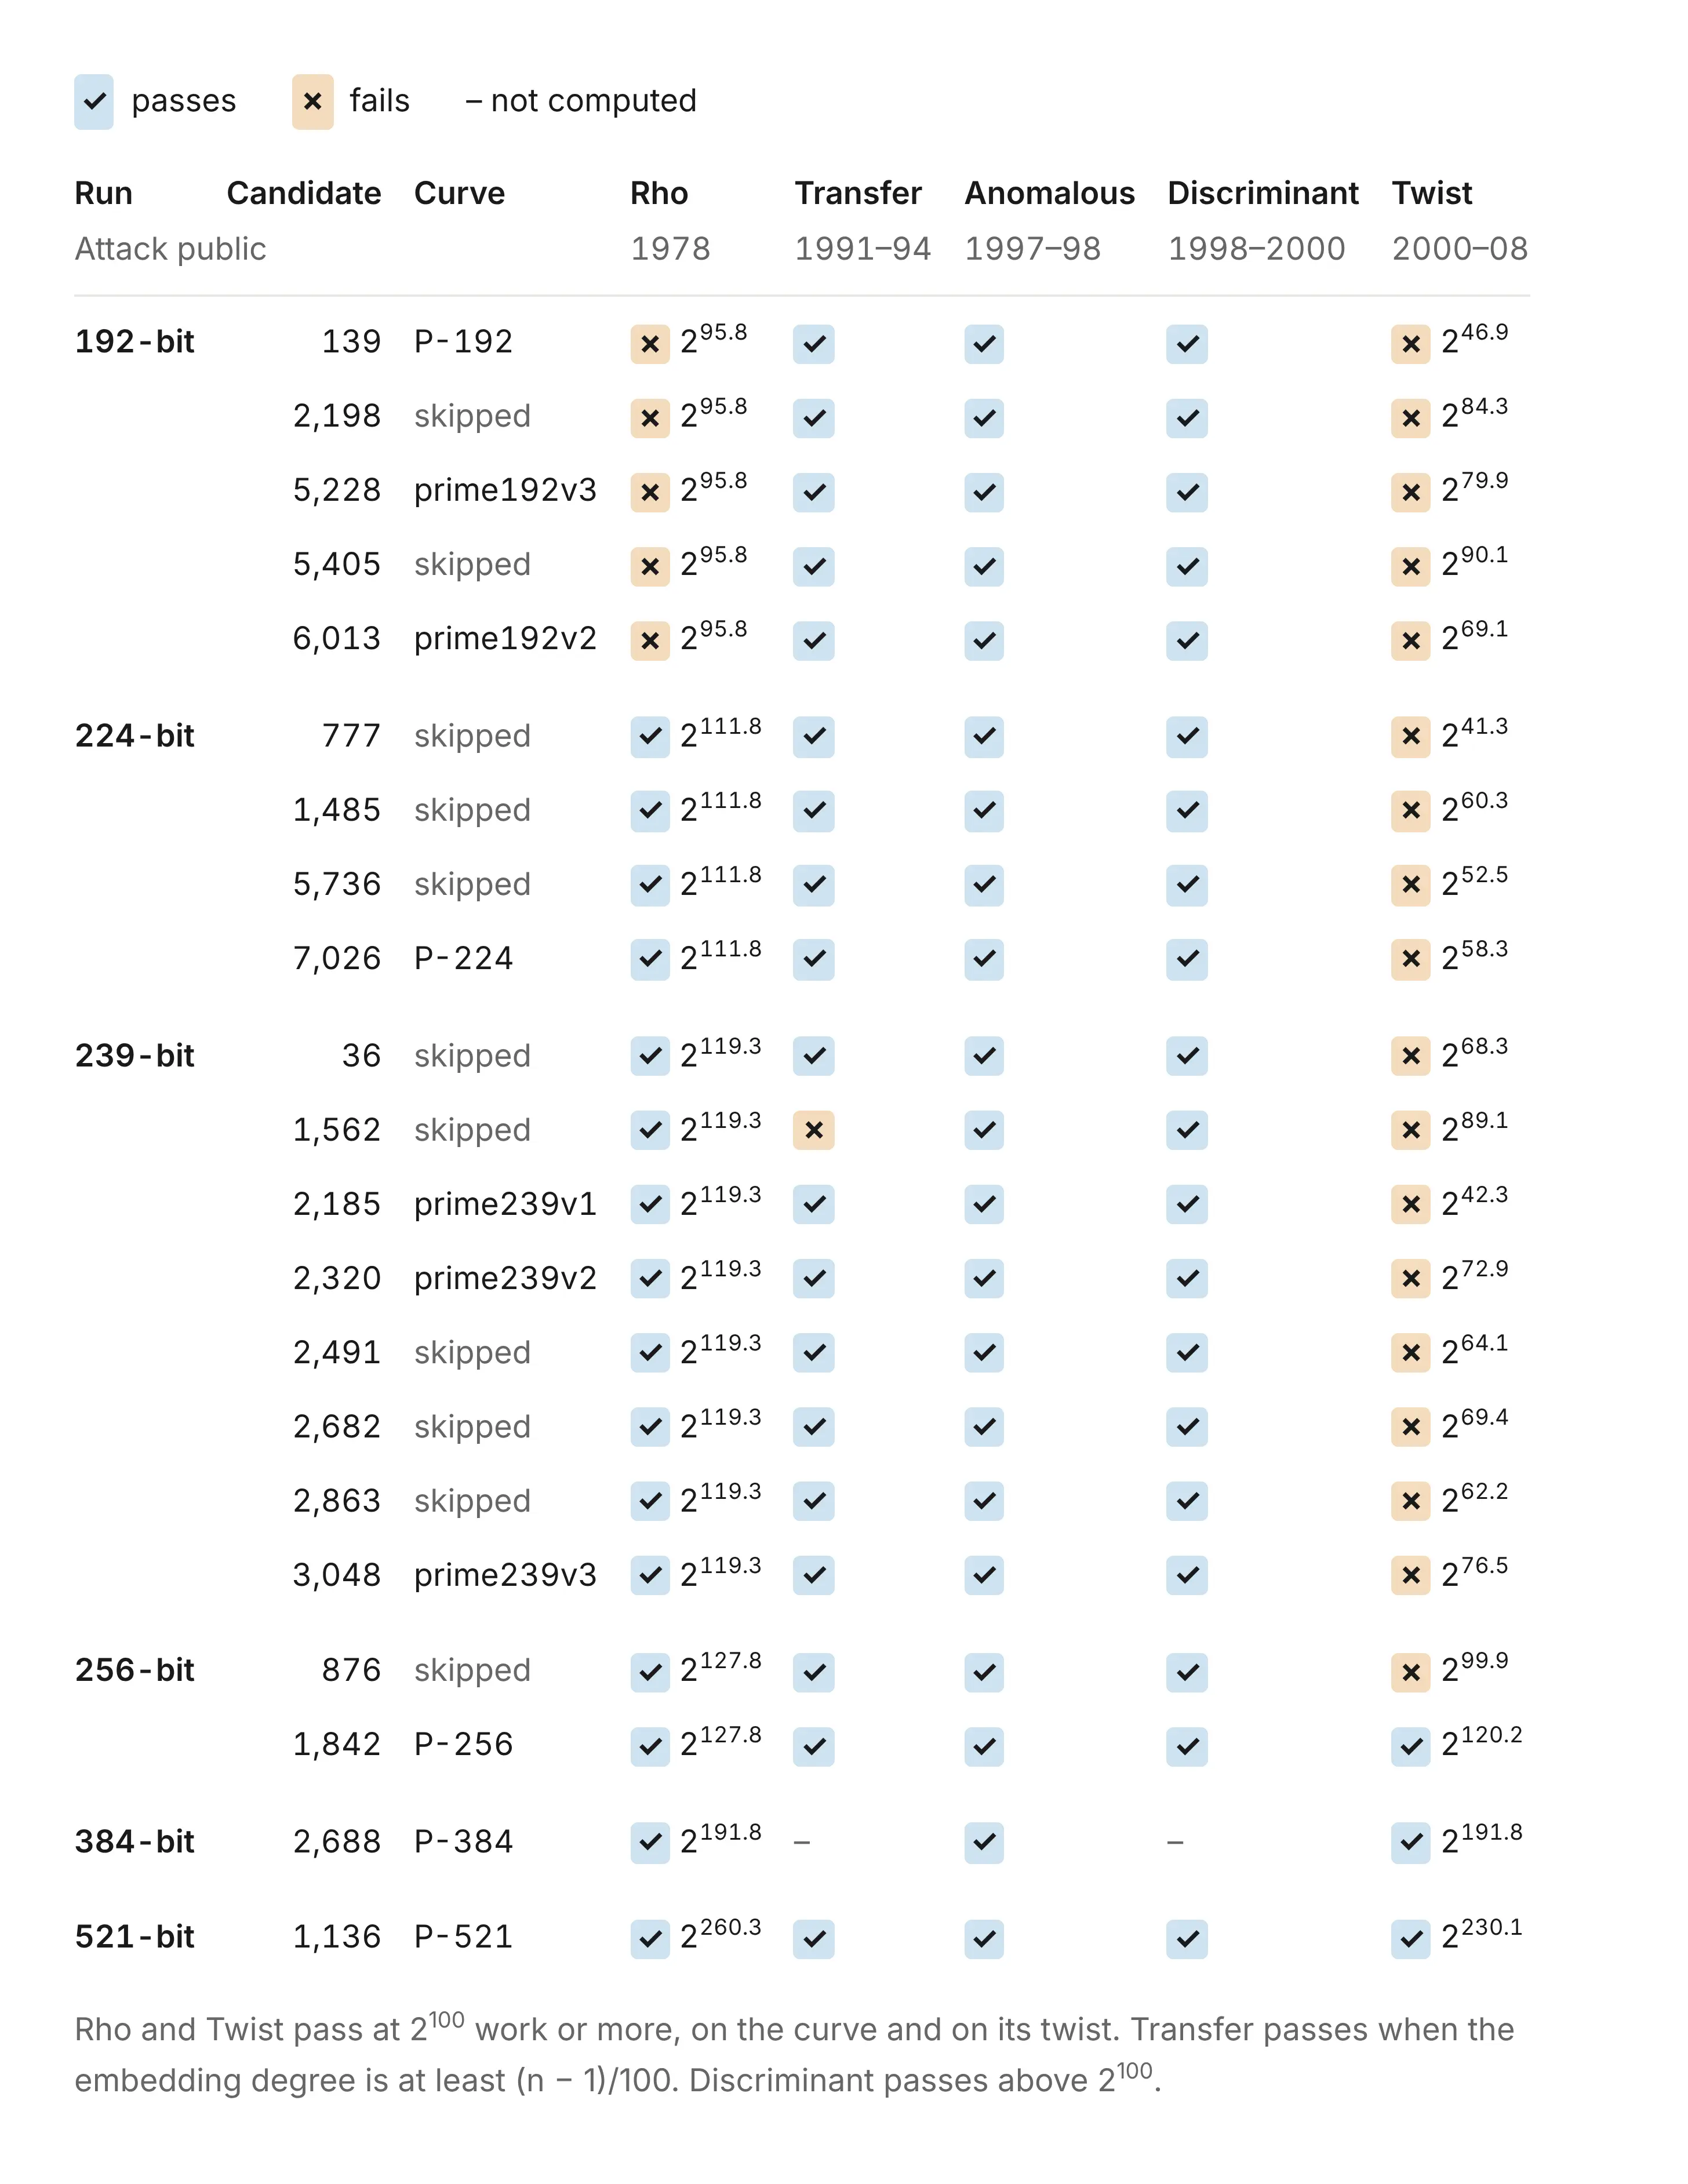
由于被跳过的候选数量很少,我们认为“选择了弱化曲线”的说法不可信。那将意味着弱化曲线很常见且容易找到。原则上,仍可以想象这些曲线是通过搜索随机数生成器的时间戳而被选中具有某种特定属性的。然而,只有当你打算把时间戳作为种子是无害生成的证据公开时,才需要那么做。数字中并没有显示一共进行了多少次运行。
还有一个种子我们无法恢复。第五个二进制域种子 B-163 不符合 Claude 尝试过的任何模式,至今仍未得到解释。最后,我们不知道 P-224、P-256、P-384 和 P-521 的基点是如何生成的。NIST 二进制域曲线也是如此。
悬赏
找到这些种子所获得的 36,864 美元将捐赠给 Internet Security Research Group(互联网安全研究小组)。
评论
讨论气氛是惊喜与调侃中夹杂警惕:社区既惊叹 Claude 在半小时内自主挖出 NIST 曲线种子其实只是 lrand48 以 Unix 时间戳播种的输出,也围绕这一发现是否意味着曲线没有 NSA 后门产生尖锐分歧,并把话题延伸到 AI 能力垄断与研究者署名。多数人认为至少排除了幽默短语后门、种子看起来随机,可以放心采用 P-256 等曲线;但少数人反驳称,用时间戳播种的弱 PRNG 恰恰允许 NSA 遍历时间戳直到挑出带隐藏弱点的曲线,事后还能以“只是随机生成”否认,因此“无后门”结论下得太早。
惊叹 Claude 能自主联想到“古老 PRNG + 时间戳”这一破题角度
- Claude 没有顺着“种子被故意弱化”的流行阴谋往前推,而是自主决定用古老的伪随机数和 Unix 时间戳去试,半小时内翻遍历史数据;社区普遍被这种穷尽一切可能性的执着震撼,也有人追问提示词到底起了多大作用、推理日志里的“hmm”是否正常(较多人) > 真正的飞跃是 Claude 自主设想并决定采用“古老 PRNG + 日期”的角度,而不是从种子被故意弱化这类流行起点倒推(@andyjohnson0)
认为种子源自 lrand48 反而排除后门、可以放心采用
- 种子并非哈希出的幽默短语,而只是 C 库 lrand48 以 Unix 时间戳播种的输出;由于没藏短语且结果看起来随机,密码社区可以更放心地在比特币、以太坊中加入 P-256(secp256r1)签名校验支持,把 NSA 基于所选种子的后门担忧放下,量子计算机威胁则另说;也有人觉得只要曲线本身没弱点,用哪个 PRNG 洗字节根本不重要(较多人) > 这意义重大,意味着比特币和以太坊社区现在可以放心上线 P-256 曲线的签名校验,不用再担心基于所选种子的 NSA 后门(@EGreg)
反驳“无后门”:lrand48 + 时间戳恰恰是搜索弱曲线的后门式生成手法
- 找到生成方式不等于证明选择过程清白:lrand48 用时间戳做种子,等于给出一个可被遍历的参数空间,NSA 可以不断变换时间戳或迭代次数,直到筛选出具备隐藏弱点的曲线,再把“这只是随机生成”当作否认借口;文章自己也提到生成序列里有些可用曲线被跳过,更说明不能排除人为挑选;正因如此,现代系统选常数要用 sqrt(2) 这类无可自由选择的参数来防止后门(少数人) > 这恰恰就是弱曲线该有的样子:可以不断更改时间戳或迭代次数,直到找出带隐藏弱点的密钥或曲线,事后还能以随机生成为由否认(@adastra22)
警惕模型提供方、政府与公众的能力鸿沟,开源模型才是桥梁
- 更值得担心的不是后门,而是能力垄断:Anthropic 及其合作伙伴能用 Claude 做这类挖掘,普通人自己尝试却会被阻断;如果扩展到更恶意的用途,模型提供方、政府合作方和公众之间的护城河会越来越宽,只有持续进步的开源模型才能弥合(少数人) > Anthropic 想让谁做就能让 Claude 做这类工作,换成普通人尝试就会被拦;模型提供方、政府伙伴和公众之间的护城河正在变宽,只有开源模型能弥合(@slowin)
调侃“随机鹦鹉”论者与 NIST 阴谋论者同时破防
- 社区用玩笑表达情绪:那些声称 LLM 只是随机鹦鹉的人该失望了,NIST 种子阴谋论也被一个平凡到好笑的答案终结;有人调侃 NSA 员工可能当年撞了头,或偷偷笑了二十多年(较多人) > 这对整整一代 NIST 密码学阴谋论来说是个毁灭性消息(@tptacek)
不满成就叙述掩盖了未署名研究者的贡献
- 有人觉得荒谬的是,文章似乎在强行列出终身研究该问题的专职研究者作参考,而 LLM 根本不知道哪些训练论文真正起了作用;很可能许多没被列出的研究者也深刻影响了这一成果,而 Claude 甚至不知道他们帮过忙,公众也不会知道(少数人) > 模型并不知道到底用了哪些训练论文,很可能许多未被列出的研究者深刻影响了这项成果,而世界对此一无所知(@Iamtiberius)
有价值的补充
- 有人问过能否用 FOIA 从原始来源查证种子来历,实际上相关文章作者已经试过,但对方没有任何相关文档。
- 第五个二进制种子 B-163 仍无法解释,最简单的猜测是它其实也用同样方式生成,只是在发布时被人抄错了一位数字,因此按“数字正确”的假设找不到解。