StarSkirmish Bench 是一个让大语言模型(LLM)为星际争霸:母巢之战(StarCraft: Brood War)编写机器人的基准,评估每个模型在 1 小时实际时间内能写出多强的机器人。v0.2 在 StarSkirmish Bench v0.1 基础上,加入了 OpenAI、Anthropic、谷歌(Google)和元(Meta)的旗舰模型,各自在实验室的第一方命令行界面(CLI)环境中运行;每个模型用 C++ 编写神族(Protoss)机器人,与其他模型及人类编写的成熟机器人、演示机器人对战,得分是 5 次运行的平均胜率(0–100)。
正文
太长不看
- StarSkirmish 是一个基准测试,让 LLM 为《星际争霸:母巢之战》编写机器人。
- 每个 LLM 有 1 小时用 C++ 编写一个 Protoss 机器人,之后这个机器人会与其他 LLM 的机器人以及成熟的人类编写机器人对战并接受评估。
- StarSkirmish 考察长程推理和智能体编程能力,因为 LLM 必须把练习赛中学到的经验融入进去,不断改进自己的《星际争霸》机器人。
StarSkirmish Bench 评估的是:在 1 小时真实时间内,每个 LLM 能写出多强的《星际争霸》机器人。v0.2 在 StarSkirmish Bench v0.1 的基础上更新,引入来自 OpenAI、Anthropic、Google 和 Meta 的旗舰模型,每个模型都在各自实验室的第一方 CLI 框架中运行。
一个 LLM 的分数反映的是它对一整套竞技级人类编写机器人和演示机器人的胜率。
StarSkirmish Bench v0.2
每次运行限时 1 小时,在模型各自的第一方 CLI 框架中进行。分数是每个模型的 5 次运行对一整套竞技级人类编写机器人的平均胜率(0–100)。
- GPT-6 Astra:57
- GPT-6.1 Sol:46
- Gemini 4 Argon:39
- Claude Opus 5.5:39
- Claude Fable 5.1:37
- Claude Sonnet 5.5:26
- Muse Wonder Full:21
- Claude Haiku 5.5:21
- GPT-6 Luna:13
Gemini 4 Argon 使用 “high”,也就是它可用的最高推理强度;其他所有模型都使用 “max”。
GPT-6 Astra 是 StarSkirmish Bench v0.2 中得分最高的 LLM,明显领先排在第二的 GPT-6.1 Sol。Gemini 4 Argon、Claude Opus 5.5 和 Claude Fable 5.1 实际上并列在其后,得分都在 37 到 39 之间。
StarSkirmish Bench 与成本
StarSkirmish Bench 分数对比一次 1 小时运行的平均 API 成本。成本采用对数刻度。
Muse Wonder Full 的定价基于 Muse Wonder 的 API 定价。
GPT-6.1 Sol 的性价比独一档:它是唯一落在最具吸引力象限的 LLM,以略高于 GPT-6 Astra 单次运行成本十分之一的开销,取得了第二名的成绩。
没有饱和的迹象
最强的人类编写机器人仍然遥遥领先于所有模型。面对 Stardust、PurpleWave 和 BananaBrain,表现最好的模型 GPT-6 Astra 只赢下 7% 的对局。
对阵顶尖人类编写机器人的胜率
每个模型的 5 个机器人对顶尖人类编写机器人 Stardust、PurpleWave 和 BananaBrain 的平均胜率。
- GPT-6 Astra:7
- GPT-6.1 Sol:4
- Gemini 4 Argon:2
- Claude Opus 5.5:2
- Claude Fable 5.1:2
- Claude Sonnet 5.5:<1
- Muse Wonder Full:<1
- Claude Haiku 5.5:<1
- GPT-6 Luna:0
1 小时推理限制是一个因素,而且这些比赛是在三张 2 人对战地图上进行的。真实的人类编写机器人锦标赛条件要困难得多。
新 AI 模型亮点
谷歌和 Meta 的新旗舰取代了 v0.1 的 Gemini 3.8 Flash 和 Muse Spark 1.3:Gemini 4 Argon 排名第 3,Muse Wonder Full 排名第 7。GPT-6 Astra 和 Claude Opus 5.5 已在 v0.1 中介绍过。
- Gemini 4 Argon 独特地偏好用“一次性写完”的方式编写机器人。在它的五次运行中,构建次数和代码版本数量是所有被追踪运行中最少的。
- 它 41% 的练习赛是面对高阶对手,比例仅次于 GPT-6 Astra;但它的机器人在面对这些 tier 时只赢下 7% 的对局,而 Astra 是 28%。
常用策略:Timing Attack
一波流推进(One Big Push):把龙骑兵(Dragoon)和狂热者(Zealot)留在本方基地,依托炮台防守,准备一波大推进。
常用单位
Reaver:它第二好的机器人在超过 70% 的对局中建造 Reaver。
Argon 的一波推进在 192 人口时遭遇同等规模的部队,最终靠 Psionic Storms 赢下交换。
- 它每局平均升级 2.5 次,是全场最多的。
- 和 v0.1 中的 Muse Spark 1.3 一样,它几乎只和最弱的对手练习。只有 1% 的练习赛是面对 B 级或更强的对手。
常用策略:Macro
人数优势优先(Outnumber First):快速扩张到 5 到 9 个 Gateway,只有在部队数量超过所见敌军时才发起进攻。
常用单位
Observer:每局 3 个,是所有模型中最多的,达到全场平均的 1.6 倍。
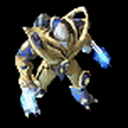
Zealot:每局 22 个,和 v0.1 一样是一支以 Zealot 为主的部队。
Muse 的 Zealot 海冲垮了一支 Dragoon 部队。
AI 模型行为
每次运行的智能体追踪记录了它如何花掉这一小时。对一个模型分数最强的预测因素是:它在这一小时里针对名单上 7 个最强机器人进行了多少练习赛。
胜率与对阵强敌练习的关系
StarSkirmish Bench 分数对比一个模型的中位运行在这一小时中对名单上 7 个最强机器人进行的练习赛数量。虚线是 9 个模型的线性拟合。
GPT-6 Astra、GPT-6.1 Sol 和 Gemini 4 Argon 在这一小时早期就开始和这些机器人对战,当时它们自己的机器人还打不过对方。Muse Wonder Full、Claude Haiku 5.5 和 GPT-6 Luna 很少或从不这样做。Claude Fable 5.1 是异常值:它得了 37 分,但练习时几乎全是在和更弱的机器人打。
各次运行的差异
每个模型 5 次运行的胜率。每个点是一次运行最终生成的机器人;线覆盖最低到最高运行,条形标记它们的均值(即模型的 Bench 分数),带状区域为一个标准差(σ)。
- GPT-6 Astra:57,σ 3.4
- GPT-6.1 Sol:46,σ 6.0
- Gemini 4 Argon:39,σ 7.0
- Claude Opus 5.5:39,σ 3.2
- Claude Fable 5.1:37,σ 2.9
- Claude Sonnet 5.5:26,σ 8.4
- Muse Wonder Full:21,σ 3.0
- Claude Haiku 5.5:21,σ 6.1
- GPT-6 Luna:13,σ 5.6
同一模型的不同运行之间结果也有差异。Gemini 4 Argon 的差异远大于其他实验室的旗舰模型:它的最好和最差运行相差 18 分,而 GPT-6 Astra 是 9 分,Claude Opus 5.5 是 8 分。
实现细节
目标
每个 LLM 用 C++ 编写一个 Protoss 机器人,基于 BWAPI 4.4.0,在 OpenBW 上进行游戏。对局是 Protoss 对 Protoss,在三张天梯地图上进行:Heartbreak Ridge、Benzene 和 Destination。当一方的所有建筑都被摧毁时,对局结束。达到 60 分钟上限(86,400 帧)的对局按 BASIL 天梯的方式判定:击杀(kills)加拆除(razings)分数更高者获胜。
LLM 从一个只会采矿的骨架机器人开始,同时拥有三个演示机器人的源代码,以及两个标准机器人库:FAP(战斗模拟器)和 BWEM(地图分析器)。一小时结束时,机器人文件夹里有什么,什么就是最终机器人,因此它必须让机器人保持可编译状态。
LLM 拥有编译机器人、进行练习赛,以及读取每局对局的总结、转录记录和自己机器人日志的工具。练习对手按 tier 分组:D(三个演示机器人)、C 和 B(各三个中等排名的人类编写机器人)、A(BananaBrain、Locutus)和 S(Stardust、PurpleWave)。
比赛设置
- 45 个 LLM 机器人
- 13 个对手
- 10,530 场对局
- 每对 18 场
每个模型的 5 个最终机器人会与 13 个名单机器人(10 个竞技级人类编写机器人和 3 个演示机器人)交手,在每张地图上用全新随机种子各打 6 次。与 v0.1 不同,LLM 机器人之间不会互相交手。
运行框架与推理
StarSkirmish Bench v0.1 让所有模型在同一个框架中以 “high” 推理强度运行。v0.2 则让每个模型在各自实验室的第一方 CLI 框架中,以它们所提供的最高推理强度运行。
运行框架
v0.1 使用一个中立的第三方框架运行所有模型;v0.2 则让每个实验室的模型在各自的第一方 CLI 框架中运行。两个版本都给每个模型 1 小时。
v0.2 使用的第一方 CLI 框架如下:
- Claude Code:Claude Opus 5.5、Fable 5.1、Sonnet 5.5、Haiku 5.5
- Codex:GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna
- Antigravity CLI:Gemini 4 Argon
- Muse Code:Muse Wonder Full
CLI 版本:Claude Code 2.1.296、Codex 0.162.1、Antigravity CLI 1.3.5、Muse Code 1.4.7。
推理强度
v0.1 让所有模型以 “high” 推理强度运行;v0.2 则以 “max” 运行。
v0.1
Low Medium High XHigh Max
High
v0.2
Low Medium High XHigh Max
Max
Gemini 4 Argon 使用 “high”,也就是它所支持的最高强度。
每个 v0.2 框架会在约 250k token 时压缩模型的上下文。当对话接近这一节点,CLI 会将其压缩,模型继续运行。例如 OpenAI 的 Codex CLI 会给 GPT 模型默认的 272k token 窗口,并在填充到 90% 时触发压缩。
这些 CLI 的网页搜索和网页抓取工具都被关闭,智能体没有其他互联网访问。CLI 在计时开始前就已安装,一小时从智能体启动时开始计算。没有提交工具:时间一到,框架就直接收集机器人。
计分
v0.2 用简单的胜率取代了 v0.1 的 Elo 等级分。一个机器人的分数是它在 234 场锦标赛对局中的胜率;一个模型的 StarSkirmish Bench 分数是其 5 个机器人分数的平均值,范围从 0(全输)到 100(全赢)。
因为每个机器人面对的都是同一套固定名单,它的对局不依赖于场上其他 LLM 机器人。它们全部并行运行,而且给新模型的机器人计分时不需要重跑其他任何人的对局。固定名单也让标准随时间保持不变,因此不同代际模型的分数比在单一场内拟合出的 Elo 等级分更可直接比较。
基准测试相关性
StarSkirmish 不再与最广为报道的评测同步变化。它和 Artificial Analysis Intelligence Index 几乎不同步(ρ 0.26);在这里排名第一的 GPT-6 Astra 在该指数的这 9 个模型中仅并列第 4。它也和 Terminal-Bench 4.0 渐行渐远,而在 v0.1 时它还与其高度同步。Claude Sonnet 5.5 和 Muse Wonder Full 在 Terminal-Bench 4.0 上都接近榜首,但在这里都接近垫底。
基准相关性
每个模型的 StarSkirmish Bench 分数对比它的 Vals IOI 和 WeirdML v3 分数,并给出它们之间的 Spearman ρ。虚线是最佳直线拟合。
Vals IOI:ρ 0.95
WeirdML v3:ρ 1.00,n = 7
WeirdML v3 给 9 个模型中的 7 个打了分:截至撰写时,Gemini 4 Argon 和 Muse Wonder Full 尚未被纳入。
StarSkirmish 仍然与 Vals IOI(用 C++ 解答的奥林匹克编程题)以及 WeirdML(一项针对非常规机器学习编程任务的独立基准)保持同步。一种解读是,被最密集基准化的评测已经成为模型调优的目标,而那些较少被针对的、考察长程高难度编程任务的测试仍然会同步变化。
评论
讨论基调是惊叹与怀疑交织:许多人被 Astra 能在限时内写出胜率超过五成的机器人震惊,但主轴分歧在于这个基准究竟衡量了什么——是模型真正的泛化或推理能力,还是训练数据里的现成代码、评测脚手架和限时压力共同制造的表象。少数人用跨基准排名一致、真实项目反例和框架差异来为基准辩护或质疑其可迁移性。
质疑模型只是调用预训练代码或针对已知对手,而非真正泛化
- 多人怀疑模型受益于训练数据里已有的机器人代码和公开解法,因此“写机器人”可能变成在已有方案上改;也有人追问模型是否被允许针对它要对战的特定机器人来调优,以及为何面对强机器人时胜率会掉到个位数。(较多人) > 我猜大量机器人代码本来就在训练数据里,所以这更像是在看模型能多好地改进已有公开方案。(@donutdonot)
认为基准混淆了多种能力,不清楚它到底在测什么
- 关键质疑是:限时写机器人同时考验代码生成速度、逻辑分析、对游戏平台和 C 语言的理解,以及战术选择;因此最终胜率很难被单独归因,评论者甚至说“我只是不知道它在测什么”。(较多人) > 我不确定自己是否喜欢这个基准,主要是我不确定它到底在评估什么:代码生成速度、逻辑分析、对游戏平台和 C 语言的理解、战术策略等因素都混在一起,我只是不知道它在测什么。(@iugtmkbdfil834)
认为跨任务排名一致,说明它捕捉到了通用推理能力
- 与质疑相反,有人指出这个星际基准的模型排名顺序,和另一个以 KataGo 为 Elo 锚点的 9x9 围棋基准完全一致;尽管表面任务不同,这种一致性暗示基准可能反映了某种通用规划或推理能力,而非纯粹记忆代码。(少数人) > 我朋友用 KataGo 做 Elo 锚点的 9x9 围棋基准,其模型排名与这个星际基准完全一致,尽管两者表面任务不同。(@GodelNumbering)
认为基准排名未必迁移到真实编码任务
- 有开发者用自身经历反驳榜单:在 ModernUO 服务器里写机器人时,Opus 5.5 表现远好于 GPT-6.1 Sol 和 GPT-6 Astra,后两者停滞一周后被 Opus 5.5 一夜间重建并继续推进,这与基准顺序相反。(少数人) > 我在搭建 ModernUO 服务器机器人时发现,Opus 5.5 远胜于 GPT-6.1 Sol 和 GPT-6 Astra:后两者一周几无进展,而 Opus 5.5 一晚上就重建并持续推进。(@t1amat)
认为基准应扩展到直接操作游戏、跨人类比较或更多游戏
- 不少人对《星际争霸 2》《红色警戒》《城市:天际线》以及第一人称射击游戏的机器人感兴趣,也有人追问为什么不让智能体直接操作游戏,而是写机器人代码;还有人想知道最强人类对阵这些大模型机器人会怎样。(较多人) > 如果让智能体直接玩,而不是写机器人,会怎样?(@brap)
肯定限时设定,但认为应补充反向指标
- 有评论赞同这次限时,因为很多基准不限时;但提出更该看反向问题:每个模型需要多久才能对不同层级的机器人达到五成以上胜率,而不是只看固定一小时内的战果。(少数人)
有价值的补充
- 评测框架的影响被严重低估:同一模型在不同命令行框架、可用工具(本次关闭联网搜索与抓取,模型无法查文档)和思考等级下表现会剧变;本次用各实验室第一方 CLI、断网、从最高推理档开始计时,结果可能混杂脚手架差异。(@djoldman)
- 有人建议用 Pluto 作为对手来对照——它是能击败顶级《星际争霸》人类玩家的神经网络机器人。(@BeaverGoose)
- 视频演示里有 GLM,但排行榜图表未包含它;有人要求给出包含全部 45 个模型的更完整图表。(@explodes)
- 相关资源与先例:此前已有让大模型直接玩《星际争霸》的 BroodBench 项目和讨论,也有 SC2 人类编写机器人对战平台 aiarena.net。(@MichaelNolan、@tweakimp)