Muse Spark Open(Muse Spark Open)现已推出,首次在苹果(Apple)M5 Ultra Mac Studios 上把领先的智能体能力带到桌面端。今天,我们发布 Muse Spark Open 的权重,它是美国迄今最强的开源权重模型。Muse Spark Open 是原生多模态模型,总参数 816B,激活 42B,上下文窗口 1M token,面向编程和智能体工作,擅长长周期任务、复杂软件工程和多步推理。它也是同类模型中首个使用两台苹果 M5 Ultra Mac Studios 和最新 MLX 框架在桌面运行的模型。
正文
Muse Spark Open 现已推出,首次在 Apple M5 Ultra Mac Studios 上将领先的智能体能力带到你的桌面。
今天,我们发布 Muse Spark Open 的权重,这是迄今能力最强的美国开放权重模型。Muse Spark Open 是原生多模态模型,总参数 816B(激活 42B),上下文窗口达 100 万 token。它面向编程与智能体工作,擅长长周期任务、复杂软件工程和多步推理。
我们相信未来属于每个人,这也包括在任何地方(包括家中)运行先进模型的自由。Muse Spark Open 是同类模型中首个能借助最新版 MLX 框架、在两台 Apple M5 Ultra Mac Studios 上于桌面运行的模型。
Muse Spark Open 现已通过 API 平台提供,包括 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter 和 Together AI。模型权重可在 Amazon SageMaker AI、Google Cloud Model Garden、Hugging Face 和 Microsoft Foundry Models 上下载。
它可在 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、Apple MLX、llama.cpp 和 Unsloth 等主流推理引擎上运行,并针对 AMD、Apple、Intel 和 NVIDIA 芯片做了优化。开发者还能使用 PyTorch 框架轻松进一步定制模型。
关键基准
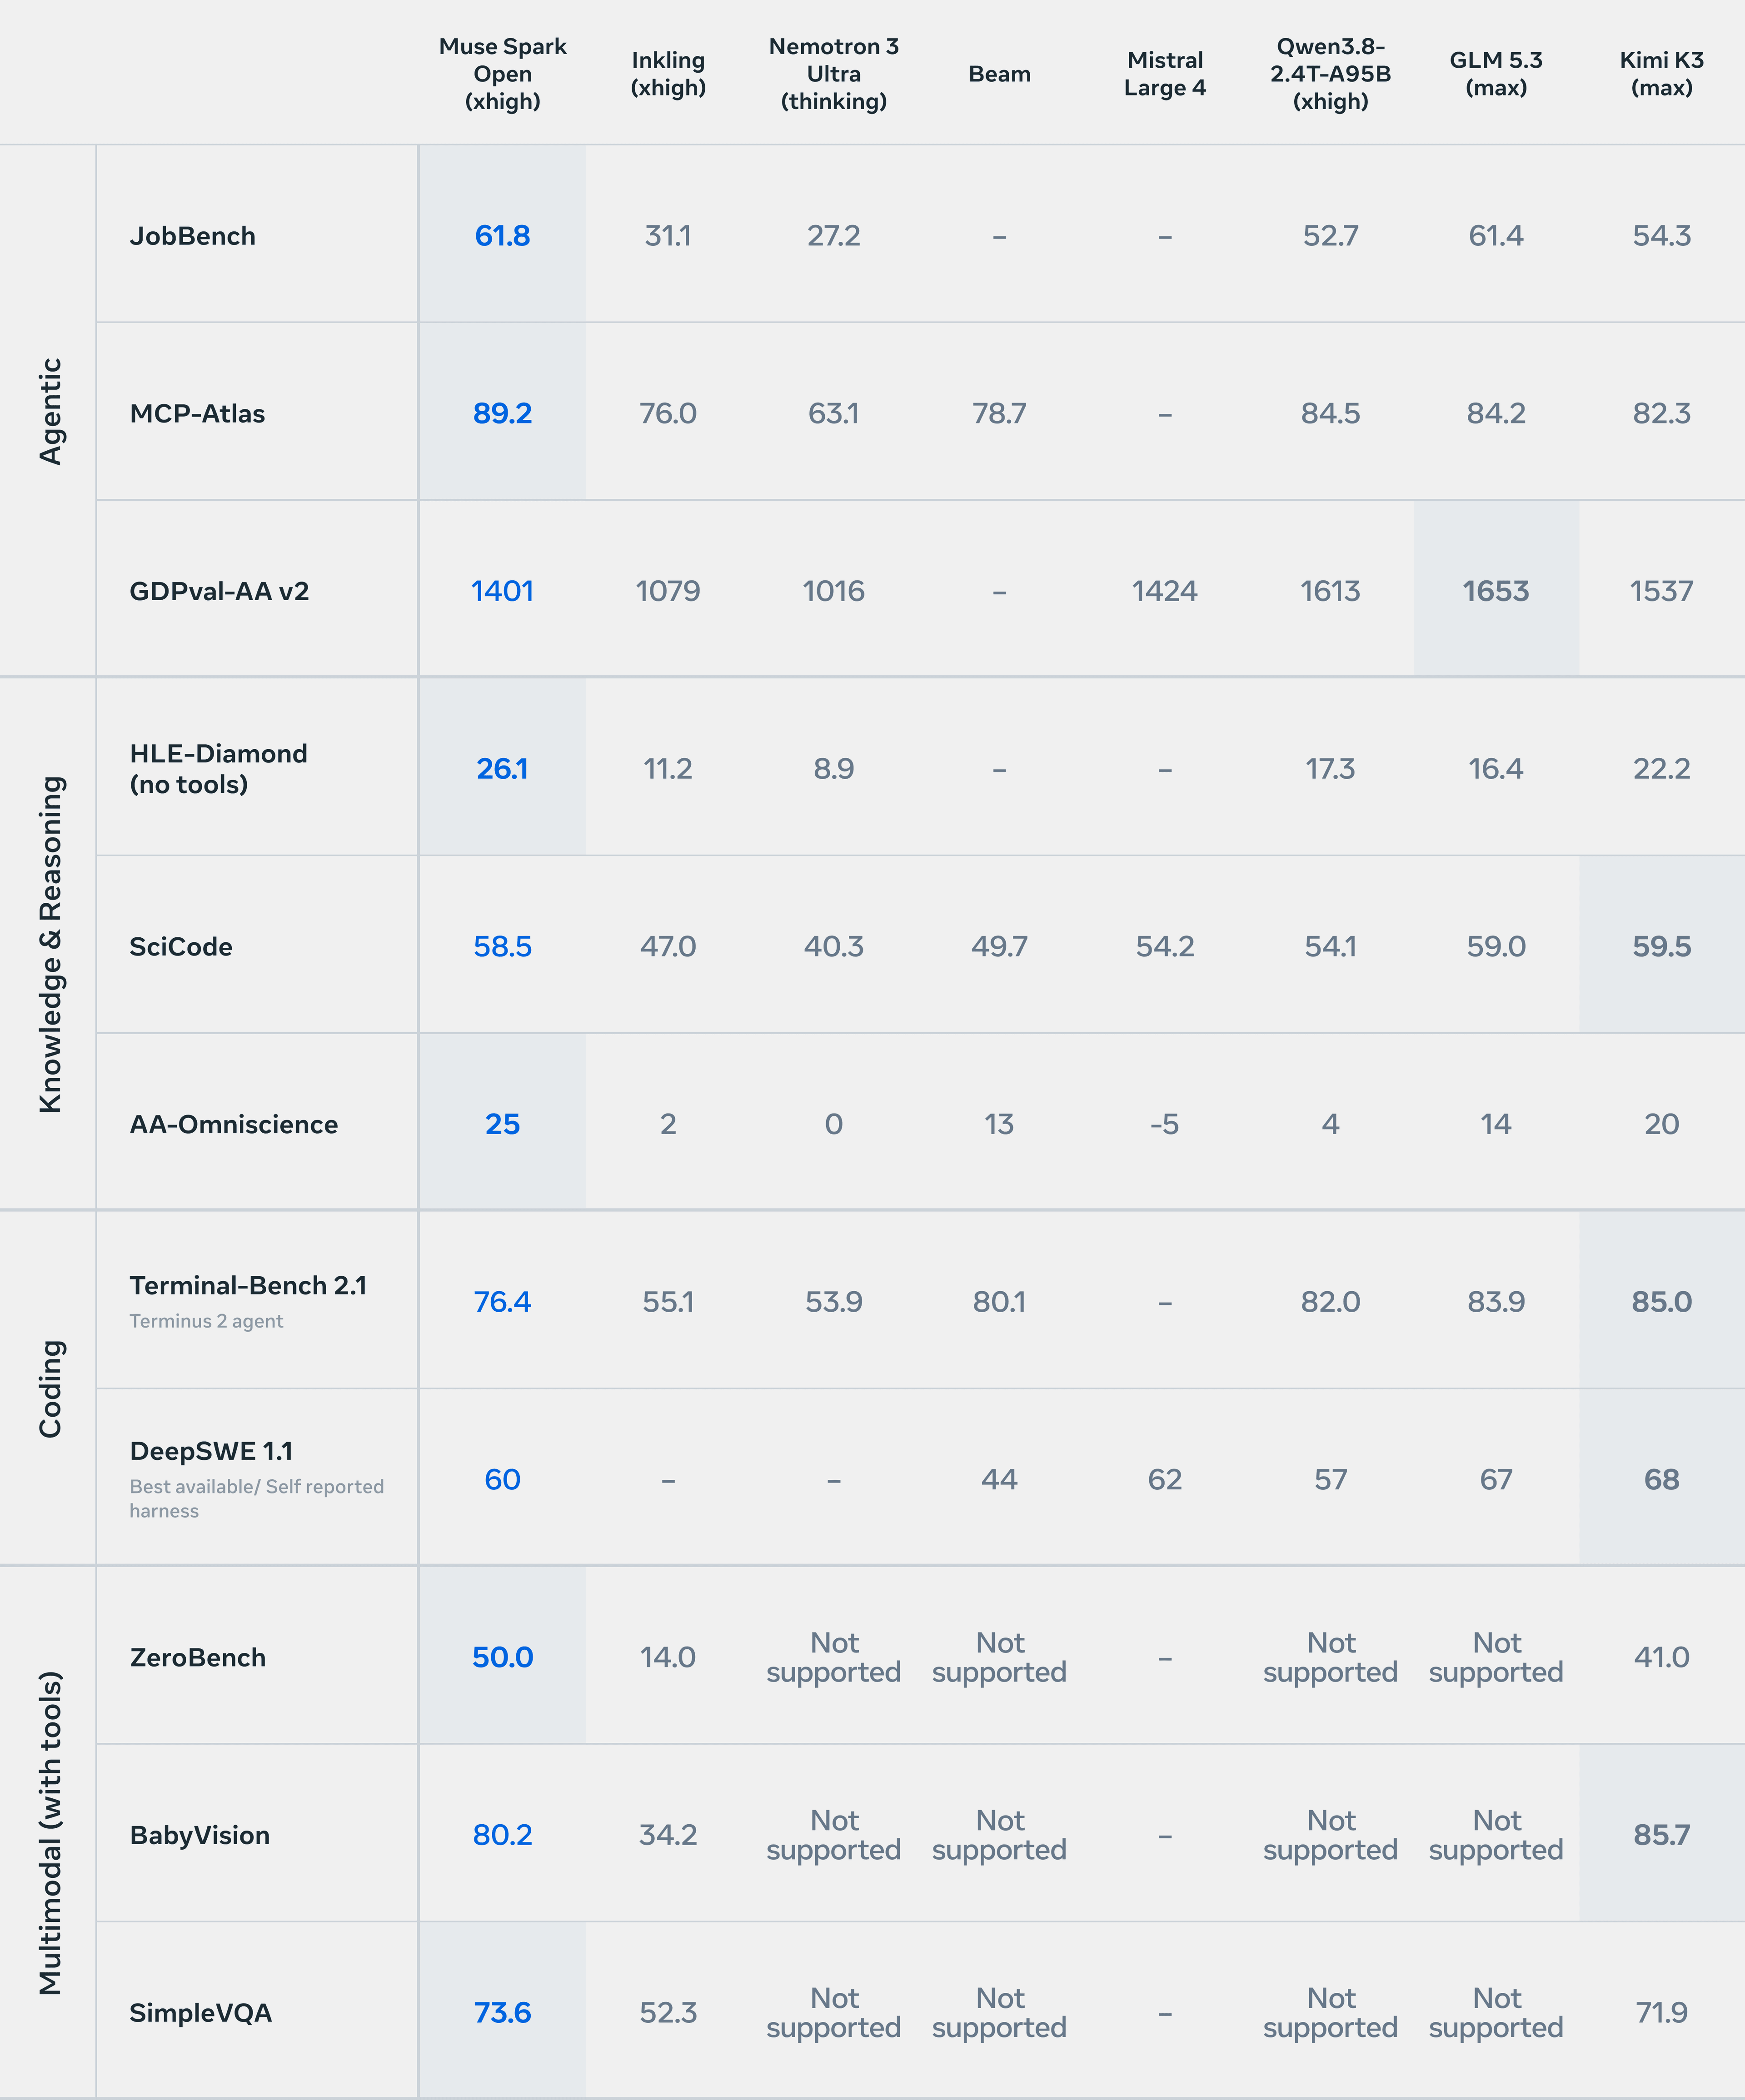
关于评测的更多细节,参见评测方法报告。
为 Apple Silicon 优化
借助最新版 MLX,Muse Spark Open 已针对搭载 M5 Ultra 的 Mac Studio 优化,二者结合是在自有桌面上运行强大模型的最佳方式。
Apple 的统一内存架构让 M5 Ultra 集成 GPU 每台 Mac Studio 可使用最多 512 GB,因此两台机器就能装下整个模型。芯片 1.2 TB/s 的内存带宽足以读取每个 token 所需的那一小部分数据。结果是两台 Mac Studio 像一台拥有 1 TB 统一内存的超级计算机。
我们用由 Muse Spark Open 驱动的 Muse Code 测试了多种完全在设备上运行的智能体工作流,包括向开源 Mastodon 客户端 Ice Cubes 交付真实的 iOS 改动——修复 bug、新增功能、完整构建——以及端到端操作 DaVinci Resolve,让模型逐帧审查素材,找出最精彩的片段并竖屏裁剪。
现已可用
我们公开这项工作,是希望每个人都能用上最好的模型。Muse Spark Open 这一开放权重版本在 SGLang 中附带了定制、可自动调优的 Helion GPU 内核,在 NVIDIA 和 AMD GPU 上实现 1.03–3.95 倍的内核级加速,在 AMD MI350 上实现 3% 的端到端加速。
安全与准备
发布开放权重模型,是我们把个人超级智能的益处带给所有人的方式之一,也是整个领域安全研究向前推进的方式之一。开放权重本身也有其考量,因此 Muse Spark Open 增加了额外的安全后训练。结果显示,在所衡量的各个风险类别上都有强有力的防护。
我们依据 Meta Superintelligence Scaling Framework 对模型进行了评估,覆盖最严重的风险,并达到了框架要求的发布阈值。详细结果见 Muse Spark Open 模型卡,完整评估报告即将发布。
许可证
我们根据 Muse Model License 发布权重,该许可证包含有限的商业条款,允许许多开发者免费使用该模型。
开始使用
你可以利用 PyTorch 的 TorchTitan 进一步微调 Muse Spark Open,以适配自己的使用场景。要在 Apple Silicon 上运行,请使用 MLX,它会直接从 Hugging Face 拉取权重。Muse Spark Open 现已通过 Hugging Face 提供:https://huggingface.co/collections/meta-models/muse-spark-open
用于在 Mac Studio 上运行 Muse Spark Open 的 MLX Adapter。
评论
多数人欢迎 Meta 重新大力发布开放权重模型,并将其视为市场利好与重要进步;但分歧集中在服务许可是否让“开放”名不副实、模型性能是否落后于 DeepSeek 和 GLM 等竞品,以及普通开发者根本无力承担的高昂本地推理门槛。少数声音还围绕后门风险、Meta 的刷榜前科,以及“真香”与抵制并存的矛盾态度展开争论。
认为 Meta 重返开放权重是值得欢迎的进步
- 社区普遍对主要 AI 实验室放出有能力的开放权重模型感到高兴,认为即便存在限制也远胜于无,并期待未来出现能在消费级硬件上运行的量化版本。这种情绪甚至带着一种“真香”定律:平时对 Meta 诸多不满,一旦有新模型又抢着尝试。(高赞) > 科技从业者一年到头骂 Meta,但一看到扎克伯格拿出亮眼东西就抢着排队(@binlog)
认为 Meta 正通过开放权重构建生态护城河并最终赢下消费级 AI
- 有深度分析认为,扎克伯格最初的 Llama 论点正被验证:前沿模型的“智能租赁”窗口极短,能力达标后价格才是决策核心。Meta 让整个生态标准化在自己的模型上,借助社区优化基础设施来降低规模化成本,借助高粘性的产品(如 Muse)增强网络效应,最终让网络价值因参与者增多而水涨船高。(少数人) > 一旦大家都标准化在 Meta 模型上,优化后的基础设施会让它扩展更便宜,从而吸引更多参与者并让网络更有价值(@swalsh)
认为服务许可限制让“开放权重”名不副实
- 该模型要求大型推理服务商单独向 Meta 申请服务许可,这令人不满;业界经验是这类做法会削弱公开云厂商的价格竞争,让效率提升转化为厂商利润而非用户降价。因此不少人认为它只是“带引号的”进步,离真正的开放尚有距离。(较多人) > 单独授权通常会减少公开提供商的价格竞争,效率提升只会变成利润而不是让用户受益的降价(@popinman322)
认为实际性能平庸且不信任 Meta 的跑分
- 不少人实测或对比后觉得该模型在编码等基准上仅介于自家旧版本之间,明显不及 DeepSeek、GLM 和 Qwen 等开源模型,连 vibe coding 仍会产出低质量代码;更有人因 Meta 过往的刷榜前科,直接不再相信它公布的任何基准分数。不过也有人承认它在部分推理服务上速度极快。(较多人) > 鉴于 Meta 过去几个模型暴露的刷分行为,我不再相信它的任何基准分数(@tintor)
认为推理门槛极高,普通开发者根本无法本地运行
- 模型规模极其庞大,官方演示依赖昂贵且尚未发售的苹果硬件,因此有人直言普通用户根本跑不动;大家普遍期待后续能有量化版,让没有早期访问资格的人也能在消费级设备上使用。(较多人) > 简单来说,这个模型你我都跑不动(@spwa4)
认为开放权重模型存在后门风险或安全担忧被夸大
- 有人读过后门相关论文后认为植入后门完全可能,只是不知首次事故何时到来,并倾向信任西方实体;也有人反讽这种安全担忧是 GPT-2/3 时代的遗留恐惧,后来被证明并无问题。甚至还有极少数人直接呼吁彻底抵制 Meta 的模型。(少数人) > 在读到关于开源权重模型后门的论文后,我觉得植入后门是完全可能的,只是好奇第一次事故何时发生(@maxdo)
有价值的补充
- 模型总参数达 816B,激活参数为 42B,普通消费级硬件无法承载,只能依赖量化或数据中心级部署(@spwa4)。
- 工程上团队做了大量适配,让模型能跑在从 Unsloth 到 MLX 的各类推理框架上(@armcat)。
- 官方演示需要两台顶配 Mac Studio(512GB 统一内存版当时尚未发售),预估成本近 3 万美元;其 1.2TB/s 的内存带宽实际上只有同价位 Nvidia H100(3.94TB/s)的三分之一左右,所谓“两台像一台超级计算机”更多是营销话术(@devy)。