OpenAI 的数学仓库中有一部分声称能实现更快的傅里叶变换(Fourier Transform)。快速傅里叶变换(Fast Fourier Transform,FFT)是数字信号处理领域最重要的创新之一,能快速提取信号的频率内容,让人迅速分析、滤波并操作频谱各频段的频率。傅里叶变换通过简单点积算出每个频段的能量:设 x 为长度 n 的采样数组,f 为频率,则 x 在 f 处的频率含量可由公式得出。
正文
快速傅里叶变换是数字信号处理中最重要的创新之一,也是我最喜欢的算法。FFT 是一种快速提取信号频率成分的方法,能让你迅速分析、滤波并操纵频谱不同频段上的频率。
傅里叶变换通过一次简单的点积来计算每个频段的能量(现在年轻人管这叫余弦相似度)。设输入 x 是长度为 n 的采样数组,f 是频率,那么 x 在 f 处的频率含量可由下面的公式算出:
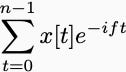
对数字信号来说,一点数学就能说明,你只需要计算 n 次这样的点积——在频率 2𝜋/n 的各个倍数上各算一次——就能掌握全部频率成分。朴素地看,每个频率需要 n 次乘法和加法,因此整个傅里叶变换看起来需要 n^2 次算术运算。
真正的「快速」傅里叶变换是 James Cooley 和 John Tukey 在 1965 年发明的一种巧妙递归过程。(维基百科说其实该归功于 1805 年的高斯!学术界的功劳归属向来是个老大难问题。)其核心思想是:长度为 n 的傅里叶变换可以通过打乱输入向量、对打乱后的分量分别计算两个长度为 n/2 的傅里叶变换,再用原子算术运算重新组合输出来实现。打乱和重组只花线性数量的算术运算。迭代重复这个过程,也就是做 log2(n) 次,就能算出完整的离散傅里叶变换。算上这些记账操作,FFT 能在少于 5 n log2 n 次算术运算内完成长度为 n 的傅里叶变换。
为了让这个加速更具体:当 n=1000 时,n^2 是 1,000,000,而 5 n log n 大约是 50,000,提速 20 倍。当 n=1,000,000 时,提速 10,000 倍。考虑到信号处理应用的限制,这些提速可能决定一个变换到底能不能算出来。
自 FFT 发明以来,人们一直在找更快的傅里叶变换。一个问题是到底能快到什么程度。看起来你至少需要 n 次运算才能算出 FFT,因为光把它写出来就要 n 步。FFT 比这个合理的速度极限慢 5 log2(n) 倍,而当 n 很大时,这个 5 log2(n) 因子会非常大。n 是一万亿时,它是 200。你能不能耍点聪明,把 200 这个前置因子降下来?
结果你猜怎么着,在上周 OpenAI 砸向数学界的一大堆论文里,他们声称有了更快的傅里叶变换。他们那份名字很有「区分度」的 main.pdf 里的主要结论是:
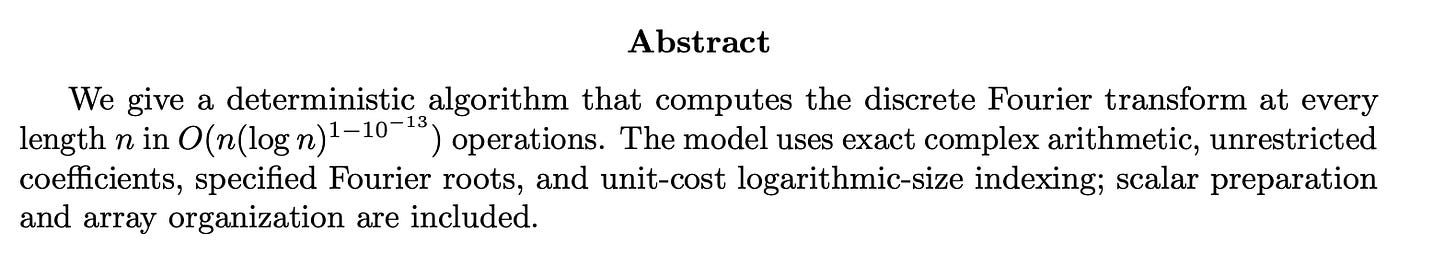
我很好奇这里头到底搞了什么名堂。理论上,这个 log(n) 项只比标准 FFT 里的要小那么一丁点。
我读这篇论文了吗?当然没有。OpenAI 里也没人读这篇论文,凭什么我就得读?我跟世界上其他数学家一样,把 AI 生产的数学垃圾再丢回垃圾机器:我把它喂给一个聊天机器人接口,跑了一次信息检索,提取出几个显眼的事实。拟人点说,我问 ChatGPT 它对自己的输出有什么看法。我们现在就是这么搞数学研究的。真是好世界。
可惜,我并没有找到一个更快的傅里叶变换。相反,我发现的是应用数学理论内部烂掉的样子:当形式化脱离现实太远,一个「突破」只不过是因为数学家没能用自然语言把游戏规则说清楚而产生的假象。
首先,大O记号被滥用到已经没有意义了。我们来复习一下它的定义,我当年读本科时还被它震住过。一个算法的运行时间 T(n) = O(F(n)),是指存在整数 N 和常数 C,使得
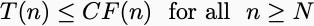
也就是说,只要 n 足够大,算法实际需要的步数就被一个常数乘以某个方便的函数 F(n) 从上方限制住。F(n) 通常是多项式、指数函数这类熟悉且可解释的东西。这个记号的意思是,我们只关心计算规模很大时会发生什么,只关心计算时间的渐近增长率。所有常数都等价。
大O记号在做算法账时很有用,但也允许了一种惊人的逻辑懒惰。如果我们想要一个实践中更快的 FFT,我们想要的是对合理大小的 n 只需要少于 50n 次运算的算法。但 O(n) 并不是 50n,它可能是 10^80 n。这也叫「线性时间」算法。一个需要 n + 10^80 次运算的算法,在大O世界里也算线性时间。一个只有当 n 大于 10^80 才有线性时间保证的算法,也算线性时间。10^80 大约等于已知宇宙中的原子总数。正因如此,Richard Lipton 和 Ken Regan 把隐藏常数大到无法想象的算法称为 galactic algorithms。
OpenAI 的 FFT 算法绝对是 galactic 级别的。在 N=10^12 时,C 的估计值是 10^100。也就是说,即使 n=10^100,老牌的 Cooley-Tukey-Gauss FFT 也会比它快 10^99 倍。
那为什么这个新的 FFT 结果还有点意思呢?注意,在大O记号下,它确实在渐近意义上比 Cooley-Tukey 算法快,因为
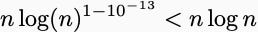
好吧,确实如此。但考虑到那些常数,这个算法只有在 n 大到不可能的时候才更快。大致需要
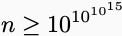
天知道这个数字到底是什么意思。
Lipton 和 Regan 认为 galactic algorithms 有用,因为它们能刺激研究。一旦你证明某个运行时间在渐近意义上可行,就可以花时间去找一个在实践中达到这个可证明运行时间的算法。也许你可以派你的 AI agent 集群去追。你随意。也许你最后能搞出一个实用算法,但我不知道有任何站得住脚的例子真发生了。我对此尤其怀疑,因为 OpenAI 使用的「计算」模型和真实计算机毫无相似之处。
「该模型使用精确复数运算。」这意味着它假设你能以任意精度存储和相乘复数。事实上,该算法要求你把大小随 n 呈超多项式增长的复数相乘。如果你把这些数按比特存储,内存需求实际上会随输入长度呈指数增长。它还假设你能用一次操作就把这样任意大的复数乘起来。我们并没有这样的计算机。所以,即使 main.pdf 里这个定理是「真」的(没人知道,我也不在乎),它也没有解决我们寻找更快 FFT 时本来想解决的那个问题。
对熟悉 FFT 理论分析的人来说,你需要一个荒谬的计算模型才能突破 FFT 的速度极限,并不足为奇。1973 年,Jacques Morgenstern 证明,如果要求计算中使用的复数系数大小有界,你就不可能得到快于 ½ n log n 的傅里叶变换。故事本该到此为止!但没有。人们说 Morgenstern 的限制性系数模型太严了。四十年后,Nir Ailon 证明,如果不伴随严重的数值不稳定性,你就不可能算出快于 n log n 的 FFT。我猜,这对某些人来说也太严了。
因此,OpenAI 这个新结果与其说是数学突破,不如说是计算机科学家不擅长把自己的设计规范形式化所产生的一个怪胎。「计算机」的理论定义和我们实际造出来的计算机相去甚远。这个「更快」的傅里叶变换只是这样一个例子:理论脱离原始问题太远,以至于一个「开放问题」变成了纯粹的学术地位谜题。这个解法就像你把计算 bot 数据流丢向不可能的问题,然后发现它们在从事非法黑客活动一样。
这个 OpenAI 垃圾仓库里其他许多「重大」结果也可以用同样方式批评。比如,其中一个结果是一个用 O(n^2.25) 次运算做两个矩阵乘法的 galactic 算法。论文里的构造甚至让你没法估计大 O 里藏着的常数;那个公式说的是,对每个 epsilon > 0,都存在常数 C 使 T(n) <= n^(2.25 + epsilon + C / log n),但不管我怎么问,OpenAI 模型也给不出 C 的定量估计。它可能干脆是无穷大,只有靠天体音乐才能算出来。
不过,这些论文如果写得好很多,本来能进入理论计算机科学最负盛名的发表场所,也就是 STOC 或 FOCS 的审稿会议论文集;矩阵乘法那篇大概还会获奖。(另一个坏传统是,计算机科学竟把审稿仓促的会议论文集当成最顶级的发表场所。)但这两篇都跟真正的计算机没有任何关系!
这是因为理论计算机科学有一种主动排斥在真实计算机上运行算法的文化。在理论会议上写论文,断言一个算法存在、却从不把它写出来,是完全可以接受的。理论计算机科学已经变成了一种不关心计算机的数学,对那些数学追求之外的影响也几乎不给奖励。我把这一点解释给一个朋友听,他说,'理论' 这个词跨学科的意思就是'躲在自己制造的晦涩里'。
AI 非常擅长把我们最糟糕的倾向自动化。它放大了那些没人喜欢、但也没有个人能合理偏离的潜在文化实践。它利用那些难以通过集体行动改变的机械化传统。顺着这个思路,AI 现在能写没用的理论论文了。但也许,在 OpenAI 那堆令人反胃的证明垃圾场的荒谬之中,我们都能抬头看一眼,并意识到我们该考虑做点别的事了。
评论
讨论气氛更像是理论计算机科学支持者与 AI 数学怀疑者的交火:不少人认为“不实用、常数巨大”本就是理论研究的常态,原文对理论界的攻击站不住脚;另一部分人则抓住技术细节,认为 OpenAI 这项结果依赖精确复数运算、用大 O 掩盖超多项式幅值增长,甚至只是形式化漏洞下的取巧。
认为原文是在无理攻击理论计算机科学和纯数学
- 理论顶会(STOC、FOCS、SODA)本来就不以落地实用为目标,想看可实现的算法应去 ESA、ALENEX、VLDB、SIGMOD 等更偏应用的场合;因为理论家不做实验就嘲讽他们并不公平,big-O 里出现荒谬常数也可以接受,只要它确实是常数。(较多人)
- “galactic algorithm”(渐进漂亮但实际跑不起来)在人类理论界已存在几十年,是正常研究产出;因此“常数巨大、没有应用”不能推出它不是真正的改进,更不等于 AI 低质产出。(较多人)
- 若按作者的逻辑推到底,连 median of medians、2019 年 Harvey–van der Hoeven 的 O(n log n) 整数乘法也会因为实际不用而被判成无用,这说明批评标准本身有问题。(较多人) > 若按作者标准,连 median of medians 这类标准算法也会因不被实际使用而被当成无用(@phoenixreader)
- 对 OpenAI 数学低质产出的反感不应牵连纯数学:不少人正借着讨厌 AI,把对数学家和纯数学的一贯轻视变得主流化,这让人不适。(少数人)
认为结果更像是形式化漏洞或被大 O 掩盖的代价
- 上周那些重磅的复杂度结果竟建立在“精确复数运算”模型上,而不是外行以为的基于整数的通用寄存器机或图灵机;这个前提本身就令人生疑。(少数人)
- 如果算法要乘的复数幅值随 n 超多项式增长,big-O 等于把代价藏起来了,足以怀疑 sub-n log n 是在掩盖问题。(少数人) > 复数幅值随 n 超多项式增长,这难道不是直接让 big-O 分析失效了吗?(@jiggawatts)
- 更普遍地说,问题出在计算机科学家把设计规格形式化得不好:AI 很会给出答案,但常常不是对正确问题的答案,结果只是规格漏洞下的怪异产物,而非真正突破。(较多人)
觉得用聊天机器人审查 AI 数学本身就是荒诞
- 文章承认没人(包括 OpenAI 的人)真正读过论文,只是把 AI 的数学产出再喂回聊天机器人、问它对自己的输出怎么看;这种“用低质产出审核低质产出”的流程被当成当下数学研究的荒诞缩影。(少数人) > 没人读过这篇论文,我把 AI 的数学产出再喂回聊天机器人,问它对自己的输出怎么看——这就是我们现在的数学研究方式(@fergie)
有价值的补充
- 整数乘法边界的改进工作仍在推进,CrocSwap/integer-mult-bounds 上的 kappa 已提升到约 0.001635527380375392。
- FFT 和 DFT 的复杂度通常按复数加法和乘法次数来计算,直接套用 big-O 并不合适,因此对这类算法的复杂度表述需要更谨慎。
- 精巧类比: > 就像 leetcode 里把 ASCII 字符空间当成常数时间,理论上可行、实际几乎无法维护,属于利用形式化假设的取巧(@Glyptodon)
- 精巧类比: > AI 就像《银河系漫游指南》里的 Deep Thought,先给出了答案,却没人知道终极问题到底是什么(@omoikane)