科罗拉多州、康涅狄格州、弗吉尼亚州等18州居民可退出定向广告,包括我们出售或共享其个人信息。我们与第三方伙伴会依隐私政策用这些信息投放你可能感兴趣的广告,加州居民还可限制敏感个人信息使用披露。你需在网站、浏览器和设备上退出,清除 Cookie 后需重复;已登录多平台会尽力同步请求。在本站退出请左滑并按下允许定向广告开关。
正文
任何哪怕是稍微接触过计算机编程的人都知道,现代 AI 编码助手和代理在生成大量可用代码方面可以非常高效。但使用这些工具的程序员也清楚,不能轻易相信这些代码的准确性,因此需要投入大量精力去审查 AI 生成的输出。
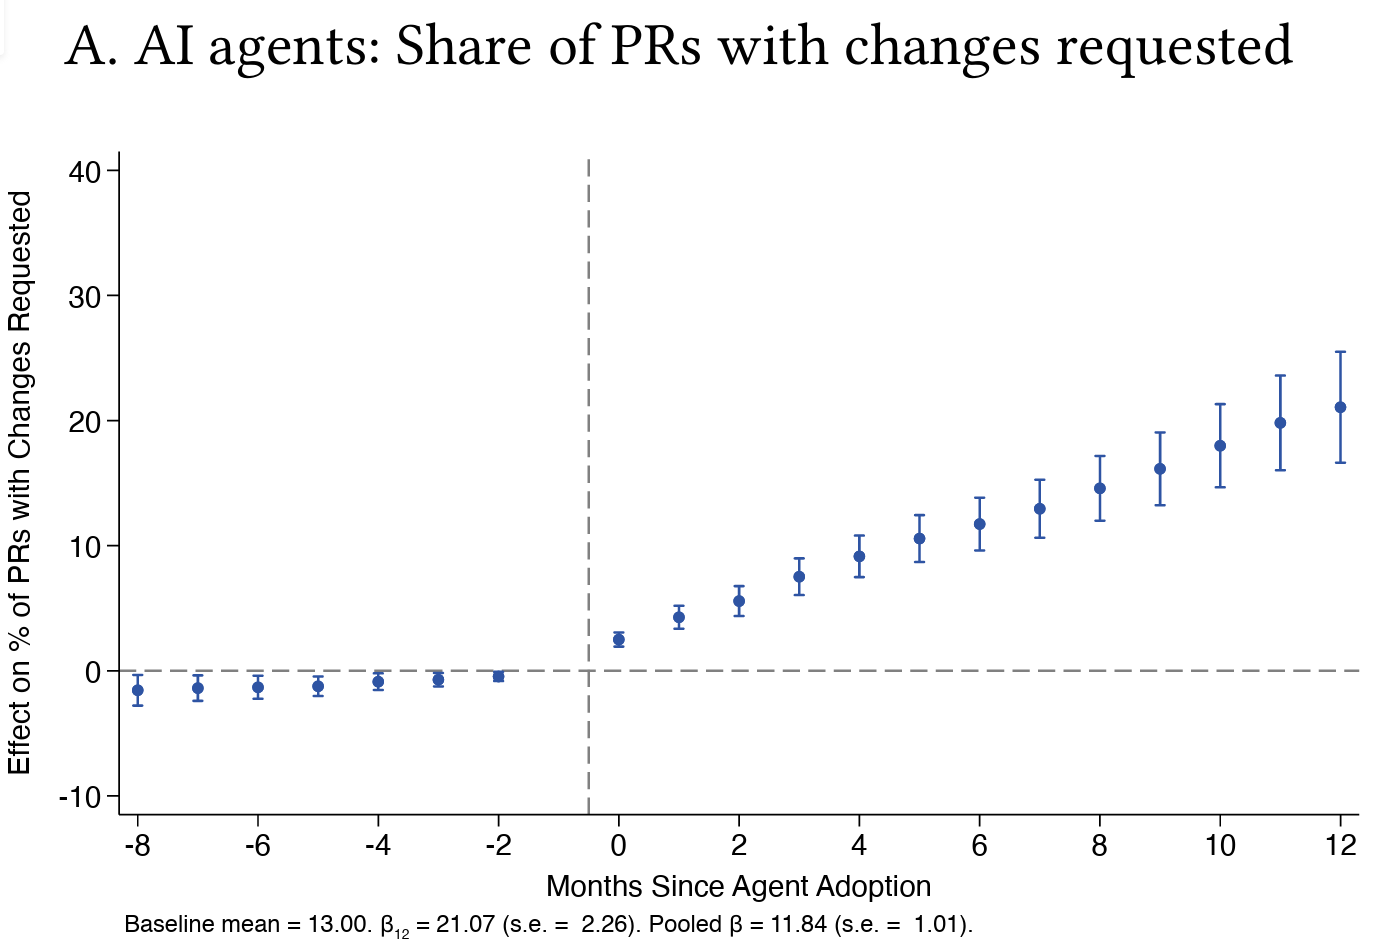
一项针对数百家公司实际编码实践的最近研究发现,人工代码审查构成了 AI 编码工具整体效率的一个显著“瓶颈”,导致“几乎没有证据表明企业通过使用这些工具增加了软件产出或减少了雇员”。研究作者发现,实际编码阶段提升的任何效率,都被“生产流程下游的限制吸收了”;具体表现为“代码审查流程的耗时显著变长,拉取请求更可能需要修改,审查者留下的评论也更多”。
裁一次,量两次
为了得出这些结论,哈佛大学研究者 Fiona Chen 和 James Stratton 使用了 Jellyfish 的汇总分析数据;Jellyfish 用于衡量工程团队的细粒度产出。这些数据涵盖 3 亿个独立“工作事件”(例如提交和拉取请求),以及来自 700 多家软件开发公司、超过 70 万名员工的问题管理软件数据,时间跨度为 2021 年至 2026 年 3 月。
为评估 AI 工具对这些公司的影响,研究者结合直接测量的 AI 使用情况和对 GitHub 活动的分析,判断每家公司何时开始引入 AI 编码助手(主要帮助自动补全人类编写的代码)和/或 AI 编码代理(主要根据提示自主编写并提交代码)。随后,研究者通过一些复杂的计算,对关键变量在不同组织、不同时间点引入这些工具前后的“双重差分”回归进行了估计。
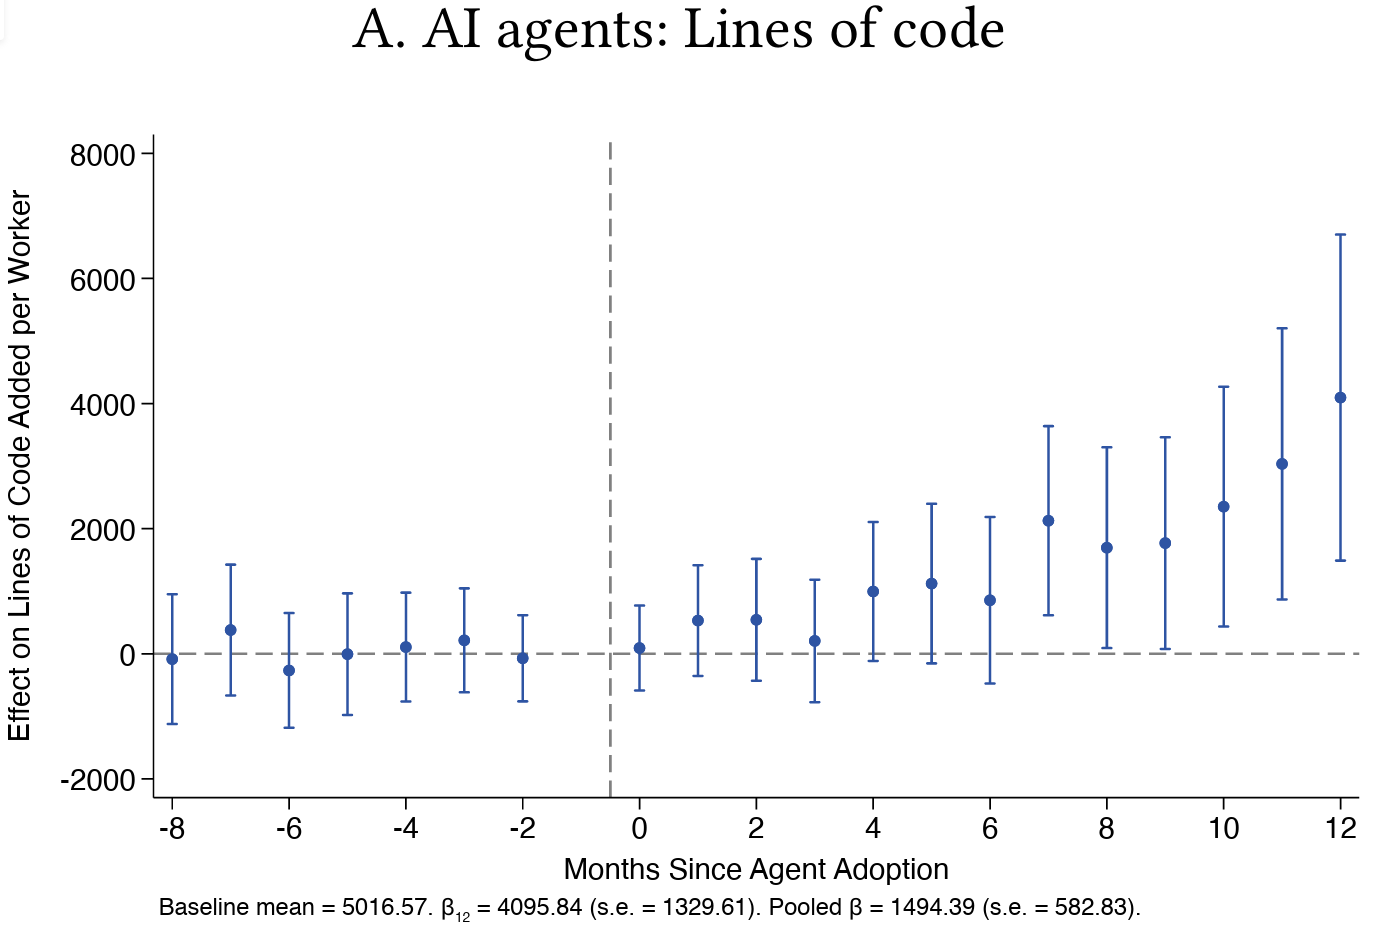
就生成的原始代码而言,结果清晰而鲜明。研究者写道,一家公司引入 AI 编码代理后,生成的代码总行数平均增加 30%,总提交数上升 20%,拉取请求数增加 23%。但这些多出来的代码并没有直接转化为公司层面软件产出的提升。相反,在用 Jira 等工具跟踪的 Issues 和 Epics(即完整的软件功能)解决率上,引入 AI 工具后并没有出现统计上显著的变化;研究者还发现,这些 Jira 跟踪问题的规模或复杂性在 AI 引入前后也没有出现“构成性变化”。
这种差异的原因可以直接在代码审查流程中找到:引入 AI 编码代理后,审查流程的平均耗时明显变长。总体而言,从拉取请求提交到合并进代码库的平均“审查流程”时间,在引入 AI 代理后平均暴增 49%。这种效应在更细粒度的数据中也能看到:研究者写道,在转向 AI 代理后,“需要修改的拉取请求占比几乎翻倍,每个拉取请求的评论数增加了 35%”。
面对这一变化,研究者发现,在引入 AI 代理后,参与代码审查的工作者比例增加了 14%。他们还写道,在查看 Jellyfish 的总活跃员工并与这些公司的 LinkedIn 数据交叉比对后,他们“无法把显著的就业变化归因于 AI”。

虽然 AI 理论上也可以帮助完成审查流程,但研究者发现,到目前为止这种影响微乎其微。尽管到 2026 年 3 月,80% 的受测公司都使用了某种形式的 AI 代码审查,但 AI 代理只贡献了所有审查评论的 23.3% 和所有拉取请求的 10.8%,说明人类仍然承担着这项工作绝大部分。
当然,AI 代理在编码世界里仍是一个相对较新的事物,而且即使在这项研究 2026 年 3 月的数据截止之后,它们的输出也已经出现了显著的更新和升级。虽然研究中 95% 的公司此时都已部署 AI 编码代理,但许多公司无疑仍在学习何时以及如何最好地使用它们。随着软件工程团队对把 AI 代理用在特定编码问题上的利弊积累更多经验,这种“编码时间与审查时间”的权衡可能会改善。

但就目前而言,让 AI 写代码看起来是一把双刃剑:编码速度的提升被人工代码审查时间和精力同等程度的增加所抵消。这样的结果让人怀疑,为了让 AI 编码代理跑起来而投入的大量时间和成本,对大多数公司来说是否真的值得。

评论
这场讨论围绕一篇称编码智能体并未带来更多软件产出的研究展开,多数人质疑其结论的现实相关性:论文主要反映 2025 年旧模型和传统企业刚部署智能体时的初始阶段,而且只统计留有 GitHub、Jira 等足迹的团队,放到 2026 年已过时,用现在时报道近乎不诚实。真正的分歧主轴是,一方坚持传统人工代码审查与组织沟通仍是瓶颈,另一方则强调新团队、个人和前沿实验室已经绕过逐行审查、用信任智能体的方式产出更多软件,并认为放弃逐行审查是抽象层跃迁的必然。
认为论文数据来自 2025 年旧模型,对当前已过时且不诚实
- 论文只是 2025 年的一张快照,所用模型还停留在 Claude 3.5 到 Sonnet 4.5、GPT-4.1 到 GPT-5、Gemini 2.5,捕捉的是部署初期、企业尚未形成成熟审查流程时的效果;基线里拉取请求平均积压七天、每月只多约 1.22 个请求和一千多行代码,说明当时工程文化本就不在乎交付。放到智能体已大幅进化的 2026 年,结论基本失效,用现在时报道更像误导。(认可度:较多人)
- > 用现在时去报道 2025 年的数据,而 2026 年的编码智能体与当时已大不相同,这近乎不诚实。(@jimrandomh)
认为传统企业里人工代码审查与组织流程才是真正瓶颈
- 代码审查一直是显著瓶颈,智能体编码下更严重;资深工程师很难放弃逐行审查,自动审查至今没落地为实用改进。组织适应更慢:产品经理、故事点、需求沟通和文档等限制仍在,编码只占整体工作一小部分,自动化编码不会带来数量级提升。人类眼球正成为勒住无数不知疲倦编码智能体的缰绳,一天“审”上万行并不现实。(认可度:较多人)
- > 代码审查一直是显著瓶颈,智能体编码下更严重;资深工程师很难放弃逐行审查,文化改变更可能先发生在从一开始就不做人工审查的初创公司。(@staminade)
认为新团队、个人与前沿实验室已绕过审查瓶颈并产出更多软件
- 研究结论只有加上“如果你还绑在传统人工审查流程上”才成立;新应用和新公司正以更快速度交付,前沿实验室自身的出货速度就是反证。范式转变是信任智能体代码、不逐行审查,如同工程经理不会读每个拉取请求的每一行。个人自制和自用软件产量飙升,许多原本没时间做的项目现在能启动,自替代的软件往往比过去用的更好;也有人举 Artcraft 这类免费开源、可替代 Adobe 创意套件的成果为例,说明更多软件已经出现。(认可度:较多人)
- > 范式转变在于信任智能体生成的代码而不去审查它,就像工程经理不会逐行读每个拉取请求;这类成果就是更多软件。(@bensyverson)
认为放弃逐行审查、信任智能体是抽象层跃迁的必然
- 每次抽象层上移都会有人反对,从汇编到 C 时人们也嫌离 CPU 太远;再给五到十年,除了性能等特殊场景,几乎没人会再看代码,只要能跑通并通过测试,智能体写得差也无所谓。大规模分布式系统本就非确定,再多一点混乱也无妨,应当押注能力改善的斜率而不是某个时间点的表现。(认可度:少数人)
- > 每次抽象层上移都有人反对,就像从汇编到 C;再给五到十年,除了性能等特殊场景,几乎没人会再看代码,能通过测试就够了。(@jedberg)
指出智能体反而制造更多审查与维护负担,而非单纯减少工作量
- 智能体能抓出过去漏掉的重要 bug,但一次给出十二条问题,其中十一条实践里根本不会触发,仍逼你逐条理解、归档或忽略;智能体不爱重构,会喷出成堆重复测试代码,测试代码行数可达业务代码数倍,且不同模型或工具倾向不碰别人的代码,宁愿复制辅助函数。它们还很不会判断界面与用户体验和整体用户流程,做出可用的产品仍需大量手工打磨;代码库活得越久,智能体基于历史腐化代码提出的边角案例也越多。(认可度:较多人)
- > 智能体会写出成堆重复测试代码且不愿重构,在集成测试里测试代码行数常常是实际交付代码的好几倍。(@CharlieDigital)
有价值的补充
- 研究计量存在足迹盲区:只统计留有 GitHub、Jira 等“工作事件”足迹的企业团队,会漏掉用自托管 Mercurial、无 issue、无日历的个人项目(如 FluxImp)和非软件工程师写的小工具;这些成果没有传统指标,却可能是编码智能体真正带来的增量。(基于 @joshheitzman 等)
- 代码审查常被误读:它从来不是逐行抓 bug 的机制,而是基本健全性检查、推行最佳实践和带新人的场合;若担心破坏,应讨论测试覆盖而不是逐行审。(基于 @sroerick)
- 引擎与轮胎类比:编码只是软件交付的一小部分,就像赛车引擎再强也受轮胎牵引限制;即便编码被完全自动化,也不会让整体生产力数量级提升,需求、沟通、测试等瓶颈会顶上,没有免费午餐。(基于 @blauditore)
- 用工具和文档约束智能体能降低审查负担:把规范、设计和文档要求固化进工具链,让智能体保持在轨道上并产出易读代码,审查才可控。(基于 @jpurnell)