今天,Meta公司(Meta)推出缪斯奇迹(Muse Wonder)系列,包含缪斯奇迹与缪斯奇迹完整版(Muse Wonder Full),在个人和专业代理任务上达到领先水平。缪斯奇迹结合主动记忆(Active Memory)与主动专注(Active Focus),记住重要信息并持续推进目标,也是扩展阶梯上的下一步,向个人超级智能大幅迈进。缪斯奇迹现已通过Meta模型API(Meta Model API)和缪斯代码(Muse Code)提供,缪斯奇迹完整版也面向缪斯代码订阅者开放。
正文
一款在个人与专业智能体任务上领先的前沿模型
今天,我们很高兴推出 Muse Wonder 系列,其中包括 Muse Wonder 和 Muse Wonder Full。这是我们目前能力最强的模型,在个人与专业智能体任务上实现了最先进的性能。它们共同标志着我们扩展阶梯上的下一步,也是迈向个人超级智能的一次重大飞跃。Muse Wonder 结合了 Active Memory(主动记忆)和 Active Focus(主动专注),用以记住对你重要的事,并持续朝着你想要完成的目标努力。
Muse Wonder 即日起通过 Meta Model API 和 Muse Code 提供,Muse Wonder Full 即日起面向 Muse Code 订阅者提供。
Muse Wonder 很快将为 Muse 中的体验提供支持,并率先推送给订阅者。它还将为 artifact 生成以及需要更高智能的流程提供支持。未来,我们将利用 Muse Wonder 开发专用模型,把它们带给所有使用 Muse 的人。
十四个月前,我们开始对人工智能工作进行彻底重构。在此期间,我们从根据第一性原理重建技术栈,走到了推动前沿。
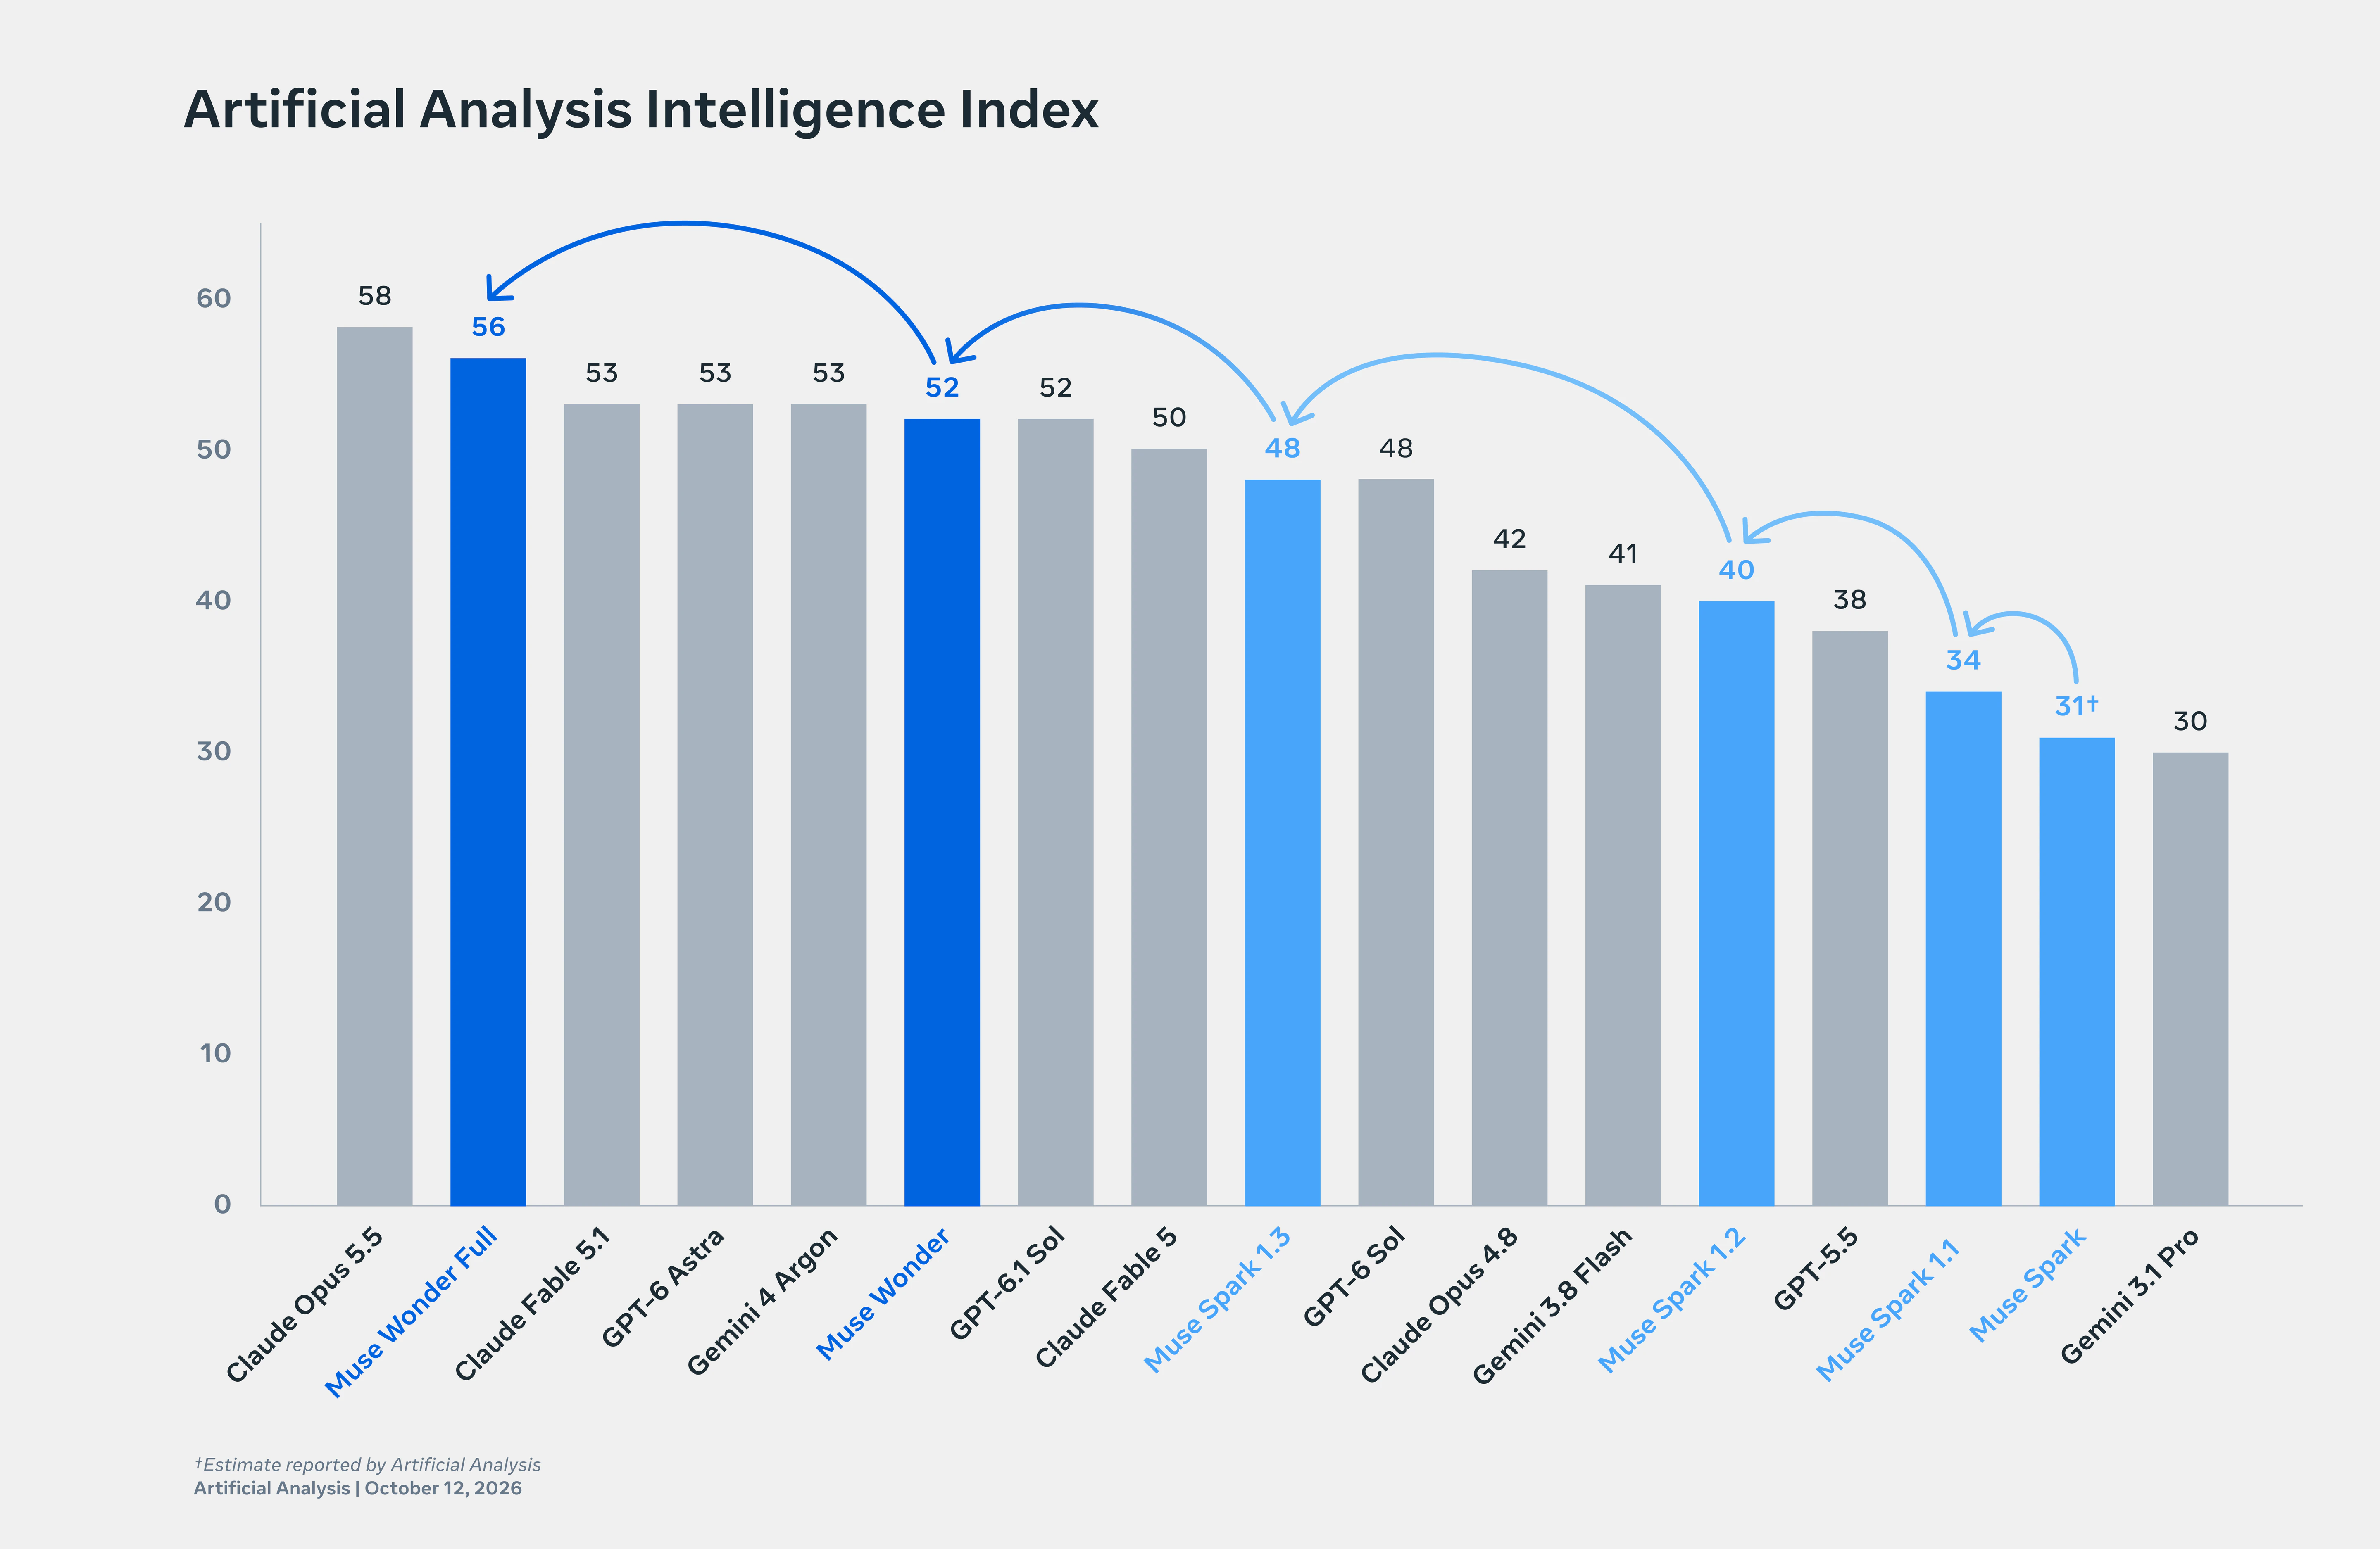
我们在推出 Muse Spark 时,概述了可预测、严谨的扩展方法。今天的发布在预训练和强化学习方面延续了这项工作,带来了我们迄今最强的模型。Muse Wonder 和 Muse Wonder Full 在我们吉瓦规模的 Prometheus 数据中心训练而成,汇聚了 Meta 各团队的成果,为工作和日常生活中的复杂任务提供前沿能力——这是将个人超级智能带给我们产品数十亿用户的又一步。
模型亮点
Muse Wonder 系列在个人与专业智能体、记忆和编程的关键基准测试中取得了最先进的结果。
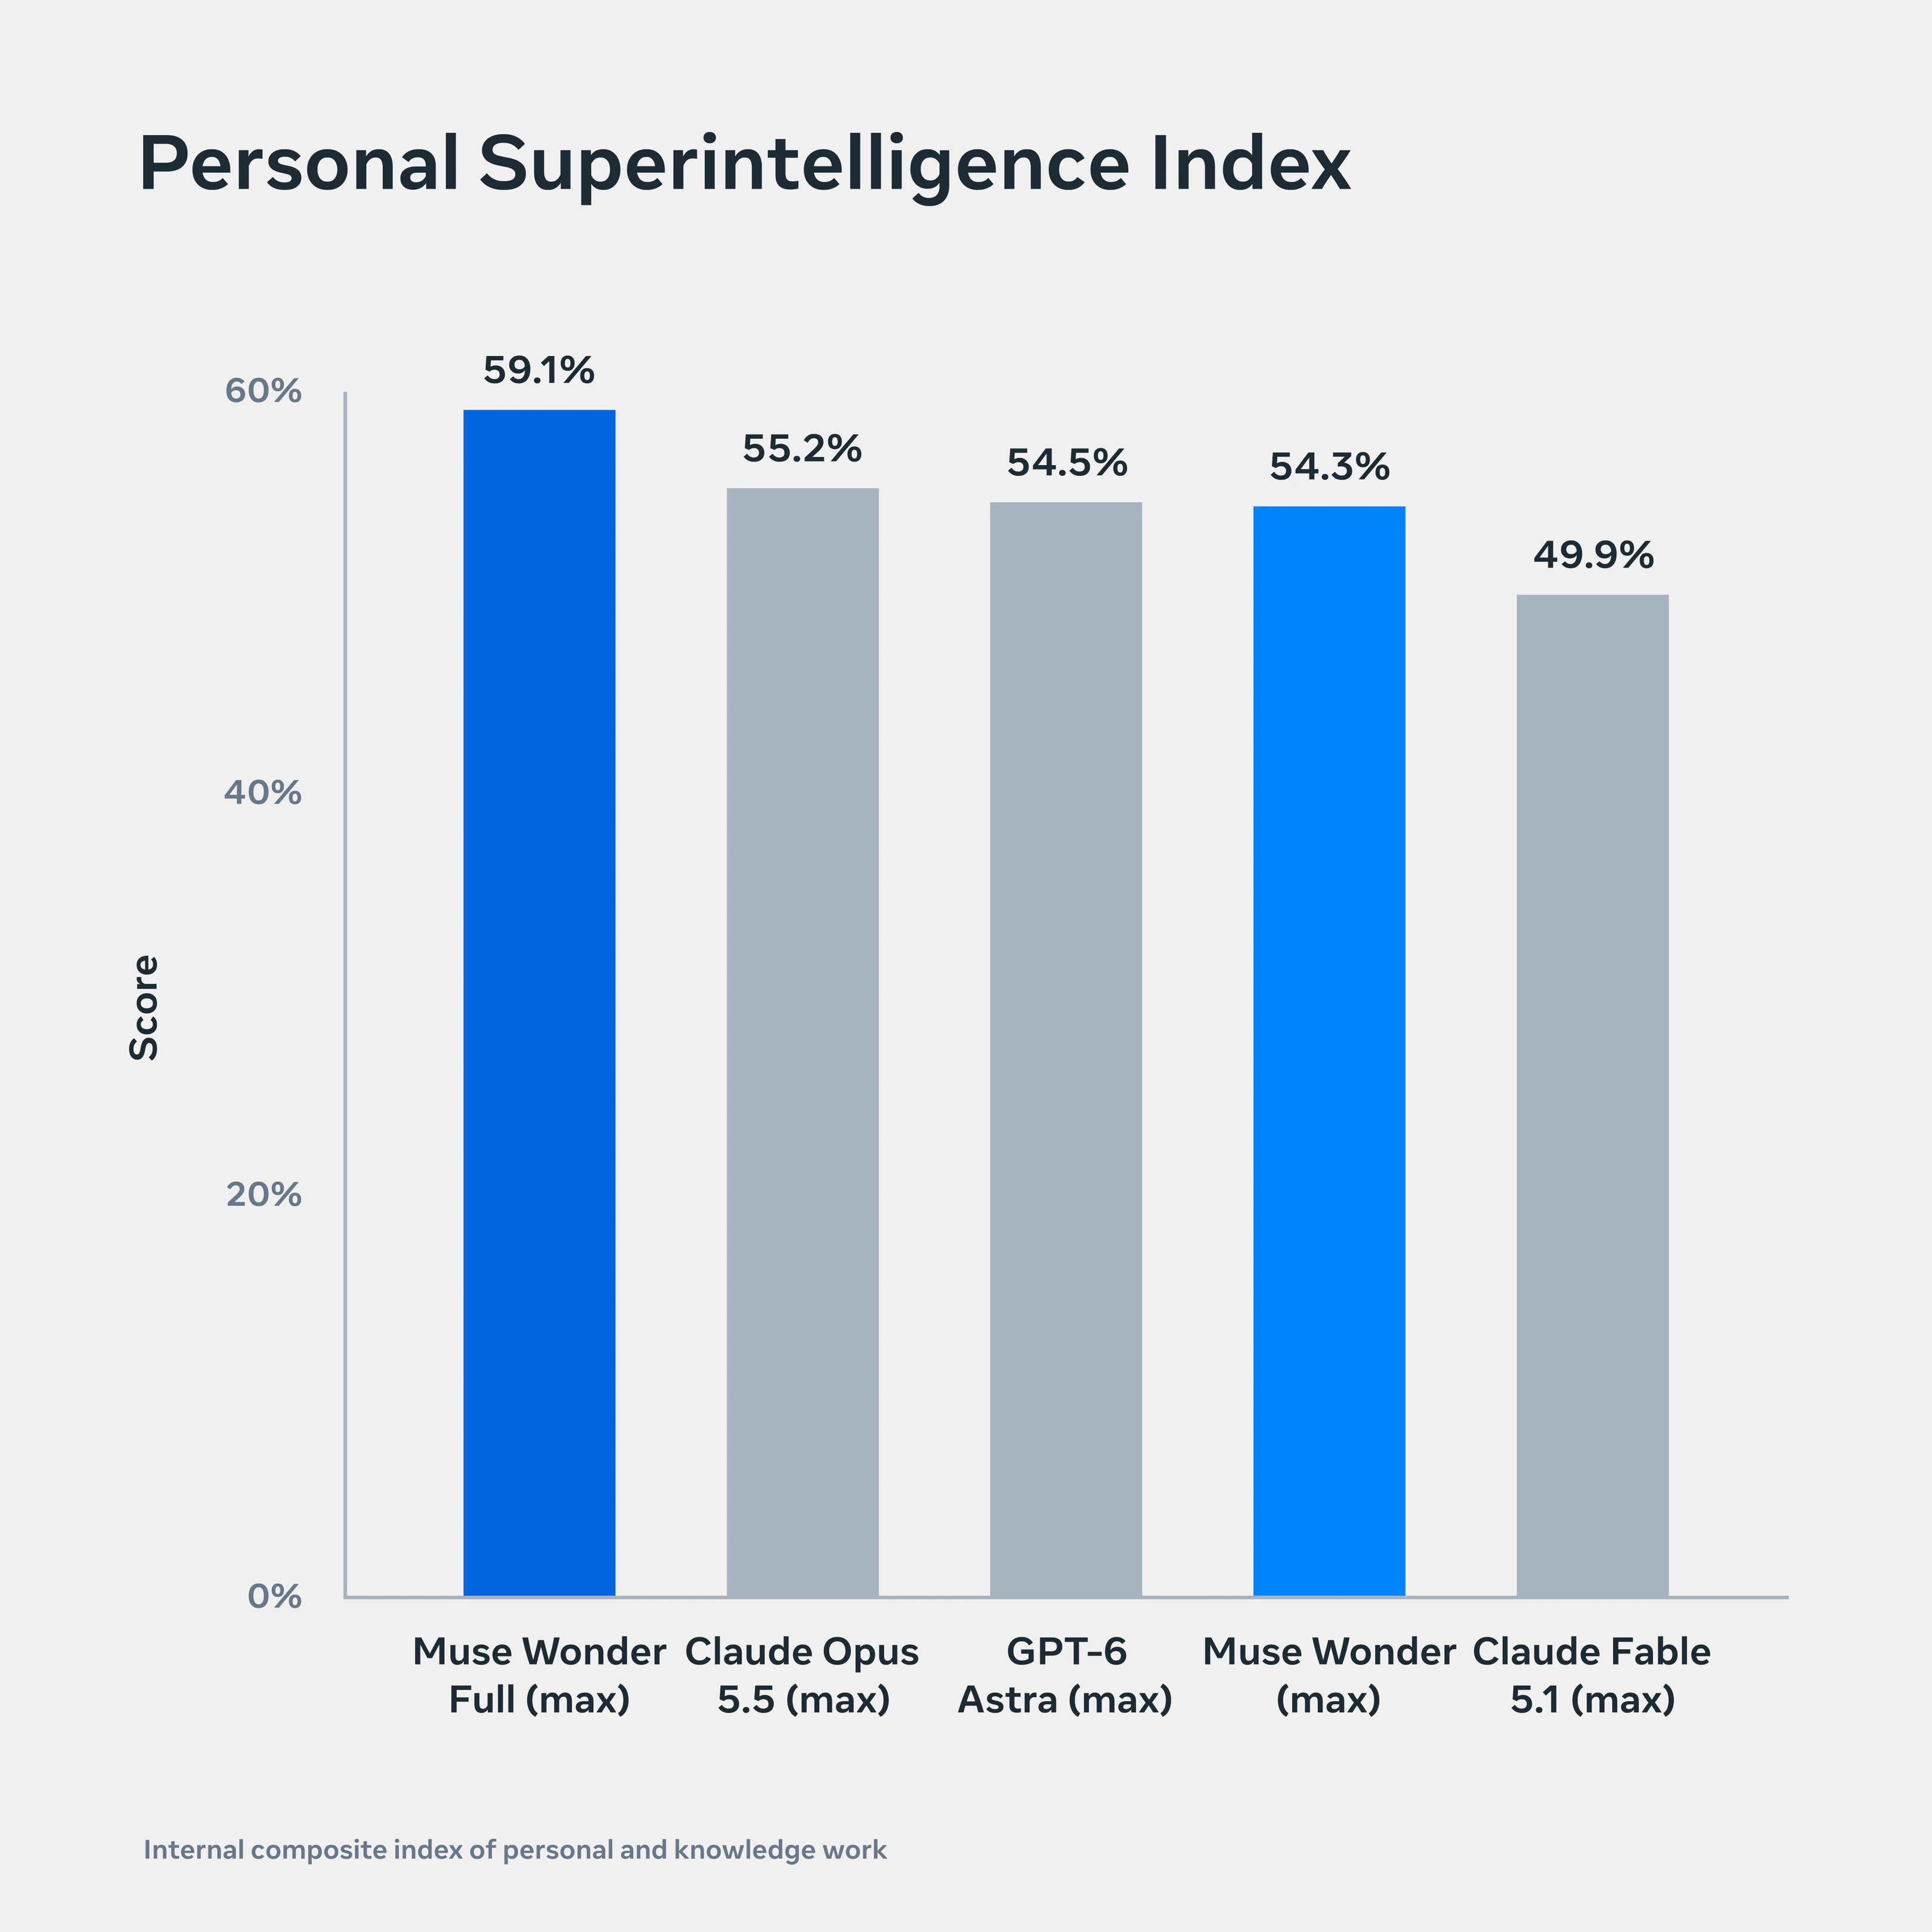

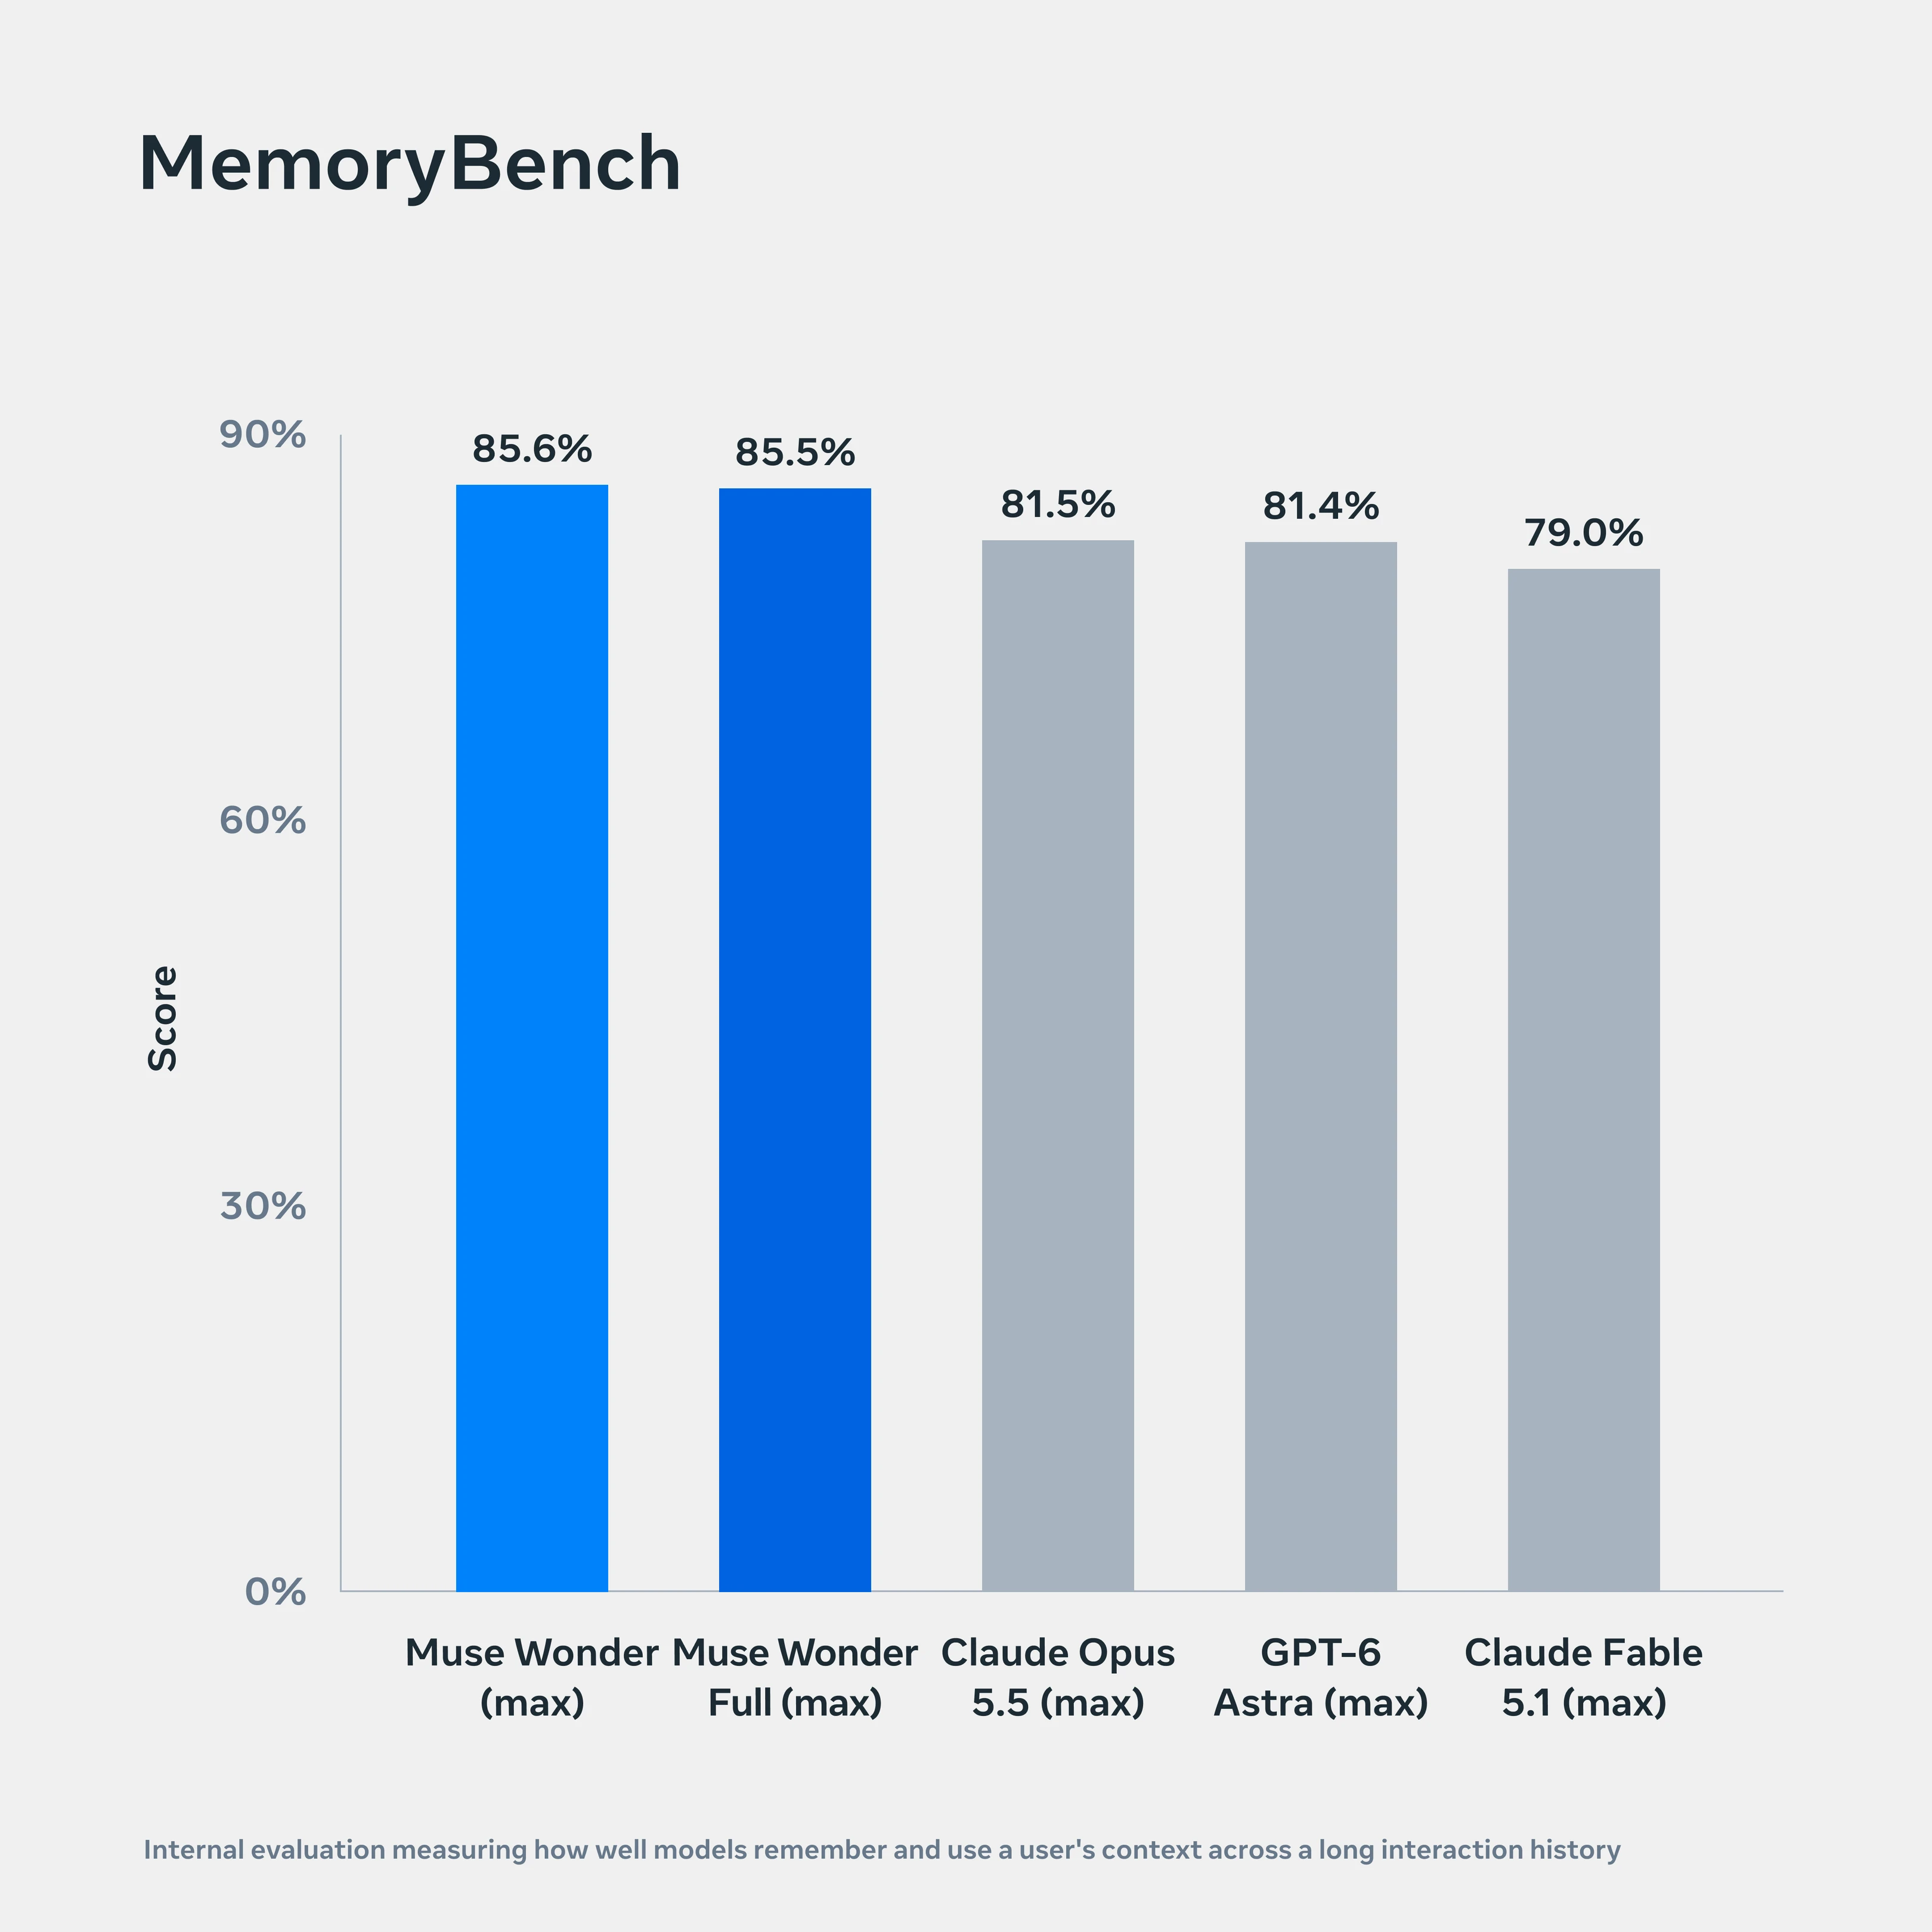

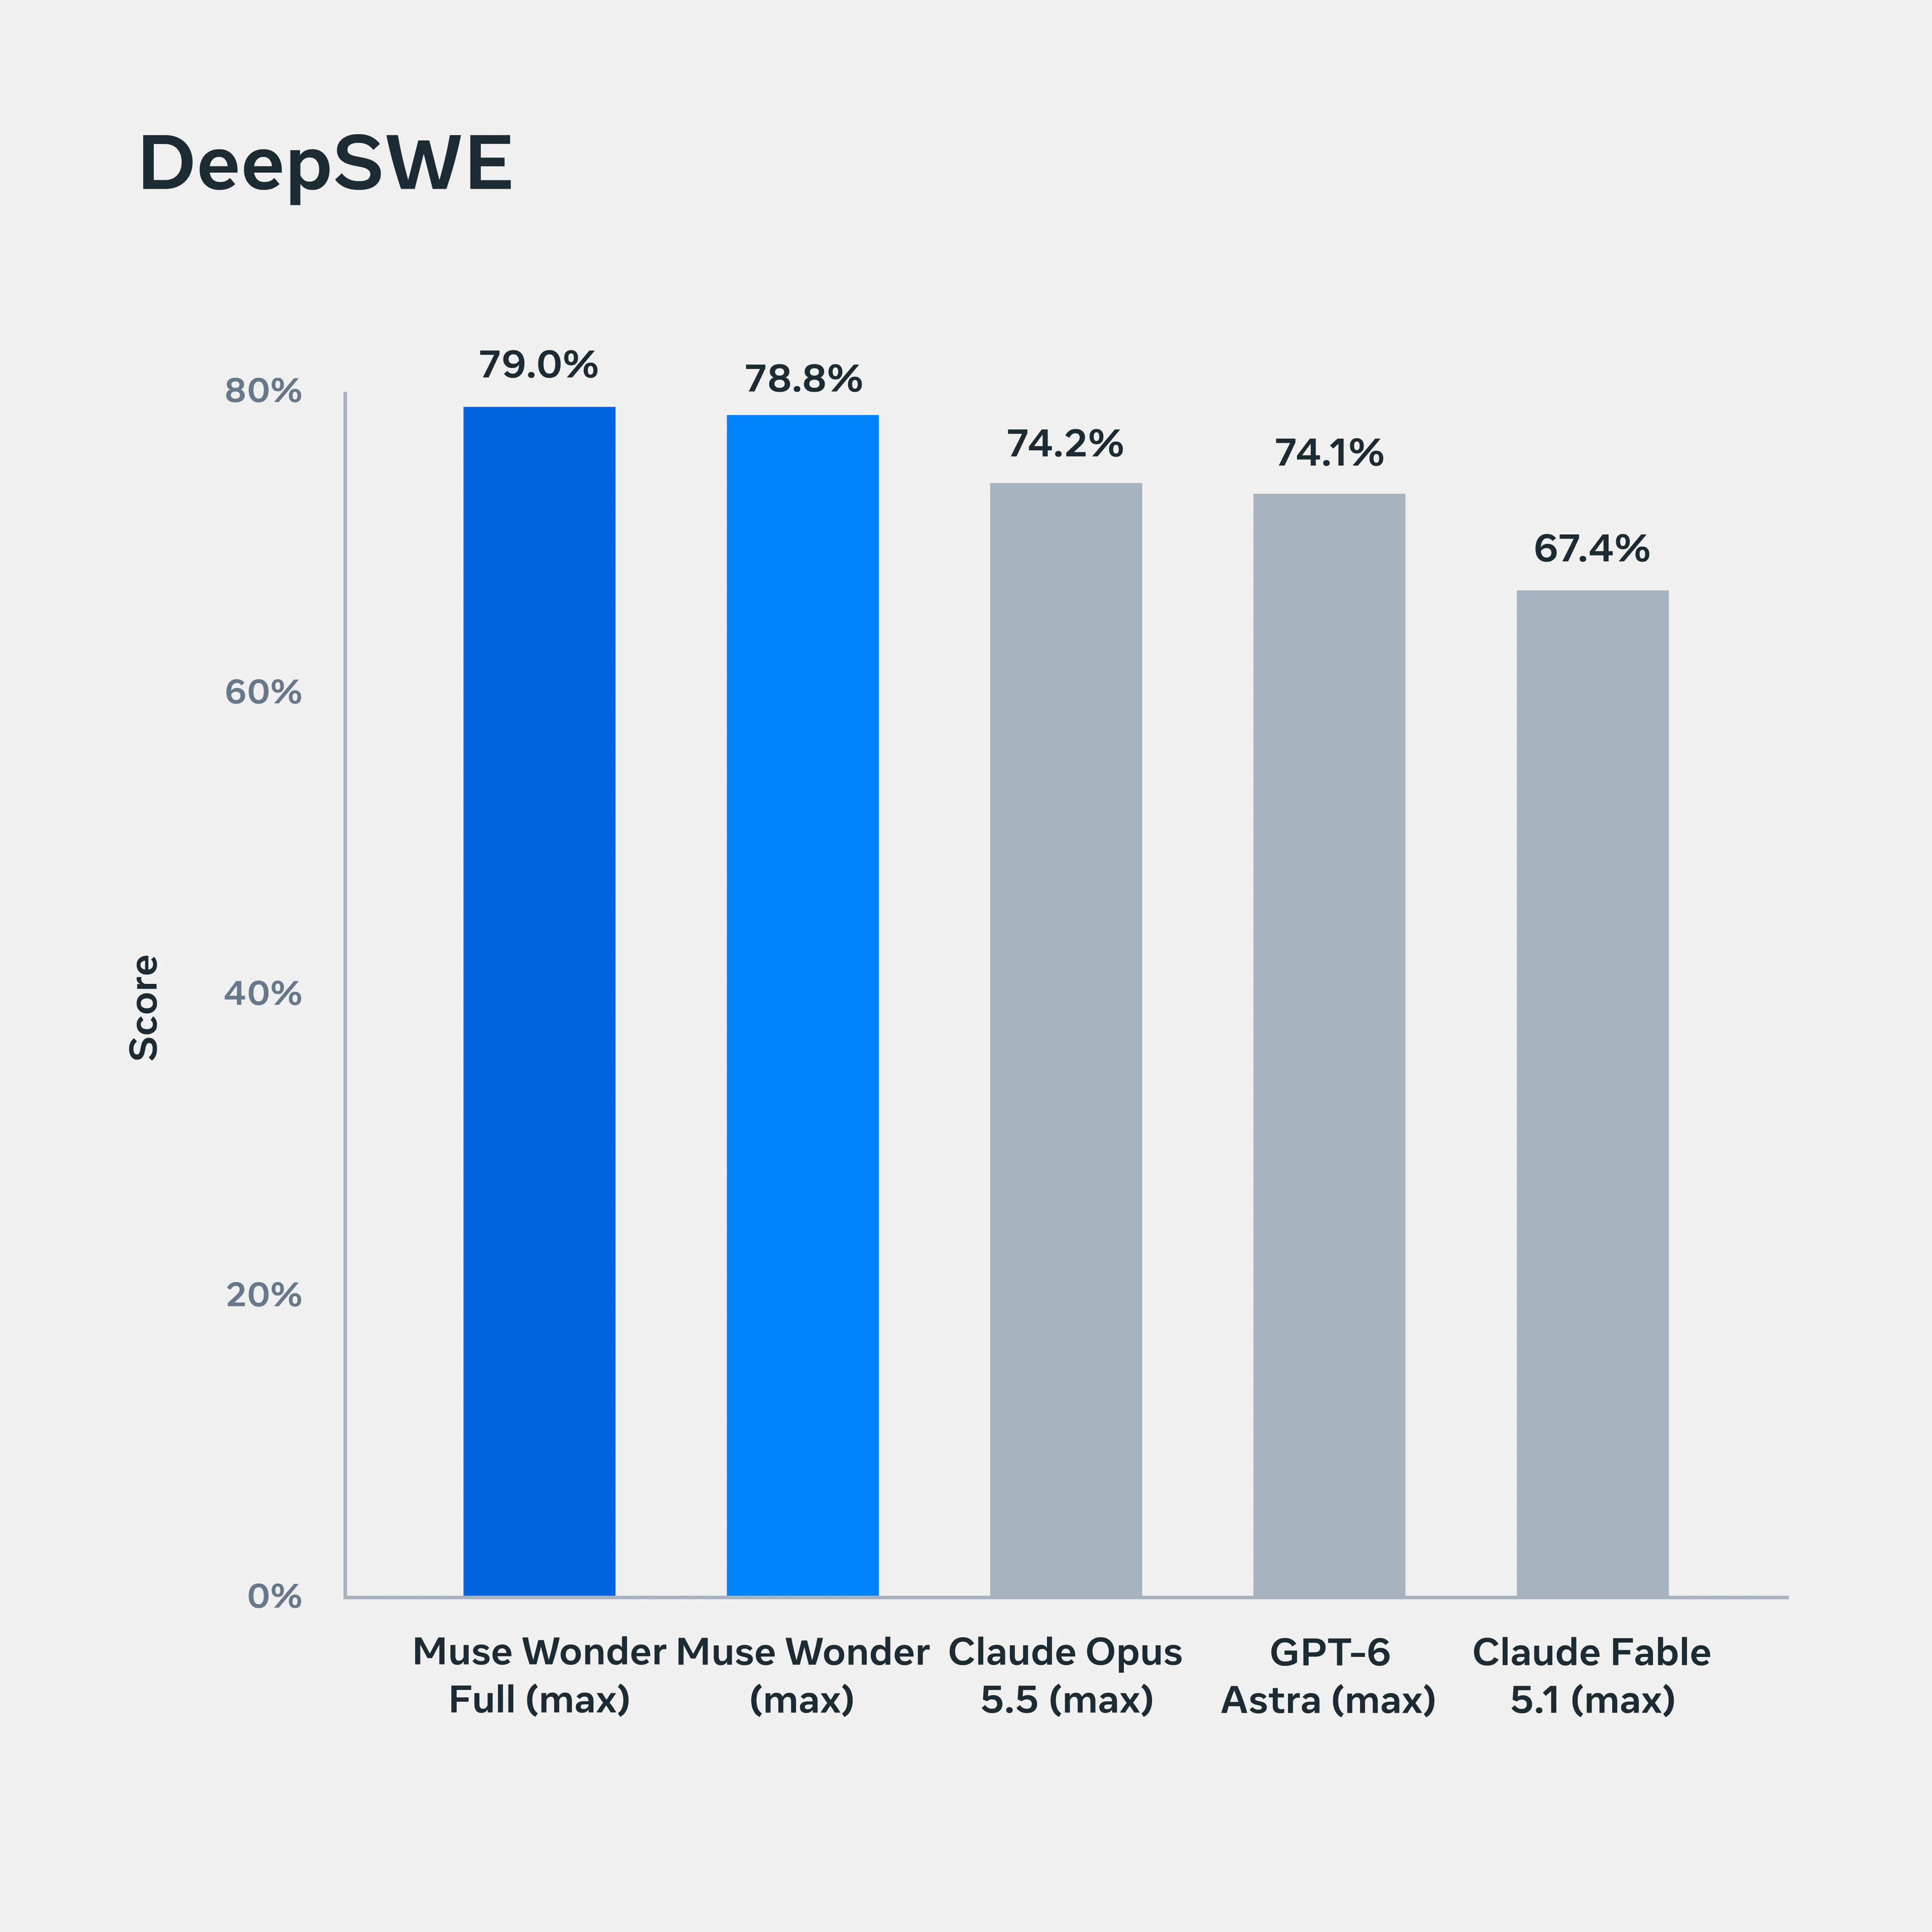
下面的完整结果在广泛的评测集上比较了 Muse Wonder、Muse Wonder Full 与其他前沿模型。
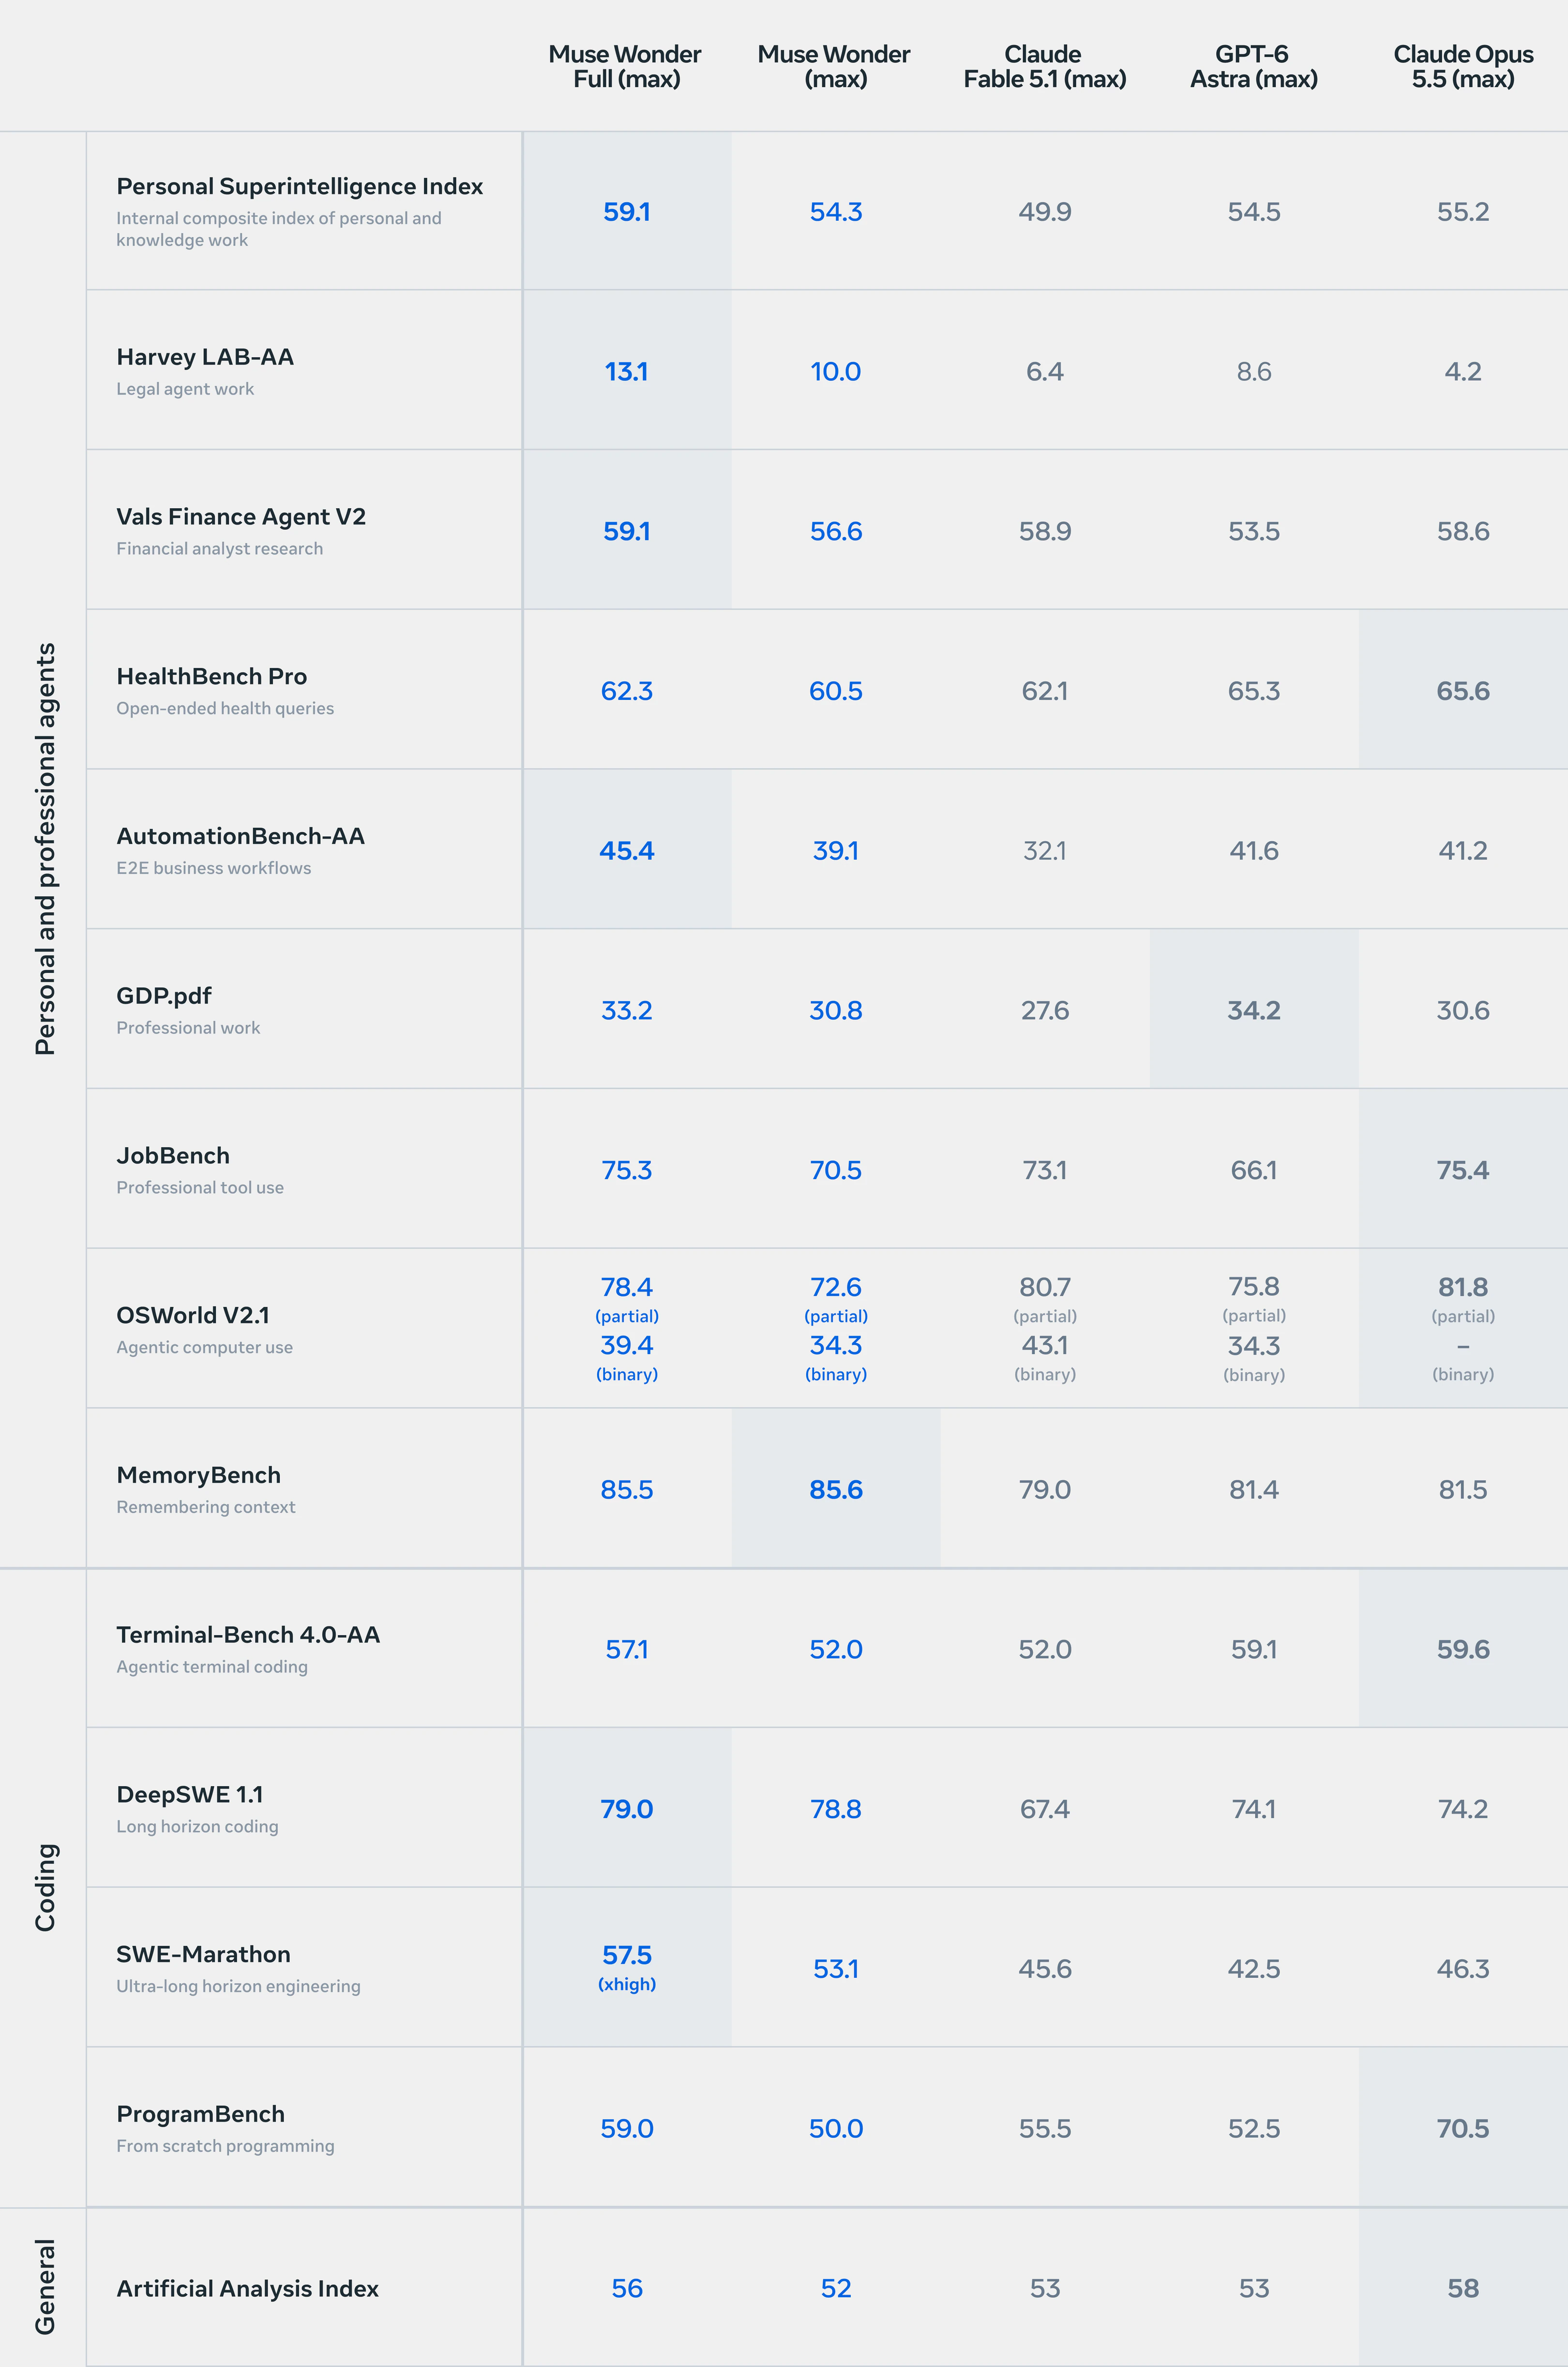
有关评估的更多细节,请参见我们的报告。
以上结果提供了模型性能的宏观视图。现在我们进一步关注它们在现实任务中四个核心领域:领域专业能力、Active Memory、Active Focus 和前沿编程。
领域专业能力
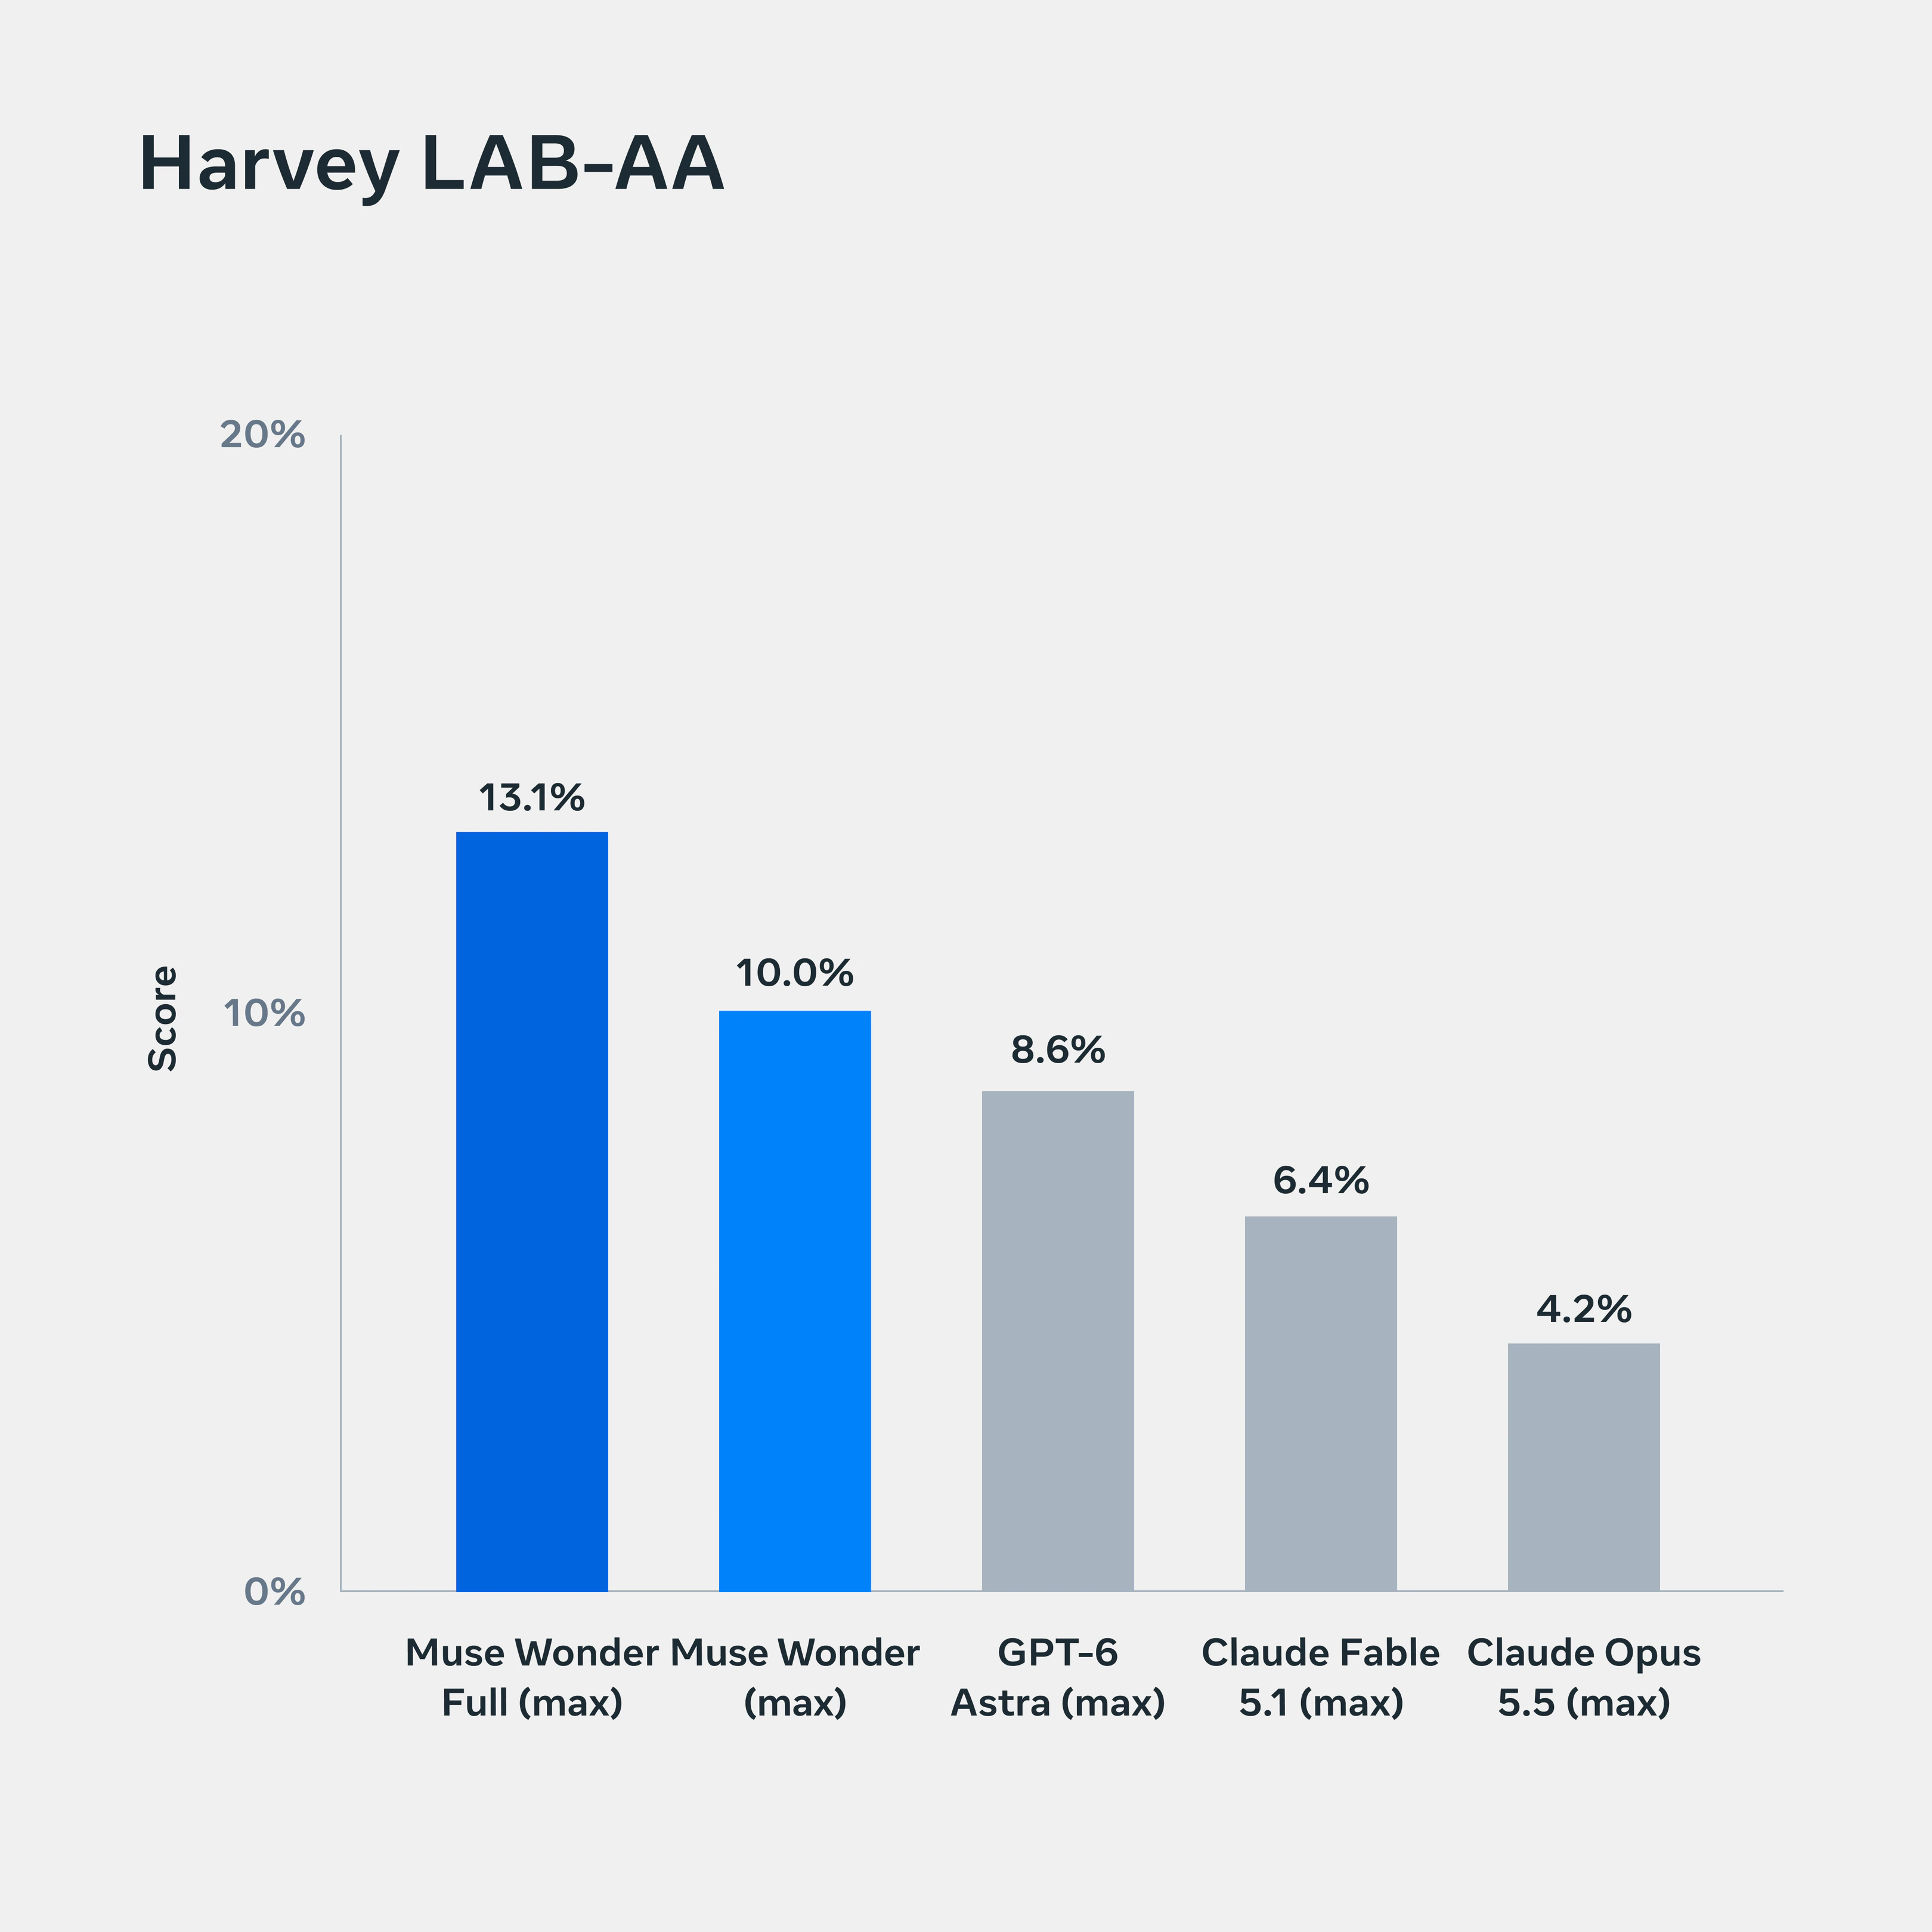
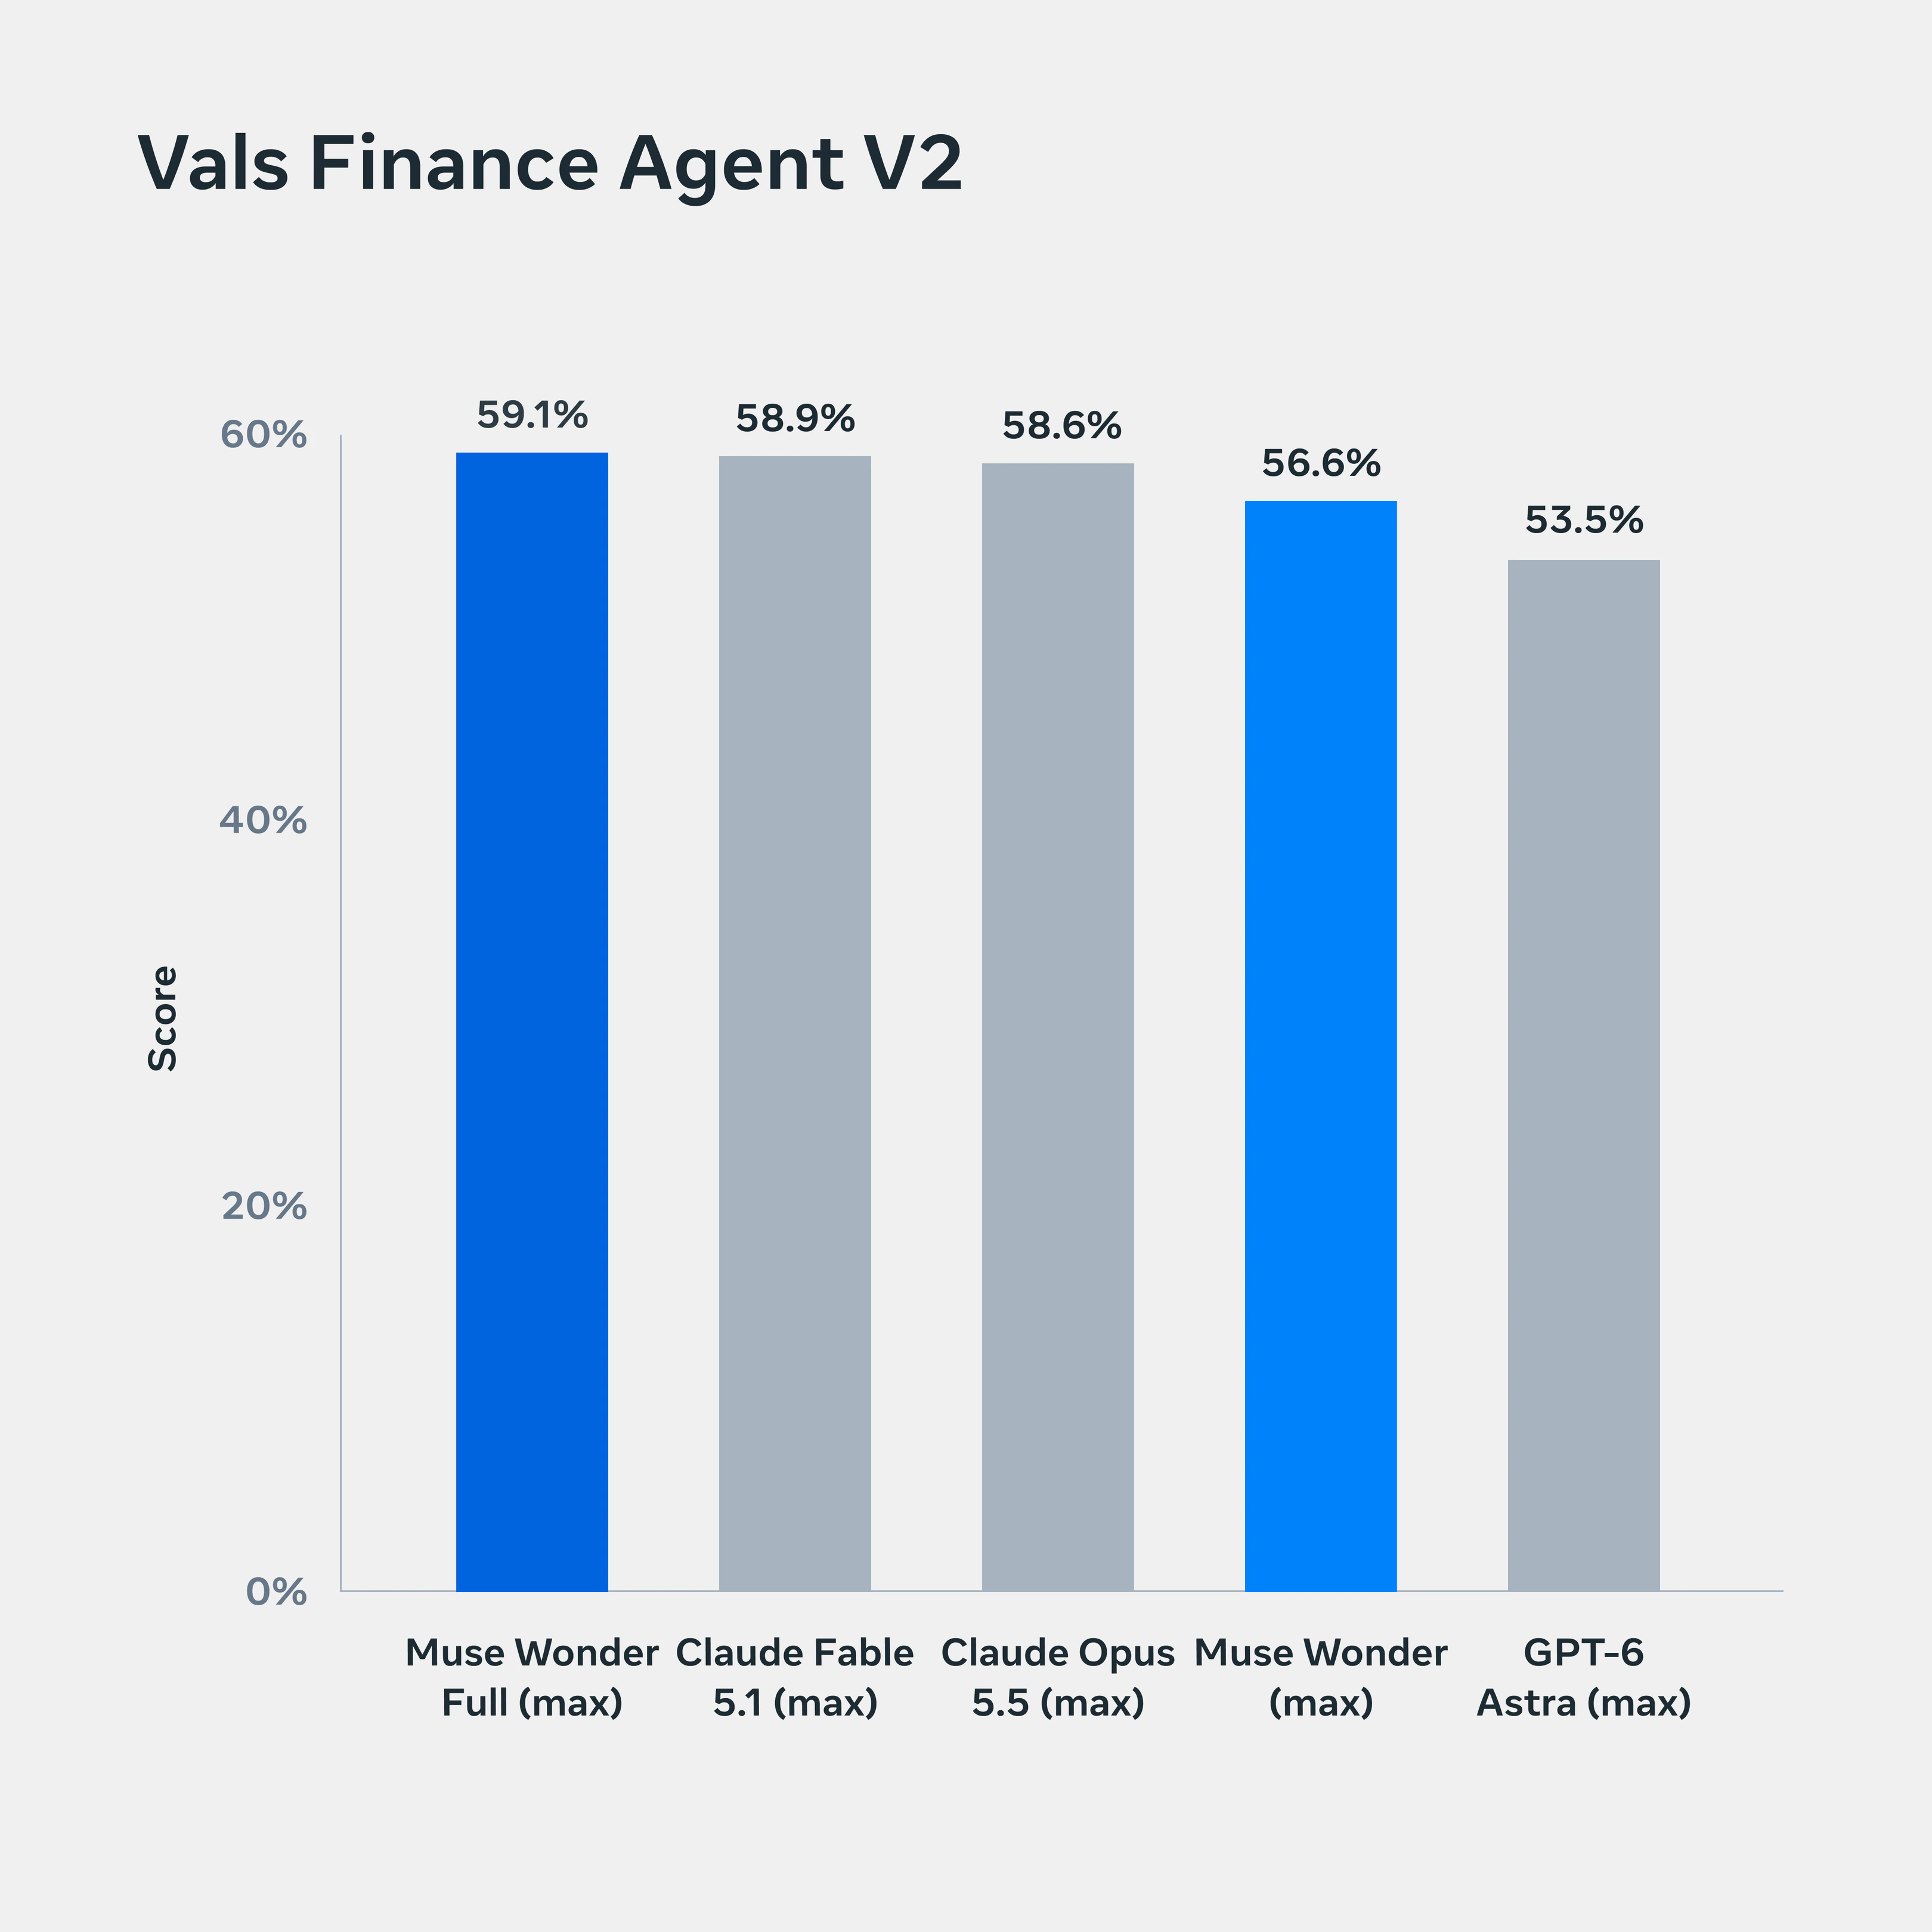
Muse Wonder 和 Muse Wonder Full 将专业知识应用于人们在工作和日常生活中遇到的问题,从理解租约,到理清财务或健康信息。我们的评估包含法律、金融和健康领域的任务来测试这项能力。例如,Harvey’s Legal Agent Benchmark(LAB)要求模型处理原始文档并遵循详细指令,产出法律工作成果。
主动记忆(Active Memory)
迈向有用的个人与专业智能体,最关键的步骤之一就是可靠的记忆。模型需要记住重要的事,并识别出先前信息何时变得相关。我们将这一能力称为 Active Memory(主动记忆):在不同对话之间携带关于你的重要上下文,并主动检索与当前任务相关的细节。
主动专注(Active Focus)
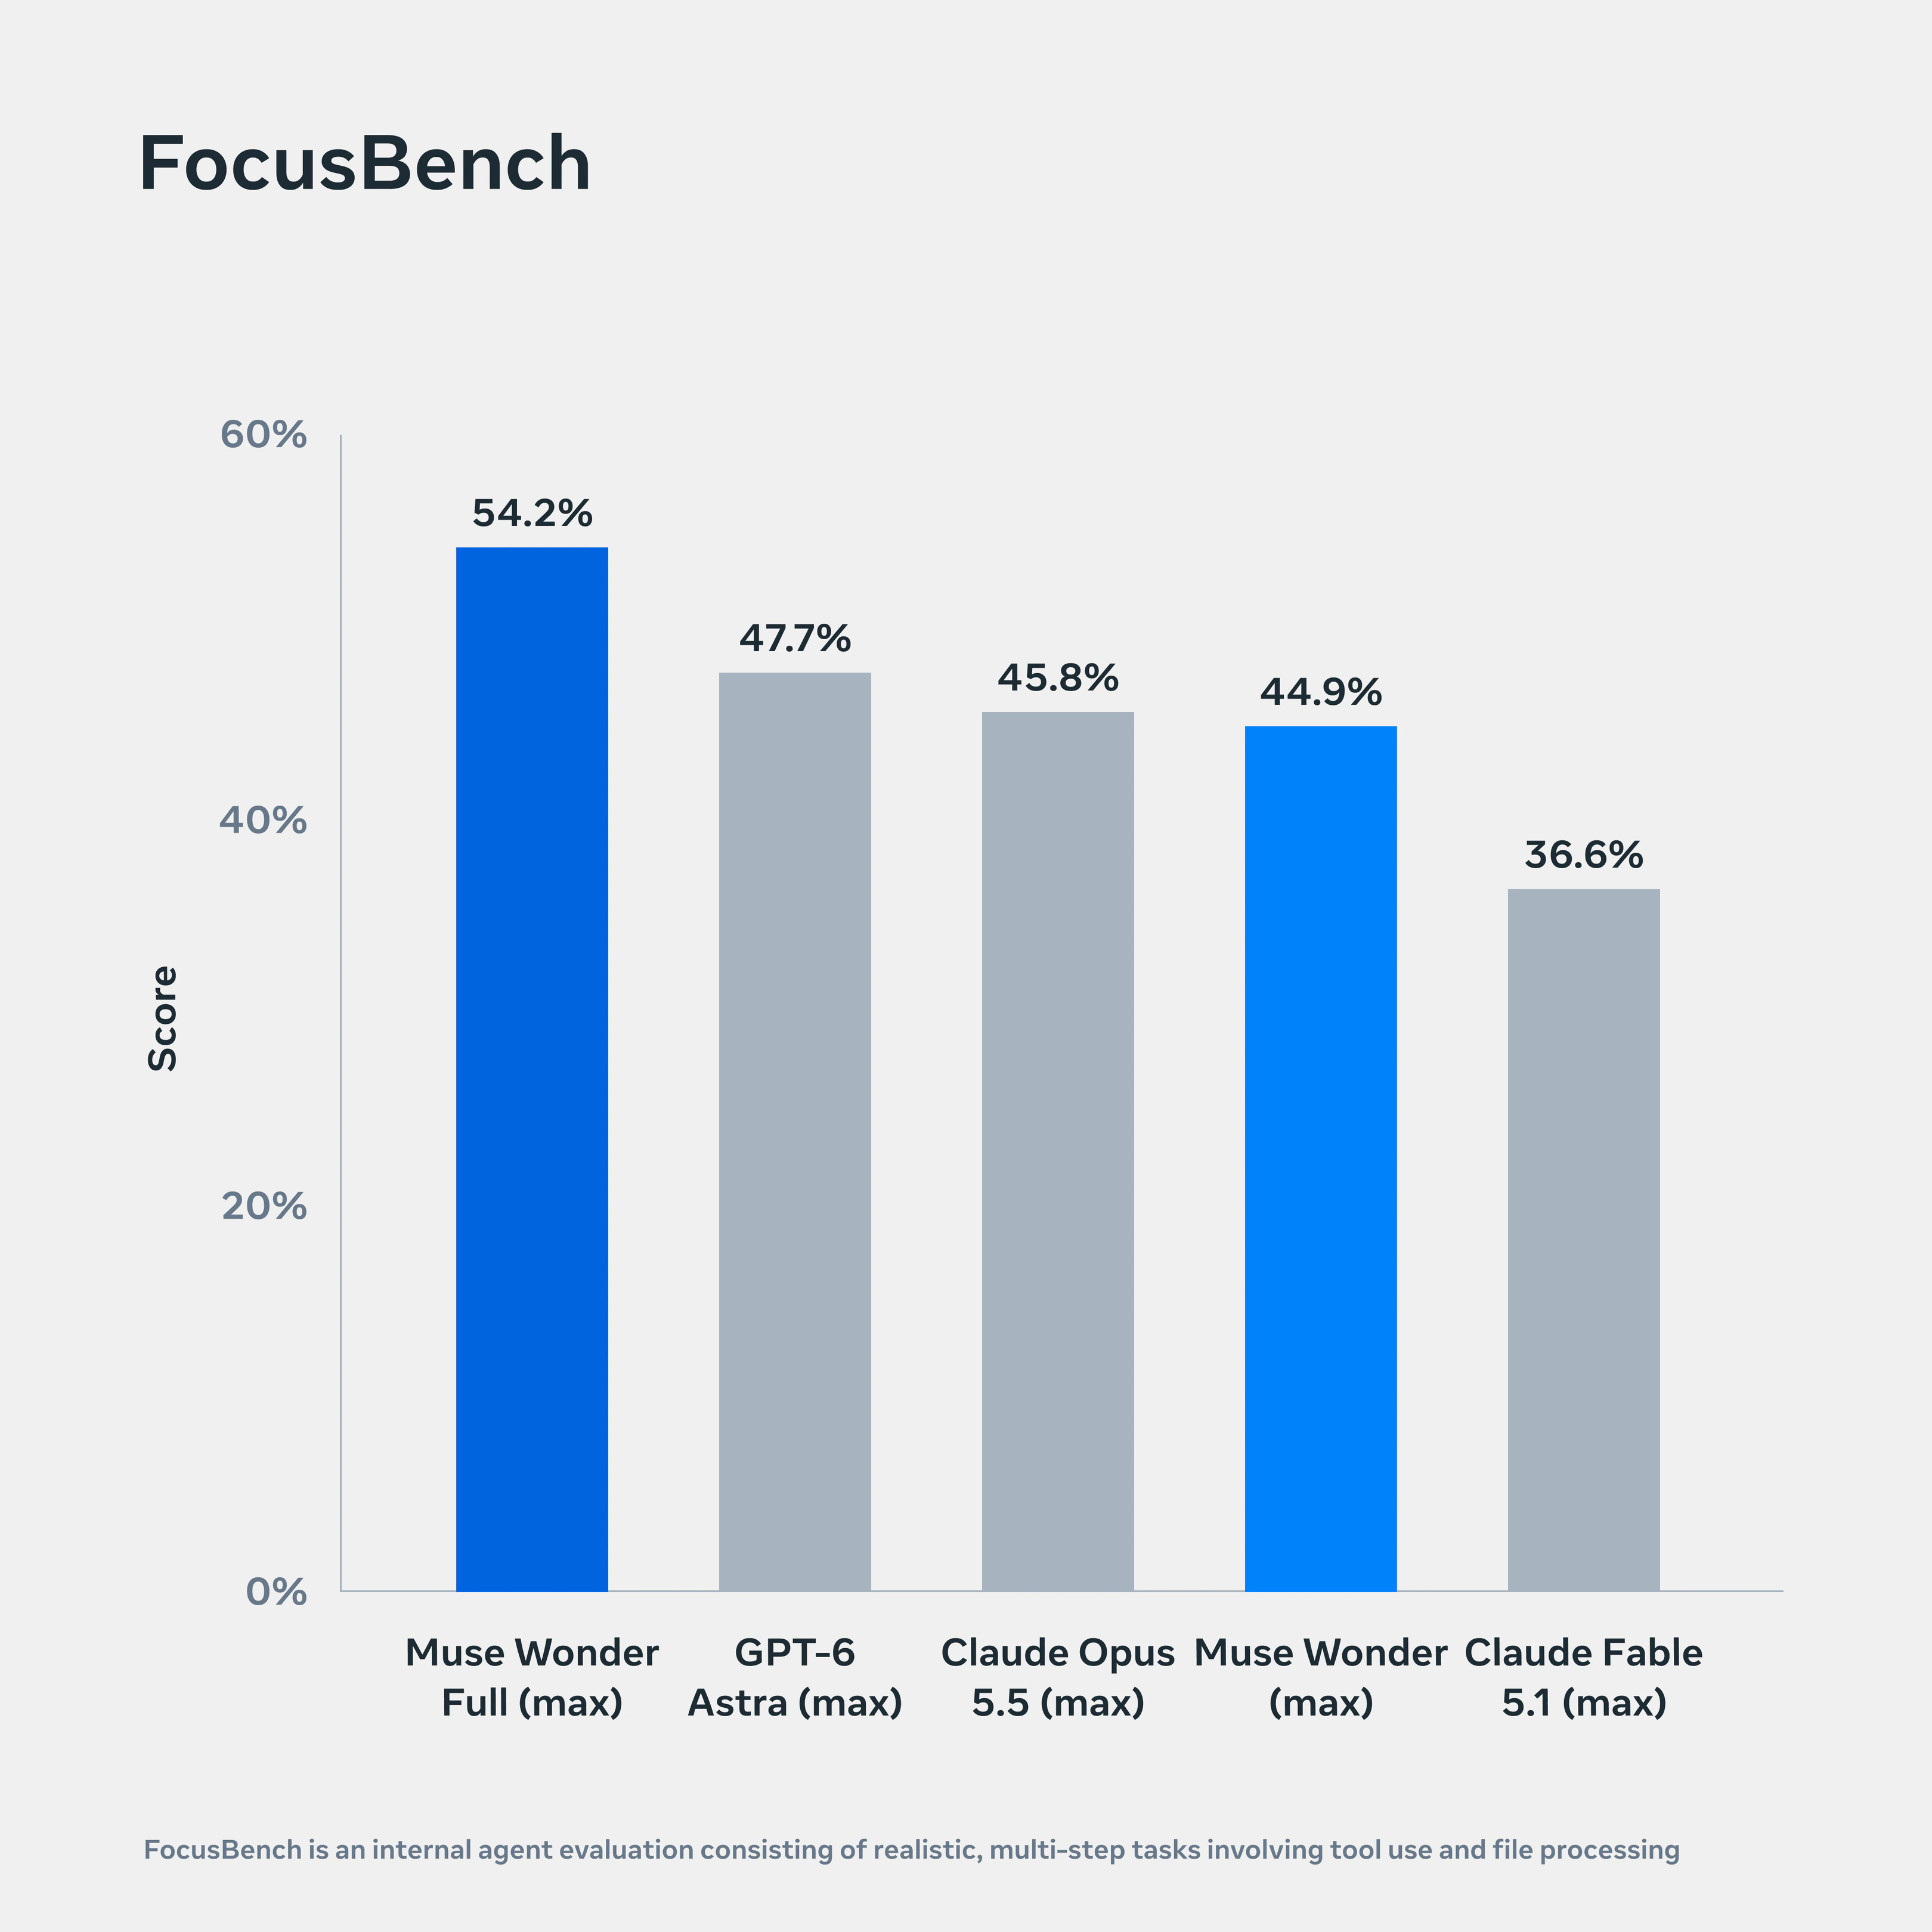
利用这些上下文来完成任务,还需要持续的努力。Active Focus(主动专注)描述了 Muse Wonder 如何朝着有挑战性的目标持续工作:尝试替代方案、克服阻碍、并适应新信息。在此过程中,它会在需要时请求澄清,并在采取重要行动前进行确认。我们通过 FocusBench 评估专注力,通过 SWE-Marathon 评估持续执行能力,后者测试的是在长期软件项目上的工作。
前沿编程
编程将这些能力结合在了一起。构建软件需要跟踪需求、在整个代码库中进行修改,并经历反复的测试与修订循环。Muse Wonder 和 Muse Wonder Full 提供了前沿的编程性能,支持从小型应用到复杂软件的各种项目。我们在多样化、长周期的任务上训练这两个模型,帮助它们在这一过程中保持进展。
Muse Wonder 可根据可定制的图像输入,构建一个可玩的 3D 厨房游戏。
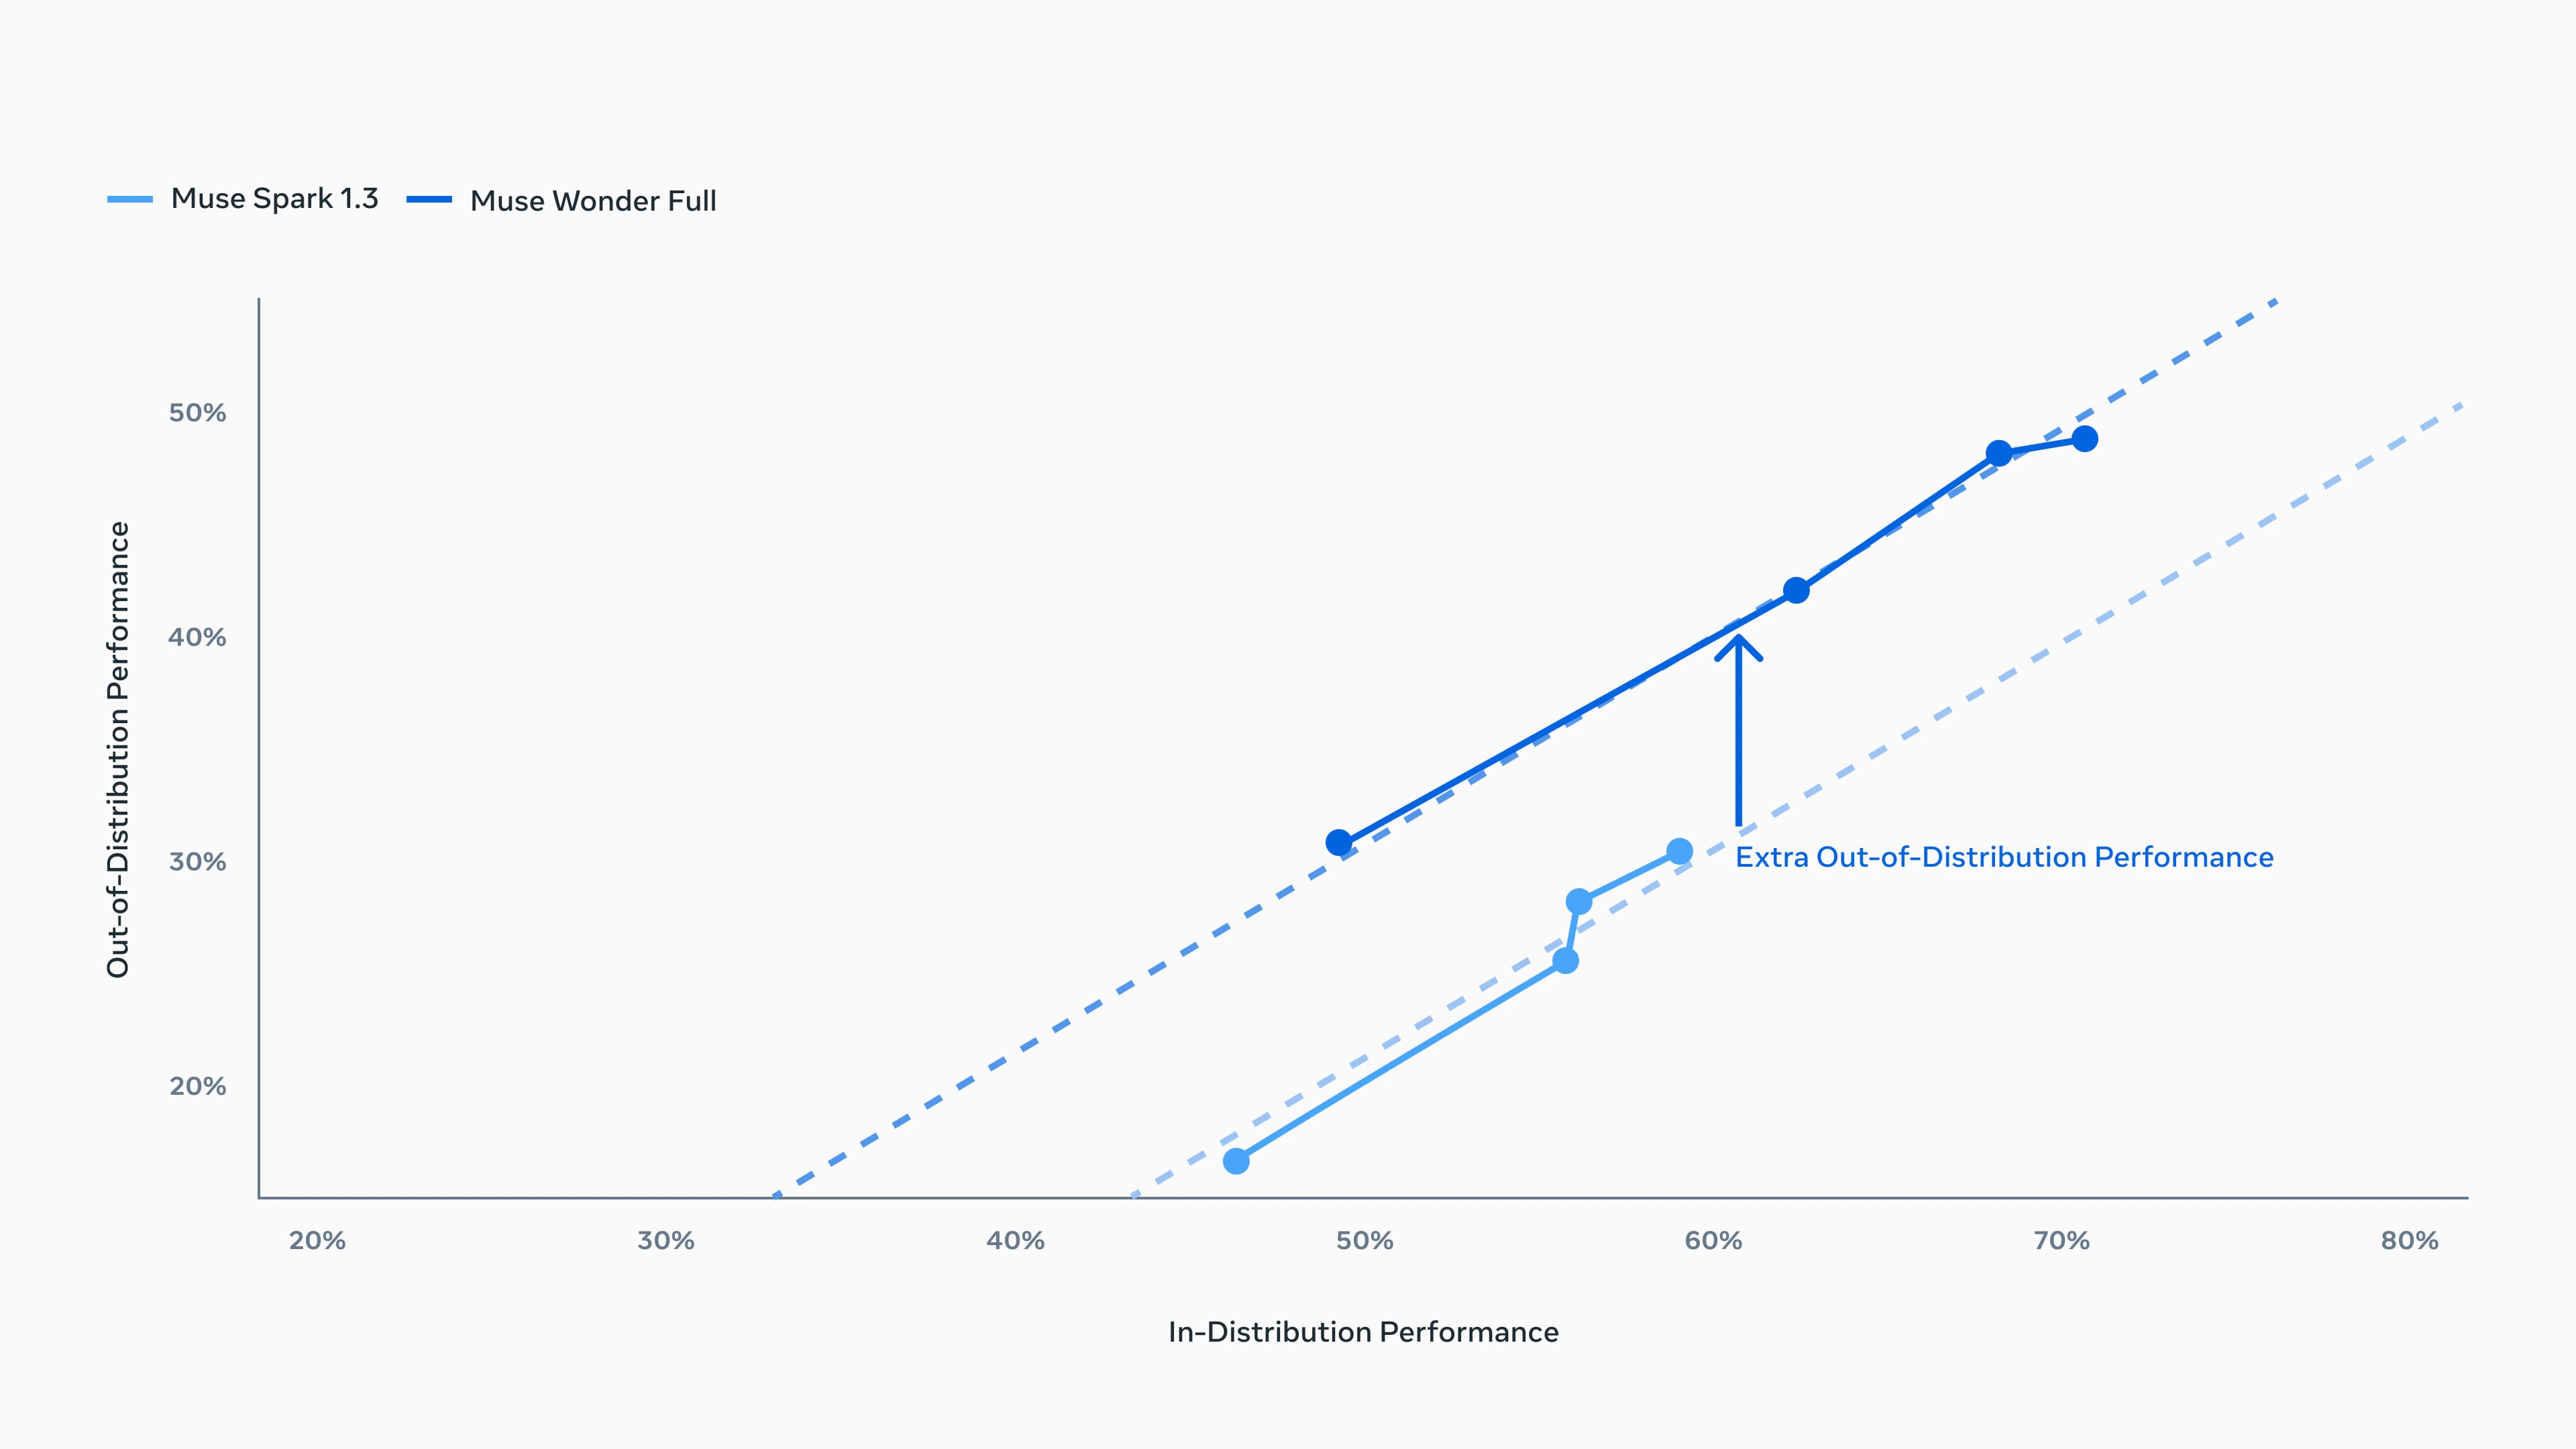
两个模型常常取得相似的基准分数,但其中一个似乎能处理更广泛的陌生任务。这正是关于“benchmaxxing”的批评与对“big model smell”的称赞共同指向的:一种在少数领域的流行基准无法完全捕捉的能力广度。
为了量化这种不匹配,我们研究了随着测试时计算的扩展,后训练阶段针对的任务表现与陌生任务表现之间的关系。下图比较了 Muse Spark 1.3 和 Muse Wonder Full,每个点代表在特定推理强度下的表现。横轴显示模型在后训练期间我们所关注任务的综合得分(“in-distribution”,分布内);纵轴显示在一组我们后训练期间未针对的任务上的平均得分(“out-of-distribution”,分布外)。
随着测试时计算的扩展,我们的两个模型在分布外任务上的提升相似。但考虑到其分布内表现,Muse Wonder Full 在陌生任务上的表现甚至优于 Muse Spark 1.3 趋势所预测的水平。这种上移是因为 Muse Wonder 和 Muse Wonder Full 建立在更大、更强的基础模型之上:更强的基础使后训练增益能更有效地迁移到陌生任务。这种通用性对个人智能体尤其重要,因为它们需要处理目标、工具和约束的多种组合——而这些并非都能在训练期间被我们预见。
Muse Wonder 在 Saturday Run Planning 智能体演示中,直接在浏览器及各类应用里工作,根据个人偏好和具体情况制定跑步计划(地图数据 © OpenStreetMap 贡献者)。
将个人超级智能带给每个人,需要在对齐和安全上进行重大投入。个人智能体代表用户采取行动,并可能处理消息、日历和私人文档等上下文。这种级别的访问要求模型对私人信息谨慎行事,并抵抗滥用。我们训练 Muse Wonder 系列在这两个维度上领先,使其具备对对抗性指令的鲁棒性,并谨慎处理私人信息。
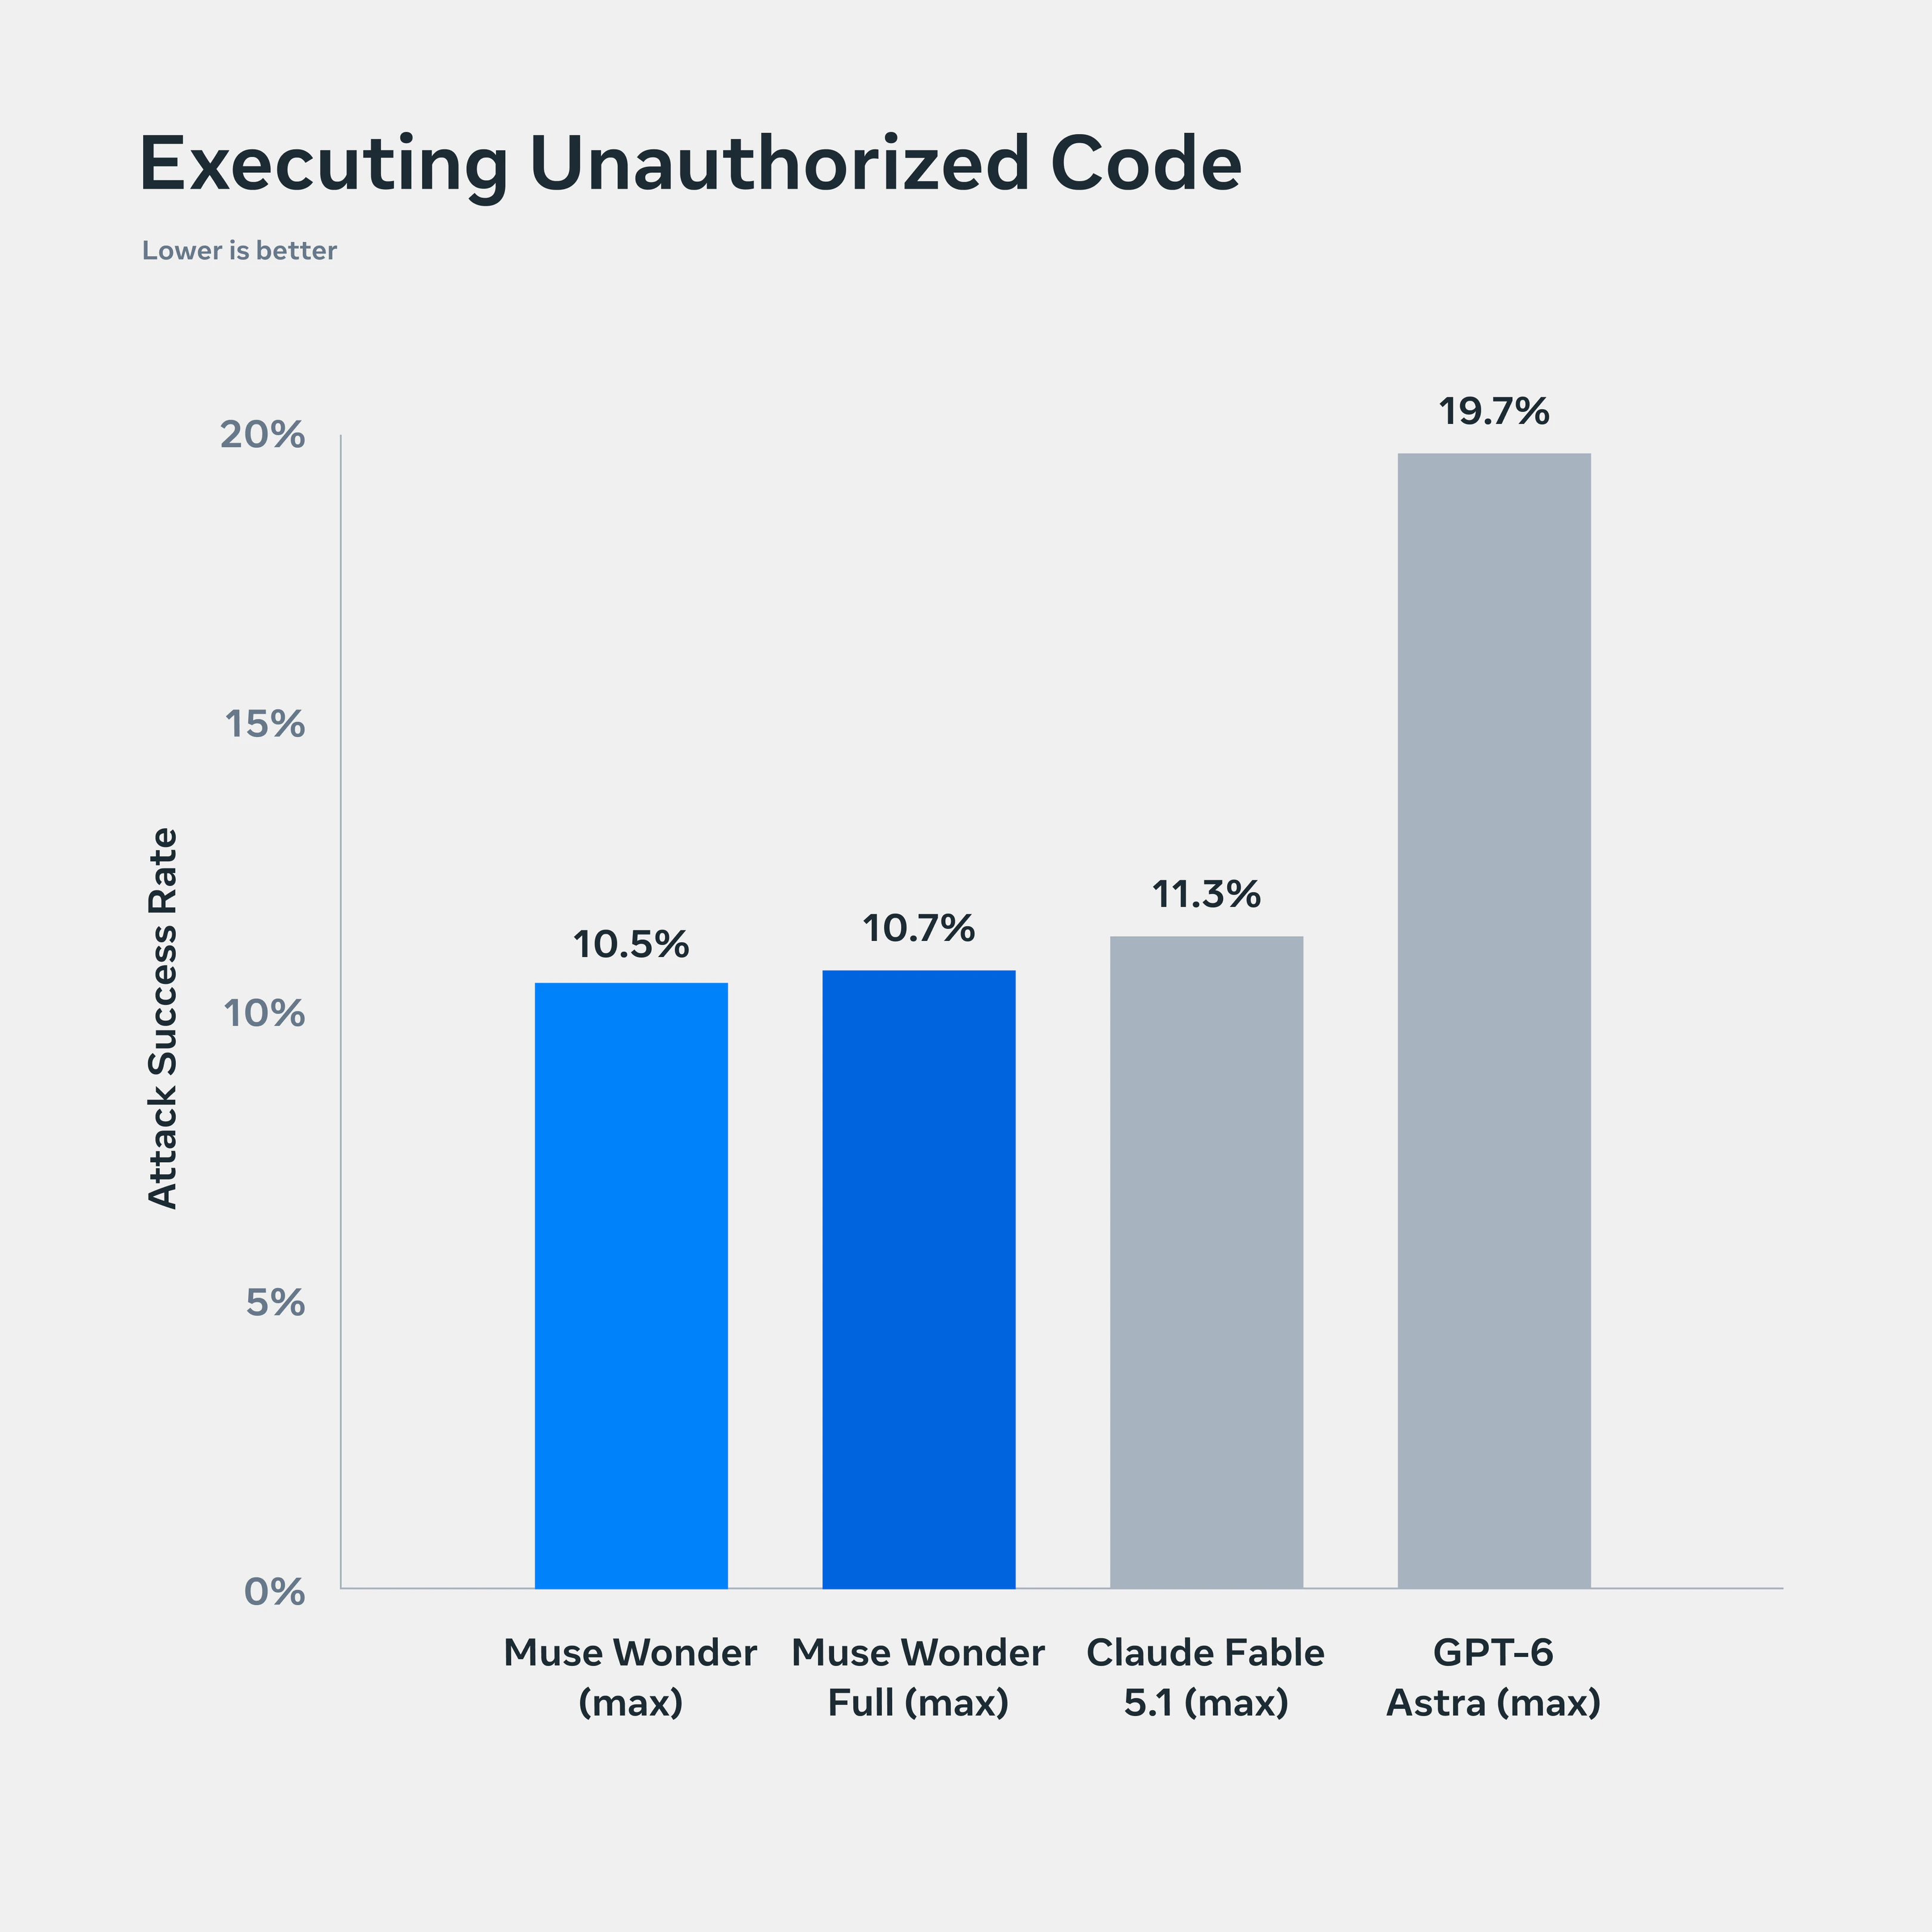
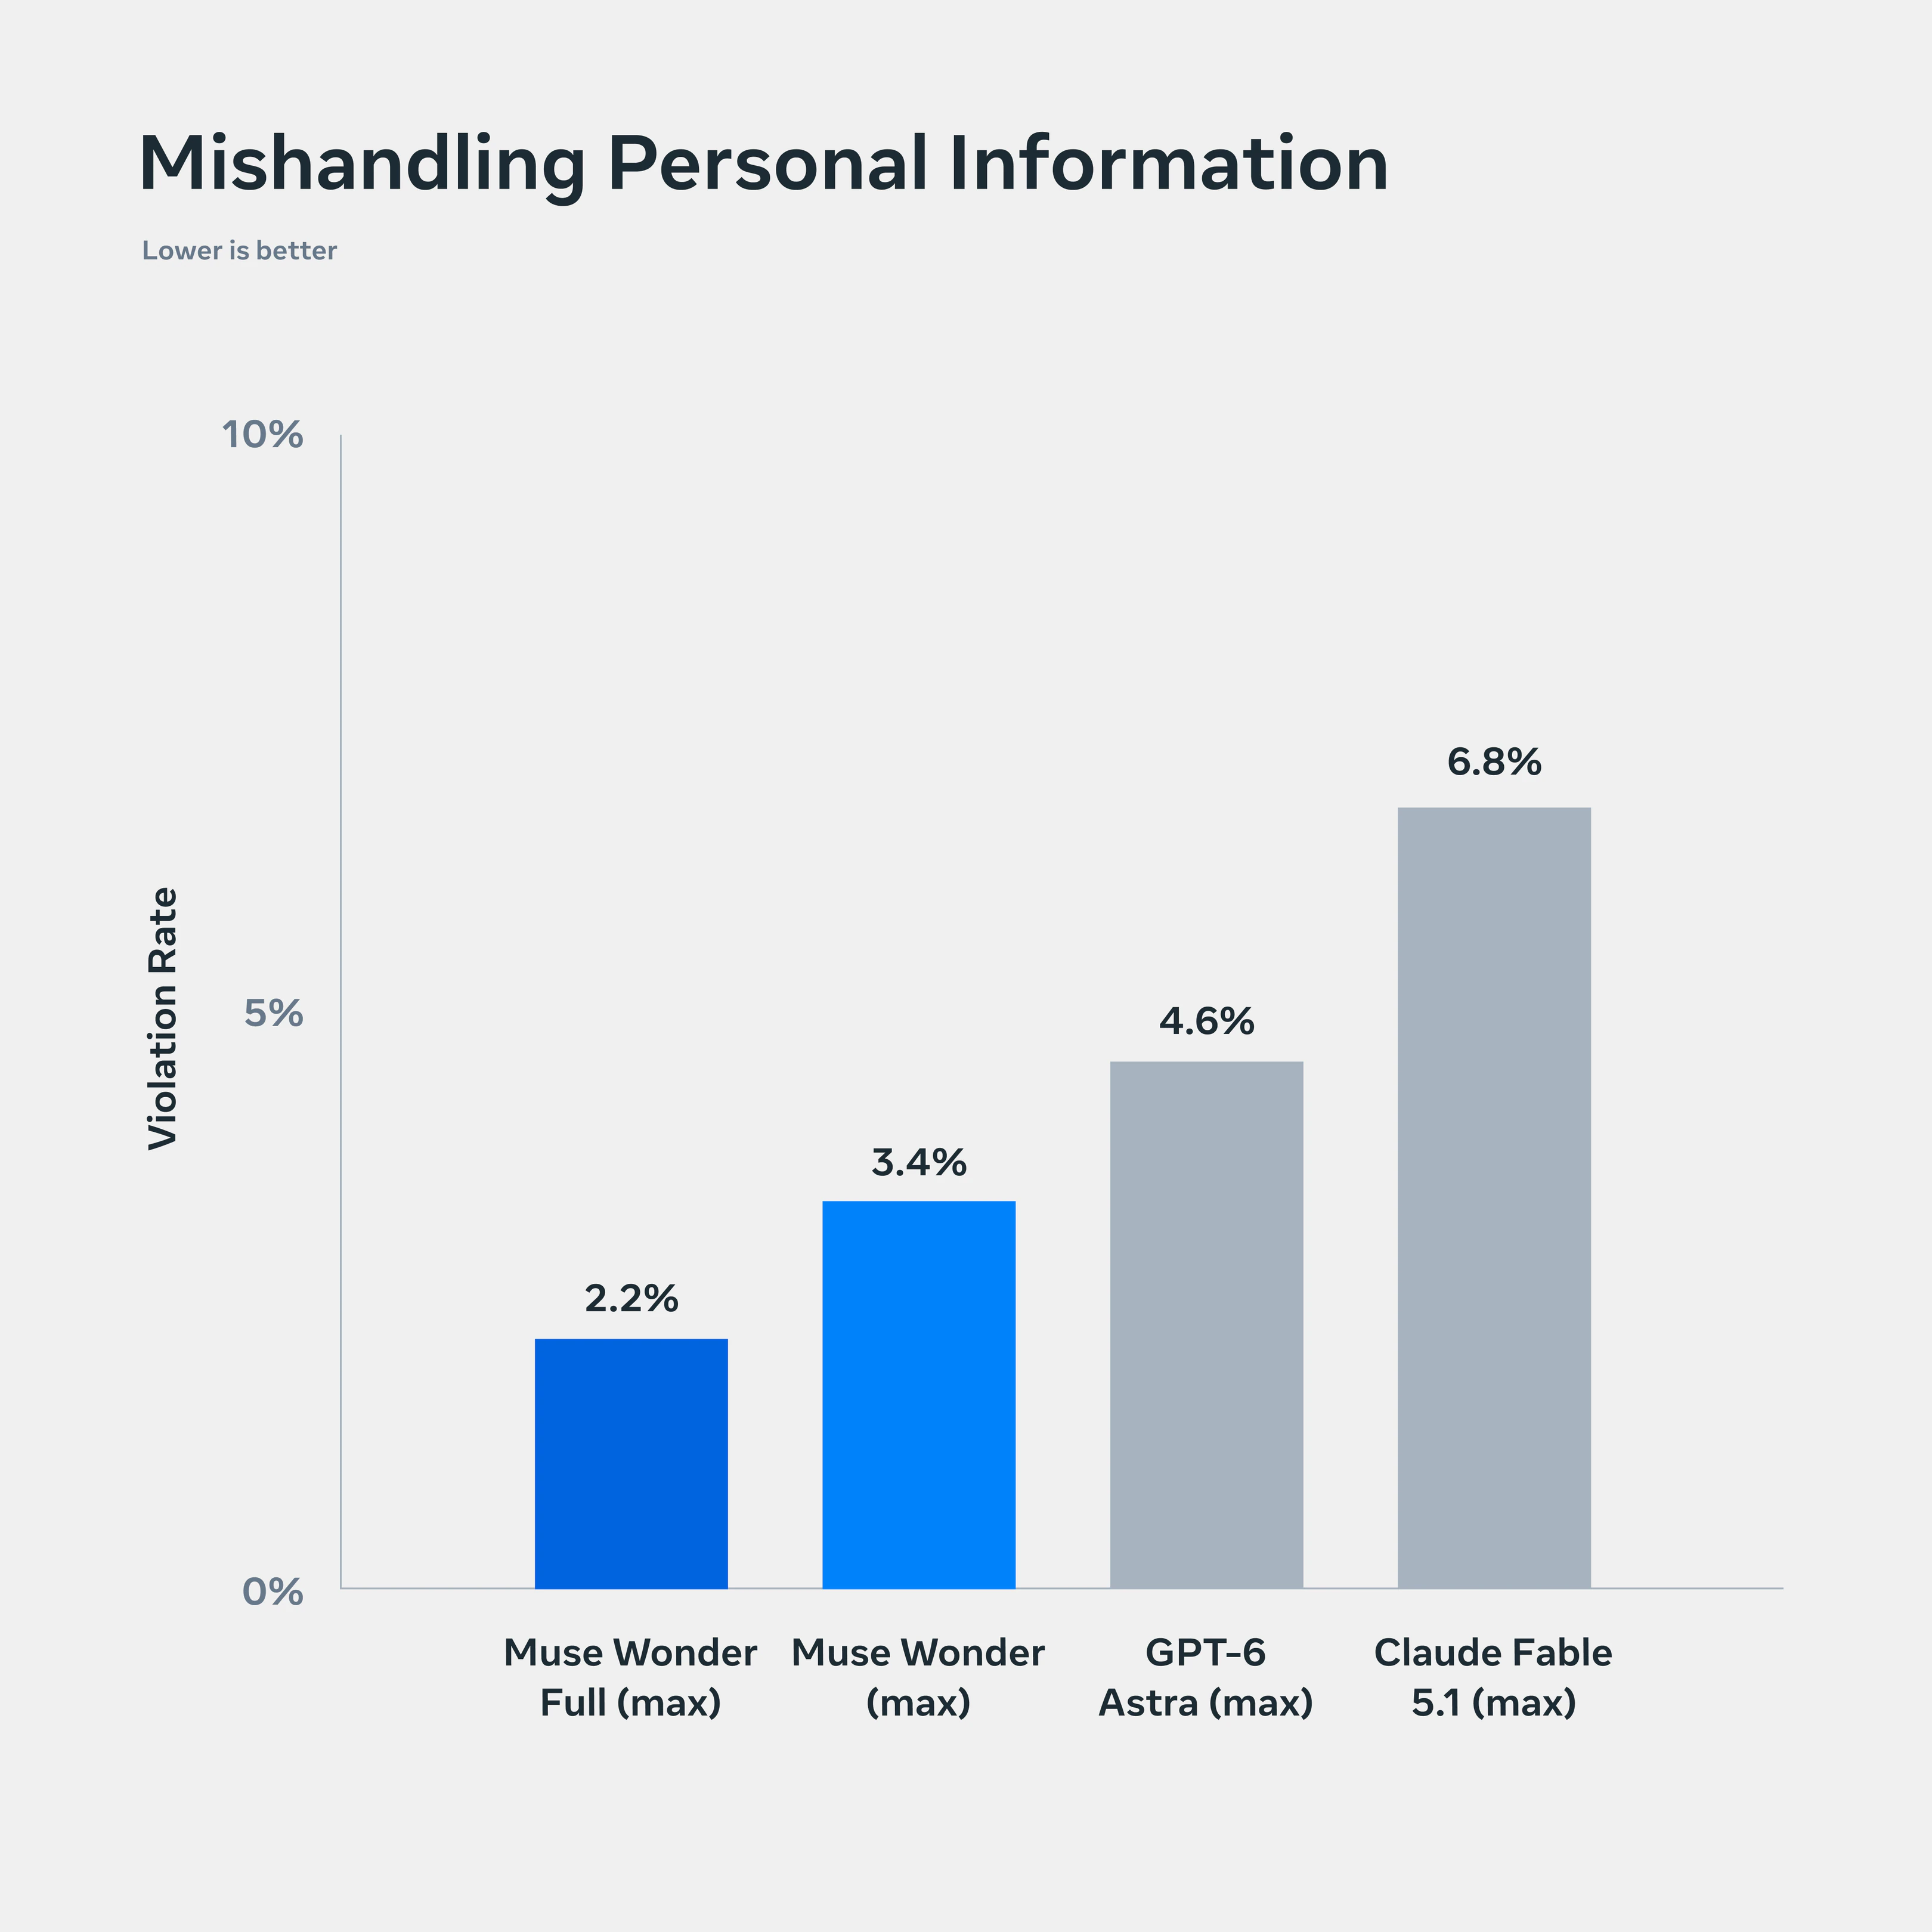
随着模型能力增强,我们的目标是帮助人们安全、负责任地利用这些能力。Muse Wonder 提供了我们迄今最强的防护措施,防范 CBRN(化学、生物、放射性和核)及网络滥用,同时根据我们的 Meta Superintelligence Scaling Framework,保留用于防御目的的前沿网络能力。
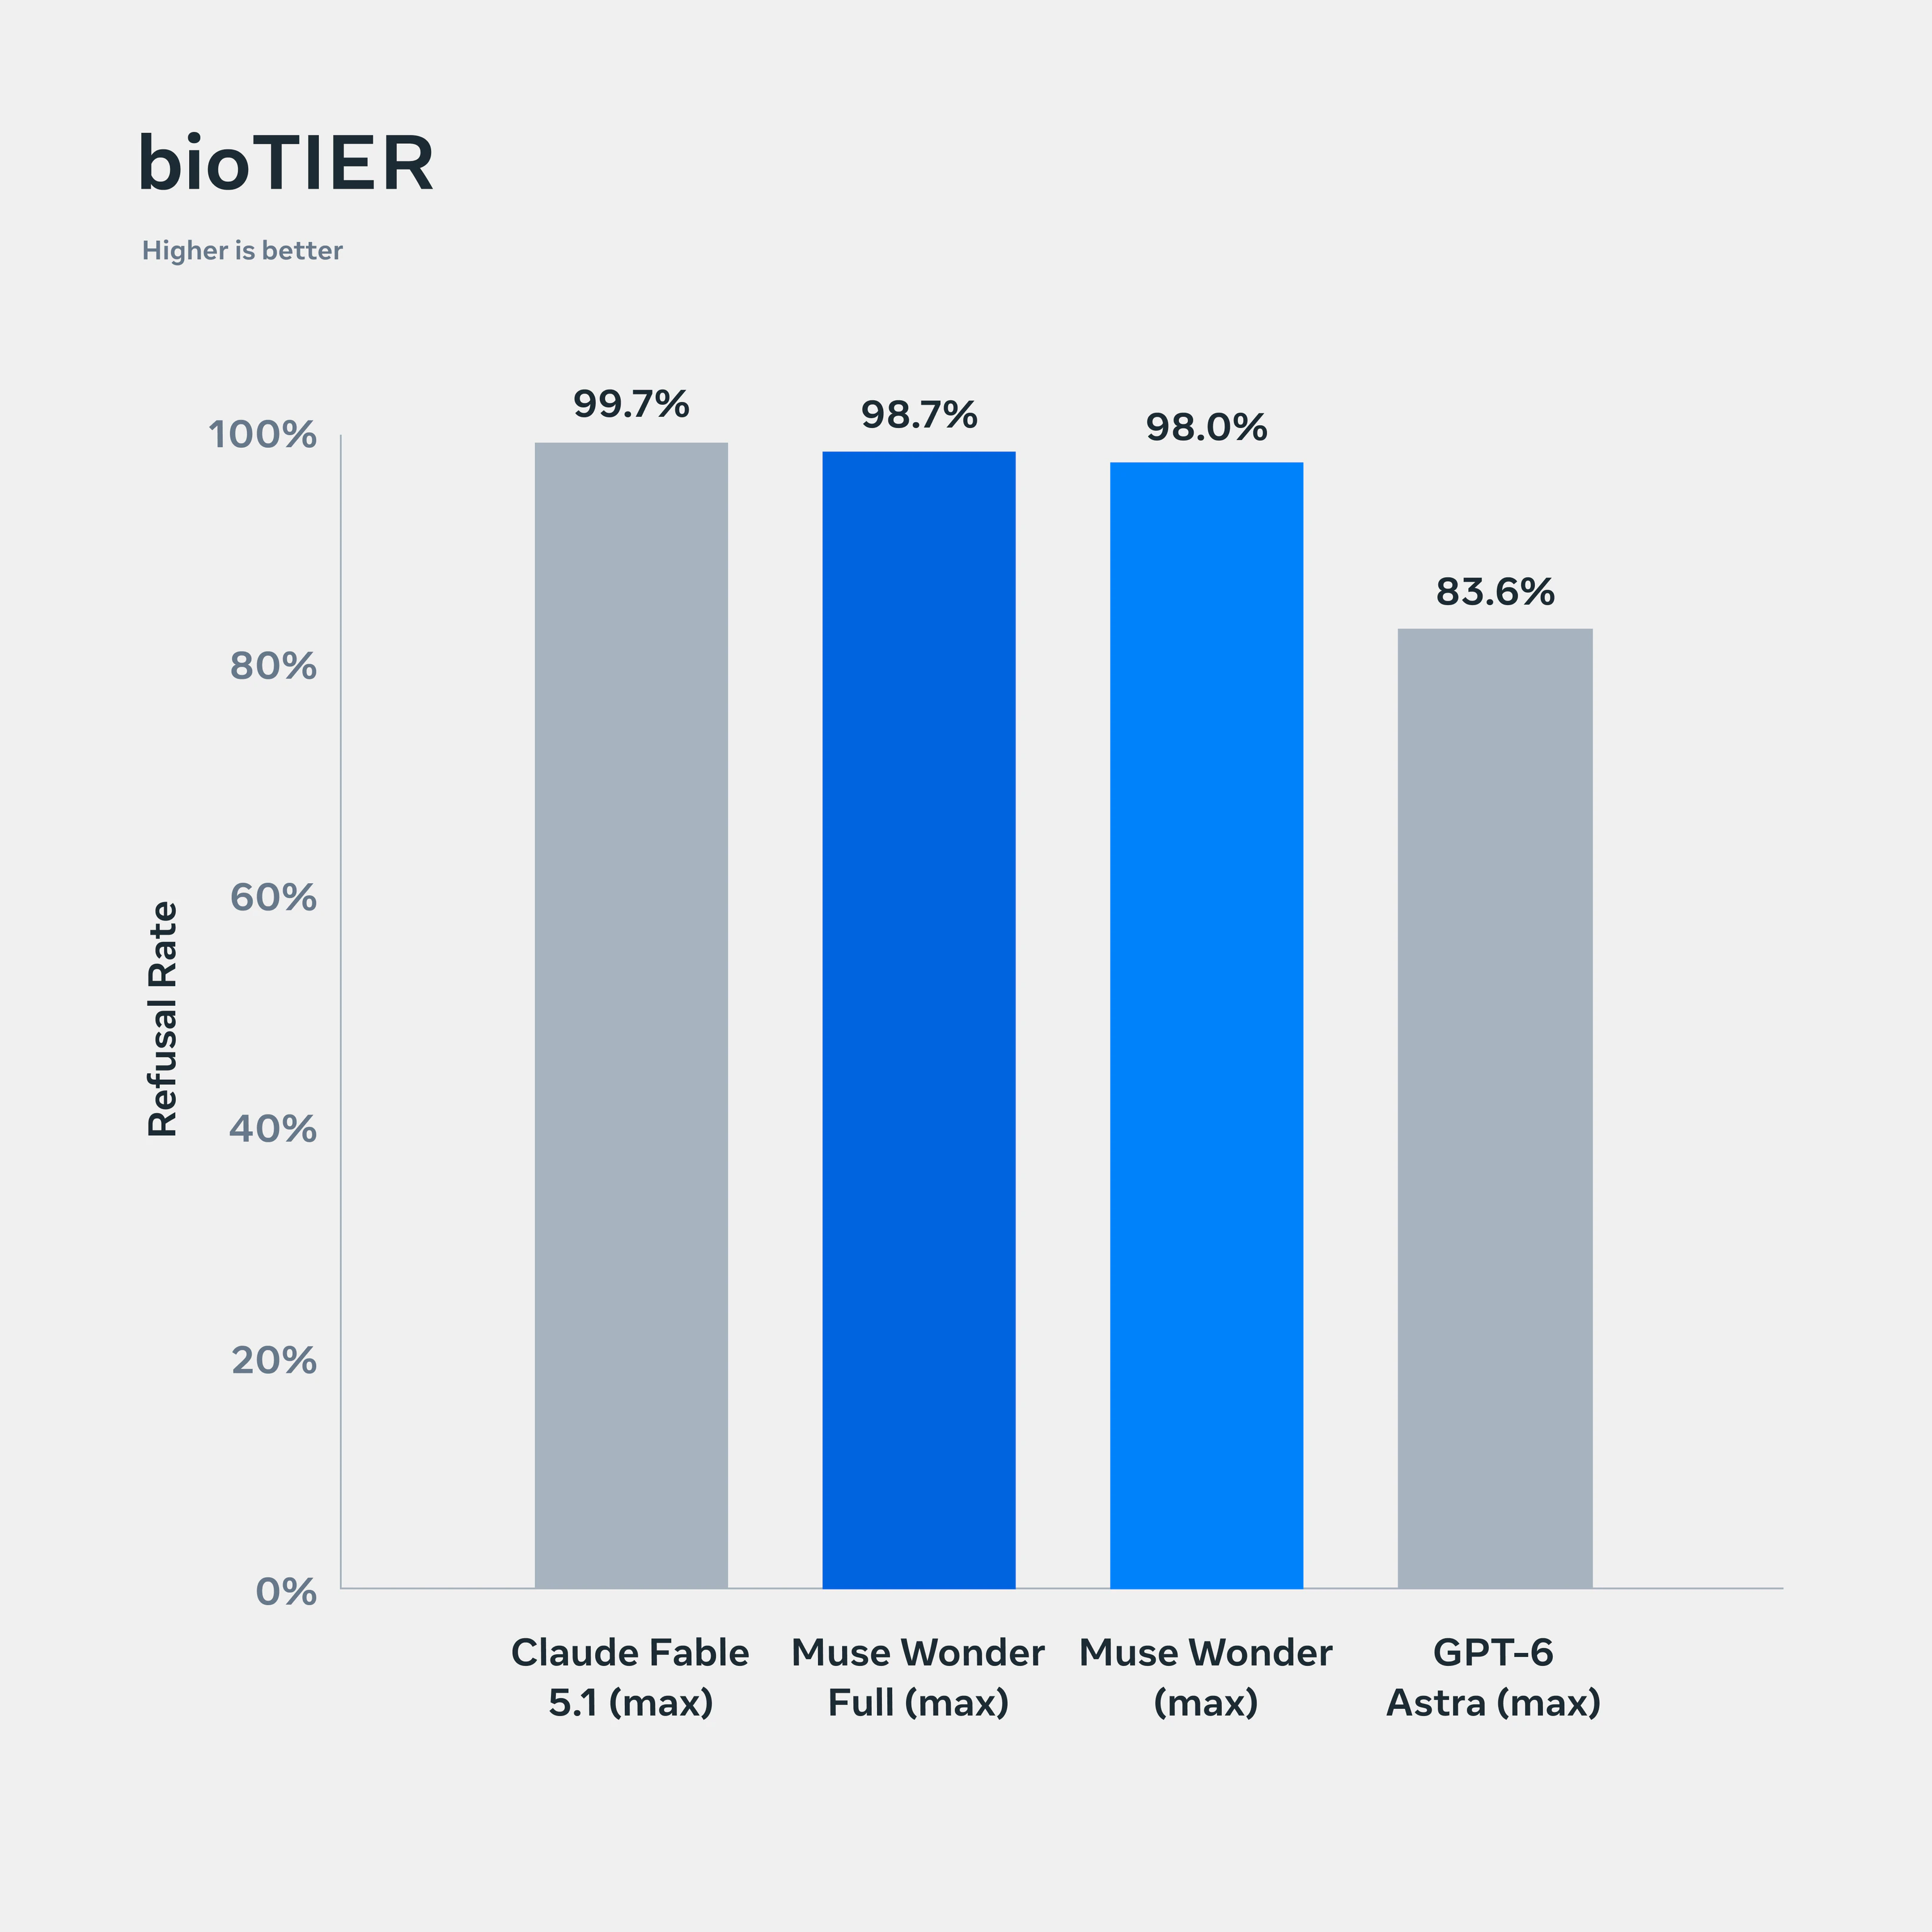
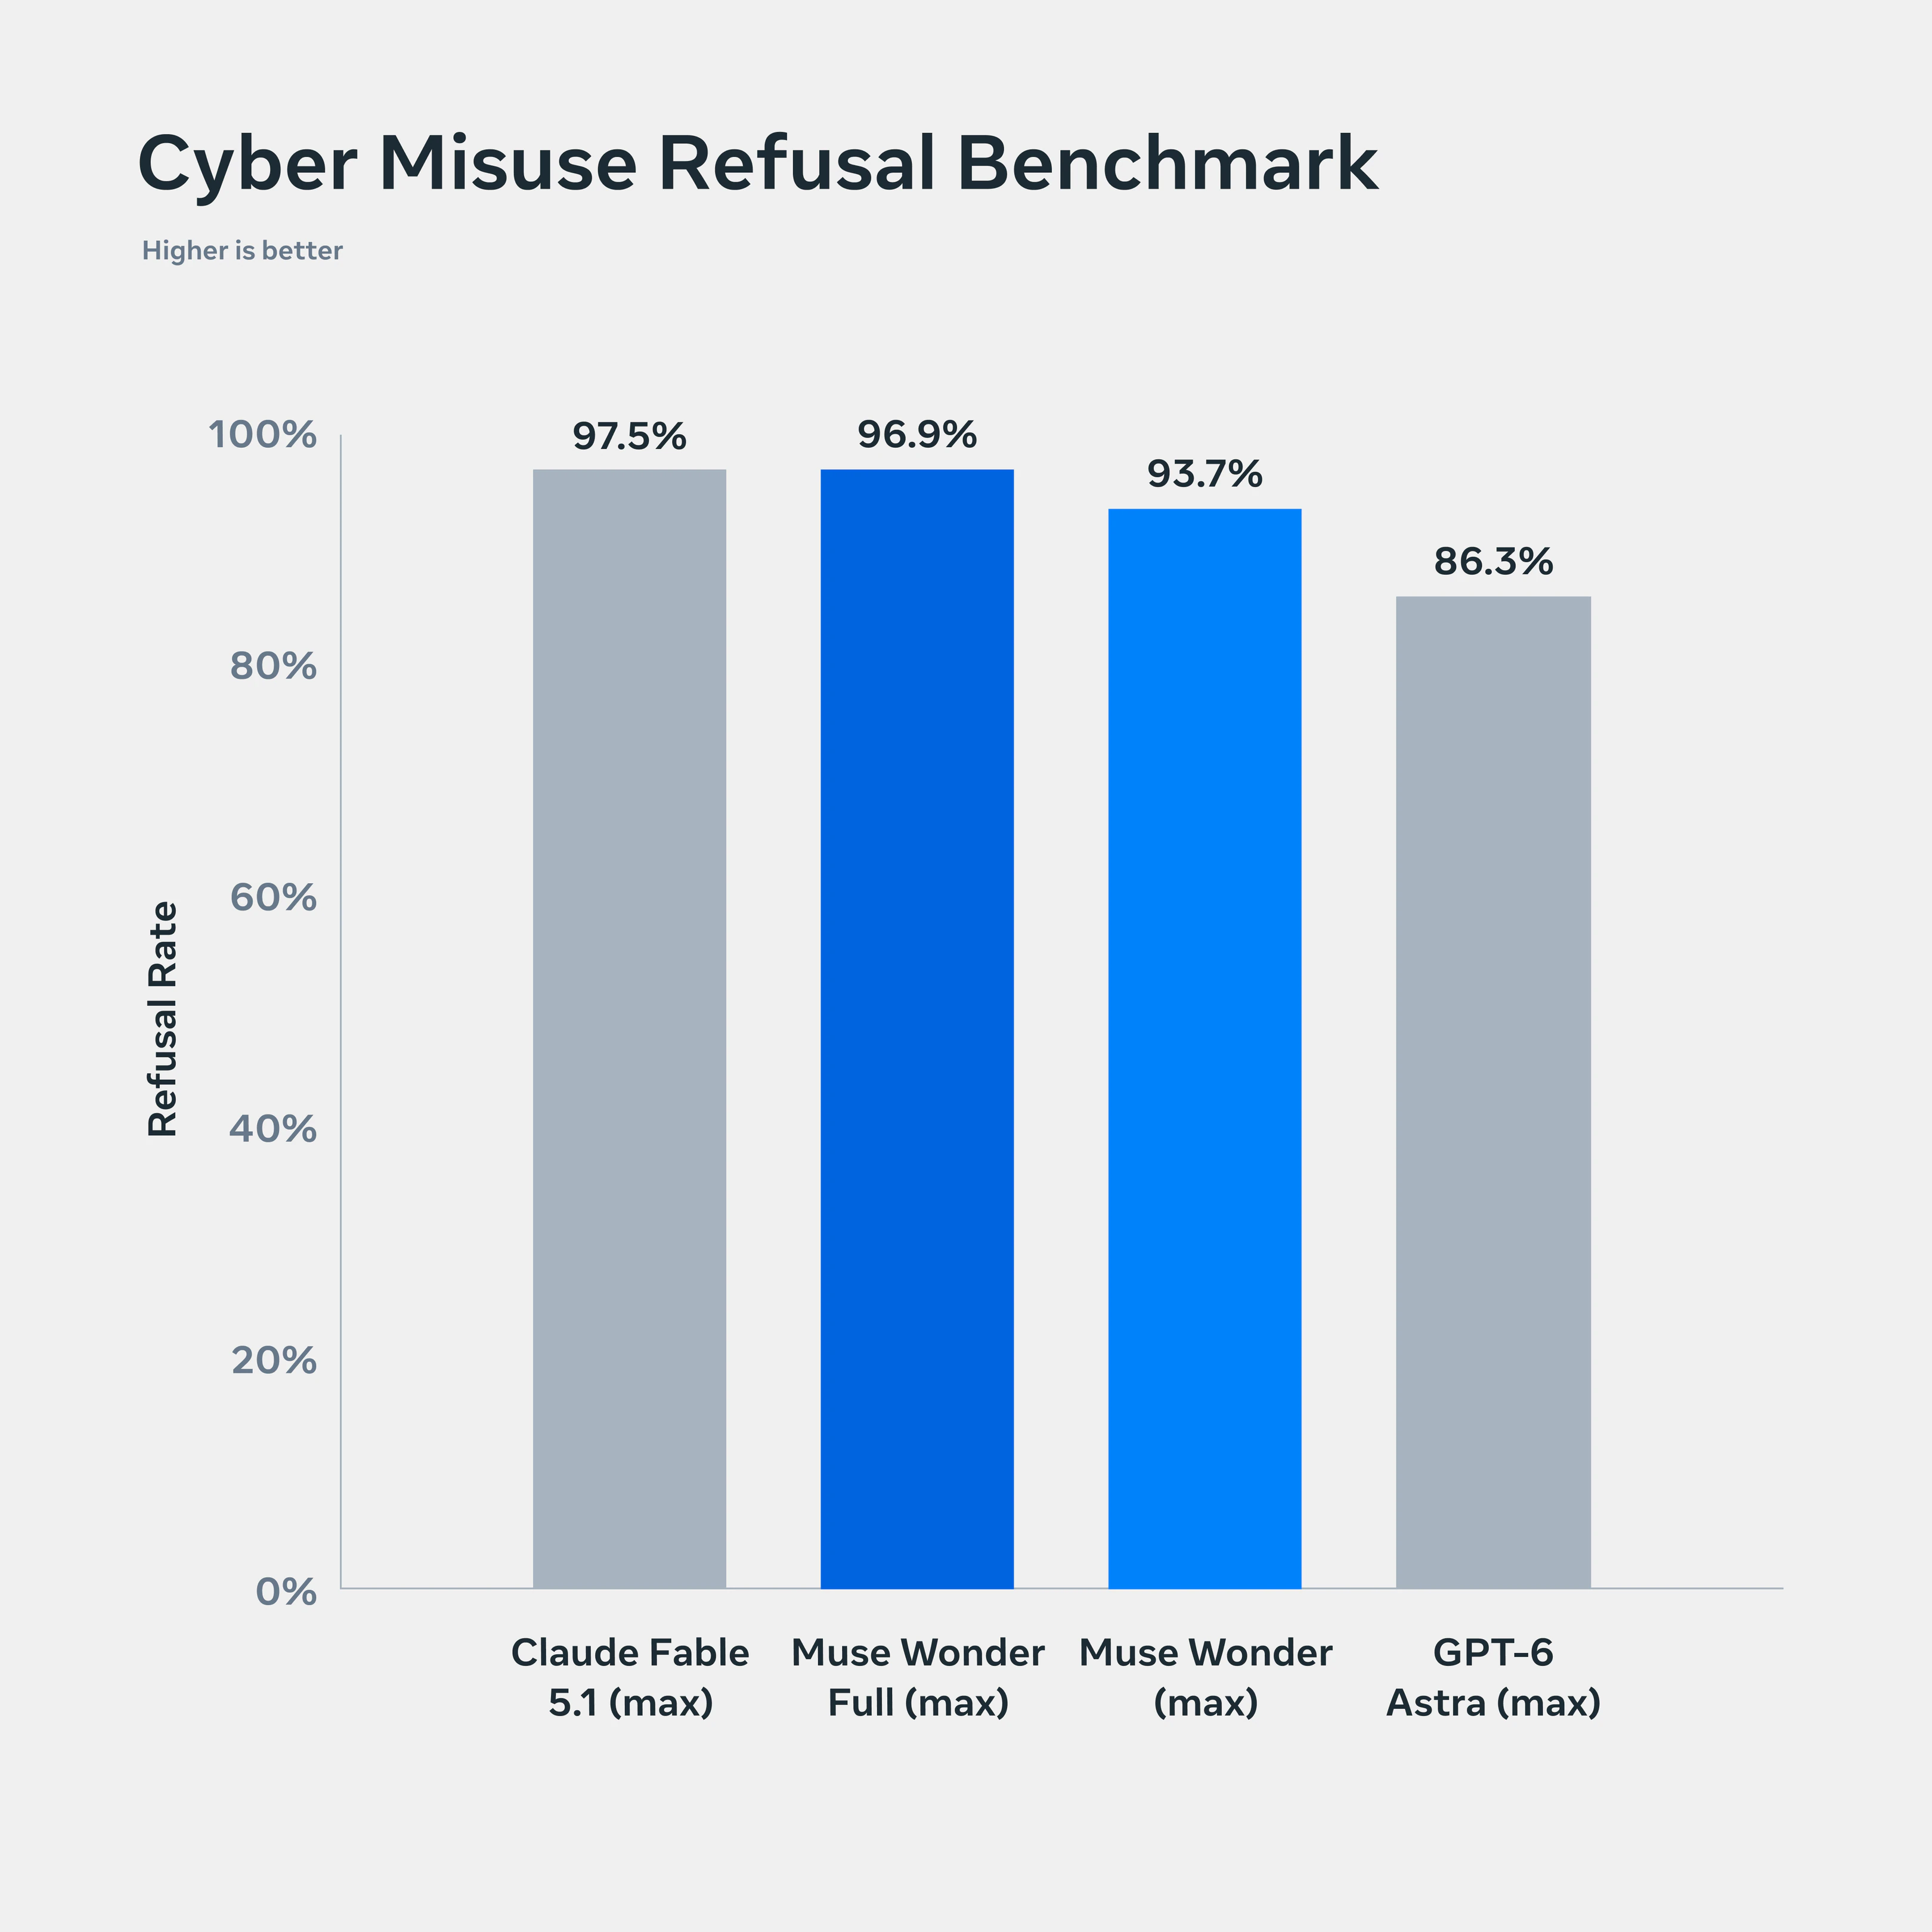

Muse Wonder 是我们迄今对齐程度最高的模型,而对齐是我们构建个人超级智能的核心。包含更多安全评估的完整报告将很快发布。
我们希望 Muse Wonder 和 Muse Wonder Full 能让更多人拥有追求梦想、构建想要世界的能力。这是面向所有人实现个人超级智能的重要技术一步,后续还会有更多进展。
评论
讨论气氛是“惊艳但高度戒备”:社区普遍承认 Meta 的 Muse 新模型在 AA 榜上已逼近 Opus 5.5、RL 进展快得反常,但主轴分歧在于这些分数是否靠刷榜、日常工具链和安全性是否配得上“前沿”标签。与此同时,不少人欢迎 Meta 把前沿竞争变成多玩家的局面,少数人则继续追问权重开放、定价与隐私风险。
承认 Meta 已靠 RL 和人才收购冲进前沿
- 这次不是过去那种低价开源的小打小闹,而是突然拿出接近前沿的完整模型;榜单仅次于 Opus 5.5,加上 RL 扩展全速推进、早前收购终于见效,让不少人觉得它已经真正挤进第一梯队。(较多人) > RL 团队这么快把模型爬到 AA 榜第二,速度快得离谱,但日常工作流是否同样好用还不好说(@ggcr)
- 也有人以“毫无预兆”形容这种反差:Meta 过去几年一直折腾廉价开放权重模型,如今却直接拿出 Frontier 套件。(少数人)
质疑高分来自刷榜,落地和工具链仍不可信
- 很多人第一反应是问到底做了多少刷榜优化,认为漂亮分数可能只是针对评测集调出来的;即便分数漂亮,编码 harness 和沙箱在 Mac 与 Linux 上都跑不起来,实际日常使用远没跟上榜单。(较多人) > 分数确实漂亮,但编码沙箱在 Mac 和 Linux 上都跑不起来,根本没法日常使用(@wkcheng)
- 反直觉的是,如果这些分数不是刷榜,那么 Anthropic、OpenAI 的独特性就会被迅速削弱,所以“是否刷榜”直接决定了对竞争格局的判断。(少数人)
欢迎更多公司逼近前沿,避免权力和价格被单一玩家垄断
- 即便对 Meta 有保留,更多人进入前沿被视为好事:三到四家互相牵制,能降低递归自我改进后价值观被单一公司强加全行业的风险,也更可能促成合作;若 Meta 真有同级模型,前沿能力会迅速商品化、价格被压低。(较多人) > 越多公司接近前沿越好;若只有一家在递归自我改进后掌舵,会导致权力极端集中、价值观被强加全行业,三到四家互相牵制反而更可能合作(@atleastoptimal)
- 也有人从产品和市场角度补充:Muse 应用已经很有吸引力,若再搭配这次的强模型,竞品会被迫回应;OpenAI 还被指同时面临订阅贬值、落后前沿和筹备 IPO 的混乱局面。(少数人)
担心定价跳涨与最强版本被订阅制锁住
- Muse 新模型不再延续 Meta 过去的低价策略,输入输出定价来到每百万 token 4/20 美元,输出价高于 Sol、与 Opus 持平,被解读为 Meta 自认已进前沿、敢于按前沿定价;另外榜上最强的 Muse Wonder Full 仅供订阅者,API 只能调用 Muse Wonder,普通开发者拿不到榜单同款。(少数人) > 这次定价跳到输入输出每百万 token 4/20 美元,高于 Sol 并与 Opus 持平,像是 Meta 认为终于挤进前沿、不必再靠折扣换用户(@Jcampuzano2)
希望 Meta 延续开放权重传统
- 由于 Meta 长期做廉价开放权重模型,这次大家紧盯 Frontier 模型是否也会开源;若放出权重,不仅能延续社区期待,也被认为能干扰 Anthropic 和 OpenAI 的商业节奏。(少数人) > 要是 Meta 直接放出权重,多少能给 Anthropic 和 OpenAI 添点堵(@cardboard9926)
反感 Meta 的“超级智能”营销与命名玩法
- 社区对“超级智能”话术和 Muse 系列命名充满嘲讽,认为这种宏大包装很扎克伯格;有人直接要求别再用“超级智能”这个词,也有人拿 Glimmer、Spark、Wonder 这一串名字开玩笑,觉得接下来可能要出“Sun Shine”。(较多人) > “超级智能”?别开玩笑了,扎克伯格这套宣传简直离谱(@khalic)
担心把个人事务交给 Meta 代理并不安全
- Meta 想推动非技术用户用 Muse 代理处理私人事务,但内部指标显示处理个人信息约有 3% 的违规率,对普通用户来说高得不可接受;再叠加对 Meta 产品会“搞坏设备/体验”的刻板印象,很多人对真把个人事务交出去很犹豫。(少数人) > 内部指标显示处理个人信息约有 3% 的违规率,在面向非技术用户推广个人事务代理时高得不可接受(@nerevarthelame)
有价值的补充
- 反直觉点:进步主要来自 RL 团队快速爬榜,而不是预训练堆规模,说明 Meta 的 RL 扩展可能已经跑通。
- 消费级视角:有讨论提醒,普通用户最后关心的可能不是 AA 榜名次,而是哪家大厂更愿意补贴消费级套餐;这提醒讨论不只看排行榜,也看最终到手价格与可用性。