在 POSETTE 2026 上,赛·斯里拉姆普尔(Sai Srirampur)发表了《Postgres Isn’t Slow. Your Storage Is.》演讲,探讨存储在规模化时如何影响 PostgreSQL 数据库(PostgreSQL)性能。演讲先提到 PostgreSQL 规模化后的常见现象:数据摄入变慢、P95 读取延迟不稳定、autovacuum 落后、检查点与工作负载争抢资源,或逻辑复制延迟累积。为弄清原因,赛在基准 gp3 弹性块存储(gp3 EBS)和本地 NVMe(local NVMe)上对比同一套 33 亿行 PostgreSQL 工作负载。
正文
在 POSETTE 2026 上,Sai Srirampur 发表了演讲 “Postgres Isn’t Slow. Your Storage Is.”,探讨存储在规模较大时如何影响 PostgreSQL 性能。这里复盘了该基准测试、结果揭示的问题,以及为在生产环境中基于本地 NVMe 运行 PostgreSQL 所提出的架构。完整演讲可观看下方视频。
演讲一开始列出了大规模运行 Postgres 的团队可能会遇到的几种现象:数据摄入变慢,P95 读延迟变得不可预测,autovacuum 落后,检查点与真实工作负载争抢资源,或者逻辑复制不断累积延迟。这些问题未必同源,但可能有一个容易被忽视的共同原因:存储性能。
为了弄清原因,Sai 跑了一个基准测试,在 gp3 EBS 基准卷和本地 NVMe 上对比同一个 33 亿行的 PostgreSQL 工作负载。下面会介绍测试设置、Sai 分析结果的发现,最后给出基于本地 NVMe 运行 Postgres 的生产实践模式。
当 PostgreSQL 工作负载达到数百 GB 或 TB 级,并具备真实的并发和吞吐时,通常会出现五个常见问题。
- 摄入变慢。 第一类问题是 UPDATE 和 UPSERT 很多的摄入流水线。随着底层数据量增长,原本几秒完成的作业可能拉长到几分钟。
- 读延迟不一致。 第二类出现在大多数查询仍然很快、但少数查询明显变慢的工作负载中。P95 延迟从毫秒级升到秒级,仪表盘超时,这种不均匀的变慢也让原因更难定位。
- VACUUM 落后。 第三类问题是随着 UPDATE 和 UPSERT 吞吐增长,autovacuum 跟不上,表膨胀从 GB 级累积到 TB 级。
- 检查点变慢。 检查点也可能耗时更长,并与客户端工作负载争抢 I/O 和 CPU,把原本不易察觉的操作变成周期性延迟尖峰。
- 逻辑复制延迟。 最后一个现象出现在将 PostgreSQL 数据流式发送到 Kafka 或 ClickHouse 等系统时。WAL 解码可能很慢,不断增长的复制槽还会让问题加重。
当工作集超出 PostgreSQL 和操作系统页缓存可用内存时,更多数据读取需要物理 I/O。在较慢的存储上,这些读取的更高成本和排队会推高平均延迟和尾延迟。
客户端查询和后台维护同样共用这份存储预算。堆和索引写入、WAL 同步、检查点、VACUUM,以及逻辑解码溢出,都在争抢带宽、IOPS 和队列容量。
一旦存储触及其中某个上限,各种操作就开始互相拖慢。这正是慢存储会成为若干看似无关的 PostgreSQL 问题根源的原因。
主张使用本地 NVMe,并不是说它能消除 I/O,而是说它能大幅降低 I/O 的代价。这里的对比是:网络附加存储上的操作是毫秒级,而本地 NVMe 上的操作可能只要几十微秒。缓存未命中、WAL 刷盘和维护 I/O 依然会发生,只是它们对整体系统的影响不再那么明显。
为了更好理解其中原因,Sai 搭建了一个简单实验,在分别运行于 EBS 和本地 NVMe 的 PostgreSQL 上比较相似的工作负载。
为了把存储作为唯一变量,基准测试使用了八个相同的 PostgreSQL 集群:四个使用实例存储 NVMe,四个使用预置 3,000 IOPS 的 gp3 EBS 基准卷。每个集群都运行在 m6id.4xlarge 实例上,配置为 16 vCPU、64 GiB 内存、16 GiB shared_buffers。每种存储类型都用多个实例,以消除各轮基准测试之间的差异。
测试使用包含 33 亿行、大小为 482 GiB 的 pgbench_accounts 堆。随后每个集群运行相同的高并发随机 UPDATE 工作负载五分钟,共 64 个客户端、16 个工作线程,执行的语句是 \set aid random(1, 3300000000) 和 UPDATE pgbench_accounts SET abalance = abalance + 1 WHERE aid = :aid;。简而言之,两组之间唯一的差别就是存储类型。
基准测试中,NVMe 集群的中位数吞吐为 16,030 TPS,而 EBS 为 1,734 TPS——本次测试相差 9.24 倍。事务延迟中位数从 36.9 ms 降到 4.0 ms。
在不同操作上,NVMe 用 366 秒完成了一次针对 10 GB 膨胀的 VACUUM,EBS 需要 964 秒;NVMe 用 139 秒消化了 10 GB 逻辑复制积压,EBS 则需要 238 秒。
有一点需要注意:这些结果只适用于该工作负载和这些存储配置。EBS 一侧使用的是预置 3,000 IOPS 的 gp3 基准卷,换成不同的 EBS 配置大概率会得到不同结果。
看看 EBS 上那 37 ms 事务延迟花在了哪里,就能更容易理解吞吐差距。
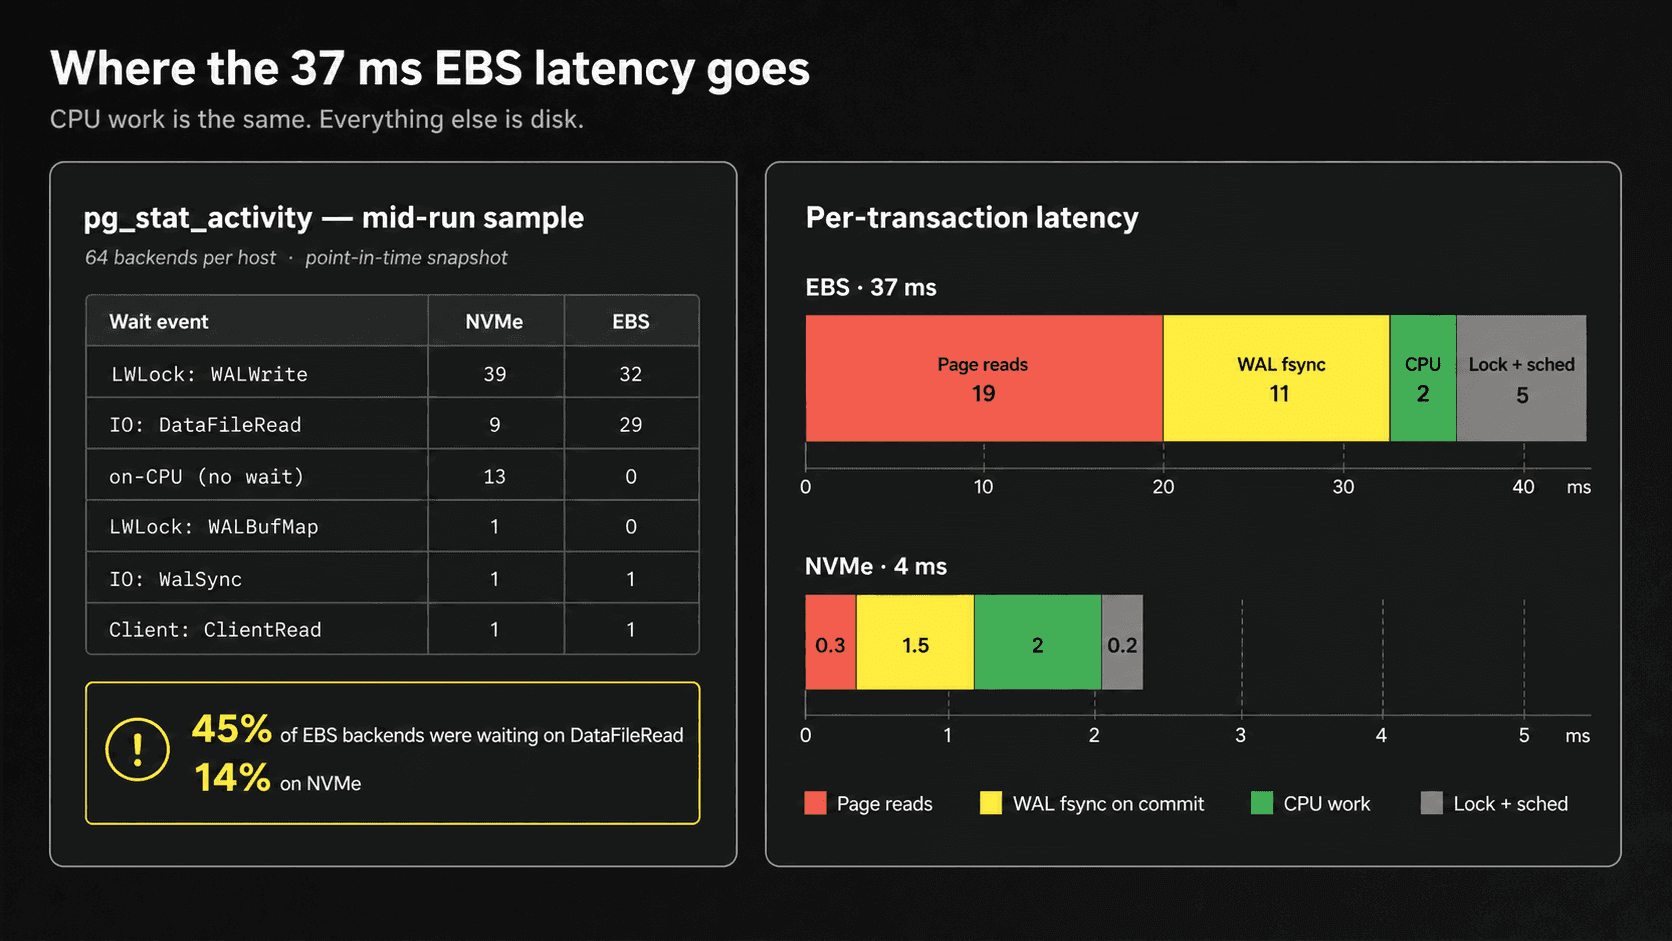
在该基准测试中,EBS 上的页面读取约占 19 ms,NVMe 上只有 0.3 ms。提交时的 WAL fsync 在 EBS 上又增加 11 ms,而 NVMe 上为 1.5 ms;锁和调度开销在 EBS 上约占 5 ms,NVMe 上为 0.2 ms。CPU 本身的开销两者大致相同,都在 2 ms 左右。
换句话说,EBS 上多出来的延迟主要来自等待存储,而不是 PostgreSQL 做了更多 CPU 工作。
运行中某时刻的 pg_stat_activity 快照从另一个角度展示了同样的模式。在 64 个 backend 中,EBS 上有 29 个正在等待 IO:DataFileRead,NVMe 上只有 9 个,大约 45% 对 14%。这只是某个时间点的快照,而非整个运行期间的平均值,但它说明在那个瞬间,多得多的 EBS 会话卡在读取上。
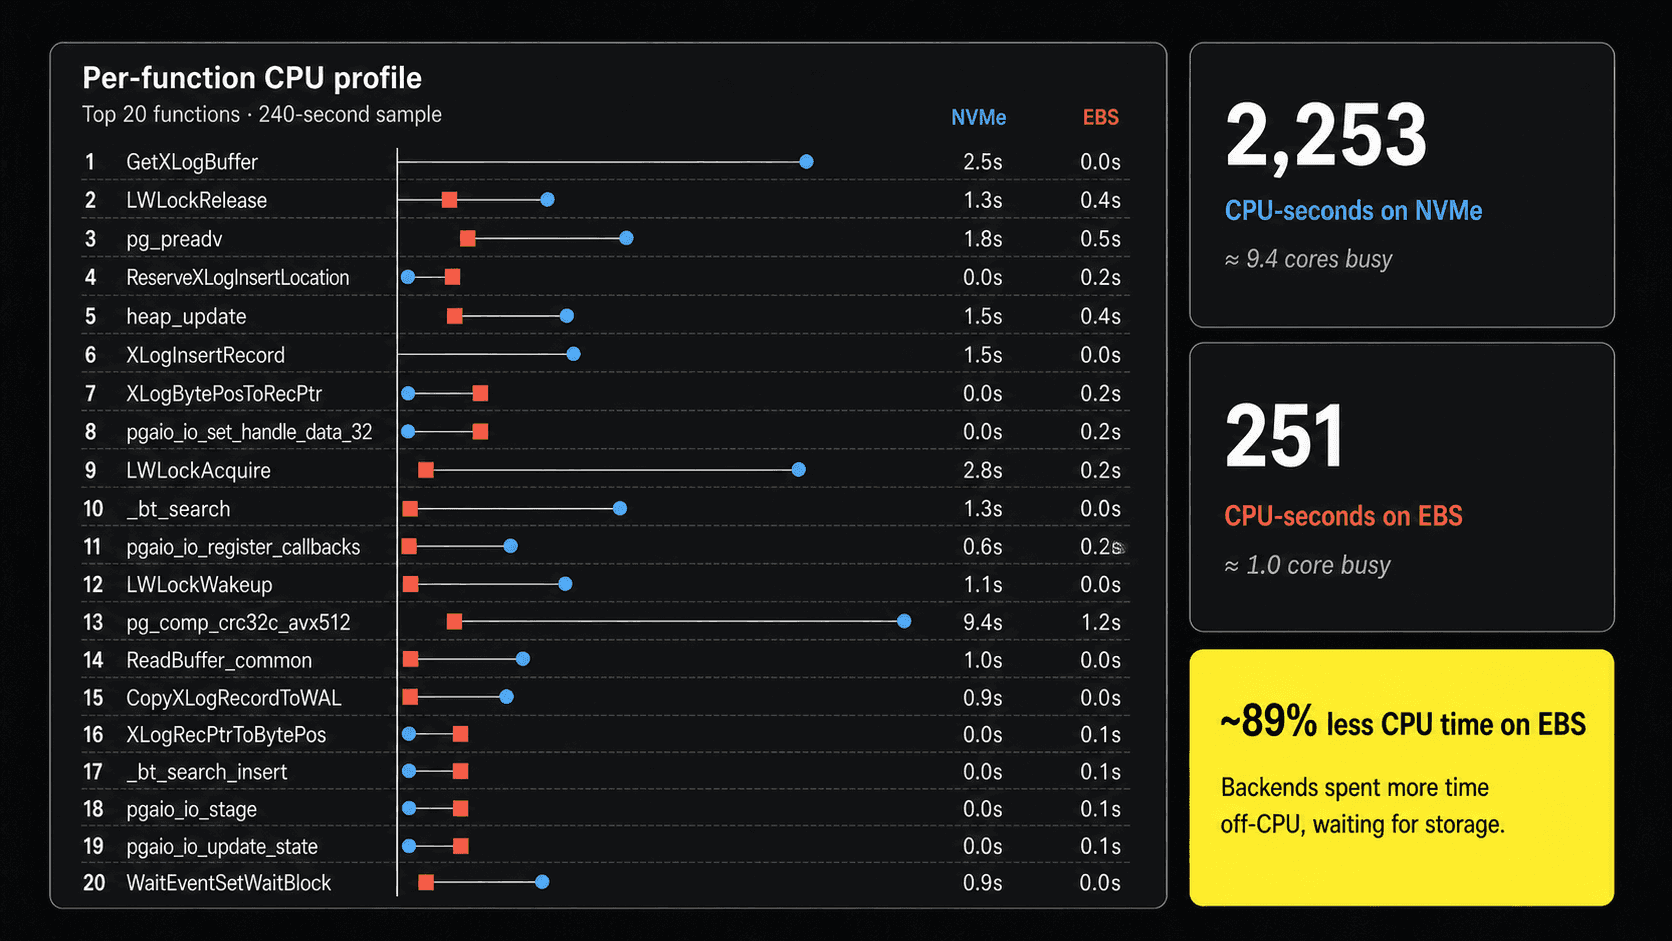
CPU profile 还给出了一个反直觉的观察。在约 240 秒的采样窗口内,NVMe 主机累计消耗了 2,253 CPU-seconds,相当于约 9.4 个核心繁忙;而 EBS 主机只消耗了 251 CPU-seconds,约一个核心繁忙。某些 PostgreSQL 函数在 EBS 上占比看起来更高,但绝对 CPU 时间表明,EBS 进程把远多得多的时间花在了离 CPU 等待存储上。
NVMe 主机让更多 CPU 容量忙于做有用的工作。这也解释了为何吞吐高得多:缓存未命中、WAL 刷盘和维护 I/O 依然发生,但它们完成得更快,使 PostgreSQL 更少时间阻塞在存储上。
讲完性能结果后,演讲转向一个明显的反对意见:实例存储 NVMe 与一台机器的生命周期绑定,节点消失时本地数据也会随之消失。运维上的问题是,PostgreSQL 能否把 NVMe 的延迟与生产级的可用性和恢复能力结合起来。
简短的回答是可以,前提是持久性由集群层面提供,而不是由任何单个 Postgres 节点提供。
在生产环境中基于本地 NVMe 运行 PostgreSQL,意味着要围绕这种“快但和机器生命周期绑定”的存储做设计。失去一个节点就意味着失去该节点上的本地数据副本;实例存储卷无法通过 EBS API 做快照;可用容量取决于所选实例类型。
演讲提出的生产架构通过三个主要要求来解决这些问题:复制数据库,使服务能在节点失效时存活;在单体机器之外维护备份和恢复数据;根据每种实例类型可用的 NVMe 来规划容量。这些模式合在一起,让人有信心在生产中运行 NVMe 支撑的 PostgreSQL。
第一个模式是基于仲裁的同步复制,配备两个备库候选。使用类似 ANY 1 (standby1, standby2) 的配置时,事务可以在任意一个备库持久确认其 WAL 后提交,而不必等待两个备库中较慢的那个。将节点分布在不同的可用区(AZ),可以防范可用区故障。
为了在数据库节点之外获得持久性,WAL-G 等开源工具可以提供物理基础备份和连续的 WAL 归档。借助低延迟的 WAL 传输,这种架构可以把 RPO 目标压到秒级,并在保留窗口内支持时间点恢复。
备份和 WAL 还应保存在独立的故障域中;如果恢复计划需要抵御整个区域中断,还应再保存一份区域副本。
基础备份和归档 WAL 不只是应急机制:同一份恢复历史还能支持时间点恢复、隔离分支、部署规模调整、只读副本播种和灾难恢复。
备份和复制解决的是不同问题。在演讲描述的架构中,备库提供快速故障转移,而备份防范损坏、运维误操作和集群级故障;两条恢复路径都需要定期测试。
这一模式并非只是理论。演讲引用了 Instacart 的公开案例,该公司介绍了在 NVMe 上运行 PostgreSQL以支撑延迟敏感的搜索工作负载;还有 Datadog,它讨论过为需要的工作负载使用本地 NVMe PostgreSQL 实例。反复出现的模式是:用本地存储换性能,用同步复制换可用性,用独立保存的基础备份和 WAL 归档换恢复能力。
演讲最后给出一个诊断建议:当 PostgreSQL 看起来无法继续扩展时,要把数据库和存储放在一起检查。摄入变慢、读延迟不可预测、vacuum 压力、检查点造成干扰,以及复制延迟,都可能是存储层已达上限的信号。
最后的结论刻意比标题更窄:对于受存储限制的工作负载,本地 NVMe 能大幅减少 I/O 代价,但它带来了一种不同的运维模型。演讲勾勒的架构使用基于仲裁的复制来保障可用性,并使用独立保存的基础备份加归档 WAL 来保障恢复。
评论
多数人认为云数据库慢的根源在于网络存储抽象掩盖了本地 NVMe 的真实速度,并把网络延迟误算到了 Postgres 头上。但也有不少人反驳称真正的瓶颈往往是烂查询、缺失覆盖索引或缓存没用好,两边互相觉得对方在甩锅,而理性声音则呼吁先看具体负载和基准测试。
认为云数据库慢的根源是网络存储抽象掩盖了真实硬件延迟
- 在 NVMe 时代还用网络附加存储(如 EBS),等于为了运维灵活性付出十倍 IOPS 和延迟代价;云把硬件抽象成 vCPU 和网络盘,让开发者把网络延迟当成了数据库本身的延迟,也忘了计算机和裸金属本地 NVMe 其实可以非常快;很多工程师根本不理解网络 I/O 往返和邻居吵闹的 VM 比起裸金属有多慢,也忽略了查询其实是映射到存储上的数据块。(高赞) > 云让人忘记了计算机到底有多快,把网络附加存储的延迟当成了 Postgres 的延迟(@matthorse)
认为本地 NVMe 加轻量或单机数据库能带来数量级性能提升
- 给 RDS 加上本地 NVMe 后,平均 I/O 延迟能从 1 毫秒降到 0.1 毫秒;SQLite 或轻量服务配合本地 NVMe 同机部署,甚至能把整个 HTTP 请求压到 1 毫秒以内,单核每秒就能处理极高的请求数;如果有本地 NVMe,很多场景根本不需要重量级分布式方案。(较多人) > SQLite 配合 NVMe 感觉像作弊,如果唯一需求是最低延迟,我想不出比它更强的选择(@bob1029)
认为 Postgres 慢其实主要是查询、表结构和缓存没做好,不该怪硬件
- 很多人犯追求“可移植”表结构、写烂 SQL 的错,然后吵着加 Redis;就算把数据库放到 NVMe RAID 上,烂查询照样几秒;Postgres 不慢,慢的是数据没在缓存里,或者没利用好覆盖索引避免回表。(较多人) > Postgres 并不慢,慢的是你的 schema 和查询,很多人把数据库当黑盒,然后吵着要加 Redis 缓存(@traceroute66)
认为单纯责怪硬件或开发者都是甩锅,优化要看具体负载和基准
- 有人觉得把慢归咎于单一因素(不管是网络存储还是开发者)像是在甩锅;真正决定优化方向的是基准测试里的查询类型,盲目给存储或 CPU 等单一资源提速并不高效,而且有时候计算反而会成为瓶颈。(高赞) > 真正决定优化方向的是基准测试里的查询类型,盲目给某个资源提速并不会高效(@crabbone)
认为复制应尽量上移到数据库或应用层,以摊薄网络延迟
- 网络存储的根本问题是上层应用都假设小 I/O 是本地且快速的,所以网络延迟无法被摊薄;把复制放到数据库层(比如提交时只做两阶段提交),就能把网络往返摊薄到几步,数据库比磁盘更清楚什么时候该走网络。(较多人) > 应用总是假设小 I/O 又本地又快,网络存储的延迟因此没法被摊薄,而复制越靠近数据库层,性能往往越好(@dangoodmanUT)
认为全栈协同的商用数据库或一体机远胜于云上自建 Postgres
- 像 Oracle ExaData 这样的方案用 RDMA 后端、三级缓存、把查询下推到存储节点、免 vacuum 的 MVCC 等全栈优化做到极致;在云上手动运维带本地 NVMe 的 Postgres 集群太重,若非常看重查询性能,商业数据库是更省心的选择。(较多人) > Oracle ExaData 用 RDMA 和查询下推等全栈优化做到了 Postgres on EBS 架构无法比拟的性能(@mike_hearn)
认为留在云上时可用更高等级块存储或带增值功能的本地盘折中
- AWS io2 延迟和耐用性都优于 gp3,替换后系统更稳定;大家也希望云能在本地 NVMe 上提供原子快照、异步复制等增值功能,而不必在性能和运维之间二选一。(少数人) > io2 比 gp3 延迟更低、更耐用,换过去之后系统都跟着稳定了下来(@d1l)
认为通用数据库已过时,应让 AI 针对用例定制专用数据库
- Postgres 这类通用数据库是旧时代产物,现在完全可以让 agent 针对具体用例写一个专用数据库,几乎肯定比通用数据库更快。(少数人) > 让 agent 针对具体用例写一个数据库,几乎肯定比通用数据库更快(@rfgplk)
反感文章标题像是 LLM 生成,影响阅读意愿
- 觉得现在到处都是 LLM 生成的博客标题,让人很出戏,就算对主题感兴趣也读不进去。(少数人) > 看到到处都是 LLM 生成的博客标题,觉得很反感,就算感兴趣也读不下去(@amitpoonia19xyz)
有价值的补充
- 仅索引扫描(index only scan)能大幅降低随机 I/O:如果把查询需要的列都放进索引,Postgres 就不必回表读取随机分布的元组,很多人用了很久才知道这能带来巨大提升(@kebsup)。
- 已有公司在用 FPGA 甚至 ASIC 加速 SQL 的 JOIN 等操作,声称能带来两个数量级提升;这说明数据库瓶颈有时候可能是计算而非存储(@crabbone)。
- CloudNativePG 支持 Kubernetes 本地持久卷,可以为 WAL 和表空间配置分离卷来提升性能,但节点本地存储会带来“临时集群降级”的运维风险(@smartbit)。
- Postgres 曾有补丁试图改用类似 Oracle 的免 vacuum MVCC 引擎,但从未被合并(@mike_hearn)。