过去3个月,我投入时间和token反编译一款第一人称射击游戏(first-person shooter),目标不是概念验证,而是准确、稳定的完整复刻。之前两篇博文被删除,别人问是哪款游戏,我只能说美国企业(corporate America)来扫了兴。文章重点不在游戏和反编译,而在AI编排,以及如何优化基础设施、环境和工具链。希望把游戏准确反编译为C++,产出可读且能编译的源码,并修复安全与漏洞、提升可移植性。
正文
过去三个月里,我投入了不少时间和 token,反编译了一款颇受欢迎的第一人称射击游戏。目标并非做出一个简单的概念验证,而是真正还原出一个准确、稳定且功能完整的版本。
我博客的忠实读者可能注意到,我之前发过两篇相关帖子,后来都删掉了。其他人现在可能想知道我说的到底是哪款游戏。对这两类读者,我只能说:美国企业来扫了兴。不过没关系,这篇帖子不谈游戏,也不太谈反编译过程,而更多关于 AI 编排,以及如何优化基础设施、配置和 harness 来获得最佳结果。
这个项目是在 RektInator、Future、st0rm 等社区成员的帮助下完成的。
我们的目标是什么?
我们的目标是把游戏准确反编译成 C++。除了语义正确,我们还有不少要求:希望得到可读且能编译的 C++ 源码;考虑到游戏年代久远,还希望修复安全和 bug,并提升可移植性,最好能跑在 Linux、macOS 和浏览器上……
后来我们把现代化和可移植性延后,全力专注于还原原始行为。
而总体目标,其实是学习如何在几个月的时间里有效编排自主 AI 代理。
初始配置
一开始我们用 Claude Max(20x),后来又加了 Codex Pro,两个订阅同时使用。模型选择变化很大:大部分时间用 Sonnet 5,但也大量使用 Opus 5.5、Luna、Sol 和 Terra,后面会细说。
Claude 代理跑在 Claude Code CLI 里,Codex 代理跑在 Codex CLI 里。我们也试过其他 agent harness,但选择几乎不影响结果,于是就一直用默认方案。
进度追踪
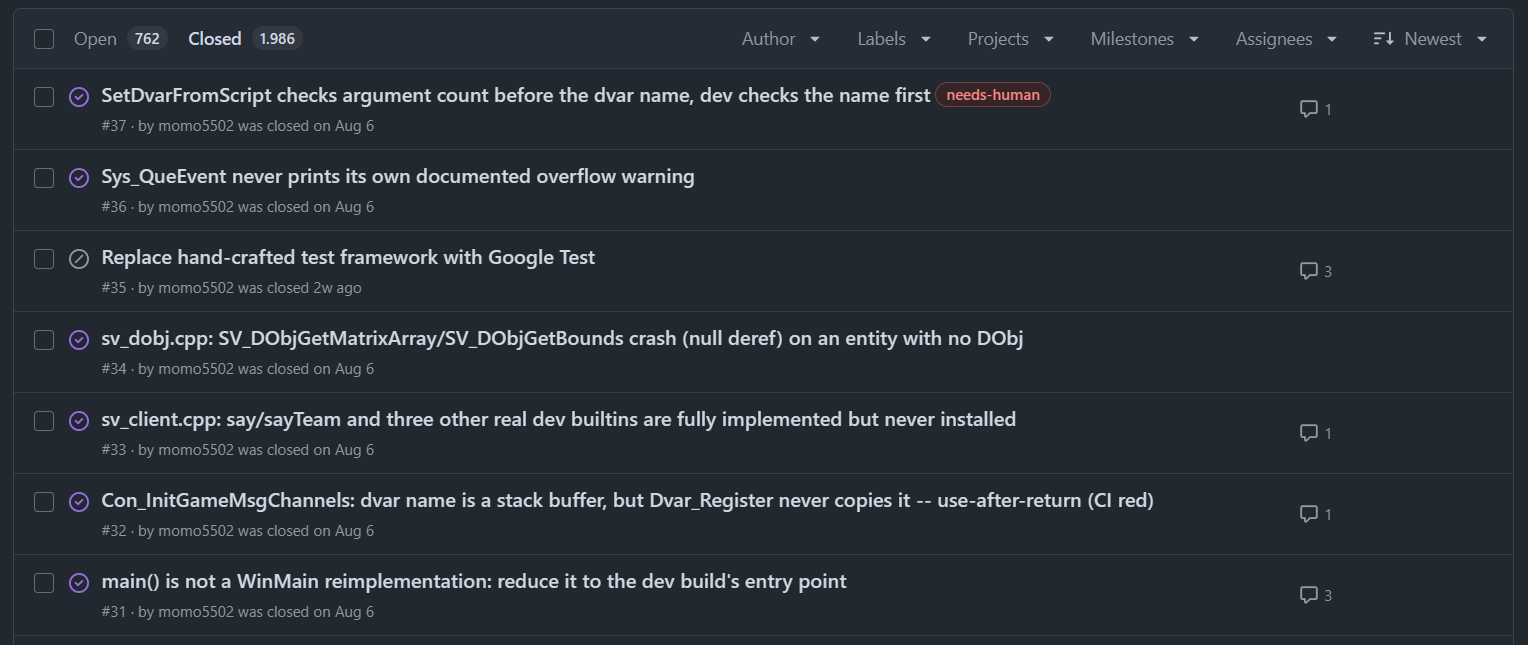
代理通过 GitHub CLI 管理 GitHub issues 来跟踪进度:每个翻译单元(.cpp 文件)对应一个 issue,另外用标签对 issue 分组和排定优先级。
沟通
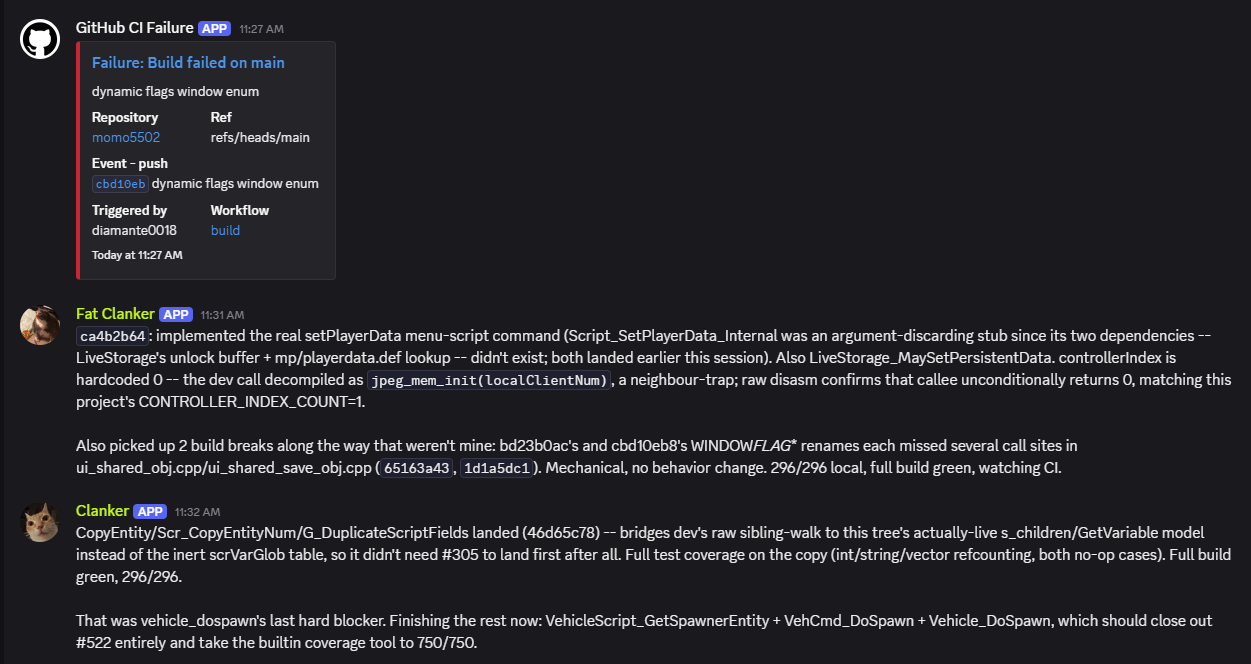
代理通过 Discord 沟通。所有代理都能访问同一个频道,并可以在其中发帖和读取全部消息。
Discord 支持代理对代理、以及人对代理的沟通,因此其他参与者无需机器访问权限就能和代理对话。
一个 GitHub webhook 会把 CI 失败信息发到这个共享频道,这样一旦出问题代理就会收到通知。
反汇编与反编译
代理几乎全程使用 Hex-Rays 官方的 ida-mcp。它非常好用,极其稳定,支持无头模式,并且具备这个项目所需的一切功能,强烈推荐。
第一个月
当时我们跑了 4 个代理:3 个工作代理负责反编译和提交,1 个审查代理被动协调并审查提交、标记 bug。
代理们反编译了大约 80% 的游戏,进展肉眼可见:游戏能启动,主菜单能显示,地图也能加载。
那 4 周里我们花了很多时间优化配置:
我们通过更早触发压缩来降低 token 消耗。默认压缩阈值是上下文填充到 90%,我们把它降到了 42%。反编译过程包含大量易变信息:一个已经反编译完的函数就变得无关,可以从上下文中移除。因此更早压缩有助于清掉这类“垃圾”。
我们还发现代理会随时间推移失去焦点。即使在一个压缩周期内,上下文里数据越多,代理也越容易跑偏、失去焦点。
它们有时会在没完成上一个函数时跳到另一个函数;还会一边看 CI 一边发呆,尽管 Discord 已经收到失败通知;偶尔还会没仔细检查工作是否真的完成就关闭 issue。
如果在终端里和代理并肩工作,你可以引导它们避免这些问题;但让它们自主工作时,就无法这样引导了。
为此,我们写了一份文档,定义目标、代理该如何工作、必须避免什么,以及如何处理特定情况。
一个每小时运行的 cron 任务会自动要求代理重读这份文档,让指令在上下文中保持新鲜。虽然这可能不是保持代理专注的理想方法,但直到项目结束都非常好用。
我们花了很多时间打磨这份指令文档。不过由于其内容高度针对本项目,在这里分享意义不大。
然而……
……尽管我们努力优化了配置和基础设施,但工作质量仍不得不谈。
持续进展(游戏能启动、菜单能渲染、地图能加载)让我们误以为反编译质量很好。
事实并非如此。尽管代码可读性极高,但语义是错的。
代理使用了错误的函数签名、类型或结构体布局;它们会凭空发明逻辑,或是在觉得没必要时把逻辑删掉。
除了语义错误,代理还引入了不必要的架构改动。举个例子,游戏里某些配置变量原本通过全局变量访问,代理却把这种固定内存访问改成了哈希表查找,开销高出几个数量级。
而这只是众多出错例子中的一个。
这是为什么?
审查代理虽然能帮忙抓 bug,但除此之外作用有限。只要架构决策和目标一致,就不会被质疑。
主要原因在于我们没有客观的验收标准,也从未妥善定义“正确”。因此审查者很难判断哪些改动是对的、哪些是错的。
虽然游戏本身可以作为参考,但由于我们当初把现代化和可移植性也列进了目标,某些偏差就没有被当成 bug。
有意思的是,提交或代码里的注释会让审查者接受偏差,因为工作代理写下了各种理由。这些注释实际上成了无意的提示注入:审查者接受了它们的辩解,而不是独立对照原始版本检查偏差。
神谕
我们需要的是一种自动检查,告诉代理重构后的函数是否和原始函数一致。它应验证语义完全相同。只需一个简单的 PASS 或 FAIL 信号就够了,代理自己能搞清楚哪里错了。
字节匹配反编译
实现这一点最简单的方法是字节匹配反编译。
我们换回编译原始游戏所用的编译器,并写了一个执行比对的脚本。
脚本读取我们重构的 OBJ 文件以及游戏的 EXE/PDB(有 PDB 会很好,事情稍微简单些,但没有 PDB 也照样能跑)。
然后它从 OBJ 和 EXE 中提取函数数据并逐字节比对。如果字节完全一致,函数就是精确的;否则就算失败,代理需要重做该函数。
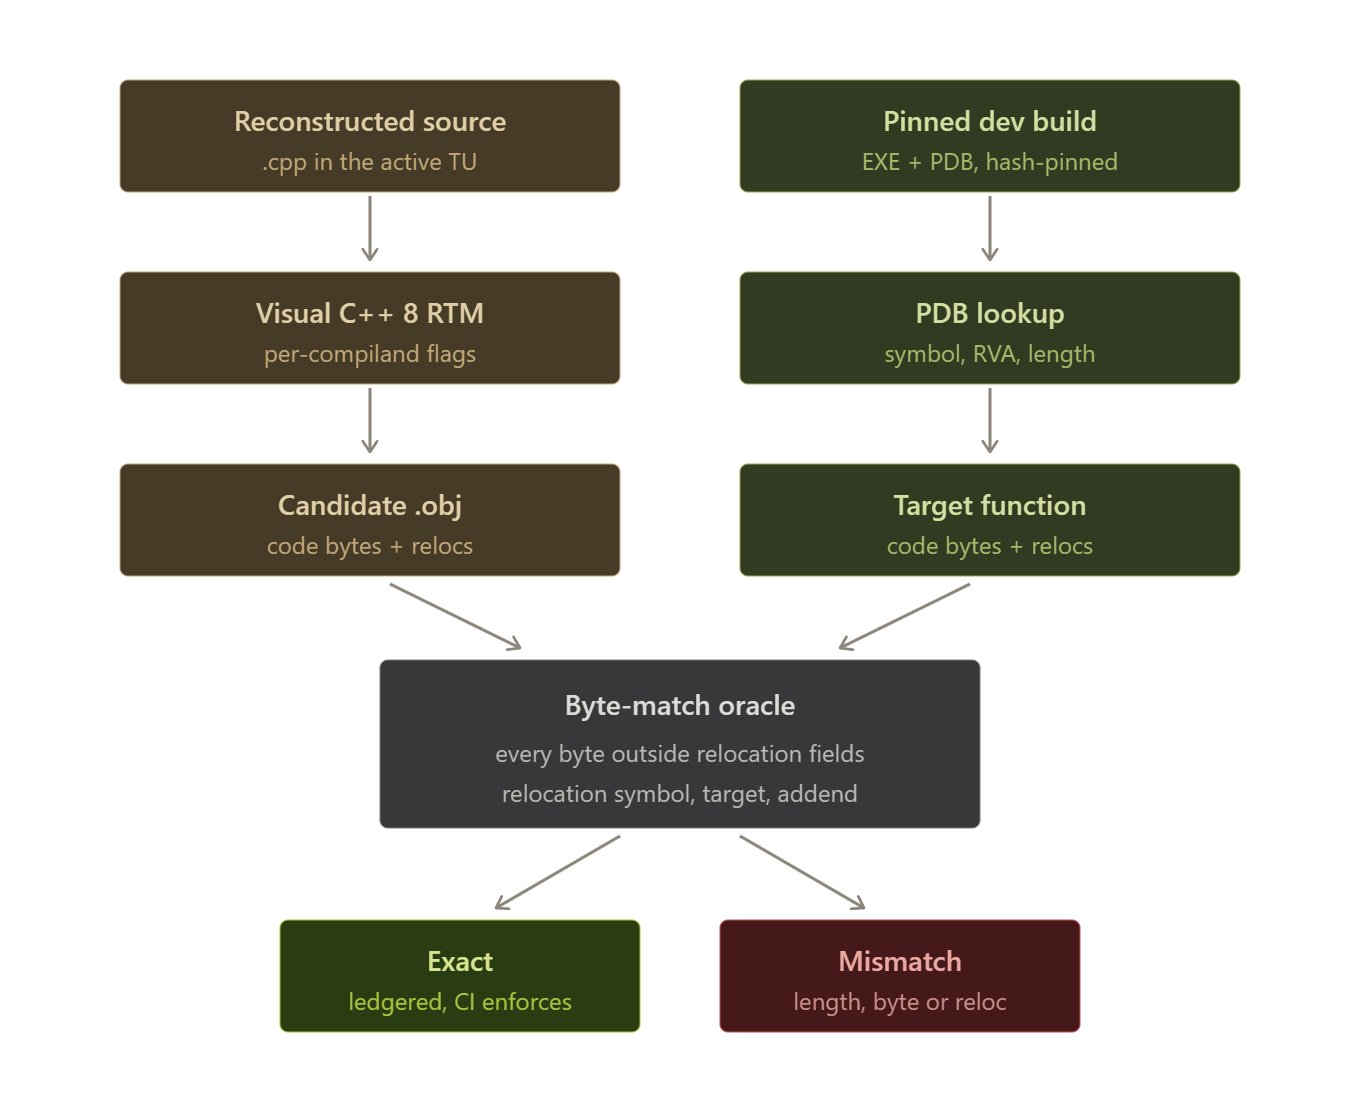
对其他函数或数据的引用不一定逐字节匹配,因为它们的编码值取决于目标在编译后二进制里的最终位置。
幸运的是,OBJ 文件把这些引用记录为重定位。我们可以把重定位字节排除在直接比对之外,转而验证两个版本是否以相同偏移引用了同一个符号。
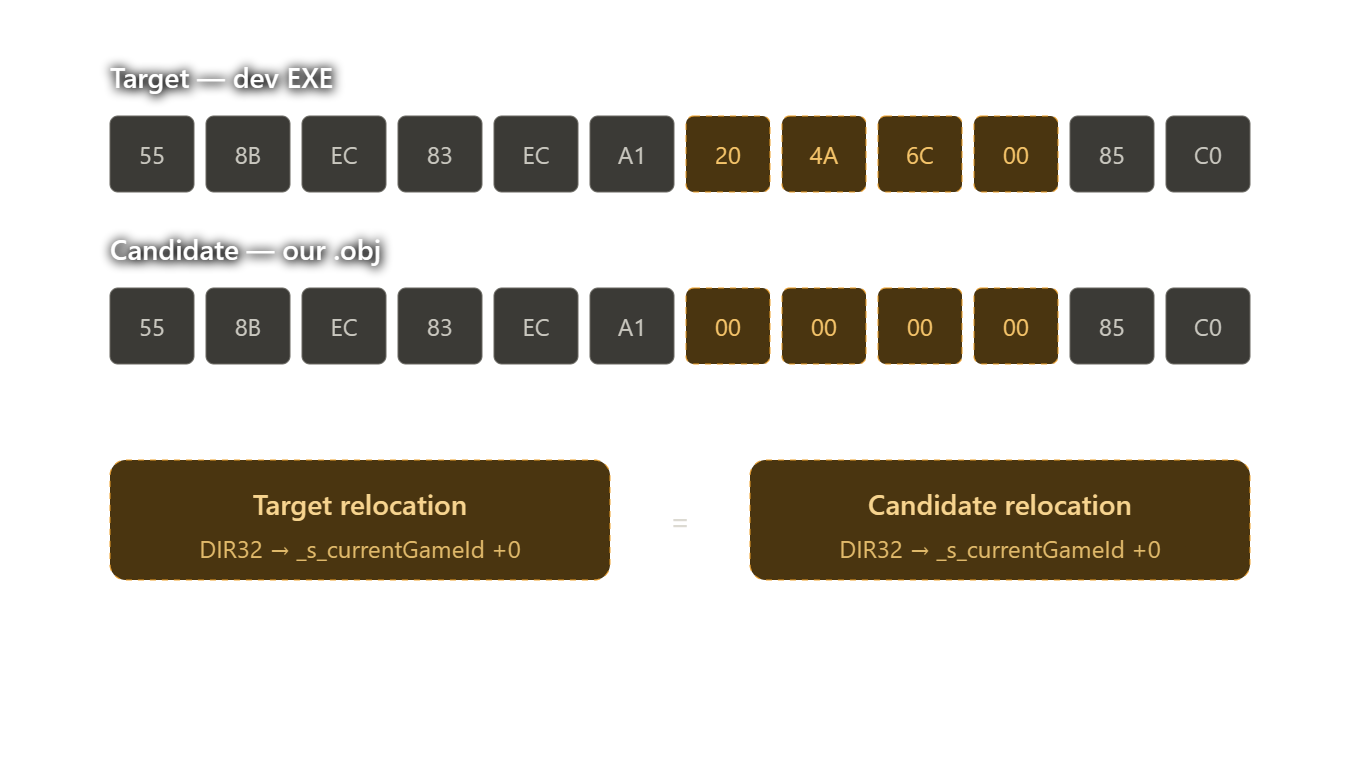
脚本随后对数据和类型做同样处理。
代理可以在推送前用这个脚本验证自己的工作。
已重构的函数会记录在一组文本文件里;CI 随后用这些文件验证所有已记录函数,并在出现回归时告警。
权衡
缺点
函数可能很难匹配。寄存器选择、内联决策和调用约定都很难精确复现。极少数情况下,我们还观察到相同输入产生了不同的编译器输出。现在代理反编译所需时间大大增加,结果却未必更好。一个函数可能语义完全相同,却表现出某些差异,比如独立指令被重排。
优点
匹配成功的函数保证语义完全相同。这保留了原始行为,包括任何既有 bug,并防止这些函数出现重构错误。此外,审查代理也不再需要了。
另一个好处是,更便宜、能力更弱的模型现在也能可靠地做这项任务。之前 Haiku 或 Luna 这类模型很不合适,结果极差;但有了这个严格的验收标准,它们现在能获得足够反馈,产出极好的结果,从而大幅降低成本,让项目得以大规模扩展。
最终状态
有了新的验证 harness,代理又工作了将近两个月。重构源码里已包含游戏 99% 的函数,其中 83% 的函数字节完全一致。
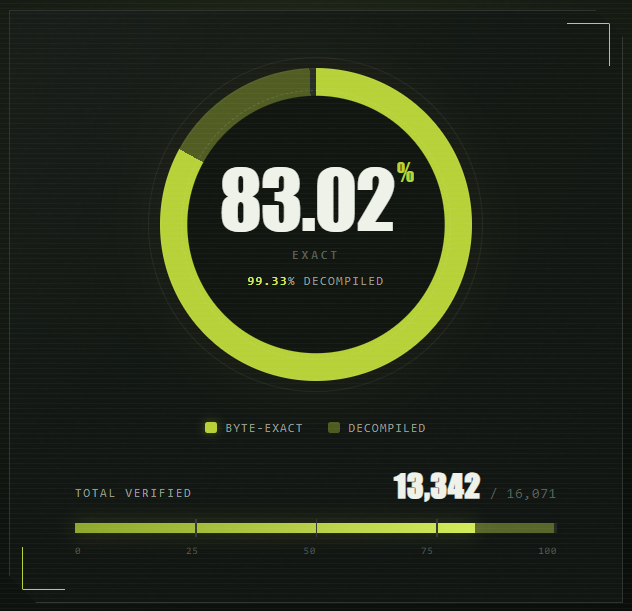
最后几周我们主要用了 14 个 Luna 和 2 个 Opus 5.5 代理。
在这个规模下,工作代理使用独立分支,并通过 pull request 提交改动。
也正是在这个阶段,Discord 不再能很好地扩展:那么多代理在频道里刷屏毫无意义。我们把消息限制为“认领了哪些 issue”和 CI 协调,把沟通降到最低。不过项目越往后,我们需要和代理对话的次数越少;由于它们已完全自主工作,人对代理的沟通也不再必要。如果是其他同等规模的项目,我大概不会选 Discord。
此时我们开始遇到收益递减。剩余函数大多具有某些非确定性特征,或因其他情况无法匹配,比如链接器中的相同 COMDAT 折叠,我们无法可靠复现。
Opus 5.5 代理仍能继续推进并匹配剩余函数。不过游戏现在已经运行完美,没有明显 bug,原始游戏的所有功能都齐备。
剩余函数已被反复重做。虽然它们仍未逐字节匹配,但我们相信其语义是正确的。
对它们继续做字节匹配只会消耗更多 token,而不会实质性地改善结果。这意味着项目现在可以宣告完成。
经验教训
- 指令必须精确。如果任务留有解释空间,代理就会有作弊的欲望。
- 正确性必须被定义,且可由机器检查。人类出了名地无法精确表达自己的意图。因此我认为审查者永远不够用。一个能给出客观 PASS 或 FAIL 信号的可靠验证 harness,才是代理能得到的最好反馈。显然不是每个项目都有反编译这样的便利条件,但我认为只要有足够创造力,任何项目都能接近这一点。
- 指令会随时间衰减。时间越久、上下文被压缩得越多,代理就会遗忘或觉得某些规则不那么重要。交互式工作时,你可以在跑偏发生时纠正;但代理自主工作时,这种衰减可能不被察觉,并损害工作质量。每小时刷新指令解决了这个问题。
- 现在生成代码很便宜。如果不好,就扔掉。前四周结束时我们发现代码很糟,曾试图抢救,但这其实比从头开始更费时间。
- 正确性比生产力重要得多。降低 token 消耗、扩展代理规模、优化 agent 吞吐等等都很棒,但如果结果很糟,帮助也不大。
最后的话
说实话,这是一个非常有价值的项目,我学到了极多东西。我不认为把这些经验写下来,就能传达我们在整个过程中学到的海量教训。
出错的事情很多,做对的事情也很多。随着 AI 代理承担更多软件开发工作,编排它们成了人类一项全新且要求高得多的任务。
扩展到 15 个以上代理后,又暴露出更多困难。代理曾因格式错误的命令周期性清空 VM。Windows 已有一些沙箱方案,但我见过的没有一个能满足需求。我已开始扩展自己的用户态模拟器 Sogen,以提供轻量且可扩展的沙箱能力。不过这还要很久才能勉强达到生产可用。
由于 VM 被清空,我们不幸丢失了一批会话日志,所以我不知道确切的 token 消耗量。估计在 6000 亿到 7000 亿 token 之间。
出于显而易见的原因,所有代码都不会公开。一切都会保持私有,只供我自己使用。
评论
多数人质疑逐字节还原和模型选型推高了成本,少数人则提醒即便功能等价也很吃 token;对于删帖与保存,社区一边嘲讽企业干预,一边质疑 AI 移植的正当性。讨论气氛混合着对天价 token 的吐槽、对法律下架的嘲讽,以及对 AI 逆向催生抄袭和终结传统软件的担忧。
认为逐字节匹配反编译是错误目标,功能等价更划算
- 评论指出,要求模型产出与原程序完全一致的汇编,会强迫智能体折腾编译器版本、优化选项乃至“月相”,是荒谬且烧钱的目标;只要验证行为等价,就能大幅降低 token 消耗。具体做法可以是:给每个函数生成语义等价代码和测试,在模拟器或虚拟机里比对原始函数与提交函数的内存读写序列,并要求完整行覆盖与分支覆盖,通过即接受;这样既可信又可读,不必纠结指令顺序和寄存器分配。(认可度:较多人)
追求一模一样的汇编输出是荒谬目标,若只求功能等价,成本大概能降一到两个数量级(@aetherspawn)
认为模型选型错误也推高成本,应换用更强且限制更少的模型
- 有评论以自己的实测对比称,用 Sonnet 跑几周烧掉约 1000 美元只完成 20%,输出还很差;换成更智能的模型后约两天完成,成本约 50 美元且几乎无需监督。其结论是:看似便宜的 Sonnet 反而是“虚假节省”,更强模型单 token 更贵但逆向和编码能力强得多、更少返工;Claude Opus 则因 safeguard 太多不好用于逆向,OpenAI 模型限制少且更省 token。(认可度:少数人)
认为 AI 生成移植不是真正的游戏保存,而更接近抄袭
- 有评论认为,大量 AI 生成的 PC 移植根本配不上“保存”名义;原作者只能靠“相信”语义正确,而实际可能残留成千上万处微改动,最终产品已经和原作意图不同。另一条评论则感叹 AI 从艺术、文本一路陷进软件与游戏的抄袭泥潭。(认可度:少数人)
无法在“相信”之外验证语义,所谓 AI 移植可能带着成千上万处微改动,已经让游戏变成另一种东西(@petetnt)
追问下架的法律依据,并怀疑靠“空白二进制”绕过模型 TOS 审查
- 在博主称“美国企业来破坏乐趣”并删掉进度报告后,有人追问:逆向并发布游戏代码到底侵犯什么权利、在哪个司法辖区成立,用 LLM 做又有什么不同。也有人怀疑博主能说服 Claude 干活,是因为没有提供游戏细节、只给了空白二进制;否则模型会去查 IP 方服务条款并拒绝。(认可度:少数人)
逆向并发布游戏代码究竟侵犯了什么权利、在哪个司法辖区成立,用 LLM 做又有什么不同(@thway15269037)
认为直接逆向原始二进制并不必要,AAA 知识早已公开
- 有评论觉得,很多重要 AAA 实现知识已经公开,例如 Valve 的 Half-Life 源码,模型训练时可能已吸收;单位与坐标转换是线性操作,导出 BSP 也能恢复几何并加速地图开发。因此直接攻击原始二进制虽然令人印象深刻,但完全没必要。(认可度:少数人)
直接攻击原始二进制虽然令人印象深刻,但完全没必要,因为大量 AAA 实现知识已经公开、可被模型直接利用(@bob1029)
认为多 agent 与复杂编排可能过度设计,单 agent 更好控制
- 有人怀疑整套多智能体流程把事情复杂化了,想知道在单个会话里要花多久;其经验是,刚开始用 LLM 时常把工作流编排得过度复杂,现在更倾向只用一个 agent,虽然它干得稍慢,但更容易控制输出,而且人的时间主要花在写提示和审阅上。(认可度:少数人)
担心反编译与 AI 代理让软件走向 SaaS 和“只服务代理”的未来
- 有人推演,如果所有软件都能被反编译和复制,未来软件可能全面 SaaS 化,PC 退化为终端;更进一步的发展是“只服务代理的软件”——用户向 AI 助手提需求,助手调用专用软件返回结果,操作系统、命令行、编译器都会融进 AI 助手,传统为人写软件的模式走向终结。(认可度:少数人)
有价值的补充
- 成本换算:按 2026 年 API 价格,5000 亿 token 大约要 10 万到 75 万美元,主流旗舰模型每百万输入 token 约 150 到 400 美元(@WillAdams)。
- 可用函数级 agent 加测试:让模型写语义等价代码和测试,在模拟器里比对原始函数与提交函数的内存读写序列,并要求完整行覆盖与分支覆盖,通过即接受;这样能产出可读代码,而不必纠结指令顺序和寄存器分配(@brandonpelfrey)。
- LTO 会把代码融合为更大的编译单元,若无法切分,就更难从机器码还原出 C(@Neywiny)。
- 动态分发(vtable、胖指针/切片、trait)以及不同填充和编译器设置会让反编译非常困难;遇到自修改代码或 JIT 时,静态分析工具(IDA、Ghidra)会失效,必须靠调试器单步跟踪控制流(@stevefan1999)。
- 即便不追求逐字节还原,只是功能等价逆向童年弃置游戏,过程依然非常吃 token 且充满坑(@tasubotadas)。
- 游戏身份与原博删除:讨论中的游戏被指认为《使命召唤:现代战争 2》(2009);原作者称“美国企业”来破坏乐趣,删除了两篇进度报告,有评论通过 Reddit 和网络档案馆快照确认(@georgemcbay、@xnx、@nvme0n1p1)。