量化金融常见模型接收某标的市场数据事件流,如订单簿挂单、撤单、成交,并预测未来价格;生成式模型较少见。设想模型不只给出价格点估计,还能合成订单簿事件及到达交易所时机,推演比点估计更有细节。但市场数据像视频或文本,连续或离散?似乎两者兼有:订单簿随挂单、撤单演变,动作空间离散;但订单价格基数极高,几乎连续。
正文
在量化金融里,我们熟悉的模型通常是接收某个标的(symbol)的市场数据事件流——比如挂在订单簿上的挂单、这些挂单的撤销、成交——然后预测该标的未来的价格。生成式模型则少见得多。设想一个模型不仅能给出价格的定点估计,还能真正合成订单簿事件,包括这些事件到达交易所的时间。当然,你会得到价格预测,但你的 rollout 会比单纯的预测有丰富得多的细节。
但市场数据到底是什么样的数据?生成式模型必须回答这个问题。它更像视频,还是文本?换句话说,它是连续的还是离散的?市场数据似乎两者兼有。订单簿通过一系列回合演化:市场参与者挂出或撤掉簿上的静止订单;这无疑是一个离散动作空间。然而,某个订单许多最重要的参数,比如价格,基数极高,基本上看起来是连续的。有些干脆就是连续的:一个容易忽视、但对生成模型至关重要的参数是时间,即“新订单何时到达交易所”。即便这样说也还是过于简化了。实际上分布呈尖峰状:“pennying”(把价格改善一个 tick)远比改善两个 tick 常见,而订单往往成簇到达,比如在整数时间点附近。
探索这些复杂性的一种方法是:先把数据当成连续的,看它会在哪里崩掉。今年夏天,研究实习生 Kavish 为市场数据构建了一个扩散模型。扩散和 flow-matching 模型是表征序列、多模态数据的强大工具,在 图像、视频、机器人 和 音频 等场景中效果很好。受 Autoregressive Image Generation without Vector Quantization 启发,Kavish 用 autoregressive diffusion 建立了一个事件级的市场数据生成模型。
过程中有一些技术发现——例如,Kavish 发现 DDPM 虽然在理论上适合做扩散模型的去噪,却出现了发散,而 flow matching 表现好得多。但核心结论是:完全连续的扩散并不适应真实市场数据的锯齿状形态。Kavish 一方面用平滑处理点质量(point masses),另一方面把模型的部分目标离散化,这些尝试极大地澄清了未来市场数据生成模型可能是什么样。
建模与设置
Kavish 看了四年的美国股票数据,每行数据包含时间戳、价格、类型(成交、下单、撤单等)以及其他信息。扩散模型要尝试为下一个事件生成这些特征,然后以自回归方式把它追加到数据流中。
沿用上述 Li 等人的论文,他采用编码器–扩散器(encoder–diffuser)架构,具体是一个因果掩码 Transformer 编码器,在每个位置产生一个潜嵌入(latent embedding)。训练时,每个位置的潜嵌入被送入一个小的事件类型头(event-kind head),输出一个 2 分类概率分布,指示下一个事件是成交还是 BBO 更新(“best bid and offer”,最优买卖报价)。价格、经过时间等连续目标,则由一个扩散头生成;该扩散头以对应位置的潜嵌入和真实事件类型为条件,通过标准的 AdaLN conditioning 实现。
推理时,你只把最后一个事件的编码潜嵌入送入事件类型头,并从输出分布中采样一个事件。下一个事件的连续特征由扩散头生成,条件是最后一个事件的潜嵌入和采样得到的事件。
DDPM 与 Flow matching
DDPM(去噪扩散概率模型)预测加到样本上的噪声,并通过减去缩放后的噪声预测、再除以剩余信号水平,得到干净样本的估计。DDPM 在图像生成等领域非常成功,但在高噪声水平下,噪声预测的小误差会导致干净目标估计出现大误差。Flow matching 则在噪声和数据之间进行线性插值,训练网络预测沿这条线的速度(数据减去噪声)。因此,采样轨迹几乎是直的,flow 模型可以用相对较少的步数精确积分。
本质上,这两者是同一目标的两种不同参数化,但 Kavish 发现差异相当重要。他最初的扩散头在 1,000 步余弦 schedule 上预测 $\epsilon$,这也是 Improved DDPM 推荐的。推理时,生成过程遵循 DDIM。不幸的是,这种配置不稳定,导致去噪轨迹爆炸:在全部 7 个连续目标上,88–95% 的值偏离分布均值超过 8 个标准差。注意图中最左边的框里,轨迹(那些细粉色细丝,在背景下几乎看不见)迅速发散到边缘。
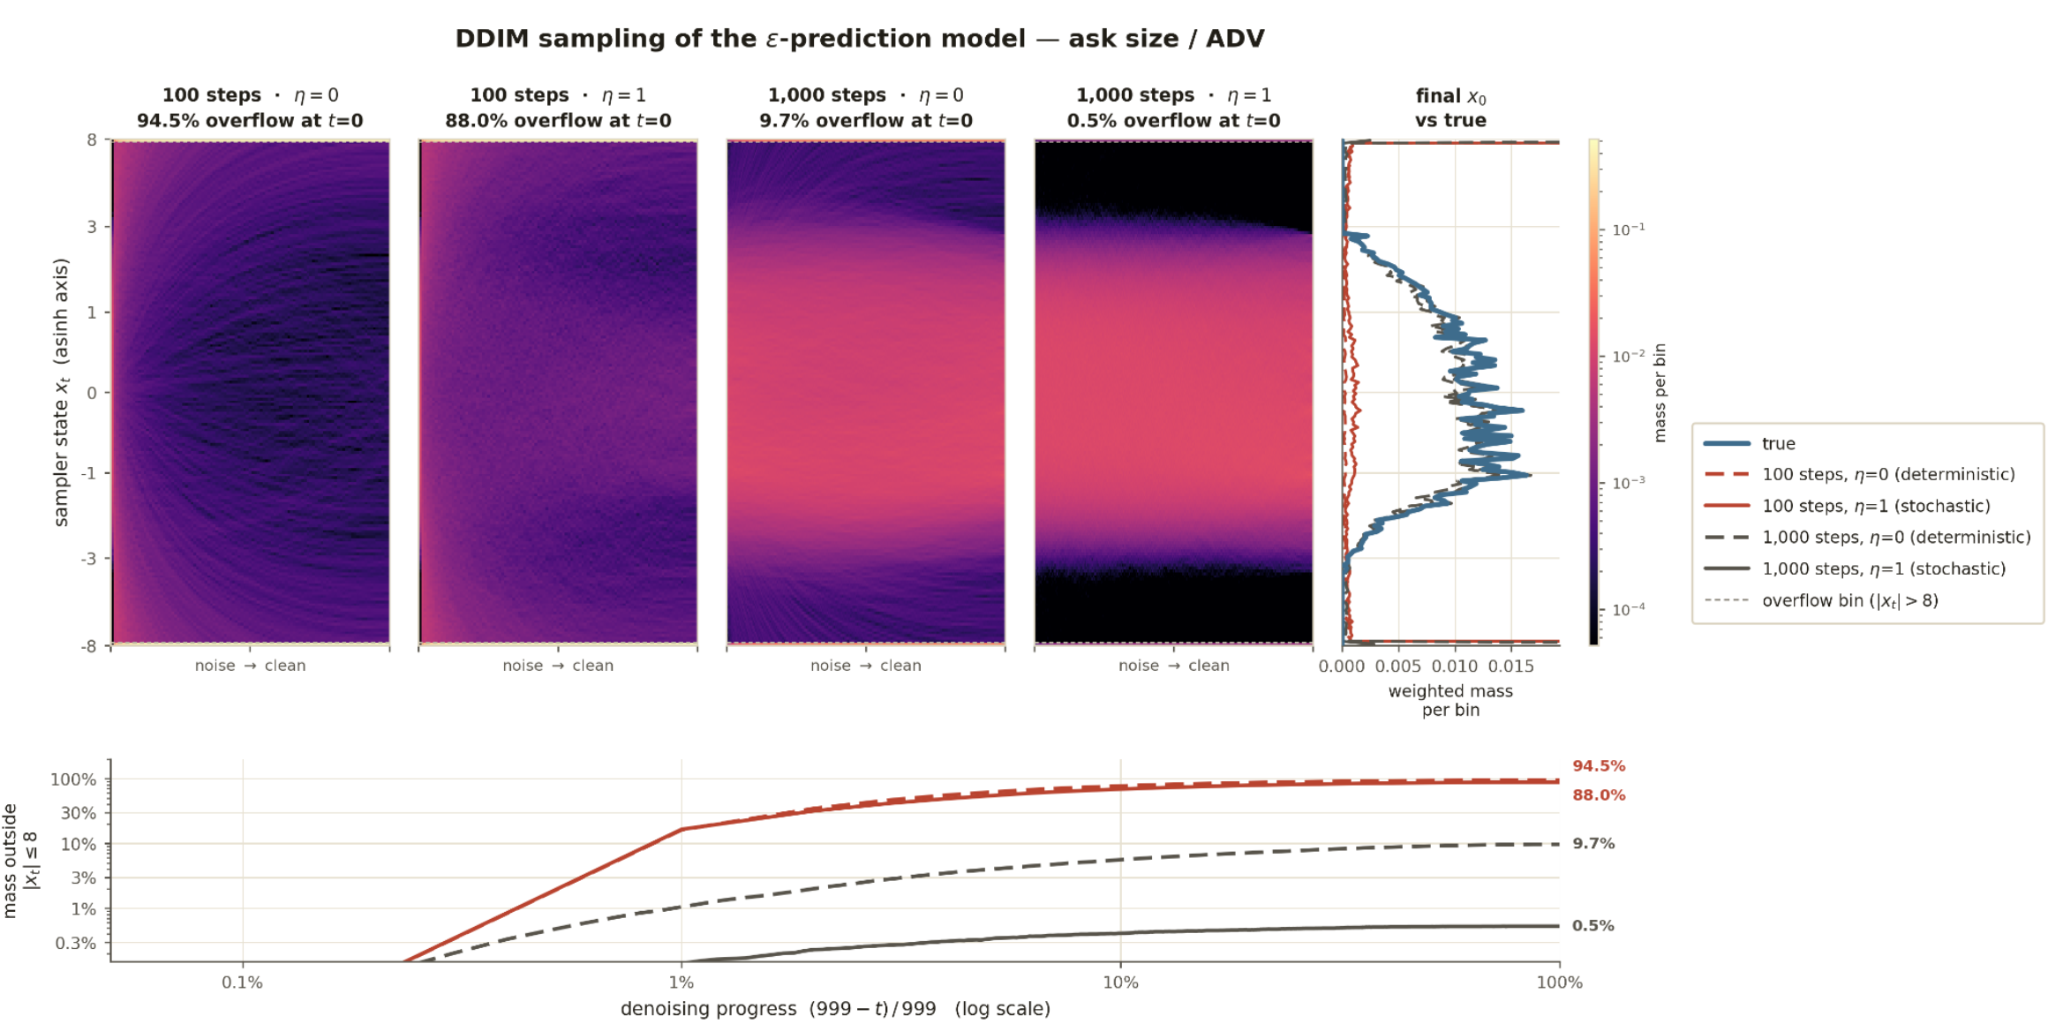
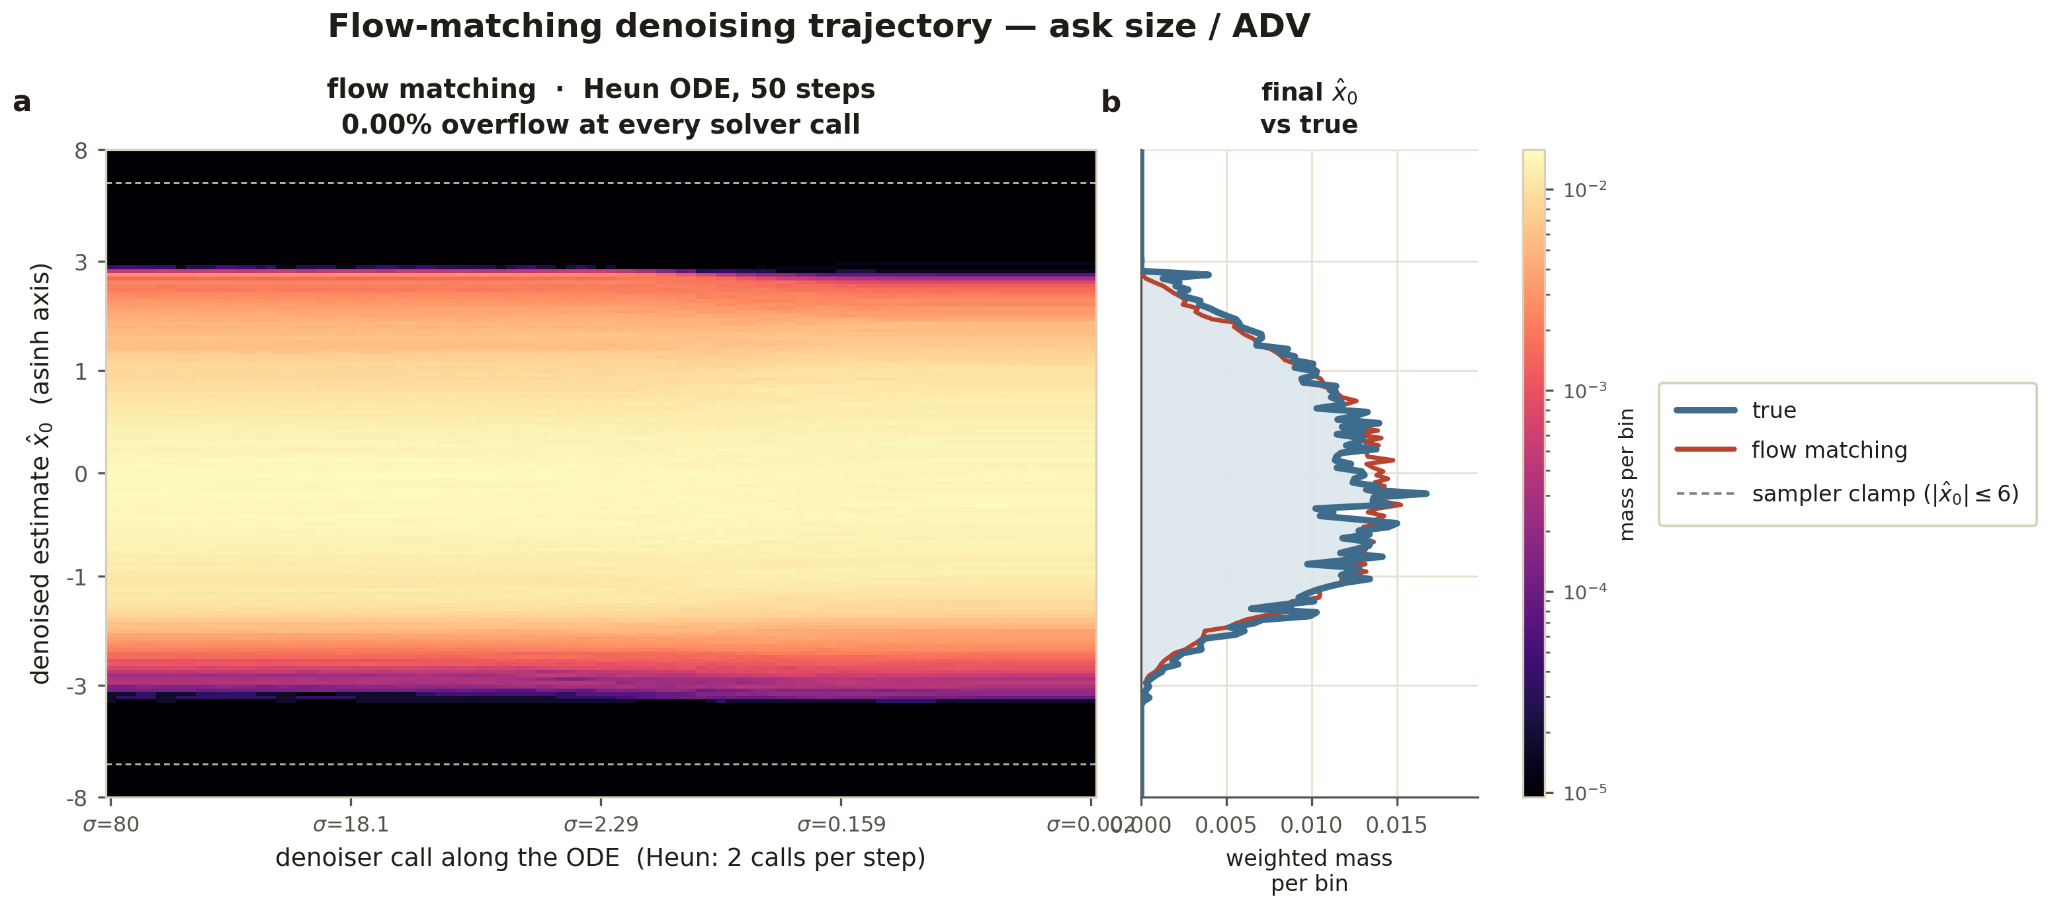
这是因为在计算 $\hat{x}{0} = \frac{x{t} - \sqrt{1 - \bar{\alpha{t}}} \hat{\epsilon}}{\sqrt{\bar{\alpha{t}}}}$ 时 $\epsilon$ 的缩放方式造成的。如图所示,增加采样步数会减小每步的增量,从而防止溢出。此外,给采样过程加入随机性($\eta = 1$)会把去噪过程正则化到标准高斯,减少偏差。虽然可以通过调噪声 schedule 来缓解这种不稳定,或在推理时干预以防止去噪爆炸,但 Kavish 发现 rectified flows 方法开箱即用表现很好。于是他改用 flow-matching 模型。
处理不连续性
项目大部分时间都在和一个根本问题搏斗:市场数据既不是完全连续,也不是完全离散。举例来说,视频非常适合扩散模型,它在快照(每帧是一系列连续像素强度和颜色)和演化(像素在帧间可以取任意连续值)上都是连续的。相比之下,市场数据虽然有连续的快照,却以一种非常离散的方式演化,受市场微观结构支配。
看特征的分布时,这一点很明显:分布带有尖锐的边界。
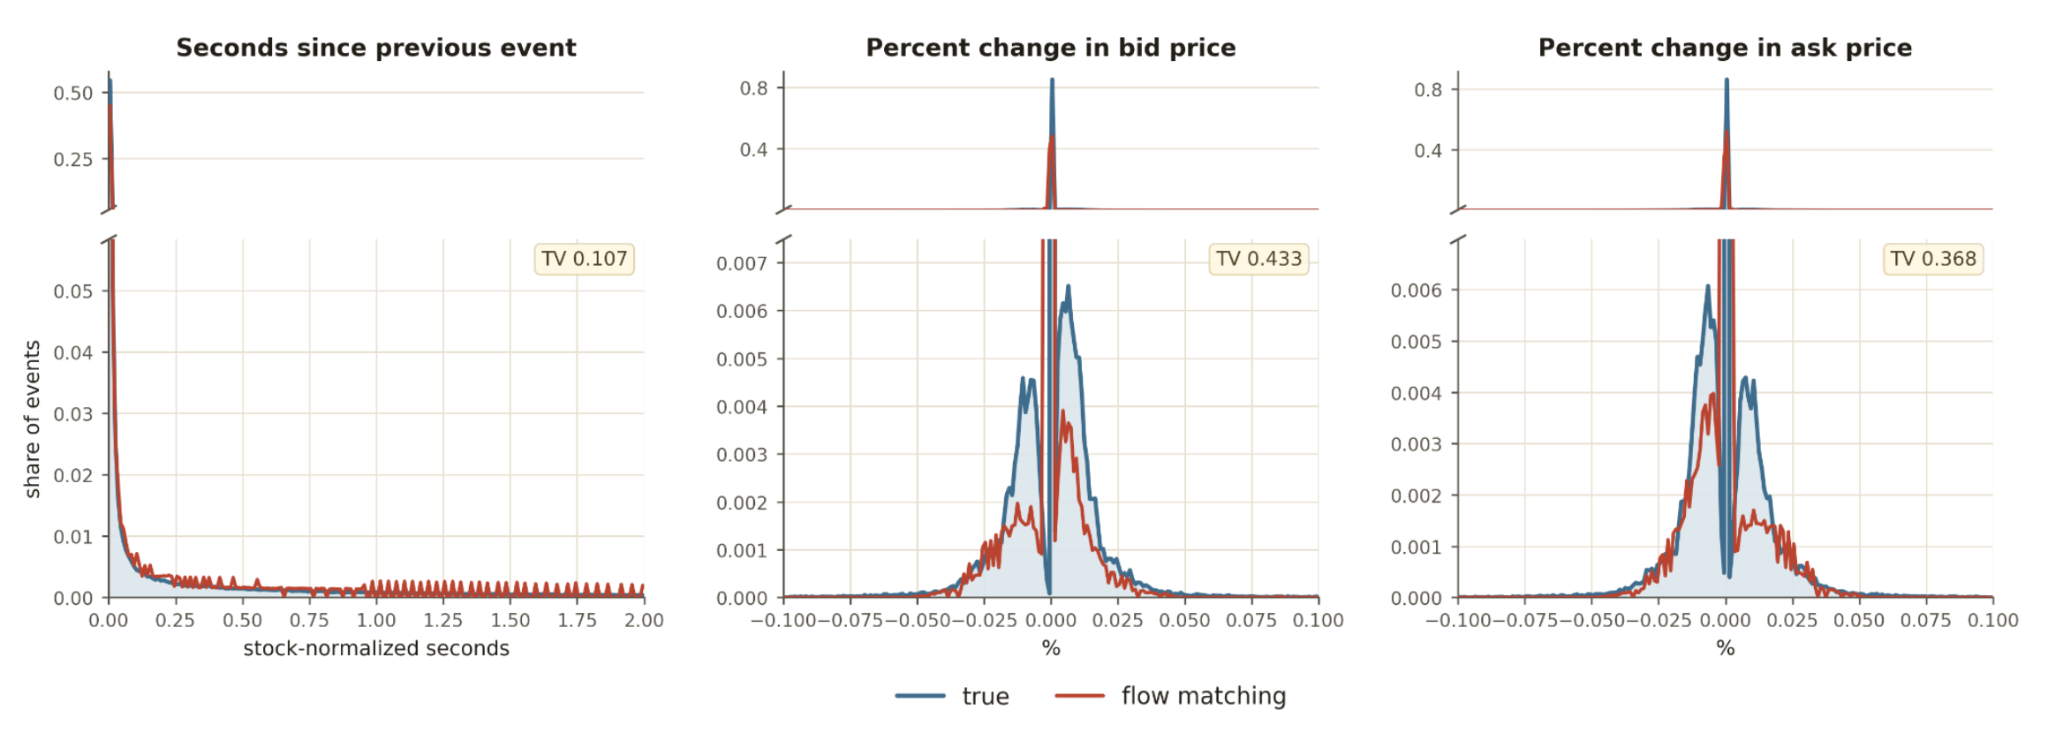
订单的时间不是正态分布,而是相当成簇,在零秒(同时到达的事件)、可能的最早反应时间以及整数秒附近有概率质量点(point masses)。价格也往往聚集在买卖价中点、当前买价或当前卖价附近,因此那里也会出现尖锐的不连续。
类别预测还存在不平衡——只有 8% 的事件是成交,其余都是 BBO 变化;因此类别头会过度预测成交。为此,Kavish 尝试把类别头预测的类别拆得更细。他把 BBO 变化拆成许多常见类别,比如“仅规模变化”(价格不变)、“ask 上移”、“bid 下移”等。这样做还有一个额外好处:可以把某些特征里的“原子”(即尖锐不连续)单独拿出来,例如把“经过时间为零”本身预测成一个类别。最终他得到一个 20 类的类别头,以及更简单的扩散目标,比如“非零时间间隔有多大”(因为零已经被类别头处理)和“买价变化的幅度是多少”(因为方向已经是一个类别)。
这种做法让事件类型和连续目标的边缘分布都明显变好,但显然需要大量手工设计。用类别头去专门建模每一个特征里的每一个不连续,在更大的特征集上会变得不可扩展。例如,真实数据很可能包含更多变量,包括“这笔成交发生在哪个交易所?”这种高基数变量,可能会让类别数量爆炸。
于是 Kavish 去找另一种处理不连续性的方法。
Atom smoothing
他采用了一种后来称为“atom smoothing”的方法。思路是:取真实的尖峰分布,把它平滑开,然后再把尖峰重新塑形回去,以捕获那里的概率质量,同时又不制造不连续。例如:
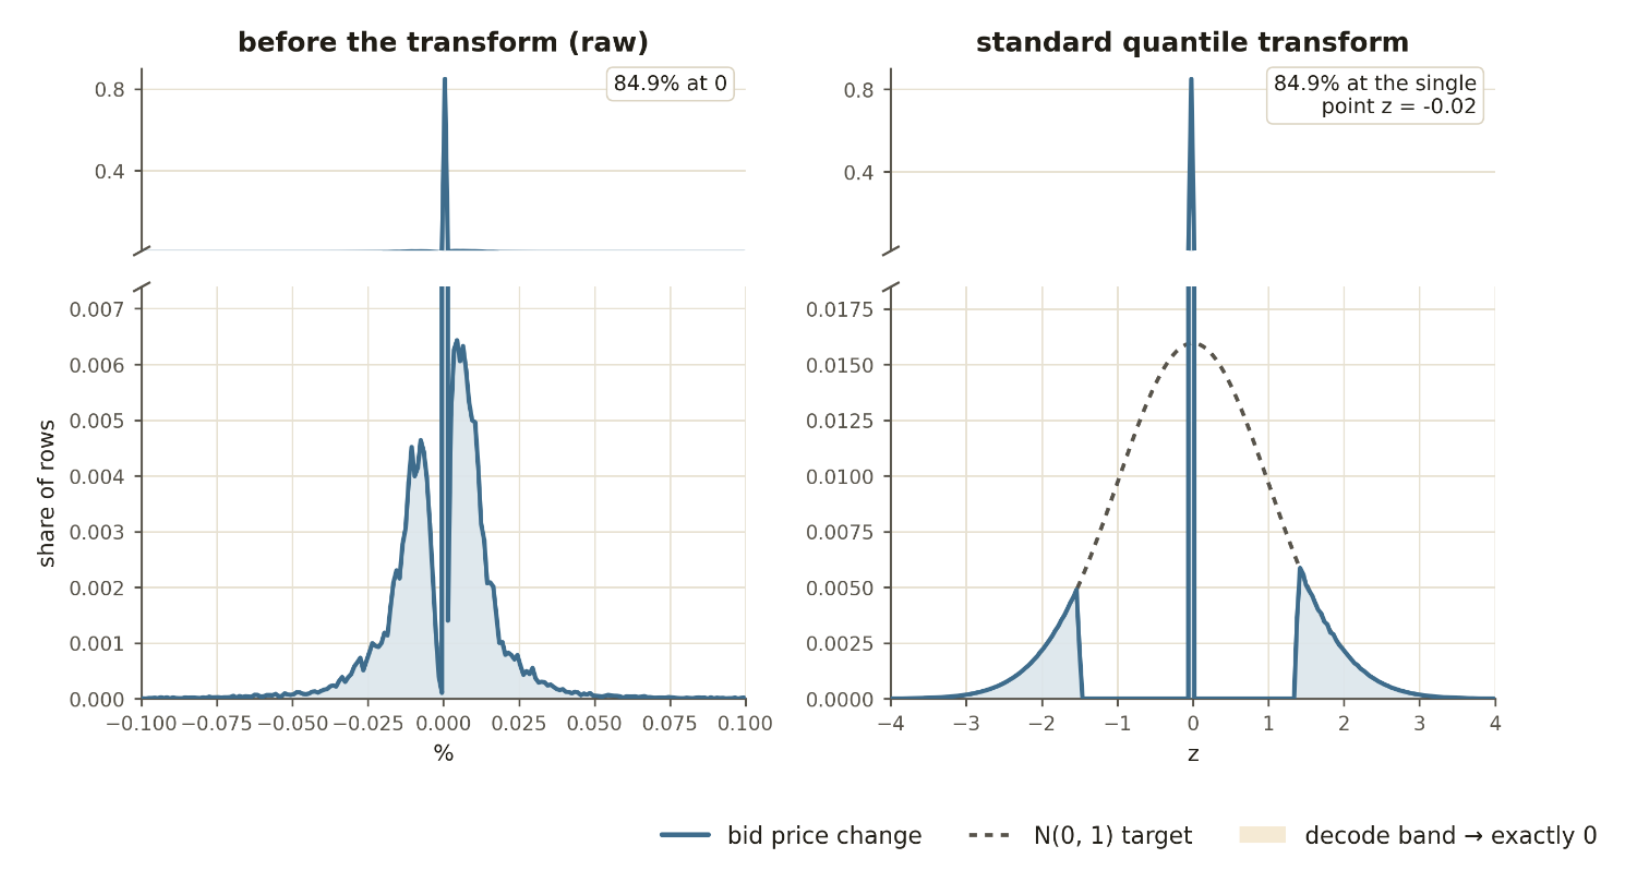
要让它效果好,必须确保为变量选择了正确的表示:在某些表示下很尖的尖峰,换一种表示可能就没那么尖,你需要暴露并平滑所有尖锐的尖峰。
结果与 rollouts
Kavish 发现,结合 flow matching 和 atom smoothing 的扩散模型效果相当好。他按目标把模型输出的边缘分布与真实边缘分布进行比较。这是在单步设定下做的:条件是一个真实的、包含 10,240 个事件的上下文,从模型里采样一个下一个事件,再与真实发生的事件比较。他用总变差(total variation,TV)散度来量化每个目标偏离真实边缘分布的程度,计算公式为 $\frac{1}{2} \sum_{x \in X}^{} \left|\right. P \left(\right. x \left.\right) \textrm{ } - \textrm{ } Q \left(\right. x \left.\right) \left|\right.$,其中 $P \left(\right. x \left.\right)$ 和 $Q \left(\right. x \left.\right)$ 是两个分布。
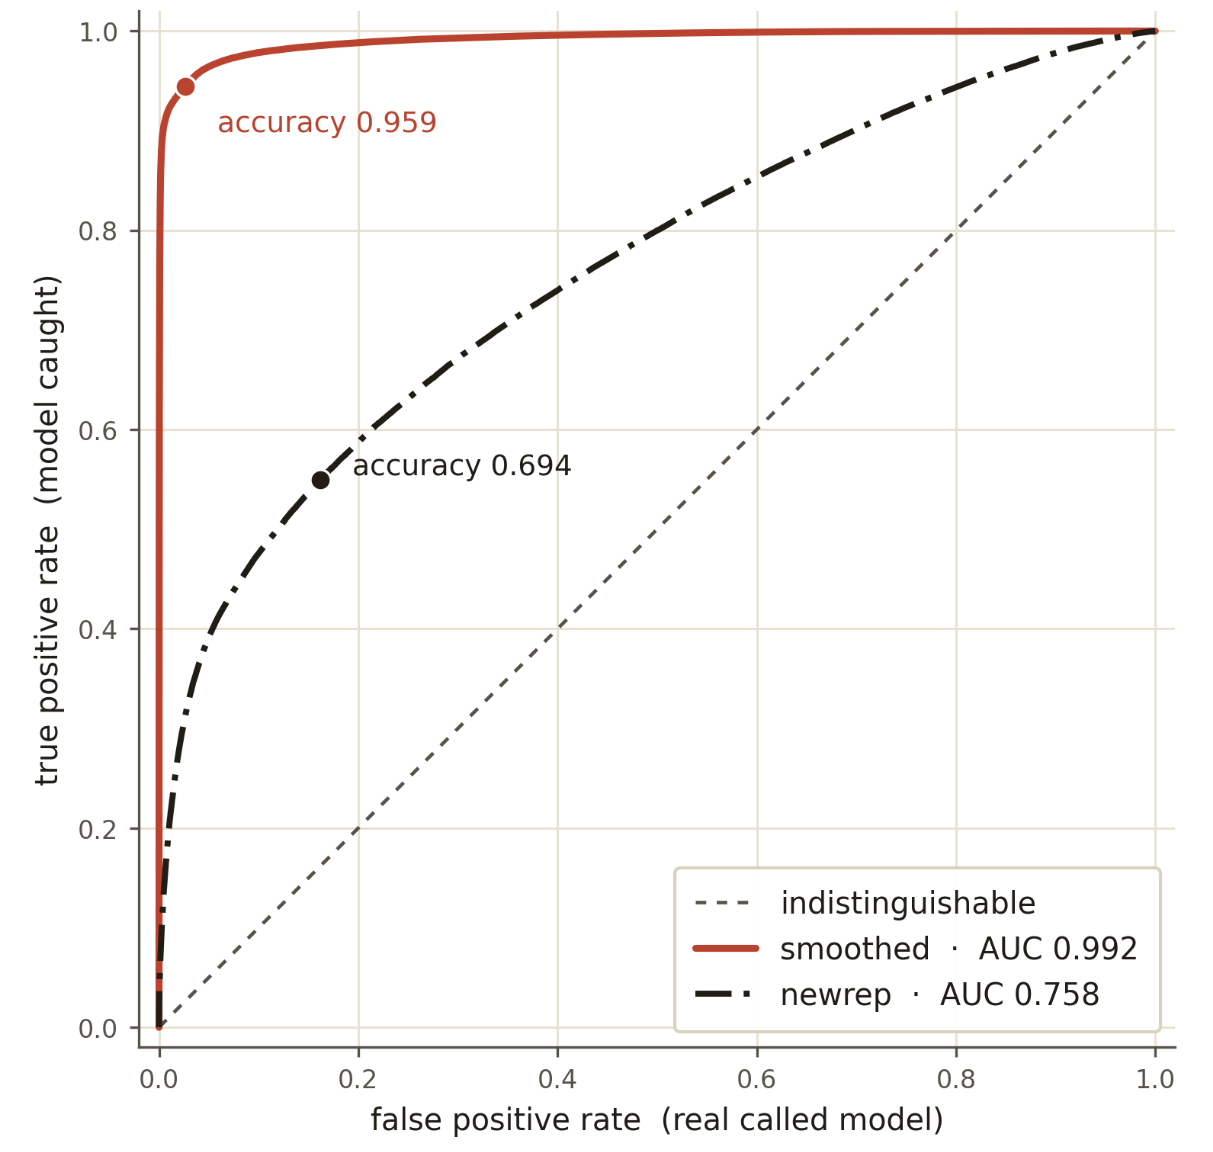
尽管边缘分布对齐很重要,它并不能捕捉特征之间的联合关系,也不能捕捉与前文的时间一致性。因此 Kavish 还训练了一个分类器,用来区分模型生成的预测和真实事件。分类器读取一段真实上下文事件,后面跟一个候选的下一个事件,然后判断这个候选是来自模型还是来自数据。经过 atom smoothing 优化特征表示的生成器,得到的样本明显更真实:
当然,模型的最终目标是产生自回归 rollouts:
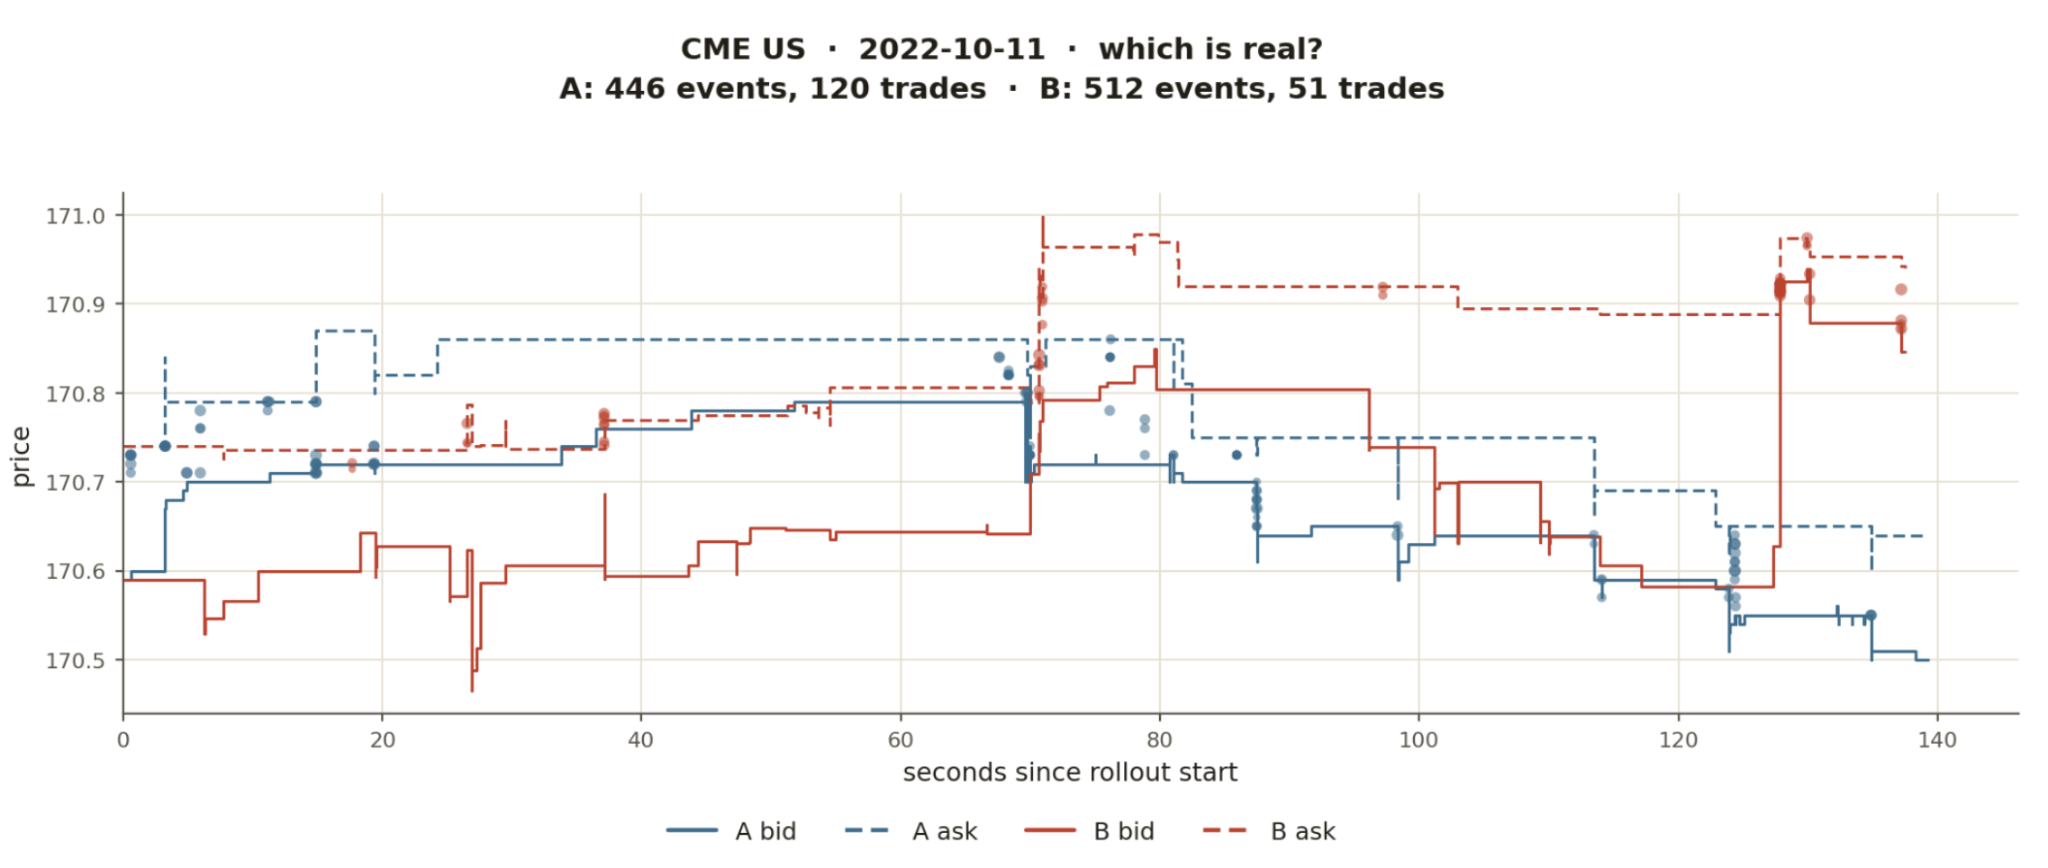
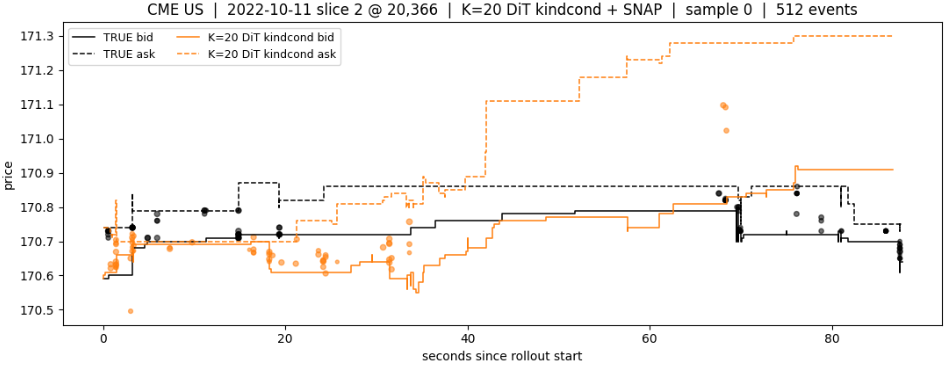
模型的预测自然会随时间推移而退化,一个待研究的问题是:退化有多快?在第二个图里,你可以看到合成 rollout 中 CME US 的价差如何变宽。
Kavish 的模型还不够准确,不能当作一个真实的生成器,但他在实习期间的研究澄清了哪些是关键旋钮:应该在模型里注入多少离散性?(即,哪些东西应该分类预测,哪些又该用扩散预测?)以及如何表示和平滑特征分布,才能给扩散最好的机会?
这个项目让我们把市场数据的订单簿事件理解为同时存在于连续空间(“卖单规模增加 10%”)和离散动作空间(“把买价 penny 一下”)。这是看待同一件事的两种方式。如果你想生成市场数据,就必须正确建模这种混合。
评论
社区整体对这份 Jane Street 实习总结,以及把扩散模型、流匹配方法用到市场时间序列上的写法评价很高;但讨论主轴很快转到「炫技之外,这类模型在真实市场里能否长期有效」:一边赞赏工程与表达,另一边强调市场会切换状态、历史规律会被参与者学会,从而让任何稳定准确的模型失效。
认为把扩散模型迁移到市场时间序列是亮眼的实习成果
- 评论普遍认为这份实习总结信息密度高、完成度惊人,真正亮点在于把扩散模型(以及扩散语言模型的思路)应用到既不是离散也不是连续的市场时间序列数据上,工程实现和写作都值得称道。(较多人) > 真正精彩的是把扩散模型应用到既非离散也非连续的时间序列数据上,看到扩散模型被用于不同场景总是令人着迷。(@armcat)
认为任何市场模型都无法长期稳定准确
- 从市场状态切换、历史表现不可外推、模型洞见会被市场吸收等角度看,评论认为不存在能持续准确的市场模型:过去表现不能代表未来结果,市场切换模式后原有预测会整套失灵;一旦某个模型足够准,市场参与者会学会它的洞见,使其失效。(较多人) > 不存在能持续准确的市场模型,因为市场最终会把准确模型的洞见吸收掉,直到这些洞见不再有效。(@stult)
认为订单到达间隔不应假设为正态,更像自激过程
- 有人指出,原文假设订单到达间隔服从正态值得怀疑;现实里一笔订单到达往往会提高后续订单到达的概率,更接近霍克斯类自激过程,这个细节也可能是故意留给实习生思考和讨论的引子。(少数人) > 订单到达会提高其他订单到达的概率,更像霍克斯过程,而不是简单假设到达间隔服从正态。(@arjie)
有价值的补充
- 流匹配比 DDIM 更稳定的技术原因:有评论补充,2023 年 Heitz 等人的论文指出二者几乎等价,但 DDIM 对应一个在去噪起始处含 1/α 项、会发散的微分方程,而流匹配 / IADB 不会发散;想深挖可看该论文(编号 2305.03486)。
- 关于用模型修补历史数据,有人联想到文艺复兴技术公司的例子:他们曾极力补全历史市场数据里的缺失片段,后来对价格走势的预测强到开始用算法反过来“填补”这些缺口;这个例子被用来类比用生成模型合成或补全金融数据。