今年早些时候,我们发布了 Strands 实验室(strands-labs),供人们上手体验智能体开发的前沿方法。今天又推出 Strands 决策器 2B(Strands Decider 2B),一个面向快速实验、本地开发和创新的小型决策模型。它属于新兴的决策模型,也称系统一模型;自本月初 TypeSafe AI 公司(TypeSafe AI)发布 Jev 模型(Jev)以来,这类模型备受关注。与能生成任意输出的大语言模型(LLM)不同,决策模型要在若干选项之间做出选择,或给出简单的数值评分。
正文
今年早些时候我们推出了 strands-labs,今天新增了 Strands Decider 2B:一个为快速实验、本地开发和迭代创新而优化的小型决策模型。
Strands Decider 属于新一代决策模型(或称系统一模型)。这类模型自本月早些时候 TypeSafe AI 发布 Jev 以来备受关注。与能生成任意输出的大语言模型不同,决策模型用于在给定选项中做选择(例如“字符串‘打开灯’是关于咖啡机的吗?是或否”、“短语‘sihamba ngokushesha’是什么语言?英语、祖鲁语还是荷兰语”),并给出简单数值评分(例如“短语‘这是我读过最好的文档’是正面情绪吗?0到1之间”)。
牺牲灵活性换来的是:在相同规模下更快、能力更强,总是从选项中产出答案,且延迟极低。反过来说,这种方法(单次并行生成所有输出)在解决复杂问题上远逊于推理模型,且因不能生成文本而不适用于编码、聊天机器人、文档摘要等常见大语言模型任务。
此外,决策模型为每个决策提供高质量可靠性评分(即“这个是非题正确的把握有多大?”),这是前沿大语言模型推理 API 所没有的。它们还能高效地对同一提示问多个问题。这些特性使它们非常适合驱动许多开发者用 Strands Harness SDK 和最近发布的 Strands harness 构建的智能体工作流。我们预计这类模型将在未来数周、数月和数年里推动智能体 AI 的有趣创新。
Strands Decider 2B 是我们对此创新的首个贡献。它是一个 20 亿参数模型,适合在本地 CPU 或 GPU 上运行,能在几十毫秒内返回有意义问题的答案。其准确度和校准能力与我们所知同类模型相当。我们已在 GitHub 开源 strands-decider-2b,权重在 Hugging Face,包含构建模型所用的所有训练数据和脚本,是开启你自己创新之旅的绝佳起点。
模型架构
核心思路是取一个预训练 LLM 主干(Qwen3.5-2B),移除 LM 头以剥夺其生成文本的能力。LM 头被指针头取代,针对每个选项对主干给出的答案打分。它通过将各选项位置的隐藏状态与 <answer> 位置的隐藏状态进行对比来打分。这个头很小,总共刚过一百万参数。主干用 rank-16 LoRA 适配器微调。
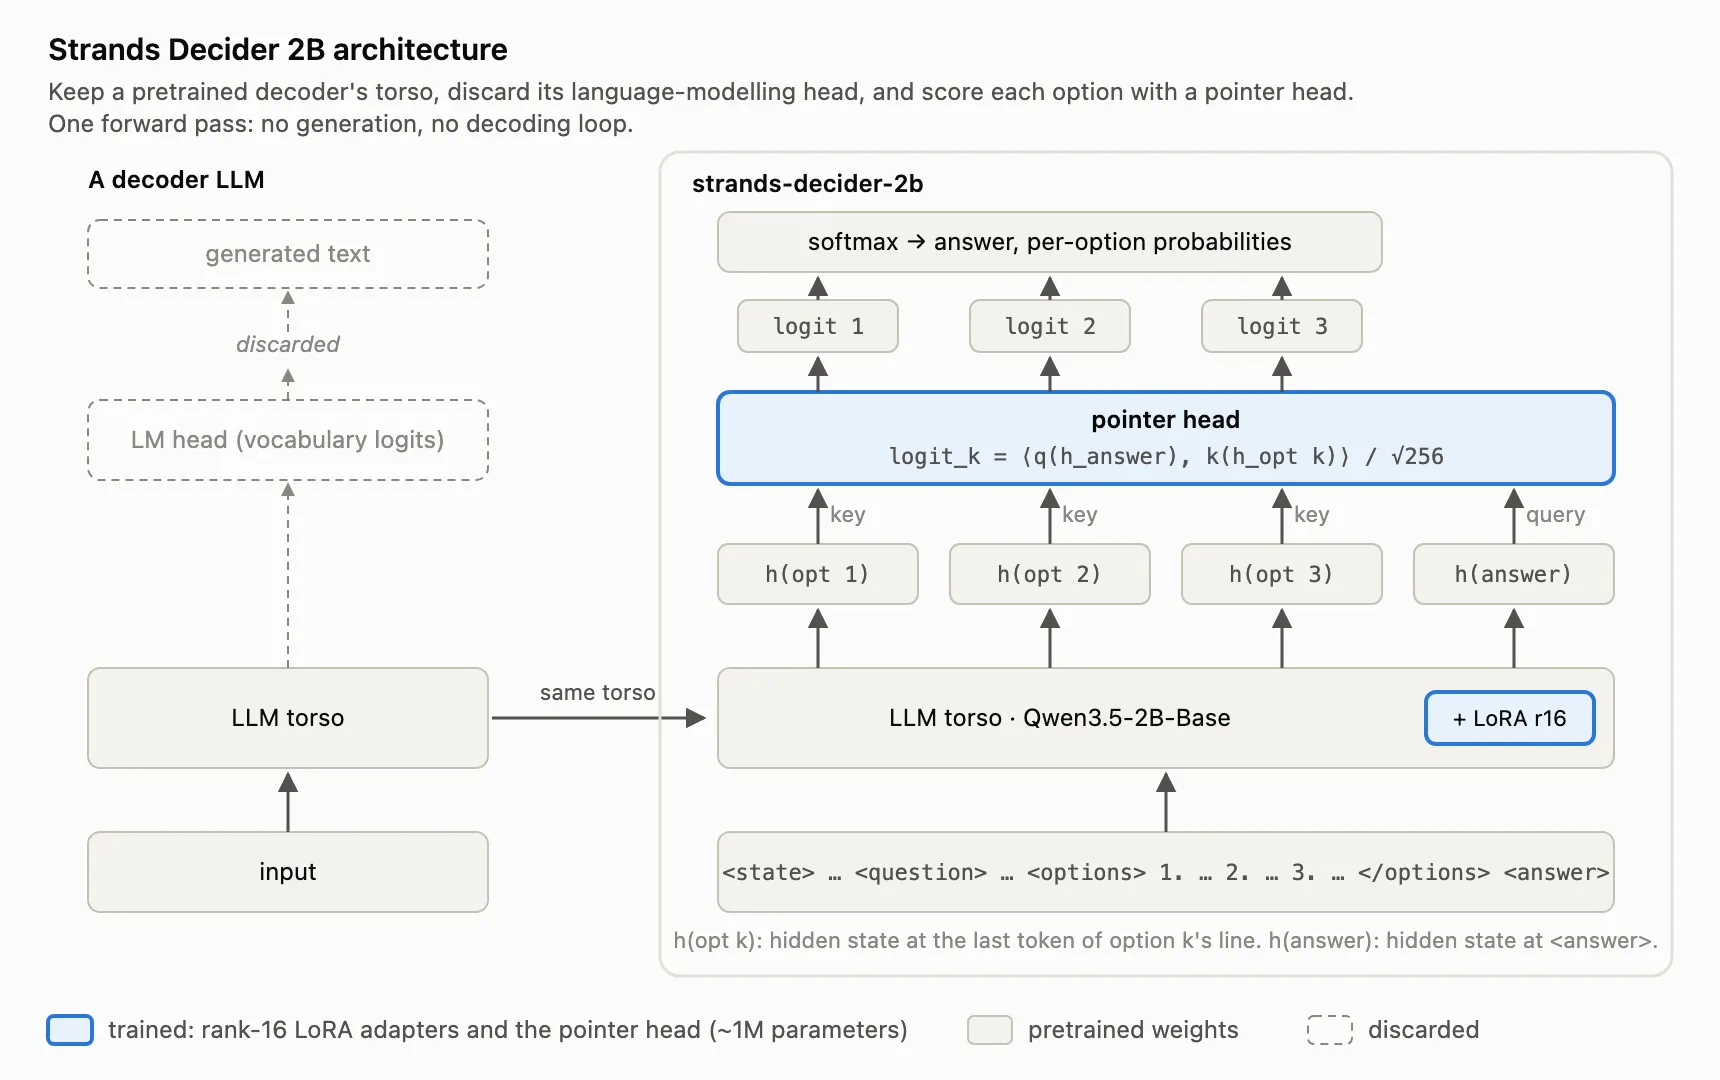
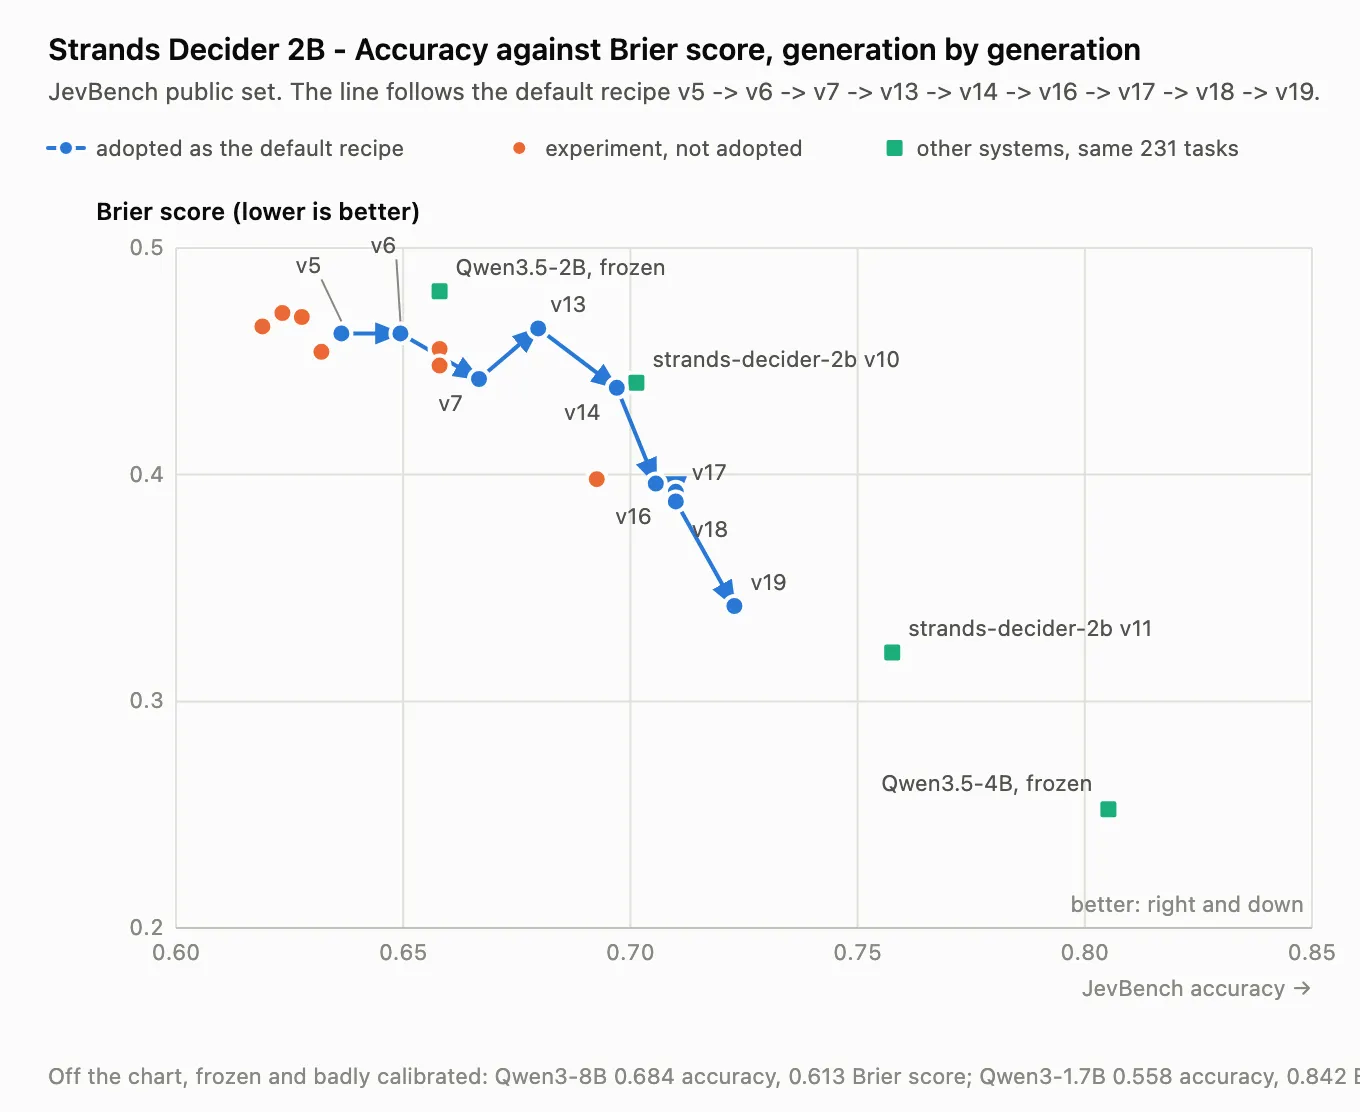
浏览仓库时会发现这是该架构的第二次主要迭代。第一版类似,但用了槽位头,表现差很多。实际上今天发布的模型是 v19,背后经历了大量迭代。每个版本的改动都在仓库中有记录,你可以跟进我们的工作。
性能表现
对于这类模型,我们关注三个性能目标:准确度(答题好坏)、校准度(置信评分可信度)和延迟(决策速度)。前两者一起测:在 JevBench 公开集上的准确度,以及同集上用 Brier 分数测的校准度。strands-decider-2b 表现良好(在 2B 级别 33 个模型中排第 3,排除刚超 2B 的模型后 30 个里排第 1)。架构演进中分数在提升,我们还有很多改进想法。希望社区以 strands-labs 精神加入,贡献新想法。
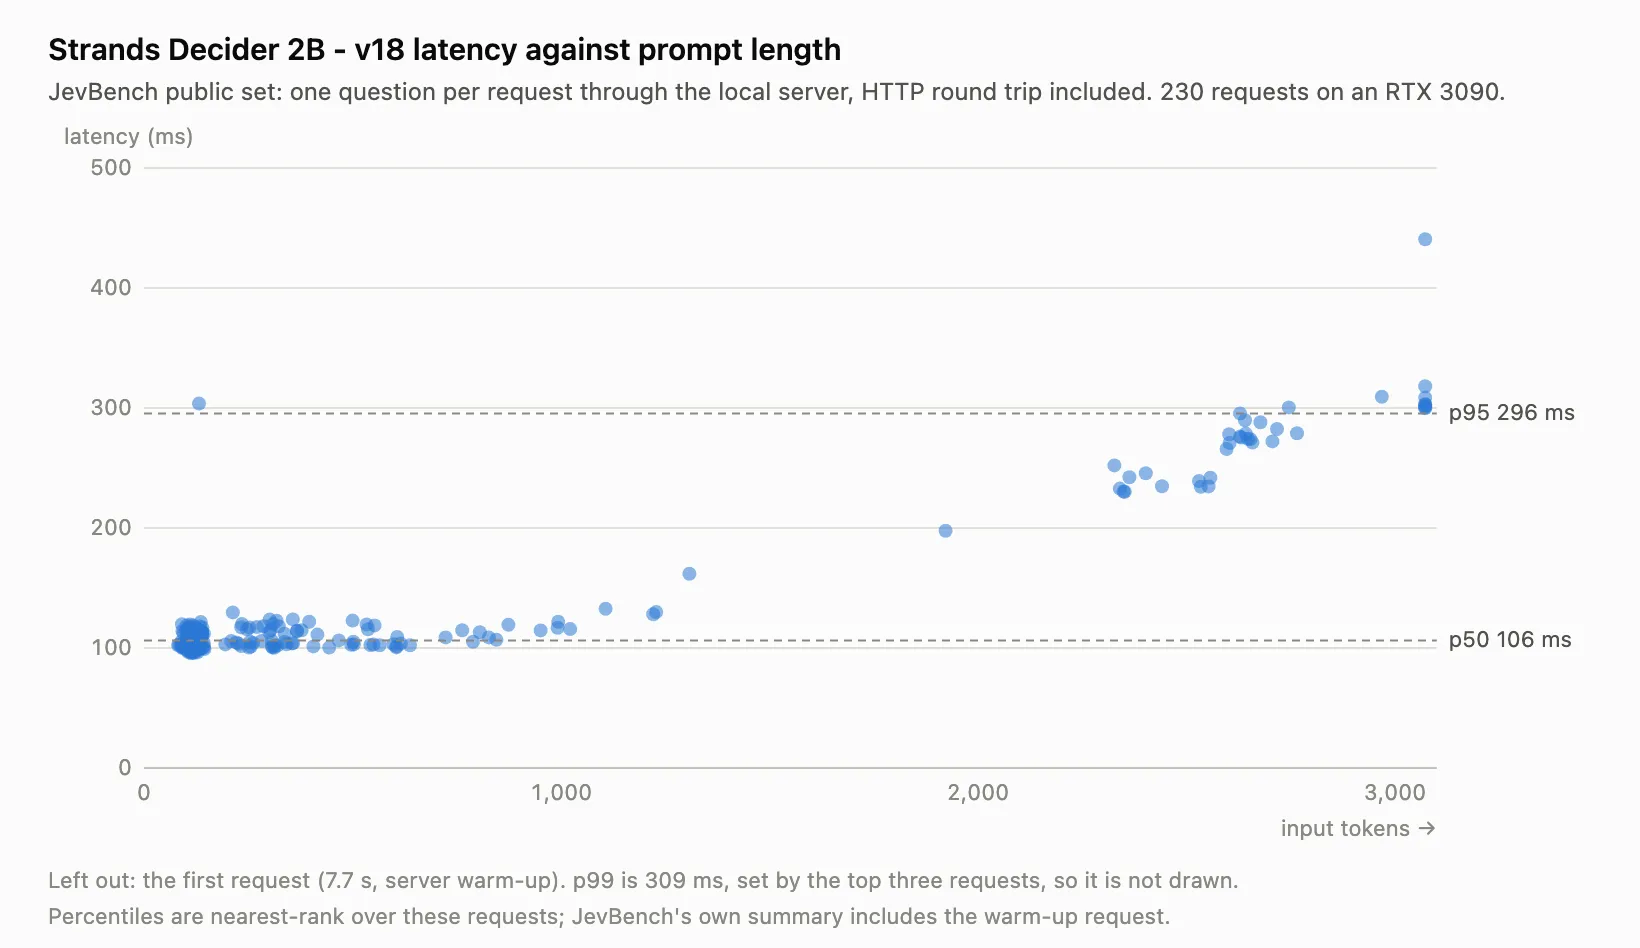
延迟方面,strands-decider-2b 在常见硬件上本地决策中位延迟约 115 毫秒。决策耗时取决于任务规模,随任务变大近似线性增加。图中结果在本地 Nvidia RTX3090 上测得,M3 MacBook 上表现相差不多,小任务中位延迟约 153 毫秒。和准确度校准一样,我们有很多降低底延迟的想法。
为何是 2B?
我们选择将 Strands Decider 作为小模型发布,原因有二。一是鼓励实验:你可以用甚至训练 strands-decider-2b 在已有硬件上,轻松、快速、低风险。二是 20 亿总参数似乎是甜点:小到足以实验,大到能做有意义工作。例如 Strands Decider 在 JevBench 上简单任务正确率 100%,这类问题很契合人们用智能体处理的较易问题。
能用 Strands Decider 做什么?
随便你!说正经的,我们看到这类模型在模型路由、工具选择、评估、护栏、记忆、上下文管理和策略分类上的早期成功。我们也看到用 LLM 做最难决策、决策模型做简单重复决策来构建混合智能体的创新,降低了成本和延迟。还有将决策模型与固定工作流语言结合构建混合工作流的实验。人们也用这类模型玩游戏、自动化任务、走迷宫等。该领域创新速度惊人。
试用
最简单的入门方式是通过 strands-decider CLI:
pip install strands-decider
选择题
你可以基于某些状态和问题让模型选择:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 --state "Help! My payouts have been failing for 3 days! " --choice "Which team should handle this?=billing,sales,retail"
示例输出:
choice_0 -> billing (confidence 0.768) billing 0.845 retail 0.091 sales 0.064
输出显示模型预测 billing 为答案且概率分最高。
仓库还包含在 Strands 智能体中使用 strands-decider-2b 的示例(在 examples/strands/)。智能体本地运行,连接本地 Strands Decider,然后使用 Amazon Bedrock 的默认 LLM。
场景刻意做小:智能体有演示用的 get_weather 工具,系统提示让它很积极,用户问“天气怎样?”不指定地点时,它会猜城市并调用工具。但在调用前,strands-decider-2b 会读取对话和提议的工具调用,回答两个是非题:参数值是否基于用户实际所说(剧透:没有!),以及现在调用是否太早。几行 Python 将预测转为决策,智能体转而问你指哪个城市,而不是自信报告没人提的地点的天气。
代码中定义了两个问题:args_grounded(参数是否基于用户实际提供的事实)和 premature(澄清前调用是否过早),各含真假值说明。
这里的模式是 Strands 的干预系统。我们用带 before_tool_call 方法的 InterventionHandler,传给 Agent(interventions=[...]),在任何工具执行前运行。它返回类型化动作:Proceed(继续)、Deny(拒绝)、Confirm(停止问人)、Guide(带反馈交回模型而不直接阻断)。该处理器是 Python 类,Strands 不限制里面写什么,所以无论调用我们的决策模型、Cedar 策略还是另一个智能体,形状都一样。(模型调用和整个调用周围也有等价钩子。)此示例仅作说明非建议,问题、阈值和策略都手动选的。重点是这么便宜的决策能处在 LLM 调用不可能处的路径上。Strands 团队正开发决策模型集成库,请关注仓库更新。
结论
今天你就可以下载、使用或基于 strands-decider-2b 构建。所有数据及上手所需都已可用。代码从 GitHub 获取,最新快照在 Hugging Face。去实验吧!
评论
讨论整体偏正面:多数人认可这个 2B 决策模型在体积、能力和速度上的平衡,并已经在浏览器扩展、Mac mini 自动化等场景里实际使用;分歧主要落在两处——基准校准能否代表真实生产输入上的可靠性,以及是否会被 Strands 自家的运行方式锁死。另外还有一票人把注意力放在部署细节上:CPU 到底跑不跑得动。
认为这类小模型已经足够实用
- 有人已经在浏览器扩展里用它过滤邮件,认为它在批量、临时的分类任务上刚好卡在体积、能力和速度的甜点上,还给出了 WebGPU 版本的模型地址(较多人)
- 也有人打算在 Mac mini 上拿它做轻量自动化(少数人)
- 有人强调文章本身写得极好:外行也能看懂 AI 专家在讲什么,是写给人的而不是写给同行的,并希望社区多贡献使用场景(较多人)
认为基准校准不等于生产环境可靠
- 校准过的概率只在基准分布上好看,换到不熟悉的生产输入上并不能保证可靠(少数人)
- 顺带有人问这些模型有没有多模态版本,想拿校准概率去回答「这两个形状是否一致」这类问题(少数人)
担心被 Strands CLI 锁死,希望走 llama.cpp
- Cloudflare 的 clef 就跑在 llama.cpp 上,被绑死在某套 CLI 会拖慢采用;既然本质是 Qwen 上的 LoRA,理论上应该能走 llama.cpp(少数人)
- 遗憾之处在于 LoRA 到 GGUF 的转换被甩给用户自己做,有人尝试转换时在注意力层的张量映射上报错卡住(少数人)
建议把这类常驻模型卸载到 NPU
- 长期在后台占用 CPU 的体验并不好,把推理挪到 NPU 是更优解:性能大约翻倍,功耗约为四分之一,风扇也不会吵(较多人)
- 发言者打算等这一波同类模型的第一轮混战结束后,整理一套 NPU/核显方案发到 Hugging Face(少数人)
觉得「2B 也叫小模型」很能说明时代
- 2B 被归入「小」模型这件事本身就是时代的注脚(少数人)
对 noul 这个叫法感到困惑
- 大家都在用
noul指代二选一,但没人解释这个词的含义,怀疑只是照抄了 Jev 的 API 命名(少数人)
玩笑:干脆让真人来当决策模型
- 有人调侃说,不如等哪位喜剧演员推出一个「由人类驱动」的决策模型,比如 Jerry——字面意义上一个叫 Jerry 的人来回答你的问题(少数人,代表社区对「人类基线」的戏谑情绪)
有价值的补充
- 想直接在浏览器里跑,可以参考 Hugging Face 上的
alxnahas/strands-decider-2B-webgpu。 - 容易踩的坑:LoRA 转 GGUF 时,
layers.0.linear_attn.in_proj_a.weight这类张量目前无法映射,转换脚本会直接抛错。 - 部署经验之谈:这类微型模型常驻 CPU 会有噪音和功耗代价,改用 NPU 大约能拿到两倍性能和四分之一功耗。