2026年10月6日,米斯特拉尔人工智能(Mistral AI)发布米斯特拉尔大模型4(Mistral Large 4)公开预览版,非正式简称 ML4,正式昵称 le Chonk。ML4 是拥有 1 万亿参数、490 亿激活参数的原生多模态模型,是该公司迄今规模最大、能力最强的模型,并推动开放权重性能前沿;它会随优化持续快速提升。用户现在可试用预览 API,权重将于 2026年10月底发布。
正文
胖墩(Le Chonk)
今天,我们推出 Mistral Large 4(非正式称 ML4,正式代号 Le Chonk)的公开预览。ML4 推动了开放权重性能的前沿。今天可在 Mistral Studio 试用预览 API,权重将于本月底发布。
前沿性能
ML4 是一个 1 万亿参数、原生多模态模型,活跃参数 490 亿,是我们迄今最大且最强的模型,并在持续快速改进。它在编码、智能体工作流和多模态理解上表现卓越,性能可媲美全球最强开源模型,大幅超越美国或欧洲开发的任何开放权重模型。在网络安全、金融和法律等关键企业负载上,它是开源模型中的顶尖水平;在视觉定位等领域甚至超越前沿闭源模型。权重月底发布前,我们正在真实场景中与网络安全领袖、审核合作伙伴和州级机构红队测试,他们将获得审核放宽、网络能力扩大的同款模型。
欧洲锻造,为 AI 主权而生
ML4 从零开始,在欧洲自有数据中心使用 3800 块 NVIDIA Grace Blackwell GPU 训练,公开预览也运行在同一设施上。这是我们在基础设施、研究和产品长期投资的里程碑:通过开放权重提供关键垂直领域的顶尖性能,让客户掌控自己的 AI。这在网络安全尤为关键,因为供应商级拒绝可能阻碍合法漏洞研究和事件响应,事件中丧失能力本身就是安全风险。ML4 将顶级网络性能与开放权重、自部署结合,赋予组织自主运行高级安全工作的能力。模型将在全球多区域可用,包括由 Mistral 端到端运营、独立于其他数字服务商且服从欧洲法律的欧洲部署。有趣的是,ML4 训练数据的很大一部分是多语言的,涵盖 160 多种语言,包括欧盟所有官方语言。我们与全球金融、工程、制造、物流、制药、科学、航运、公共部门等企业的紧密合作训练了 ML4,它使用的训练、定制和 RL 环境正是我们通过 Mistral Forge 提供给客户的。
即刻试用
我们邀请你试用预览 API 并反馈。该模型将作为新一代专用和优化 Mistral 模型的基础。
能力深潜
网络安全
ML4 是全球最强的网络安全 AI 模型之一。在 Artificial Analysis Cyber Index(独立评估找补真实软件安全缺陷)中,它全球前五,且大幅领先中国以外开放权重模型。在其中一项要求复现开源漏洞并修补的测试中,ML4 以 82% 居首。它在包含 40 项安全竞赛练习的 Cybench 中解决了 93%,是开放权重模型最高分之一。这反映了实际优势:一些领先闭源模型如 Claude Opus 5.5 和 GPT-6 Astra 因拒绝执行而得近零分,但防御常始于证明漏洞真实,恰是闭源安全过滤所阻。随着威胁行为越狱闭源模型搞进攻,防御者需要匹配能力而不受同样拒绝限制的系统。ML4 能做到,且能力超越显式训练:内部测试证明它有助于分析恶意软件、排优先级和写检测规则。需要主权、可审计安全运维的组织可在私有云或本地运行。
智能体编码
ML4 在软件工程、仓库理解和复杂终端工作流表现出色,DeepSWE v1.1 得 61.7%,SWE-Atlas-QnA 59.4%,Terminal-Bench 4 得 28.3%。综合 Coding Agent Index 49.8% 领先 DeepSeek V4 Pro 0813 和 Qwen3.8 Max。Surge AI 盲测中(专业标注者 1-5 分隐名评代码质量),ML4 预览以 3.74 排五模型第二,超 Kimi K3 (3.59)、GLM-5.3 (3.60) 和 GLM-5.2 (3.40),仅次 Claude Opus 5 (4.22)。
智能体工作流
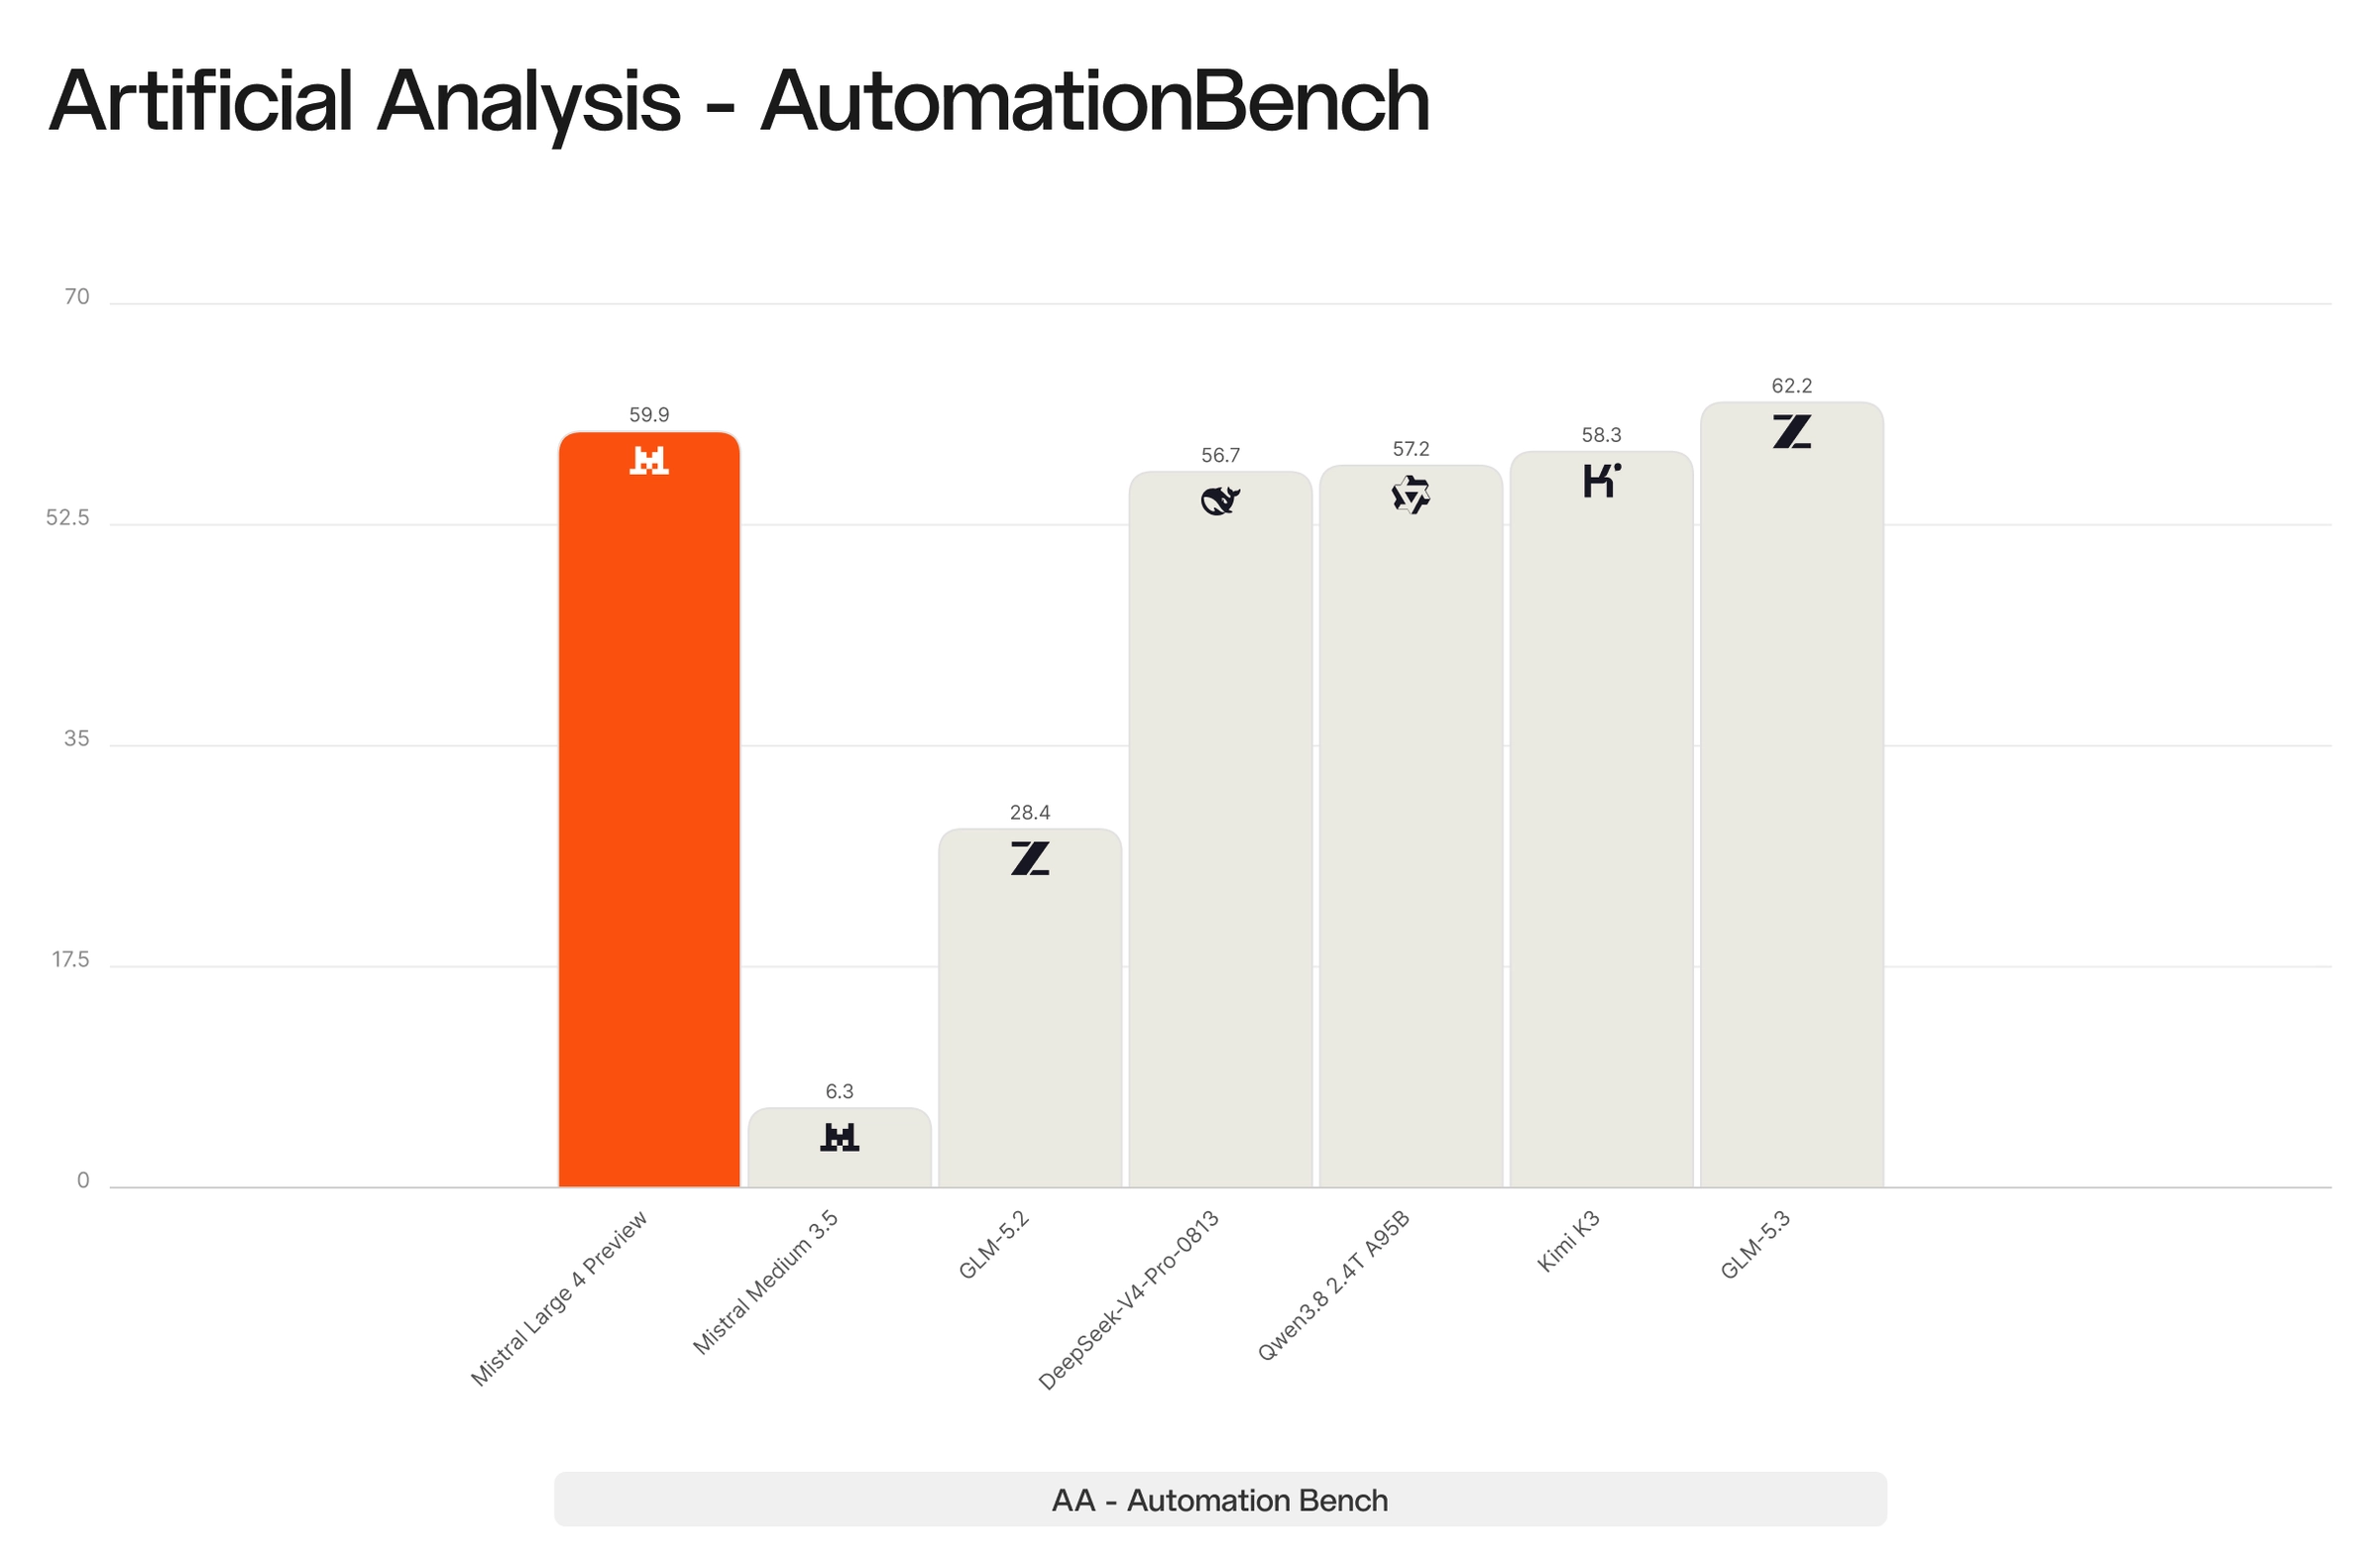
ML4 运行通用智能体,在复杂工作流中搜集信息、用工具并产出成品。在涵盖 Gmail、Sheets、Slack 等 657 项业务流的 AutomationBench 上得 59.9%,超前述模型。在评估长程知识工作的 AA-Briefcase 上达 1393 Elo,领先 DeepSeek V4 Pro。
多模态
ML4 在图像理解上阶跃提升,能强力推理复杂文档、图表和自然图像,为工程、制造和地球观测等关键感知行业带来视觉能力。它可将视觉定位与智能体结合:从检查千兆像素卫星图助救灾,到分析工程图缩放验证。演示中,ML4 定位密集自然场景、验证技术图纸机械零件、从 PDF 取证、扫描大型地理图像找难寻物体。视觉定位尤强,如 Dense 200 上以 42% 对 41% 超越 GPT-6-Astra。
科学与数学
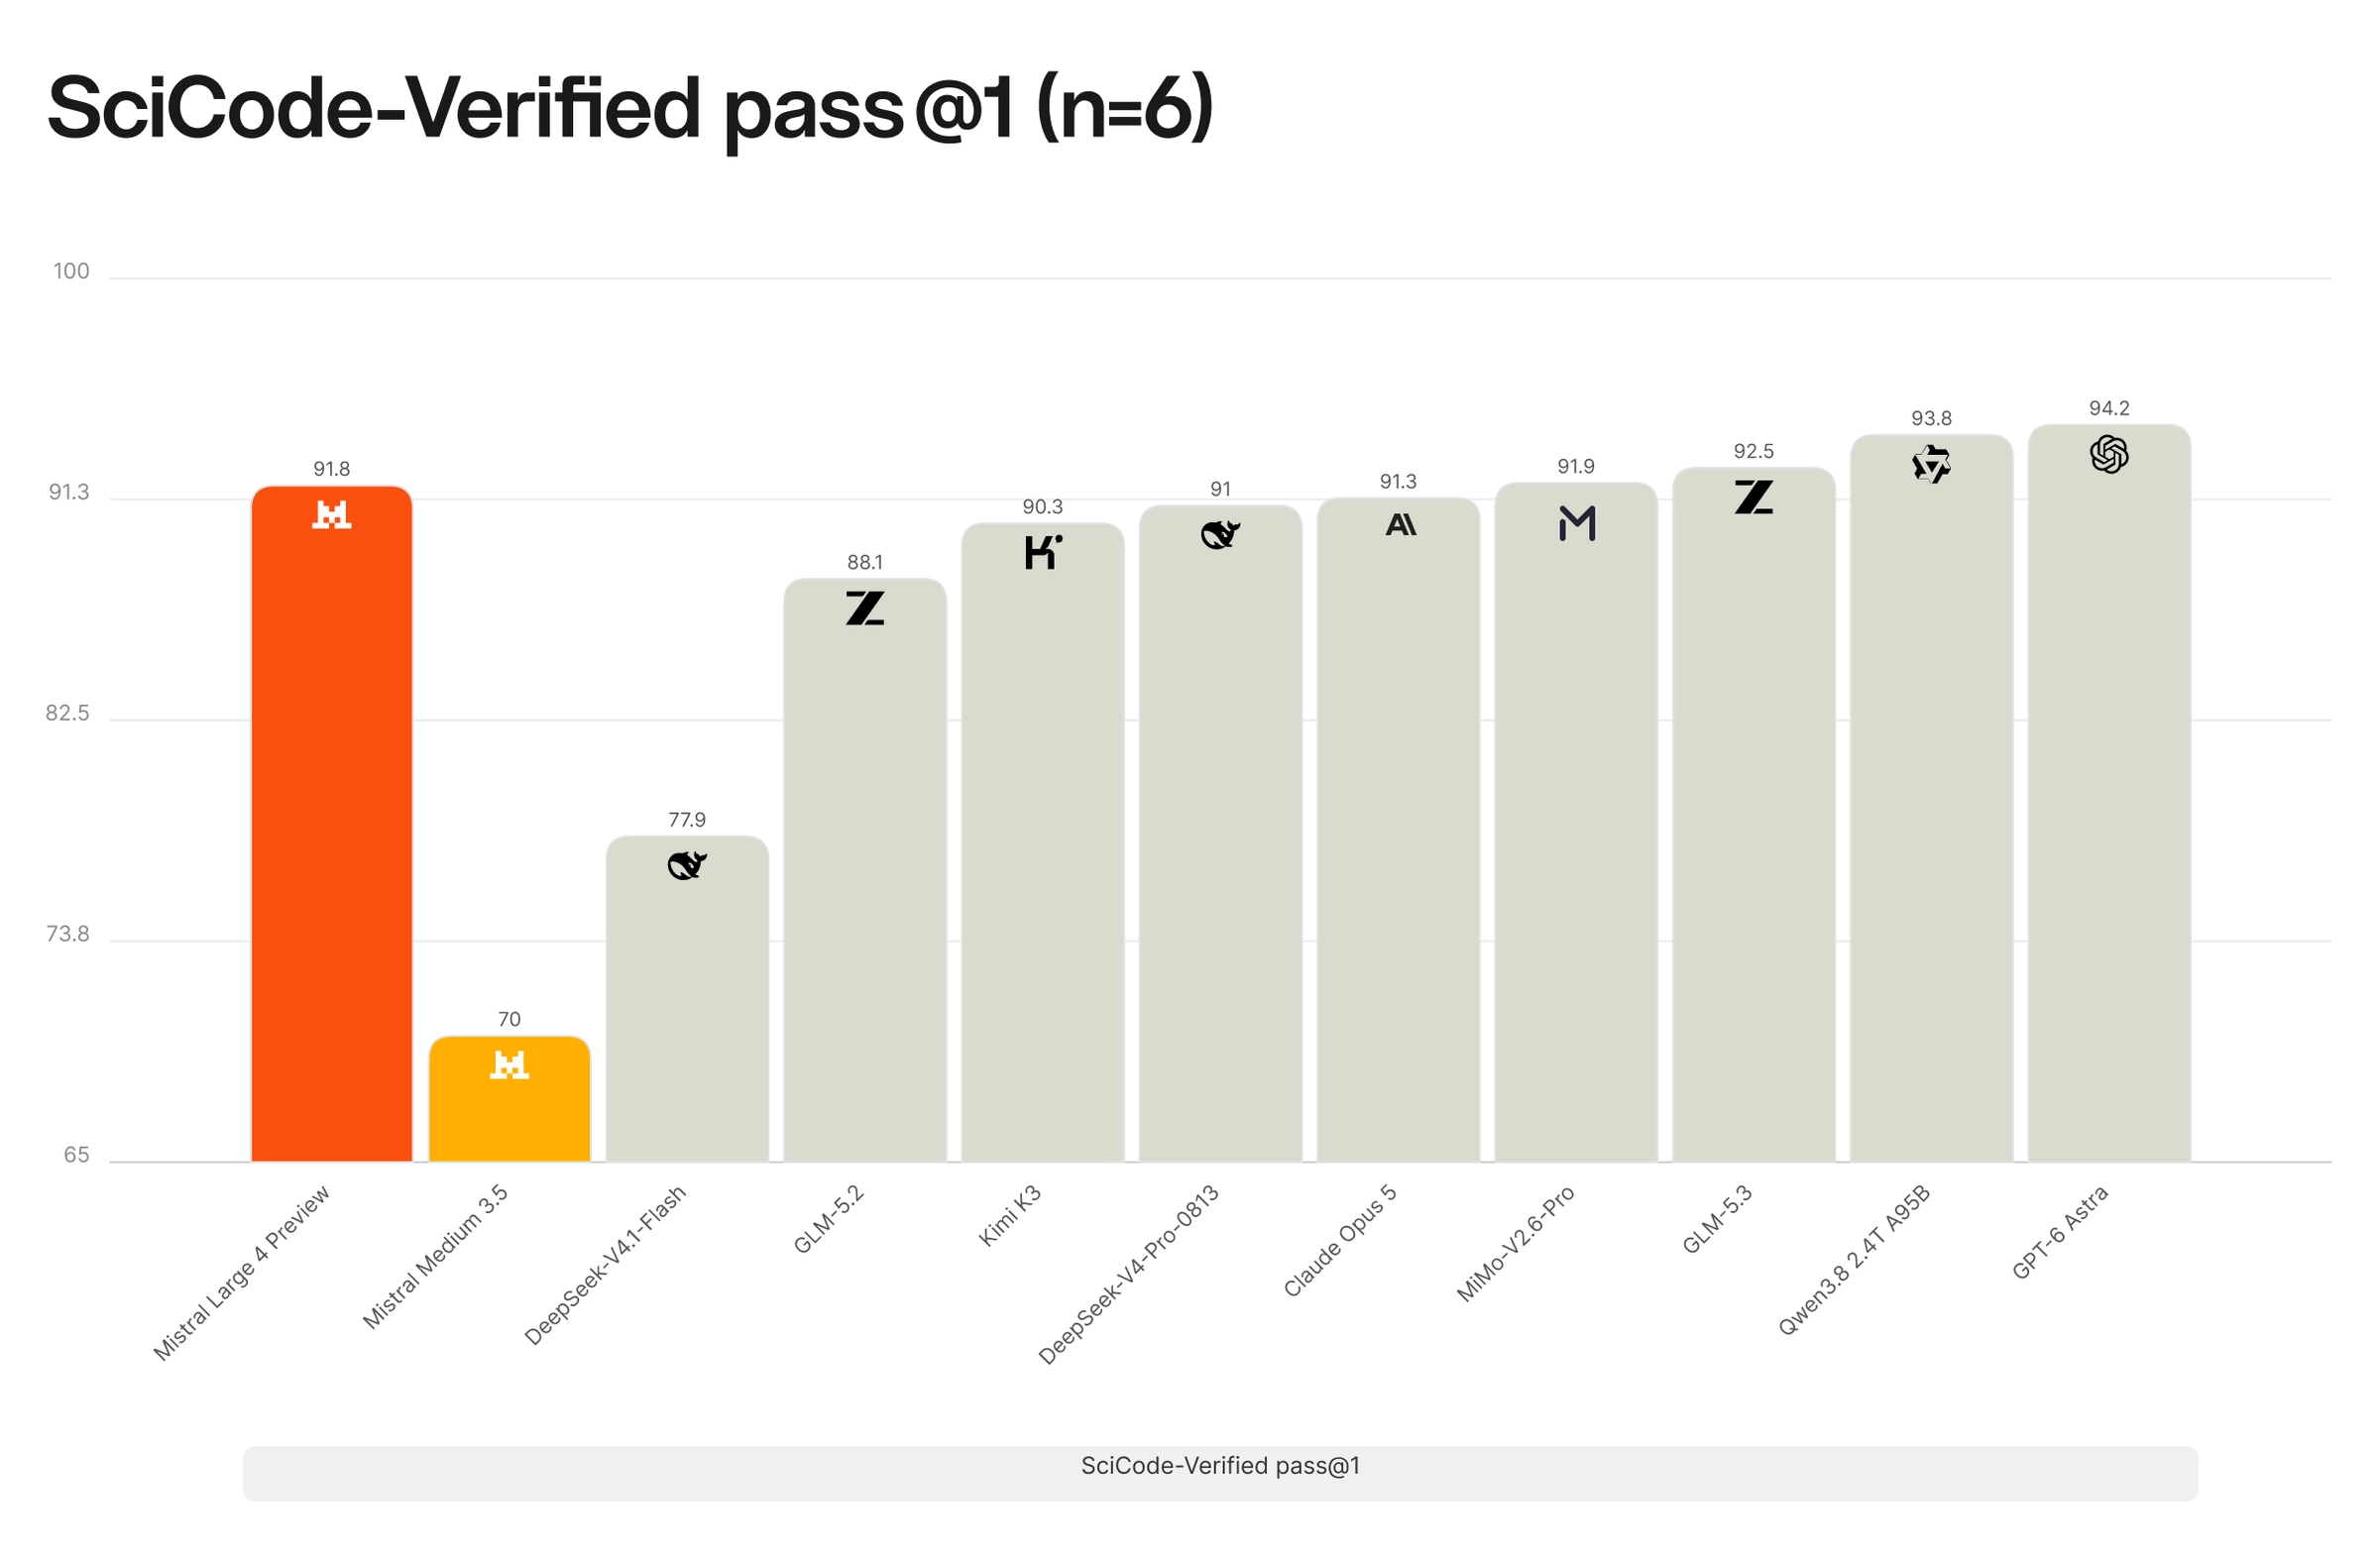
ML4 结合 AI 方法与研究者数理化学专长,具强科学能力。它擅长科学任务智能体编码(数据分析、建模、模拟物理现实),让研究者专注问题。基准上,ML4 在 SciCode-Verified 开源模型中顶尖,实践中能一次生成完整 Hartree–Fock 模拟(复杂多步化学任务)。数学在形式与应用上均更强,人类评测中比 GLM-5.3 推理更精确有结构,能维持长程应用数学(含前沿理论物理)。这些能力使它成为强研究助手。

知识工作
ML4 是最擅日常专业任务的模型,能创建、编辑和修复复杂表格文档,在法律金融基准上表现极佳。第三方 (vals.ai) 评测中,它在法律和金融任务均超 GPT-6-Astra;HarveyAI 法律智能体基准超所有开源。FinWorkBench 测试表格创建编辑。金融分析需精确与多源综合,演示中 ML4 对比其他顶级 OSS 模型挑战多步企业金融,搜索 EDGAR 等公开报备,语义图追踪各模型解题路径与取证文档。
模型安全
ML4 在抗间接提示注入基准饱和,居开源前沿。Lakera 公开 B3 基准抵抗 93.3% 攻击,竞品无更高。它也比前代更负责任,KORA 基准 1.691(满分 2 “Exemplary”)居开源最高。其拒恶意网安请求倾向高:尽管网安基准强,但在 JailbreakBench 等数据集上平均拒绝率高于所有开源模型。
人类评测
专家标注者跨编码、CAD、金融、数学物理对比 GLM-5.3:ML4 在 CAD 和 STEM 更受偏好,金融编码持平或接近。

大规模强化学习
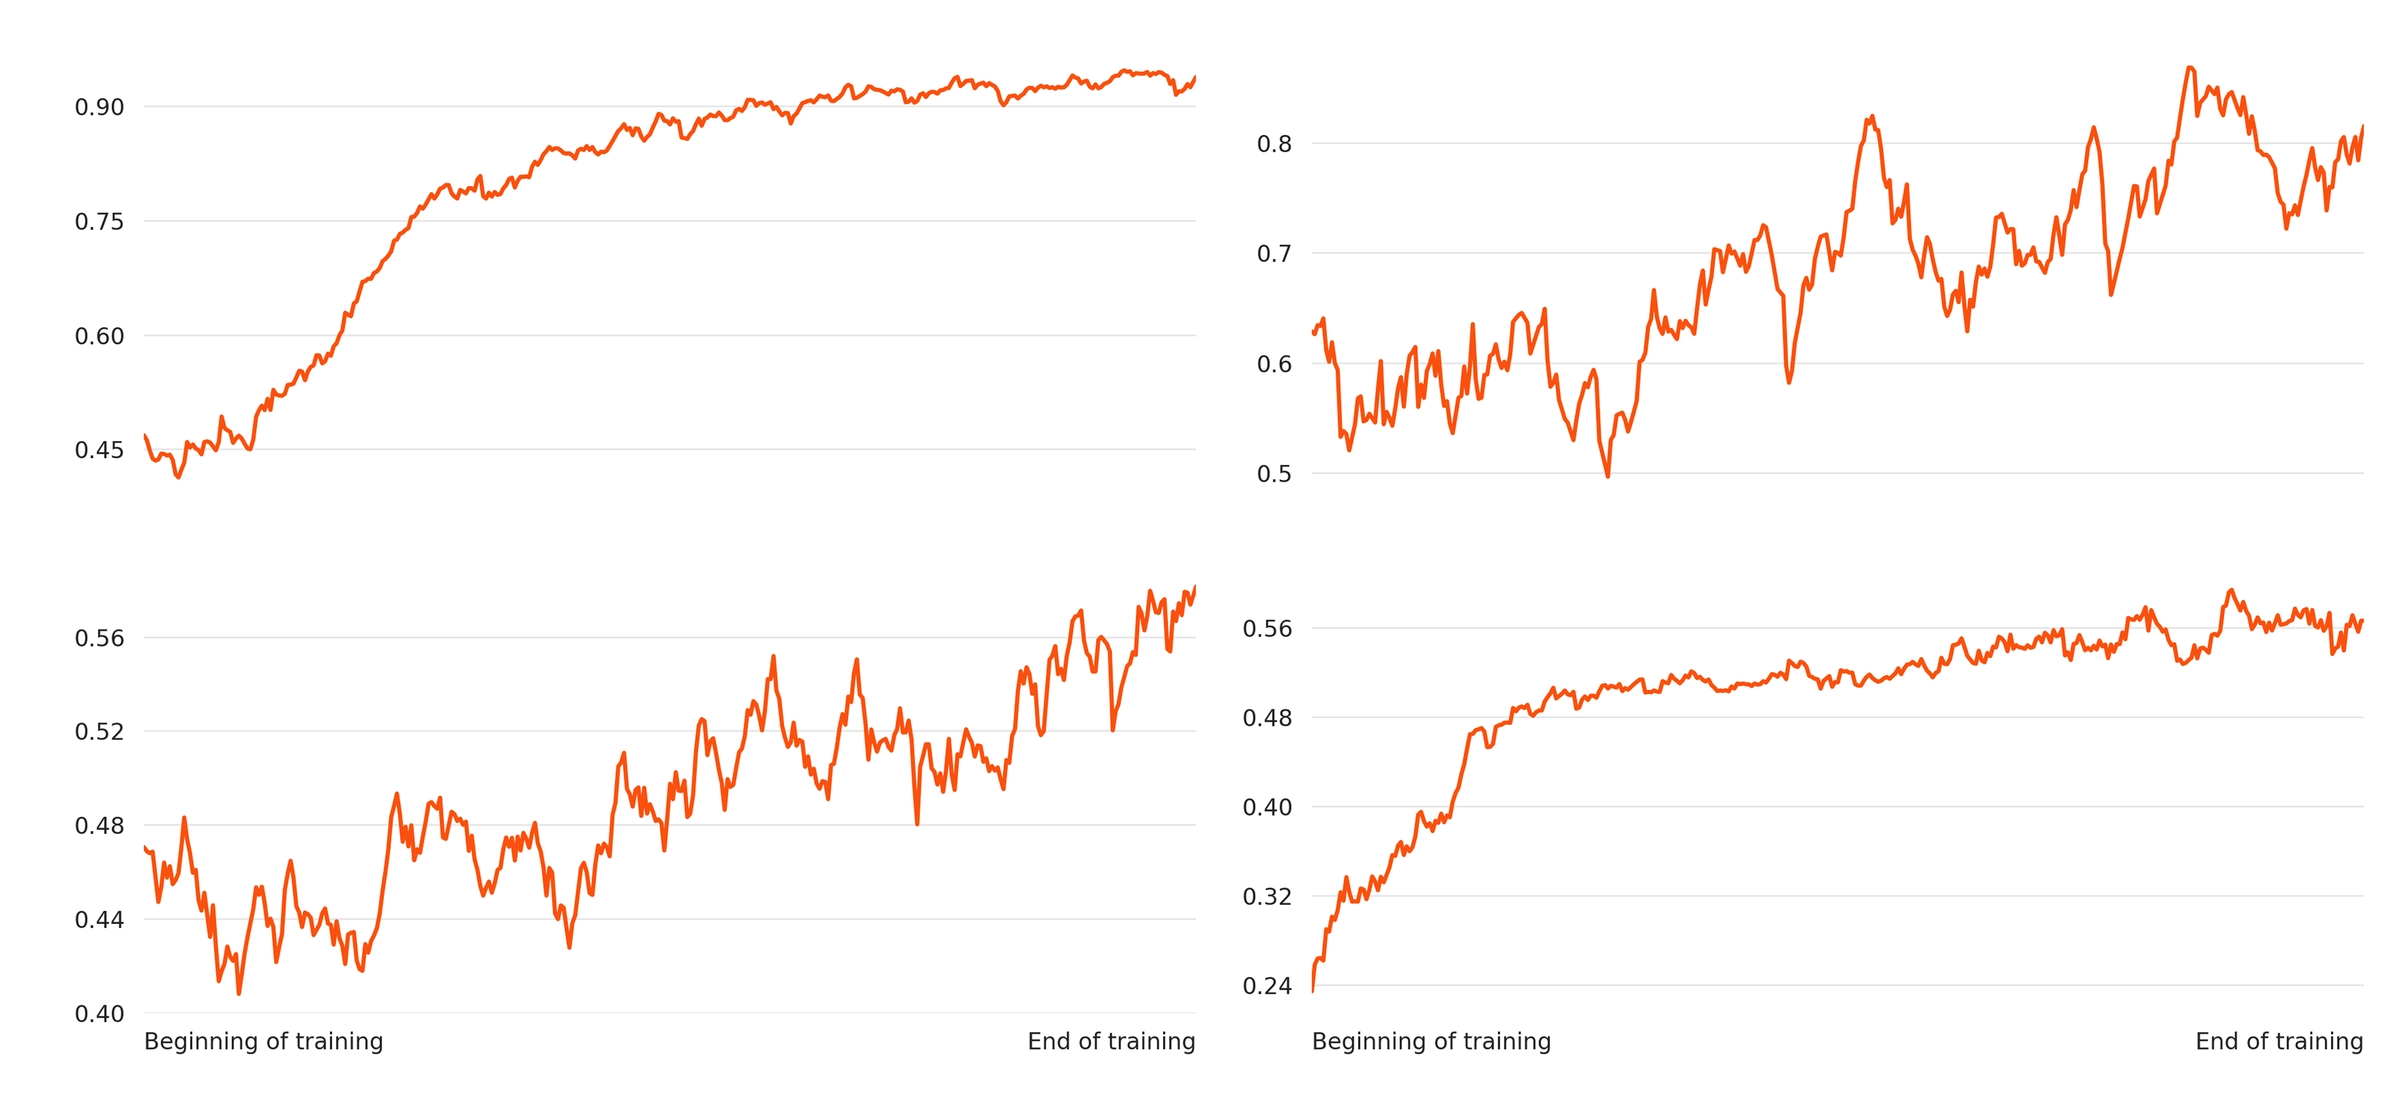
基础模型快进,后训练须跟上,旧配方留能力。我们用 RL 因它随模型适应:训自身尝试结果,提难度广度。RL 库易加环境大规模,共享组合接口单运行组合任务(聊天、科学、安全、事实、长程工具),共享代码沙箱等脚手架;验证组合奖励模型、单测等。运行时自伸缩 actor 并行数万 rollouts 异步训,优化长轨迹支持百万 token 低过期。新方法减离策漂移稳长程。当前 3k GPU 规模下单运行日产约 330 亿 token,约 160 亿可训完成 token。训练奖励在代表环境上升。
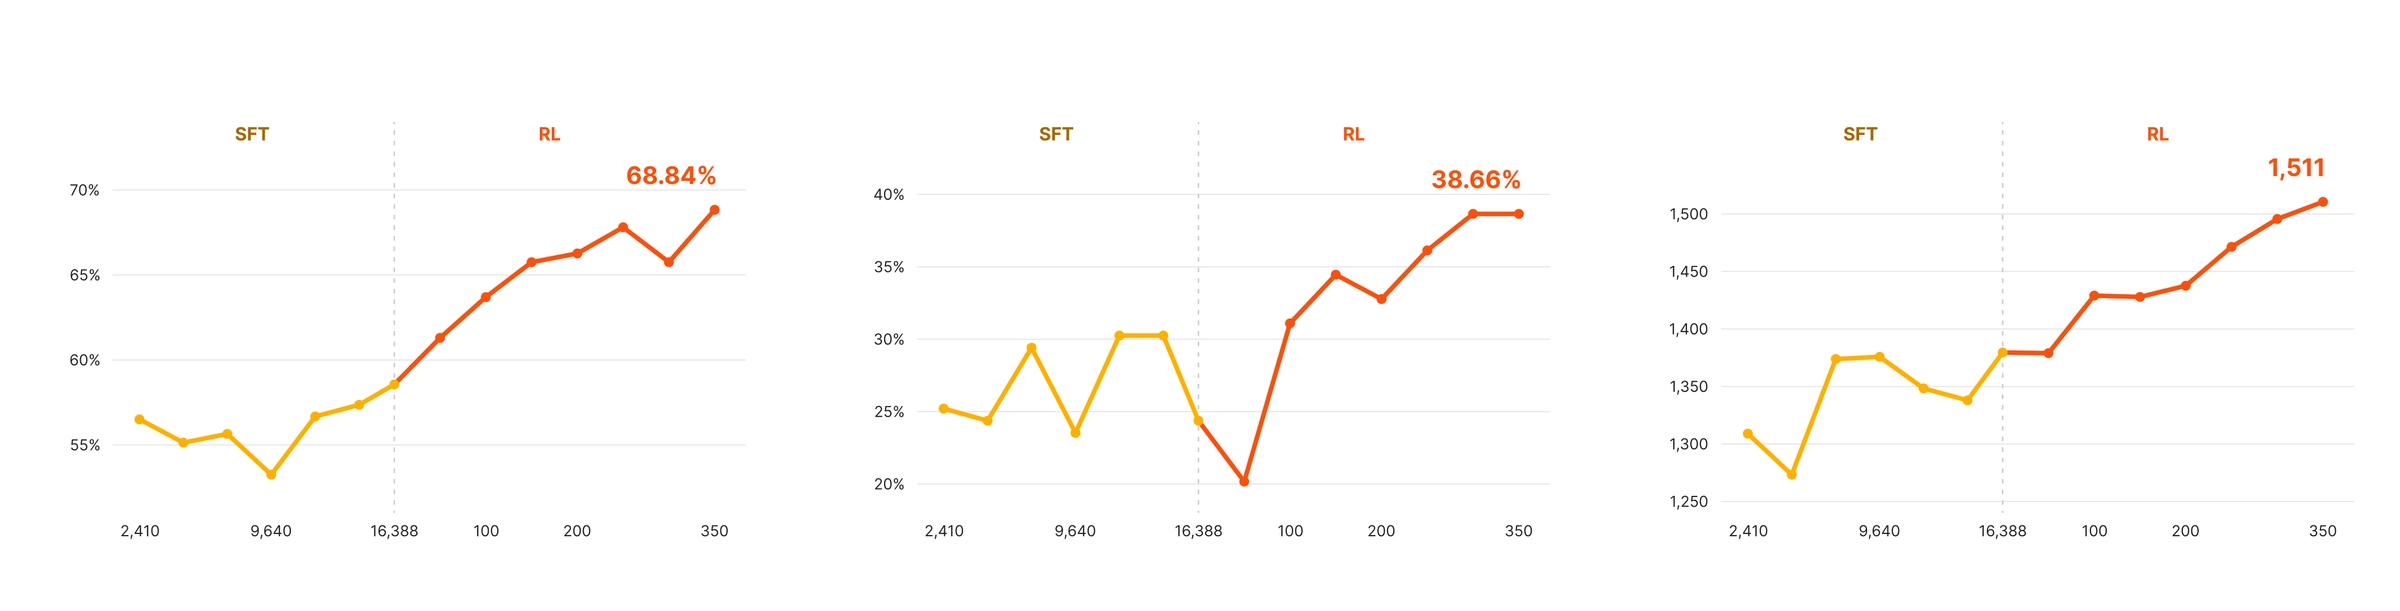
改进不限于训练环境,转移到下游评测,归功于 SFT 和 RL 两阶段。
下一步
这只是开始。ML4 是€30 亿 D 轮(欧洲科技最大股融)路线图首里程碑。资本扩欧数据中心算力。RL 运行进行中未饱和,扩基础设施训练预期数周数月大改进。权重月底发,附架构等细节。ML4 是基础,将衍新一代专用优化模型。进度将很快。
评论
社区对这款欧洲开放权重新模型发布普遍感到兴奋,称赞其命名与性价比,但少数人认为性能仍落后于中国开放模型,并对基准图表排序方式存疑。
赞赏模型命名风格与发布带来的兴奋感
- 认为这种个性化命名和久违的欧洲大模型问世让社区振奋,部分纯玩笑言论也折射出“重回赛道”的情绪(较多人) > 就该这么给模型起名,其他家学着点(@baggachipz)
认可开放权重与高性价比的实用价值
- 认为模型开放权重、出自欧洲,在网络安全等领域可比肩 GLM-5.3,且低成本与基准表现值得日常试用,能节约开支(较多人) > 开放权重、欧洲出品、网络安全可比 GLM-5.3,没什么不喜欢的(@danslo)
对性能仍落后中国开放模型感到失望
- 指出模型虽进步但仍未超越中国开放模型,认为需要非中国开放模型去反向挑战以推动整体发展(少数人) > 有点失望它仍落后于中国开放模型,我们需要同样强的非中国开放模型去挑战他们(@theturtletalks)
对基准图表排序和发布动作存疑
- 有人觉得图表排序观感奇怪,也有人疑问是否为重复发布(少数人) > 这样排图表总让人觉得氛围有点怪(@tosh)
肯定模型多样性与渐进式进步
- 认为无论是否突破性能边界,将 Kimi 等竞品列入图表彰显多样性,对生态有益(少数人) > 模型多样性对人类是好事,尊重他们把 Kimi 放在图上(@vessenes)
有价值的补充
- 据调侃信息,模型参数规模为 1T-A49B,权重暂闭但承诺月底开源(@spwa4)
- 模型命名可能被联想至宝可梦 Lechonk,增添了社区讨论趣味(@chevman)
- 相比 K3 和 DS4,部分用户认为该模型表现更优且日常使用成本更低(@redanddead @rglover)