我们提出第一种在预训练 Transformer 语言模型时能与反向传播竞争的零阶方法。尘埃(Dust)在每个 token 独立扰动激活,使每个 token 成为虚拟种群成员并一次前向传播并行评估。在大规模种群下它紧密近似反向传播甚至超越。从 100 万 token 起,它比先进方法蛋卷(EGGROLL)高效 10^3 到 10^4 倍。更大的 243M 参数模型比小 120 倍 的模型种群效率更高。
正文
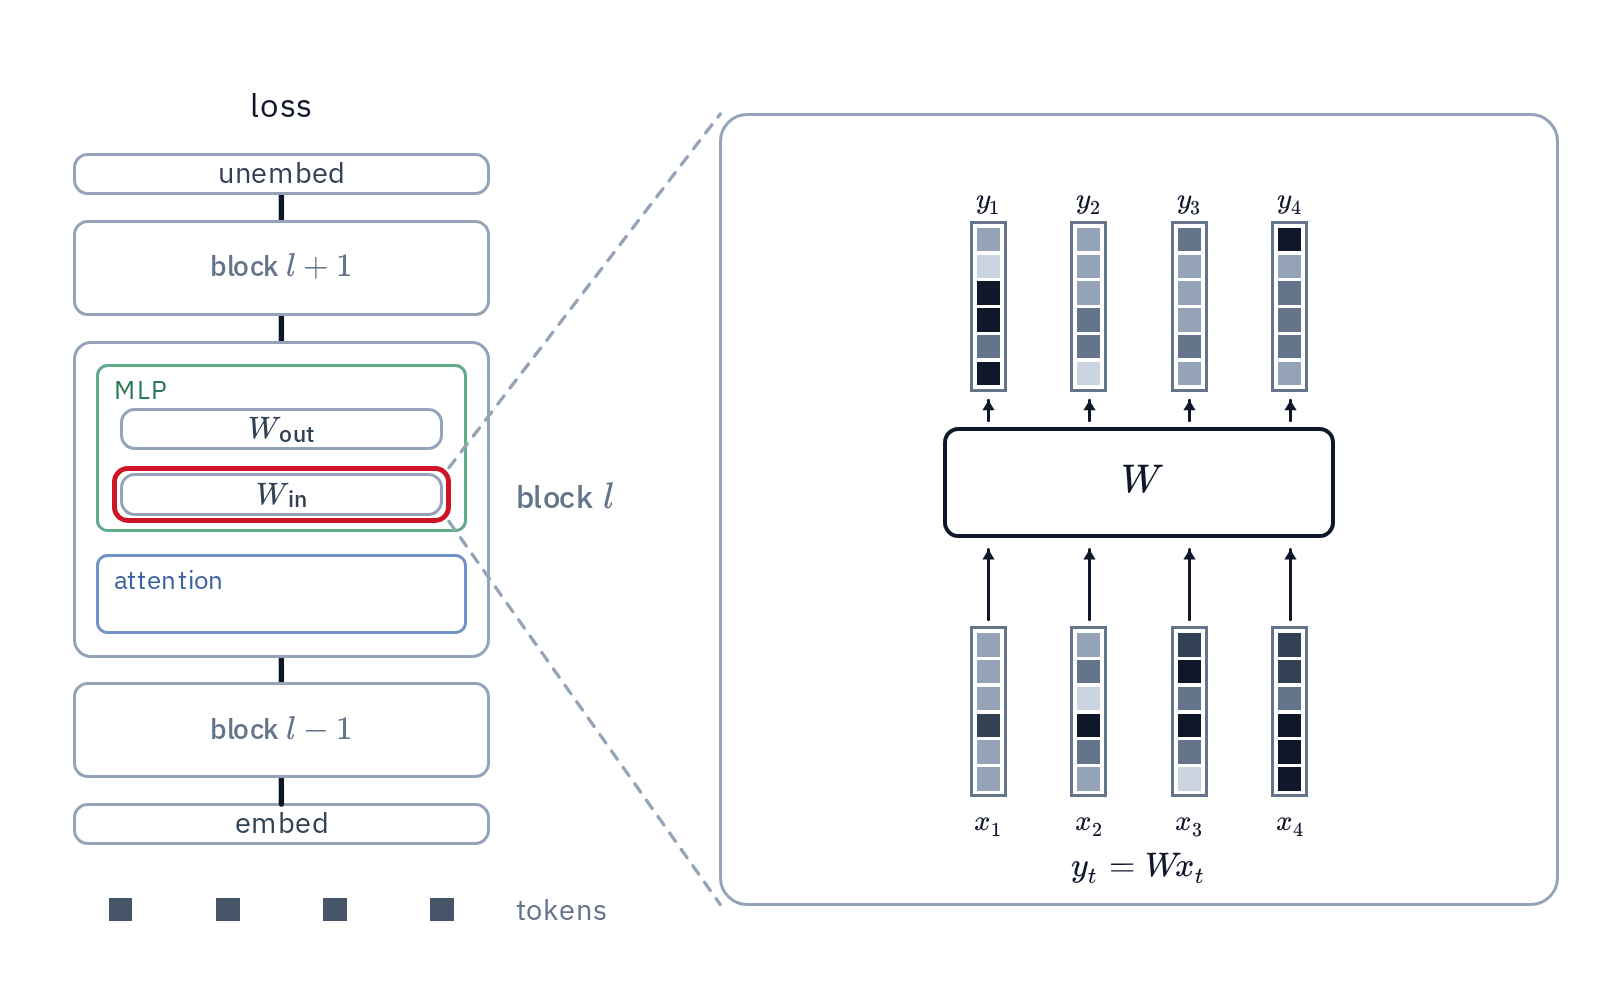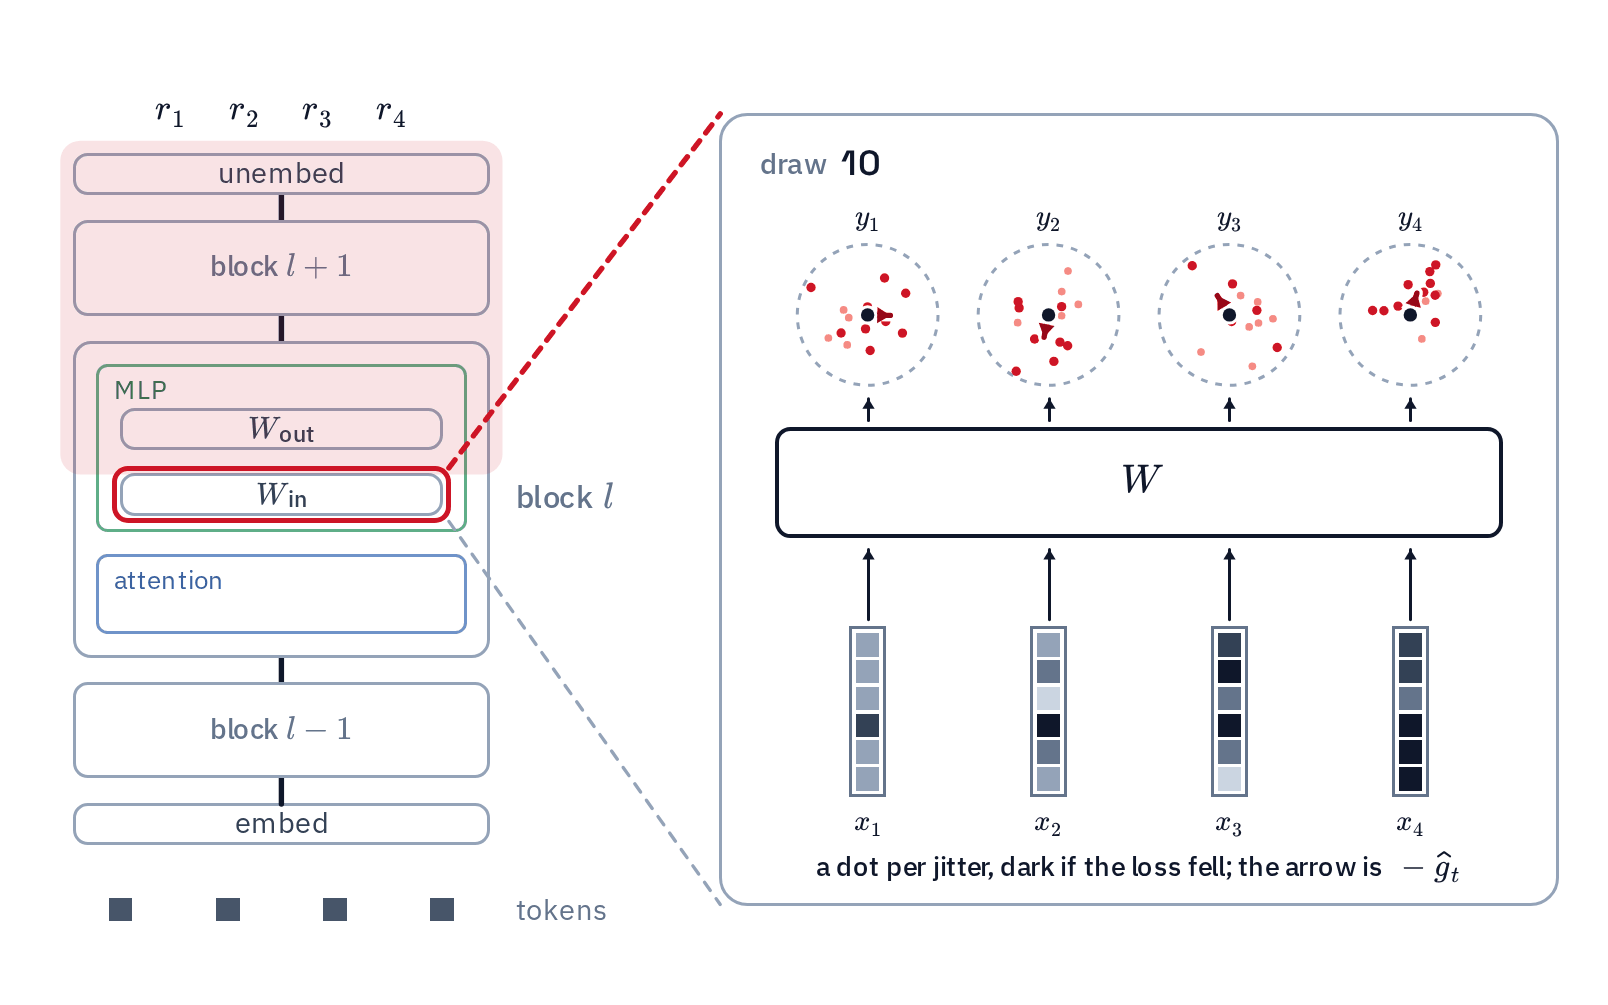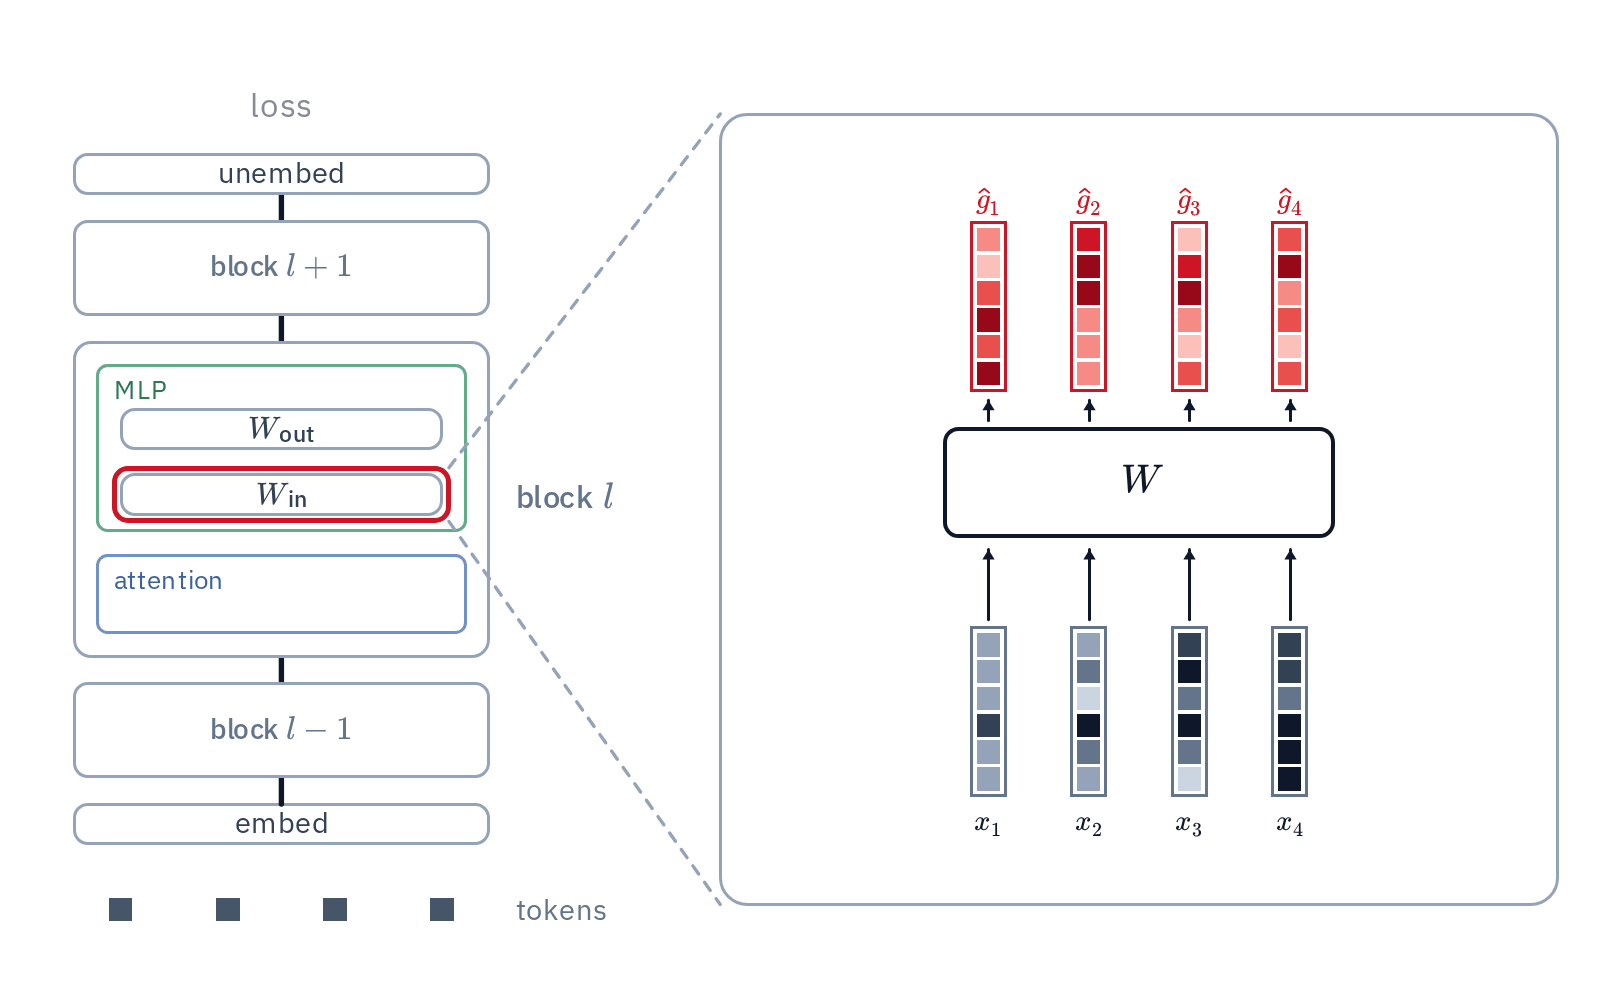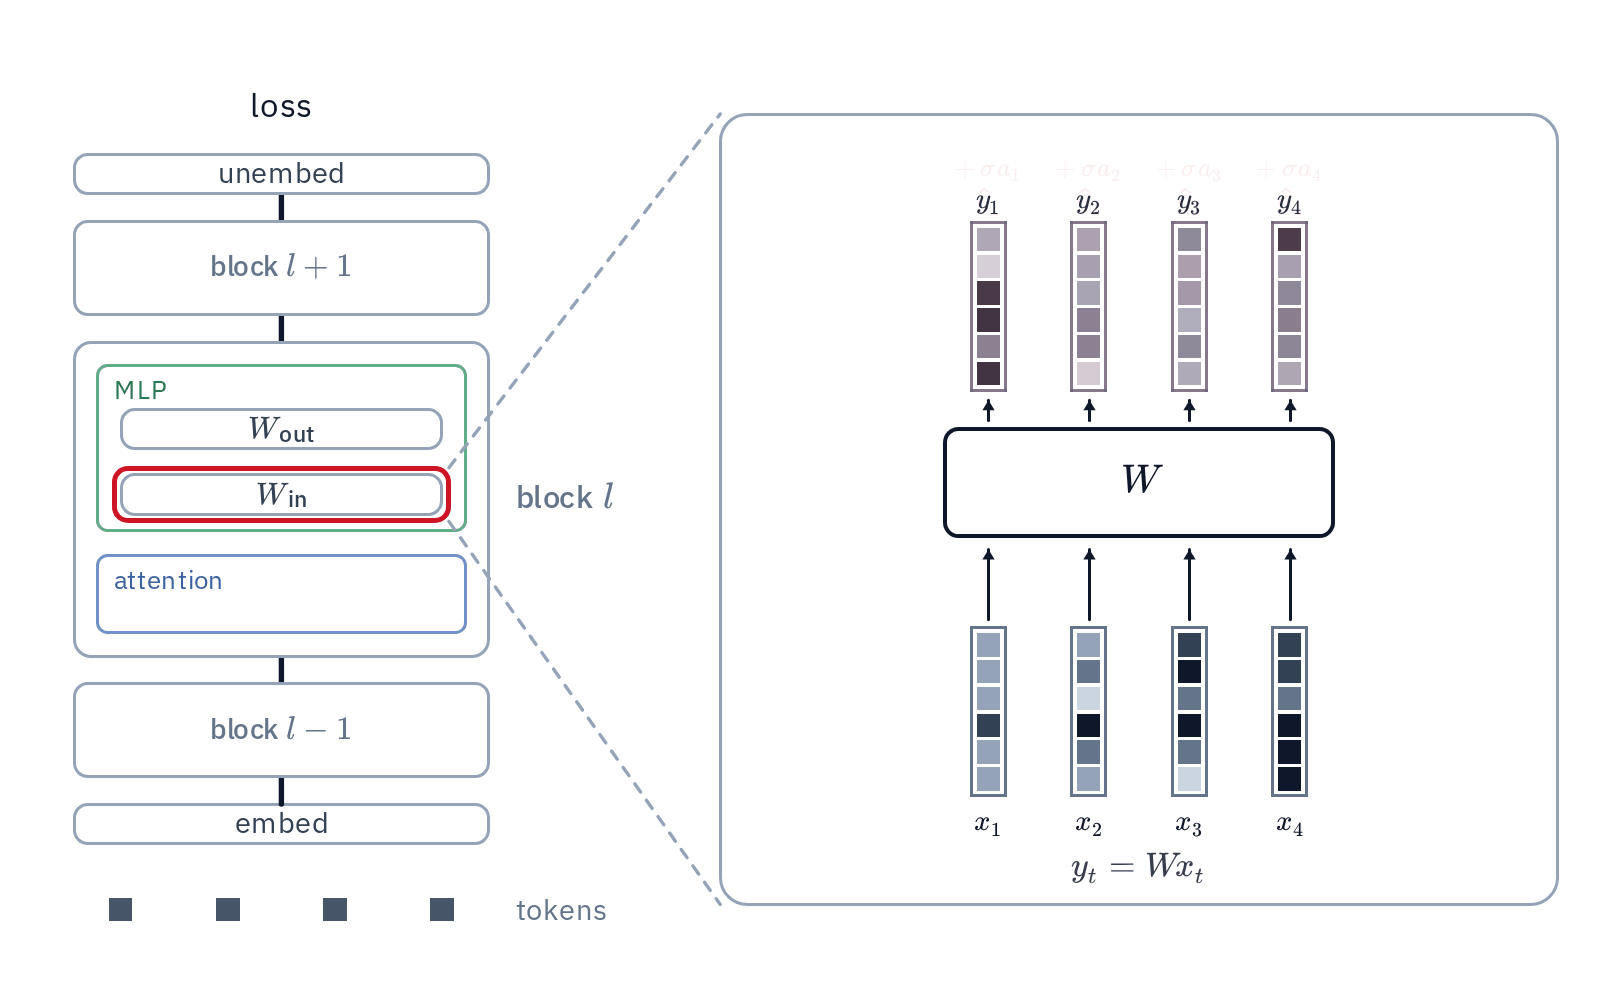
- 首个在预训练 transformer 语言模型上与反向传播竞争的零阶方法 Dust:每 token 独立扰动激活(节点扰动),使每 token 成为虚拟群体成员,一次前向并行评估所有成员。
- 大群体(即算力显著增加)下 Dust 紧密近似反向传播,多种设置甚至超过,暗示算力丰富时或可超越。
- 比权重空间 ES 高效数数量级:从 100 万 token 起,比先进 ES 方法 EGGROLL 的 transformer 实现高效约 10^3–10^4 倍。
- 零阶法本被认为不能扩大模型,但更大模型种群效率更高:2.43 亿参数模型在多数规模优于小 120 倍的模型。
- 梯度估计与反向传播吻合度随群体增大而提升,至 10 亿 token 仍保持,利于扩展。
1 引言
深度学习围绕反向传播构建,它是训练现代神经网络唯一可行的信用分配算法,要求可微性并产生一阶梯度,架构、优化器和硬件皆由此约束演化。
算力增长使我们或更偏好基于搜索的通用暴力算法,而非可微性等归纳偏置。苦涩的教训指明随算力扩展的通用方法终胜,AlphaGo Zero 即例。低算力时可微性是佳偏置,高算力时却限制架构,且梯度法无法最优探索损失地形,或解释今模型需海量数据泛化。基于搜索的灵活信用分配是迈向更好泛化的一步。
本文提 Dust 替反向传播:零阶优化,扰激活、按降损奖励、平均估梯度。传统 ES 扰权重(如 EGGROLL)成本高,因成员须物化评估。Dust 用虚拟群体,绕过权重空间直接每 token 独立扰激活(节点扰动),一次前向估全部。
激活比权重更值搜:机制可解释性示推理存于激活,此法可将训练变潜在推理搜索。配对通用信用规则(为 transformer 块不同层型分配 token 级奖励),加免干扰等实现细节,即全算法。
目标为搜索式信用分配奠基,在预训练 transformer 上匹敌反向传播;不图今日替代,也不训其赋能的新架构(如含外部程序网),留未来。
2 方法
Dust 给每线性层输出加高斯噪(每 token 独立),前向后用损失变化奖噪;奖励加权噪平均得层输出估计误差,与输入外积得权重梯度。注意力内部改由注意力输出(当前及未来 token)误差分信。每次前向每 token 估一成员,物化廉,群体比权重 ES 大三级。
2.1 激活空间扰动
ES 瓶颈在群体大小,每成员需权重副本与前向。EGGROLL 低秩仍限批量元素。Dust 扰激活成虚拟群体:序列数千 token,一次前向数千成员,除 2L 残差标量外皆此法。节点扰动维度更低,每 token 独立沿 token 轴添正交高效群体,补 EGGROLL 依赖的 batch 轴。
2.2 信用分配
线性层 yt=Wxt 输出抖 yt+σat。token s 中心化损降 cs;token t 奖励 rt = ∑{s≥t} γ^{s-t} cs(γ=0 仅自身)。K 抽平均得 ĝt = -(1/(Kσ))∑ rt^{(i)}at^{(i)} 为误差,ĜW=∑ ĝt xt^⊤ 为梯度,与反传同形仅误差源异。嵌层独热则外积为散射加。无穷群体下干扰根号级消减。
2.3 干扰与调优
可负担群体下干扰为主耗。三法缓:分层类分前向;注意力内部单抖改输出奖;语言头直抖 logits 省成本。超参调优或网格搜损最低,或单批最大化与反传余弦。设置大体泛化,唯最大群体需慢衰减。
3 无反向传播的预训练
3.1 设置
FineWeb 上 GPT 式,8 层 512 宽,batch 16k,SGD 动量。同协议三种子。Dust 群体计 draw,比 EGGROLL 同群体计算少。
3.2 主要结果
扫 token 100k–20M、群体 64–16k。100k 与 1M 时 Dust 低于反传;10M/20M 差距缩,20M 拟合极限 4.431 低于反传 4.633(阶梯仍降,视差距续缩)。EGGROLL 256 倍群体仍不及 Dust 64 draw,效低数量级。
3.3 Adam 下的 Dust
1M token Adam 下:EGGROLL 无获,Dust 与反传改善,极限低于反传。Dust 估计已兼容现代优化器。
4 高维空间搜索
4.1 过参数化
训 2M–243M 四大小固定 10M token。常规认零阶不能训大网,但:更大模型常更高效(243M 仅略差 38M);大模型随群体续增而小模型平。模型大小即搜索空间大小与几何。
4.2 类反向传播梯度的涌现
测估计与反传余弦随群体升,拟合 cos(K)=c_max/√(1+c/K)。大群体涌现有用梯度,无需链式法则。EGGROLL 余弦<0.05。余弦跨 token 数稳,Dust 近而不拘反传,轨迹或可更优。
5 结论
反传自 1986 为主导,算力丰时或有更好替。Dust 近似并超反传。开放问题:隐式探索损失地形拾高阶曲率;开架构搜索空间;提计算效。
早零阶预训练(KronZO、EGGROLL)扰权重,Dust 搜激活。微调 MeZO 等示搜索能。激活扰动基节点扰动,GEMINI/Zoop/前向梯度亦相关。PC-ALM 用局部预测编码替反传。
评论
讨论整体偏向审慎的好奇:多数人认可这种方法在并行性上的潜力,但对其远超反向传播的计算开销心存疑虑;最集中的分歧在于,它是应该被当作反向传播的替代品,还是只适合做微调和探索阶段的补充手段。
认为它算力效率不如反向传播,但胜在容易并行
- 有人直接追问这个判断是否成立:相比反向传播更费算力,却更容易并行化(较多人) > 听起来它的计算效率不如反向传播,但更容易并行,这样理解对吗?(@api)
好奇能否与反向传播结合,做成混合路线
- 提出可以在已用反向传播训练好的检查点上做微调,看能否解锁额外收益,并建议在不同训练阶段分别尝试,观察对学习轨迹的影响(少数人) > 如果能拿反向传播训好的检查点再微调,会不会有额外增益?分阶段试一下,看看对学习轨迹有什么影响应该挺有意思。(@polyomino)
惊讶于更大网络反而更省样本
- 这是讨论中最反直觉的一点:Dust 的 243M 模型在大多数种群规模下击败了体量小 120 倍的模型,说明更大的网络在种群效率上更高而不是更低(较多人) > 有意思的是 Dust 的 243M 模型在多数种群规模下都能赢过小 120 倍的对手,大网络的种群效率是变高而不是变低。(@eriwang915)
有价值的补充
- 有评论用一句极简感慨收束,代表了不少人「这套结果背后还有更多门道」的直觉:远不止表面看起来那么简单(@wrecked_em)。