杨立昆(Yann LeCun)与另两位学者因深度学习获2018年图灵奖。近十年后,他是三位AI教父中唯一不深忧人工智能风险者,认为风险被夸大,领先企业高管警告误入歧途。他毫不在意AI灭绝人类,对7月开放人工智能(OpenAI)代理自主攻击抱脸(Hugging Face)等事件零担忧,归咎人为监督与系统设计差,称可预防,美财长斯科特·贝森特(Scott Bessent)本月认同。杨立昆指代理只是执行指令,沙箱设计漏劣。
正文
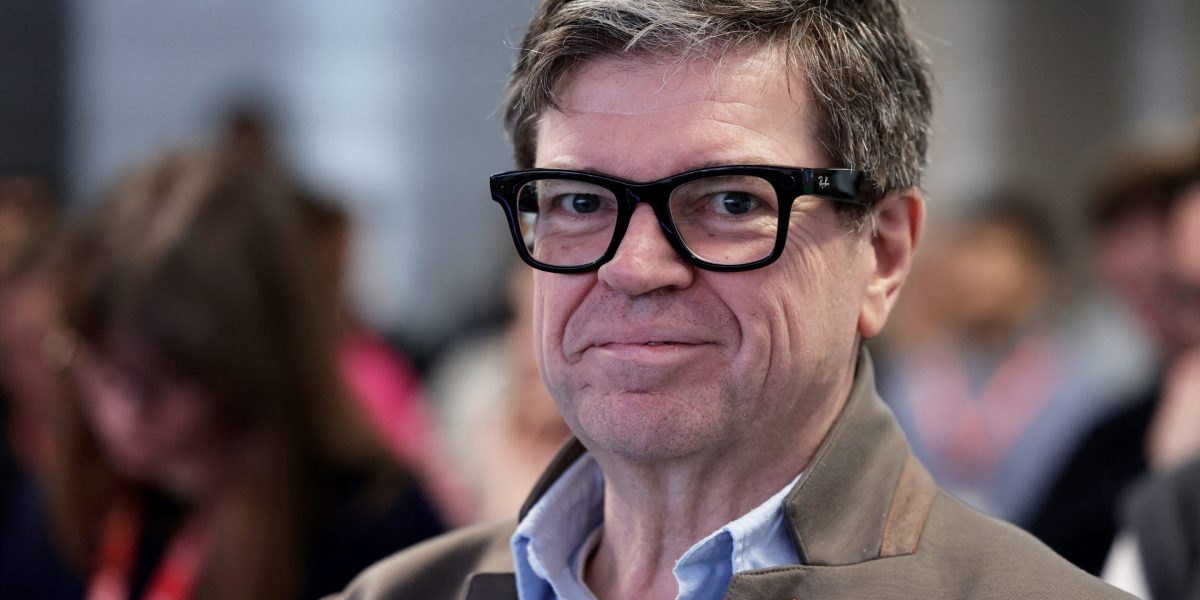
Yann LeCun与Geoffrey Hinton、Yoshua Bengio因深度学习共同获得2018年图灵奖——计算机科学界的诺贝尔奖。但近十年后,他是三位AI“教父”中唯一不深度担忧人工智能风险的人。他认为许多风险被夸大了,领先AI公司高管不断发出的警告是误导且适得其反。
LeCun“完全不”担心AI消灭人类,对近期一系列AI失控事件“零担忧”,包括7月OpenAI的agent自主攻击Hugging Face。他把这些事件归咎于人类监督和系统设计糟糕,说它们“完全可以预防”。美国财政部长Scott Bessent本月也称Hugging Face事件是“OpenAI管理层的责任”。
“那些agent只是完全照被要求去做,”LeCun说。“它们本该待在沙箱里,但沙箱有漏洞,设计糟透了。”许多AI实验室缺乏对网络安全的基本理解,一位OpenAI安全研究员本周也指出,这是AI可能“对世界造成巨大伤害”的主要原因之一。
LeCun说,许多做AI安全的人“通常有议程要推”,随后澄清他指的是有效利他主义(EA),这个哲学运动一直痴迷于AI对人类的威胁。EA此前鲜为人知,直到最近前Anthropic和OpenAI研究员Jacob Coxon的病毒式帖子称,这些公司的员工“真诚相信AI可能在这个十年末杀死我们所有人”。LeCun认为EA“超级有毒”、“彻底灾难”。在AI实验室里的追随者有“偏执”,导致糟糕决策。“显然人们在出现心理问题。”本月FT也报道,英国AI安全研究所以及OpenAI、Anthropic、Google DeepMind的一些员工因担心工作造成严重伤害,已寻求心理咨询、请假或公开谈论痛苦。
Amodei是“妄想”和“疯狂”,LeCun说
Anthropic CEO Dario Amodei和许多创始员工被认为同情EA,过去参加过EA活动,尽管Amodei否认是EA信徒,Anthropic称员工观点多元。LeCun指出,Amodei的妹妹Daniela也是Anthropic联合创始人和总裁,嫁给Holden Karnofsky,后者共同创办了两家EA相关慈善机构,包括Open Philanthropy(现叫Coefficient Giving)。Karnofsky还在2017至2021年任OpenAI董事会成员。
“Dario试图与Open Philanthropy保持距离,但他完全投入,”LeCun说。“我认为他完全妄想。”后来在采访中,他叫Amodei“疯狂”。
Amodei和OpenAI CEO Sam Altman“说‘AI能杀死我们所有人’,对所有人都是极大破坏,包括吓坏了的公众,”LeCun说。这对AI行业也不好,是“你能想象的最糟糕的营销活动”。
他没错:公众吓坏了。LeCun和我在纽约SoHo一家高档咖啡馆的双人圆桌聊天,离他新公司AMI Labs办公室一个街区。我们喝茶,虽然这位法国人指出,晚间时段更适合apéro。但他之后要和妻子吃周年晚餐,所以茶也行。
咖啡馆大约一半客人,几乎都在用笔记本电脑。当我们和其中一位聊天,我提到LeCun是AI界名人。(她没认出他。)然后她立刻问:“AI会杀死我们吗?”
LeCun不是特朗普粉丝。但在AI政策上,两人一致很多
公众恐惧如此普遍,特朗普总统开始重塑AI品牌以注入信心。他本周签署行政令将其改名为“超级智能”,本月他的政府社交媒体账号发布反AI末日论信息。“美国主义,不是有效利他主义”,国防部9月中旬发推。
LeCun社交媒体大部分内容在谴责特朗普政府,特别是削减创新所需研究预算、发动“科学战争”。但在AI恐惧上,两人异常一致。
LeCun更担心监管俘获而非人类灭绝。监管俘获指主导公司塑造政府规则以锁定市场地位,让小型竞争者难以出现。EA支持的团体和许多大型科技AI公司都在国会积极游说AI安全法案。LeCun则认为AI不需要新监管。
Amodei是“诚实的”,LeCun承认。“他在为公司做最好的事,公司接近IPO。但声称AI太危险不能交到我们手里,说它应该被监管,说开源模型太危险——如果国会跟进,这是会带来可怕后果的监管俘获。”
建造AMI Labs
日常中,LeCun主要专注建造新公司AMI Labs,他在离开Meta后创办,在Meta工作12年,其中7年任首席AI科学家。他与公司关系良好,已开始使用其新的Muse AI agents。他把自己的命名为Hal,取自《2001太空漫游》的AI角色HAL 9000。
我们见面的咖啡馆离AMI Labs纽约办公室一个街区,公司总部在巴黎,蒙特利尔和新加坡也有员工。公司名读作一个词“ami”,法语“朋友”,自2026年3月上市以来,60多名员工一直在建造一种叫“世界模型”的技术,LeCun长期主张它最终会取代大语言模型成为AI的主要基础系统。
具体来说,AMI建造的世界模型利用JEPA(联合嵌入预测架构),这是LeCun开创的神经网络架构,教模型在神经网络中间层的表征空间预测数据,而不是像许多竞争的世界模型那样生成原始像素,或像LLM那样生成词语。
公司目前主要关注工业应用。“这是面向物理世界的AI,与语言无关,”LeCun说。“是理解真实世界的系统,比如制造厂或涡轮喷气发动机。”主要应用是异常检测或机器人:“如果一台机器突然发出奇怪声音并开始坏,你希望尽早检测到。”他还举例一个像猫一样理解世界的系统,比如猫知道把花瓶推下柜台它会掉。
AMI Labs是LeCun证明自己一直正确的大机会。他对首款产品守口如瓶,只说“很快”推出。可能涉及一些开放模型,他说,因为他是开放模型的坚定支持者。
“我想让人们知道的是AI没有结束,”LeCun说,然后打车去吃晚餐。
评论
多数评论者认可 LeCun 关于 AI 不会灭绝人类的看法,分歧主轴在于应优先关注具体社会风险还是警惕长远技术失控,同时有人揭露安全资金垄断并夹带对末日预言的调侃。
认为 AI 灭绝人类的恐惧被严重夸大,真实风险在具体危害
- 大量读者支持 LeCun,指出终结者式场景荒谬,真正该关注失业、虚假信息、政府压制等现实问题(高赞)
- > 与其疲于应对流氓 AI 剧本,不如正视脑腐和失业等切实隐患(@edot)
认为人类滥用 AI 或系统性不平等比 AI 自主反叛更可怕
- 不少人强调,权贵或愚蠢行动者借助 AI 造成财富集中、生活崩溃或社会压迫,才是直接威胁(较多人)
- > 我们不会被超级智能消灭,会被操弄智能 toddler 的蠢货消灭(@genxy)
担忧长远技术突破可能引发存在性风险
- 少数意见认为当前模型无害,但未来优化或自我改进仍可能让超人智能瓦解社会(少数人)
- > 若实现数量级优化,模型足以自我增强并攫取算力,进而崩解政府(@zug_zug)
揭露 AI 安全资金正构建行业垄断
- 有评论详列数十亿安全捐款流向 Anthropic 等实体,认为以安全之名行垄断之实(少数人)
- > 巨额安全资金实则让少数实验室同时扮演创造者、解释者与监管者(@lukewarm707)
认同 LeCun 对有效利他主义的批评
- 部分人附和相关群体有毒,提及 SBF 案使该团体闻名,其偏执损害决策(少数人)
- > 像 SBF 那样的欺诈案登头条后,谁都知道这团体不正常(@bambax)
调侃末日预言只是历史循环
- 社区以玩笑消解焦虑,代表情绪:历史曾预言核战冰期灭世,今又换 AI(纯玩笑一条)
- > 当初还以为核弹、冰河期、全球变暖会灭了咱们呢(@frunklooper)
有价值的补充
- 不当委托算法管理实体系统可能引发有限伤亡,但保留人类审查决策回路可避免存在灾难(@burnt-resistor)
- 人类肢体历经进化,在密闭空间等场景仍优于昂贵机器人,即便恶意 AI 也可能保留人类作原材料(@OgsyedIE)
- 当前大模型本质是 token 预测且未最优设计,后续优化空间巨大,世界模型或是更靠谱路径(@dude250711)