2026年9月,Wagtail CMS团队尝试整月只用 GLM 5.3 Flash 编码,当月 token 用量超过 20 亿。前半个月目标达成,该模型花费 68 美元,约合 4kWh 能耗和 365 克碳排放。后半个月不太顺利,有 10 亿 token 流向了其他模型。意外障碍之一是 vibe coding 的成本:实验性的 Wagtail MCP 服务器本是 vibe-coded 原型,选错模型后几乎一夜之间就花掉 4.5 亿 token、150 美元和 5kWh 能耗。
正文
用 GLM 5.3 Flash 写了一个月代码
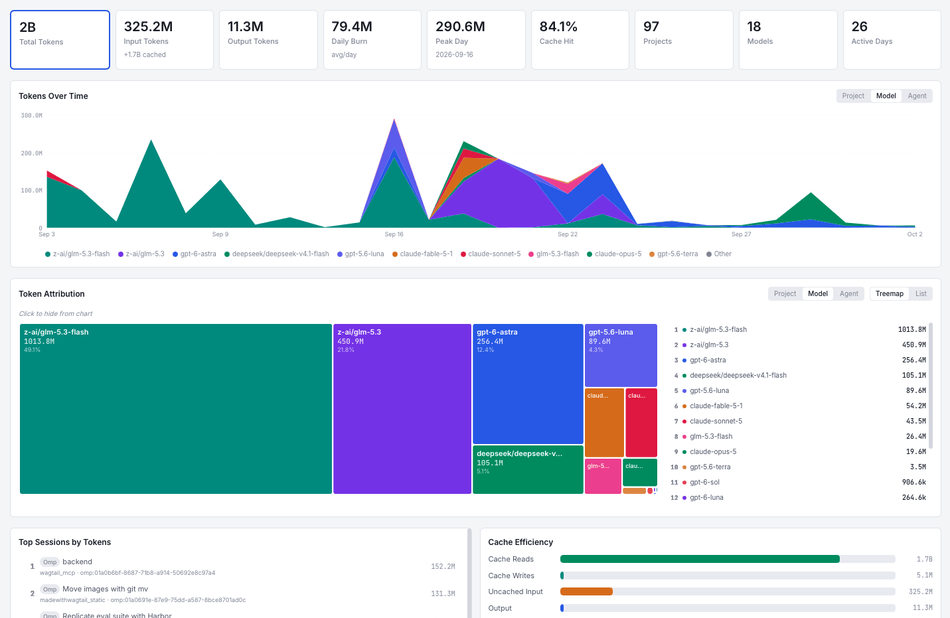
再具体看模型分布:
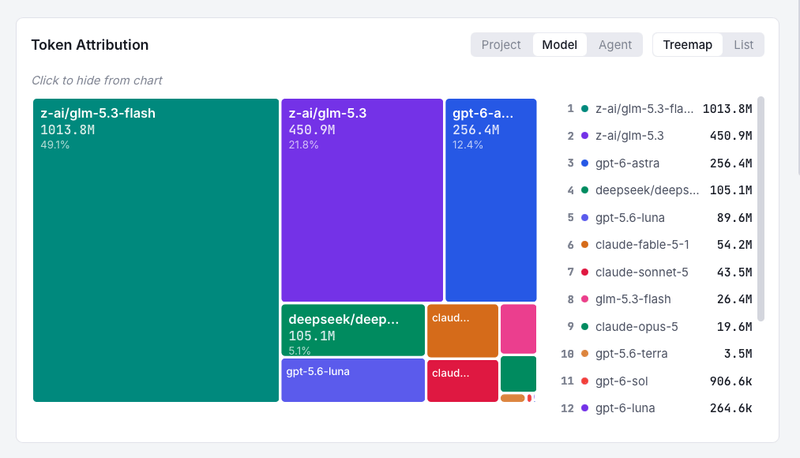
目标是整月都用图中青色的 GLM 5.3 Flash。顺利的部分是:上半月确实只用了这个模型,用量也稳稳落在预算内(68 美元,约 4kWh 能耗,365 克碳排放)。下半月就不太行了,有 1B tokens 流向了其他模型。
意外的障碍
氛围编程的代价
我们一直很坦白,实验性的 Wagtail MCP server 就是个氛围编程出来的原型。氛围编程不是我们通常追求的方式,但对原型来说正合适。可惜它仍有代价:我为这个原型选了「错误」的模型,几乎一夜之间花掉 450M tokens / 150 美元 / 5kWh 能耗。MCP server 本身运行良好,我们现在有了很好的能力演示,所以不算白花。
但这提醒我们要谨慎选择模型、谨慎使用 agent 式的工作模式。同样的结果很可能用五分之一的成本就能达到,多花的力气并不多。教训记下了:得为这类开销做预算,也要更小心。这本可以预见,现在算是知道了。
基础设施的麻烦
另一个意外是基础设施可用性。我们写过很多关于推理服务商对比的内容。我们的选择大多数时候都很好用,但它们太受欢迎了,容量比不过那些囤着 GPU 的大实验室。我们注意到 GLM 5.3 Flash 的性能明显下滑,很可能是因为它在相关模型的帕累托前沿上位置太靠前。
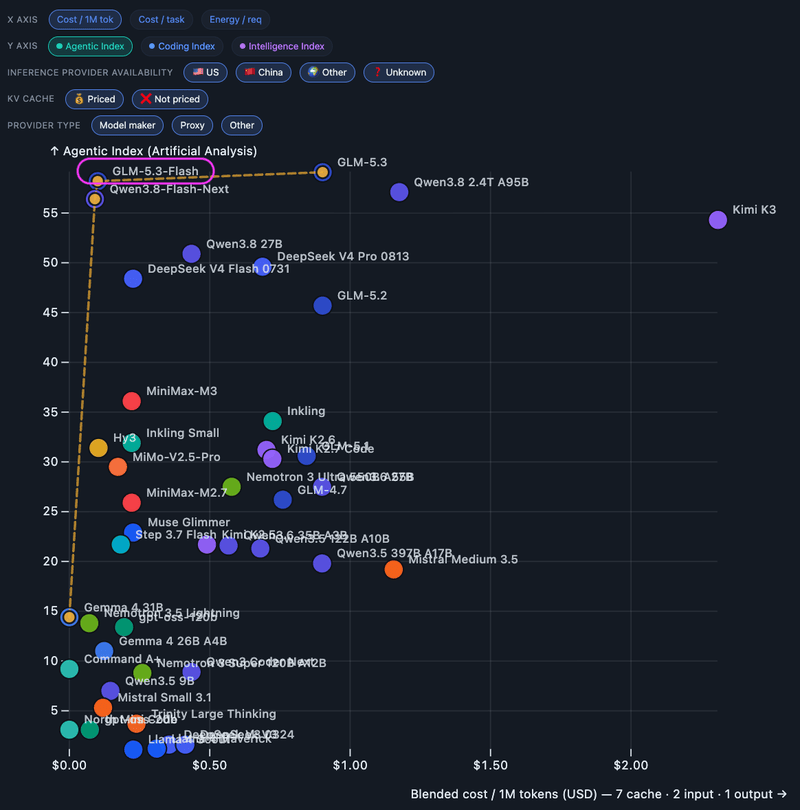
这意味着不得不切换到其他类似模型(DeepSeek V4.1 Flash、Qwen 3.8 Flash)。切换本身很简单,但依然出乎意料。
实验与研发的成本
最后,除了日常工程工作用一个模型,持续试验各种模型、跟上各家的发布节奏也十分必要。尤其在我们开始基准测试模型在 Wagtail 任务上的表现时,更需要跨大量模型的数据。先剧透一下我们的基准测试:
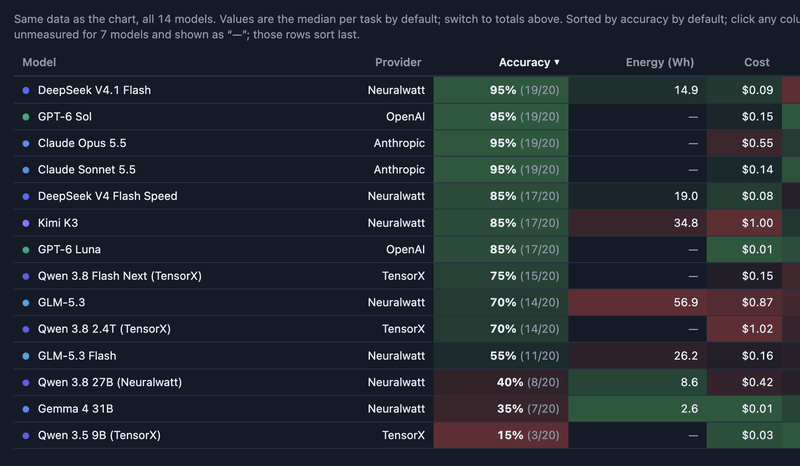
有了这类具体数据,引导人们选择更轻量的方案就容易多了;我们也能通过 agent skills 或新的 CLI 原型让这些方案更可行——那个 CLI 原型就是为了和 agent 配合良好而设计的。
收获与下一步
所以严格来说这次挑战是失败的:目标模型只占 50%,2B tokens 里只有 1B;能耗约 35 kWh,而不是 10。但我们学到了很多,这在当下至关重要。为 10 月做反思,以下这些能让它行得通:
- 持续在本地测量并报告用量。不只看 tokens,还要看能耗和花费,最好还能看出这些东西如何带来实实在在的好结果。
- 为实验做预算,而不只是为日常任务。更慎重地决定哪些原型值得做、该怎么做。
- 更好的提示词选择和多智能体技术。编排者、侦察者、实现者、审查者各司其职,目标有边界。不是什么高深科技,但确实又多了一样要学的东西。
- 继续推动更高效的技术和模型。Jev 式决策扩散模型如果能跑得这么高效,看起来很有前景。最新的旗舰模型在这方面也像是朝着对的方向迈了一步。
对日常开发工作来说,专注一两个 flash 档的便宜模型完全可行。一个可行的目标大概是:AI 推理工作的大多数都应当由这类高效模型完成,衡量标准是成本或能耗,而不是毫无意义的 tokens。这就是 10 月的目标。你也该试试,过程中会学到很多。
十一月来 Wagtail Space 2026 打个招呼,听听这一切最终如何收场!
评论
多数人肯定闪存级模型用于原型开发的价值,少数人质疑原帖能耗数据及文章质量,并有人提醒注意开放模型归属问题。
认为闪存级模型适合日常编码与原型开发
- 用户反馈 GLM5.3-Flash 等廉价模型在模糊修复、默认助手场景表现良好,搭配规划与审查模型更佳,原型可行。(认可度:较多人) > 日常开发中聚焦一两个闪存级廉价模型完全可行(@fallinditch 意译)
质疑原帖能耗数字真实性与选型教训模糊
- 有用户指出服务商能耗数据含利润而非真实耗电,同模型不同平台价差因缓存处理可达数倍;另有人疑惑文中“选错模型”未给具体反例与预见方法,怀疑缓存被清致成本异常。(认可度:较多人) > 那些能耗数字只是另一种计费形式,并非实际能耗的代表(@benjiro29 意译)
认为AI数据中心能耗极低且建设可能严重过剩
- 基于文中模型仅耗电4度、成本占比1%,有用户类比相当于电动车行驶15英里或烧开水,推断行业扩建如同暗光纤般过度,芯片产能受限反成经济救星。(认可度:少数人) > 4度电不过是烧开约38升水,能耗成本仅占总支出的百分之一(@epistasis 意译)
担忧开放模型推理归属与地缘影响
- 用户提醒“开放模型”常被忽略推理发生地、所有者及可能反哺强化学习;有人对中国开源权重模型表达兴奋与担忧并存。(认可度:少数人) > 人们很少追问开放模型的推理归谁所有、如何喂养训练(@consumer451 意译)
接受原型代码可抛弃而不求生产级
- 有用户共鸣作者“原型好用即可”,认为 vibe coding 可解复杂任务但产物不宜直接上线,应重拾“首次尝试会丢弃”的常态。(认可度:少数人) > 你能应付极复杂任务,但我绝不会日常使用AI产出的GPU驱动(@nxobject 意译)
有价值的补充
- 闪存模型编码需配好规划与审查:可用低价规划模型加中等审查模型弥补一致性(@throw930rmdkdk)。
- 缓存机制决定长任务成本:DeepSeek 官方 API 缓存命中率近99%且支持24小时缓存,远优于部分第三方,长期会话价差可拉大2-3倍(@benjiro29)。
- 资源效率新动向:Qwen3.8-Flash-Next 接近 GLM5.3-Flash 体验但需更少资源,后续版本受期待(@hgoel)。