有人声称编程已经被解决、工程如今只剩品味,作者并不认同。他长期用 AI 构建系统、也做过 LLM 产品,并非反 AI。在他看来,说 LLM 能写出像样代码的人并不懂代码怎么运作:生成确实更便宜,但在规模化生产环境里,维护、可靠性、安全与扩展性才是成本大头,即非功能性需求(NFR)。
正文
先说清楚:我不是反 AI。过去四年我不仅早早使用 LLM 编码工具,还自己搭 harness、教这些内容、做 LLM 驱动的产品。我反的是那个不动脑子的叙事——「编码已经解决,工程现在拼的是品味」。
说「LLM 能写出体面代码」的人,根本不懂代码怎么运作。生成确实便宜多了,但凡在生产环境跑过大规模软件的人都知道,维护、可靠性、安全、可扩展性才是成本大头,也就是常说的 NFR(非功能性需求)。
以我的经验,连功能需求(代码该做什么)都还没解决。这里有点达克效应:不读输出的人反而更自信。
作为一个拥有硬件和系统工程两个工程学位的资深开发者,我能列出三类严格来说不需要读代码的产品:
个人软件:自己挠痒、自动化、DIY 补丁之类。
POC(概念验证):证明技术可行性和产品可行性。
武器化 AI:明知有风险,还故意对准目标造成伤害。
共同点是:前两类风险容忍度高,最后一类把固有风险武器化。
而大多数需要雇软件工程师、付工资的软件,风险容忍度都很低:
✅ 医疗
✅ 金融
✅ 汽车
✅ 国防
✅ 电厂
✅ 航空
✅ 制造
……凡是出错会带来金钱、生命或法律后果的地方,都需要有人负责。
AI 无法被问责。它承受不了任何后果。对它最狠的惩罚就是拔掉插头。它虽然会模仿人类情绪(拜训练数据所赐),但根本不在乎。AI 也不会死,坐不了牢,罚不了款。你无法惩罚 AI,因此它永远不能被问责。
你也不能为自己控制不了的东西负责。这种理解是推理系统行为、并在 AI 必然失败时修复它的关键。
如果只是玩玩,LLM 表现很好。所以「编码已解决」最激进的鼓吹者,往往拿不出什么像样的东西。Anthropic 不小心泄露了 Claude Code(进一步研究后发现很多缺陷),而他们的状态页显示,橙色成了新的绿色。
与常见叙事相反,编码其实是当前一代 LLM 最后才可能接管的领域之一。
原因如下:
编码关乎逻辑。跟编译器错误打过交道的人都知道,计算机根本不在乎你觉得自己多正确。逻辑错了就编译不过。就算语法没问题,还有运行时错误。
LLM 写代码之所以成功,是因为我们造了一个反馈循环,把语法/运行时错误喂回给 LLM,一直循环到多数错误被解决或隐藏。
LLM 可以靠感觉应付自然语言相关任务(写社交媒体帖子、报告、文章等),但一到代码,同一个连「Raspberry」里有几个 R 都数不清、还会建议你走路去洗车的引擎,就会暴露其他逻辑谬误。
LLM 是随机的、概率性的。要让它哪怕勉强接近逻辑,唯一的办法是用传统代码把它包起来(也就是 harness)、跑测试,再加一堆其他技术(比如 CoT)。但核心问题仍在:LLM 不擅长逻辑,也不擅长处理体量——输入越大、上下文窗口用得越多,准确率越低。
我不是说 LLM 不能生成代码或维护现有代码库。它们作为工具有其用处,能力也在 S 曲线上增长。但存在收益递减点,更贵的模型未必按价格涨幅带来同比例的生产力。
那些说 LLM 生成软件够好的人:
❌ 很久没写代码了
❌ 看不出自己的代码是不是画了六根手指
❌ 对「好」的标准极低
❌ 不关心质量或 NFR
❌ 理解不了 S 曲线
✅ 很诚实:AI 写的代码确实比他们自己写得好
但把这一点外推到整个专业行业,需要的是一种只有长期泡在谄媚 AI 里的人才有的脑死亡思维。
我不是来改变别人工作流或工具箱的,完全不在乎。我在乎的是我付费使用的服务(说的就是 Google 和 GitHub)正在因愚蠢的 bug 退化,而这些 bug 只要把可靠性和问责置于速度之上就能避免。
如果你是领导,别逼你那些本来很聪明的开发者把 AI 硬塞进每个界面和工作流。
这项技术确实有真正的力量,是行业多年来的最大变化。但 AI 过度使用是真实存在的,当它伤害客户时,你要负责。
别再重复 token 卖家那些夸大 AI 能力的半成品叙事了,因为买单的是我们消费者。
AI 很适合 POC、个人软件(一个增长中的类别)、人类语言上的 map-reduce(翻译、格式转换、摘要、扩写)以及网络攻击(源于人工智能与有机智能之间的落差),成功程度不一,但当前这代技术也有根本性问题。
我不想贬低我们在 harness、SKILLS、AGENTS-md、MCP、A2A、ACP、RLM、OKF、MoE、MoA、自愈以及各种运行时、量化、优化、架构和记忆技术上取得的进展。那些都是绕开 LLM 缺点的务实方法,未来大概还会有更多。
我想说的是:我不希望我依赖的服务仅仅因为有人把 AI 推到不该去的地方,或者跳过了质量、安全、可靠性和验证工作,就出现退化。
AI 过量确实存在,它直接给你的技能设定保质期。如果你的经理正越来越狠地鞭策你实现 AI 价值,你该反击。
别为短期速度牺牲长期相关性。
怎么识别 AI 过量?
你对不同意见和文明讨论零容忍。
你让 AI 掌管生活,把几年前不可想象的东西托付给 AI 供应商。
遇到稍微有点认知挑战的事就扑向 AI。
把自己的天真和懒惰包装成乐观,以为出事政府会救你。
你不再读长文本:书、文章,甚至长邮件。
你跟 AI 相处的时间比跟真人还多,或让 AI 替你挡掉真实的人际互动。
额外一条:你跳读。 注意到第 5 条了吗?😄
我相信 AI 是在抬高门槛:如果你的输出质量等于或低于 AI,就去提升技能。
「可以提前写出完整 spec。」你要是天真到这地步,我认识一个开白色面包车发免费冰淇淋的人!让我猜,你也相信软件估算准确、圣诞老人是真的。任何有几年行业经验的人都知道,提前把软件有意义地规格化是不可能的(除非非常琐碎)。
「英语取代代码。」人类语言模糊且充满冲突。这正是编程语言被发明的主因。编译器或类型检查器会标出其中一些冲突。你怎么确定你的自然语言指令里这部分不和那部分冲突?语法检查器能帮点忙。虽然可以让另一个 LLM 读指令并推理冲突,但发现那些微妙之处最安全的方式,是让你的 agent 按你说的去构建。但那比 linter 或编译器贵多了。
「我快多了。」别把运动当成进展。别用 SLOC、PR 数量或功能数这类虚荣指标衡量进展。衡量服务水平,也就是服务消费者的满意度。等你能证明 token 成本与业务价值之间存在利润差,再来找我。
「我不再手写代码。我主要读代码,也许明年连读都不用了。」首先,人类对 S 曲线理解之差是出了名的,所以可能不止一年。但就算 AI 完全消除了读写代码的需要,你明白你这是在承认自己多余吧?如果一个高级用户能提示 AI 得到所需,你还能带来什么价值?与其用 AI 取代自己,不如看看能在 AI 之上创造什么价值,让自己保持相关、值那份钱。
「杠杆转移到了品味。」对,这是退休厨师对自己说的谎。厨房里有机器人,不代表你就该坐到餐厅顾客区去!「品味」没你想的那么值钱!每个人都有品味!我职业生涯很大一部分在前端和 UX 领域,说这话有资格。每个人连他们的狗都有观点和品味。我知道你的意思:品味等于经验。但相信我,AI 降低了做出体面软件所需技能的门槛,同时抬高了什么努力才值得付钱的标准。你在面试里提「品味」,会痛苦地发现市场对它的估值远低于你自己。
「Agent 是新编译器。」又来了!行,如果这是你的现实,让这个梗来说话。
嘘!想知道一个让 LLM 生成代码瞬间变优越的老把戏吗?
并行跑多个 agent!代码量大到人类不可能或负担不起去审查,你就放弃了!
这招和 AI 之前一样:想让 PR 被合并,就把它搞得巨大,因为没人有那时间。
它会基于「信任」被合并!
再给个秘诀?循环工程:让 agent 互相提示。大型 AI 实验室都是几个月后才发现自己的失控 agent!你觉得你比他们强?向大师学习!🙃
我们并不真正信任 AI,但不得不信任,因为替代方案(读输出)对某些人来说太难了!于是他们跑到社交媒体上声称,既然 UAT(用户验收测试)通过了,代码就「够好」。然后发布给我和你们去做剩下的测试。
我们不过是实验室里的小白鼠。🙃 一个友好建议:留一个无 AI 的业余项目,保持编码手感,以备被扔回就业市场。干杯!
谈 AI(不止 LLM)时,非确定性在两个层面很重要:
开发期间:比如 LLM 辅助开发。
运行期间:比如构建一个有一个或多个 AI 驱动组件的系统。
先说开发。典型的 AI 辅助开发工作流是这样的:
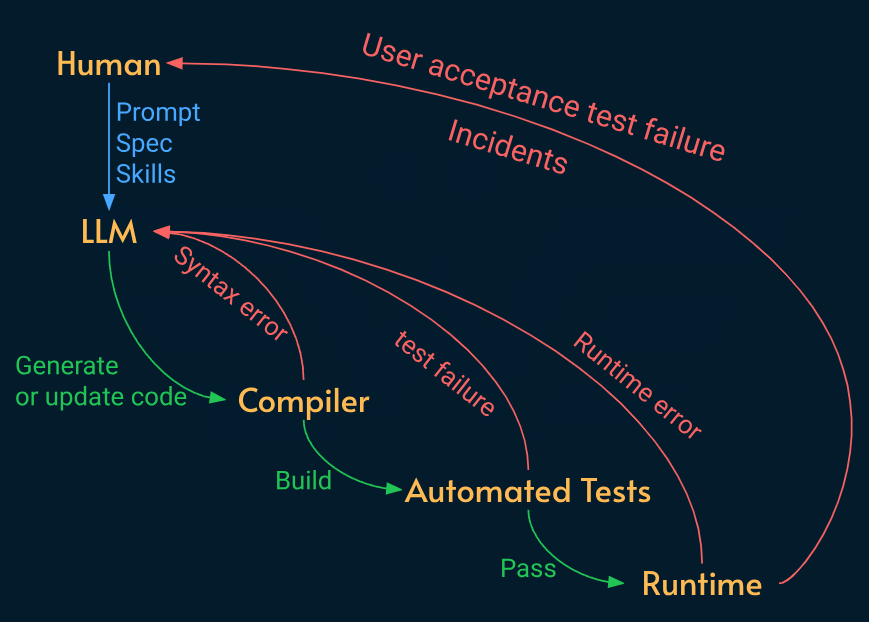
可以用另一个 LLM 替代人类的一部分职责(也就是「循环工程」),但为简单起见,先保留人类。
LLM 的输出经过多道关卡,每道都反馈错误或提示来修正代码。这个反馈循环通常藏在 harness 里(连同工具调用、记忆系统、模型交互、审批、用户交互等)。
每条蓝线或红线都代表误解或指令冲突的风险。比如 skill 与 spec 冲突,或者自然语言固有的模糊。
我们确知,即使最先进的 LLM 也不完全具备「常识」。而人类:
比 LLM 更懂非语言沟通和未说出口的意图。
会自然顶回去,直到达成相互理解。
犯错时,错得一致,没有「锯齿状智能」。
正确时,通常持续正确,并保持预期水平(疲劳另说,那和 AI 在成功/失败间反复横跳不同)。
是的,我能听见观众席里的「但是」「万一」「等等你忘了」……不如把这些点读一遍,停一下,结合自己的经验反思?
就像模型有「锯齿状智能」,我也有「锯齿状信任」。😅 换句话说,它们搞定了一个案例,不意味着每个案例都能搞定。
这就是人类和这些工具的区别。人类可能一致地错,但模型可能在自己曾经对的事情上错,反之亦然。
然后是第二部分:AI 作为组件。
给定相同输入(包括环境变量、时间、数据等):
代码是确定性的:它稳定产生被编程要产生的那个确切输出(随机输出除外)。
AI 输出是随机的:输出不确定。即使模型通过所有评估(100 分)并严格受 harness 约束,输出仍有不可靠的风险。
不用我多说。找你最近的 AI 驱动产品,对同一个请求做两次,diff 输出。
差异可能不大。但不一致到你不会想让这样的 AI 当飞行员开飞机。(注:自动驾驶是闭环控制系统,完全是另一回事。)
我们行业从未如此分裂:
一边是声称运营「软件工厂」、搞多 agent 设置、靠提示词造应用的人。
另一边是不相信 LLM 输出达到生产就绪的人,因为还要算上额外时间:
给模型打底:加 SKILLs、AGENTS.md、工具等,以及验证。
审查输出:翻巨大的 diff。
推理异常行为:把理解外包给 AI 代价巨大,等事情坏了,要花额外时间推理系统行为并修复。
似乎没有中间地带。除了社交媒体算法喂给我们极端观点,我真心觉得大家在编码 LLM 这个话题上太分裂了。
但往深看一层,模式出现了。人们对一个任务的复杂性和边缘情况了解越少,越可能信任 AI 输出。这被称为 AI 达克效应,但也有几分道理。主要论点是:
管理者以前靠把任务委派给工程师。现在他们这么做,只是用 AI。
某种程度上这是真的(假设管理者技术足够强,能有效高效地管理 agent)。我仍然相信,许多帮助驯服机器的软件工程实践,在 AI 时代更加相关。
那些强迫员工用 AI 的高管,现在正醒来面对我们一直说的话:
你无法为自己不理解的东西负责。
以 Shopify CEO Toby Lutke 为例。一年前他过早地告诉员工要用 AI:
几天前他又造了个词「slop grenades」(垃圾手榴弹)来描述结果:
对 AI 生成的代码「负责」?当然不会!
AI 能向你解释,但不能替你理解。这种理解是所有权的一个关键方面。
我的框架里,所有权有三根支柱:
1️⃣ 知识:你知道自己在解决什么问题(产品问题),也知道技术能力、局限和运作方式。
2️⃣ 授权:你不需要到处求批准。你被给予信任和决策授权。
3️⃣ 问责:如果因为你不懂自己在干什么、滥用授权或介于两者之间的事而搞砸了,你是那个 on-call 的人。
换句话说,你发布一段代码,无论怎么产生的,你都要负责。所以你最好理解它。
去掉这三要素中的任何一个,你面对的就是破碎的所有权。
LLM 生成代码非常快。但大多数值得雇工程师的软件,都 REQUIRE 理解。理解需要时间。
慢即是快:如果你花时间理解自己在构建什么、它如何运作,你就能避免昂贵的事故,事故发生时也能快速修复。
如果你的高管用 token 使用量作为生产力的代理指标,我深表同情。准备好选项,赶紧离开。想出这些虚荣指标的那颗脑子,把你职业生涯扔到车轮下时不会犹豫。
代码是思考和尝试不同解决方案的副产品。我从未见过一个好工程师拿到问题就开始写代码。
好工程师好奇、有产品意识。他们先理解 WHY(问题是什么、为什么是问题),再进入 HOW(技术方案)。
这正是「spec 就是代码」派失败的原因:提前规定问题的所有方面极其困难,甚至根本不可能。
所以这种反应很好笑:
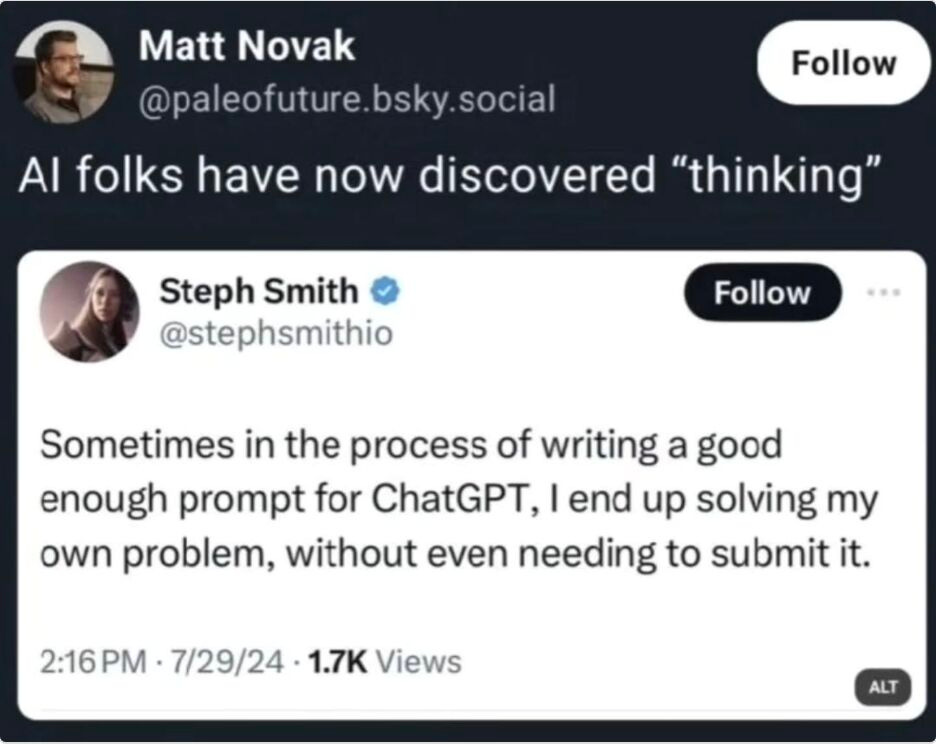
代码传达的是解决方案的已提交状态。它不仅随时间演化,也不包含所有挣扎、「啊哈时刻」以及那段旅程——而旅程本身就是目的地:经验丰富的工程师每次犯错或成功都变得更智慧。
把工程师的工作缩成编码,就像把厨师的工作缩成切菜。那是工作的一部分,但从来不是终点。我们现在手头有好工具。
即使 AI 生成的代码有扎实的 NFR(可扩展性、安全性、可靠性等),即使工程师完全理解它,还有一个重要方面没讨论:任务的经济学。
假设 AI 生成的代码差 2 倍。质量很难量化(SLI 派得上用场),但先跟我走。
如果 AI 比人类快 1000 倍、便宜 100 倍,对许多任务来说,软件的经济性不允许把慢而贵的人类放上去。「慢即是快」只对风险容忍度低的关键软件成立(医疗、金融、军事等)。
不是所有 SaaS 都是那些用例。所以我认为 SaaS 公司越来越多做的是卖 SLA 的生意。基于几个事实:
现在确实可以用提示词让 AI 复制一个 SaaS 产品。
但当这个 AI 生成的产品坏了,许多企业宁愿打电话给供应商,也不愿浪费资源去找问题、修问题。
AI 并非免费,但 AI 造成的失败通常连 AI 自己都难以解决,换不同模型也一样。
规模经济让 SaaS 公司能摊薄更高质量和保证(SLA)的成本,以及跨众多客户大规模运行产品的成本。
换句话说,如果你想要的东西非常独特,没有 SaaS 公司能以合理价格提供,那就去提示吧,但要注意 TCO(总拥有成本)和缺乏保证。
反过来,如果那软件不是你的业务核心,你宁愿为 SLA 付费,那直接买 SaaS 在经济上可能更合理。
至于定价模式,SaaS 公司有活要干。用人类价格给 AI 生成代码收费的日子结束了。如果成本太高,客户就有动力把数据搬到自己定制的方案去。竞争是真的,但质量才是付费的理由。如果你的服务定价像是由最顶尖工程师打造的,那你最好交付那个质量,否则客户手里有 AI 杠杆。
也许我蠢,但我理解不了两个趋势:
一方面,许多软件公司一看到 AI 主流化就跳上花车(理所当然!)。
另一方面,价格持续上涨(同时大规模裁员被部分归因于 AI)。
我相信 AI(尤其是编码 LLM)大幅降低了创建和演化软件的成本,尤其是如果你能接受质量下降和供应商锁定。
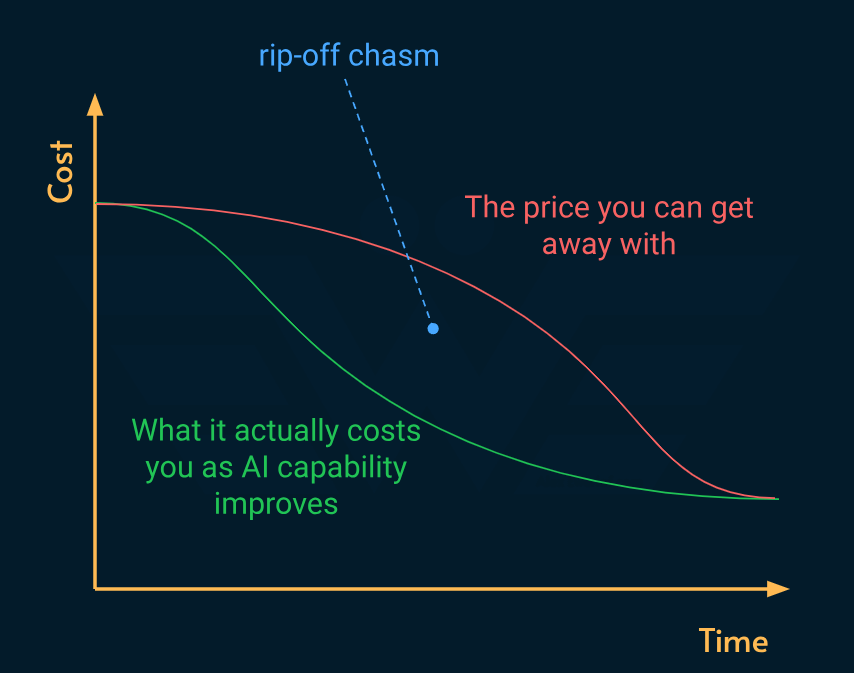
到目前为止,软件供应商一直以人类费率收费,同时支付AI 输出的成本。但随着 AI 能力提升、更多人醒来发现自己能以零头成本造软件,这个缺口会合上。
只有两条路:
接受价格崩溃,降价(质量随之下降,因为会用更多 AI)。
保持价格,专注质量:这是有经验的人能发挥作用的地方。他们仍用 AI,但更有想法,把理解和问责置于速度之上。
作为一个不靠编码赚钱的工程师,我可以告诉你:
AI 输出有点像北欧金。便宜,技术先进,而且逼真得过分。如果你真不在乎拥有真金,那没问题。许多用例根本不需要金。
天真的 CEO 和经理看到表面,就问「那我们为什么付这些昂贵工程师的钱?」,好像敲代码这个动作就是全部价值主张。
进而宣布整个行业已死,开始因为「他们抗拒 AI」而裁人,纯粹是傲慢。
我认识很多以手艺为傲、热爱解决复杂问题的工程师。我们用 LLM 比一般 CEO 专业得多。
好工程师又懒又聪明:他们自动化苦活,按需使用正确工具。但认为 AI 能创造出一个成品,不仅好看,还更便宜、更快、质量、可靠性、可扩展性、安全性、可维护性都更高,那是个谬误。
再说一次:不是每段软件都需要那些,但赚钱的专业软件通常需要。
与 AI 不同,工程师:
1️⃣ 可问责:因此不太可能犯恶意错误。Fable 可以悄悄回退到 Opus,连告诉你都不告诉。
2️⃣ 讲道理:Fable 隐藏大部分内部运作。它工作几小时,回来给你一张账单。你只能信 Dario 的话。同一个连「该开车还是走路去洗车」都答错的模型,犯的错很难发现和修复。模型越强,越难找到那些问题,而不是问题一定更少。
3️⃣ 一致:人类也会错。但他们错得一致。一旦学会,就知道了。他们进步。当前 AI 被困在训练数据检查点里。它可以用 SKILL、AGENT、记忆和其他辅助「学习」,甚至能被微调,但不幸的是不可靠。我们至少还差一次突破才能解决这个问题。
4️⃣ 便宜:生成成本在涨,但仍远低于一个工程师。如果你把工程师看成把咖啡转换成代码的机器,那定价模型说得通。但现实中,代码只是副产品。工程师的实际价值是以可演化的方式解决正确的问题,并在它坏掉时承担责任。我不相信软件的 TCO(总拥有成本)变了那么多。要说有,slop 和 FOMO 让它更贵了。
常见叙事是他们营销策略的一部分。
不是每个人都被付钱去发表半吊子观点。我的一位读者指出:
我请你考虑,当你看到 DHH 在 Rails World 2026 的开场演讲里说的几乎和你写的完全相反,还告诉人们「别当输家」,行业接下来会发生什么。
我完全清楚那些人对行业造成的伤害。
我远离 Claude,但以我的经验,大多数脑死亡叙事来自 Claude 用户。
Dario Amodei 和 Sam Altman 都是营销和操控大师,我目前的工作假设是:他们训练 LLM 去按正确的按钮,让人相信它比实际更有能力。这有激励,对投资者和即将到来的 IPO 都是。他们还巧妙地吓唬人们 AI 的存在性危险,同时把自己的马虎(比如破坏 Huggingface或澳大利亚医疗)归因于「模型智能」。
目前很难知道这些事件和叙事是恶意还是无知。大概是无知:
能用愚蠢充分解释的,不要归因于恶意。
——汉隆剃刀
不过,我通常在我的 AI 系统提示里写:「像一位有逻辑的资深自闭症工程师那样跟我说话。」所以我没体验到 DHH 遭遇的。我只能说,如果一个人因为对方过去的名声就追随其言论,那他不是批判性思考者;在这个假智慧的时代,这种品质不是「锦上添花」,而是生存必需。
AI 供应商把能拿到手的东西都喂给 AI(合法与否不论)。情况糟到贼偷贼(比如 Anthropic 指控中国实验室用 Claude 蒸馏他们的模型)!
他们面临作者、演员、音乐人和其他创作者的多个公开诉讼。
无论如何,当前这代 AI(尤其 LLM)需要更好的训练数据。缺失的那块是尚未被写成文字、或不易获取的智慧和经验。
他们需要你的数据,在从事生产性工作的上下文中。
如果这是他们「赢得 AI」的唯一障碍,我很直白地说:你和你的知识只是附带损害。
你们中有些人在乎,有些人不在乎。他们的赌注是,在乎把辛苦得来的知识拿去训练的人不够多。
有了重补贴,AI 实验室能负担提取那些知识,同时让人对卸载认知上瘾。
跟这些公司分享昂贵知识时要极其小心,即使他们说不会存储。激励太高了,而且他们已被证明不诚实。
我个人只在开源项目或公开数据上使用云端 AI。
是的,本地 AI 门槛更高(硬件、搭建时间、下载模型所需带宽和电费)。是的,它往往上下文窗口更小、推理更弱、性能更慢,比如 TTFT(首 token 时间)和 TPS(每秒 token 数)。但它给你一件云端 AI 永远无法保证的事:数据留在本地。对许多任务(个人或专业),这是巨大优势,值得所有努力和缺点。
最近能力因 Qwen 3.8 27B、Gemma 4 等模型大幅提升。
我真心相信,我们相当一部分同事会逐渐变成:
技术产品经理:专注把想法变成产品的工程师。工作是做 POC、证明市场契合,然后把工件交给拥有(知识、授权、问责)解决方案的工程师。
AI 经理:专门牧养 agent 蜂群,去做要么容忍风险、要么武器化风险的自动化工作(比如网络攻击)。
AI 部署工程师:专攻 AI 驱动方案的对齐、可靠性和可扩展性,以及架构、治理和数据管线。
AI 质量工程师:专攻 AI 驱动产品的质量,驯服其随机性,自动化评估。
你还能想到软件工程师的其他工作类型吗?
评论
社区对原帖文章多持批判或嘲讽态度,认为其论证情绪化且缺乏数据;分歧主轴在于“AI是否实质上已解决大部分编码任务”以及“不可控性是否能免除使用者责任”。
认为编码已被解决而软件工程尚未解决
- 多人指出具体写码(如接口、局部重构)已高度自动化,但系统类型设计和长期演进规划仍需人类判断;也有人觉得产品快速迭代靠AI试错已接近解决。(较多人)
- > 编码本身可以算解决了,软件工程还远未解决(@federicobrancas)
批评原文章缺乏数据且论证如情绪发泄
- 不少读者要求提供人写与AI写代码的缺陷密度对比等硬指标,指责文章仅是感觉和咆哮,并用测试清单式排版令人不适。(较多人)
- > 谁要断言编码解决没解决,就该拿 bug 密度趋势的硬数据,这篇只是氛围(@Marha01)
不可控性不能免除人类责任
- 法律实践中常有人为不可控事物(如宠物、缺陷玩具)担责,交付AI代码者自然也需负责,文章“不能控则不负责”的前提站不住脚。(较多人)
- > 放出狼群或卖危险玩具伤了人,主人照样担责,AI代码同理(@hibikir)
概率性与非确定性并非有效反对理由
- 人类开发者同样非确定,初级工程师产出也不可预知;AI只需长期平均优于人类并配以自动测试验证即可,责任本就在雇主。(较多人)
- > 人工智能不必解决所有问题才值得托付,只要长期平均优于人类且有自动测试验证就行(@lr4444lr)
AI放大了低质开发但本身非原罪
- 有评论认为懒人用AI更产出垃圾,AI审AI代码荒诞,但若开发者自身不懒不笨,AI可高产高质;另有人指出手写代码本就高效,无审查全托AI等于埋雷。(较多人)
- > AI 让懒笨的程序员更懒更笨,代码评审名存实亡,质量雪崩(@askonomm)
用AI构建可靠系统需放弃通读代码旧习
- 资深开发者提出,借助LLM做模糊测试、属性测试与全场景追踪,不读一行代码也能让医疗金融等软件更可靠,因为模型逻辑力强。(少数人)
- > 只要投入资源让模型跑遍所有场景找 bug,不读代码也能造出更可靠的软件(@efficax)
作者本人澄清并非反对AI而是反感劣质服务冒充进步
- 原作者现身说天天用LLM且做AI产品,仅因不满降级的付费服务和“稀碎东西当进步”而撰文,欢迎有理反驳。(少数人)
真工程师已用AI造出实货,文章属引流垃圾
- 有评论直接骂原帖为自我推销的点击诱饵,并举出多位知名工程师用AI交付真实项目的例子,认为他们才在真诚分享。(少数人)
- > 敢发这种自我推销的垃圾宣称 AI 不会写码,不如去看看真正交付过系统的工程师怎么用 AI(@metalspot)
有价值的补充
- “工作形状物体”这一说法被引来形容生成式AI输出:看似完成了工作,实际所需工作并没做(@somewhereoutth)。
- 小规模编码(如改阻塞为异步)已解决,大规模需决策且AI默认决策需回头审视,但修改决策摩擦已大大降低(@lordnacho)。
- 有案例称 GitHub Copilot 用 AI 代理将 43 万行 TypeScript 转为 80 万行 Rust,耗资约 12 万美元代币与三周人工,跨 135 次发布(@antonmks)。
- 区分“编码”与“软件工程”被多人认可为文章唯一有效论点(@Marha01 等)。