作者又写了一篇关于英特尔(Intel)8087的文章。1980年英特尔推出8087,让IBM PC等系统的浮点运算快了许多。这次看的是这颗芯片正切指令背后的算法。三角函数可用CORDIC算法或多项式逼近,8087把两者结合,兼顾精度与性能。8087算一次正切只需90微秒,8086则要13000微秒。作者用凿子和显微镜打开芯片、拍摄高分辨率图像,通过电路与微码解释FPTAN指令。
正文
逆向工程老式Intel 8087的正切算法:不止是CORDIC
1980年,Intel推出8087,让IBM PC等系统的浮点运算快得多。我来看芯片正切指令背后的算法。三角函数的一种流行方法是CORDIC算法,另一种是多项式近似。8087把两者结合,同时获得高精度和高性能。相比8086微处理器,8087的速度提升巨大:算一个正切只需90微秒,而不是13000微秒。
通过检查8087的电路和微码,我可以解释正切指令FPTAN背后的算法。为了研究8087的电路,我用凿子撬开芯片盖子,用显微镜拍出高分辨率图像。微码ROM是芯片中央的大矩形区域,存有控制芯片的1648条微指令。芯片下半部分(红框)是数据通路,对80位值执行浮点计算。
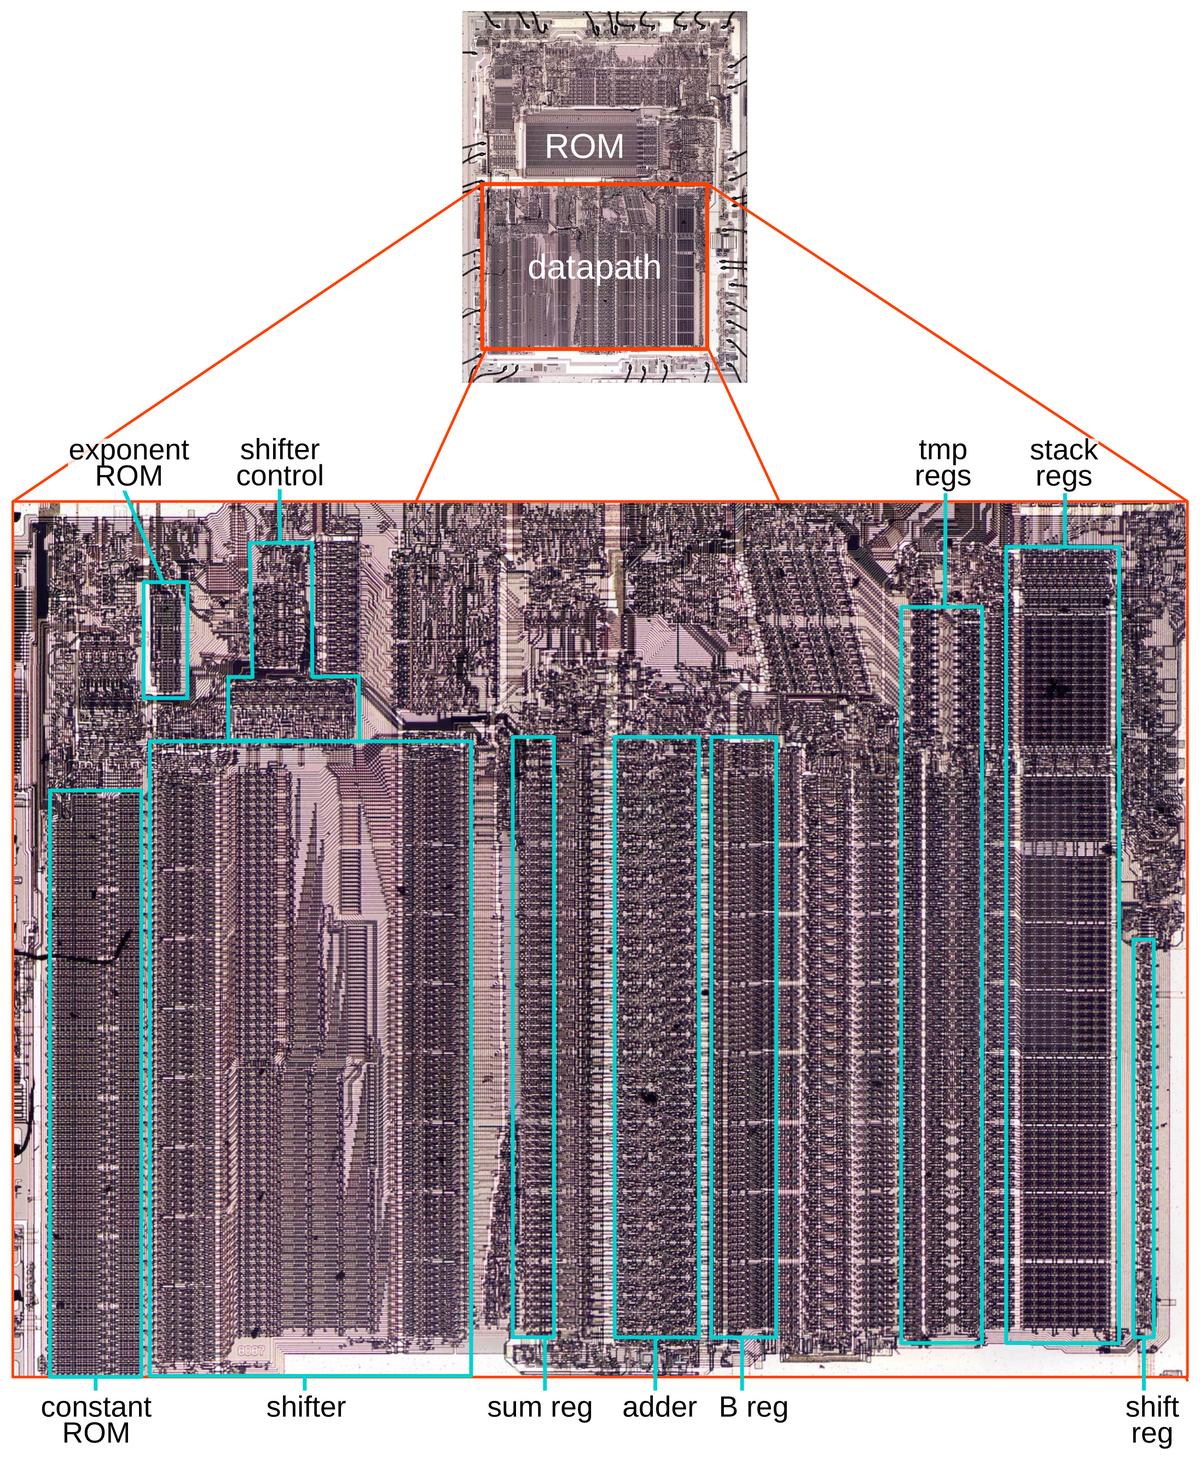
放大数据通路可以看到相关功能单元。指数ROM存储算法所需的固定指数值。常数ROM存储常数,包括CORDIC算法使用的常数。移位器很大,可以把64位值左移或右移任意位数。加法器是8087计算的核心;除了加减,它还在循环中用于乘法、除法和平方根。B寄存器保存加法器的一个输入,另一个输入可以有多个来源。和寄存器保存加法器的输出。八个栈寄存器和临时寄存器保存浮点数。最后,移位寄存器保存CORDIC计算所需的16个状态位。
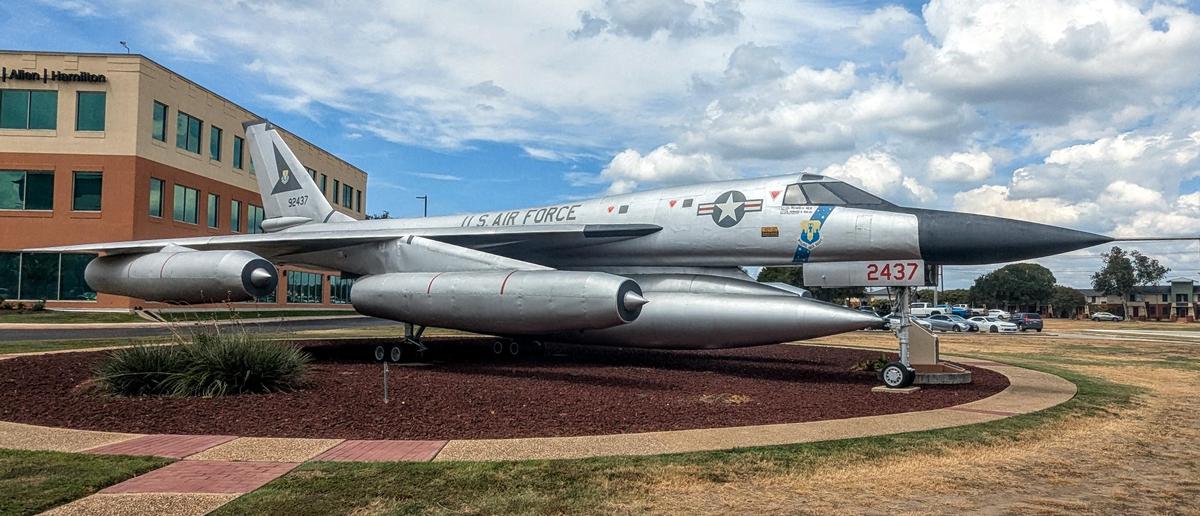
CORDIC是一种用简单硬件快速计算超越函数的巧妙算法:它使用移位和加法指令加查表,不需要乘法或除法。这个算法追溯到1956年,当时为B-58 Hustler研制,那是第一种能以2马赫飞行的轰炸机。飞机有模拟导航计算机,但模拟元件精度有限。工程师Jack Volder的任务是设计数字计算机来替代模拟计算机。一个关键问题是,模拟计算机可以用机电式分解器轻松产生正弦和余弦,但数字方式很难生成三角函数,尤其用当时缓慢的晶体管。
Jack Volder想出一种用简单硬件快速计算三角函数的方法。他把算法——以及实现它的计算机——称为CORDIC:"坐标旋转数字计算机"。CORDIC把角度转成向量,向量的坐标提供所需的三角函数。诀窍是把角度分解成一系列特殊角度,这些角度让向量旋转变得容易。这些特殊角度预先算好存在表中,所以即使在1950年代的硬件上,CORDIC计算也能很快完成。每次CORDIC迭代增加一位精度,算法收敛很快。CORDIC流行起来,包括在科学计算器中,它们使用十进制CORDIC而不是二进制。
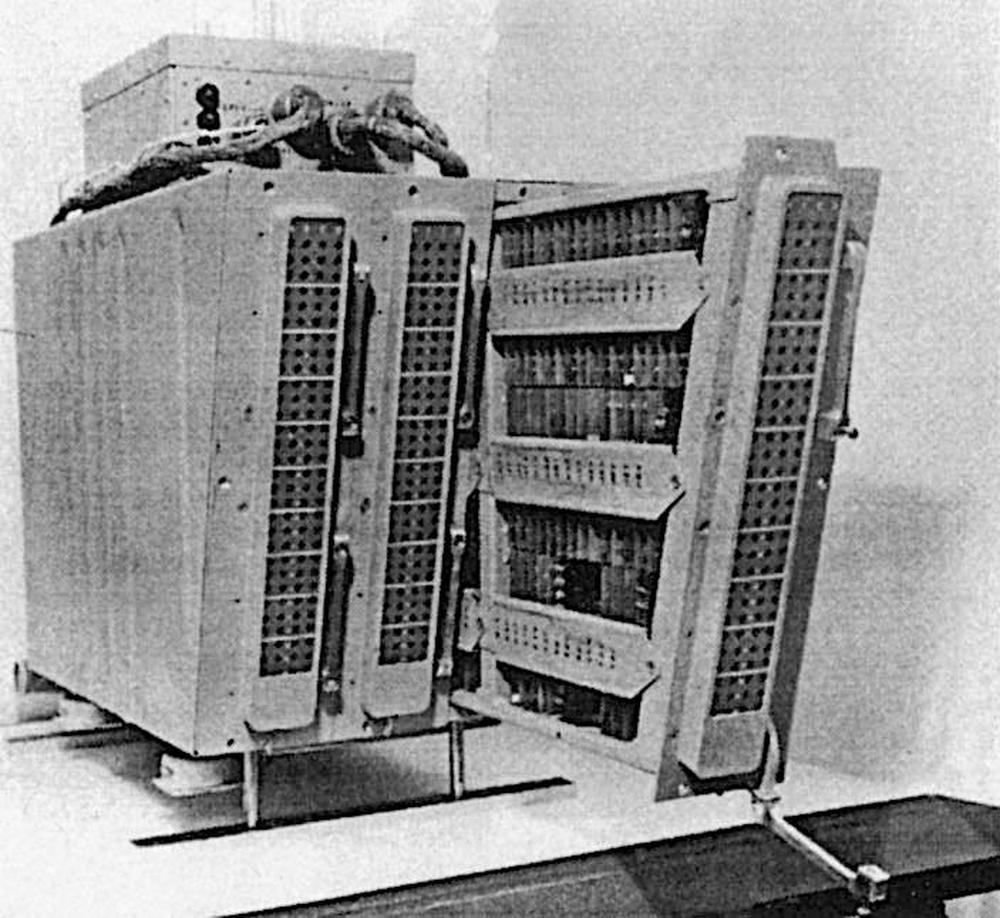
B-58上的CORDIC II计算机是30位串行计算机,运行频率198.4 kHz,重达134磅。它用二极管-晶体管逻辑门实现,有2498个晶体管和4265个二极管,还有鼓存储器(顶部可见)用来存储,容量相当于39 KB。有趣的是,CORDIC操作被实现为指令集的基本指令,而不是子程序;一条CORDIC指令耗时5毫秒,和乘法或除法速度一样。
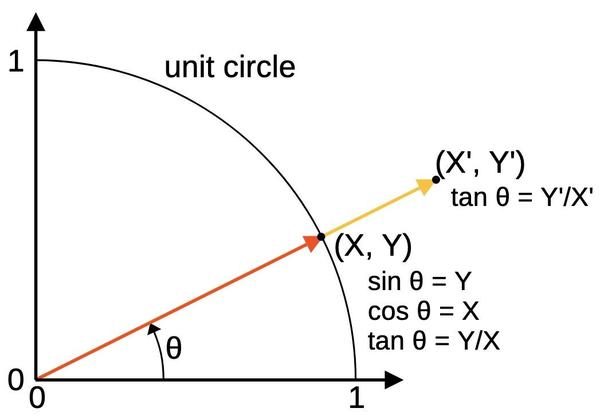
一些三角函数
我会尽量少用数学,但这一节快速解释CORDIC如何工作。下图回顾三角函数与点坐标的关系。假设有角度θ,它指定单位圆上的点(X, Y)。基本公式是X=cos θ,Y=sin θ,Y/X = tan θ。因此,如果能确定坐标(X, Y),就能确定三角函数值。如果点不在单位圆上,比如(X', Y'),仍然容易确定tan θ(8087就是这样做的)。但sin θ和cos θ会变得麻烦。
如果你做过计算机图形学,大概见过旋转矩阵如何把点旋转一个角度。把点(X, Y)乘以旋转矩阵,得到新点(X', Y')。
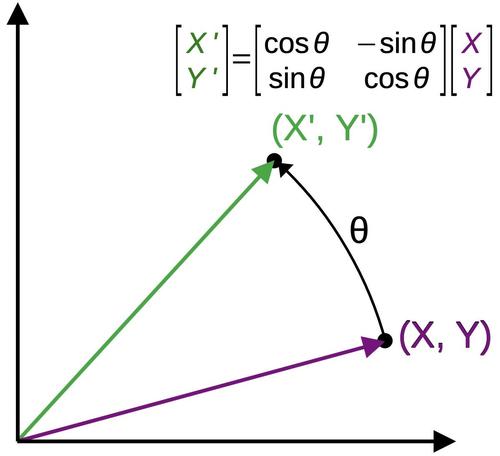
可惜旋转矩阵需要sin和cos,看起来帮不上忙。但可以把矩阵除以cos θ;这似乎更没用,因为矩阵现在需要tan,正是我们想求的。(而且向量长度会增长。)但CORDIC的关键是使用特殊角度α_n = arctan(2^-n)。把特殊角度代入矩阵,得到矩阵(3),在硬件中很容易计算:乘以2的幂可以通过移位完成。
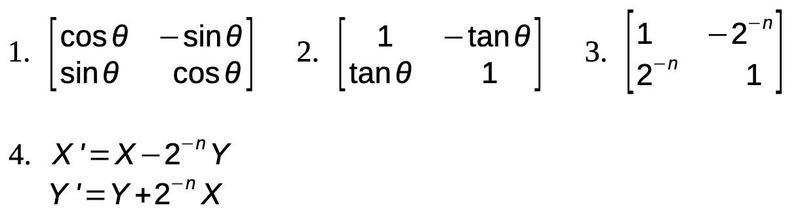
把矩阵(3)作用于点(X,Y),得到方程(4)。这些是CORDIC过程的关键方程。重要的是,这些方程在机器语言或硬件中计算起来又快又容易,因为只有加法、减法和二进制移位。
有了这些背景,就能看出CORDIC如何工作。首先,把输入角度分解成一组特殊角度之和,加起来等于目标角度。然后从单位向量(1,0)开始,对每个特殊角度应用旋转公式。结果是一个位于目标角度的点(X, Y),所需的正切就是Y/X。由于特殊角度表是预先算好的,arctan运算不会拖慢过程。顺带一提,前几项之后,特殊角度接近2^-n,每步大约缩小一半。
概括一下,CORDIC算法就是循环查一个存储角度表。如果存储角度小于目标角度,就从目标角度中减去它,得到新的目标角度,并对向量应用上述方程(移位、加、减)。最后,原始角度的正切由Y/X给出。
有理多项式近似
CORDIC的精度取决于使用的项数。16项约2^-16,即16位精度。要达到64位精度需要计算64项(以及64个特殊角度的表)。为了更快得到答案,8087用16位CORDIC,剩余角度用另一种算法。剩余角度是特殊CORDIC角度之和与目标角度之间的差距,所以非常小,约2^-16。
对于剩余角度,8087使用Padé近似,即两个多项式之比。8087用一个简单公式:3x/(3-x²)。这个近似对小值非常精确,误差正比于x⁴。由于x<2^-16,误差小于2^-64,满足8087的64位精度要求。而且8087不需要在有理多项式中做除法,因为FPTAN返回单独的分子和分母。因此,除法是"免费"的。
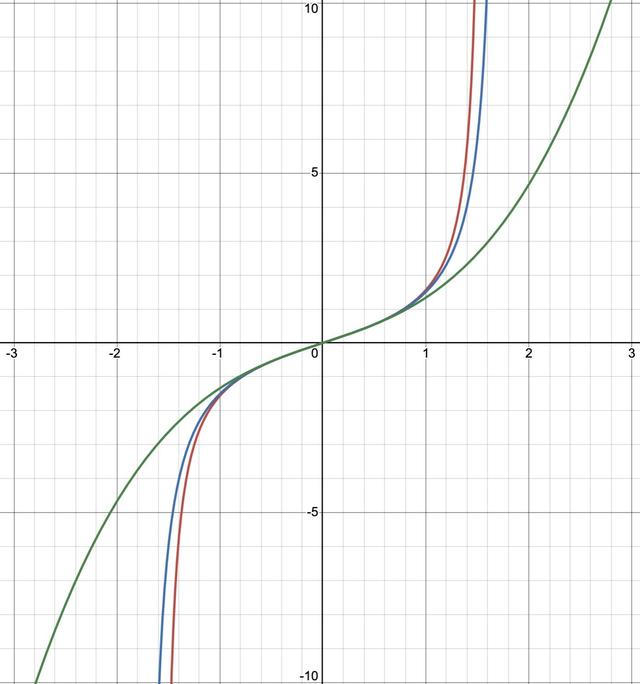
如果你学过微积分,可能觉得泰勒级数多项式是正解,但两个多项式之比更好。一个原因是正切在π/2处趋于无穷。多项式不会趋于无穷,但多项式之比可以,所以更贴合正切函数。上图比较了正切函数(红)、有理近似(蓝)和三阶泰勒级数(绿)。
把各部分组合起来:8087算法
8087的正切算法有三部分:确定CORDIC决策位(称为伪除法),计算有理近似,根据CORDIC决策位应用旋转方程(称为伪乘法)。
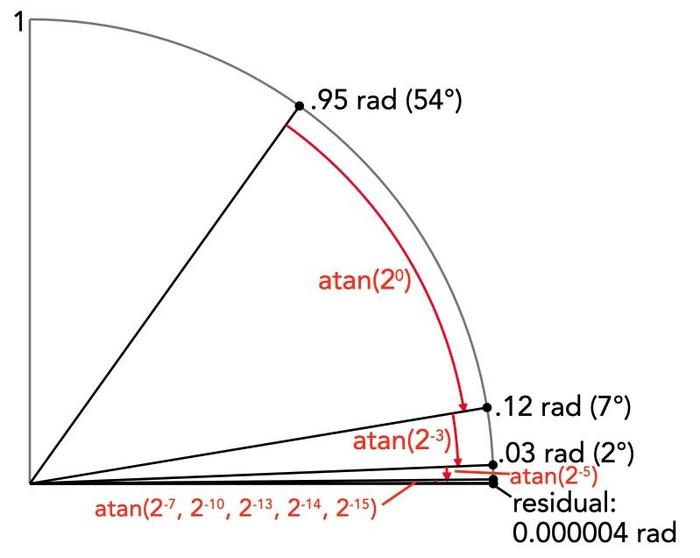
更详细地说,第一步确定用哪些特殊角度来近似输入角度。每个特殊角度与剩余的输入角度比较,如果更小就减去。如果减去,记录1;否则记录0。这个过程类似长除法中减去(或不减去)逐次移位的除数,产生商的1或0,所以称为伪除法。注意这一步不应用旋转,而是决定后面应用哪些旋转。
下图显示这个过程应用于输入角度0.95弧度。过程生成位序列[1,0,0,1,0,1,0,1,0,0,1,0,0,1,1,1],最左位对应arctan(2^0),依此类推。每步角度大约减半,所以残余角度非常小。
接下来,用有理近似函数3x/(3-x²)计算剩余角度的正切。结果作为下一步的初始向量。这里不执行除法;分子成为初始向量的Y,分母成为X。这样避免了昂贵的除法,因为它隐含在答案中。乘以3很容易(左移再加),所以这一步唯一昂贵的操作是角度平方,需要完整的64位乘法。
最后一步在第一步对应决策位为1时应用相应的CORDIC旋转。这有点像二进制乘法——乘数位为1时加上被乘数——所以这一步称为伪乘法。如前所述,每次旋转用移位、加、减计算,很便宜。这一步的每次旋转对应第一步的一次角度削减。旋转按相反顺序应用——最小的先——以减少舍入误差。为此,决策位在第一步存入一个16位移位寄存器,在这一步按相反顺序移出。
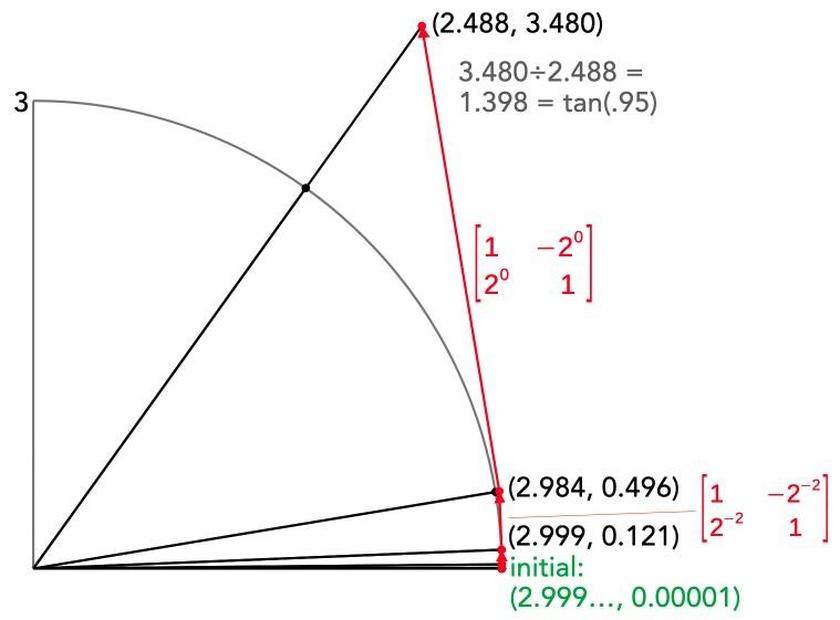
上图显示应用于输入0.95的过程。初始向量(绿色)来自有理近似函数;它非常接近(3, 0),但因微小的残余角度而略微旋转。每次旋转产生一个新向量,与第一部分对应步骤的角度匹配;图中显示两个旋转矩阵。注意向量偏离圆——这是每个矩阵除以cos θ的结果——但不影响正切。
FPTAN指令有点特殊,它不直接返回正切,而是返回部分正切:两个坐标值(X和Y),相除得到正切。有人可能问芯片为什么不自动做除法。原因是当时除法很慢,省略除法在某些情况下可以优化。
文档说FPTAN的有效参数范围是0<θ<π/4,所以我用的0.95超出了范围。这令人费解,因为第一个CORDIC常数是arctan(1)=π/4,只对超过π/4的输入有用。可能8087原本为更大范围设计,但数值误差比预期大,所以截断了范围;也可能FPATAN指令反正需要第一个CORDIC常数,干脆共用同一个循环。
8087的相关硬件细节
这一节解释8087的一些特性,对FPTAN的微码实现很重要。
8087支持多种数据类型,但内部一切都存为80位浮点数,称为"临时实数"。一个数有三部分:符号位、15位指数和64位有效数字。多数情况下,浮点数表示为符号 × 有效数字 × 2^指数。浮点数的优势是指数让它们覆盖巨大范围,从很小到很大。有效数字是形如1.bbb…的64位二进制数:前导1,然后二进制小数点,再是其余位。一个重要细节是指数存储时加了16383的偏置。因此,存储的指数总是正数,即使实际指数为负。例如,指数1存为0x4000,指数-16存为0x3fef。
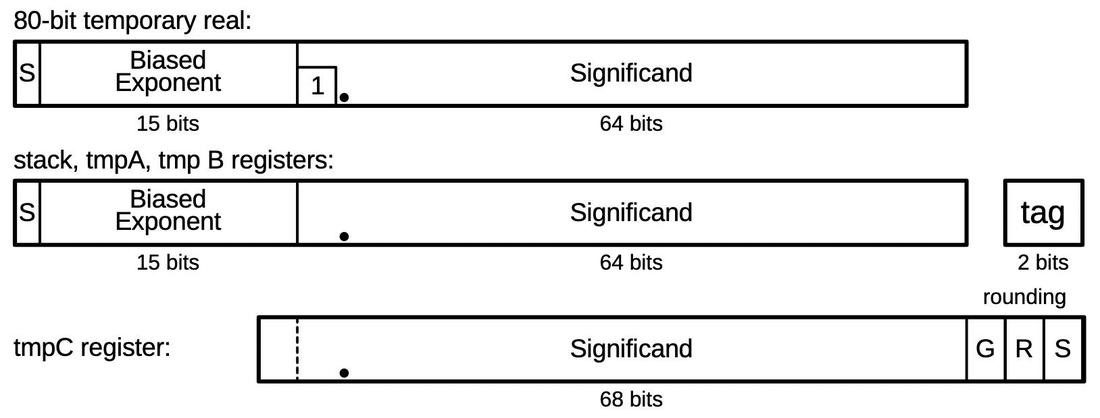
要使用8087,程序员把值存入它的八个内部寄存器,组织成栈。每个寄存器保存一个80位浮点数。为优化性能,寄存器栈中每个值还关联一个"标签":zero、valid、special或empty。零标记为zero。正常浮点值标记为valid。如果是无穷、NaN或非规格化值,标记为special。empty表示寄存器没有值;这样可以检测栈下溢(读空寄存器)或上溢(写入非空寄存器)。
8087还有内部使用的临时寄存器:tmpA、tmpB和tmpC(这些寄存器在正切计算中大量使用)。tmpA和tmpB是80位寄存器,还有两个标签位。但tmpC不同:它没有符号、指数或标签。而且有效数字是68位;tmpC多一位防溢出,还有三个低位用于舍入,称为guard、round和sticky。
在微码中,每条16位微指令执行一个低级操作。许多操作把数据从一个寄存器移到另一个。其他操作提供条件跳转、子程序调用和返回。移位操作需要两条微指令:第一条把值移到移位器,配置方向和移位量。第二条(可能在第一条之后一段距离)把结果从移位器移到目标。
类似地,加法需要两条微指令。第一条指定要加的第一个参数,并选择进位、舍入等选项。(减法用一个选项对第二个参数取补。)第二个参数总是来自B寄存器,它和tmpB寄存器无关,容易混淆。第二条微指令把结果从和寄存器移到目标。
微码中正切算法的实现
这一节讨论正切微码的一些要点。控制流有点复杂,所以下面有流程图。
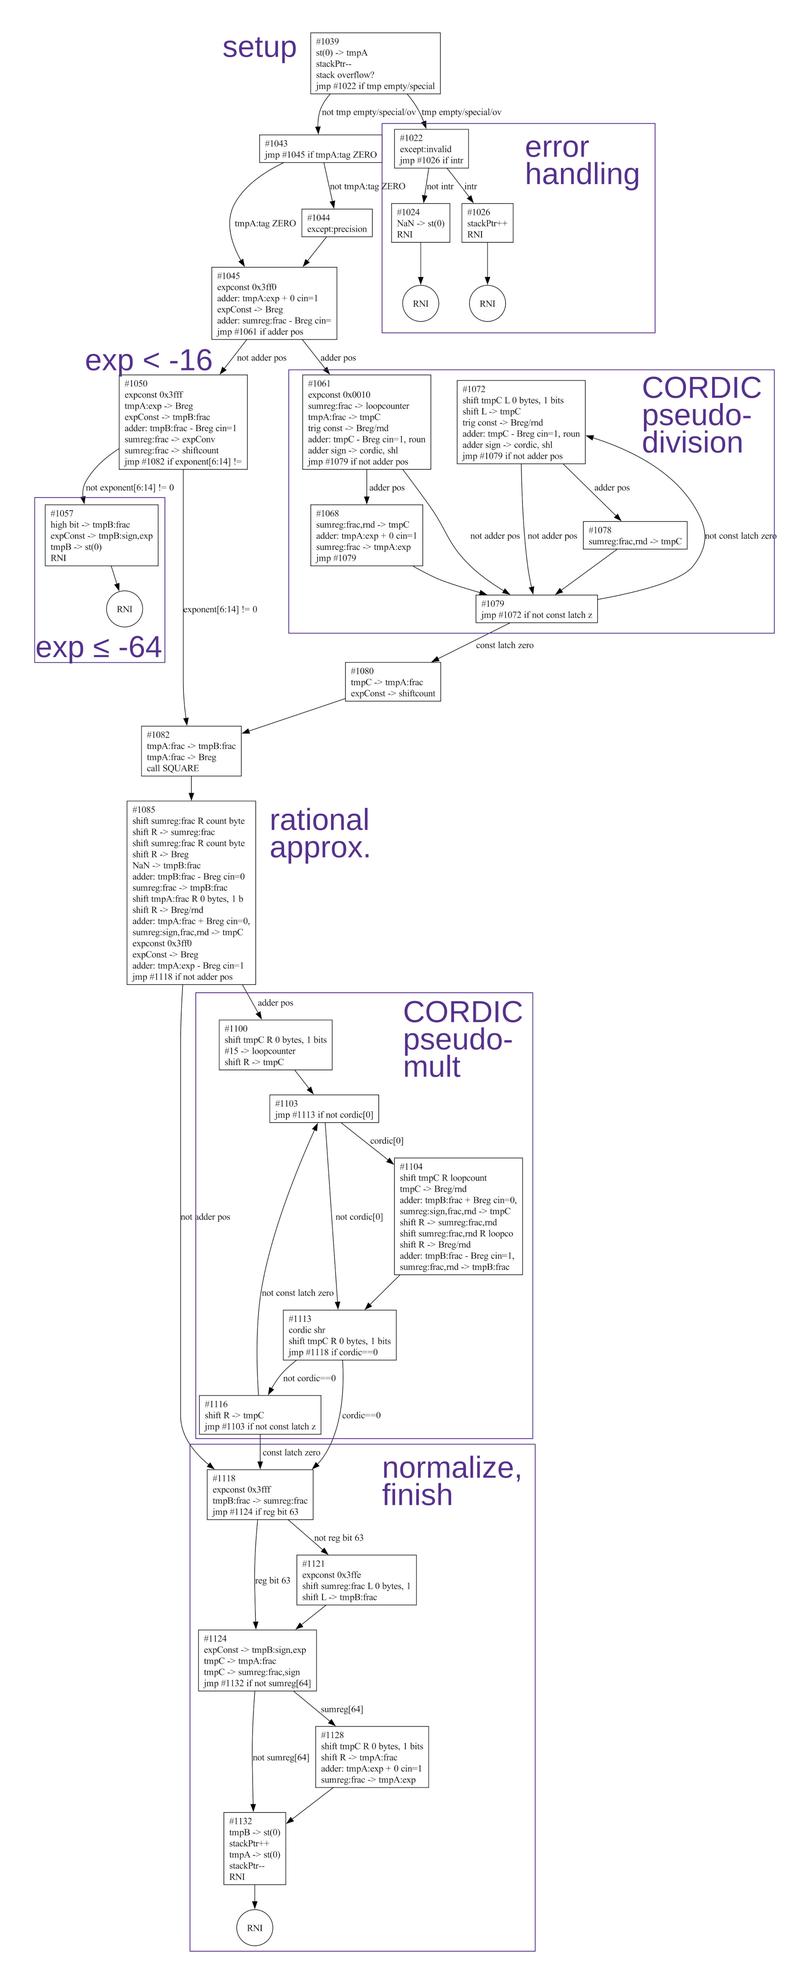
FPTAN微码从地址#1039(十进制)开始。微码先把参数从栈顶移到tmpA寄存器。如果栈顶为空,表示栈下溢。如果栈上下一个元素(将保存结果的位置)非空,表示栈上溢。两种情况都报"invalid"异常并结束指令。
8087的一个特别之处是,结果不精确时会标记"precision"异常(这经常发生,比如1/10)。8087能精确计算的唯一正切是tan(0),所以其他所有输入都会触发precision异常(#1044)。
接下来检查参数的指数,把执行分成三条路径。如果指数≤-64,参数太小,正切在系统精度内等于参数本身。此时(#1057)原参数原样返回(压入分母1),代码结束。第二种情况是指数≤-17。此时跳过CORDIC步骤,直接跳到有理近似(#1082)。
CORDIC伪除法
最有趣的是CORDIC路径(#1061),指数在-1到-16之间时走。概念上代码执行16个CORDIC步骤,使用16个存储角度。但代码经过优化,对较小输入跳过大的角度。具体说,循环计数器根据输入角度的指数初始化(#1062)。CORDIC伪除法循环(#1061-#1080)测试角度,减去不太大的。
决策结果记录在16位移位寄存器中,位于芯片最右侧。大概是布局中有未使用空间。由于移位寄存器串行加载和卸载,不需要访问内部尾数总线,只需两条线移入移出位,所以可以放在别处未用的空间。
代码优化使用64位整数运算而不是浮点运算。这使代码难以理解,因为值必须更多看作带隐式指数的定点数。这些指数不存储在任何地方,但可以通过分析算法确定。连ROM中的角度常数也没有显式指数。而且隐式指数在循环每一步都变化以保持精度。大致上,循环每轮把值减小一半,角度常数相应缩小。如果值有固定指数,最后会有16个前导零,浪费精度。但每轮通过左移缩放值,数字可以继续用满64位。换句话说,硬件执行快速整数运算,但数学上可以看作带指数的定点,这些指数并不物理存在于芯片中。
有理多项式近似
CORDIC伪除法循环之后,微码计算有理多项式近似(#1082)。小角度路径也在这里重新汇合。计算多项式近似的微码有几个有趣之处。最耗时的部分是SQUARE例程,把定点数自乘。乘法很复杂。简要地说,8087用Booth算法每次乘两位(基4),比普通二进制乘法快一倍。执行移位和加法的循环在硬件中实现,而不是微码。也就是说,一条微指令执行32次加法:硬件测试位,做相应的加或减,更新循环计数器,然后循环。为了性能,移位用专用移位器,而不是8087的通用移位器。
除平方外,多项式用加法而非乘法计算。常数3不来自常数ROM,而来自特殊晶体管,设置有效数字的高两位;这通常用于提供NaN。(如果隐式指数为1,这对应3。)减去平方得到分子。分母方面,角度右移(即除以2)再加自身。这执行乘以3(技术上乘1.5,但把隐式指数增到1就变成3)。用分子除以分母会很昂贵;相反,分子和分母作为后续CORDIC步骤的初始Y和X值。
CORDIC伪乘法
接下来是CORDIC循环,对向量应用旋转(#1100)。旋转按第一步计算的反序应用:最小的旋转先做,以保持精度。位从移位寄存器移出,指示是否应用旋转。移位寄存器全为零时循环停止。换句话说,较小的角度只循环几次,不是完整的16次。
旋转通过移位和加(或减)应用,但跟踪隐式指数有点棘手。由于向量起始几乎水平,X值约3,Y值约2^-16。向量旋转时,X保持约3,但Y可能每次增大一倍。为给每个数最大精度,X(tmpB)的指数为1,而Y(tmpC)的指数从-14开始,循环每轮加1(因为Y右移)。(记住这些指数不存储在任何地方,而是隐含的。)由于两个寄存器的(隐式)指数不同,相加前必须移位。移位量并不直观。
CORDIC循环之后,代码最后部分(#1118)规格化X和Y值,生成指令返回的浮点值。此时它们还不是"真正"的浮点数,所以可能需要调整。具体说,如果X没有前导1,左移一位;如果Y有两位前导数字,右移一位。无论哪种情况,指数相应调整。X和Y值入栈(#1132),完成指令。
结论
FPTAN在8087指令中算慢的,因为复杂。文档说典型450个时钟周期。(时间范围很大;取决于值,可能30到540个时钟周期。)对我检查的值(0.95),33%时间在CORDIC伪除法,15%在有理多项式(主要是平方操作),47%在CORDIC伪乘法,5%开销。
CORDIC是计算三角函数的流行方法,但也有多项式等替代。8087不寻常,因为它结合了CORDIC和有理多项式。Pentium上,Intel从CORDIC转向多项式近似;Pentium的快速乘法电路让多项式变得实用。如今Intel有MKL(数学核心库)和SVML(短向量数学库)等库,提供针对Intel硬件高度优化的实现。这些库据说使用多项式近似,用并行指令(SIMD)提升性能,而不是专用硬件。有了这些库,x87操作和80位浮点大多过时了。
评论
社区一致赞叹早期底层硬件工程的精妙与创造力,无明显分歧,少数技术讨论聚焦于特定指令的兼容性设计细节。
赞叹早期硬件底层工程的精妙与工程师的创造力
- 多数读者欣赏这种揭示现代习以为常的低层技术如何诞生的深度解析,认为那个资源受限时代的工程师既聪明又富有创造力(较多人) > 在当今似乎不再看重专业知识的时代,看到这种对早期硅片级计算的逆向工程解析让人耳目一新(@jaygreco)
理解 8087 的 fptan 指令推入 1 的兼容性设计
- 有读者剖析了 fptan 指令往寄存器栈推入 1 的看似奇怪的行为,指出其实际是为了保持软件兼容(少数人) > 原本奇怪的 fptan 推入 1 的设计,现在明白了是为了让期望通过 y/x 获取正切的旧代码在新处理器上靠 y/1 继续工作(@cmovq)
有价值的补充
- Const-me 分享了自己基于 AVX 指令集实现双精度浮点向量正切计算的代码,作为现代向量化数学库对该历史特性的延续参考。