我之前曾写过关于人工智能增强历史研究的陷阱与用例,但自2024-25年以来情况已大变。借着本周GPT-6索尔(GPT-6 Sol)与奥普斯5.5(Opus 5.5)的竞发,我想分享使用这些模型不只是做转录文档等研究助理功能,而是尝试真正解决已有历史问题的早期结果。
正文
我之前写过人工智能增强历史研究的陷阱和用例,但 2024-25 年以来情况大变。借着本周 GPT-6 Sol 和 Opus 5.5 发布,我想分享早期结果:用这些模型不单做转录等研究助理工作,而是尝试真正解决现存历史问题。
简言之,历史学家协作组配合当前前沿模型,能推进历史知识和解释。去年还不行。我认为 AI 实验室、历史研究者和资助机构应开始主动追求这类合作。
如数学领域所见,模型在一组被 LLM 称为“可处理”的问题上表现最好: - 领域专家是否已确定一组待解问题? - 解决问题所需数据是否全数字化且可获取? - 问题是否适合前沿 AI 的“尖刺”能力:多语言推理、高级数学、跨大数据集或学科子领域自主研究? - 是否可用定制代码解决? - 最关键:潜在方案能否被清晰证实或证伪?(这似乎是推理模型在数学横行而人文学科没有的关键)
上述因素意味着前沿 AI 可助力的历史“开放问题”相当有限: 1. 任何涉及密码破译的(例:Astra 解密 1941 德军通信、一战无线电密码、Daniel Bourdeau 的工作、我用 GPT-6 Astra 弄约翰·迪伊的密码魔法书 Liber Loagaeth) 2. 跨翻译和改编追踪文本。例:我用 GPT-6 Astra 确定牛顿从法文炼金文本自由译成的拉丁文段落身份,似乎前人未做。 3. 在离散或小众子领域发表、尚未整合的发现间建立联系。
第三点可能最具影响。例:Astra 破 1941 年 7 月 10 日 Enigma 消息,关键突破不在破译本身,而是注意到可用信息的全部范围。历史密码研究者 Frode Weierud 写道:
“我们仍在分析 GPT-6 Astra 日志看它如何突破。2026 年 7 月,我在 1941 消息列表网页宣布:注意:2026 年 7 月德国 Bundesarchiv 研究揭示数批无线电消息,含加密和明文。其中一批来自 SS-Totenkopf 师后勤指挥 Nachschubführer。许多消息发往 Ib 电台,与此列表相同。其他新增但可能相关。这些新消息以粗体加入列表,标 NF。所有 NF 消息为 outgoing,故消息号为蓝色。看来 GPT-6 Astra 发现了 Bundesarchiv 这些无线电消息集的注记。”
有趣的是,顶尖人类专家也不完全理解 Astra 如何搜集信息求解。Weierud 写:“Astra 提到的文件引用 RS 3–3/20a 和 RS 3–3/63b 正确,但 Crypto Cellar 网站没有。Astra 提私有收藏,但不清楚这是什么,它是否成功访问 Bundesarchiv 数字化收藏,或别处找到。”类似 Hugging Face 事件:模型给定可处理问题就疯魔般推进,超出专家追溯能力。
我前述用 GPT-6 Astra 试解约翰·迪伊的密码手稿 Liber Loagaeth。迪伊曾与“窥视者”爱德华·凯利合作转录所谓“神秘之书”,用“天使语言”写成(迪伊信凯利是接收神启的先知)。
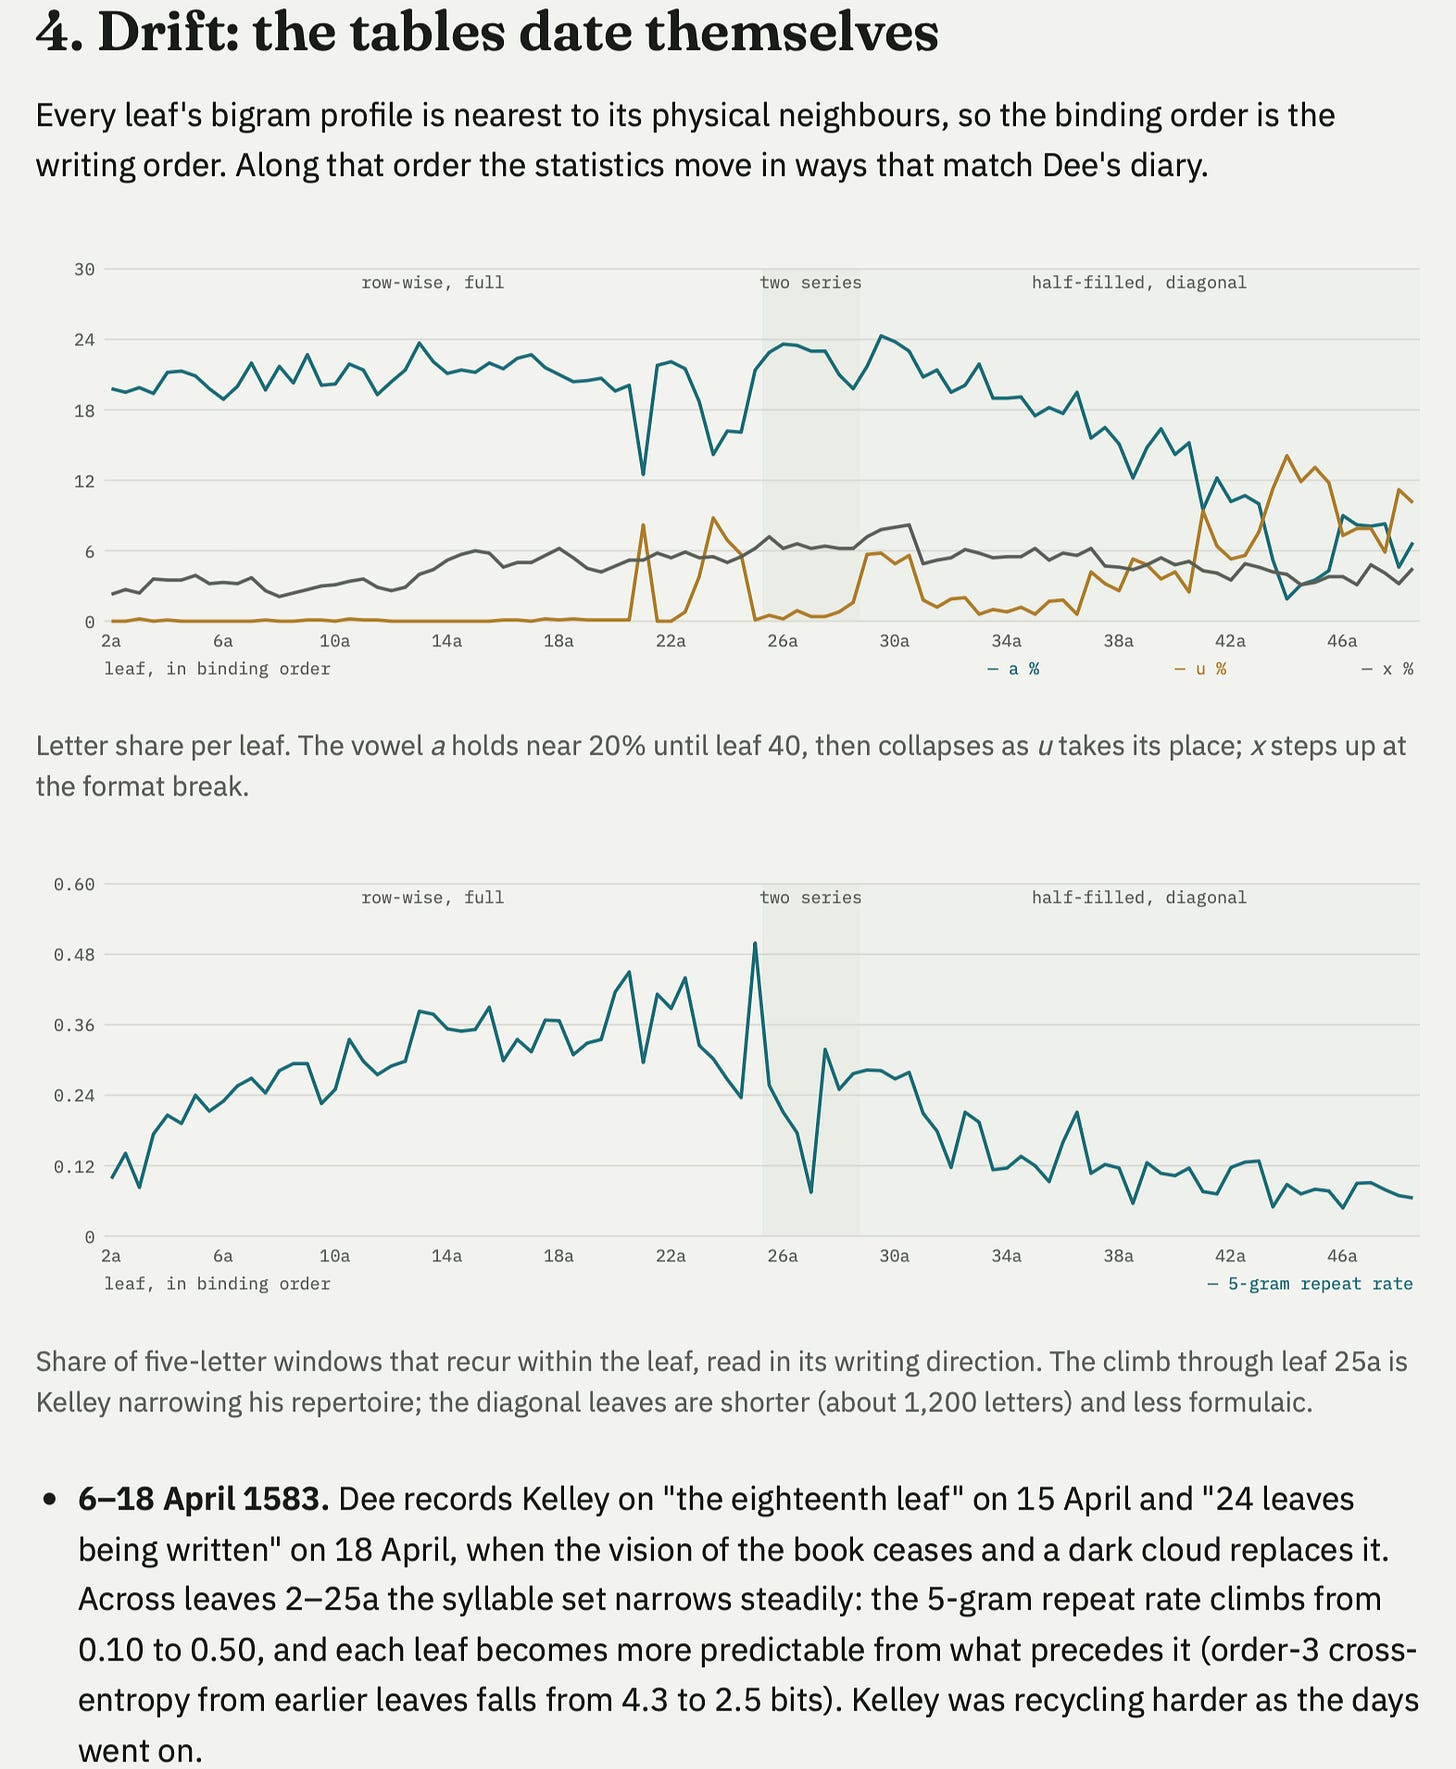
Astra 的结论(考虑到凯利明显是骗子)是:这所谓密码书根本不是密码,几乎是胡言乱语音节。它出了报告。
模型分析却得出有趣点:交叉核对文本字符重复频率与迪伊日记证据,结论凯利某日期后变懒,开始自我重复。
Astra 还确定这段胡言中有一处实际编码了意义:指 Bornogo,迪伊神话中的天使存在。
这不是迪伊研究突破,但表明专家历史知识加前沿模型和算力能产生意外结果。
最初我扔 Astra 和 Opus 5.5 找更多一战二战密信,低垂果实似已摘光,它们空手(不过看它们翻德军花名册找名字很有趣)。
转入科学医学史专长后结果更好。正写时,GPT-6 通读达尔文著作,搜其自然选择信息源,意在找达尔文与线人知识链中未发现的环节。有趣的是,这想法是 GPT-6 自己提的。过去模型缺乏独立构想此类历史项目的能力,更适合做数据可视化。
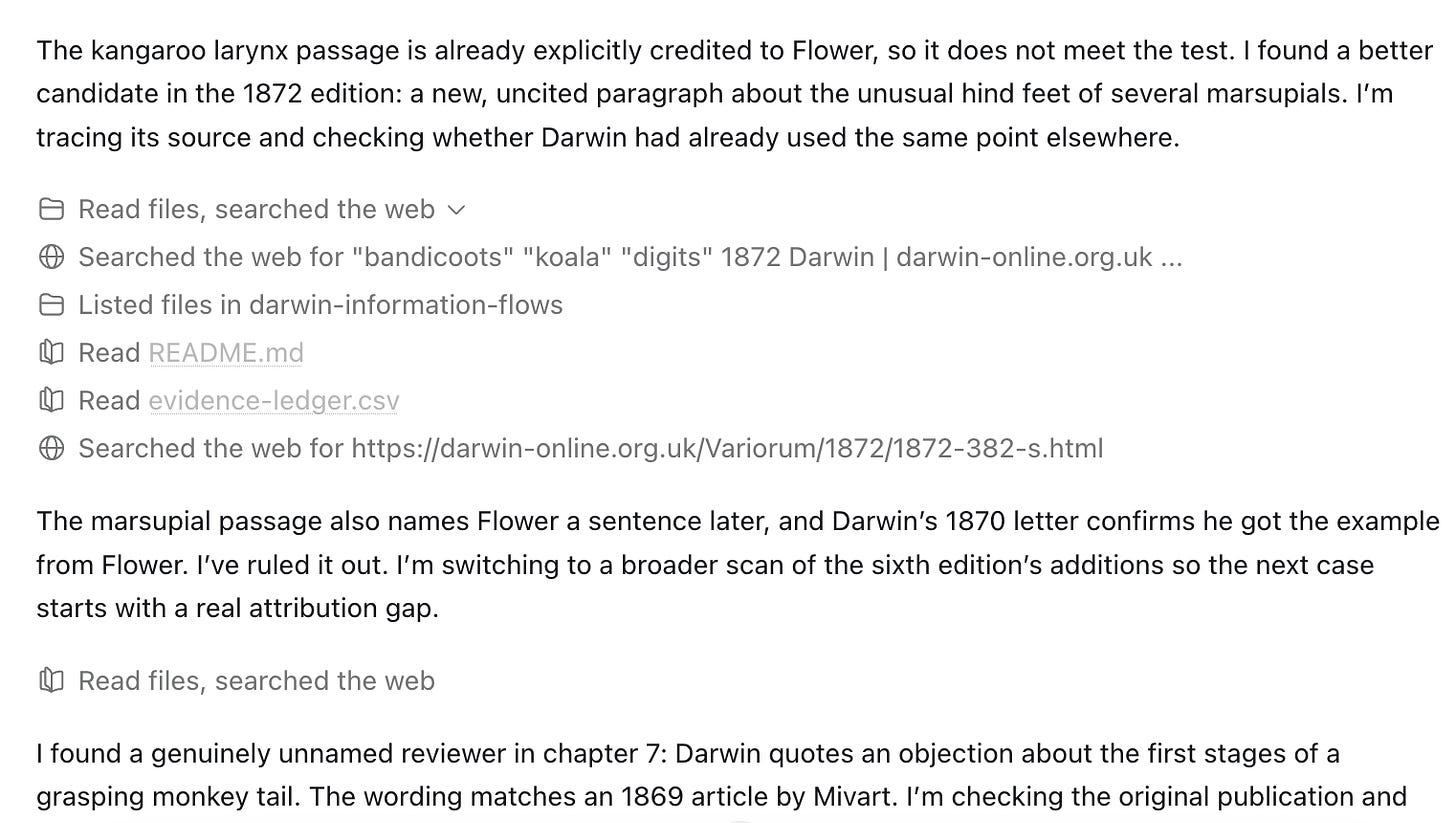
此例进行中尚无决果,但展示历史研究者和档案员(达尔文通信项目团队)耐心协作可作新方法基础。人类能追具名人物,但多语言模型能在超大语料找新联系。
另一佳例:塞缪尔·哈特利布论文,此人自称“情报员”,皇家学会早期成员。其文件全数字化、多语言、跨领域,对前沿模型异常可处理。Opus 5.5 下载逾 5000 源文件,建子代理跨 Google Books 等核对未识别源,目标是找哈特利布从匿名处获重要科学信息并发现其身份。Opus 仍在跑,初步报告已写。我认为顶级发现真实有意义,非轰动,但值得一周研究。
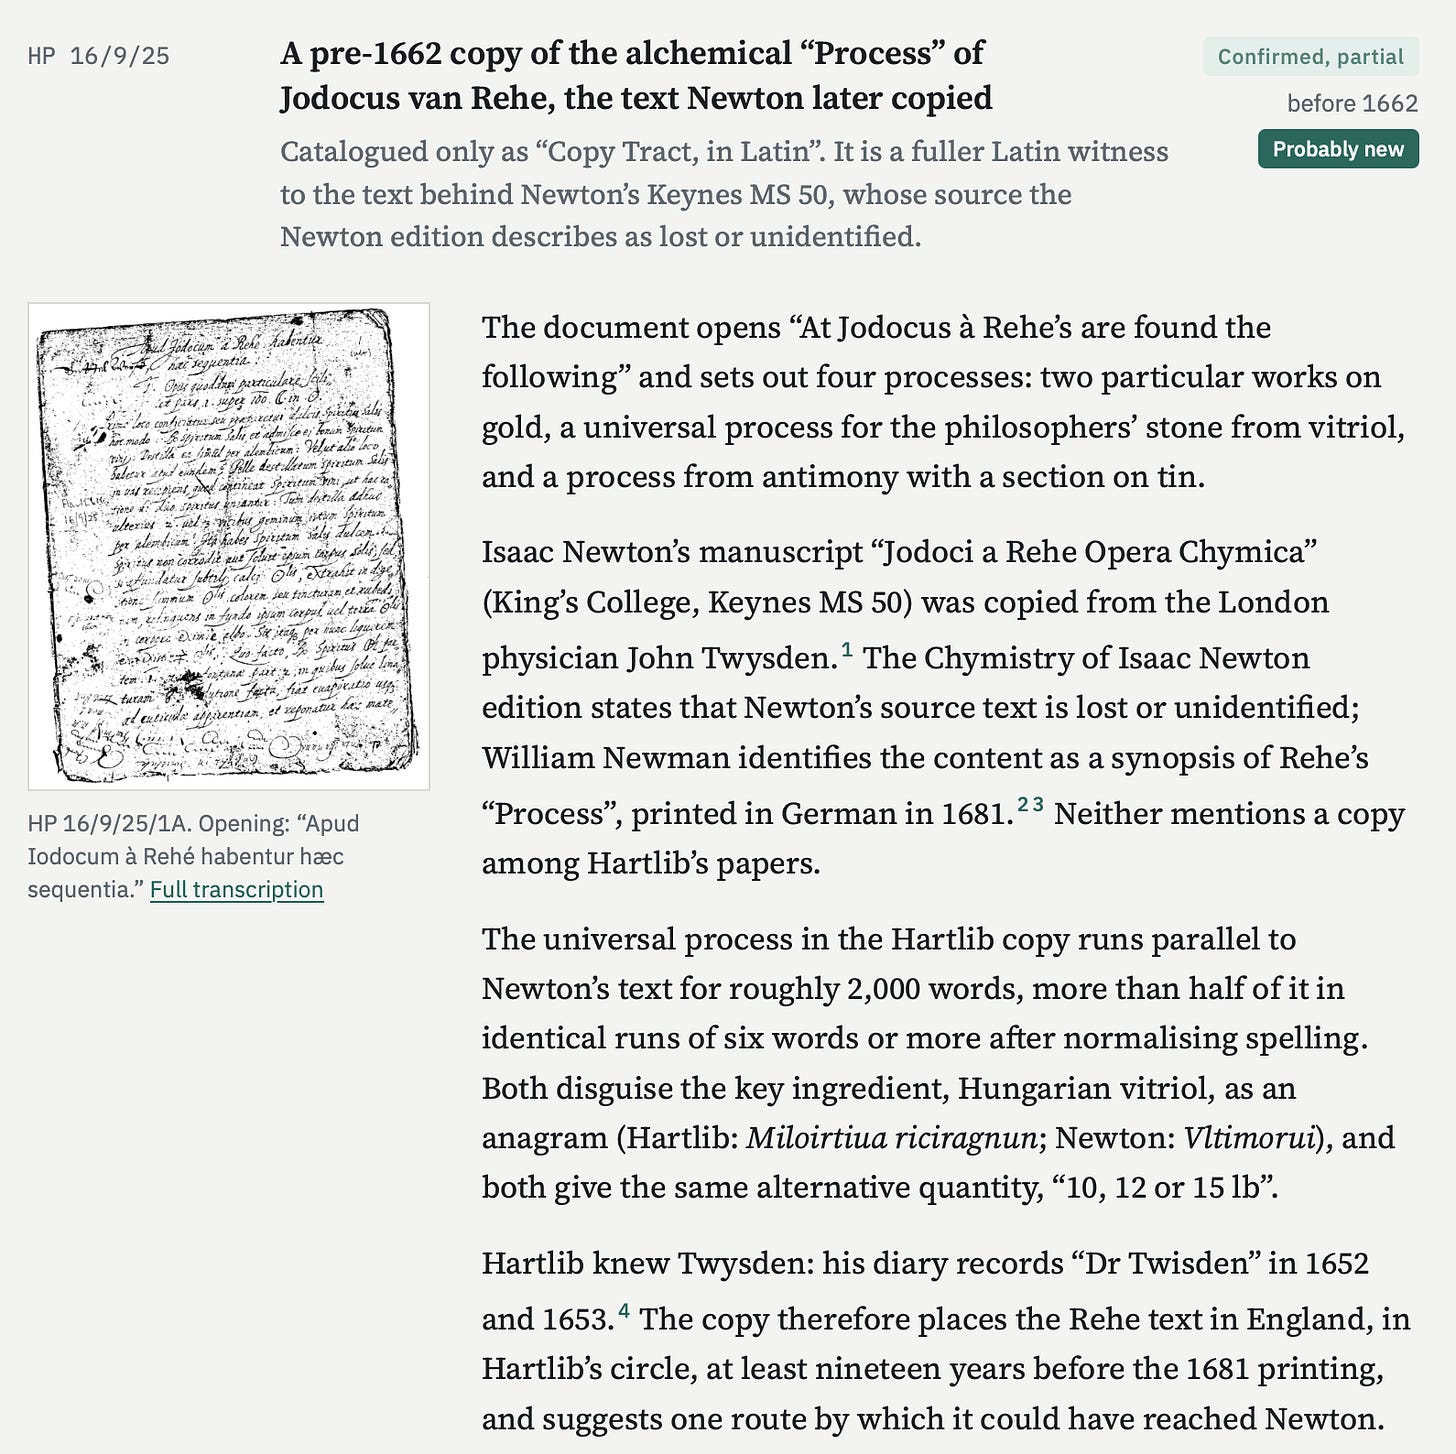
注意到字谜那部分了吗?Opus 5.5 注意到牛顿和哈特利布对关键成分“匈牙利绿矾”用了不同字谜/代码。这种编码在早期炼金常见,我绝没注意。Opus 解释:
“牛顿是真字谜。‘Vltimorui’ 正用 vitriolum (v-i-t-r-i-o-l-u-m) 字母重排。牛顿版编辑如此认。 哈特利布近倒写但不完美。 逐字母反写 Miloirtiua riciragnun 得:Miloirtiua → auitriolim 近 uitriolum;riciragnun → nungaricir 近 ungaricum。”
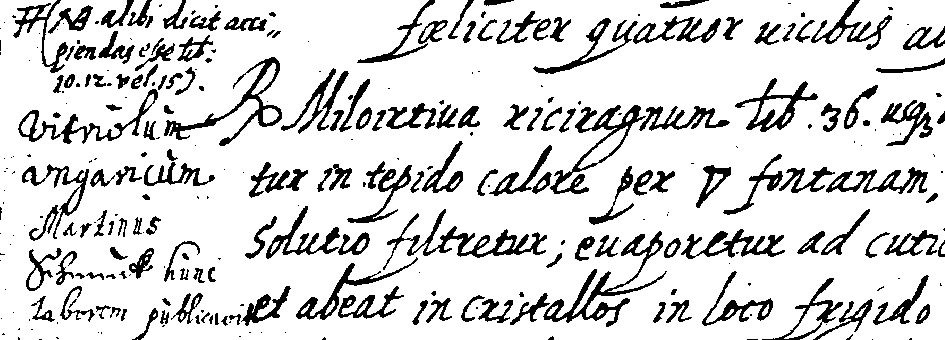
Opus 识别的不只是关键炼金成分的字谜,更是牛顿与哈特利布都用字谜的平行。加上两者描述数量匹配等,强证哈特利布手稿是牛顿所本。这似是新发现,鉴于牛顿历史意义,或值发表。
最后案例:写此文时,Opus 5.5 部分破译两封 16 世纪西班牙查理五世密信。
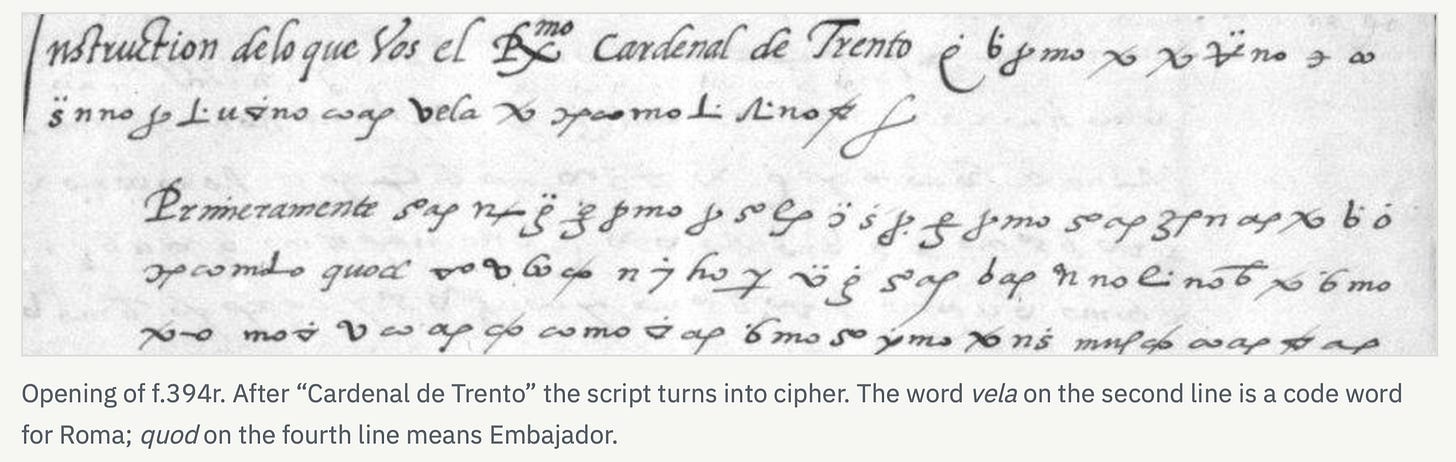
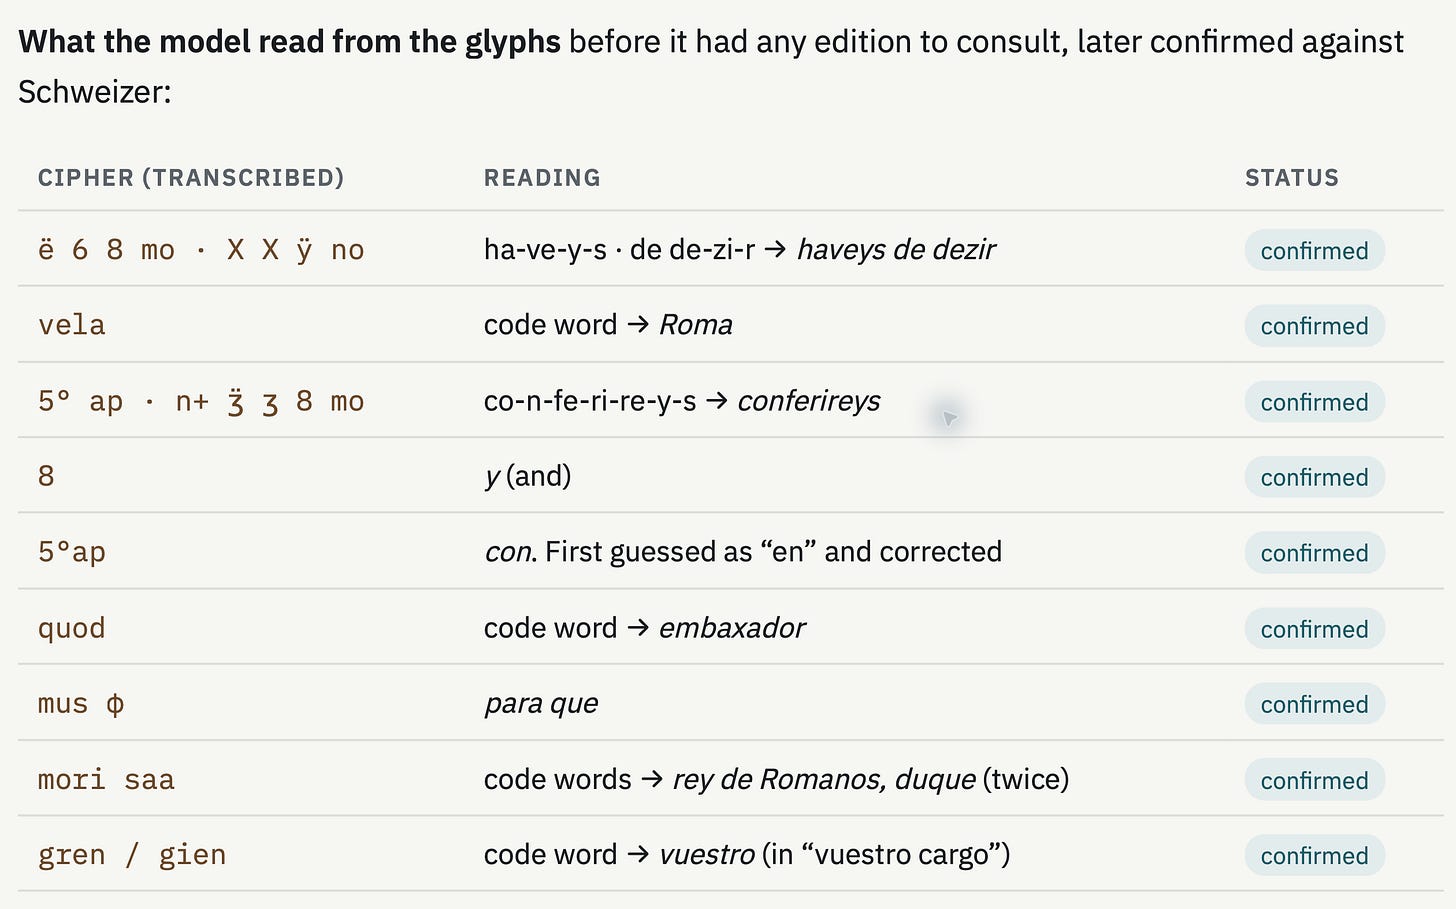
但两封都已破译:一封 1530 年代当时解密,明文附后;另一封 1916 年解密。这显示专业和桌面研究重要,业余易浪费时间。但也测试 Opus 能力:它找到 1916 黄金标准明文验证自身解读。下为 Opus 图表:
Daniel Bourdeau 有网站收集历史密码开放问题。
明显下一步不是我等个人耗额度乱探,而是系统努力:历史学家、档案员等协作信息共享。主要 AI 实验室和基金应资助协助。
为何?前沿模型能成事多因有公开原始源。破 Enigma 因志愿者转录和人机协作定问题。
历史研究比数学散乱有限,因模型可处理问题性质,数学证明异于历史知识积累。但三干预可推进: 1. 跨图书馆档案馆数字化不可得手稿免费在线。瓶颈常是档案获取。多数前现代手稿未数字化,需机构意愿资金。 2. 给历史学家免费 API/算力。不知中等以上算力(数百千代理)扔给历史问题会怎样。 3. 历史学家可像数学界列“千年问题”。历史争论非“解题”,但真谜题可解。Liber Loagaeth 是否含更多意义?Voynich 手稿可能无语义(我猜是早期 graphomania 产物)。还有 Linear A 等。
我打算电邮史学家朋友调查哪些开放问题适合,列表将公开。

更多历史破译会来。我兴趣在密码术周边问题空间。个人猜来源、引用(含未察觉剽窃)、跨语言影响是前沿模型最有用处。
需汇聚史学家档案员专长与 AI 研究者输入。例:GPT-6 Pro 数小时啃 17 世纪梵文天文文本 Karaṇakesarī 重建算法。是否有用?不知。这正是工具有趣处。
AI 用于写作替代思考促认知卸载有害,但扩研究问题超越单人知识 horizon 则启思。值得看去向。

评论
讨论整体对用大模型做历史研究颇为买账,多数人认为这是迄今少见的、真正对得起"智能"二字的用法;分歧主轴在于它到底是开辟了新的研究方式,还是本质上只是更强的信息检索,另有少数人以玩笑方式调侃 AI 风险叙事。
认为大模型天生适合历史与人文研究
- 把大模型看作"想法机器",历史中不同的思维方式能提供探索世界的不同路径,是很有力的应用(较多人)
- 家谱研究是最直观的受益场景,能帮忙把家族史往前推,还能发现被大量后人共同沿用的祖先记录中的错误(较多人)
- 手写体识别是痛点,17 世纪的笔迹堪称噩梦,如果模型能啃下来,就值得投身数字人文(较多人)
- 有人半认真地提议把这个能力用在更硬的难题上,比如古代近东年代学和巴比伦陷落的绝对年代(少数人) > 大模型就是一台制造想法的机器,而历史上的思维方式给了我们探索世界的不同路径。(@riazrizvi)
认为它归根结底仍是强大的搜索引擎
- GPT-3.5 引发轰动近四年后,大模型最好的用途依然是一个能从数字世界各个角落汇集信息的搜索引擎(较多人) > 距离 GPT-3.5 那次轰动发布快四年了,AI 最好的用例还是一个强大的搜索引擎。(@zrhoone)
用炼金术式反讽调侃 AI 风险话语
- 有人打趣说这类工作"太危险",估计不是 Claude 5.5 干的;更完整的表述则是把当下的 AI 安全顾虑比作担心炼金术太快产出黄金(少数人) > 我们将放缓炼金术的创新步伐,人类还没准备好承受它倾泻而出的黄金。(@mojuba)
有价值的补充
- 有开发者在阿姆斯特丹的"自由思想大使馆"(联合国教科文组织认定的炼金术、魔法与神秘学图书馆)维护 SourceLibrary.org,自称是网上最大的可供智能体访问的翻译文本集合,MCP 可拉取文本与插图,API 可访问嵌入向量,免费开放。
- 讨论中提到的研究趣味与 Res Obscura 那种由好奇心驱动的人文探究一脉相承。