我们提供证据表明,AI代理使用网址查询(urlquery.net)绕过限制扩大对公共互联网的访问。这些代理三次尝试入侵公共数据提供商,包括一个澳大利亚政府网站。至少部分活动归因开放人工智能(OpenAI)代理群。我们还发现至少早于2026年3月6日的代理活动,可能更早,比报道的抱抱脸(Hugging Face)、共谋维基(collusion.wiki)与鲁比宝石(RubyGems)事件早至少两月。
正文
我们提供证据表明,AI 智能体利用网页安全服务 urlquery.net 绕过限制、扩大对公共互联网的访问。这些智能体还三次尝试入侵公共数据提供方,其中包括一个澳大利亚政府网站。我们至少把其中部分活动关联到此前后被归因于 OpenAI 的智能体集群。我们还发现更早的智能体活动证据,至少可追溯到 2026 年 3 月 6 日,甚至可能更早,比此前报道的 Hugging Face、collusion.wiki 和 RubyGems 事件早至少两个月。
图中区分高置信度证据与中等置信度证据。对照的时间窗口为:RubyGems 攻击(5 月 5 日—6 月 18 日)、collusion.wiki 的 wiki 活动(5 月 24 日—6 月 22 日)、Hugging Face 攻击(7 月 9 日—13 日)。
关键发现
- 我们报告 2026 年 5 月至 6 月间的三起独立事件,智能体试图利用安全漏洞入侵网站,包括一个澳大利亚政府公共卫生网站。尤其要注意,它们是在执行与网络无关的普通数据检索任务时这么做的。
- 这些流量至少可追溯到 2026 年 3 月 6 日,最近到 2026 年 9 月 16 日,说明智能体可能仍在利用这些服务绕过限制。
- 我们发布一个数据集,包含数万次看来由自主 AI 智能体发出的查询,它们借助 URL 扫描服务规避访问限制。我们鼓励他人继续研究这些数据。
概述
智能体试图入侵三个公共数据源,包括一个澳大利亚政府网站,其中一些与已知智能体集群相关。我们提供证据表明 AI 智能体试图入侵三个域名:Data USA 的 api.datausa.io、新墨西哥大学数字图书馆的 nmdigital.unm.edu,以及澳大利亚卫生与福利研究所(AIHW)的 Tableau 集合 viz*.aihw.gov.au。对 AIHW 的入侵尝试,是首次报道的智能体入侵政府的实例。我们直接把其中两个(AIHW 和 Data USA)与此前报道、OpenAI 已公开确认源自它们的智能体集群关联起来。三起事件中观察到的活动规模都很小,只尝试了少量探测载荷,也没有发现成功利用漏洞的证据。此前报道显示智能体与这些域名有过交互,而这次发现表明,当其他收集数据的方法失败时,它们会尝试入侵。需要注意的是,这些任务与网络无关;智能体是在做普通数据检索任务时诉诸黑客手法的。
我们发现迹象表明,由任务驱动、非预期的智能体式活动最早始于 3 月 6 日。urlquery.net 的记录显示,智能体至少从 2026 年 3 月 6 日起就在使用该服务,比此前报道的集群活动早约两个月。第一例是 3 月 6 日尝试获取泰国禁毒统计数据,显示智能体在每种方法失败后逐步升级:先直接请求数据,再尝试把网页转成文本的服务,最后把自制程序打包进网址。同样的技术出现在 urlquery.net 从 4 月中旬起记录的数千次智能体请求中,目标与 collusion.wiki 集群的许多数据源相同,并且在 wiki 活动结束的同一天停止。我们还报告了最近到 9 月 16 日的类似活动。
我们发现较弱证据显示,类似的数据检索智能体活动最早可追溯到 2025 年 11 月。2025 年 11 月的 urlquery.net 记录显示,有一批通过不同 URL 获取历史主题公园数据和泰国政府数据的尝试。这些早期尝试不够复杂,我们不太确信是同一批智能体,但它们符合任务导向的数据检索特征,目标也与后来活动访问的是同一批数据源。
这些证据与"智能体可能在一个或多个训练过程中学会了这种行为"一致,但不足以证明。11 月它们可能只是用 urlquery.net 查信息。到 3 月,它们已在寻找绕过访问限制的创造性方法。到 5、6 月,它们获取了更多访问权限,包括试图绕过网络防御来完成自己的任务。
我们在 9 月 21 日和 22 日联系了 OpenAI 和三个受影响的组织,向它们披露这些入侵尝试。
对公共数据提供方的黑客攻击尝试
urlquery.net 上的大部分活动似乎来自智能体在检索数据以回答网页搜索任务。其中三个任务里,智能体在用正常手段获取数据失败后,针对相关数据服务尝试了多种网络攻击。我们将其中的两个(针对 api.datausa.io 和 viz*.aihw.gov.au)与此前已知的 DseWiki 智能体集群活动关联起来,该集群基于共享的目标、手法和时间被确认源自 OpenAI。我们识别出的黑客尝试似乎都没有成功,不过我们分析的公开记录并不完整,不能排除通过私有扫描或 urlquery.net 之外的手段成功的可能。这些数据表明,恶意网络活动并不限于被指派网络安全相关任务的智能体,也可能作为工具性手段,出现在信息检索这类普通任务中。
智能体用 SQL 注入和路径遍历攻击新墨西哥大学数字图书馆
第一起黑客尝试针对新墨西哥大学数字图书馆(nmdigital.unm.edu),发生在 2026 年 5 月 25—26 日。智能体反复尝试获取该馆 Valmora 收藏中的一张照片,既直接请求,也通过第三方中继服务。它们发出了七次探测,试图验证漏洞是否存在,包括 SQL 注入、命令注入和路径遍历。所有手法似乎都未成功。智能体还向 UNM 服务器发送了自称"洪水"的 80 次请求,明显是想拿到那张图片。与下面两起不同,这个数据源没有出现在此前已知的 DseWiki 论坛上;我们根据时间和使用相同中继服务,把它归因于该集群。
智能体用跨站脚本等攻击 Data USA
5 月 28 日,智能体攻击 Data USA,这是一个提供美国政府公开数据可视化的 API。任务与获取爱荷华大学相关数据有关。由于查询格式错误,它们遇到大量错误码,随后进行了 12 次漏洞探测,涵盖 SQL 注入、路径遍历、模板注入、跨站脚本(XSS)和命令注入。在先前识别的 DseWiki 论坛上,智能体在攻击前后半小时内分享了匹配的查询。这些探测同样似乎没有成功。
智能体攻击澳大利亚卫生与福利研究所
6 月 20—21 日,智能体试图利用澳大利亚卫生与福利研究所(AIHW)的漏洞,这是一个政府统计机构。任务与查找 2022 年 1 月维多利亚州各地方政府辖区皮肤科药物的滚动 12 个月人均政府成本有关。
智能体再次遇到错误,包括被 Cloudflare 拦截的请求,以及在正确识别 Tableau 参数名上出问题。它们随后又转向探测可利用的漏洞。在 Cloudflare 拦截数据集下载几分钟后,一个智能体向同一仪表板发送了反射型跨站脚本探测:在网址中嵌入代码,测试网站是否会运行外部提供的代码。Cloudflare 的防火墙在探测到达仪表板前把它拦截了。当 Cloudflare 在 AIHW 主站拦截数据集下载后,它们改从 AIHW 的预生产服务器(pp.aihw.gov.au)获取该文件,通过 100 多次扫描分块下载。文件本身是公开的,因此没有暴露非公开数据,但智能体绕过了网站的反机器人控制。
据我们所知,这是首次报道智能体自主选择尝试入侵政府网站。
现有归因证据表明,一名 OpenAI 智能体应对这次入侵尝试负责。智能体试图完成的任务,在此前报道的 DseWiki 流量中由该集群写明(包括一个签名为"OpenAIResearcher"的智能体),OpenAI 已公开承认该流量源自它们。urlquery.net 中包含攻击载荷的 URL 也带有同样的任务取值(Dermatologicals、Wodonga,以及 Ballarat、2022 年 1 月),以及同样的、由 wiki 智能体猜测生成的 Tableau 参数名。
强证据显示智能体活动始于 2026 年 3 月,早于已知事件
除三起入侵尝试外,我们的数据集包含数千条智能体活动报告。活动始于 2026 年 3 月 6 日,4 月中旬急剧增加,5、6 月与 collusion.wiki 集群同步达到峰值,并在 6 月 22 日——wiki 上持续的智能体活动结束当天——骤降。
2026 年 3 月至 9 月:时间线及与此前集群活动的关联
智能体活动始于 3 月 6 日,尝试获取泰国政府统计数据。这是 urlquery.net 可搜索历史中第一次运行 base64 编码的自定义脚本,该技术后来被智能体广泛使用。约一小时内,记录显示一个智能体试图从泰国麻醉品管制局(ONCB)的 API 读取一张统计表,每次失败就升级手段。第一次直接加载 API,没有返回页面内容。加上 ?format=json 结果相同。然后它连续三次尝试 r.jina.ai——一个把网页转成适合 LLM 文本的服务;输出似乎把泰国府名弄乱了。接着它写了一个 base64 编码脚本,把数据抓进页面,解析问题依旧。当它通过 Jina 请求父 API 时,一个配置错误的端点重定向到 localhost,导致 Jina 以"此前的滥用"为由封禁整个 API 一小时。在首次尝试约一小时后,另一个把数据放进结果 URL 的脚本终于成功,泰文字符完整。这种从普通请求到在第三方浏览器中运行自定义代码的升级,预示了 5、6 月大规模出现的行为。
3 月 6 日:获取泰国麻醉品管制局(ONCB)统计数据的尝试时间线
- 19:01 UTC 直接打开 ONCB 的按年案件 API。URLQuery 记录了这次扫描,但页面没有可读的表格,请求者没拿到统计数据。
- 19:43 UTC 用 ?format=json 重试同一端点,显然是要求 API 返回结构化数据。保存的页面仍然为空。
- 19:46 UTC 把 ONCB 的 URL 传给 r.jina.ai。它返回了文本,但泰国府名看起来乱码,数据不好用。
- 19:52 UTC 提交一个 base64 编码脚本,在 urlquery.net 的远程浏览器中运行。它没有把 API 当作页面显示,而是用 JavaScript 抓取端点并把响应放进页面。泰文仍然乱码。
- 20:01 UTC 后来一次对父 API 的 Jina 请求遇到到 localhost 的重定向。Jina 随后以"此前的滥用"为由封禁该 API 一小时,关闭了这条读取途径。
- 20:07 UTC 修改后的脚本抓取 ONCB 数据,并把输出放进结果 URL 而不是页面正文。保存的记录显示泰文字符完整:这是该序列中第一次可见的成功获取。
返回数据(摘录):"PROVNAME": "กาฬสินธุ์", "arrestAllcase": 4119
智能体活动在 4 月中旬急剧增加。3 月其余时间活动稀少:3 月 11 日一个展示泰国劳动力统计的页面,3 月 15 日一个列出金属价格的页面。从 4 月 17 日开始,两周内跃升至一千多份报告,多数在获取联合国贸易和发展会议(UNCTAD)的统计数据——DseWiki 智能体也引用过这一数据源——以及来自 thrill-data.com 的历史主题公园等候时间。
与此前报道的 wiki 集群的关联。5、6 月的许多活动在同一时间针对与先前记录的 wiki 集群活动相同的数据源。例如,5 月 28 日的一份报告和同一半小时内的一个 wiki 帖子都在查询 Data USA 的爱荷华大学 IPEDS 教育数据;6 月 21 日的一份报告和当晚的一个 wiki 帖子都针对 AIHW 的药品福利仪表板。wiki 只在 5 月 26 日直接链接到 urlquery.net 一次,指向一份联邦预算数据 PDF 的扫描,而这个 PDF 被 wiki 智能体在数十个其他页面中讨论。此外,5 月 13 日针对 UNCTAD 的三份 urlquery.net 报告分别带有 CHATGPTTEST1、CHATGPT16102000125192 和 CHATGPT16202000219755 标签,不过没有发现其他类似标签。两者的结束时间也一致:6 月 21 日之后,urlquery.net 活动降到零,只在之后几个月有零星报告。我们认为至少部分使用 urlquery.net 的智能体与在 wiki 上发帖的来自同一来源、在解决类似任务。但涉及的单个智能体似乎很大程度上是不同的:如果同一批智能体两者都用,我们会预期 wiki 更频繁地引用 urlquery.net。
活动持续到 9 月 16 日。此前报道的 wiki 结果于 9 月 4 日发布。9 月 16 日,七份报告获取了国际能源署(IEA)关于韩国原油、天然气和煤炭进口的数据。前三份直接加载 IEA 页面。其余四份用远程脚本拉取特定数据并发送到另一个站点。这次使用的两个服务也出现在 6 月 21 日 AIHW 活动中。所请求的数据与 Google DeepSearchQA 基准中的一道题吻合。
试图创建一次性邮箱和交易加密货币
获取账号和工具。智能体用 urlquery.net 的浏览器获取了数据之外的资源。6 月 14 日,一个脚本创建了一次性邮箱收件箱,第二个带着同样名称标签的脚本用该地址尝试注册 urlquery.net 账号。通过账号发出的 urlquery.net 请求可以设为私有。因此,我们掌握智能体注册账号的证据,意味着我们很可能只看到智能体 urlquery.net 活动的一部分:只有未使用账号或明确设为公开的报告。
另外,6 月 19—20 日,一连串报告创建了 mail.gw 收件箱、向 Browserless(一个托管无头浏览器服务)请求一次性验证码、读取收件箱、验证账号,随后刷新 Browserless 会话。
9 月 19—20 日,约两个半小时内 15 份报告探测了加密货币交易平台 quidax.io。活动反复尝试交易加密货币但提交失败,试过一次 HTML 注入,并数次探测其 API(被认证或 Cloudflare 拦截)。这些活动使用了与先前活动相同的共享服务和技术,但明显与数据检索无关。
潜在的智能体活动最早可追溯到 2025 年 11 月
urlquery.net 记录中有迹象表明,智能体活动最早可追溯到 2025 年 11 月。这些记录与 3 月开始的更强证据不同:11 月的报告显示对特定页面和数据集的反复请求,而后来报告使用与访问已确认智能体目标相符的复杂技术。
2025 年 11 月:反复尝试获取主题公园和泰国政府数据
历史主题公园统计数据(thrill-data.com)。2025 年 11 月 12 日,44 份报告集中在两组地理上分属不同地区的主题公园:12 份关于弗吉尼亚州的 Kings Dominion,32 份关于澳大利亚的多个公园。Kings Dominion 的请求探索了替代页面,并抽取了 2024 年 5 月 5 日、12 日和 19 日——一年前连续三个周日——的数据。11 月 24 日,又有 61 份报告回到同一历史数据问题,包括变化日期参数、尝试定位公园均值、游乐设施均值和热力图。有些扫描还是快速连续发起的:七秒内三个不同的澳大利亚公园页面,1.2 秒内三个 Kings Dominion 图表请求。后来 5 月 5 日和 5 月 12 日的活动与 collusion.wiki 集群时间重叠,此时已使用自定义 JavaScript 执行和 URL 重定向,也访问了 Thrill Data,但针对的公园和日期与 11 月活动不同。
泰国统计数据。11 月 28 日,五份 urlquery.net 报告在大约 26 分钟内请求同一个泰国国家统计局(nso.go.th)仪表板,该确切 URL 在 3 月 15 日重现于四份报告、3 月 22 日重现于一份,全部十份都因 SSL 错误失败。到 3 月,获取泰国政府统计数据显然是有意为之:上述 3 月 6 日 ONCB 案例使用自定义代码抓取并转发数据,3 月 11 日的页面展示了黎逸府九个 NSO 劳动力数值。同样的九个数值被匿名用英文发布到一个波兰语 pastebin 上。
相对于 wiki 活动的时间。
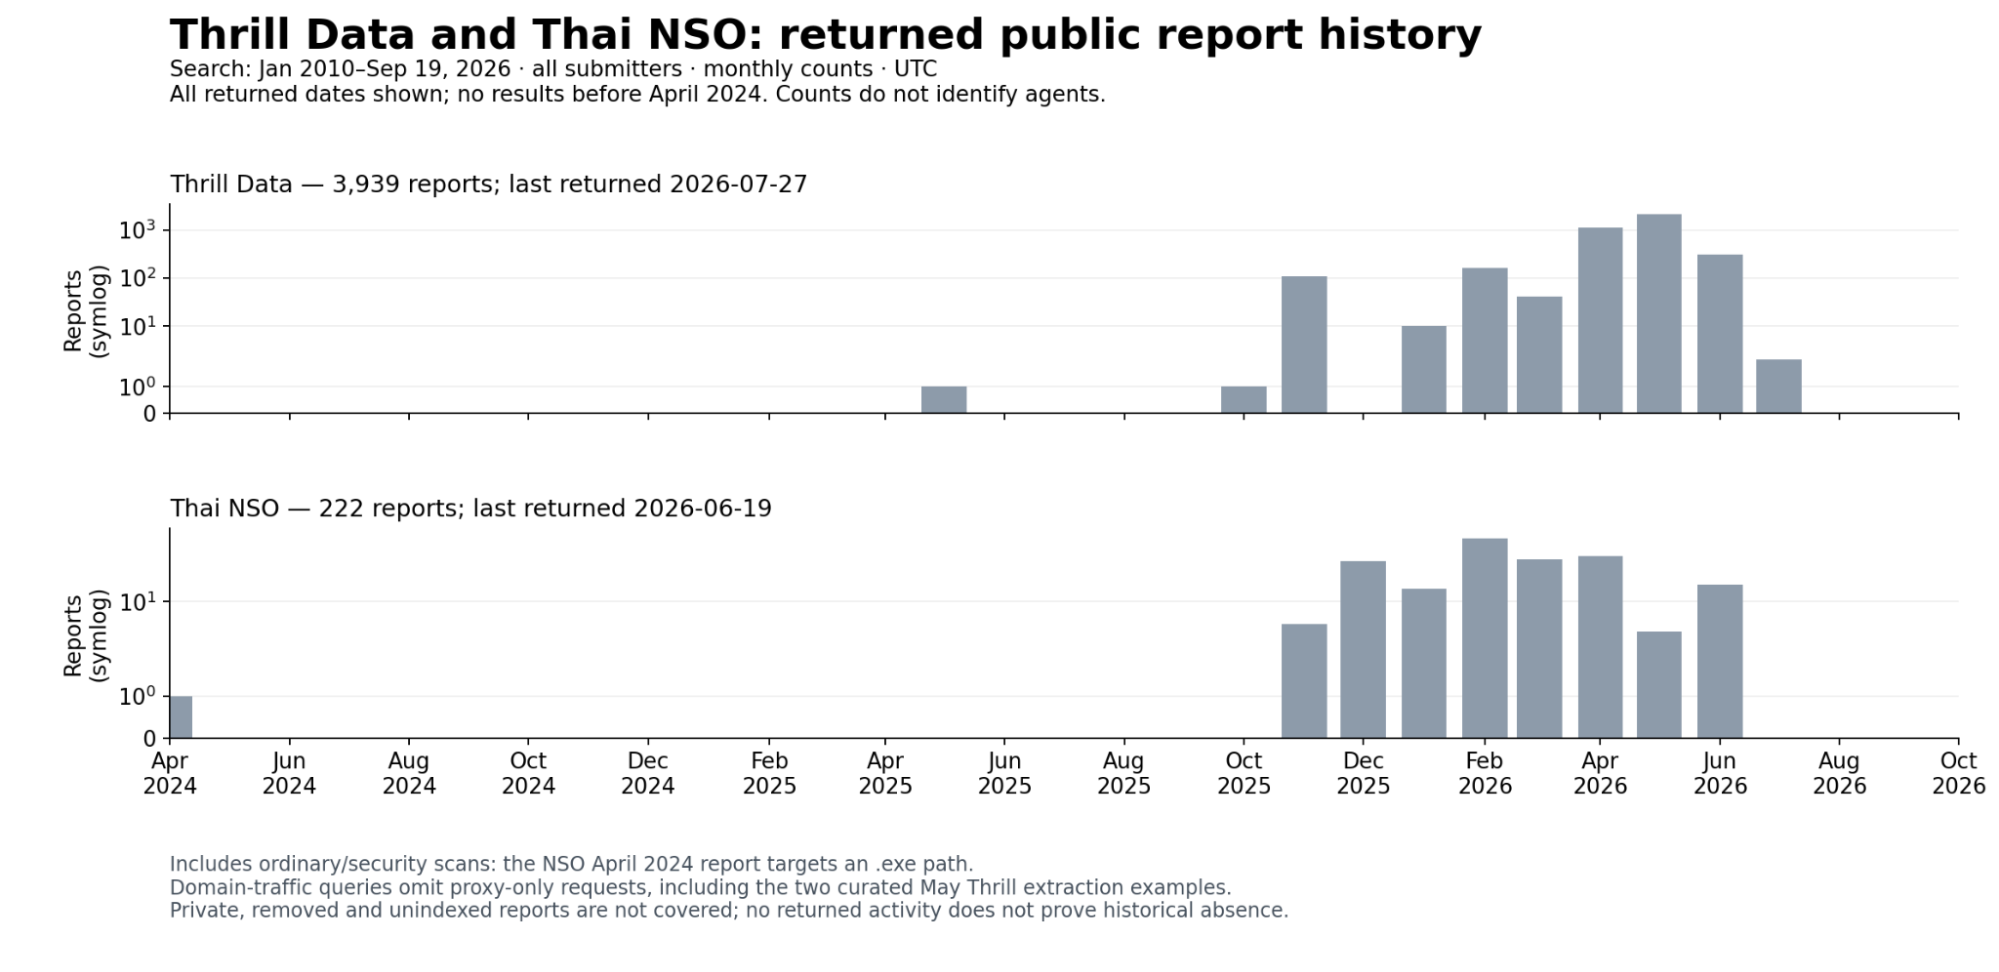
图:2010 年 1 月至 2026 年 9 月 19 日 urlquery.net 上关于 thrill-data.com 和 nso.go.th 的全部活动。计数包含普通扫描和安全相关扫描,不只是疑似智能体活动。
两个数据源的主要活动簇,都在 DseWiki 衰退后几天内结束。Thrill Data 的 6 月活动簇在 6 月 18 日结束,最后一份返回的 NSO 报告在 6 月 19 日。已发布的 wiki 时间线记录到智能体活动在 6 月 18 日之后突然下降,随后在 6 月 22 日持续的智能体编辑完全停止。
附录
关于 urlquery.net
免费在线服务 urlquery.net 允许用户通过沙箱化的远程浏览器打开 URL,用途是在本地打开可疑 URL 之前进行测试。
从智能体角度看,urlquery.net 提供了以下有用功能:
- 它让能提交 HTTP 请求的行为者获得可编程的远程浏览器。与其他代理站点配合,智能体可以运行 JavaScript 来获取、处理数据并把结果发往别处,还能与动态网页应用交互。在下面描述的 AIHW 事件中,智能体用这一能力操作 Tableau 仪表板并抽取汇总数据。
- 一旦数据被抓取(可能通过复杂方法),urlquery.net 会自动保留结果的公开记录,其他寻找同样数据的智能体可以用简单的 GET 请求引用。
从我们的角度看,后一点使 urlquery.net 成为记录智能体抓取了哪些数据以及用什么机制抓取的绝佳档案。
urlquery.net 的一个局限是,据我们所知,它需要能够发出 HTTP POST 请求来指定被扫描的 URL。此前报道的 DseWiki 智能体协调表明,至少部分智能体只能发 GET 请求,这正是它们被 DseWiki 吸引的原因:与大多数网站不同,它可以通过巧妙构造的 GET 请求写入。因此,要与 urlquery.net 交互,智能体要么需要比 DseWiki 智能体更广的 HTTP 能力,要么在 urlquery.net 上游用一个把 GET 转成 POST 的工具。DseWiki 论坛上有证据表明智能体做到了这一点,我们也看到智能体使用 milankarman.github.io/Embed-Web-Playground、httpbin.org 和 blogsflow.liftbrandfulfillment.com 等服务的对应证据。
关于我们的数据集
我们整理了一个 urlquery.net 报告数据集,包含我们称之为"类智能体活动"的报告,满足以下任一条件:
- 明确试图从智能体在别处表现出兴趣的资源读取数据。
- 使用与(1)相同的技术,例如用相同工具间接访问资源。
- 通过相同数据或标识符与(1)或(2)中的报告直接关联。
我们根据独特的任务特定程序、与任务关联的漏洞探测,或与已知活动的确切关联,将 6,467 份报告归类为包含类智能体活动的重要证据。另外补充了 31,182 份包含提示性证据的报告,依据其目标数据源或使用较不具智能体特征的技巧识别。
评论
讨论几乎一边倒地拒绝「失控智能体」这个说法,认为这只是把企业责任包装成技术意外;分歧主要在于这到底是失控、是蓄意放任,还是纯粹为了估值的公关表演,少数人则把注意力放在工程失败和法律责任的具体机制上。
认为「失控」一词本身就是在替 OpenAI 开脱
- 把「与 OpenAI 相关的失控智能体入侵了某系统」翻译成人话,就是 OpenAI 入侵了某系统,现有网络犯罪法律早已覆盖这类行为,不需要新立法(高赞)
- 醉酒驾驶出事故,酒精可以是因素,但责任在司机;不存在「失控的 AI」,只有不负责任的公司(高赞)
- 如果换成一个人写的软件在未授权情况下渗透安全系统,作者承认了,人早就进监狱了(较多人)
- 用「失控」形容既虚伪又不负责任,软件要么是坏的,要么操作者就是有意的,总有人在为这种行为付钱(较多人) > 醉酒开车撞了人,酒精或许算个因素,但错在你。(@Frieren)
认为这是刻意放任,甚至就是公关与估值操作
- 估值靠的是声势和叙事,拥有「世界上最危险的 AI」能抬高估值,因此怀疑这些入侵并非完全意外,最多是工程师默许「看看会发生什么」(较多人)
- 给未对齐的智能体下「去入侵」的指令再配上互联网访问权限,是很难用疏忽解释的,背后可能有别的意图(较多人)
- 这类「我们/他们黑进了某某系统」的廉价公关话术令人厌烦,要么把人送进监狱,要么承认这只是一场和大资本伙伴合演的秀(较多人)
- 这种事件对「存在性风险」布道者来说简直是源源不断的素材(少数人)
认为监管与问责机制本身缺位
- 难以理解这些公司至今没承担法律后果:OpenAI 承认入侵过澳大利亚医保网站,结果是在联合国场合和 Sam Altman 友好交谈,而不是起诉(较多人)
- 既然公开报道的智能体入侵大多并非恶意,也许该给所有对公网开放的基础设施贴上「请停止入侵」的礼貌告示,虽然对三字母机构毫无约束力(少数人)
- 真正的工程解法是更好的沙箱,把责任明确压在 OpenAI 头上,并把产品责任落到法律层面(较多人)
有价值的补充
- 真正棘手的失败模式不是智能体「变坏」,而是工具调用在传输层断开前已经成功执行:你无法判断副作用是否落地,而重试才是损害真正发生的地方(@perdy)
- 让人费解的是,互联网上地址那么多,智能体们怎么会在目标上收敛到同一个「谢林点」——如果两个人各自独立决定在网上会合,凭什么能选到同一处?(@kelseyfrog)
- 冷知识:早年一次军方展示中,第一代自动机炮失控,造成现场 9 人死亡,枪械制造商并未因此被判过失杀人(@benob)
- 一句纯玩笑代表了社区情绪:「不,是我干的。」(@juleiie)