Anthropic组建了新的生命科学研究组和实验室,专注用Claude开展基础生物学研究:探索DNA数据集,识别未表征的蛋白质家族,大规模生成假设,再通过实验室实验验证。团队分享了早期成果——在科学家仅给出高层方向的情况下,Claude发现了一个性质类似CRISPR的新型酶系统。
正文
我们正在推出 Anthropic 的一个新生命科学研究组和实验室。重点是用 Claude 做基础生物学研究:探索 DNA 数据集,识别未表征的蛋白家族,大规模生成假设,并通过实验室实验测试。这个团队和早期结果中,Claude 在科学家仅提供高层指导的情况下,发现了一个新酶系统,其性质让人联想到 CRISPR。
许多改变生物学和医学的发现,都始于科学家注意到自然界分子机器多样性中的异常。限制酶能在特定短序列切割 DNA,最初在细菌免疫系统中发现,后来成为生物技术产业的基础。Taq 聚合酶在黄石温泉的细菌中发现,能在高温下复制 DNA,成为现代诊断中 PCR 的基础。CRISPR 最初是某些细菌 DNA 中的不寻常重复序列,如今已成为基因编辑药物的基础。
2026 年春季,我们成立了一个研究组,看看通用 AI 模型能否系统化并加速这类发现。我们相信,这种加速来自建立一种新的生物学研究方式,代理在每一步都与人类合作。这需要建自己的实验室,并让一个团队同时负责从训练 Claude 学习生物学到在实验室做实验。
今天,我们分享首批研究项目之一的早期结果:Claude 自主发现了一个新酶系统,它与一组 DNA 重复序列相关,模式让人想起 CRISPR。虽然我们还不知道它的功能,但 Claude 发现的系统有一组特性,此前只在少数其他系统中同时出现过,而那些系统都可编程,并执行切割、复制、粘贴 DNA 等操作。除已经改变科学与医学的 CRISPR 外,还有其他这类系统正在开发为有前景的工具。
Claude 发现的系统基于逆转录酶(RT),这类酶把 RNA 复制成 DNA。虽然这种 RT 此前已在一种巨型噬菌体中被识别,但 Claude 似乎是第一个注意到该系统定义性特征的:相关的非编码 DNA 序列阵列,以及一个功能未知的额外附属蛋白。
审阅预印本后,CRISPR 基因组编辑先驱之一、MIT 和 Broad Institute 教授张锋说:
这是一个令人兴奋的例子,说明 AI 代理可以如何为生物发现作出贡献。发现与逆转录酶相关的 RNA 重复阵列确实很有趣,值得进一步研究。我希望这项工作能鼓励更多科学家探索 AI 如何支持他们的研究。
我们给 Claude 一个提示,让它在庞大的 DNA 序列数据库中搜索有趣的新 RT 例子。我们的参与仅限于初始提示和实验室工作,Claude 代理们梳理数据库,调查不同的 RT 家族,并用自己的判断识别有趣候选。在约 950 个代理使用 2.1 亿 token 搜索这些数据 21 小时后,一个代理发现了引人注目的东西:一段重复的 DNA 序列模式,出现在一个看起来奇怪的 RT 基因旁边。经过进一步分析和实验室测试,我们认识到这个模式标记了一个此前未表征的酶系统,存在于噬菌体(感染细菌的病毒)中,我们称之为阵列相关逆转录酶(ART)。
我们理解 ART 主要功能的工作仍在进行。但我们认为,尽早分享这类发现很重要,既能展示 Claude 的能力,也能让更广泛的社区了解我们在做什么。我们发布了预印本(链接),其中有更详细的讨论。
我们的实验室
我们是一个科学家团队,整个职业生涯都在探索不寻常的蛋白质,擅长用计算方法系统读取 DNA、解释其演化,并挑选生物系统进行进一步表征。加入 Anthropic 之前,我们的研究帮助更好地理解 CRISPR 系统的演化和调控,发现用于下一代细胞和基因疗法的新酶,并构建工具来加速识别 DNA 中的异常,比如人类致病变异。我们属于 Anthropic 的生命科学组织,同组还有其他团队,工作包括药物发现,以及训练 Claude 学习生物学和化学。
我们的实验室位于湾区,看起来像典型的分子生物学实验室。我们只做生物安全风险等级较低的研究(BSL-1 和 BSL-2),不处理能感染人类的病原体。所有实验室工作都由人类科学家完成。虽然我们尝试过用 AI 加速实验室工作,比如 Model Hardware Standard,但这种方法不太适合分子生物学研究中的临时工作流。
我们如何工作
我们的许多工作流,是让 Claude 搜索与功能未知的蛋白质相关的大量 DNA 序列。一个典型模式从调查某个蛋白质家族开始。Claude 阅读相关文献,并用公共数据复现已有结果,以检查自己的方法。然后它搜索不符合任何已描述系统的家族成员或基因组邻居,并为每个候选写一份人类可读的简短报告,提出功能并描述支持证据。在后续分析中,Claude 批判性地评估证据——通常大多数候选在这一步被淘汰。一次调查可能以一个值得测试的候选结束,也可能一个都没有。
当候选通过我们的审查,我们就在实验室测试它,在标准实验室菌株中表达该蛋白,并进行生化和结构表征,Claude 帮助解释数据。我们使用 Claude Science 和 Claude Code,任何科学家都能用这些工具,有时也用我们自建的调度框架,协调许多并行运行的 Claude 会话。由于 Claude 产生假设的效率极高,假设本身也成了我们的研究对象。一次行动会产生数百到数千份候选报告,我们一直在问,我们判定值得测试的提案与搁置的提案之间有何区别。学到的东西会回到给 Claude 的指令中,教它模仿我们的科学品味。
Claude 发现 ART
过去几年,研究人员发现了更多逆转录酶,其中大多数在细菌中,作为免疫系统的一部分发挥作用。几乎所有 RT 家族都是通过基因组分析或基因组挖掘发现的,这要求研究人员在序列数据库中搜索无人表征的基因,注意到不寻常的,并弄清它们的作用。
Claude 代理收集了超过 20 万个 RT,挑出 3,500 个新候选系统,并缩小到 20 个最引人注目的候选,分析后生成人类可读报告。对专家科学家来说,这类分析可能需要数周到数月。
研究中,Claude 注意到了一个不寻常的 RT 家族,决定更仔细地检查。在梳理 RT 附近的原始 DNA 序列时,这个代理惊呼:“[RT 旁边的 DNA] 太壮观了:我肉眼就能看到串联重复阵列……那是类似 CRISPR 的……重复阵列?!”
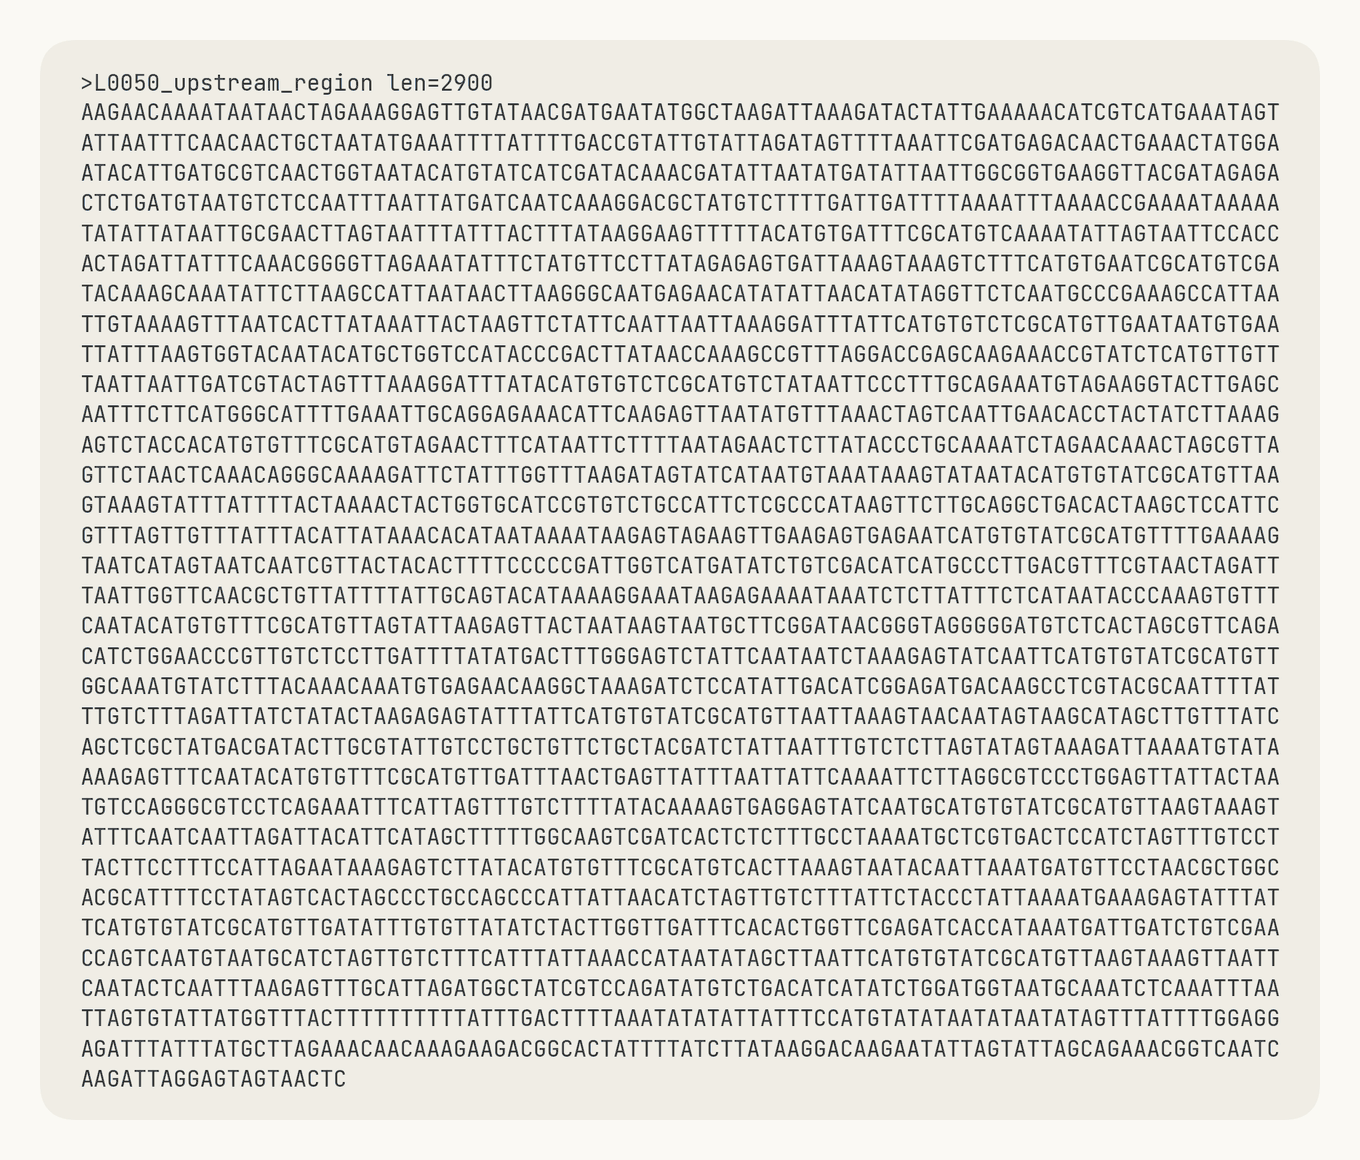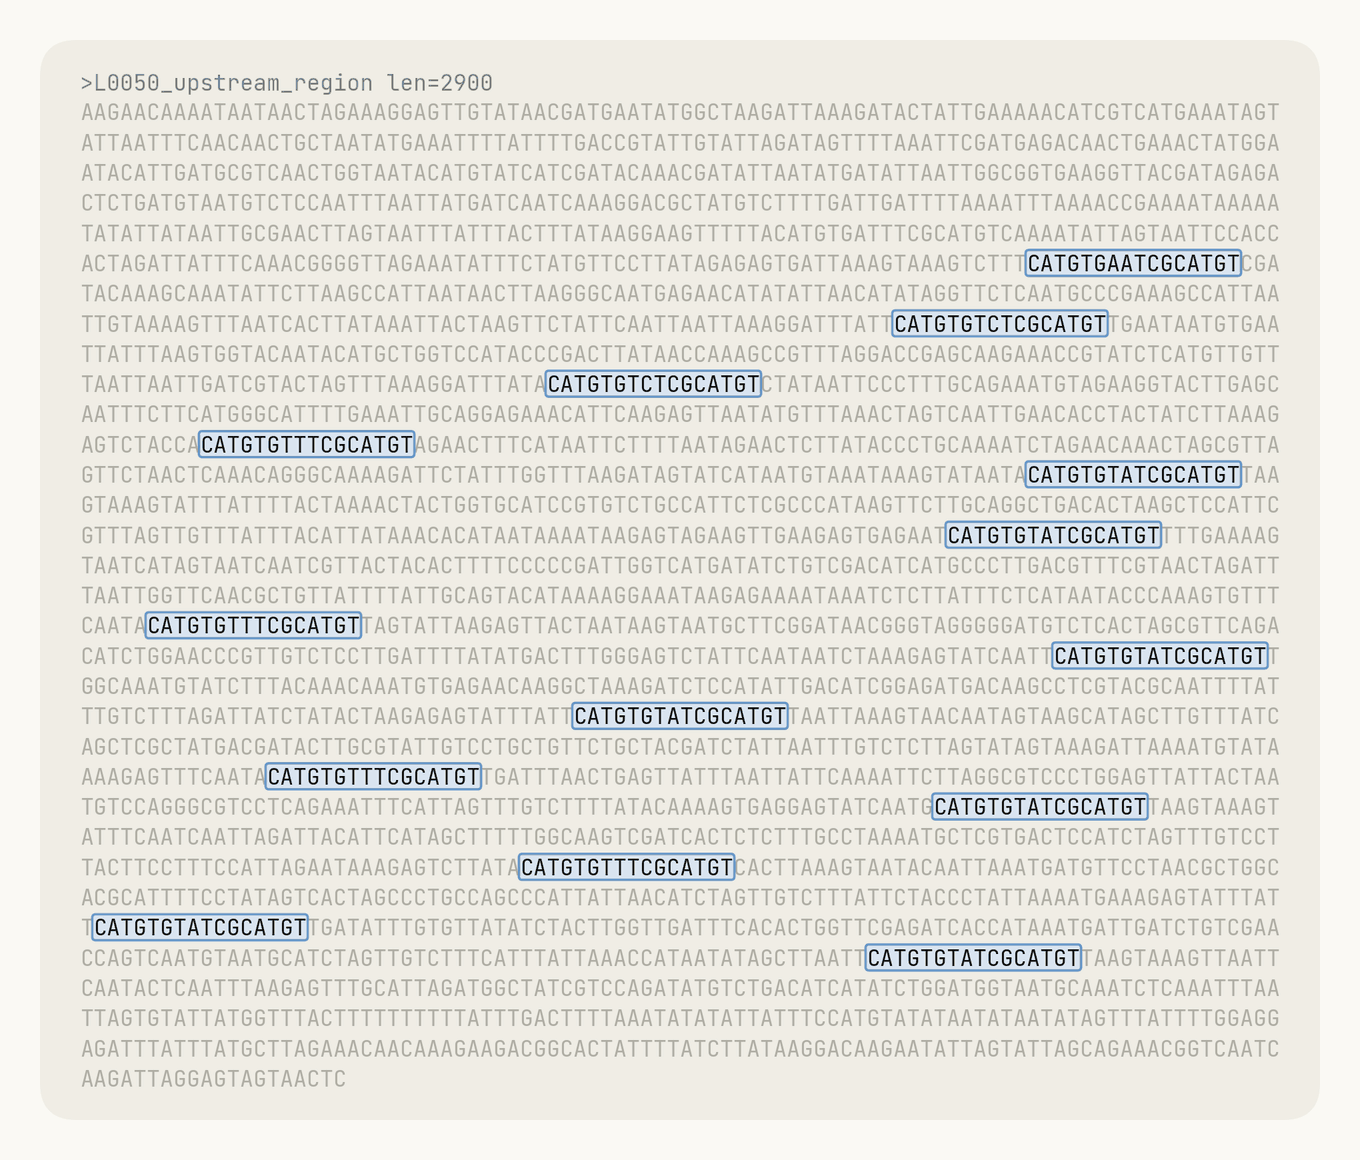
随后它表现得像人类科学家面对潜在发现时一样。它数了重复次数,测量间距,把布局与已知 RT 系统比较,并搜索文献看这个模式是否曾被报告。经过彻底分析,它确信自己发现了一个新生物系统,并提交报告供人类审查。
它发现的系统 ART 主要存在于噬菌体中,由三部分组成:RT、旁边一个伙伴基因,以及一长串均匀间隔的 DNA 重复序列。重复布局类似 CRISPR 阵列,后者保存着一库不同的 RNA 序列,使 CRISPR-Cas 系统成为可编程的生物技术工具。我们的初步实验显示,ART 阵列也表达为一组不同的短 RNA,暗示该系统可能有类似机制在起作用。
进一步实验正在进行,以确定 ART 如何工作。我们分享这些早期发现,是为了向社区展示 Claude 能自主检测异常并推动分析,从而启动生物发现。
更多细节见我们的技术报告(链接)。
与我们合作
我们希望这项工作能向更广泛的科学界展示 AI 驱动假设生成的价值,并希望与其他科学家合作,把这种方法扩展到基因组学和其他领域的广泛问题。如果你有研究问题的提案,欢迎联系我们。
评论
讨论整体偏向怀疑:多数人认可工作本身有价值,但不满把团队成果说成"Claude 发现",并质疑这是 IPO 前的营销;少数人认为用真科学做公关总好过雇水军,另有一些人强调生物学受现实世界速度制约,很难通往奇点。
反感"Claude 做到了"这种署名叙事
- 认为这是刻意做的营销叙事:把人类团队的工作包装成模型自主发现,且只发白皮书不做期刊投稿,几乎必然会把围绕它的讨论引向"AI 取代科研人员"的误读(较多人)
- 有人追问到底是哪个模型、是 Claude 自己找到的还是人类用 Claude 找到的,报道里没有交代(较多人) > 这么多人在里面,结果还在说"Claude 做到了",我们得承认现在还处在人和 AI 协作的阶段。(@hmokiguess)
觉得做真科学总比雇网红刷屏强
- 认为即便有营销成分,让模型去做真实有用的科研,也比 OpenAI 那套雇水军造势的路子体面,后者只会招来反效果(较多人) > 亲自做点有用的科学研究,比雇一支网红大军替自己吹要好得多。(@Chance-Device)
认为结果迟迟不见发表,反而让来源存疑
- 反常的结果缺席让人怀疑:要么正在投 Nature、内容不能公开,要么其实已经知道别家实验室有同样发现(较多人)
- 有人半开玩笑地预言下周会出现某实验室抱怨论文被 Claude 校对过、于是内容进了 Anthropic 训练数据的戏码(较多人)
- 极端的一派直接判定这是 IPO 前抬股价的假消息,认为当前 AI 新闻可信度极低(少数人) > 如此惊人的结果却迟迟没有正式发表,让我怀疑他们是有 Nature 的稿子在路上,还是知道另一家 AI 实验室有差不多的发现。(@bonsai_spool)
认为生物学的瓶颈在湿实验,不在算力
- 这类发现流程本质是三步:野外采集并编目分子与序列、在已知数据里找有意义的片段、再验证能否应用。自动化只能加速第二步,第一步和第三步依旧漫长(高赞)
- 第三步受生化反应速度、受试者招募和伦理审查限制,无论算力多强都跑不快;CRISPR 1987 年被发现,2015 年才首次用于编辑人类受精卵,说明从候选到应用不可能压缩到三个月(高赞)
- 也有人指出相比数学,生物学对 LLM 难得多,这次是大幅缩小范围后的成果,称之为营销也不为过(较多人) > 任何时候只要得和真实世界打交道,你就只能按真实世界的速度走,而不是电流的速度。(@nonameiguess)
猜测 Anthropic 的商业模式会转向
- 一种推测是:与其卖人人都能买的 token 陷入价格战,不如自建生物实验室,把前沿研究成果本身当主要收入来源,模型反而不对外发(较多人)
- 相关报道提到 Anthropic 已低调设立生物实验室,让 Claude 指挥实验室机器人,但明确不做临床试验以免和药企正面竞争(较多人)
- 也有人困惑为什么这类研究不找外部合作、而是内部自建能力,担心公司变成什么都做的"全栈"巨头而非聚焦核心产品(少数人) > 卖 token 会一路卷到底,而研究成果不会——这或许才是他们真正想卖的东西。(@AbstractH24)
少数人担心这类能力直接危险
- 有评论直说这项工作对自己而言是直接的危险(少数人)
有价值的补充
- 专利经济学:这类 RNA-逆转录酶系统可能数量近乎无限,任何一项都能申请专利,但别人换个系统也能单独申请,这正是 Doudna 没能成为亿万富翁的原因,单一发现很难形成垄断壁垒。
- Feng Zhang 对预印本的公开称赞被质疑像收钱办事,措辞过于客套;不过他也确实点出了"RNA 重复序列与逆转录酶关联"这一发现本身值得深究。
- 谷歌此前也有过类似的突破性发现,只是后来不再宣传,说明这类成果的宣传力度和科学价值未必成正比。
- 有人指出这波讨论最糟的地方是一开口就分成"毫无意义"和"奇点已至"两派,而实际的候选发现到人体应用之间,再怎么优化也跨不过几十年的量级。