机器学习智能使用价格每年降数个数量级且未放缓。未来1-2年大语言模型(LLM)将作基础设施融入计算各环节而非仅产品。未来3-6年大语言模型或于商品硬件本地运行达当前前沿质量。不久质量与访问或成人工智能(AI)限制因素,此处用人工智能而非大语言模型因 Jev 等非大语言模型分类器能力可比,限制在使用质量而非令牌数。
正文
使用机器学习智能的成本正以每年几个数量级的速度下降,且没有放缓迹象。未来一两年,LLM很可能作为基础设施融入计算各方面,而不只是产品。未来3到6年,很可能看到LLM在普通硬件上以当前前沿水平本地运行。很快,AI的限制因素将是质量和可用性,而非单纯的token数量。这里我特意用“AI”而不是“LLM”,因为像Jev这类新的机器学习分类器虽非LLM,但能力相当。
这真的在发生吗?
非同寻常的说法需要非同寻常的证据,所以我收集了大量证据。AI可以是专有模型(如GPT-6 Astra)或开放权重模型(如GLM-5.3-flash)。开放权重模型可由第三方托管(如Z.ai)或本地运行。通常本地运行的模型更小,如Muse Glimmer或Qwen3 Coder。某一类的改进未必影响其他类。
影响所有AI的改进
GPU
GPU每代效率呈指数提升。下图X轴是时间,Y轴是GPU自身的能效,数值越大越高效。
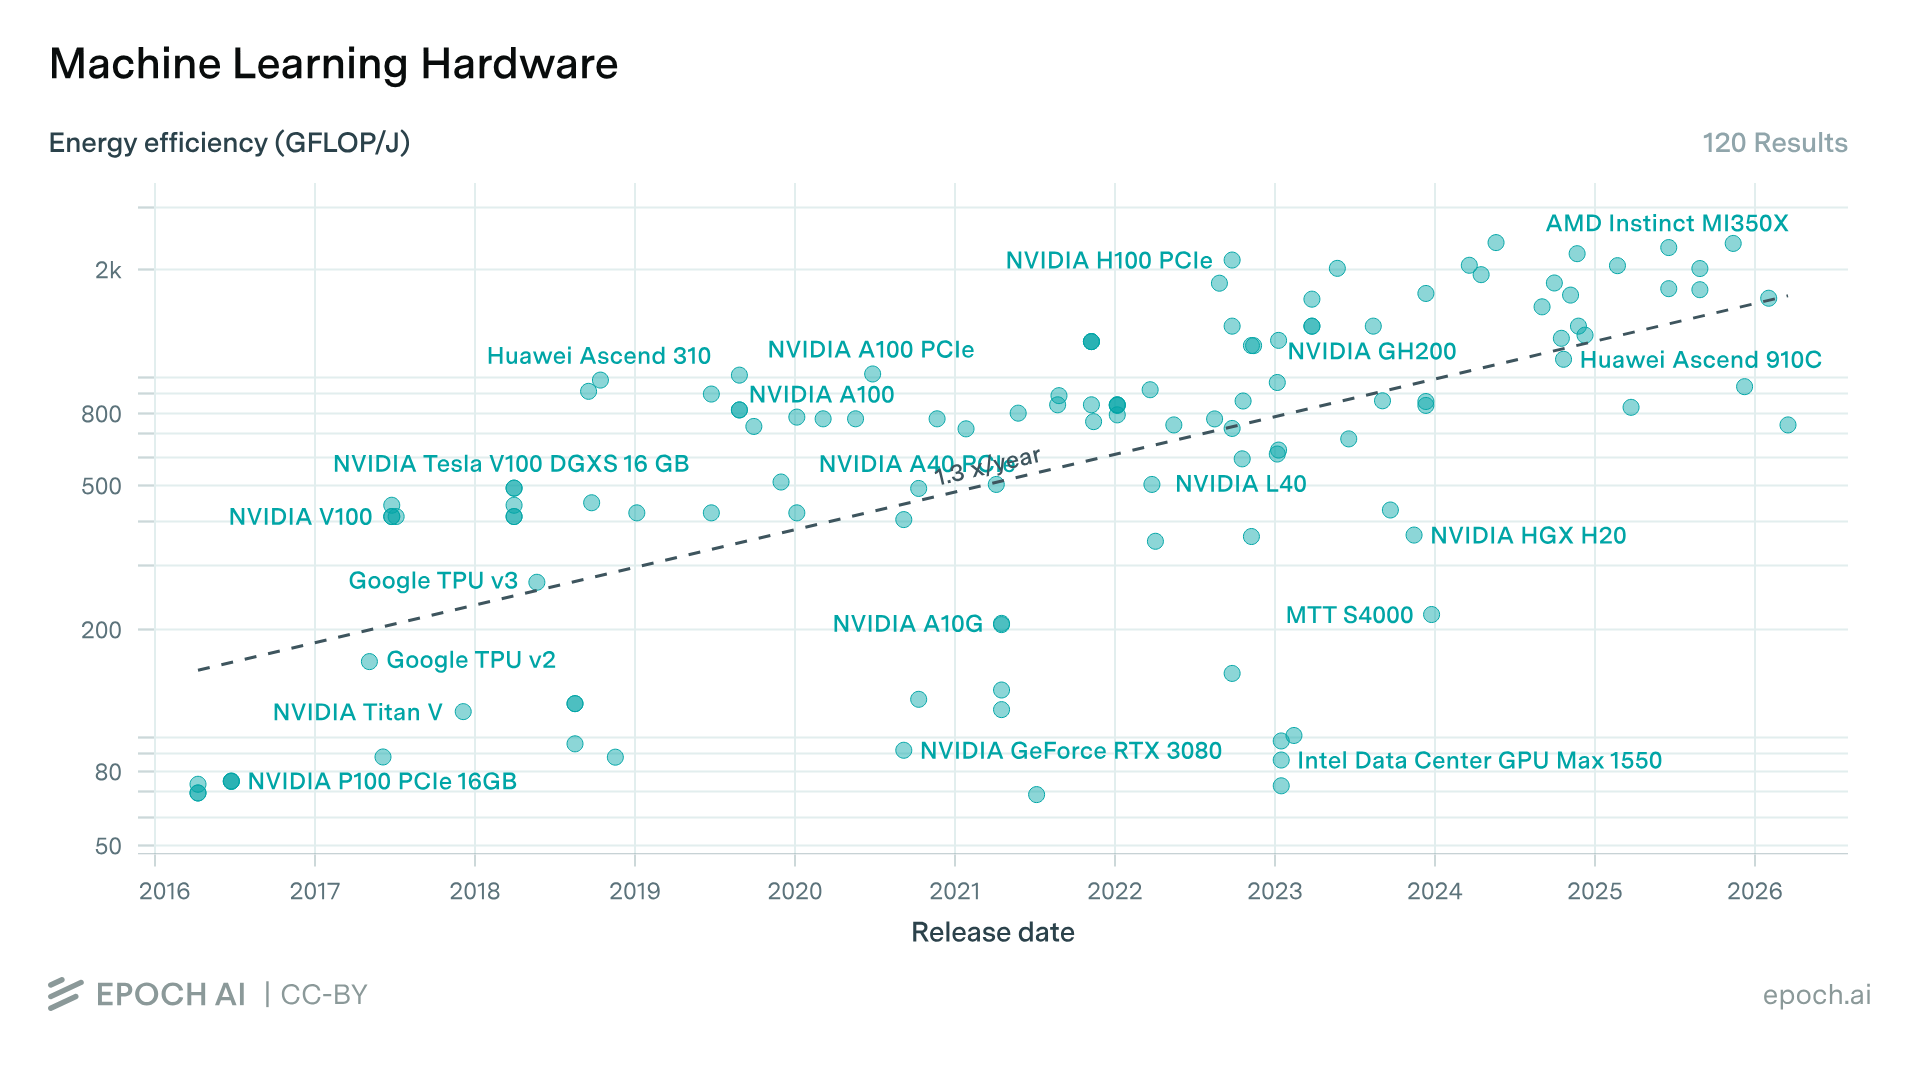
这是对数图,直线代表效率指数增长。对数斜率为1.3,意味着能效约每两年翻一番。这是自1960年代摩尔定律以来未见的增长。
模型
用模型完成特定任务的成本正急剧下降。模型通常按token计费,token约为词片段,一词约1.5 token。前沿模型每token成本未必降,但每任务成本在降。小模型每token便宜但完成任务总token更多。
下图为2026年任务成本/质量的帕累托前沿。其权衡体现为: - Y轴:模型“质量”(由基准测试套件衡量) - X轴:完成那些基准测试的成本
成本对数刻度,Y越大X越小越好。
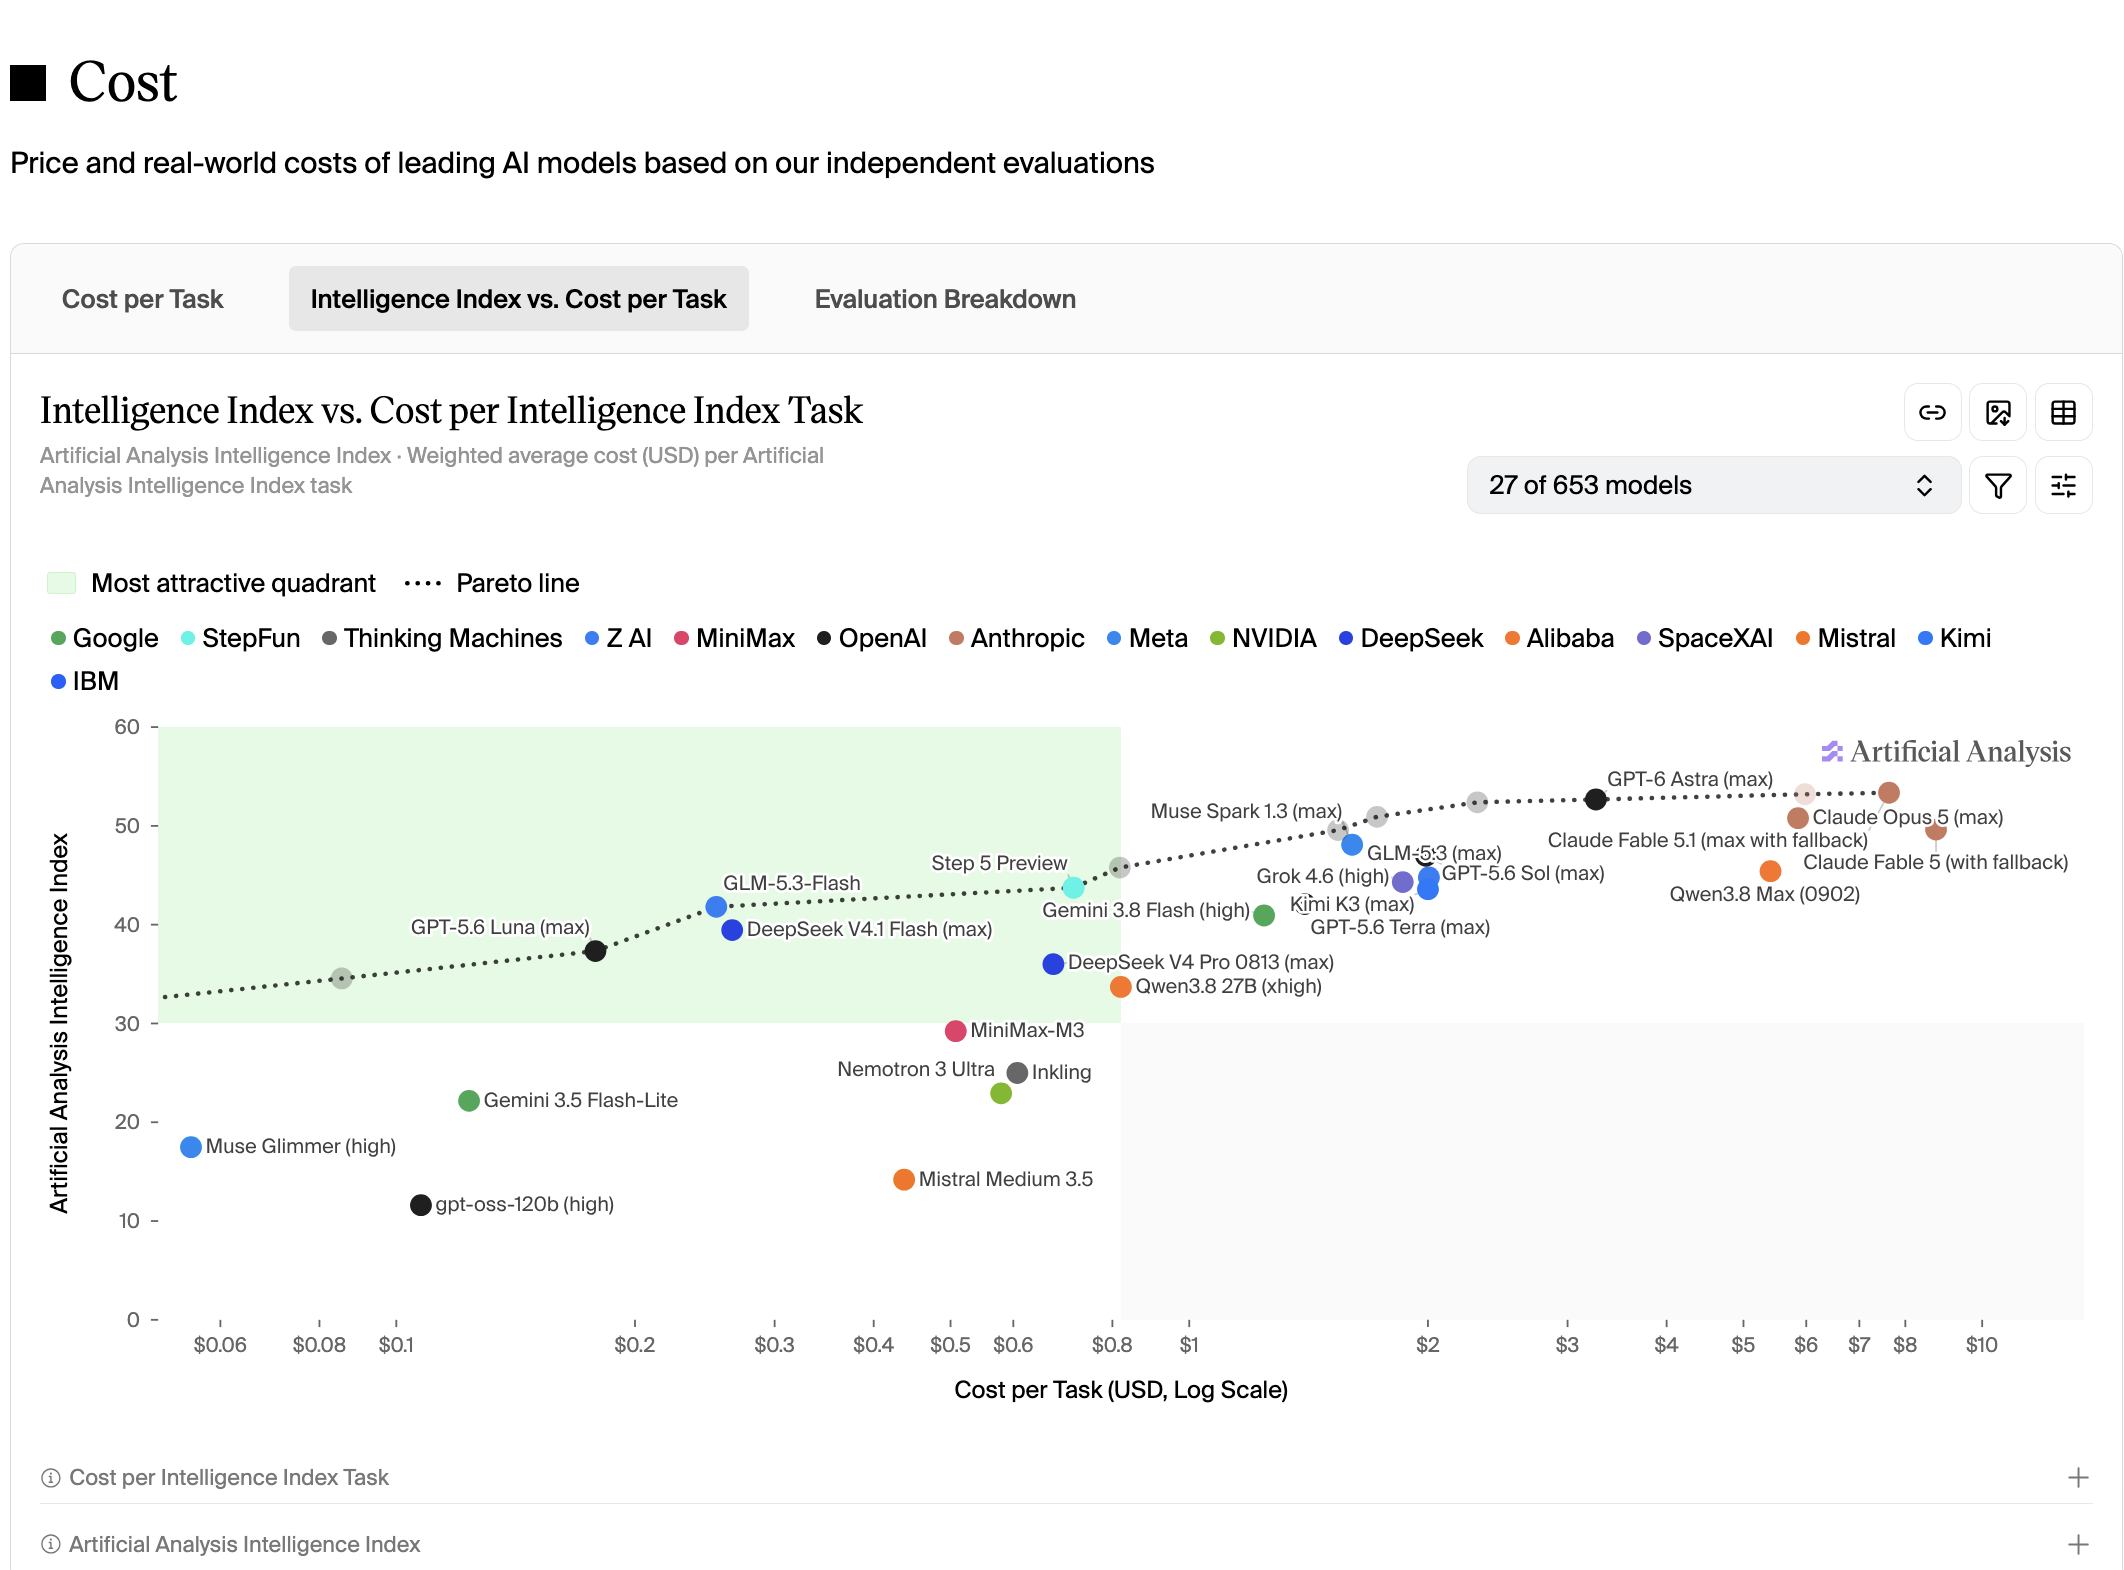
图中右上为Claude Fable-5.1(贵而强),中左为GPT-5.6 Luna(廉而弱)。虚线以下模型不值得考虑。
2025年初、中、末的帕累托前沿对比如下:
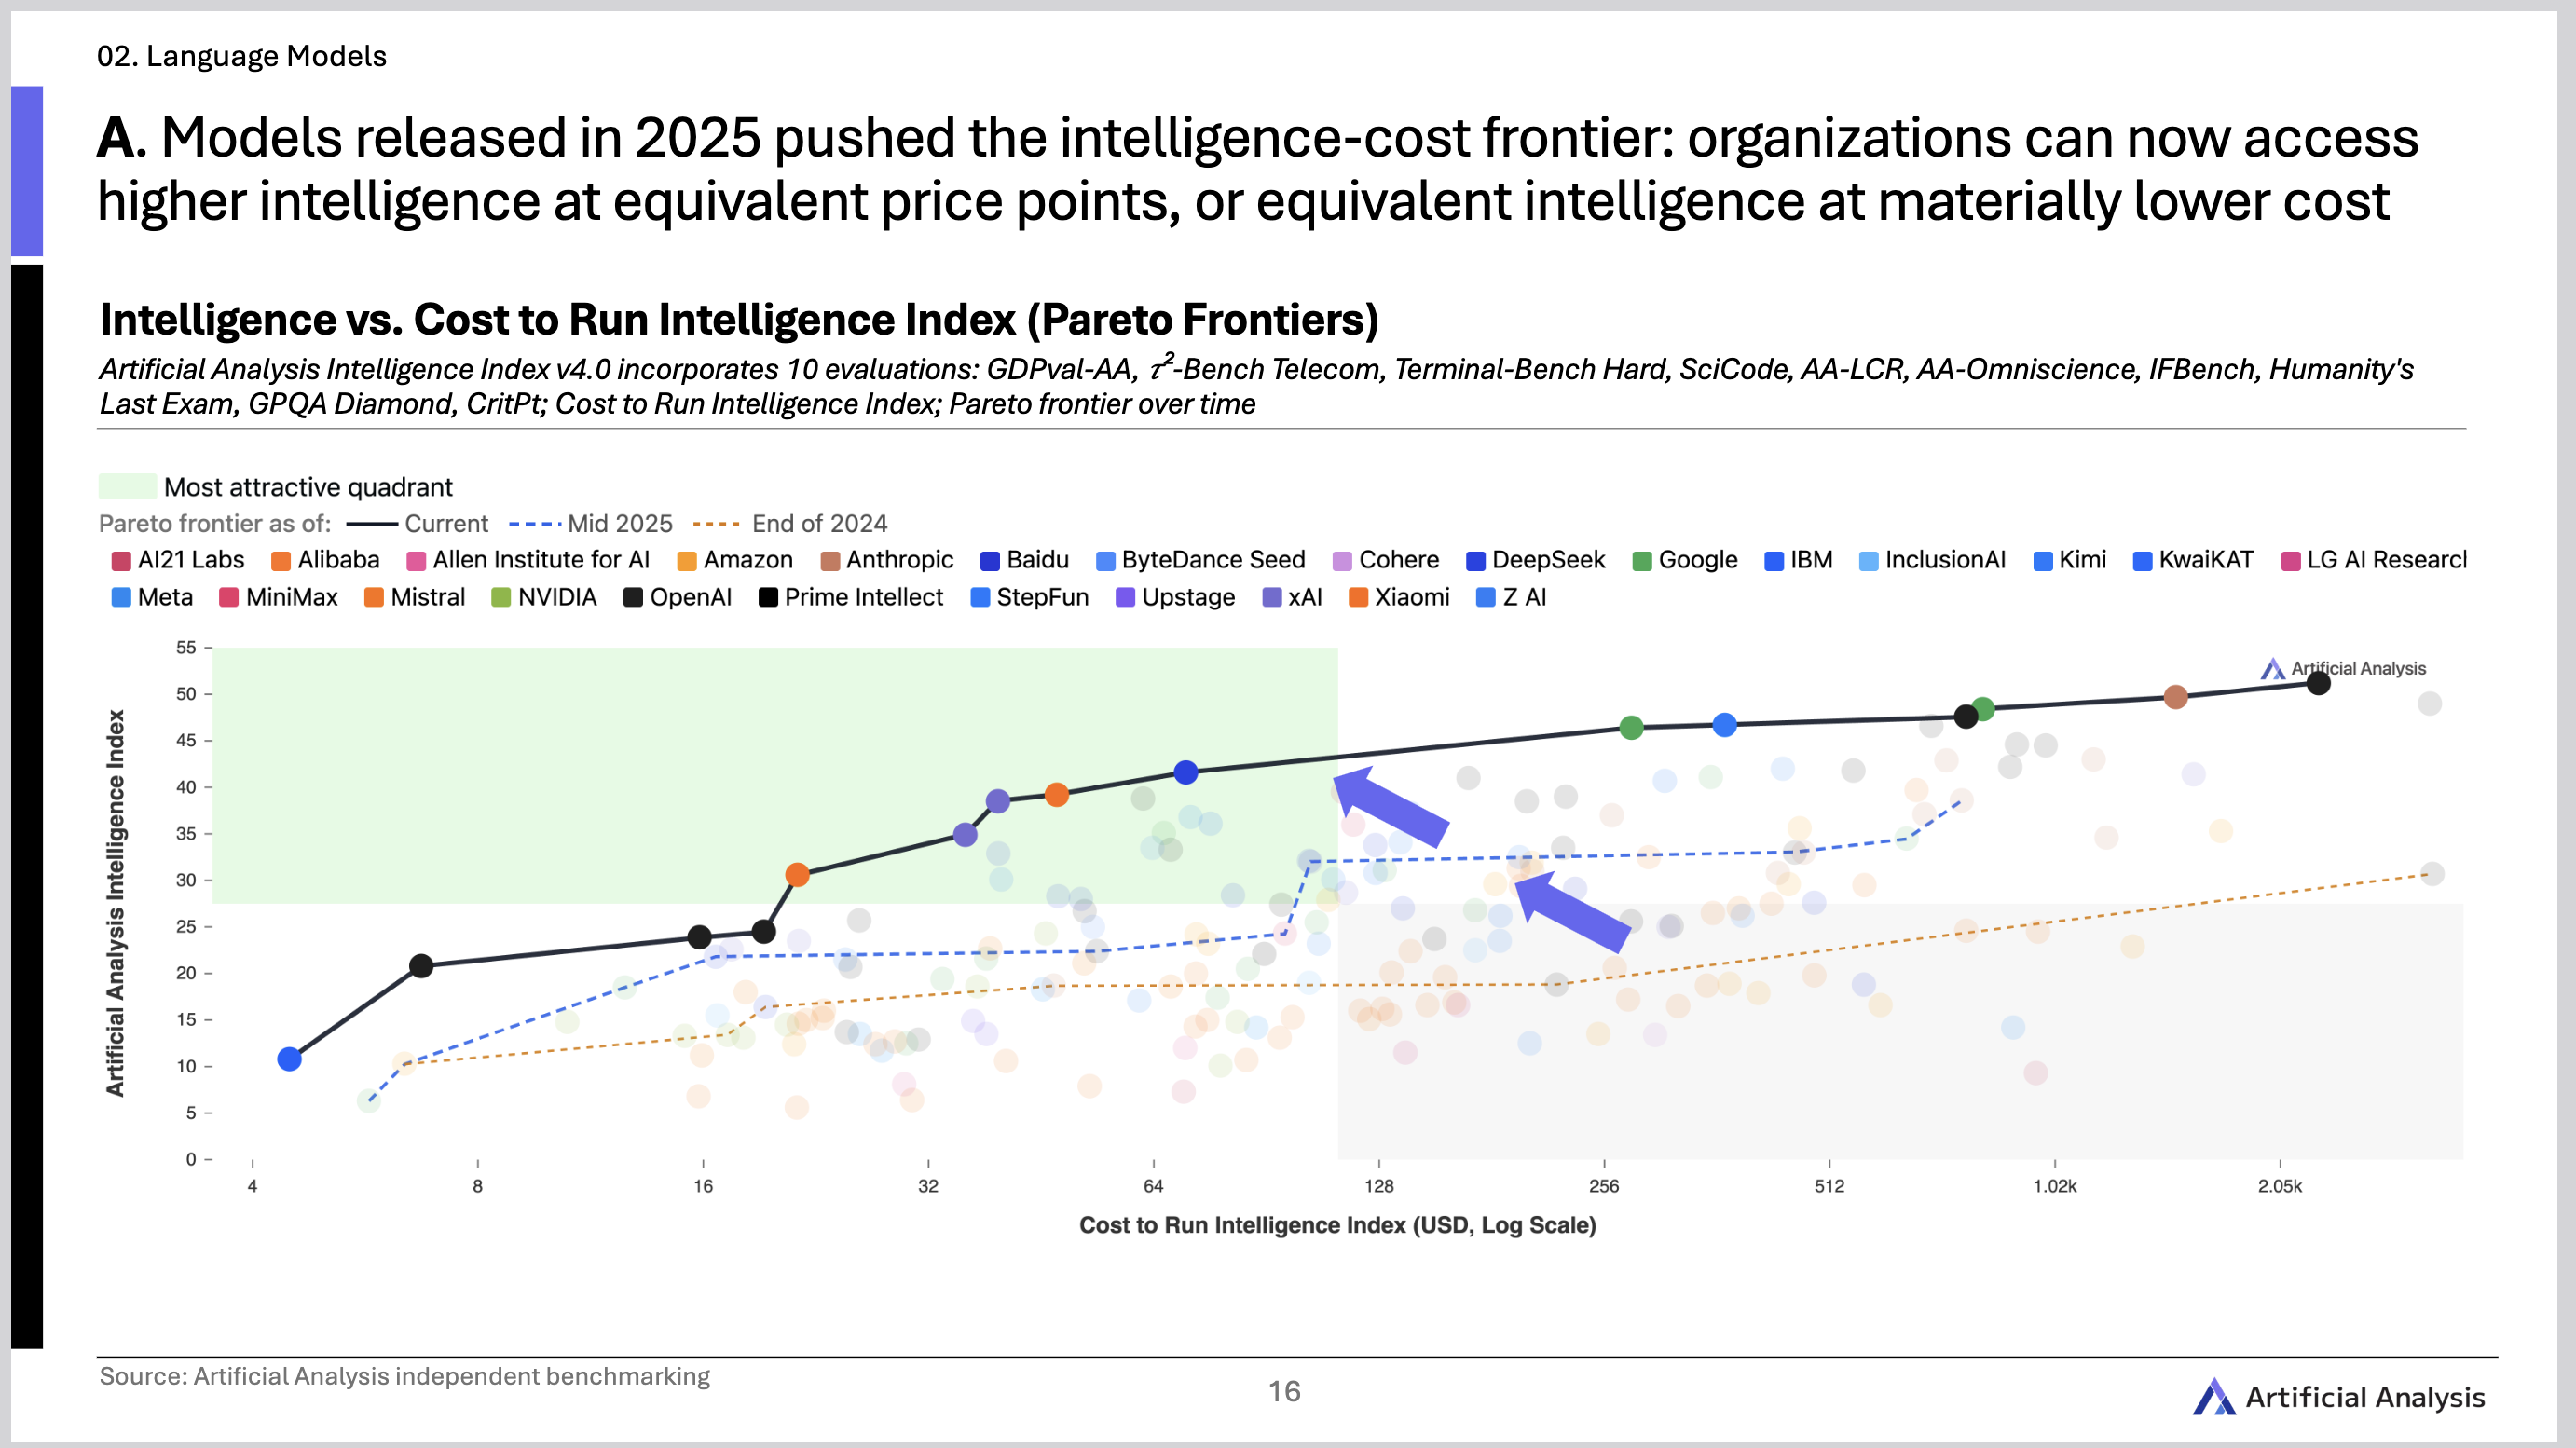
2025年内模型变得更聪明且单任务更便宜。横向看任意任务年末比年初便宜;纵向看任意成本下能做的事更多。对比2025与2026图,Y轴智力相近,但廉价端衰减更少;X轴成本便宜了两个数量级。
推理引擎
推理引擎是让训练好的模型在GPU上运行的软件,目前不成熟但年增10%-50%效率,其中在线服务(serving)比离线推理提升更快。以下均为serving负载数据。
vLLM
vLLM是开源推理引擎,效率渐增。下图Y轴焦耳/token,X轴批大小,蓝红线为不同版本,数值越小越高效。vLLM 0.11.1(2025年12月)比v0.5.4(2024年9月)约15个月效率提升40%。虽无连续多版本干净对比,但v2到v3性能增益与已知能效改进成比例。
NVIDIA
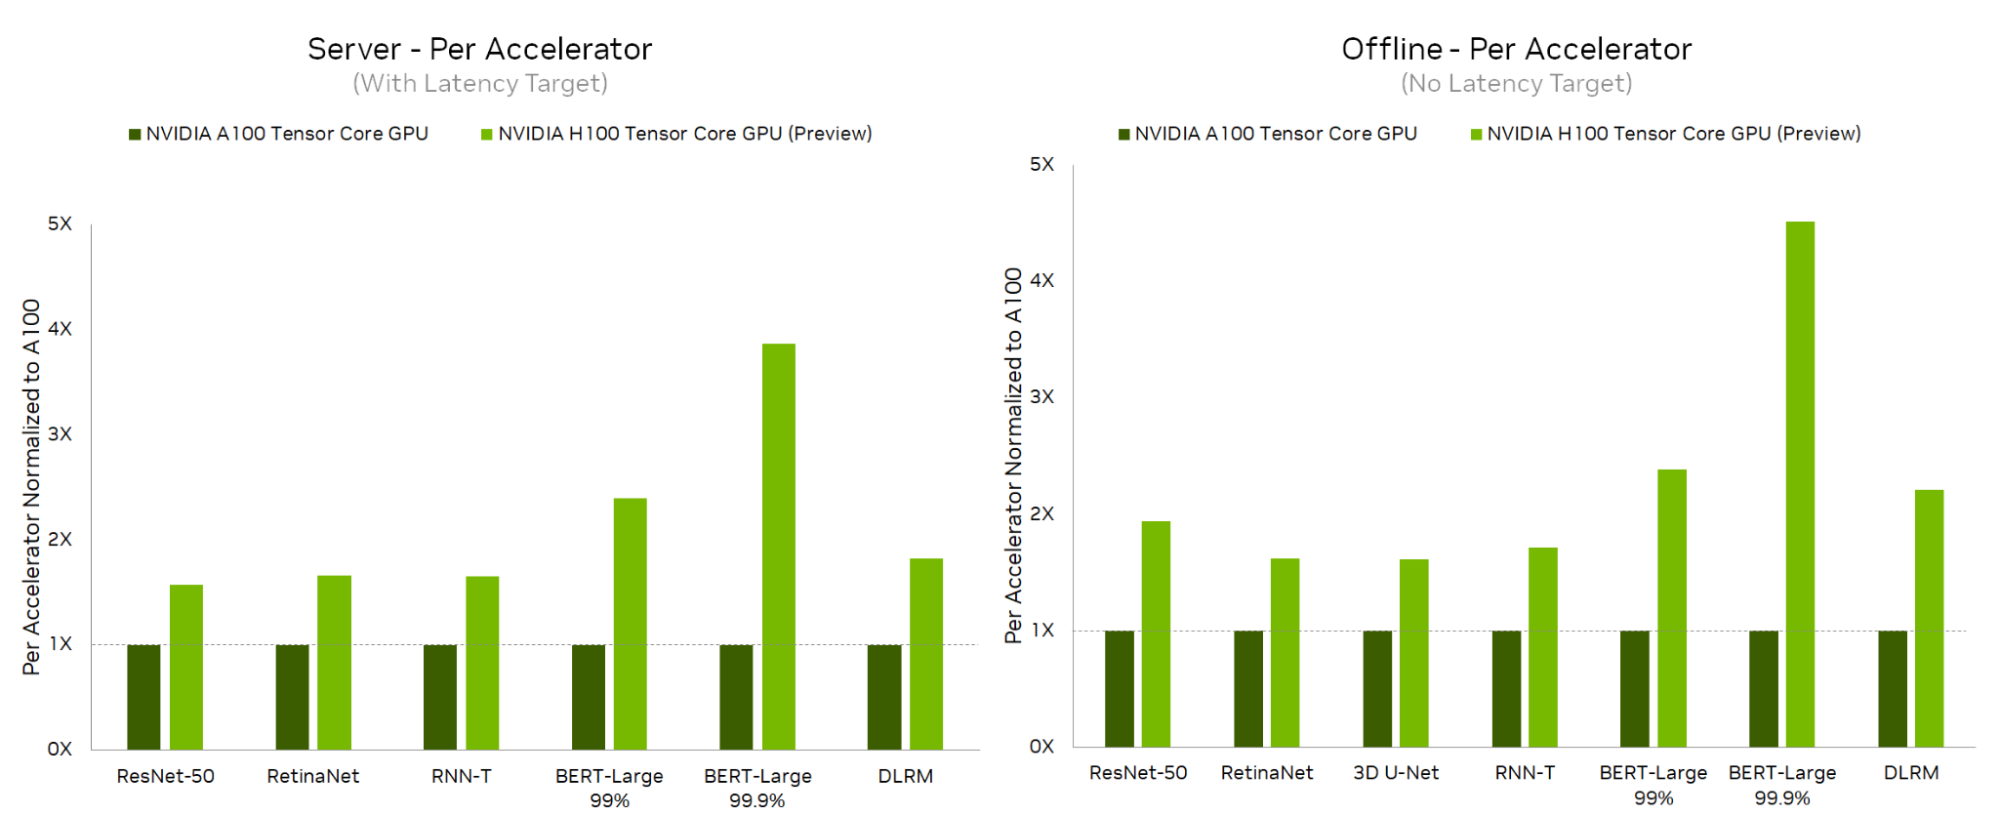
不仅单个软件包如此。NVIDIA在MLPerf套件2.0到2.1上展现最高50%效率提升:
Intel
Intel近期仅靠改进MLPerf 6.0到6.1便实现2.4倍吞吐提升。虽测的是吞吐而非能效,但硬件不变软件变,很可能反映能效提升。
影响托管AI的改进
混合专家模型
模型架构比早期更高效。早期LLM是稠密模型,每个输入激活全部部分。近期MoE架构在不需时停用专家层,同等质量下计算更少。下图显示模型可缩小7倍(6B到0.8B)而基准表现相同:
这意味着相对于质量,模型成本和内存占用会下降。人们往往用同等计算换更好输出,故每焦耳token数持平,但每焦耳质量在快速上升。MoE对本地机器帮助不大,因专家仍需驻留内存;mlx-flash等项目可按需换层使之能跑但不快。
影响本地AI的改进
Mamba
本地运行LLM的限制是需海量RAM。近期模型将所需RAM降至1/5以下。传统transformer架构记住每个输入(每层数百KB),而Mamba架构只记有损摘要,类似编码代理中的压缩,但内建于模型故更高效。纯Mamba不行(如记不住URL),但Mamba-Transformer混合架构大幅减少同token量所需RAM。Nemotron-H-47B量化至4位权重后,可在32GB显存存超百万token;同质量Llama-3.1 60B需近120GB,不用量化更糟。
影响特定用例的改进
Jev与Laya
仅靠专用是/否回答,成本可降两个数量级。TypeSafe AI本周发布旗舰产品Jev,它不能生成文本,只能从预设选项中选,给出0-100%概率。其定价页写道:
现有LLM:
输入token:每百万token 0.2至10美元。输出token:约为输入5倍贵。
System One + Jev:
输入token:每百万0.042美元(每十亿42美元)。输出token:免费(便宜到无需计量)。
每十亿token仅42美元。token约词的2/3,书均8万词,故读5本书约3美分,42美元可读万分之一的人类全部书籍。比电费还低。有人据此造工具,如jgrep,可对输入流做查询:jgrep -o "announces or releases a new AI model" titles.txt | sort -rn | head -3 会输出带概率的标题(如0.980 PrismML Launches Bonsai 2 27B...)。jgrep自述称约200毫秒、千分之一美分返回概率,足以置于管道,测994条HN标题耗4.6秒和0.012美元。另有Jev triage,用TUI按优先级看PR,它通过查看每条评论定优先级,虽不能替代团队但是好助手。
Jev专有,Laya开放权重且小到可本地跑,微调后更快更准,但它是代码库非产品: - 不托管,需自搭大量环境 - 不微调则表现差,需ML知识 - 上下文仅512字节,不善长输入
二者让我相信架构改进空间仍大,近期不会碰缩放极限。
综合起来
综合看,去年token成本降约2.5个数量级: - 模型单任务成本效率约百倍 - 硬件每token能效约1.3倍 - 引擎每token能效约1.4倍
若看其他基准: - 新架构同RAM多存5倍token,利于本地强模型 - 专用模型Jev/Laya再降1-2数量级
皆不成熟,远未到收益递减。
接下来会发生什么?
Token比工具调用更便宜
有趣的是与计算其他成本比。GPT-5.6 Luna约每百万token 30美分,假设每次工具调用耗1万token,即每轮0.33美分。纽约和荷兰电费约每千瓦时25美分,MacBook Air闲置10W重负30W。由此得表:
| 工具 | 功率(W) | 时长(秒) | 价格(美分) | 比Luna轮次便宜的数量级 |
| --- | --- | --- | --- | --- |
| grep | 10 | 0.1 | 0.000007 | 4.5 |
| 解析HTML | 10 | 1 | 0.00007 | 3.5 |
| cargo build | 30 | 30 | 0.00625 | 1.5 |
近几年这并非不可想。一旦模型比工具便宜,把模型嵌入工具就有吸引力。如上jgrep,未来或更广,如自适应构建调度器。
供给侧杰文斯悖论
模型运行越便宜,公司越建更多算力(如Stargate),因每美元投资赚更多。此即杰文斯悖论:效率越高总量越大;便宜引发诱导需求。
投资者如何回本?
若token便宜到不必计量,提供商如何赚钱?会泡沫破裂吗?不。每token虽廉,推理对提供商仍利厚;且OpenAI和Anthropic领先,便宜的是量而非质。最难任务用前沿实验室,普通任务用开放权重或低价计划。若开放权重追上,会伤投资者,但NVIDIA仍旺,AI使用更廉。
需求侧杰文斯悖论
另一问题:算力足够廉,人们用来做啥?百万、十亿token?可能: - 网络安全更糟,公司集中托管服务防黑 - 原始算力优势利好超大规模商,租专用推理GPU增多 - 软件难点变需求、测试、UI,就业市场怪,QA/UX岗复兴 - 租用软件更少,代码非护城河,运维安全才是价值 - 或许更多,未来更奇
可选项
从前软件三选: 1. 使用它 2. 不用它 3. 用类似产品
今有第四:让LLM造它。质量或优劣但选项新生,公司竞质非能力有无。受监管行业 incumbent 优势大。这也让量身定制的可塑软件更易造,非程序员也能(除少数如快捷指令等)。
总结
我不知道接下来怎样,但应规划一个不仅计算便宜、智能也便宜的世界。
评论
讨论整体偏怀疑:多数人对「成本暴跌、本地跑前沿模型、算力需求无限增长」这套叙事持保留态度,认为文章的数据与商业逻辑都站不住脚;少数人认可效率会继续提升,但强调能源、显存和风险偏好构成硬约束。
数据中心建设是泡沫,但 AI 本身不是
- 硬件和模型效率的改进可能跑在需求前面,需求饱和后效率还在涨,会留下一堆孤立的数据中心(较多人) > AI 不是泡沫,但数据中心需求大概是,最终会有大量闲置算力无人使用(@api)
英伟达在推理市场只有几个月的领先优势
- 真正走量的是推理而非训练,而这个领域竞争者众多,下一代推理卡的利润率会明显低于训练卡(少数人)
本地跑前沿级模型,卡在显存供给上
- 本地化能否普及取决于厂商何时把内存产能和统一内存铺开;厂商眼下偏爱卖给云服务商的高毛利生意,转向高销量只是「按部就班」,中国竞争者和数据中心需求下滑或许能加速(较多人)
长期指数级效率提升不会一直持续
- 调用成本不会无限下滑,grep 这类高质量编译软件的单次成本更像是 LLM 成本逼近的下限,除非量子计算之类出现真突破(较多人)
- 能源、能耗效率、数据中心规模都不是无限的,基准测试也只是现实问题的抽象;此外每次技术替换都带风险,很多替换并不产生正经济收益(较多人) > 如果一件事不可能永远持续,它就会停(@jetrink)
文章的成本图表经不起细看
- 2025 与 2026 的成本对比口径不一致:前者是跑完整个评测集的成本,后者是每任务的加权平均,成本下降没有文中那么快(高赞)
- GPU 那张图几乎可以画出任意趋势线,反而说明四年前的 H100 与当今最先进芯片效率差别不大,结论与文章相反(高赞)
- 给散点套回归线之后,总得判断这是真趋势还是噪声,文章和引用来源都没做这一步(较多人)
文章回避了最要命的问题:商业模式能否成立
- 每往基础设施投入一万亿美元,要维持 10% 以上年回报,就得永久性地每年产生超过一千亿美元的自由现金流;文章只用一小段定性讨论带过,没有硬数据(高赞)
关于成本存在两套互相矛盾的叙事
- 一边说推理成本高到实验室在偷偷补贴、很快要重新定价,一边说 token 会便宜到实验室无法盈利,两者不可能同时成立(较多人)
- 「便宜到不用计量」这个说法让人想起 1954 年核能的承诺,结果电费表照样转、账单照样大(少数人)
- 本周集中出现的「开源模型」与「价格快速下跌」宣传,配合首页的其他帖子,看起来像协调过的舆论动作(少数人)
关于本地 AI 的关键改进,作者举错了例子
- 把 Mamba 列为首要改进、并拿一个月前就已过时和早已「上古」的两个模型举例,说明选材有问题;真正重要的是 llama.cpp 的部分卸载、量化、混合精度的动态量化、MoE,以及苹果和 Strix Halo 这类统一内存设备(较多人)
grep 不会被取代
- 新工具是扩展 grep 到新场景,而不是替代它,关键词搜索永远有位置(少数人)
有价值的补充
- Epoch AI 前一天发布的统计分析更扎实:刚成为 SOTA 的能力层级降价最快,五个基准平均每季度降 66%(约每年 75 倍),两年后降速减半到每季度 32%(@foob)
- 本地推理的隐性成本被忽视:正是投资资本在补贴云端 LLM,反而推高了本地计算硬件的价格(@dofm)
- 环境外部性「介于糟糕和灾难性之间」,这一维度基本没被认真讨论(@hermitcrab)
- 一条玩笑代表社区情绪:有人问该拿厨房台面上那台占地方的旧 Juicero 怎么办,暗指这轮硬件热潮的结局(@bigbuppo)