作者近日受邀向美国国会(U.S. Congress)议员及助手介绍中美竞争下开放权重模型状况并分享发言。开放语言模型权重公开可用,对比闭源模型仅通过应用程序编程接口(API)如GPT-4(GPT-4)或产品如ChatGPT(ChatGPT)访问。开放模型分开放权重与开源两类,前者如元(Meta)的Llama(Llama)、阿里巴巴(Alibaba)的通义千问(Qwen)、谷歌(Google)的Gemma(Gemma)、深度求索(DeepSeek)的模型,自2025年4月左右中国公司领先。
正文
我最近受邀向美国国会众议员和工作人员介绍美中竞争视角下开放权重模型的现状,现将准备的发言分享给更广的读者。
开放语言模型指权重公开可检视或下游使用的AI模型,常与闭源模型对比。闭源模型仅通过API(如GPT-4、Claude Opus 4.5)或产品(ChatGPT、Claude Code)提供访问。开放语言模型主要分为开放权重和开源两类。开放权重最常见,如Meta的Llama、阿里的Qwen、Google的Gemma、DeepSeek的模型,受许可证约束,常配推理代码(Transformers、VLLM等)。自2025年4月左右,中国AI公司在开放权重模型上明显领先。
真正的开源模型除权重、许可证、推理代码外,还包含复现所需的训练代码与数据。最知名的开源模型在美国,如艾伦人工智能研究所的Olmo(笔者曾参与构建)、OpenAthena的Marin、EleutherAI的Pythia。各类模型存在开放程度光谱:Nvidia的Nemotron释放大量训练数据但非完全开源;闭源模型也因API揭示信息而异。
当前,智谱的GLM-5.2和月之暗面的Kimi K3等中国最新领先模型,在商业可行性和智能体能力上实现阶跃变化,跨过了类似Anthropic的Claude Code在2025年12月达到的门槛。
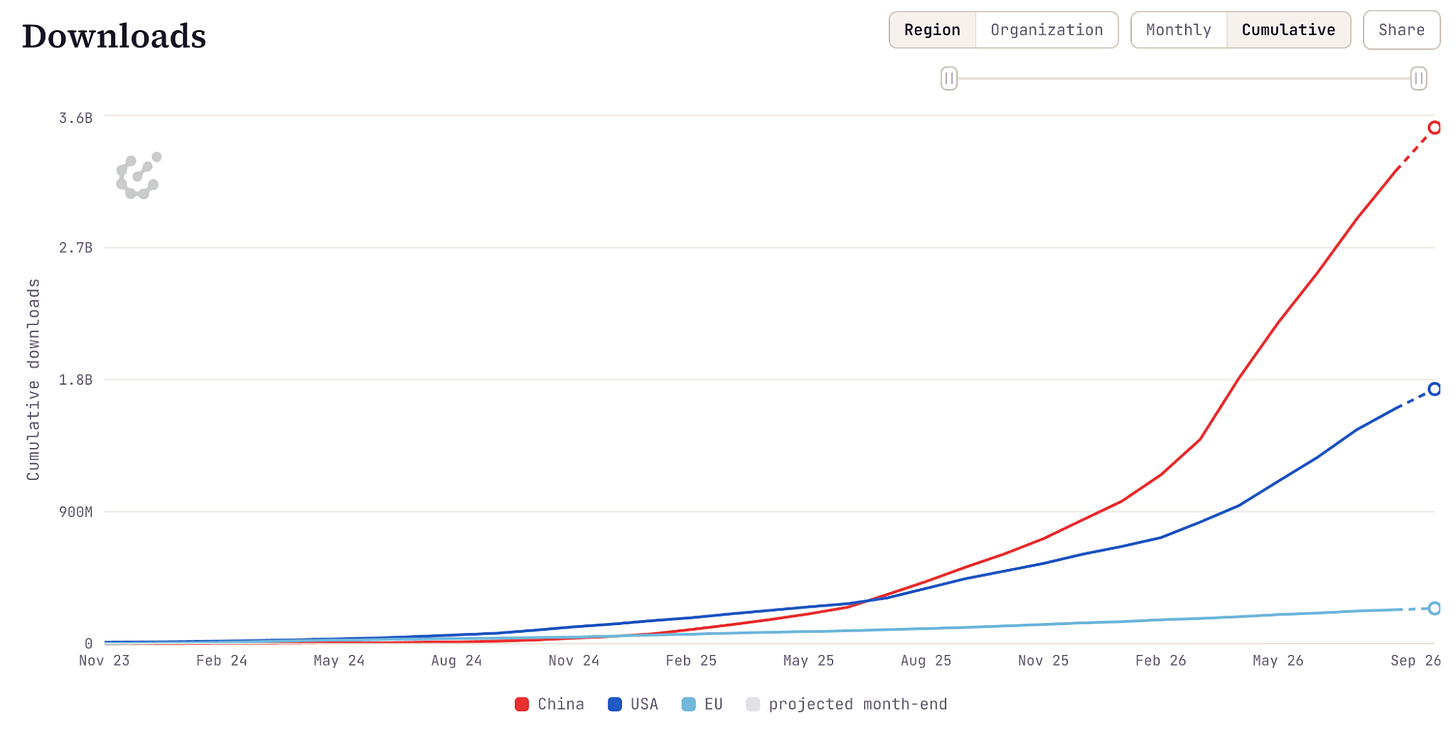
美国早期靠Meta的Llama领先,约18个月前中国在研究与商业任务上超越美国开放权重模型。简单指标Hugging Face下载量显示,中国于2025年7月凭借Qwen成功领先。笔者维护的工具显示,自2025年8月发布美国真正开放模型(ATOM)项目后,中国下载领先增至约16亿,总下载32亿,是美国总量的两倍。
在Artificial Analysis智能指数(AAII)等基准上,中国开放权重模型明显领先。2026年9月14日,前三中国模型为Z.ai的GLM-5.3(45分)、GLM-5.3-Flash(42分)和Moonshot AI的Kimi K3(44分);美国领先模型为Thinking Machines的Inkling和Inkling Small(均26分)、Nvidia Nemotron 3 Ultra(23分)。美国顶级模型2026年6-7月发布,更新不如中国频繁,中国实验室早2-6个月就发布了分数更高的模型(如GLM-5、DeepSeek V4 Pro)。虽有更多美国公司(Arcee AI、Poolside、IBM)入局,但未快速缩小差距。
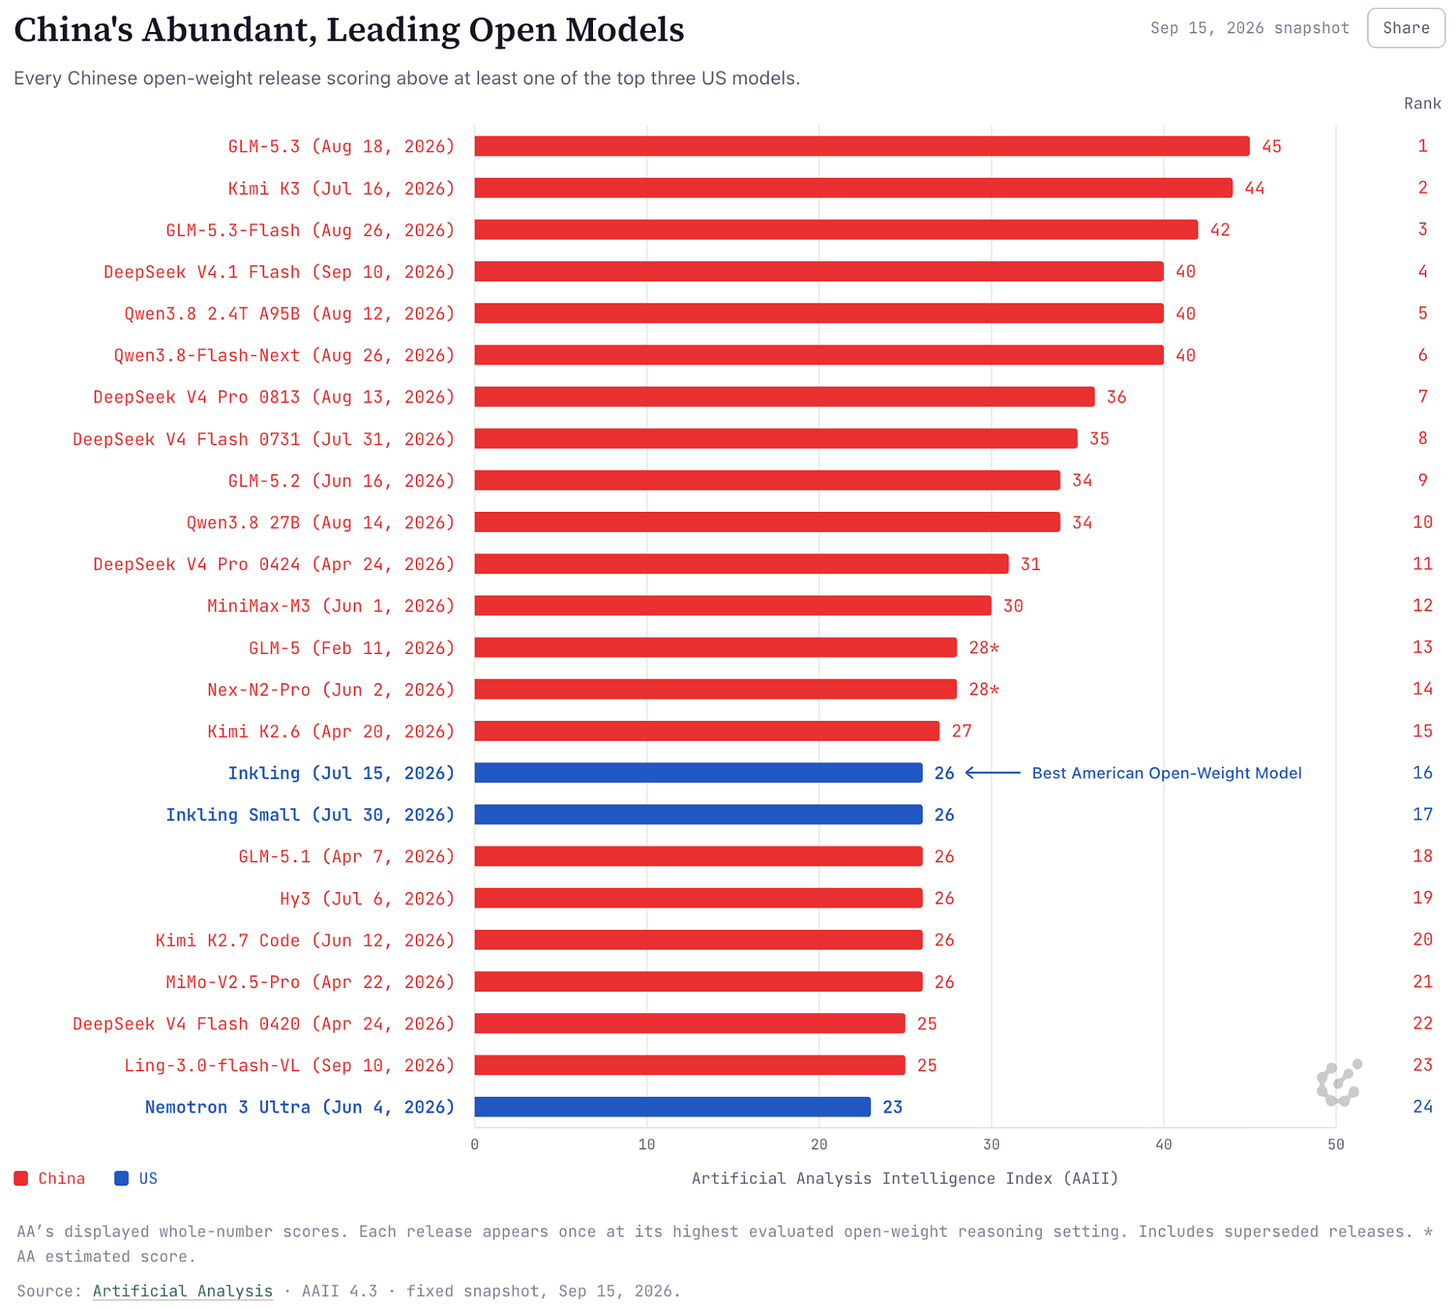
美国在AAII上的顶级开放模型落后15个中国模型。综合看,中国开放权重模型约落后美国闭源前沿2-5个月,美国开放权重模型落后OpenAI和Anthropic约6-9个月。中国实验室在智能体编程等需求明确任务上最接近,在物理、生物等开放科学任务上较远。
中国实验室资源少于美国却能产强模型,原因仍有争议,受工作文化及技术因素影响:发布更快、任务分布较窄,公开基准稍占优。发布快因进度一致,发布即性能快照,晚发布者分数高。但中国模型确实强,且随闭源修补API漏洞(防蒸馏),竞争不会明显减弱。蒸馏在新领域影响大,但非易事造通用强模型;若完全阻止(如KYC),中美差距仅增1-2个月。例如2026年中国实验室迅速转向购买训练数据,年初Moonshot AI和Z.ai偏好内部构建,夏季已开始买前沿数据(智能体RL环境)。
随着中国开放权重模型逼近前沿,及网络安全等风险增长(如OpenAI-HuggingFace事件),监管不确定性上升:持续发布如何促更安全生态?结构性挑战是难阻开放软件落恶意者手。若限制中国最强开放权重模型访问,受挫的是美国企业——HuggingFace曾用中国开放权重模型分析网络攻击,因闭源模型拒绝回答。管理风险常取决于生态准备。开放权重模型成AI扩散必需工具,领先风险及美企依赖中国模型的不平衡,最佳路径是继续投资美国开放模型,以更好协调全球风险并加速国内经济扩散。
2026年开放权重模型兴趣与可行性大增,除Hugging Face外,OpenRouter等平台提供采用对比。OpenRouter是流行推理平台,自2025年1月1日共享数据,周处理token从2025年9月约1T增至当前约80T,中国模型份额从约70%升至超80%。开源编程代理OpenCode上中国模型推理量约95%或更高。
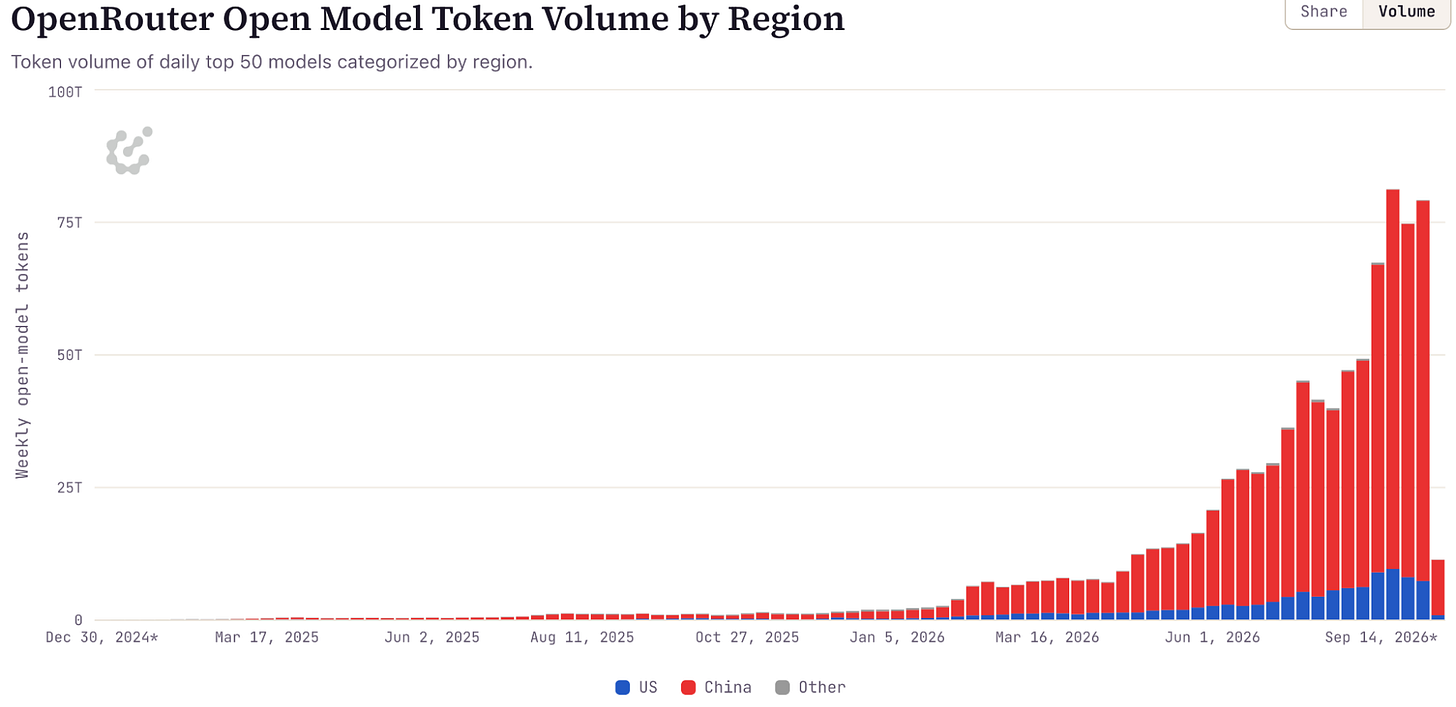
这些开放平台是开放模型使用最佳近似(大量使用在不披露细分的Together AI、Fireworks AI及私有部署)。许多知名公司基于中国开放权重模型:法律代理Harvey、编程代理Cursor、DoorDash用Kimi、Airbnb用Qwen、Perplexity用DeepSeek。大量年轻硅谷初创也如此,以求低成本灵活;美企正与中国实验室签企业协议获使用权,形成新跨境合作。
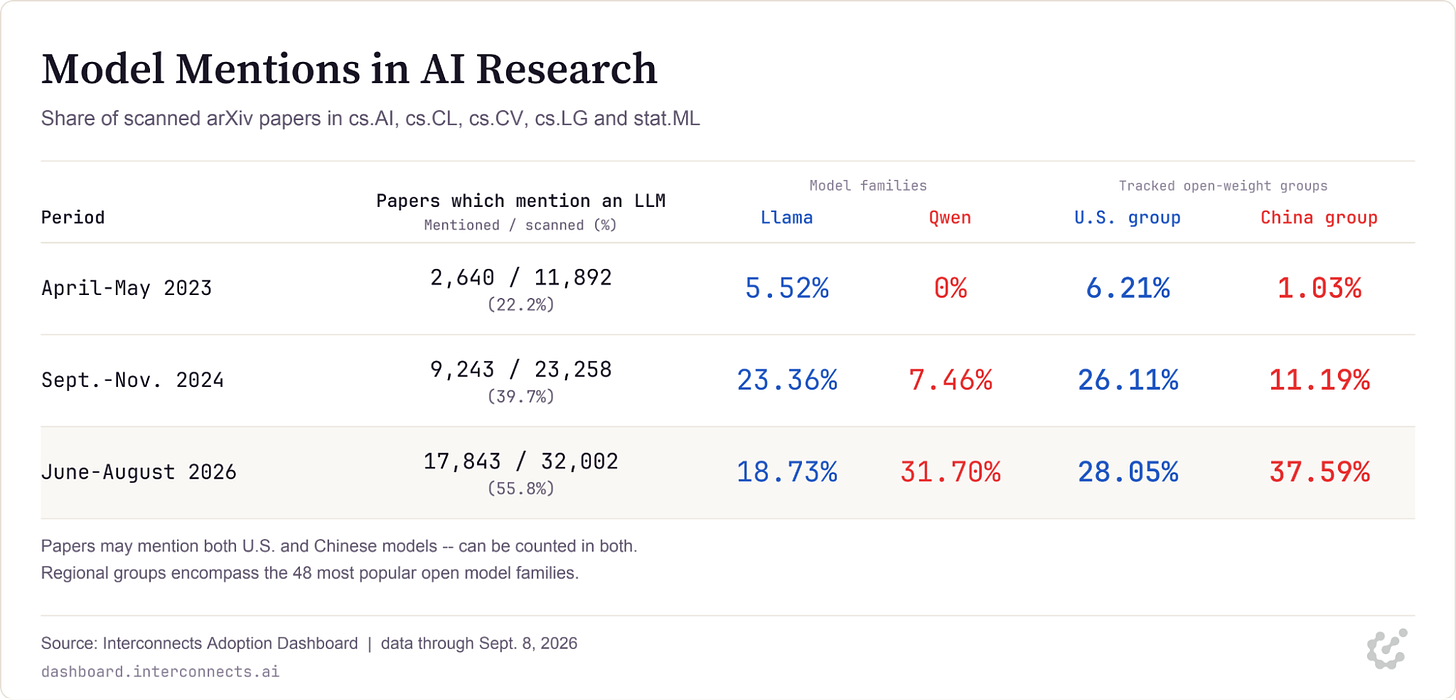
学术界基础层亦如此:多数研究基于阿里Qwen。笔者访华见Qwen团队,其有意维持此采用。扫描arXiv五大ML类显示,提及开放模型论文从2023年1月2%升至2026年9月50%,领导权由美转中。2023年4-5月Llama发布后,约5.5%提Llama、1%提中国模型;2024秋Llama峰值23%、Qwen 7.5%;今Llama仍21%,Qwen升至30%,任何中国开放权重模型超40%(美30%)且续增。
重建美国AI研究地位需努力,但有希望:研究发现能力相当的美国模型采用率更高。去年OpenAI首个开放权重gpt-oss成最被广泛采用模型之一;Google Gemma 4采用数近Qwen小模型;Nvidia Nemotron适中。
2026年开放模型故事是确立经济相关性,可总结为:
- 开放与闭源模型能力差距过去3年减小,约2-5个月,开放权重模型2026解锁巨大市场。
- 开放模型在高价值行业(软件工程、法律、金融服务)使用爆发,出现替代闭源生态;平台Together、OpenRouter等增长,技术员工因速度、低价、可定制、隐私用GLM-5.3等替代Claude/GPT。
- 中国AI公司明显领先开放权重;相比2025 DeepSeek R1震惊,美国恢复位置但投资更多下中国仍产更强模型。
- 蒸馏不能全解释成功:中国最盛用漏洞提取推理,最佳估计仅减差距1-2个月。
- 中国模型尤其Qwen成学术与本地基础层:近月中国开放权重被38% AI论文提及,超美28%,且增长更快,加速美领先下降。
- 开放权重模型进入新风险水平(网络安全),需生态级准备;监管不确定,而许多研究者依赖开放模型因闭源常拒防御性安全或生物研究。
2026中国实验室保持开放权重生态领导者,模型过经济拐点,面对美国活动未被实质挑战,全球采用扩展。此关键期,OpenAI和Anthropic大步前同时呼吁协调管理;少数前沿实验室内发生将预示开放生态未来。开放模型将是世界其他人的基底,加速软件工程,代表软权力与影响。
未来将至需谦卑:未知多,如美中以外使用无好数据;ML训练专家广泛,开放模型跨阈值启用新工作流是何时非是否。集体应理解用此开放智能行善并缓解害。
评论
多数社区成员认可中国开放模型在性价比、数据主权与打破垄断上的优势并欢迎多极化,少数人质疑该声明是利益方宣传,另有人修正术语并尖锐吐槽欧洲缺位。
中国开放模型凭性价比和避免断供风险赢得广泛采用
- DeepSeek、Qwen 等设定了美国开放权重模型难以匹敌的价格性能底线,用户因惧怕美国随时切断服务而转向中国模型,采用驱动力更多是成本而非跑分(认可度:较多人) > DeepSeek 和 Qwen 设立了美国开放权重模型无补贴下无法匹配的成本性能底线,采用靠性价比而非基准(@Transformanshen)
企业采用开放模型是保护数据与主权的必然
- 大企业处理银行流水、供应商 ID 等敏感流程时,绝不能交由闭源云模型,本地开放模型方案成为唯一出路(认可度:较多人) > 大企业应拥有自己的智能,使用开放模型处理敏感信息是不容妥协的方向(@Zaraif13)
中国实验室共享研究比美国安全叙事更科学
- 欢迎中国模型不仅因其打破单极,更因其同步公开研究;反观美国大厂把 AI 包装成国家安全议题以规避监管、维持金融泡沫(认可度:较多人) > 中国实验室不仅放模型还发研究,比用国家安全借口避开监管的贡献更好(@JSR_FDED)
质疑该声明是利益方炮制的宣传话术
- 有评论认为通篇像是模型生成的日常宣传,受益者是卖“开放”叙事的初创和想避开寡头指责的大厂,且面向国会的简报没人真懂(认可度:少数人) > 这不过是模型生成的日常宣传,利好兜售叙事的初创和自称非寡头的巨头(@arel-fgkl)
开放权重与闭源应改称为本地可安装与云专属
- 指出原对比框架有误,部分开放权重许可证并不真正开放,更准确区分在于能否本地部署(认可度:少数人) > 开放权重对闭源的比较是错的,不如叫本地可安装模型和云专属模型(@est)
Meta 的 Llama 策略真正推动了民主化与差距缩小
- 认为 Meta 通过 Llama 开放访问加速了创新,中美模型差距收敛快于预期(认可度:少数人) > Llama 策略改变了格局,民主化了访问并极大加速了创新(@cold_boot)
欧洲在 AI 上零投入却强推监管应予无视
- 尖锐指出欧洲对 AI 发展毫无贡献,只试图域外立法,社区应嘲笑并无视其影响(认可度:少数人) > 欧洲人毫无投入只立规矩,非欧世界该指着我笑然后走开(@avazhi)
有价值的补充
- 文章由 RLHF 书籍作者、AllenAI 员工撰写,该机构属少数真正开源模型的机构(@verdverm)
- 个人实测中国模型性价比极高:用 DeepSeek 前缀缓存配合 Reasonix 可廉价处理海量代码分析,十美元两月未用完;本地 MacBook 跑 Qwen 受带宽限制但能装下大模型(@abalashov)
- 肯定将分析分享给美国领导层与社区的价值,同时有人期望补充 OpenAI 开放模型家族信息(@tamaker @kittikitti)