我一直稳定地使用 xhigh 或 max effort 级别与模型交互,但当我更深入地观察后,我发现绝大多数对该模型的调用实际上几乎未接收到任何思考 token。而当确实出现了耗时较长的思考运行时,这些运行过程也几乎从未达到官方已发布的基准测试水平。
正文
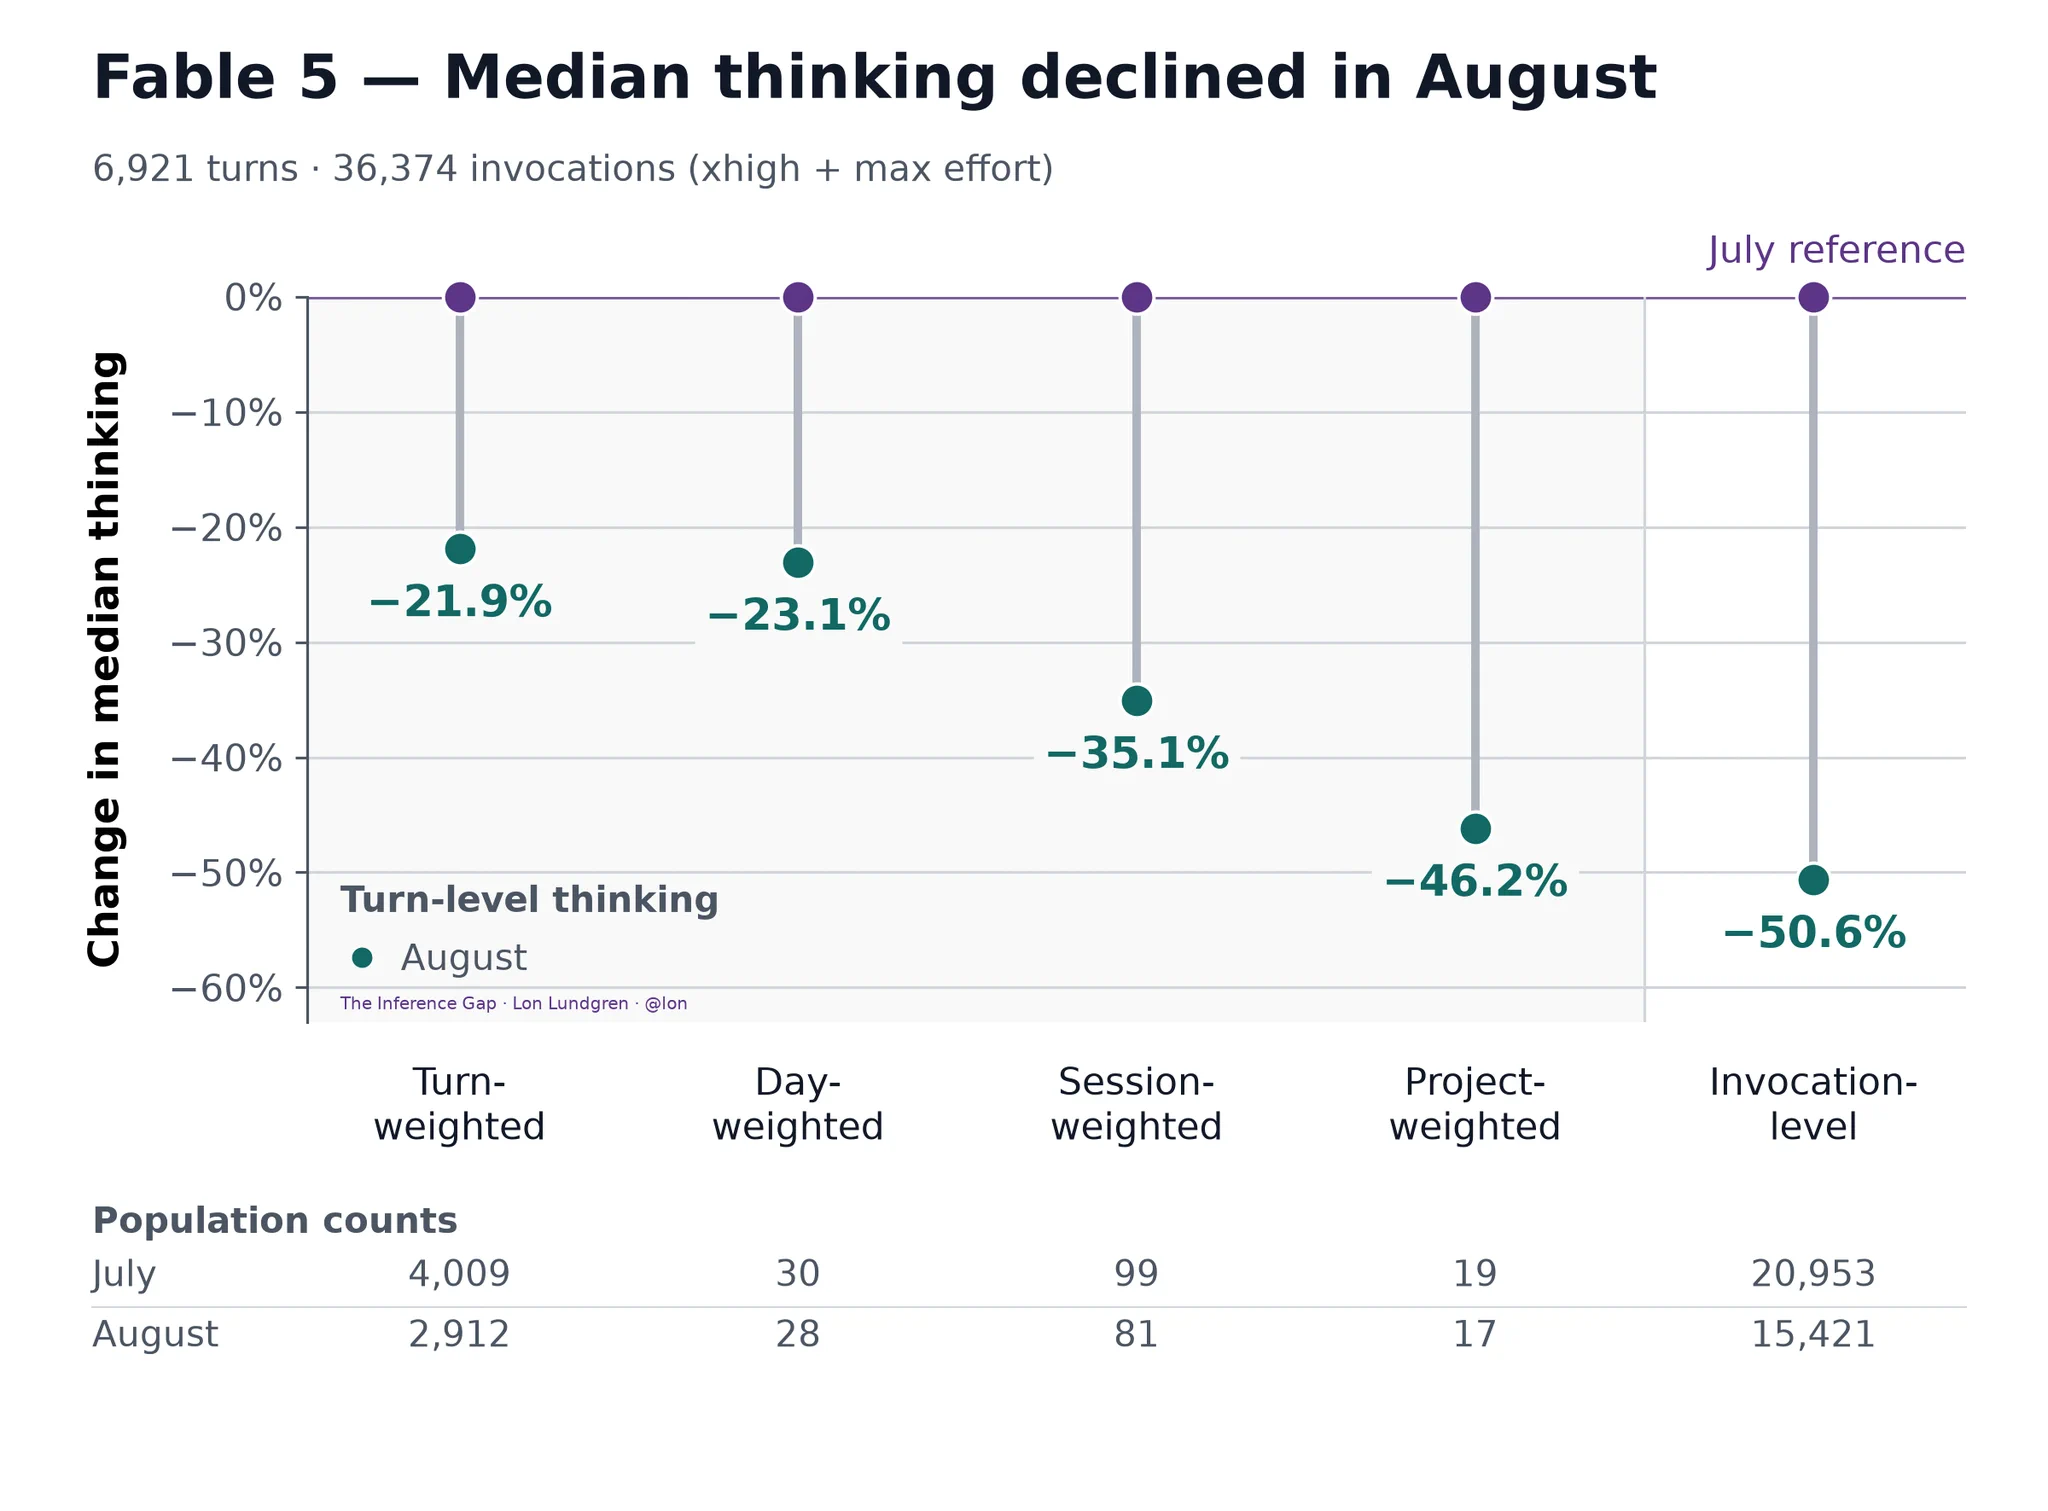
我一直把 effort 档位稳定设在 xhigh 或 max,但往深里查看后发现,绝大多数对模型的调用几乎完全没有分到思考 token。即便偶尔真的出现较长的思考过程,它们也基本从未达到对外公布的基准测试水平。
评论
社区弥漫对模型发布后悄悄降级的质疑与不满,少数人从方法论和跟踪数据出发认为证据薄弱,分歧焦点是厂商是否在借不透明调整持续榨取订阅利润。
认为模型发布后数周内性能明显退化
- 大量用户基于使用经验报告前沿模型(Fable、Opus、GPT、Astra、Gemini)在首发惊艳,几周后因推理算力减少或量化而变笨,简单任务需更多引导,怀疑厂商为省钱自动降级。(较多人) > 用前沿模型久了会发现,从第一周的研究助手到第八周就成了讨好主人的小狗。(@mlmonkey)
- 有人指出真正完整的模型可能只存在于发布初期,后续被削弱,或新账号有临时智力加成,且行业通病不仅限于一家。(较多人)
- 部分人呼吁点名此类“自适应推理骗局”并要求监管介入调查。(较多人)
质疑降级证据不足或源于测量偏差
- 思考 token 不返回客户端,且模型非确定性导致无法复现测试,现有分析多混淆了每日工作负载变化与模型能力波动,难以严谨证明质量下滑。(较多人/技术派) > 日常编码工作的思考 token 不该和极端基准比,这个分析基本无用,确认偏误深。(@Aurornis)
- 有长期跟踪者发现 Claude Code 趋势是用更少 token 做同样或更好,可能是客户端版本调参而非底层模型变化,没找到故意降级证据。(少数人)
认为厂商不透明且应当受监管
- 厂商要求外界透明却对自身推理机制保密,暗中调整模型涉嫌欺诈,应像普通商品一样受度量衡式监管或面临诉讼。(较多人) > 他们要求别人透明,自己却不然,毫不奇怪。(@vb-8448)
视作资源瓶颈与商业策略
- 测试时计算本就可变或物理资源受限,发布营销高峰后悄悄缩减合理;也可能是为制造“新模型更强”的循环假象,反映行业进展停滞与投资者压力。(少数人)
- 另有观点跳脱具体抱怨,指出物理基础设施终将上线,廉价前沿模型终会广泛开放并颠覆经济,当前争议未触及真正潜力。(少数人) > 一旦新数据中心投产,当前前沿模型的廉价广泛接入就会颠覆经济,训练暂停也挡不住。(@bpodgursky)
有价值的补充
- 第三方持续基准测试云模型智能的项目构想存在,但面临变现难和实验室作弊猫鼠游戏。
- 降级可能仅发生在订阅账户而非付费 API,或集中于分布式系统等特定领域用户,需分群数据。
- 共享云式资源争抢类比提示,若不为模型智能设 SLA,用户买到的是“桌子的智能”。