深入软件沙盒大多像踏入未绘制领域,实现好沙盒的部件散落各处,先驱尚未把知识汇成统一世界地图。我在埃米卢亚(Emilua)沙盒支持中积累了一些经验,这里会重复些以免误解。部分 Lua 代码示例需要未发布的 Emilua 0.11,可从仓库开发分支取近期提交。先采用朱利安·廷内斯(Julien Tinnes)和克里斯·埃文斯(Chris Evans)在 2009 年 Hack In The Box Malaysia 给出的非正式定义。
正文
软件沙箱:基础
软件沙箱基本还是一片未探明区域。实现良好沙箱所需的零件散落各处,先驱者还没汇成一张统一地图,给后来者标出安全航线。这里分享我在 Emilua 沙箱支持工作中积累的经验。部分 Lua 示例需要尚未发布的 Emilua 0.11,可从开发分支取近期提交。
先给一个非正式但有用的沙箱定义。Julien Tinnes 和 Chris Evans 在 Hack In The Box Malaysia 2009 上这样定义:
限制进程权限的能力:
- 以编程方式;
- 无需机器上的管理权限;
- 自行决定降权。
这个定义很好用。不过我今天的一些看法与 2009 年不同,尤其是“能不能用超级用户 API”,下面会给出我认为 2025 年更好的做法。
以编程方式降权
操作系统给用户和软件开发者提供不同接口。系统管理员传统上靠文件系统权限隔离服务,比如 UNIX 守护进程。如果允许第三方程序随意修改这些权限,管理员想执行的政策就被架空了。
而且第三方程序会抽象出自己的虚拟世界,UNIX 文件系统权限往往不适合建模这些虚拟世界所需的安全策略。你用 UNIX 权限模式定义谁能看你的 Twitter 时间线、谁能在 Identi.ca 给你发消息吗?文件系统权限不是管理员唯一的限制手段,但同样的道理也适用于其他手段。
进程终究运行在操作系统上,会与内核暴露的资源交互,比如文件。对软件开发者来说,这个接口才重要。Firefox 会运行 DRM 插件,理想情况是让这些第三方插件不能访问 Firefox 能访问的所有文件,通常也就是用户 HOME 目录下的所有文件。setuidgid 这类传统工具帮不上忙,它们也不是给软件开发者用的接口。
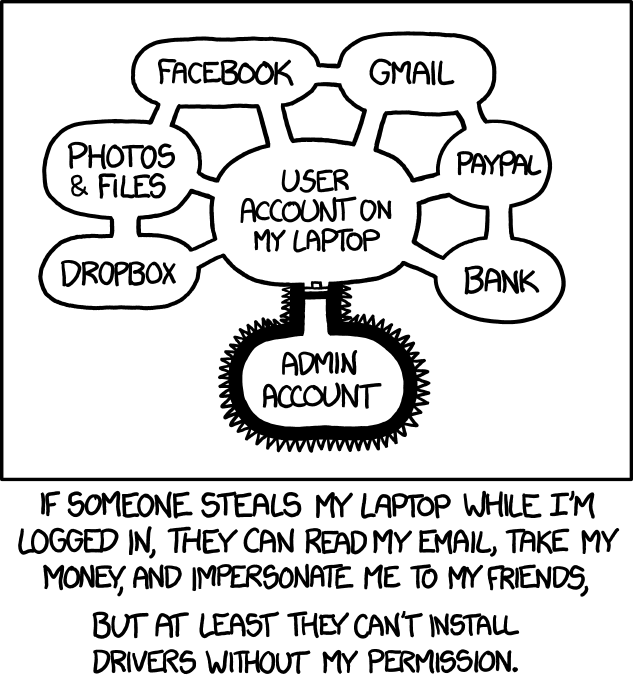
对编程式降权来说,传统 UNIX 接口并不合适。真正在意这个缺口的操作系统会提供超出传统 UNIX 的扩展接口,比如 FreeBSD 的 Capsicum 和 Linux 的 Seccomp。
无需 root 降权
当好的沙箱接口不存在时,程序员会滥用只有超级用户才能用的机制来造沙箱。最典型的是用一个 suid 辅助程序配置 chroot 监狱。
问题很明显:不是所有程序都能这么做。允许任何程序安装 suid 二进制,等于破坏所有安全措施。suid 二进制会临时把权限提升到系统完全管理权。权限只应减少,不应增加,这是最小权限原则。
另一个相关担忧是:不要设计出会指数级扩大内核攻击面的 API。Docker 热潮让 Linux namespaces 流行起来,用来廉价隔离服务。但在嵌套 user namespace 里,进程以超级用户身份运行,原本只对超级用户开放的内核代码路径,现在每个用户都能走。十多年内核代码并不是按这个前提写的。过去已经出过安全问题,以后还会再出。Andy Lutomirski 说过:
我认为,能用
CLONE_NEWUSER在任意网络 namespace 获得CAP_NET_ADMIN,从而访问网络配置 API,是巨大风险。比如非特权用户可以编程 iptables。如果那里没有提权漏洞,我就把帽子吃了。
只要把 user namespaces 限制给受信任的容器化工具,比如 Docker,还可以接受。但 Linux namespaces 对软件沙箱来说是很糟糕的接口。Linux 较新的沙箱接口如 Landlock,被小心设计成不会指数级扩大内核攻击面,以避免 user namespaces 那种灾难。而且限制 namespaces 的新方法仍在开发,长期依赖它们作通用沙箱机制是坏赌注。
Emilua 头几年只研究 Linux namespaces。经历很多挫折后,重点转向了别的方案。如今 Emilua 仍支持 Linux namespaces,但意图是用于容器化工具。要在 Emilua 里正确沙箱化,会用其他机制。
自行决定降权
沙箱也可以定义为:
一个受限、受控的执行环境,防止潜在恶意软件访问除被授权之外的任何系统资源。
—— CNSS 术语表 2022
对于什么代码才算沙箱,并没有真正共识,定义通常很松。这些定义并不要求前面讨论的属性。所以另一个术语会更有用。J. Tinnes 建议叫“自行决定降权”。这就是下面要讨论的沙箱类型。它不取代系统管理政策,而是与之互补,应一起采用。
实践中的沙箱:进程
我们说的沙箱就是自行决定降权。怎么从非沙箱程序走到沙箱程序?在当今所有主流操作系统上,权限边界都在进程层。凭证与进程关联,内核据此决定进程能否用环境授权获取新资源。
Linux 实际上把凭证关联在线程层,但线程层设计行不通,所以 glibc 会额外工作,即使内核马虎,也要在线程间同步凭证。GNOME 开发者以为可以在线程层工作,结果 CVE-2023-43641 证明他们错了。
Adam Langley 描述过一种理论上可行的线程层机制:每个不受信任的线程有一个受信任的辅助线程,运行在同一进程里。但这对受信任代码来说环境非常敌对:它只能相信 CPU 寄存器,所有内存都必须视为敌对。C 代码会溢到栈上,也可能在栈上传参,所以受信任线程的代码必须用汇编小心编写。受信任线程可以通过 socket pair 接收不受信任线程的系统调用请求,验证系统调用号并代其执行。只使用 CPU 寄存器,并拒绝让不受信任代码用 mmap、mprotect 等不安全操作 VM,就能阻止逃逸。
别理论化其他设计了。今天只有进程。把程序分隔成独立进程后,下一步是:
- 给每个 compartment,也就是每个进程,分配不同权限。
- 处理 compartment 之间的通信。
FreeBSD Capsicum 的研究者十多年前就有正确的心智模型:
分隔化应用开发必然是分布式应用开发,软件组件运行在不同进程,并通过消息传递通信。
—— Capsicum: practical capabilities for UNIX,Robert N. M. Watson、Jonathan Anderson、Ben Laurie、Kris Kennaway
每个平台降权手段不同,先跳过,专注分布式应用开发。
Actor 模型与基于能力的安全
Actor 模型是分布式系统最知名的模式之一,Erlang 大概是最标志性的用户。Erlang 的兴趣在高可用和容错,但我们仍可看看这个广泛使用的模型。
只列我们关心的要点:
- Actor 能管理自己的内部状态。
- Actor 能生成其他 actor。
- Actor 能向其他 actor 发消息。
- Actor 能在消息中包含其他 actor 的地址。
落到编程语言或框架的设计选择上:
- 有创建 actor 的函数,返回新 actor 的地址。
- 地址可用于发消息。
- 地址也可作为消息,或消息的一部分。
- 有接收消息的函数,读取排给调用 actor 的队列。
- 可以取得当前 actor 的地址。
- Actor 之间不共享内存。
- Actor 不会与自身并行运行。若它正在线程 A 运行,就不能同时在线程 B 运行。但它可以从一个线程跳到另一个线程,工作窃取式线程任务调度器就是这样。Boost.Asio 把这种性质称为 strands。
在 Emilua 里,这对应三个函数:spawn_vm(module) -> actor、actor.send(msg)、inbox.receive() -> msg。学会三个函数就能按 actor 模型编程。
若用 actor 模型做沙箱,每个进程就是一个 actor。UNIX domain socket 可做 actor 消息。生成新 actor 时设置 socket 继承,以便和它通信。socket 就是 actor 地址。我们还需要能在消息中包含其他 actor 的地址,这也被覆盖了,因为文件描述符可以通过 UNIX domain socket 发送。inbox 文件描述符永远不会发给其他 actor,也就是一个 MPSC 通道。
Emilua 有多种 actor 模型实现,所以生成新 actor 时要显式指示用子进程:spawn_vm{ module = 'module1', subprocess = {} }。
这个设计还解决了另一个沙箱问题:把资源交给受限进程。“一切皆文件描述符”是 UNIX 文化里最有名的说法之一。如果连文件描述符都能发送,那么可用于沙箱进程的资源范围就很广,例如:
- 文件。
- 目录。
- 管道。
- 套接字。
- 设备节点,比如
/dev/random、GPU 通信。 - 共享内存,memfd。
- 进程句柄,pidfd、procdesc。
- 同步对象,比如 eventfd。
- eBPF 程序。
这些正是沙箱程序时要关心的资源,也是安全模型要考虑的资源。如果能证明不会把文件描述符泄漏给错误的 actor,就可以用 actor 模型。基于能力的安全正好解决这个问题。甚至还有同时基于 actor 模型和能力安全的语言:Pony。
要结合两个模型,只差一个小缺口:能力安全假设令牌不可伪造,而 actor 模型使用地址,地址可伪造。这里用通道代替地址已经解决了。API 不变,没人会注意到。现在可以用能力来推理:
- actor A 是否可能有效访问资源 X?
- 怎样设计布局,让任何沙箱 actor 都不可能同时访问文件和套接字?
至于把文件描述符当能力,经验法则是避免 ioctl,后面再谈。
Actor 模型简单但强大。能在消息里包含其他 actor 地址,意味着拓扑可以任意变化。我自己的多数项目只限树形拓扑,但一旦树形不合适,换成别的拓扑也很容易。至今没遇到不能用 actor 建模的沙箱应用。
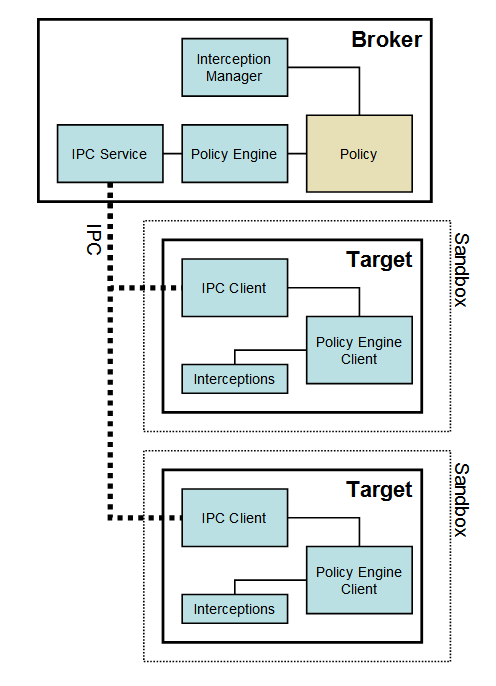
如果需要分布式应用的开发指南,actor 模型有几十年的研发积累。
文件描述符作为能力
消息问题已用 actor 模型解决,现在回到沙箱安全模型。对象要建模成能力,还需要其他属性。能力不只是资源引用,也包含相关访问权。拥有能力就等于有权执行操作。因此要考虑:
- 文件描述符能否建模为能力?
- 用文件描述符作能力要采取什么预防?
一般 UNIX 系统只在创建新文件描述符时做权限检查,使用已有文件描述符时不检查。这个行为与能力兼容。比如以 root 打开 /root 会成功,普通用户得到 Permission denied。以 root 运行 grep /etc/shadow 成功,普通用户被拒。但让非特权用户运行 grep,却继承 root 打开的 fd,它就能读取 /etc/shadow。因为 UNIX 一般不对已有 fd 操作做权限检查。
新内核版本可能引入新系统调用打破惯例。但 suid 二进制从 UNIX 早期就存在,这个遗产会长期约束内核开发者,让他们别破坏惯例。suid 二进制只允许运行管理员信任的程序,比如 su。用简单的 fd 继承就能骗 suid 二进制读写我们给的 fd。如果写者进程的凭证对系统安全重要,所有 UNIX 系统早就完蛋了。所以新接口总设计成写者凭证无关。
近期例子:Linux 新挂载系统调用最初的补丁被拒,因为某些操作用 write 时拿调用者凭证做权限检查。后来改用新系统调用 fsconfig,补丁才被接受。
内核开发者会尊重这个惯例,无论发行版是否允许 suid 二进制。即使完全禁止 suid,也可以假设攻击者不能借我们的进程当代理来获得新权限、执行危险写操作。攻击者直接写那个 fd,效果一样。
例外是 ioctl。对不受信任进程送来的 fd 执行 ioctl 总是危险。Emilua 依赖 Boost.Asio,Boost.Asio 以前在不该用 FIONBIO 时用了。经过邮件交流,我说服 Christopher Kohlhoff 改掉,Boost 1.86 起会做对。顺便说,isatty() 在 Linux 上也是用 ioctl 实现的,所以对非标准操作要非常小心。
确实可以把文件描述符建模为能力,但我们不是第一个得出这个结论的。
FreeBSD 的 Capsicum
Capsicum 是更好支持“文件描述符即能力”的接口,从 FreeBSD 9.0 起就是系统一部分。它提供的设施之一是 cap_enter。cap_enter 通过彻底禁用环境授权来降权。
在 Emilua 里,生成 actor 时可在 subprocess.init 里执行 C.cap_enter()。运行时会在尝试初始化复杂库或获取系统资源之前运行这段 Lua。一次调用,权限就降了。所有系统访问都必须通过已打开的文件描述符。如果还没有某个资源,唯一获取方式是 inbox。尝试打开文件会失败,尝试连接套接字也会失败,因为环境授权被禁用。Capsicum 的美妙之处在于:用名字引用资源的路本身不可用了,所以外部资源被拒绝。
Capsicum 研究发布时还给出了一张表:
| 操作系统 | 模型 | 行数 | 描述 |
| --- | --- | --- | --- |
| Windows | ACL | 22350 | Windows ACL 和 SID |
| Linux | chroot | 605 | setuid root 辅助程序沙箱化 renderer |
| Mac OS X | Seatbelt | 560 | 基于路径的 MAC 沙箱 |
| Linux | SELinux | 200 | 受限沙箱 type enforcement 域 |
| Linux | seccomp | 11301 | seccomp 和用户态系统调用包装 |
| FreeBSD | Capsicum | 100 | 使用 cap_enter 的 Capsicum 沙箱 |
研究者当时修改 Chromium 来使用 Capsicum,并比较各机制所需的工作量。Capsicum 只要 100 行,seccomp 要 11301 行,Windows 要 22350 行。其他机制并没有显著限制沙箱,可以忽略。如果一生只学一种沙箱机制,那应该是 Capsicum。至今我还没见过比 Capsicum 更好的沙箱机制。
Capsicum 还提供文件描述符的细粒度访问控制。比如可以让一个进程等待信号量,但不允许它 post。文件描述符通常创建时带全部权限,之后可用 cap_rights_limit 减少权限。
在 Capsicum 模式下 open() 不工作,但 openat() 可以,而且 Capsicum 会确保相对路径只在给定目录 fd 的层级下解析。要是能强制 Linux 系统调用总带上 RESOLVE_BENEATH 就好了……也许可以?后面再回到这个话题。
我用 Capsicum 没遇到太多问题,唯一抱怨很久前也修了。这个系统极其简单又强大。它会启发生余下所有沙箱设计,无论什么操作系统。
UNIX 上的非阻塞 IO:很糟
从沙箱收到文件描述符后,就要操作它。如果马虎,线程会阻塞。要避免阻塞操作,以防某种 DoS。UNIX 上非阻塞 IO 的混乱由来已久。这里不展开异步 IO,只列要点:
- 按 POSIX,
close()可能阻塞。 - 据说 Linux 上
close()总会成功,不必查错。 - 如果“慢关闭”文件成问题,可能需要专门线程跑
close()。 - 用
fstat检查收到的文件描述符是不是 socket。 - 对 socket,
recv()用MSG_DONTWAIT。Boost.Asio 仍然做错,但我没时间发修复。 - 对非 socket,用 proactor,也就是完成事件而非就绪事件,来做 IO,比如 Linux 的 io_uring、FreeBSD 的 POSIX AIO。
- FreeBSD 现在可用
aio_read2()加AIO_OP2_FOFFSET做无偏移读。其他方法可能返回ENOTCAPABLE。Boost.Asio 也做错,我也没时间修。 - Linux 的 io_uring 被广泛不信任并禁用。因此如果 fd 来自沙箱进程,也许直接拒绝非 socket IO。
现在应该明白有两种用例:
- 受信任进程创建资源,也就是文件描述符,发给不受信任的沙箱进程。
- 不受信任的沙箱进程创建资源,发到别处。
如果 fd 由受信任进程创建,可选手段更多。但 O_NONBLOCK 这类状态在所有 fd 副本间共享,一旦 fd 到达第一个沙箱进程就会成问题。Capsicum 至少可以禁止 F_SETFL,稍微缓解,但这只适用于 FreeBSD。
沙箱化现有代码
现在工具应该够沙箱化未来代码了。但我们为什么要沙箱化代码?项目会长大,直到无法确保代码无 bug。几十个模块里一个模块出小 bug,被黑客利用后不应等于系统完全沦陷。损害应被限制。外部操作系统工具实施的安全策略只能在程序或用户级工作。程序仍会完全沦陷,黑客仍能访问程序有权访问的所有数据和凭证。
当程序处理的数据可以独立处理时,就有机会更安全。如果能在操作系统上以不同用户运行多个程序实例,就能用现有安全方案。但如果“把固定数据分给固定用户”不适合项目,就需要更复杂或定制的方案。用户关系模糊、项目又要求动态策略时,就可能需要沙箱。
经验法则:每个 shell 都应有沙箱。shell 是坐在人类操作者和某个虚拟世界之间的膜。平板、手机、笔记本显示图形 shell,用来和程序、窗口、文件交互。服务器用文本 shell。Web 浏览器则是 www 世界的 shell。
Firefox 和 Chrome 可能是你知道的唯一使用自行决定降权的软件。它们毕竟是 shell,所以沙箱对它们重要,而且它们资金充足。沙箱过去非常昂贵,尤其 FreeBSD 之外。但它们不该是唯一内建沙箱的软件。以 Telegram 为例,一个正确的媒体解析 bug 就可能让黑客访问我的全部聊天记录。我儿子什么时候放学?我信任谁用我的信用卡?我什么时候旅行让房子没人?这些只是 Telegram 缺沙箱可能造成损害的几个例子。不只 Telegram,每个即时通讯软件都该用沙箱。媒体解析应始终在专用沙箱里做。
第一步是现实工程:不要重写所有代码。前面学的技巧仍有用,但从现在起要处理现有现实代码。Capsicum 用户把“在沙箱中运行未修改代码”叫 oblivious sandboxing。这类技术通常与自行决定降权无关,也不能解决刚提的问题。但可以在同一项目里结合两种方法,所以仍值得研究。
实现 oblivious sandboxing 要看的地方很明显:环境授权函数。Super Capsicumizer 9000 等项目用 LD_PRELOAD 注入动态库,拦截环境授权调用。这技术不新,fakeroot 已经用了几十年。
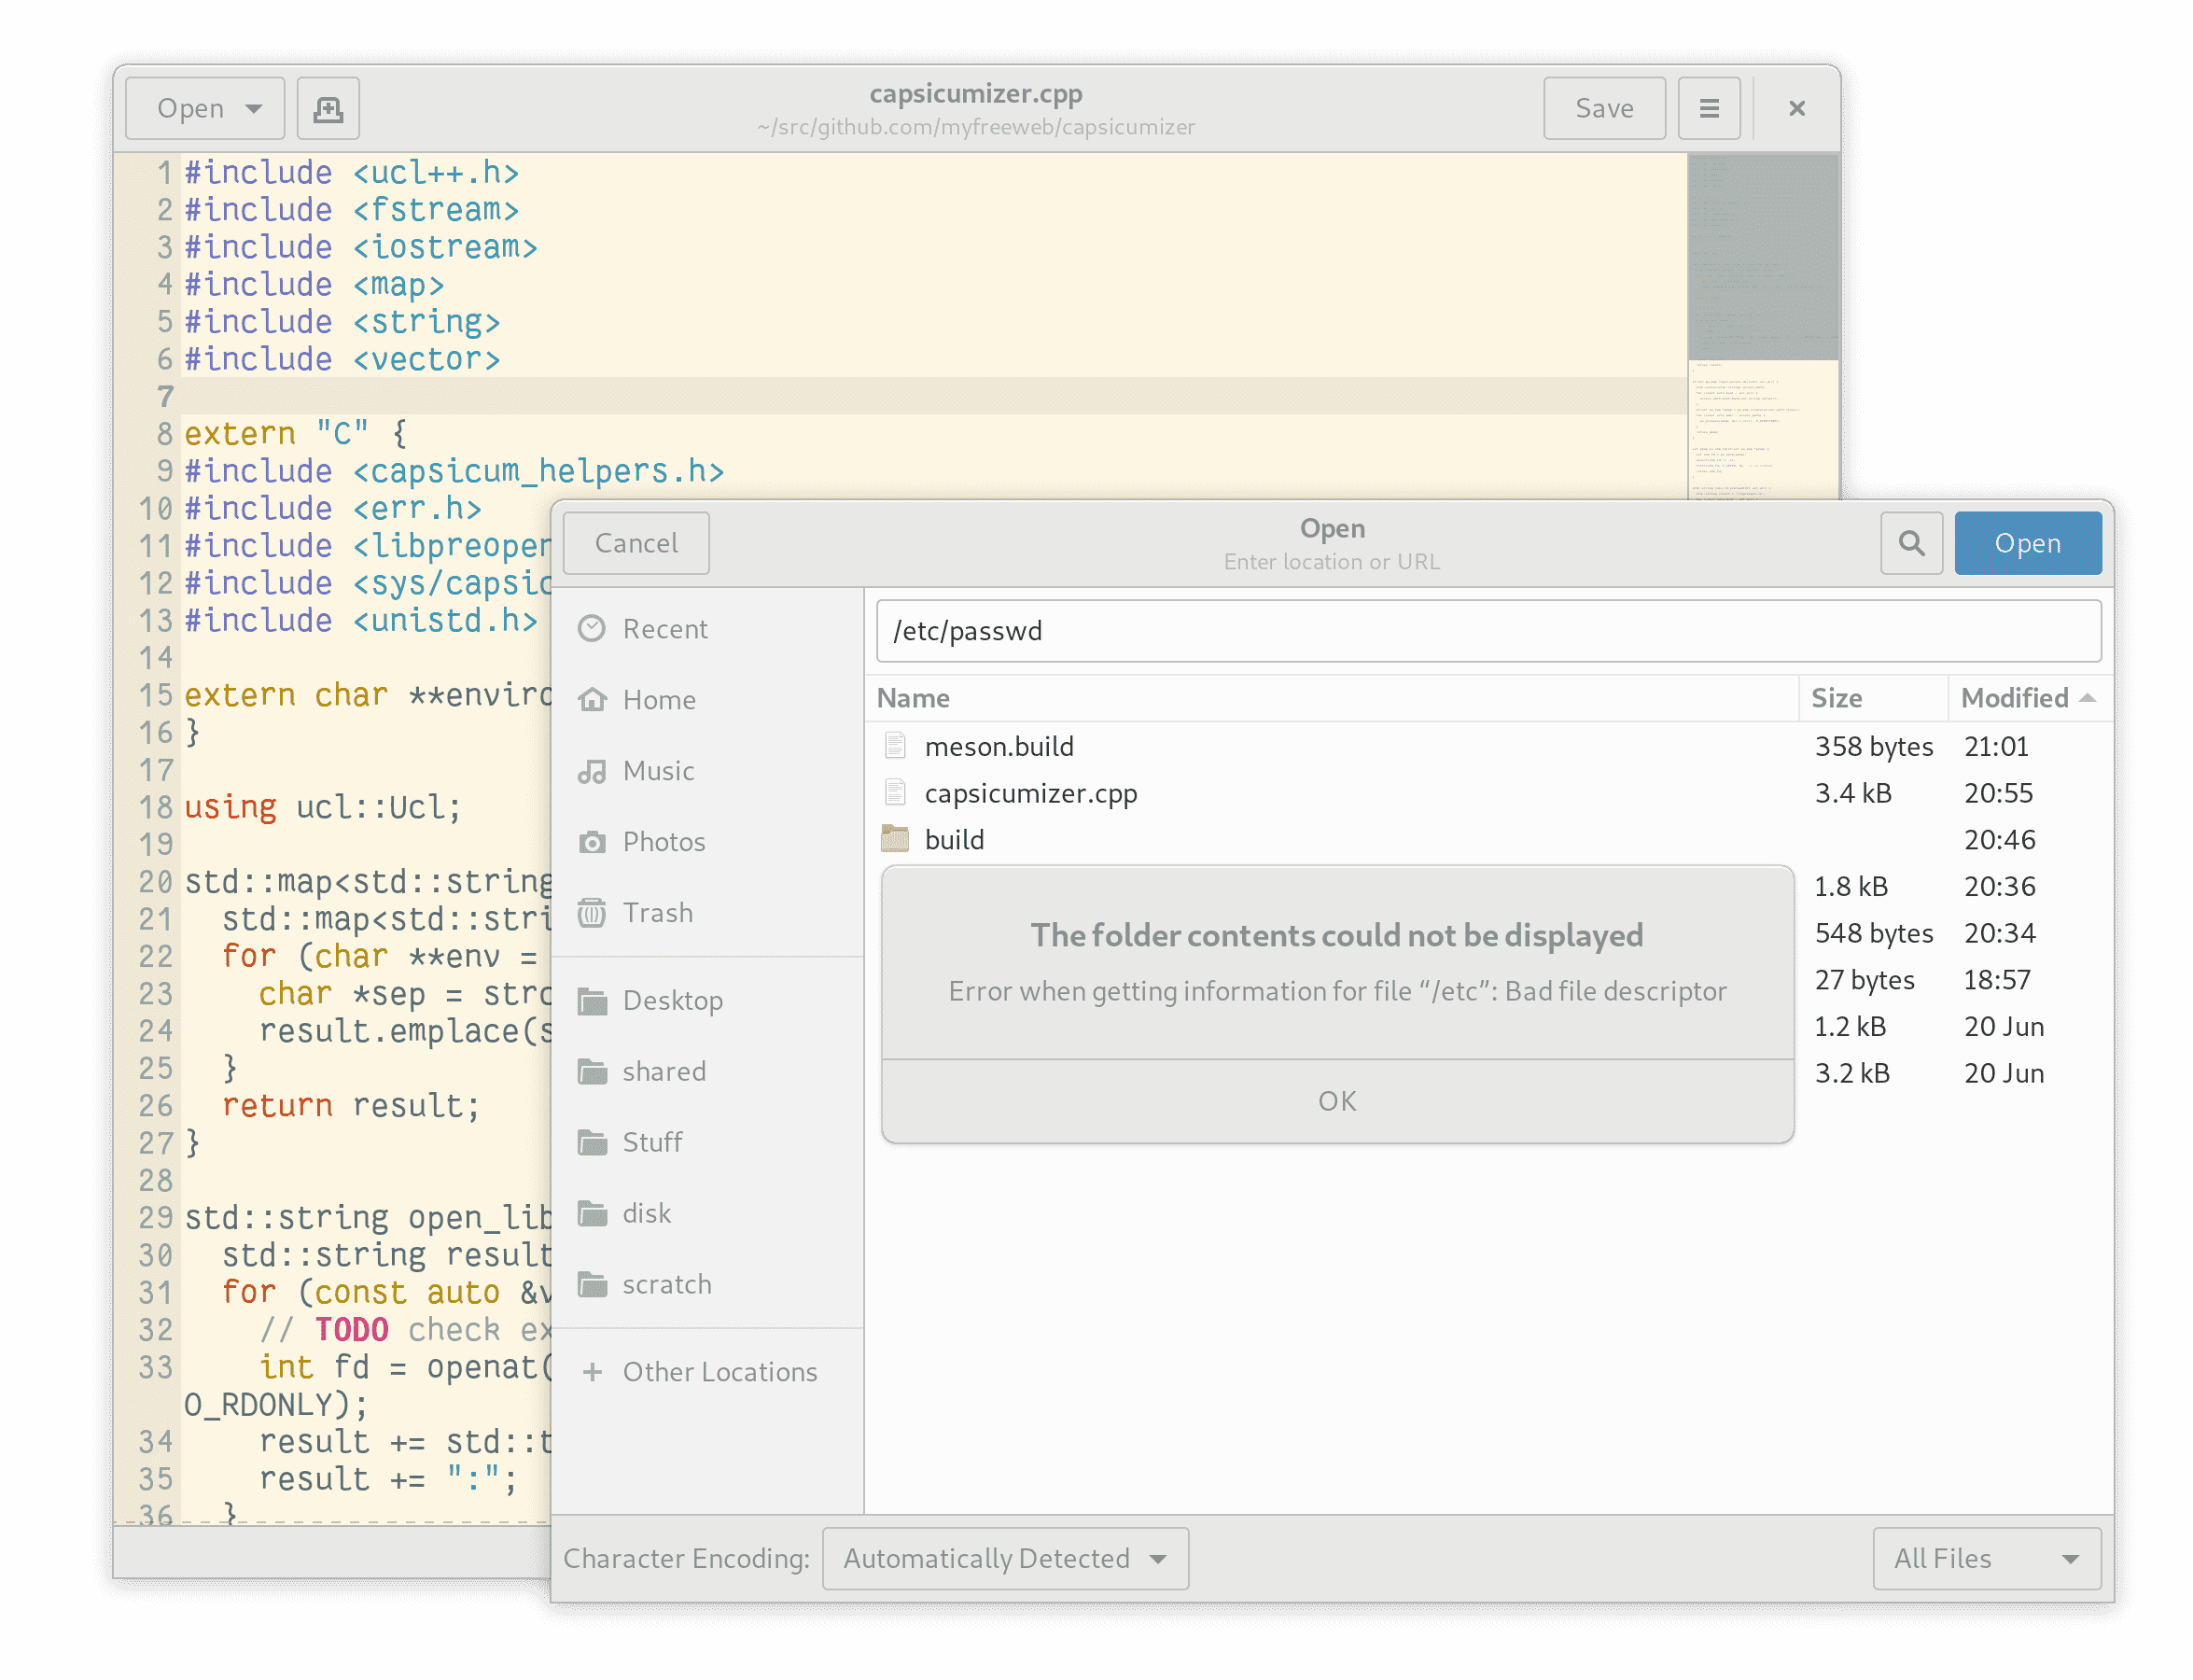
Super Capsicumizer 9000 是一个很小团队拼出来的实验,却成功打开了基于复杂库、变更历史很长的旧软件。这很有希望:单个程序员只拦截几个环境授权函数,也许就能成功运行遗留代码。
程序员几乎从不直接做系统调用,而是靠 libc 代劳。所以这个方法才有效。只要写出想拦截的 libc 函数定义。如果动态链接 libc,你的函数会先加载。如果静态链接 libc,libc 符号往往是弱符号,静态链接器看到你的定义后会把它丢掉。Emilua 在 Linux 和 FreeBSD 上用这个方法支持动态和静态可执行文件。至今 getaddrinfo 是唯一缺少弱符号属性的环境授权函数。相关 bug 报告在 sourceware 32509 和 FreeBSD 283528。
下一步是选拦截哪些函数。FreeBSD 的 libcasper 函数是好候选。但出于某种原因,libcasper 不拦截它想替换的函数,所以要改名称和参数;libcasper 函数总会多一个参数。另一个灵感来源是 Super Capsicumizer 9000 用的 libpreopen。多数情况下,即使复杂项目也只需拦截少数函数。
Chromium renderer 需要很少权限。它们需要访问 fontconfig 找系统字体,并打开字体文件。
Emilua 0.11 把这些细节抽象成 libc_service 模块。示例里覆盖 open,当子进程尝试打开 /dev/null 时返回伪造的文件描述符。真正的沙箱设置被省略。示例还预填代码缓存,让新子进程不去文件系统查询要执行的 Lua 代码。
Emilua 后台用 UNIX socket 在两个进程间通信。这样可以实现完全动态的安全策略。比如用 Telegram 的 tdlib 实现自己的客户端,可以规定:
- 只把名称查询解析到
pluto.web.telegram.org。 - 只允许连接前面步骤解析出的 IP 地址。
发到沙箱侧执行的小 Lua 脚本还能在调用点做简单修正,进一步拓宽用例。比如沙箱代码打开连接到 /tmp/.X11-unix/X0 的 GUI 时,可以发送一个新 fd 到无关的显示服务器,并在调用点用 dup2 替换原 socket。实际上可以做到。示例启动 Xephyr,用 libc_service 覆盖 connect_unix,当 xterm 连接 /tmp/.X11-unix/X0 时,实际连到 Xephyr 并 dup2。这也显示 Emilua 能用 LD_PRELOAD 对 xterm 这类现有程序做 libc 拦截。
另一个可能有用的方法是在安全策略里用 kcmp。这样能按文件描述符实施不同子策略,进一步提高粒度。
现在还可以在 Linux 上拦截 openat(),让它像 FreeBSD 能力模式那样工作,但照常要禁止真正的系统调用。示例中覆盖 openat,给 flags 加上 resolve_beneath,再通过 dirfd:openat 打开。这些技巧可能已经超过你需要,但还有几个技巧可分享。
沙箱化原生插件
沙箱威胁模型里的常见主题是:最初受信任的代码被攻陷后会变恶意。比如我们可能相信 ffmpeg 开发者没有后门,但 ffmpeg 很复杂,合法 bug 潜伏其中,有些可能被黑客利用。这时可以把 ffmpeg 作为库导入,只在对外部数据调用 ffmpeg 函数前设好沙箱。
但如果假设代码从一开始就被攻陷呢?以 Telegram 的 tdlib 为例。假设你完全不信任 tdlib。在这种威胁模型下,连加载库都危险。首先要在安全环境里构建 tdlib,比如 FreeBSD jail 或 Linux namespace。构建好插件后,进入下一挑战。
如果禁用环境授权来沙箱化代码,dlopen() 会无法访问文件系统。可以改用文件描述符来 dlopen。FreeBSD 用 fdlopen。Linux 可以传 /proc/self/fd/ 路径,只要不关闭 fd,避免路径被另一个插件重用,因为 glibc 会按路径去重插件。不完美,但算起点。
前面见过代码缓存预填,让 Emilua 策略避免文件系统查询。插件也类似,Emilua 暴露 native_modules_cache 来预填原生插件缓存。插件最大的问题是可能依赖尚未加载的动态库,dlopen 会失败。可以试前面 libc 服务的变通办法,但有更干净的方案。Linux 可直接用 Landlock,而 /proc/self/fd/ 技巧本来也需要 Landlock。FreeBSD 可用 rtld_set_var 和 LIBRARY_PATH_FDS。
tdlib 不需要担心这些,代码会简单些。但问题来了:如果不信任 tdlib,为什么还要把数据托付给它?要评估威胁模型是否合理。对 tdlib 来说,我们并没有给 Telegram 开发者他们没有的东西,也就是 Telegram 服务器上的数据。在插件里运行 tdlib,是防止 Telegram 公司无限制访问我们系统中的数据。tdlib 的答案也许简单,但真正的教训是:评估威胁模型是否合理。
另一个故事:Linux 内核能加载压缩 initramfs。即使内核用满是有名漏洞的、没人维护的库来解压,也完全没关系,因为我们只对受信任用户生成的数据用这个库。如果对手能控制我们加载的 initramfs,那即使解压库零漏洞,他也能造成任意损害。但如果库被后门,故事就完全不同。有时,由可信任的人写的可审计代码,比由不确定能否信任的人写的“更好”代码更重要。
用 Seccomp 降权
这一节一直拖到最后,因为它很糟。Seccomp 不是自行决定降权的好机制。它是操作系统加固的好机制。Seccomp 是基于 BPF 的简单可编程系统调用过滤。BPF 程序必须为进程尝试的每个系统调用选择动作:
SECCOMP_RET_KILL_PROCESSSECCOMP_RET_KILL_THREADSECCOMP_RET_TRAPSECCOMP_RET_ERRNOSECCOMP_RET_USER_NOTIFSECCOMP_RET_TRACESECCOMP_RET_LOGSECCOMP_RET_ALLOW
这个机制可以用来拒绝环境授权,比如用 SECCOMP_RET_ERRNO 禁止按名字操作的系统调用,如 open、bind。禁用环境授权后,进程就被沙箱化,可以用前面的分隔化应用开发经验。可以实现白名单或黑名单。实现系统调用黑名单的项目有 LXC 的 common.seccomp、Flatpak 的 issue 和 Flatpak-run.c。
黑名单的问题众所周知。新内核会加新系统调用。今天不知道明天会加什么,也不知道明天的系统调用是否会破坏今天的政策。Seccomp 的问题更糟。Linux 允许多架构系统,系统调用编号在不同架构间差异很大。即使你在 x86-64 程序里阻止 acct,被攻陷的沙箱也能运行 x86 可执行文件绕过过滤。Linux 还能把问题弄得更糟:
arch字段并非对所有调用约定唯一。x86-64 ABI 和 x32 ABI 都使用AUDIT_ARCH_X86_64,运行在同一处理器上。系统调用号里的__X32_SYSCALL_BIT掩码用来区分两者。这意味着策略要么拒绝所有带X32_SYSCALL_BIT的系统调用,要么必须同时识别带和不带该位的系统调用。只按nr拒绝、不包含带X32_SYSCALL_BIT的列表,可以被恶意程序设置该位绕过。—— seccomp(2)
即使迁移到白名单,也会被这些实现细节困扰。基于白名单的项目有 Moby 的 default.json、Podman 的 seccomp.json、GNOME localsearch 的 tracker-seccomp.c、Android bionic 的 seccomp_policy.cpp。
实现自己的 seccomp 策略时,还会遇到另一个问题:Linux 系统调用的参数顺序在各架构间会变。所以 Docker 对 clone 要用多条规则。为什么我们必须成为 Linux 系统调用约定专家,才能做 FreeBSD 用户调用 cap_enter() 十秒完成的事?欢迎来到 Linux。
好消息是,理论上可以实现一个库,只用一个函数禁用环境授权,然后大家都用。我有一些实现想法,但至今没有客户对这个感兴趣,同时我也忙别的项目。
还有一个注意事项。Linux 用户态太依赖文件系统。即使为了兼容遗留代码拦截 open,嵌套沙箱时遗留代码访问 /proc/self 仍会失败。最好允许 open,用 Landlock 过滤文件系统访问。现在的问题是:如果进程能用不同 mode 重新打开 /proc/self/fd/,文件描述符就不能建模为能力。Landlock 开发者有长期目标,想暴露与 Capsicum 兼容的能力,也许未来有解。
Seccomp 的复杂性可能让分隔化应用开发者灰心,但看 Linux namespaces 会更糟。Linux 上,Seccomp + Landlock 就是现有方案。
用 Kafel 简化 Seccomp
Kafel 是一种语言和库,用于指定系统调用过滤策略。策略会编译成 BPF 代码,供 seccomp-filter 使用。
Kafel 是我寻找过程中最有希望复用 Seccomp 策略的项目。用 Kafel,我定义了几组策略。这些策略受 Docker 默认 profile 影响,并做了进一步定制:避免需要 root 的系统调用,因为策略主要给非特权用户用,不是给内部有 root 的容器用;避免很少使用、又能被桌面应用用来做更多指纹识别的系统调用;并按 systemd seccomp 过滤集和 OpenBSD pledge 的类别拆分。
策略分成这些组:Aio;BasicIo;Clock;CompatX86、CompatDB32、CompatSystemd、CompatWine;Credentials、CredentialsExtra、CredentialsMutation;CRuntime;Debug;FileDescriptors;FileIo;Filesystem;FilesystemAttr;IoEvent;IoUring;Ipc;Memlock;NetworkIo;NetworkServer;NetworkSocketTcp、NetworkSocketUdp、NetworkSocketUnix;Pkey;Process;Resources、ResourcesMutation;Sandbox;Signal;Sync;Timer。
其中 Aio 允许 io_cancel、io_destroy、io_getevents、io_pgetevents、io_setup、io_submit。BasicIo 允许 read、readv、tee、vmsplice、write、writev,也包括 ioctl,因为任何做文件、socket 或 TTY IO 的程序最终都会碰到 glibc 用 ioctl。Clock 允许 clock_getres、clock_gettime、gettimeofday、time、times。兼容组处理旧 ABI 模拟、32 位兼容、systemd、Wine 等。CRuntime 允许内存分配、线程、系统调用交互和 libc 支持,比如 brk、exit、exit_group、futex、mmap、mprotect、munmap、getrandom。Filesystem 和 FilesystemAttr、FileIo 分开,以便进程仍能对已打开文件、从 UNIX socket 收到的文件、memfd 做 IO。Process 组包括 clone、clone3、execve、fork、kill、wait4 等,通常要沙箱化别的二进制就总需要这组。Seccomp 和 cgroups 没有 exec 时切换策略的机制,这点很遗憾;SELinux 的人早就知道这种机制对正确降权很重要。
这些策略我用了将近一年。今天会改几处,但还没时间。还要注意,Kafel 的系统调用数据库差得离谱,需要做点类似 sed 的预处理,把系统调用名替换成编号,才能让上面的策略工作。即使能工作,也会漏掉很多 Docker 这类使用更好数据库的项目会处理的系统调用。比如上面没提 clock_gettime64,就是因为 Kafel 的数据库太差。只要 Kafel 还保持这么差的系统调用数据库和多架构支持,Docker 这类项目就不会采用它。
Kafel 能改进的不只是数据库。我还想看到策略版本化和更好的策略组合操作符。我愿意开发这些功能,但同样没有客户感兴趣,所以时间花在别的项目上。
结束?
以上只走过了 Linux 和 FreeBSD 沙箱的基础。还有更多教训想分享,留到以后。可能覆盖的主题包括:
- 更多演示。多年来我在一些机器上只靠容器运行图形应用,有不少可展示。
- 更多关于 actor 模型、基于能力的安全、访问控制策略。
- 更多 Linux 权宜之计。
- 也许评论一下 Windows 和 macOS。
PR_SET_DUMPABLE和/proc/sys/kernel/yama/ptrace_scope。- 容器,Emilua 也可作容器运行时。
- 沙箱化 GUI 应用。
- 攻击面与安全解析器。
- FreeBSD 的 libnv。
- 权限撤销与代理。
- 沙箱模式。
- Emilua 使用的、面向 C 程序员的 UNIX 技巧。
评论
社区讨论聚焦于不同沙箱机制的实用性,多数人推崇 OpenBSD 的 pledge/unveil 简洁且已真实部署,少数人从系统调用模型根本改革或系统级工具组合出发提出异见,并质疑学术推荐的 Capsicum 脱离实际。
OpenBSD 的 pledge 和 unveil 是更实用且易用的沙箱机制
- 相比其他方案代码极简,且 OpenBSD 端口中的 Chromium 与 Firefox 自 2016 年起默认启用并获上游接纳;与之相反,被某些文章奉为最佳的 Capsicum 在 FreeBSD 中几乎无程序真正使用。(较多人) > 和 OpenBSD 从 2016 年起就在 Chromium 里默认用 pledge、2018 年起用 unveil 且被上游接受相比,FreeBSD 上如今没有浏览器用 Capsicum。(@brynet)
沙箱困境源于进程默认继承权限,应从 API 层面改为默认无能力
- 现有继承式能力语义仅为兼容旧软件,安全模型应在进程创建时显式传入白名单能力,Linux 的 seccomp 严格模式接近该理念,可在此基础上用 RPC 模拟访问控制。(少数人) > 需要降权本身就是默认继承能力的进程 API 带来的后果,安全的方案从来都是默认无权限、靠显式参数授权。(@10000truths)
应用层沙箱不够通用,系统级工具组合更可靠
- JVM 或 Deno 等应用内权限控制覆盖面不足,不如假设任何程序都可能被攻破,用 Bubblewrap+seccomp+socat 等底层工具隔离,能安全运行编译器乃至无头浏览器。(少数人) > 我不太喜欢应用层沙箱,最终你不得不假设机器上跑的东西都可能坏掉,再按风险偏好处理。(@sieve)
有价值的补充
- 有开发者将 OpenBSD 的 pledge 移植到 Linux,包装为 seccomp-bpf 前端,降低使用复杂度(@Panino)。
- seccomp 严格模式仅允许 read、write、exit、sigreturn 四个系统调用,进程只能通过继承的文件描述符与外界通信,可据此构建纯计算沙箱(@10000truths)。
- 实际工程中可用 Docker 沙箱配合短时效令牌,将宿主机作为只读远程仓库,避免凭证长期驻留(@DubiousPusher)。
- 针对 LLM 生成的 Python 代码,可使用 pydantic 的 monty 库进行约束(@aadyachinubhai)。
- Capsicum 虽在学术研究中被高度评价,但 FreeBSD 官方端口树从未提交 Capsicum 版 Chrome,折射出学术原型与生产环境脱节(@brynet)。