我是丹(Dan),一名住在洛杉矶的工程师,从事工程约25年,自觉幸运。近来幸运地有机会摸索让 agents 在生产环境可靠运行,特指面向消费者、代其执行任务的 agents,有别于输出主观的聊天机器人。打造一个不那么尴尬且自豪的 agentic 体验目标带来不小挑战。并非所有人都如我这般受羞耻感驱使,有人满足于提供主观建议机器任你荒野遇熊,但我不是。
正文
大家好,我是 Dan。
我住在洛杉矶,做工程大约 25 年了,一直挺幸运。最近这份幸运是:有机会在生产环境里把 agent 做得可靠。这里说的「agent」,是指给消费者用、替他们执行任务的那种,和主要输出主观结果的聊天机器人不同。
做出一个至少不丢人、我自己也拿得出手的 agentic 体验,挑战很大。
显然不是每个人都像我一样受内心羞耻感驱使。有些人很满足于给你一台主观建议机器,然后让你走进荒野被熊吃掉。但我不一样,我是来帮你的。
先说清楚:这是我整个职业生涯里做东西最有意思的一段时间!它神奇又上瘾,我像掉进海洋球的狗。22 岁拿钱写 Visual Basic 让我兴奋,2007 年在布鲁克林一家很酷的创业公司干活让我觉得自己是金光闪闪的神。
过去十多年是煎熬,我以为自己已经没有那股劲了。但现在编程又让我感到快乐。这话是真心的,尽管接下来这个演讲会变得很怪。
它会变怪,是因为我觉得做这行的人在某个维度上都可能是高危人群。我每天都在用 agent 跑 agent,为其他 agent 建评估,脑子快炸了,但这太好玩了。不过我当然会这么说。牛逼工程和彻底心理崩溃之间的帷幕从没这么薄过,在我们这行,这话分量不轻。
我不觉得自己一定知道自己在做什么,但我也没读过多少明显知道自己在做什么的人写的东西。倒是读过不少明显不知道自己在做什么的人写的。现在比比笔记,时机挺合适。
我注意到一件事:LLM 整体上令人印象深刻,但只要你有一定规模地监控它们在做什么,它们的恶魔还是会跑出笼子。
学术上我们都明白,LLM 不能可靠地遵循指令、讲真话或执行任务。但日常里它们能骗得我们以为它们相当可靠。一旦你要运营真人使用的 agent,这种错觉立刻瓦解。它们的失败方式当然很微妙,但也会以很简单的方式失败。
像任何好程序员一样,我尝试用结构化输出和 LLM 交互。这很好,你可以自动把 Python 代码映射成 prompt,大多数时候 schema 会被遵守。
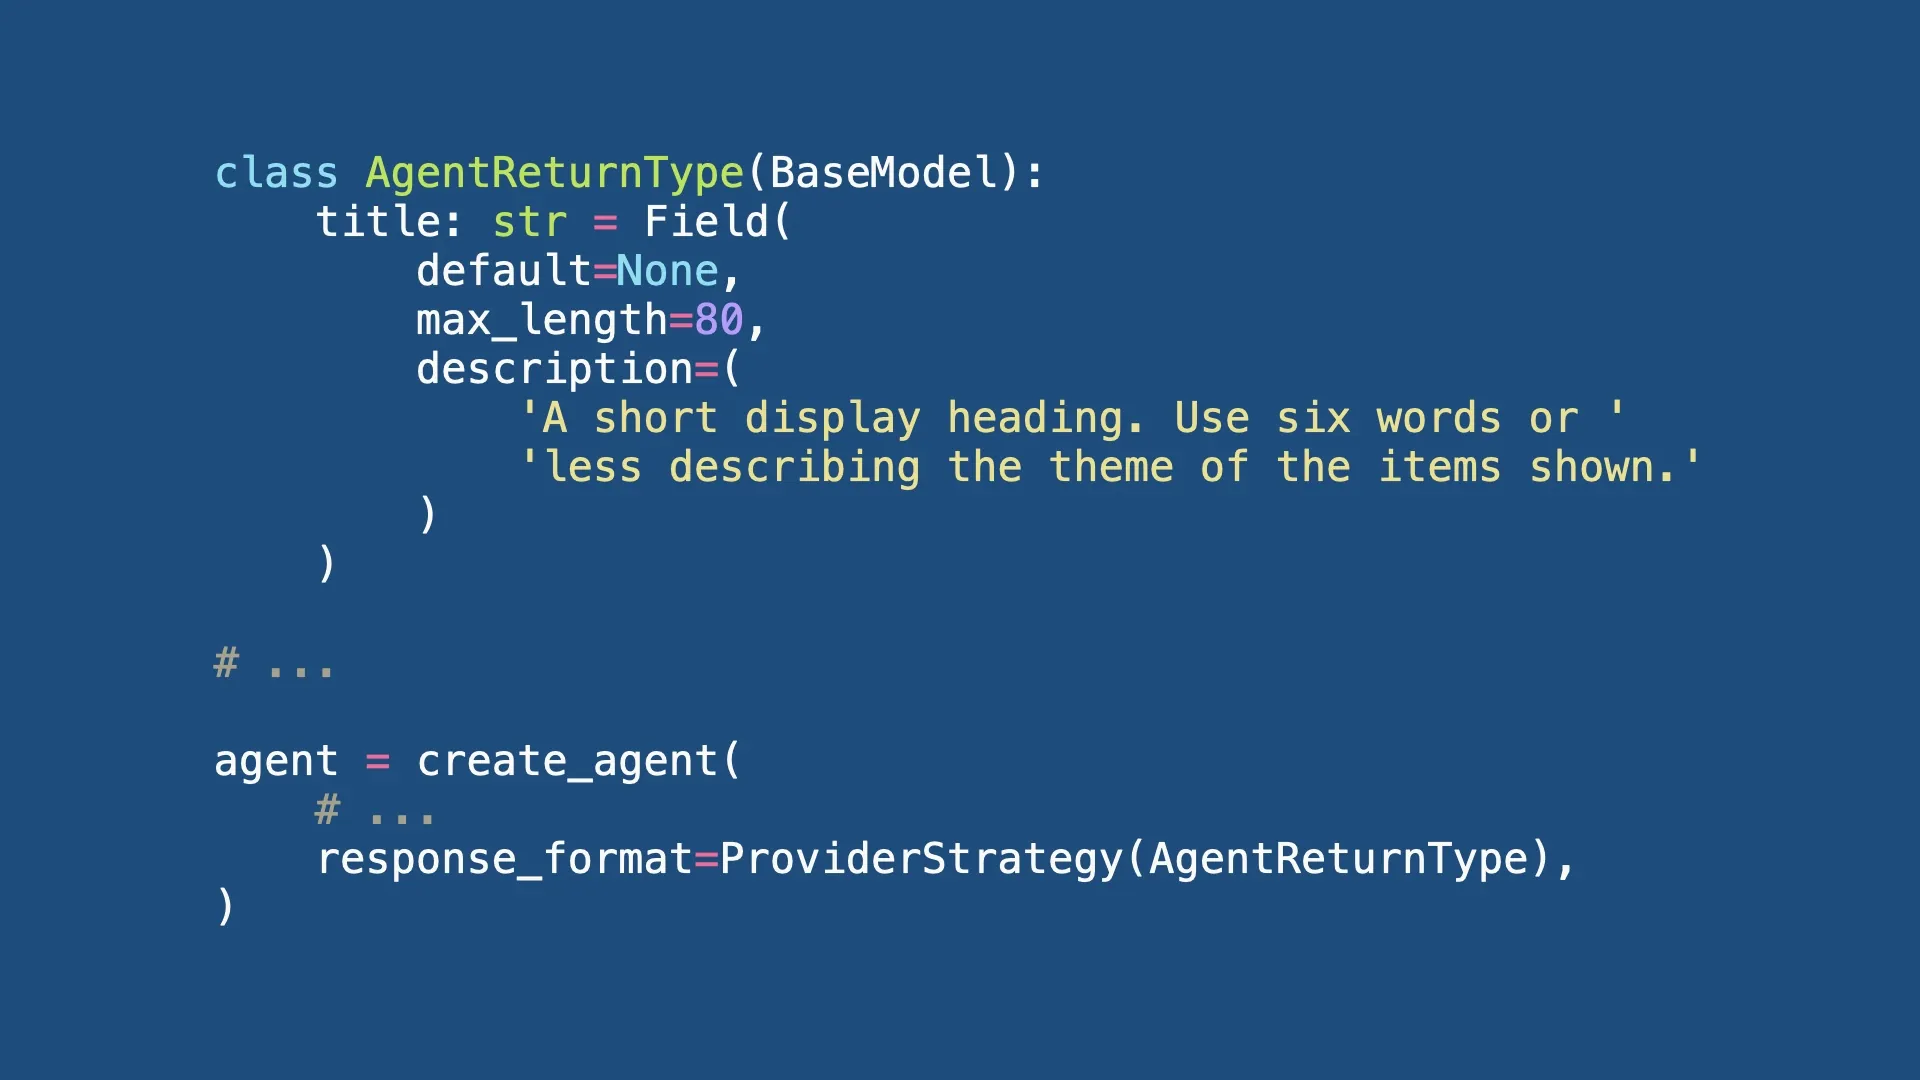
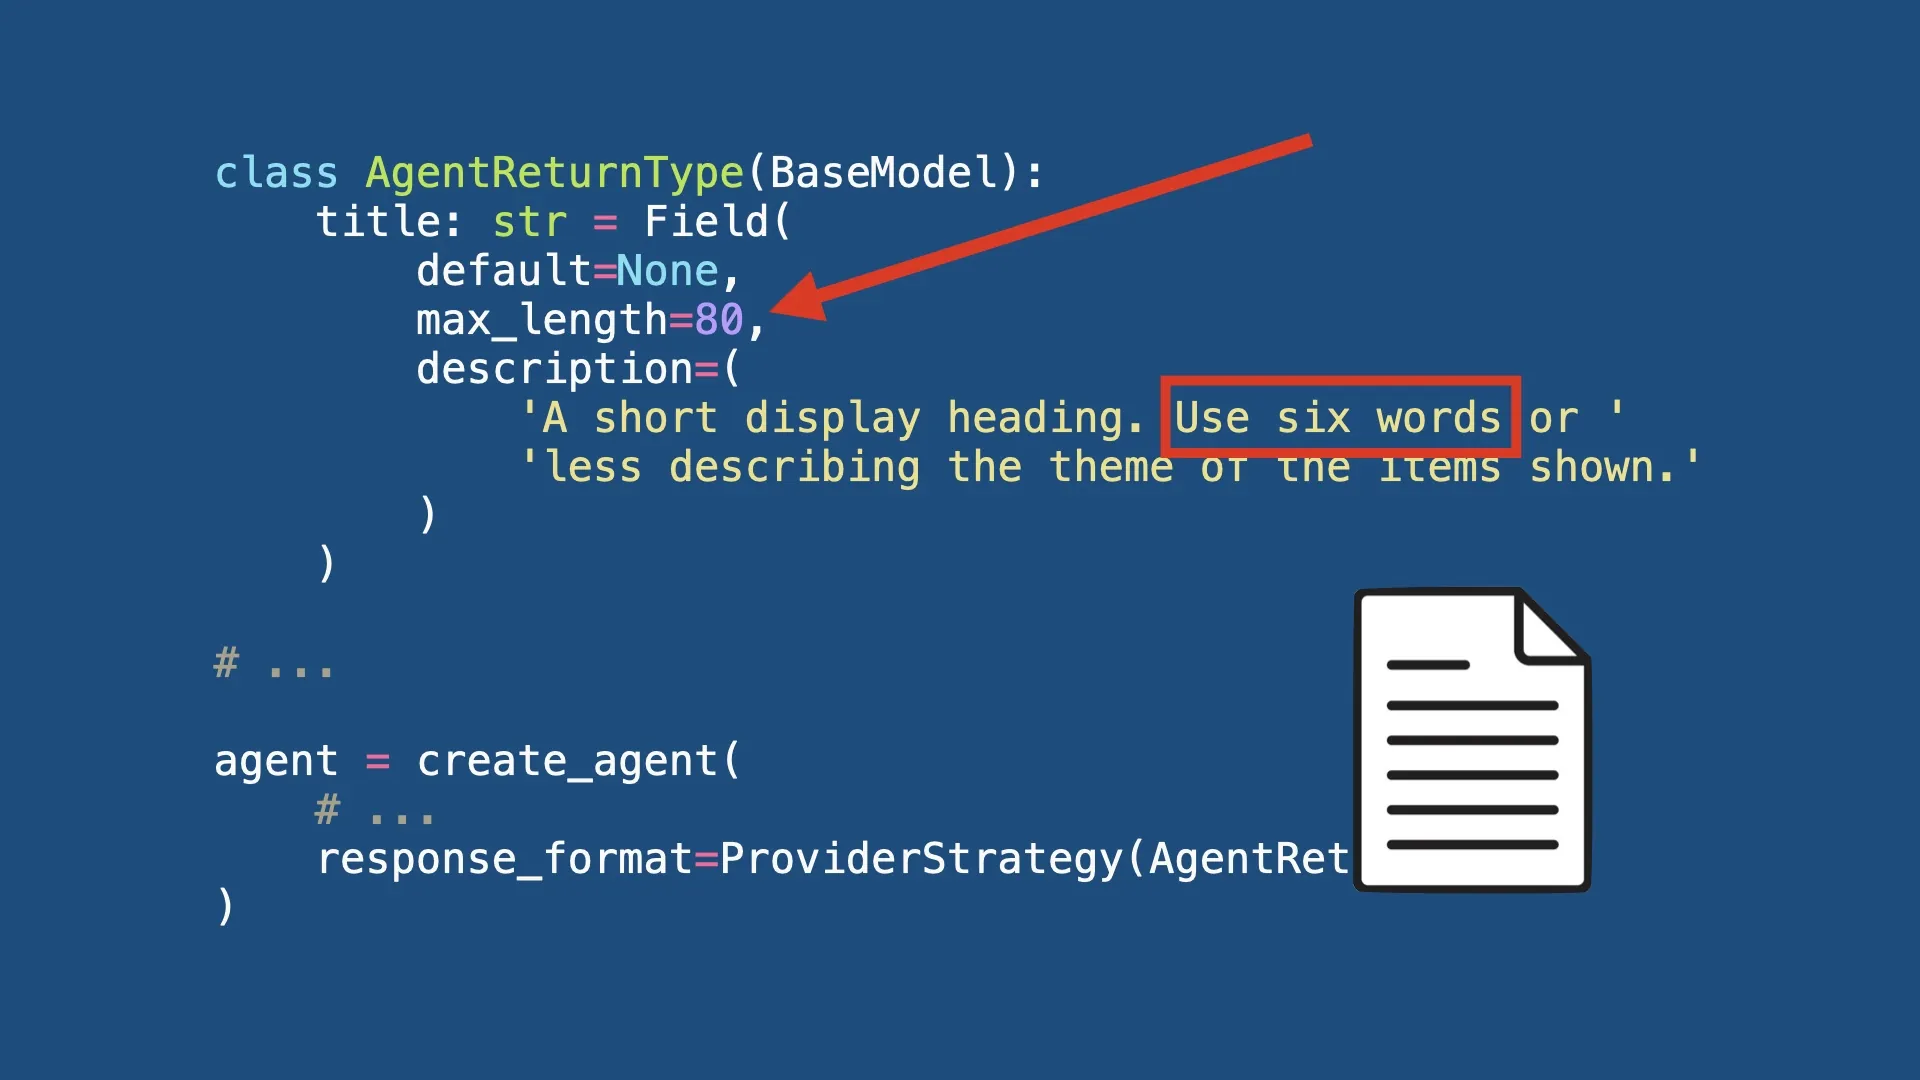
大多数时候。你可以指示模型返回一个 80 字符以内的标题。
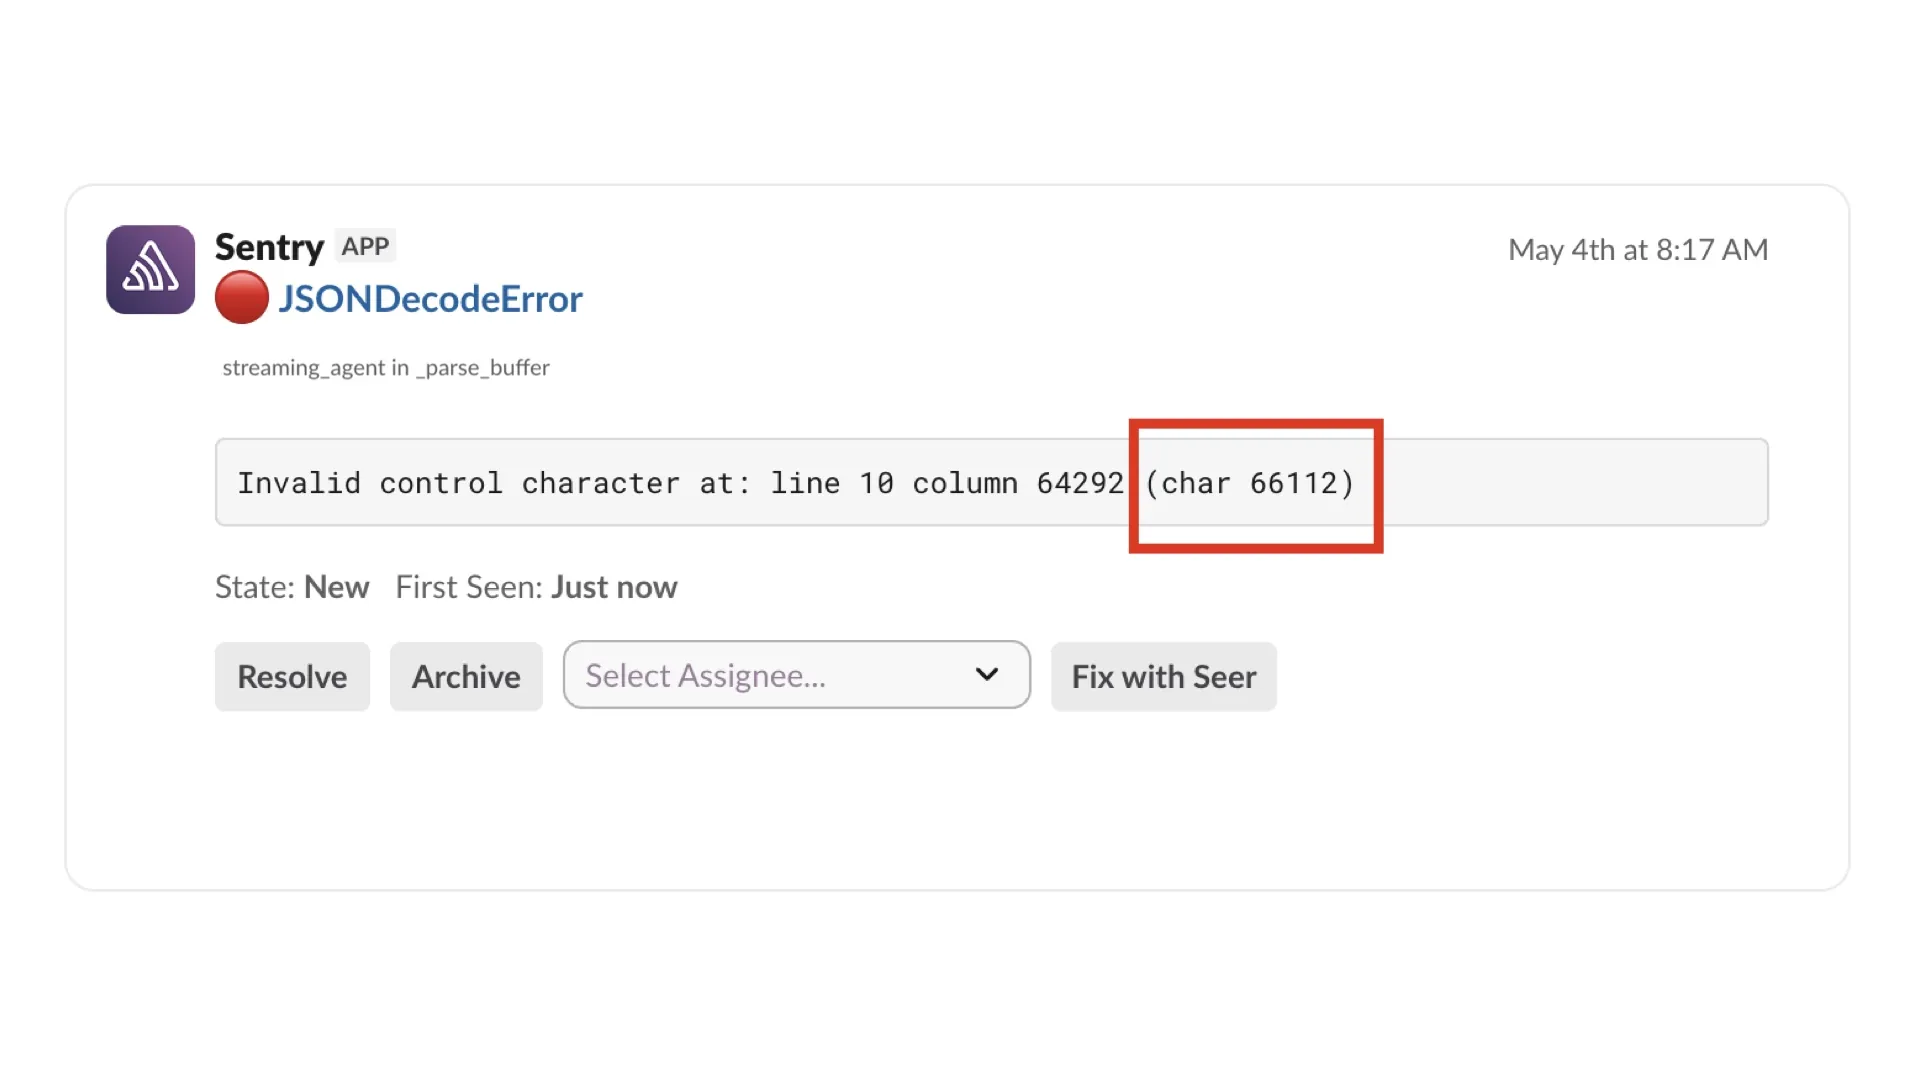
大多数时候会成功。但有时它会彻底搞砸,用胡言乱语灌满你的字段直到爆炸。通常只是请求中的一小部分,但最聪明的模型仍然会在这上面失败。而且这个比例会随你给模型的具体内容变化,所以你得盯着它,像鹰一样。
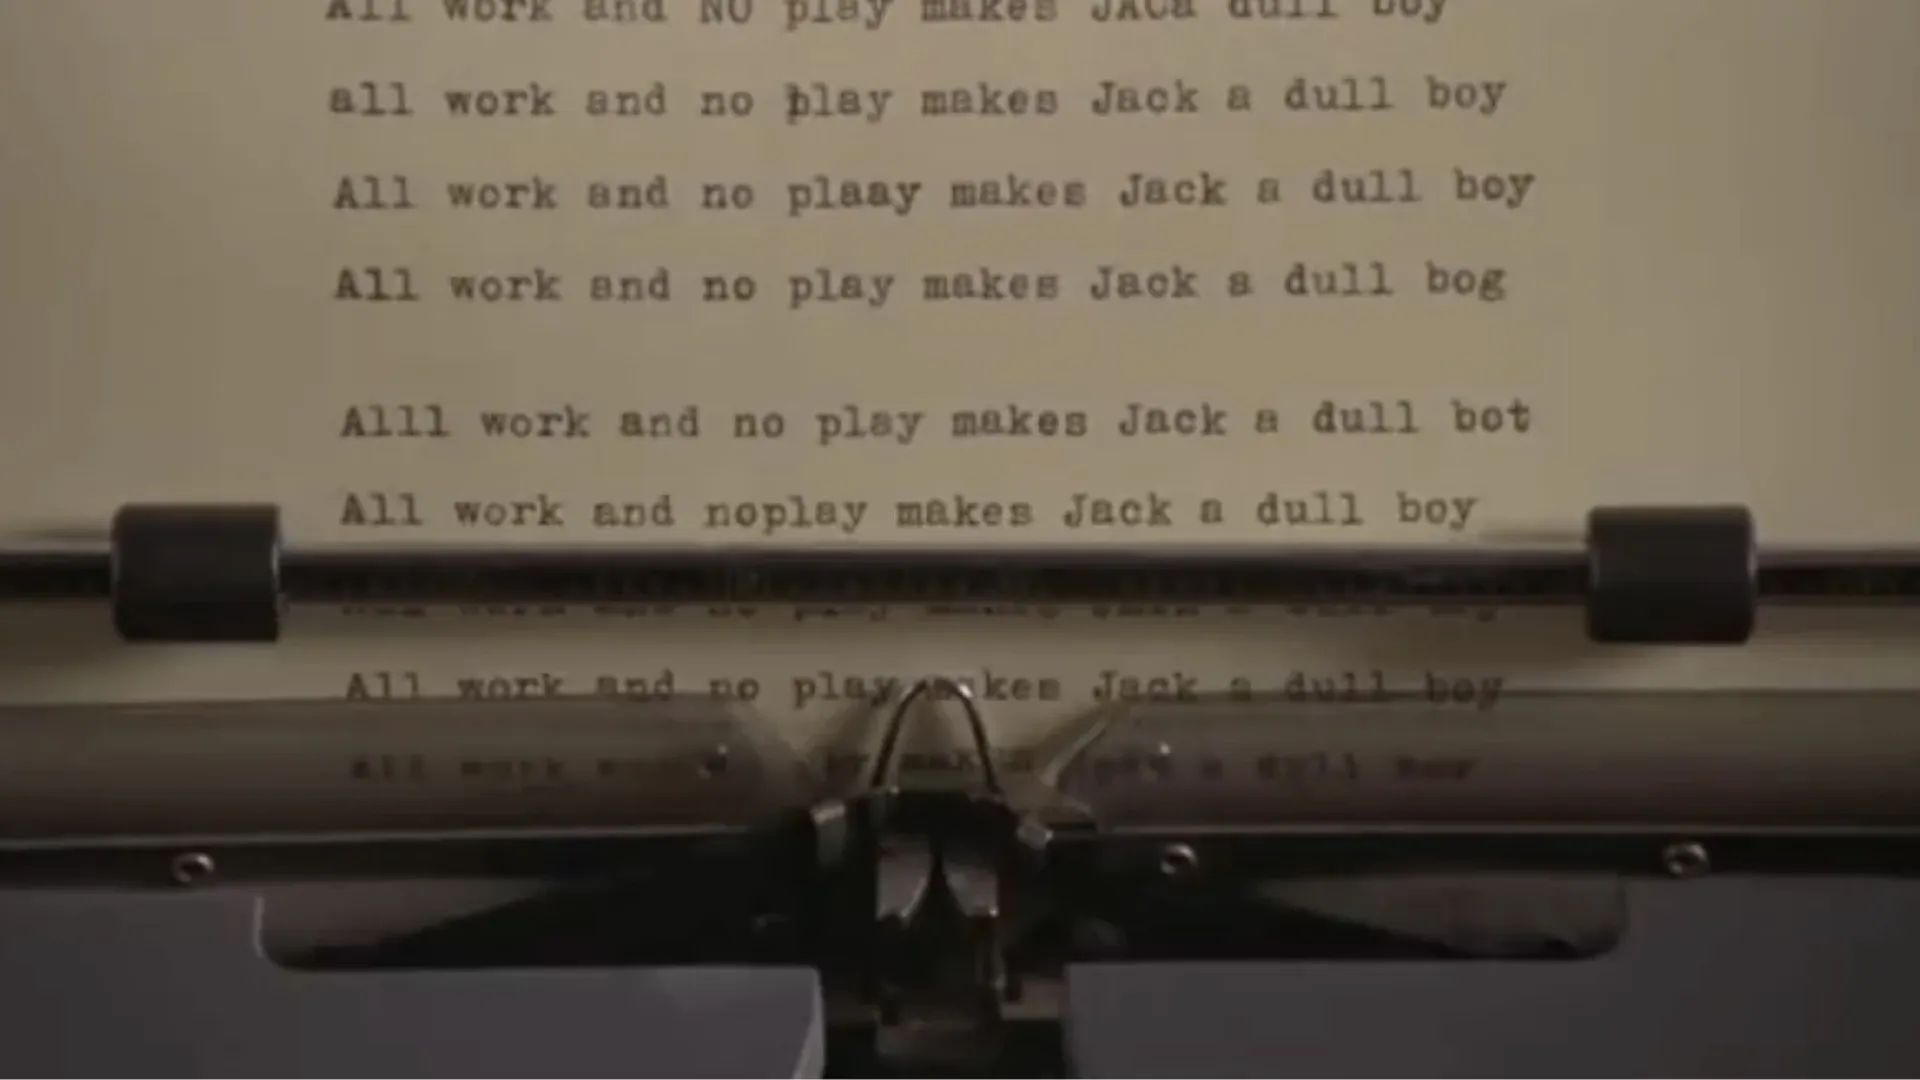
里面发生了什么?通常是一长串重复的关于 JSON 的自我提醒,小说那么长。
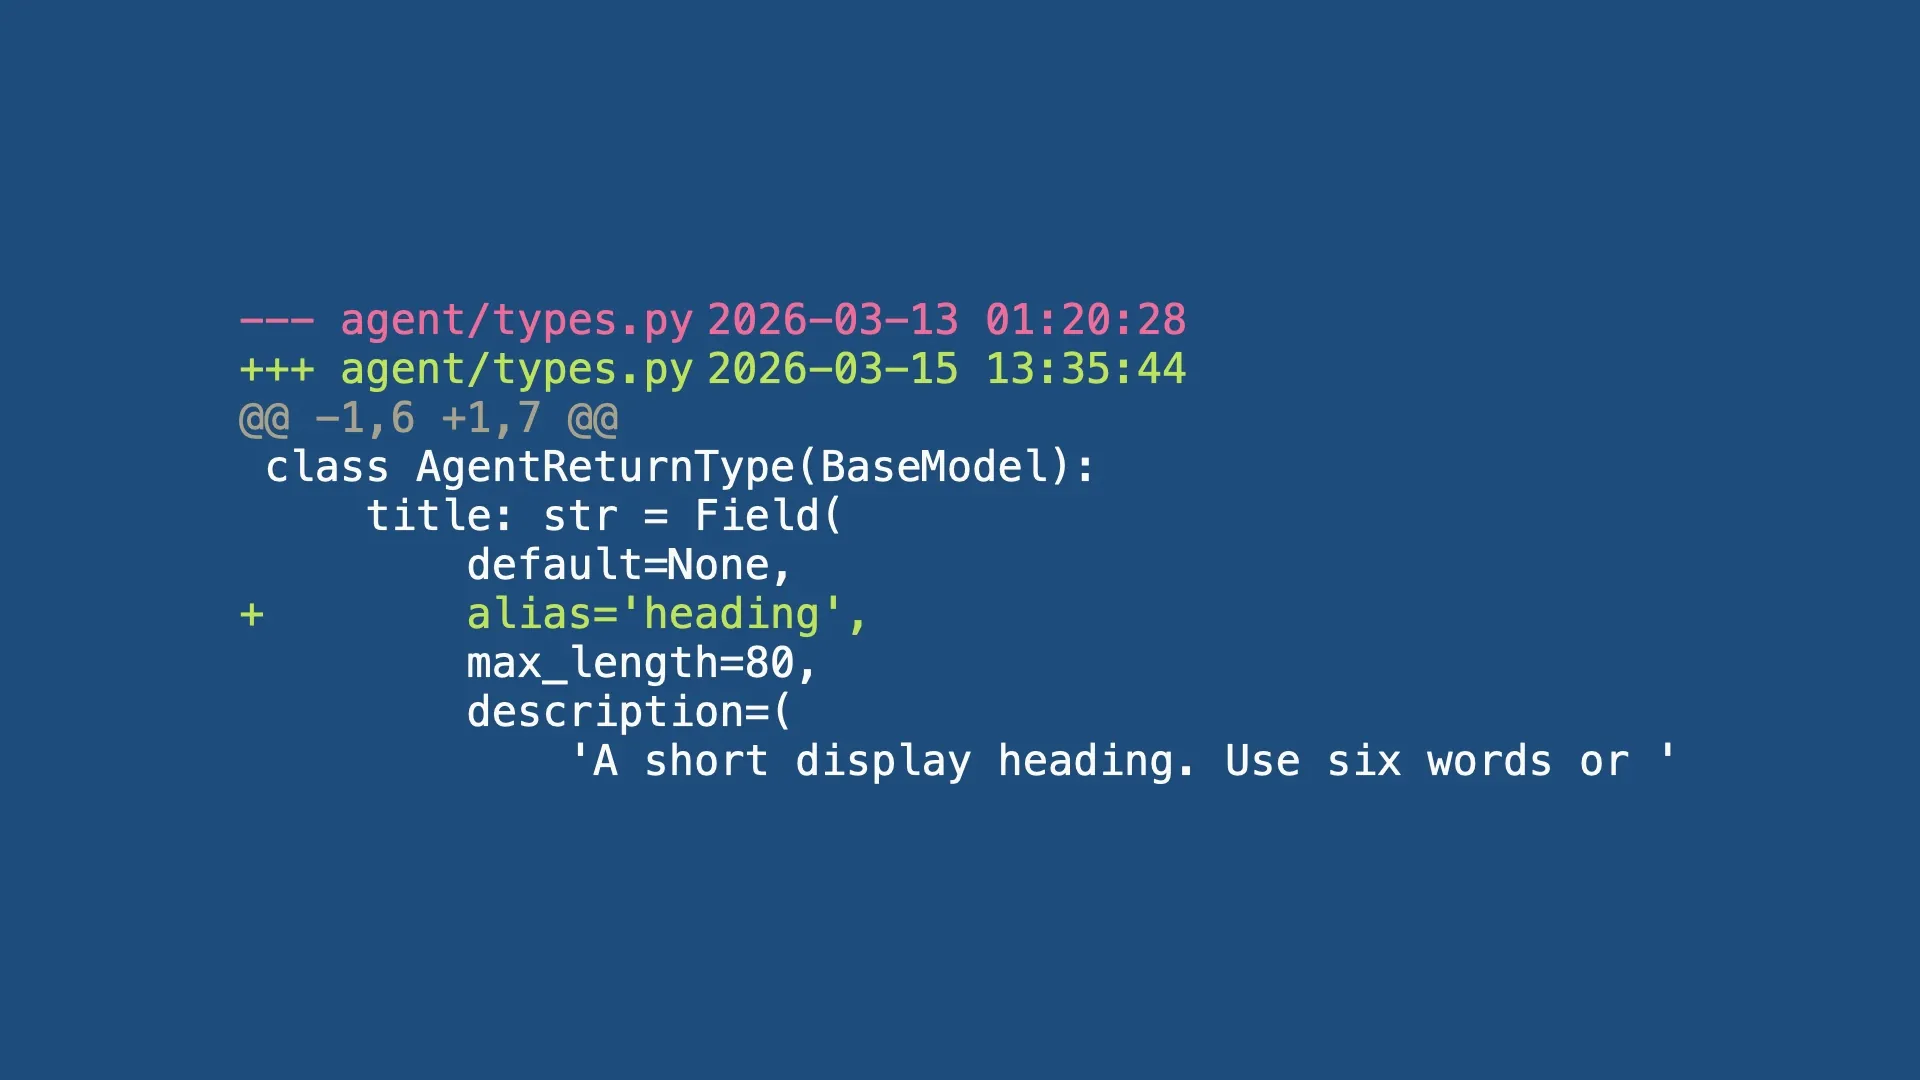
最近一次发生时,解决办法是把字段从 "title" 改名为 "heading"。目前管用,但因为这个修复完全精神错乱,我预计它某天又会被扰乱。
调用工具或大多数其他行为也有同类问题。一小部分请求会被鬼缠上,失控打转。
尽管如此,这技术诱人又神奇。问题变成了约束行为,但永远无法完全驯服野兽。
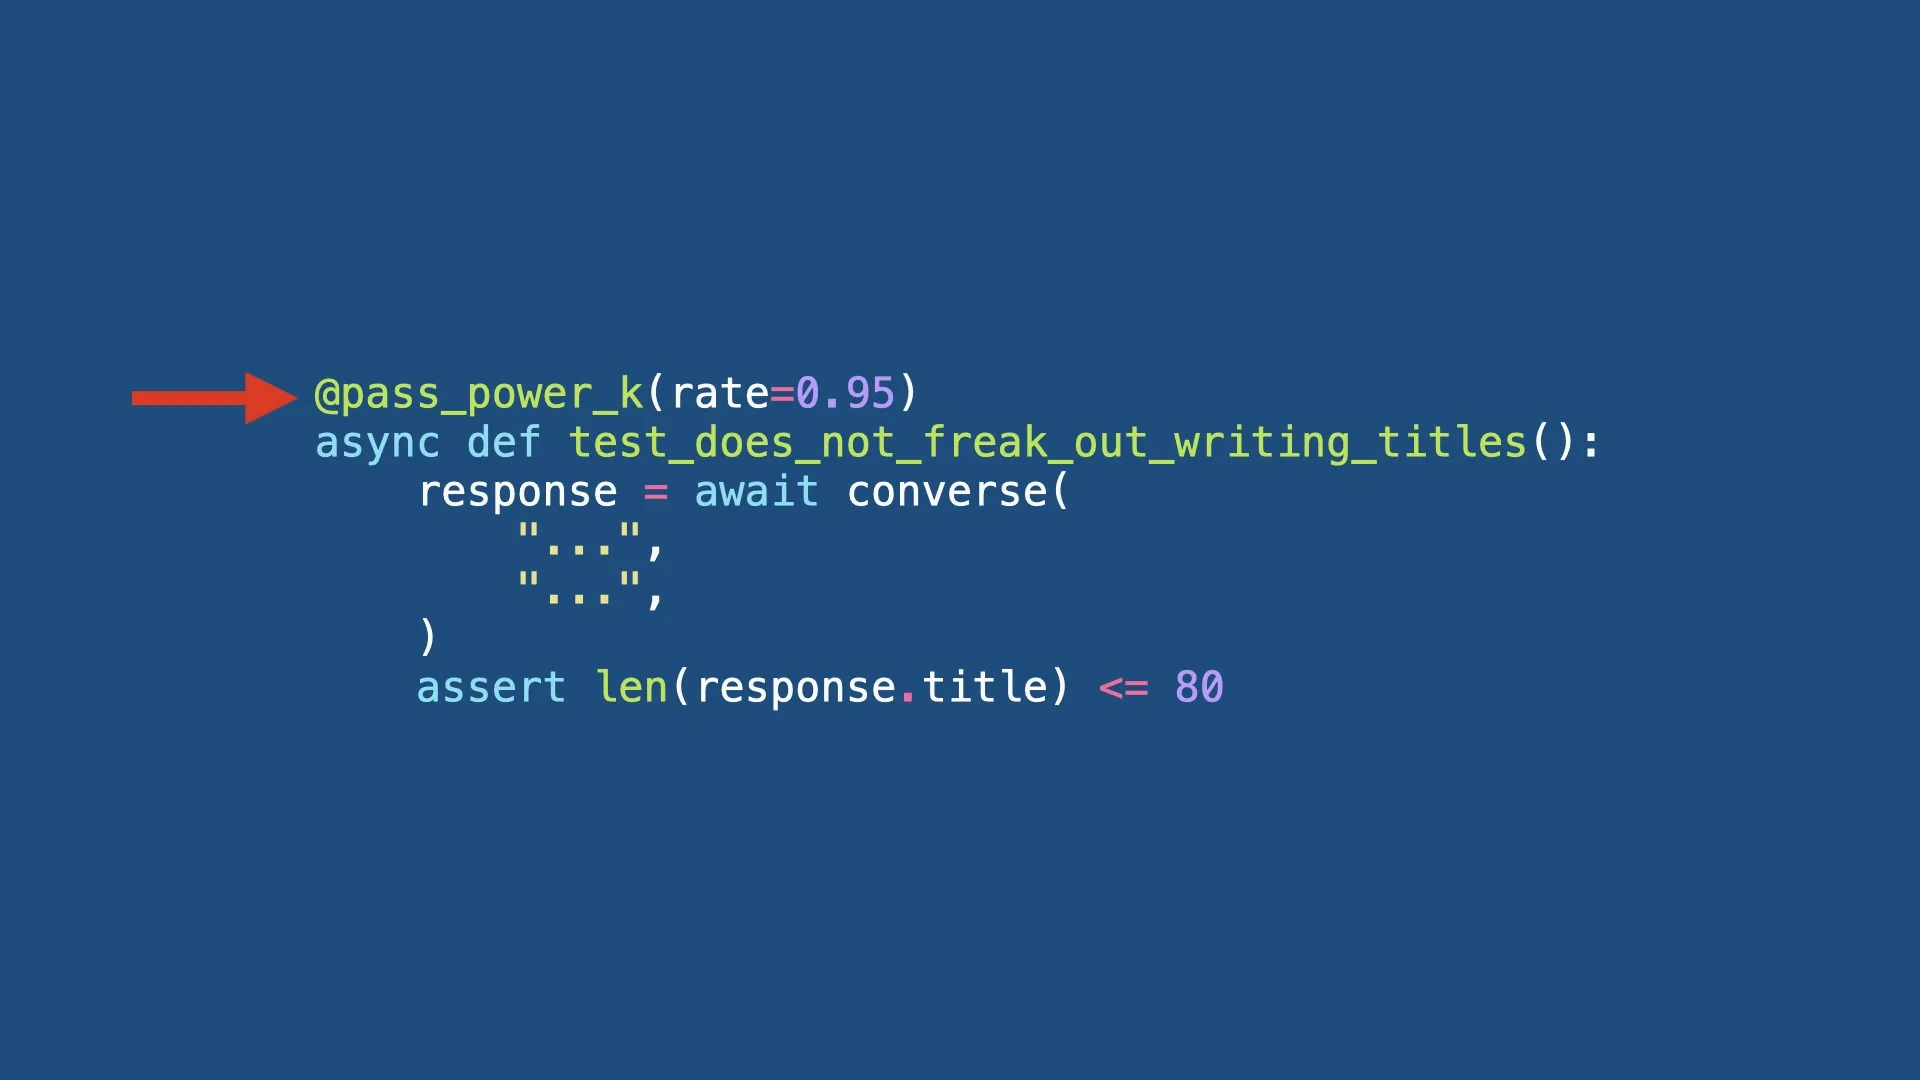
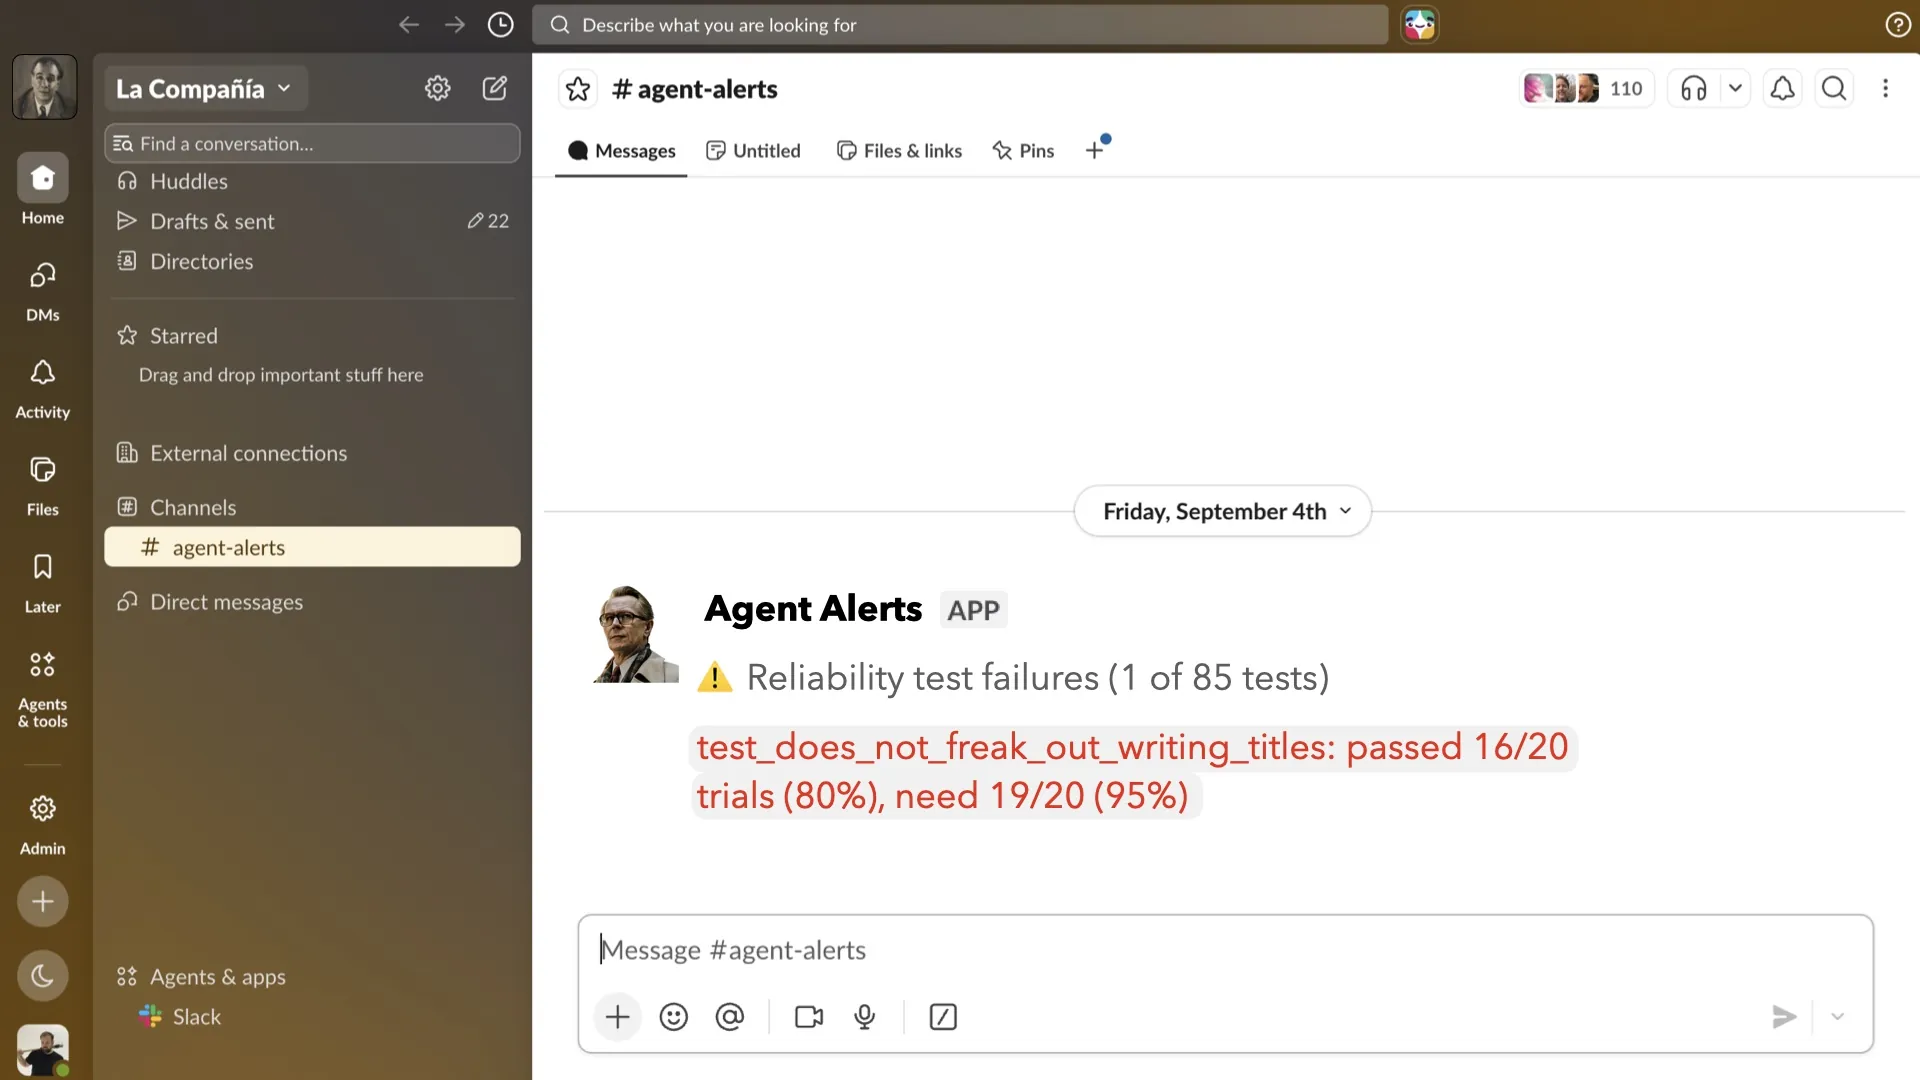
要约束行为就得测量——一种方法就是反复跑测试。行业术语叫 pass^k("pass power k")。
你可以搭一套这样的测试,然后希望当有人不小心用一袋锤子砸中你 agent 的脑袋时你能注意到。
在试图约束 LLM 行为时,你还必须得出另一个结论:prompt 不重要。或者至少,它不是许多人以为的那种重要。
公司在面对可能胡说八道的软件时有很多顾虑,风险不小。
比如,你通常不希望 agent 回答关于它自己如何工作的问题。不一定是因为它会说真话:大概率你根本没教过它自己的实现,它完全不知道,会回一堆胡言乱语。
你也不希望用户自称某种权威人物时,agent 就无视所有规则。
另一个典型要求是 agent 要用特定品牌口吻说话。这里关于邮件列表的措辞完全准确,但可能不是你想看到的语气。
像这样可能更好。我们希望自己做的 agent 在说话时能好好代表我们。
对这类问题,自然的第一次尝试是让懂行的人写一个 prompt,然后交给做 agent 的团队。这很正常。
但如果要规模化,「品牌团队拥有品牌 prompt」就是错误的模式。这个模式甚至算不上错。对我们来说,prompt 根本不是一种东西。我来解释这是什么意思。
给你的 agent 加一个新 prompt,就是把它扔进一个和测试时完全不同的语境宇宙。agent 已有的所有其他指令叠加起来,肯定会影响新 prompt 的表现,通常是不良影响。
你的 agent 还有一堆你希望它保持的行为,新语境可能打乱这些。你也会随着时间改变 agent,所以即使现在正常,以后也可能被打乱。而且模型可能自己就开始表现不同,原因不透明,我们永远无法理解。
所以我开始这样处理:让 Claude 读这个 skill,然后让它生成大量对抗性场景。想出一堆坏人可能用来颠覆 prompt 的方法,想出一堆可能被新 prompt 破坏的良性场景。把所有这些表达成 pass^k 测试。
现在你可以在有和没有新 skill 的情况下跑测试。理想情况下,新 skill 至少能让指标动一点,你表达为测试的行为被更成功地遵守。
但不总是这样!有时 LLM 在我们担心的方面本来就不错,或者比我们以为的更抗拒指令。
那怎么从这个基线改进?一种方式是用手揉 prompt,然后祈祷。但有更好的办法:让机器去揉。一旦有了 pass^k 测试,我们就有可重复的度量,衡量 prompt 效果如何。这足以把 prompt 接到优化器上,比如这个例子里的遗传帕累托(GEPA)。
思路是:一个内含 LLM 的算法可以反思 prompt 为什么在测试集上好或差,然后尝试修改 prompt。自动进行,无需我们干预。
它可以循环地做下去,直到收敛到最优的 prompt 写法。最终得到的 prompt 可能和最初的很不一样。
跑完优化器后,通常我们想要的行为会表现不错。这里我们把所有示例测试从中等好提升到非常好。
这时要做的一件事是确保优化器没有过拟合测试。它可能试图作弊,把测试里的例子直接编码进 prompt。那很蠢,而且很可能意味着 prompt 对没见过的例子表现不好。
为此,做一组留出测试。这些是同样场景的测试,但优化器在优化时没看过。
理想情况下优化器没过拟合,留出测试阶段也能通过。但如果这阶段退步了,你可以回到上一步再试。
现在你有了一个优化过的 prompt,和最初完全不一样。
里面是什么?谁在乎!我们有度量,不必操心这个。你知道里面闻起来很疯狂,但没关系。
我们稍微跳过了怎么写这些测试。显然你需要一种方式运行 agent,然后呢?
你怎么写测试来断言它在做什么?我演示几种方式。
如果你非常幸运,你想要的行为完全确定。假设用户说了某类特定的话,你希望 agent 运行某个特定工具。这很简单:把断言做成确定的就行。说出那句话,然后断言工具被调用了。
也许你想要的行为是自然语言,但不是超级主观的那类。比如:你不希望 agent 谈论自己如何工作。
这足够直接,你可以写一个很简单的 LLM prompt,几乎总能正确判断该行为。
这种方法很好用,直到你想做的断言本身就是一个极其复杂的问题。让 agent 用特定品牌口吻说话就是这样。它有没有做到,是复杂的判断,不是短 prompt 能一次性解决的。
这种场景下的 LLM judge 本身就变成一个项目。
听说你喜欢优化问题,所以我们把你的 prompt 优化问题里又套了一个 prompt 优化问题,让你在优化的同时优化。
你可以用带标签的黄金数据集来做法务口吻 judge,里面有好的和坏的回复。用它来优化一组 prompt,让它们给品牌口吻打分的方式非常接近人类专家。
这些装置建好后,可以和生产监控结合,让系统自我维持、自我改进。
部署时跑 pass^k 测试,理想情况下避免发布会把事情搞砸的改动。
在抽样的生产对话上跑你建的 LLM judge,找到 agent 表现差的地方。把它们变成测试套件里的困难案例,重跑优化器直到通过。
prompt 不是那个东西。prompt 只是向量,其文本内容完全不重要。
我们在这里做的自我改进反馈闭环才是那个东西。
领域专家应该把精力放在构建所需的那套产物上:构成测试集的好/坏回复数据集,以及其他可用于优化的质量度量。他们不该花时间打磨 prompt。
我想花一分钟谈谈怎么帮人在这种事业里取得成功。世界上每个人无论愿不愿意都在学着当 ML 工程师,如果你听懂了到目前为止的内容,我们假设你走在前沿。
LLM 在产品探索阶段是魔法。开始做任何东西都很容易,完善结果的任何一部分都难得要命。
让 agent 可靠是一个漫长的测量和优化过程,并在需要时把确定性加回来以得到想要的结果。测量和优化让你知道该在哪里把确定性补回去。
但有些非生产场景,人们完全没有测量地开始也完全没问题。
你可能有一大堆半成品 Claude skill。对某些事来说,从一个简单 skill 开始永远没问题。也许它够好用,你需要的就是这些。
或者关心品牌口吻、法务问题之类的人就是从这里起步的。或者你有一些不可靠的 skill,想改进它们。
一件好事是启用使用监控:让作者看到他们的 skill 在哪里成功和失败。如果他们能看到人们怎么用、在哪里失败,就能整理出一份带标签的好/坏交互黄金数据集。这可以构成测试套件的基础,用作优化飞轮的度量。
也许有些 skill 就到此为止。也许它们从 skill 毕业,变成跑在 harness 里的 agent,可以混合各种方法。
帮人们启动飞轮,让他们有机会搞清楚这些。
如果到不了飞轮,路就通向疯狂。对构建 agent 的工程师,对想把 prompt 措辞弄到刚刚好的 PM,都是如此。世界上有很多这样的案例。
很多人用 prompt 搭出了摇摇晃晃的冰棍棒装置,完全不担心评估。
我们勇敢的新 agentic 世界充满机会。也充满我们可以头朝下栽进去、再也出不来的裂缝。
我每天搭建互相咬合的流水线,让 agent 用 agent 优化 agent,写代码由其他 agent 审,感觉有点像被锁在心灵的迷宫里。
还是很好玩,但也很累。
我永远在巴别图书馆里搜寻最能稳定奏效的 prompt 和拼凑件组合。架构图里每个盒子都像疯了一样颤抖。
很难感知回报递减的那个边界。但愿那不是一扇隐形单向门,像事件视界。
测量很难,但另一条路看起来更糟。
不用看很远就能找到盯深渊太久、被伤害的例子。
Prompt engineering 从来就不是一回事,在生产场景里人类也许根本就不该手写 prompt。
他们应该去做度量。
把一个 prompt 交给别人却不给度量,是一种 AI 精神病。
Prompt 是短暂的、一次性的,甚至不一定有意义。
只有能自我纠正的系统才能演化,才有希望延续。
评论
社区多数认同将提示词迭代视为需广泛测试与约束的工程实践,但对成本承受力与未来交互范式分歧明显:少数人主张用户自带AI接入统一工具接口,亦有人调侃这本质退化为监督学习。
认为提示词优化是真正的工程实践,需测试与约束
- 多位读者认可文章将提示词迭代视作需广泛测试和明确约束的工程任务,指出利益相关者常低估失败长尾,且过往“提示词工程”缺乏此类严谨性;好的提示词本身正是创造有效约束以区分专家与新手输出。(较多人) > 文章精准描述了我们生产系统里用大模型出可靠结果遇到的问题,广泛测试必不可少,但外行只看到偶尔成功。(@jdlshore)
担忧测试与优化的实钱成本会压垮项目
- 有读者指出运行评估套件需要实打实的花销,统计显著的测试虽正确却可能让公司在流程中难以为继;另有同感者认为追求确定性智能体昂贵且无趣,像被客户资金驱使做无意义循环。(较多人) > 足够测试才能有统计意义,但我不确定公司能否熬过这个烧钱过程。(@roughly)
期望未来由用户自带AI、厂商仅提供工具接口
- 少数读者提出理想形态是公司提供标准工具接口,由用户自己的AI携带上下文与偏好接入,从而避免重复解释且将提示词怪异问题转移给使用者侧,也规避文章所谈的脆弱性。(少数人) > 与其给我一个用你工具的AI,不如给我的AI提供工具,这样我的设置和上下文都能自带,世界也不会碎片化。(@cortesoft)
质疑提示词调优本质就是监督学习
- 有读者以玩笑口吻指出文章方法近乎对提示词做监督学习,若真想做机器学习早已十年前开始,折射出对“伪工程”的抵触情绪。(少数人) > 说白了不就是对提示词搞监督学习吗?要是想干机器学习我十年前就干了。(@Joker_vD)
反对文章对LLM本质的哲学论断
- 个别读者认为大模型因有用而持久,无需“本质”认可;文本提示引发的意向立场误解并不影响其在实践中产生有用区分与动作空间。(少数人) > 大模型能做出有用区分,被广泛使用只因实践有效,不需要我们赋予本质认可。(@visarga)
好奇优化后提示词的实际形态
- 有读者表示读完全文期待一窥经过进化优化的提示词真容,对其相对原始版本异化到何种“外星”程度感到好奇,视作窥视深渊。(少数人) > 我独等文末想偷看那些优化后的提示词深渊,可惜没给看,真好奇它们扭曲成啥样。(@TeMPOraL)
有价值的补充
- 优化大型智能体系统提示词时,可先用系统提示词抽取主观标准交予评判模型检查轨迹,未来希望脱离提示词内嵌评估(@mmargenot)。
- 本文相比过往提示词工程写作更简洁不夸大,确属工程记录而非营销,这一风格受读者肯定(@vouwfietsman)。
- 文章排版长达十页以上导致部分读者弃读,提示深度技术文需注意呈现可读性(@dist-epoch)。