开放人工智能(OpenAI)的广告收集器在 bzr.openai.com 设置一个名为 obi 的 cookie,作用域为 .openai.com。你在聊天生成预训练转换器(ChatGPT)上时该值存在并与账号绑定,随后 __obi 从你访问的普通网站发往 OpenAI。任何在 ChatGPT 投放广告的公司会在自家站点安装一小段 OpenAI 代码,如同零售商安装元(Meta)和谷歌(Google)跟踪代码。加载该代码时,obi 随浏览页面数据发往 OpenAI,包括搜索的产品、阅读的文章和购买行为。
正文
OpenAI 的广告收集器 bzr.openai.com 会设置一个名为 _obi 的 cookie,作用域为 .openai.com。它的值在你使用 ChatGPT 时生成,并与你的 ChatGPT 账户绑定。随后,你访问的普通网站会把 _obi 发回 OpenAI。
任何在 ChatGPT 上买广告的公司都会在自己网站安装一小段 OpenAI 代码,就像零售商安装 Meta 和 Google 追踪代码一样。加载该代码会把 __obi 连同你正在浏览的页面数据发给 OpenAI,包括你搜索的产品、阅读的文章和购买行为。
结果是,OpenAI 能把这些网站上的行为关联到你的 ChatGPT 账户。
作者在自己手机上复现了完整机制,用两种独立抓包方法验证,并交叉比对数月观察流量,覆盖 936 个不同广告像素、1,029 个主机名。
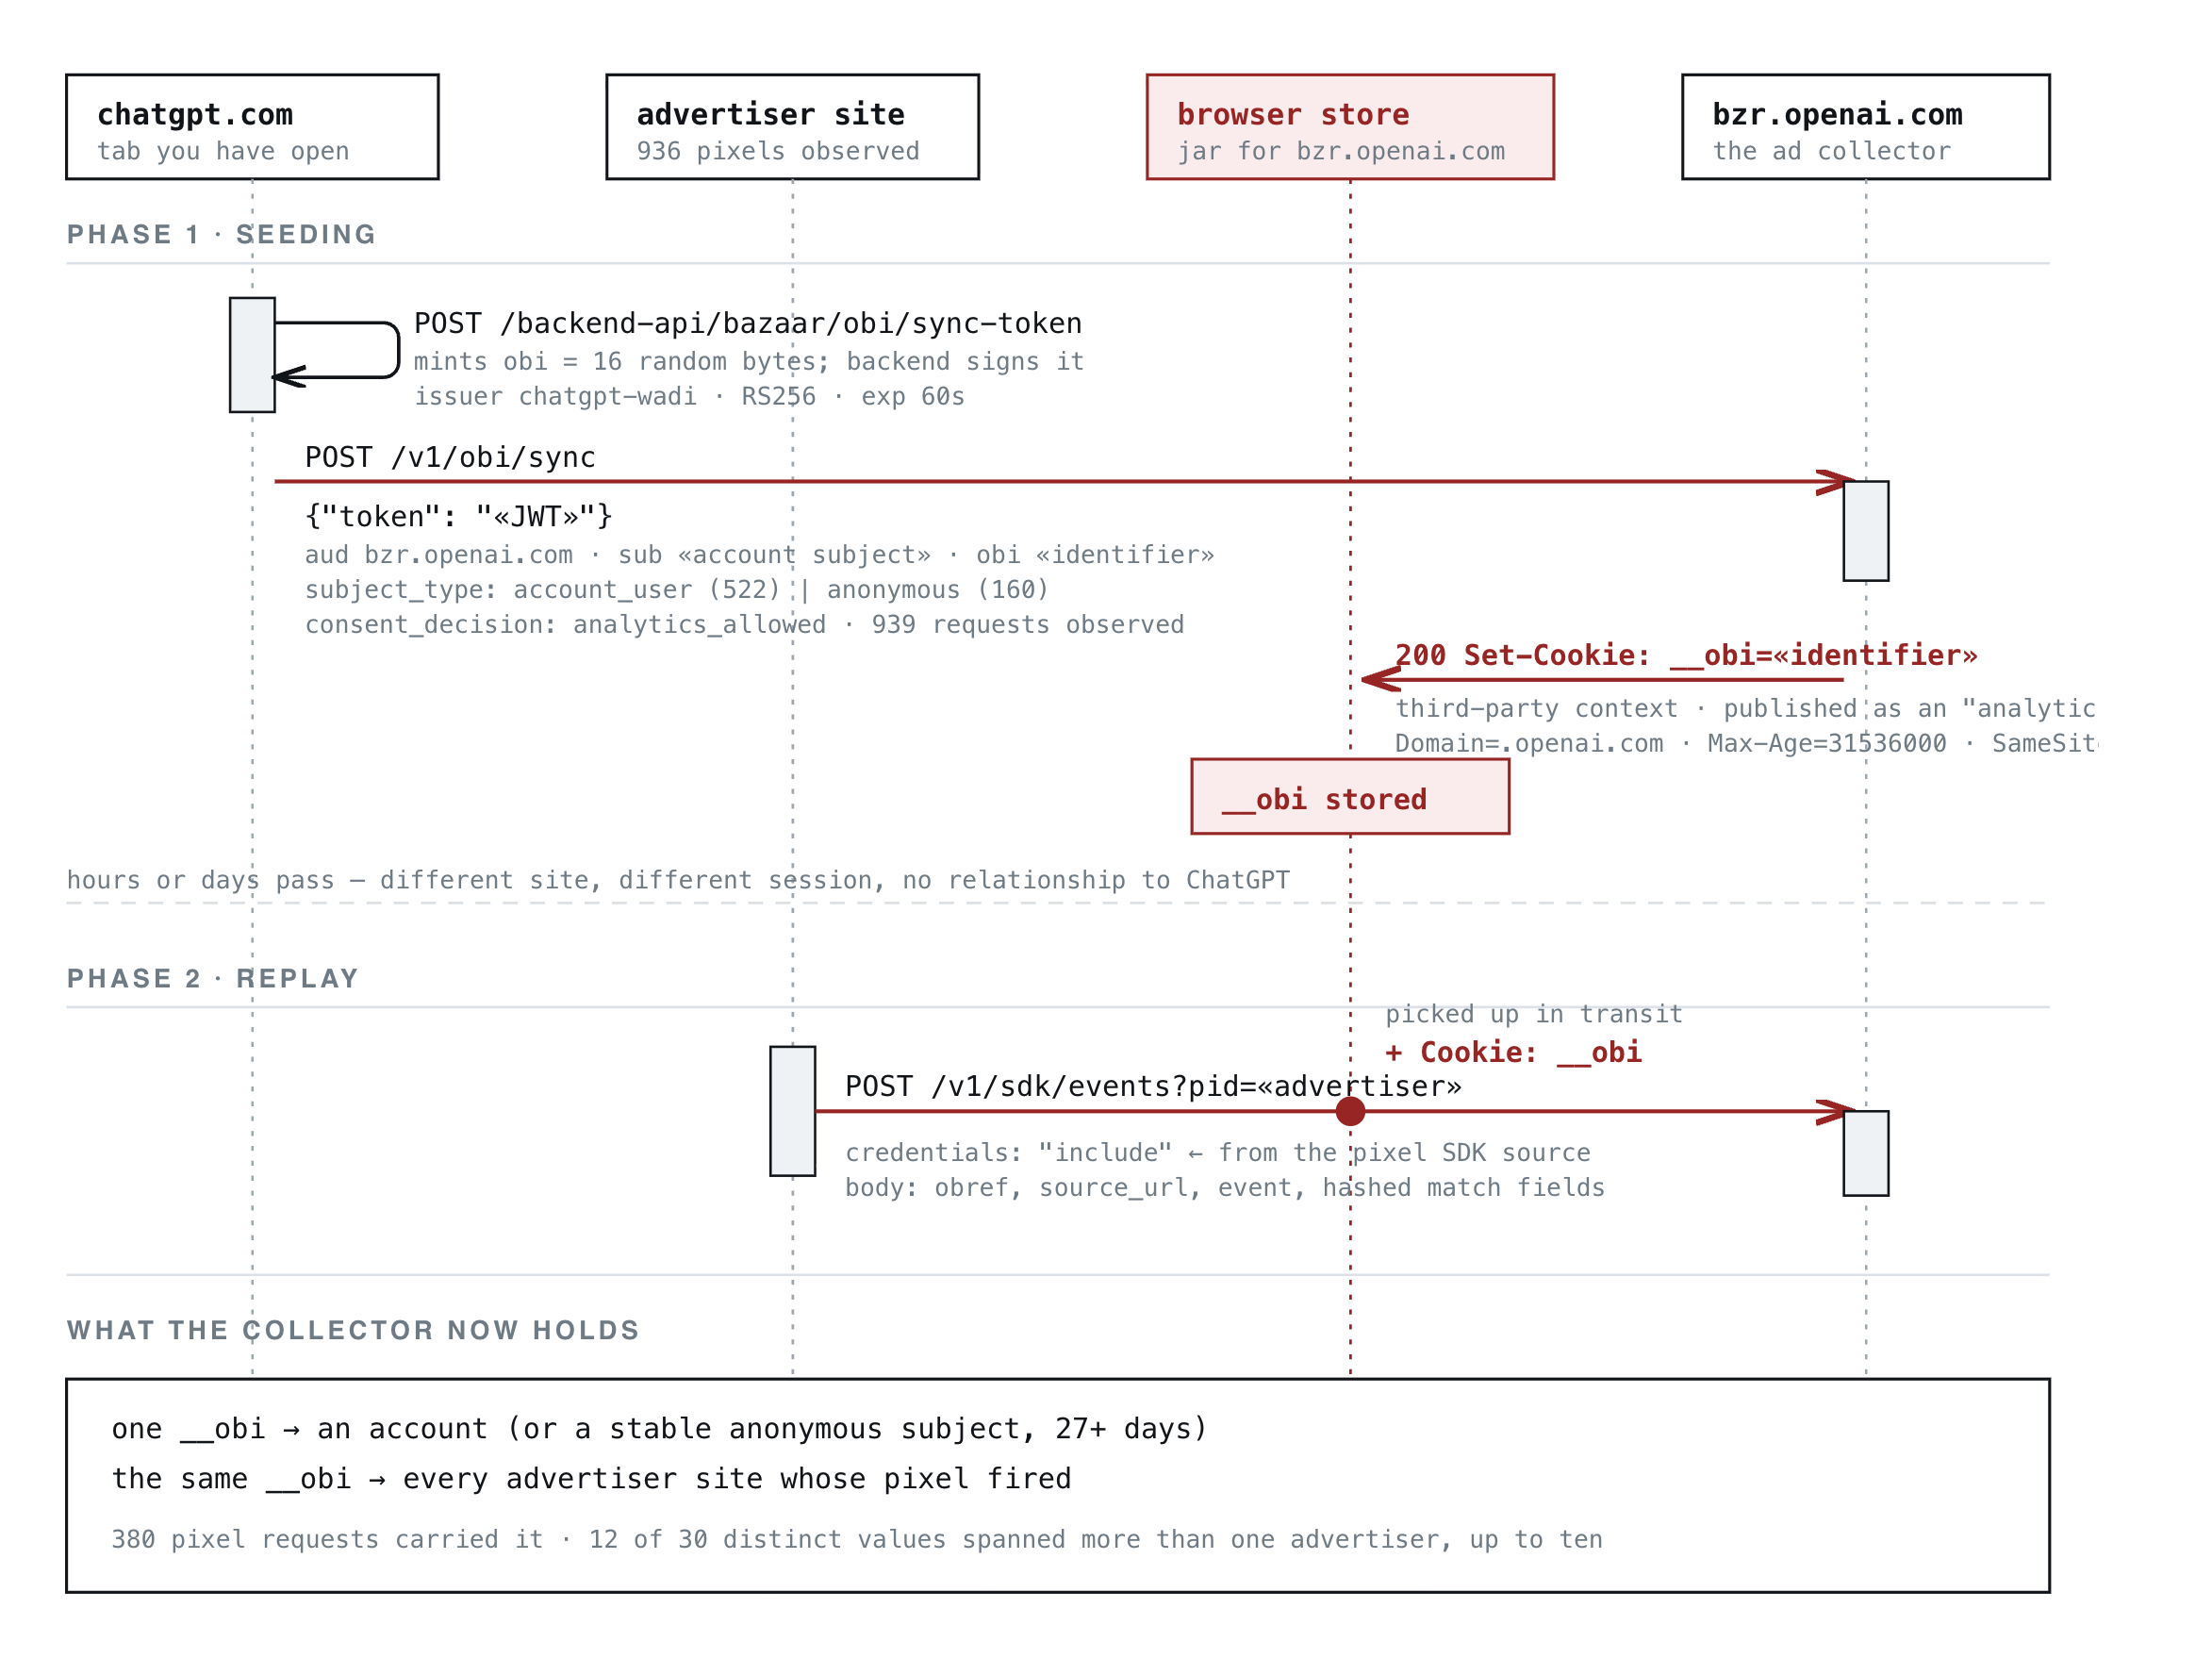
工作原理
第 1 步:ChatGPT 创建标识符并签名。
在 chatgpt.com 上,客户端生成 16 个随机字节,调用 POST /backend-api/bazaar/obi/sync-token(未登录时用 /backend-anon/)。后端返回一个 RS256 JWT,其中 iss 为 chatgpt-wadi,aud 为 bzr.openai.com,purpose 为 obisync,operation 为 set,consentdecision 为 analyticsallowed,consentpolicyversion 为 usergranularconsentv1,sub 为账户的 64 位十六进制标识,subjecttype 为 accountuser,obi 为 22 字符标识符,exp 为 iat+60 秒。sub 是账户,obi 是标识符,令牌把两者绑定,作用域限于收集器,60 秒过期。bzr 代表 bazaar,是 OpenAI 对广告平台的内部叫法;wadi 是签发服务。
第 2 步:标识符变成 OpenAI 域名上的 cookie。
客户端跨站 POST {"token": "JWT"} 到 bzr.openai.com/v1/obi/sync。响应头为 Set-Cookie: __obi=…; Domain=.openai.com; HttpOnly; Max-Age=31536000; Path=/; SameSite=none; Secure。SameSite=none 加 Secure 是 cookie 在跨站请求中发送所需的配置。Max-Age 为一年。JWT 中的 obi 值与 cookie 中的值相同。
第 3 步:广告主网站把它发回来。
从广告主页面到 OpenAI 主机有三类请求。在手机带有 __obi 时,三类都携带它:
| 请求 | 是否携带 __obi | 备注 | | --- | --- | --- | | GET bzrcdn.openai.com/sdk/oaiq.min.js | 是 | 脚本加载本身 | | POST bzr.openai.com/v1/sdk/events 带 obref | 是 | 转化事件 | | POST bzr.openai.com/v1/sdk/events,裸请求体 | 是 | SDK 的“无凭据”路径 | | GET bzrcdn.openai.com/pixel-config/… | 完全没有 cookie 头 | 对照 |
第一行尤其值得注意。像素 SDK 有一条省略凭据的代码路径,但没有用:浏览器在 OpenAI 代码运行前,就会在加载 SDK 的 script src 请求上附带 cookie。仅凭加载标签,标识符就已泄露。
随它一起传输的内容
同一 SDK 还从广告主页面收集身份。载荷按 OpenAI 自己的标签分四类来源:in 是广告主有意传入的值,fm、ht、js 是 SDK 从表单字段、渲染页面文本和标签管理器总线抓取的值。在观察流量中,抓取身份的事件有 685 条,广告主提供的有 255 条。
标签管理器总线是 email 的最大来源。SDK 用自己的函数替换 window.dataLayer.push,也读取 adobeDataLayer,并通过解析 gtm.js script 标签上的 l= 参数定位改名的 GTM 层。当前版本从中取 email 和电话。0.1.31 版还取姓名和地理位置,8 月 27 日范围收窄。
Email、电话、名和姓在传输前经 SHA-256 哈希。国家、地区、城市和邮编明文发送。邮编是最常被采集的表单字段,28 个网站共 100 条事件。
URL 发送前缩减为 origin 加路径;观察到的 23,929 个 URL 都没有查询字符串。路径保留,到达收集器的路径包括一种医疗状况、一个债务解决方案漏斗和一份诉讼受理表。
881 个已知设置的像素中有 638 个启用了自动匹配,包括观察到的所有信贷和贷款广告主。它由 OpenAI 广告管理器控制。拒绝列表排除密码、一次性验证码、卡号、SSN、出生日期、病史、诊断和法院字段。
cookie 是为跨站而建
在同一广告主页面请求上,其他 OpenAI cookie 都被浏览器阻止:
| Cookie | 结果 | | --- | --- | | oai-did, oaicom-stable-id | 被阻止,SameSite=Lax | | oai-client-auth-info,会话 cookie | 被阻止,域不匹配 | | __obi | 已发送 |
__obi 是唯一配置为 SameSite=None 的 OpenAI 标识符。
观察到的覆盖范围
在作者设备上,一个 __obi 值从 12 个商业网站、13 个不同像素 ID 发给 OpenAI,包括 Chewy、Wayfair、ThriftBooks、Eventbrite、HelloFresh、Coursera 和 SeatGeek。每个请求都返回 202。
在更广的流量中,30 个不同 __obi 值里有 12 个出现在多个广告主下,其中一个出现在 10 个广告主下。
登出时也有效
932 个解码同步令牌中,736 个是 subjecttype: accountuser,196 个是 anonymous。匿名主体和账户主体一样稳定:每台设备一个,至少持续 27 天。
OpenAI 的 cookie 政策怎么说
OpenAI 的 cookie 政策把 __obi 列在 Analytics cookies 下,一年,适用于 chatgpt.com 和 openai.com。这是该节唯一条目。政策称分析 cookie 帮助 OpenAI 了解其服务表现和使用方式。
OpenAI 把分析和营销设为两个独立同意选项,oaiconsentanalytics 和 oaiconsentmarketing,作者解码的每个同步令牌都带有 consentdecision: analyticsallowed。允许分析但拒绝营销的人也会得到它。
OpenAI 的回应
作者 9 月 14 日把机制和两个问题发到 press@openai.com 和 privacy@openai.com:为什么 __obi 被归为分析 cookie,以及允许分析、拒绝营销的用户是否仍会收到它。回复来自 OpenAI 支持,确认收到询问,称会内部审查,但没有回答任何问题。上述脚本加载观察是在询问发出后做出的。如果 OpenAI 回应,作者会更新。
局限
浏览器。观察在 Android 版 Chrome 上完成。Safari 的 Intelligent Tracking Prevention 阻止所有第三方 cookie,iOS 上的 Chrome 也运行在 WebKit 上,所以该机制在任何 iOS 浏览器上都不运行。桌面 Chrome 未测试。
门槛。大约每五个 ChatGPT 会话有一个产生同步令牌。ChatGPT 移动网页客户端提供广告但完全不同步。按所给步骤操作的人可能看到像素触发却没有 cookie 附着。
关联未被观察到。202 意味着收集器接受了带有 cookie 的事件。OpenAI 在服务端把它解析到账户,这从设计上可以推出;作者没有直接看到这一过程。
Meta 多年前就建了结构等价物。登录账户、像素触发时的第三方 cookie、站外转化解析到个人资料。机制是标准广告技术。没有先例的是把它运行在 AI 聊天产品上。人们会告诉这些产品一些不会发到社交网络上的事,而这些产品越来越多地代表他们行动。
像素的另一个 cookie 不这么做。__obref 设置在广告主自己的域名上。每个网站得到不同的值,没有网站能看到另一个网站的值。观察到的 2,860 个值中,2,828 个只出现在一个广告主下。
广告主看不到这一点。__obi 属于他们脚本无法读取的域名。他们安装了转化像素,无法知道访客正被解析成 ChatGPT 身份。
评论
社区普遍将OpenAI的广告追踪视为传统广告技术的延续,但因对话私密性与付费前提而倍感不适;少数人理性探讨追踪若可控或有益,但多数人预测必然劣化。
认为追踪机制只是标准广告技术的新场景
- 指出这类用户行为追踪与关联分析正是多年来Facebook、Google等推动数据科学的动机,OpenAI仅将其跑在AI聊天产品上并无技术新意(较多人) > 追踪消费者并挖掘消费关联加以利用,正是当年“数据科学”和“机器学习”热潮的全部理由(@Avshalom)
认为在付费AI对话中被追踪更令人不安
- 用户与AI交谈时抱有比刷社交平台更高的隐私预期,且已付订阅费却仍遭监控,产生被背叛的恶心感(较多人) > 机制虽标准,但跑在AI聊天产品上史无前例,明知细节仍每次重读都觉得膈应(@mavsman)
主张用浏览器隔离和屏蔽手段自保
- 推荐使用Firefox等默认隔离cookie的浏览器、DNS黑名单或定期清cookie来阻断跟踪,并疾呼将广告视作瘟疫彻底封锁(较多人) > 除非你允许第三方cookie和广告,否则不该发生;广告永远别放行,要像打瘟疫一样在各处阻击(@hagbard_c)
警惕监控权力扩张并呼吁监管
- 认为监控经济借AI赋予巨头前所未有的操控普通人的力量,必须从这类行为启动立法(较多人) > 我们完了,监管就得从这开始(@jamienk)
认为追踪或能改善产品但终将劣化
- 区别于传统网页广告纯负收益,若OpenAI让用户自主授权并可调阅历史来调优回答或有用,但预测其必先建转化跟踪再卖广告导致聊天产品熵增(少数人) > 惯常的“广告跟踪坏”在此案或需重新考虑,模型知你习惯确可优化回应,但预测他们终将造广告平台搞臭产品(@jfasi)
讽刺内容窃取与双重标准
- 指出巨头抓取全网内容放广告若个人做会入狱,却因政治献金逃脱,建议技术自卫(少数人) > 个人做同样事会坐牢,太大而不能倒的行业借政治捐款就没事?(@ck2)
有价值的补充
- 有用户指出该OpenAI像素追踪至少从4月起就有公开报道,并非新发现。
- 第三方数据显示接入ChatGPT广告跟踪器的网站数量月度翻倍。
- 推荐使用tinfoil.sh之类声称无法窥探用户的LLM服务作为缓解。
- 有用户调侃想在ChatGPT投广告,但受众将是舍不得买订阅的廉价用户。
- 有用户以玩笑表达脱离网站生态的无视态度:不再上网站所以无所谓。