我们开源千问图像2.1(Qwen-Image-2.1),这是千问家族中平衡生成质量、推理效率和成本的图像模型。它在单一模型里统一文生图与图像编辑,视觉生成组件仅7B参数,原生支持生成和编辑透明图像。此次更新带来紧凑高效、原生透明统一创作与编辑、最多用10张参考图的通用编辑,以及真实纹理与精致美学等四项改进。
正文
我们正式开源 Qwen-Image-2.1,这是 Qwen 家族中的图像模型,在生成质量、推理效率与成本之间取得平衡。Qwen-Image-2.1 把文生图与图像编辑统一在同一个模型里,其视觉生成部分只有 7B 参数,并原生支持生成与编辑透明图像。
本次更新带来四项关键改进:
- 紧凑高效:轻量架构加推理优化,在图像质量与算力开销之间取得平衡。
- 原生透明,创作与编辑统一:可根据提示词生成普通图像或透明图像,编辑透明图层,也能从照片中抠出主体。
- 编辑能力全面:最多可使用 10 张参考图,支持局部编辑,保持人物与商品一致性,覆盖多种任务。
- 真实质感与精细审美:文字排版、人像光影与细节均有提升,生成图像视觉效果更具吸引力。
紧凑高效
Qwen-Image-2.1 采用轻量架构,视觉生成部分包含 32 层 Single-Stream DiT,7B 参数。尽管体量紧凑,图像生成质量依然出色。下图的 Qwen-Image-Bench 对比展示了它与其他开源、闭源模型的性能。
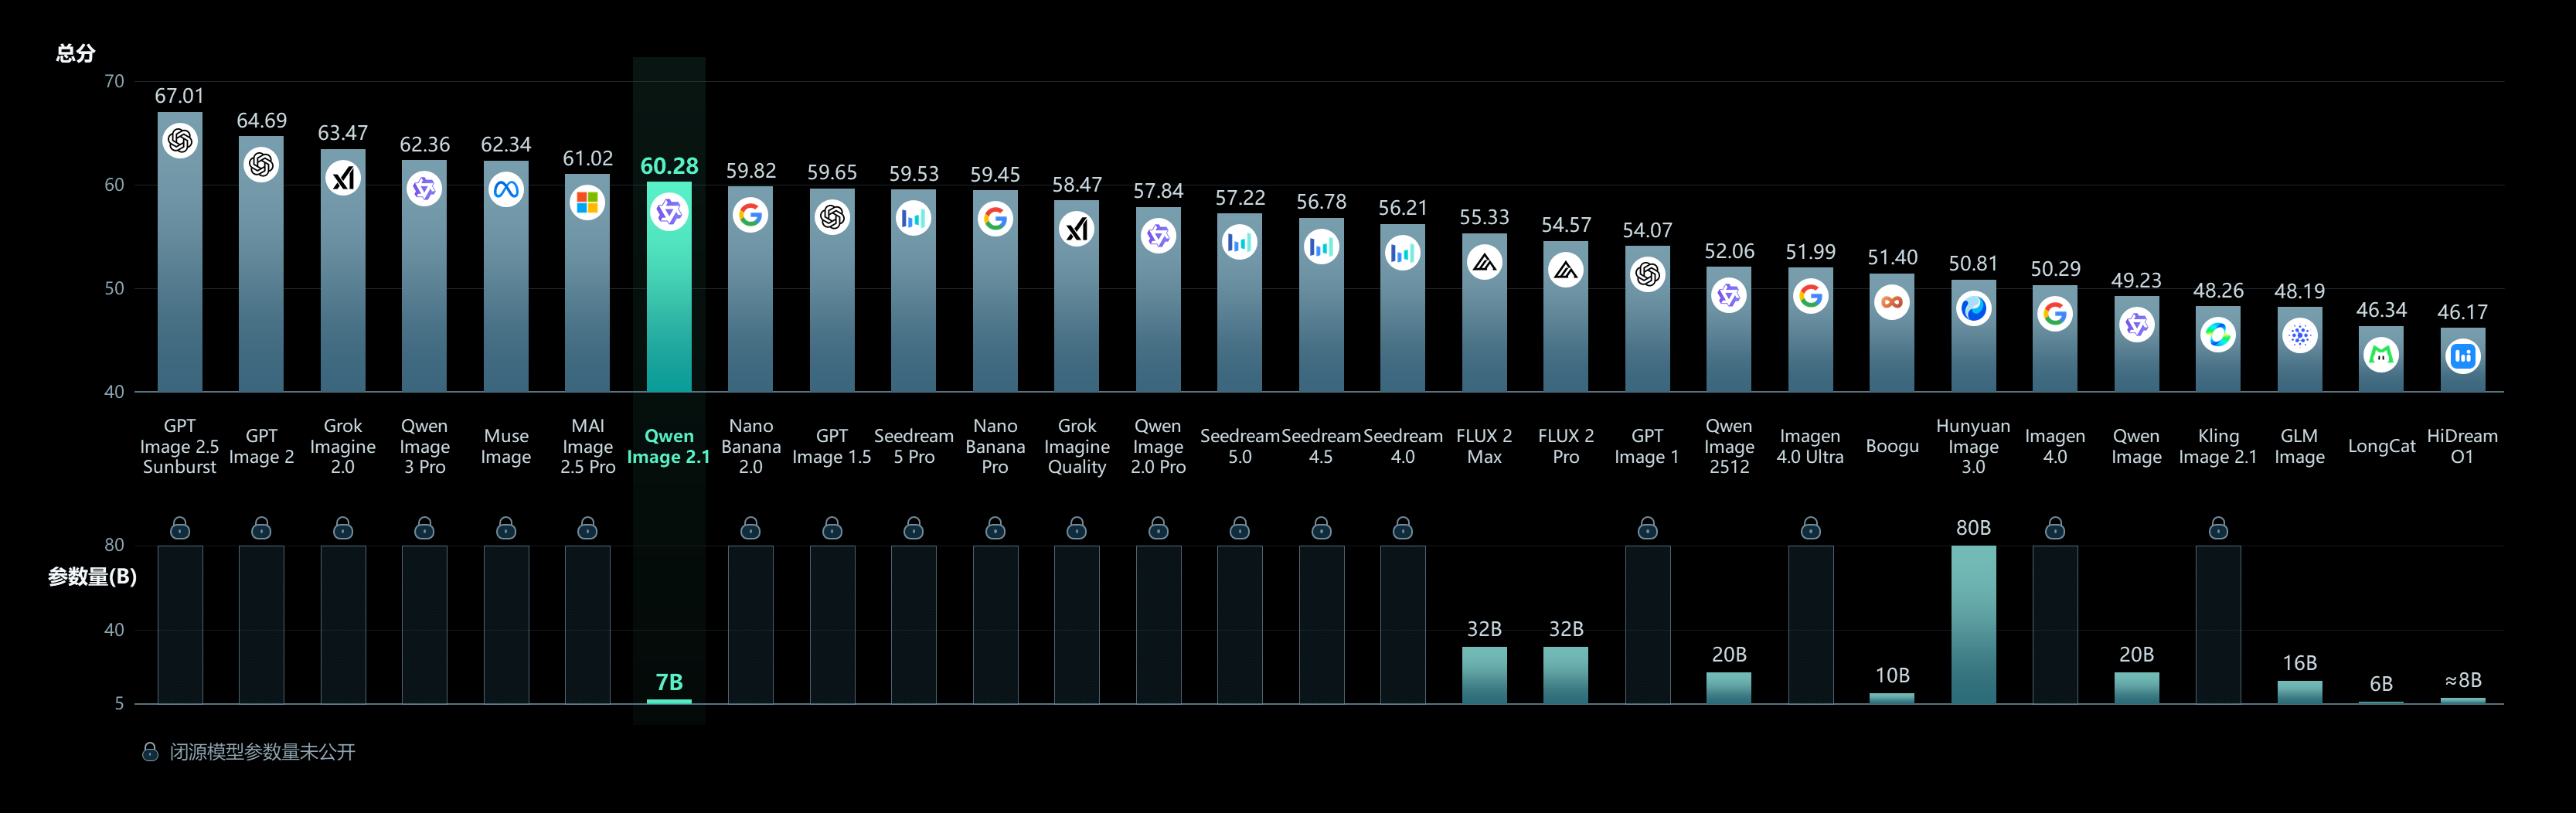
Qwen-Image-Bench 评测对比
推理效率是另一个重点,尤其是在使用多张输入图像进行编辑时。这一优化来自混合粒度注意力架构:文本(包括系统前缀与编辑指令)使用 token 级因果掩码,图像生成使用 chunk 级掩码。KV 缓存复用让输入图像与编辑指令作为静态上下文,在第一步计算并缓存,从而提升推理效率、降低内存占用。
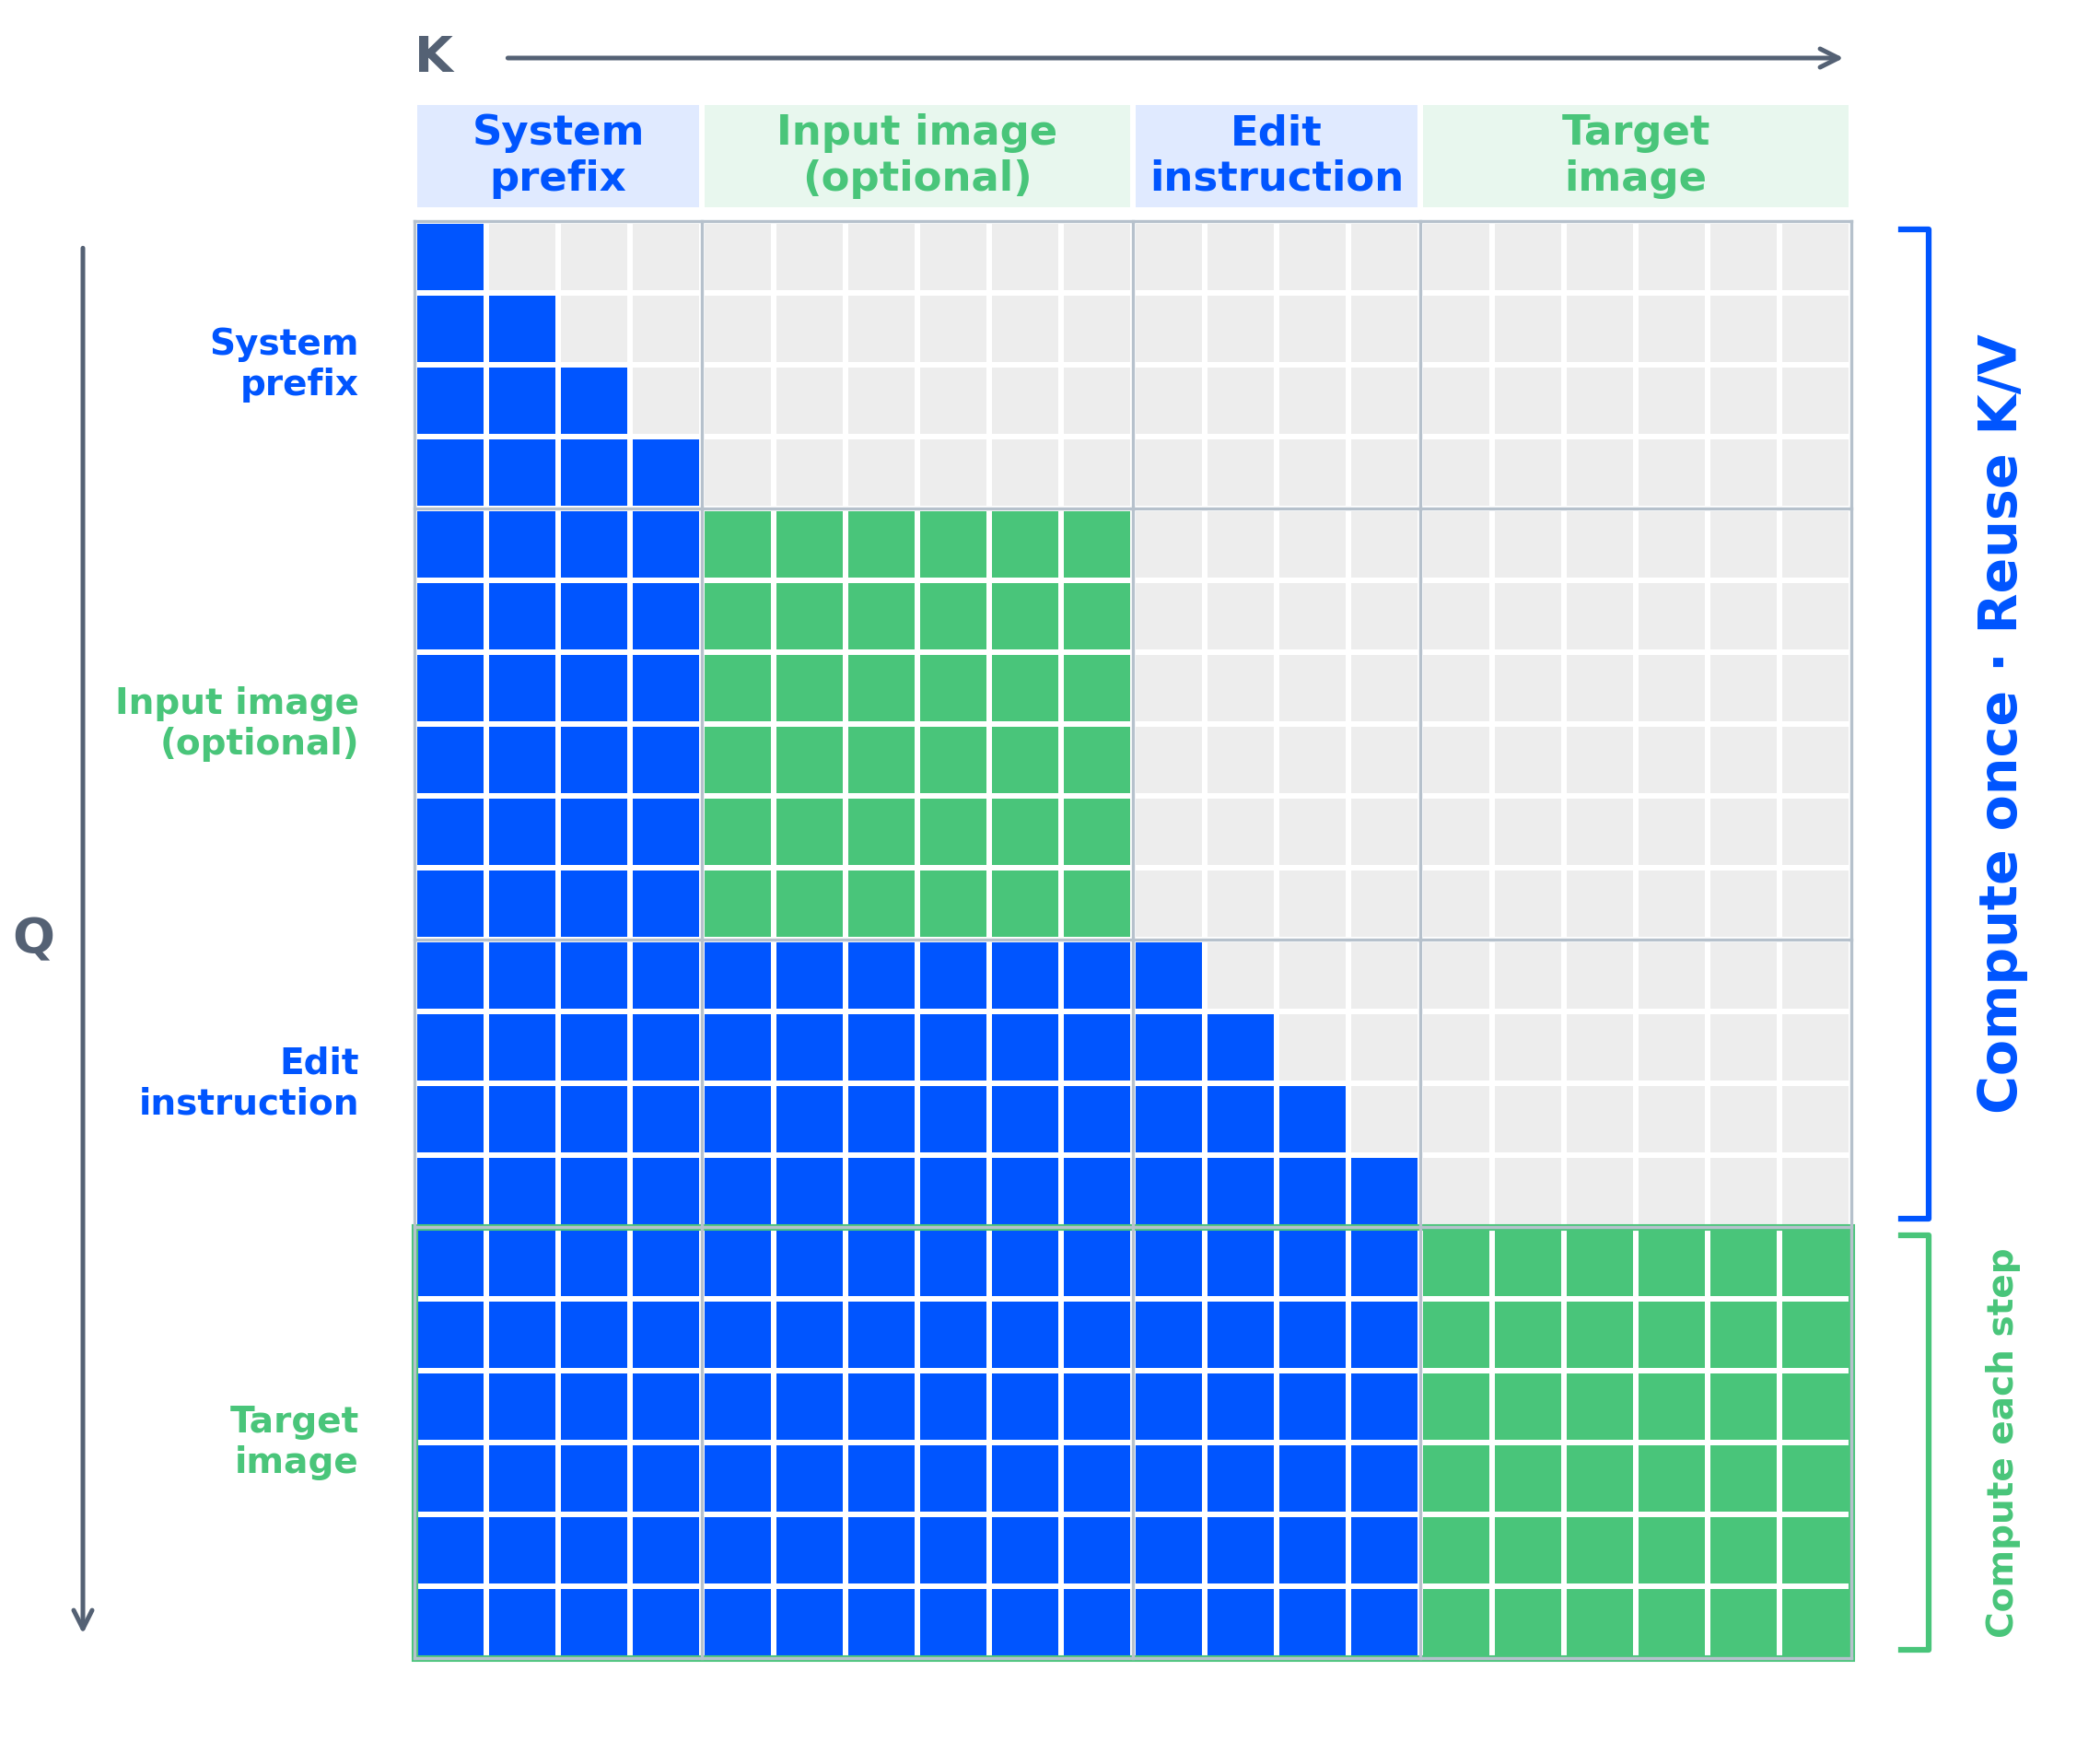
Qwen-Image-2.1 混合粒度注意力架构
原生透明,创作与编辑统一
原生透明是本次发布的重要新增能力。2025 年 12 月我们曾推出专用模型 Qwen-Image-Layered 来支持透明图像生成,如今 Qwen-Image-2.1 将这一能力整合进统一模型,由提示词决定输出普通图像还是带透明通道的图像。
以下是由文本直接生成的透明图像示例:
除了单个主体,模型还能生成由多个元素构成的更复杂的透明图像,为设计与素材创作带来更多可能。

由于生成与编辑被统一起来,Qwen-Image-2.1 也支持直接编辑透明图像。例如,它可以在保留透明背景的同时改变主体的表情。左侧为输入,右侧为编辑结果。


透明图层中的文字同样可以编辑。在下面的例子里,“BLOOM”被替换为“Qwen-Image”。


这一能力也延伸到真实照片上。给定一张 RGB 图像,模型可以把所需主体提取为带透明度的 RGBA 图层,方便在后续设计与合成中复用素材。
编辑能力全面
Qwen-Image-2.1 在四个方面改进了编辑:多参考图、局部编辑、保真度与任务覆盖。
多参考图:最多 10 张输入图像
Qwen-Image-2.1 支持最多 10 张参考图,可将多个主体与素材合成连贯的画面。在下面的合影示例中,左侧的六张单人肖像被合成到一张照片里。
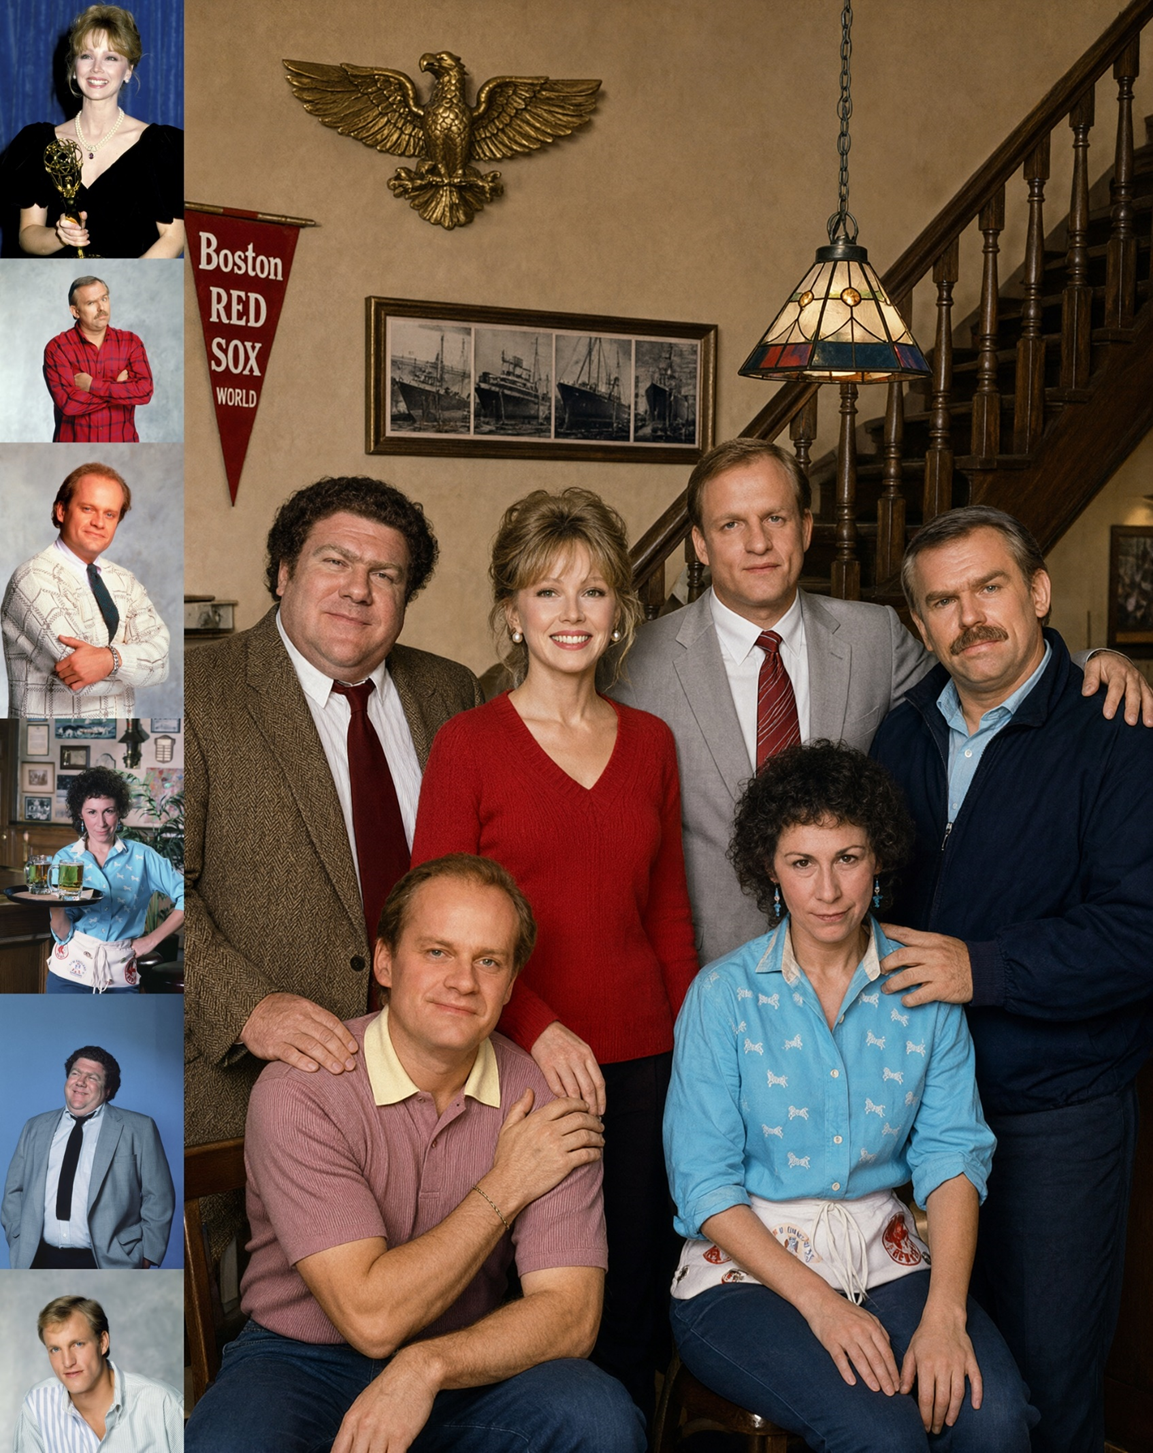
由六张肖像参考图生成的合影
虚拟试穿场景下,模特、服装、鞋子、包和帽子五张输入图可以组合成一套完整造型。
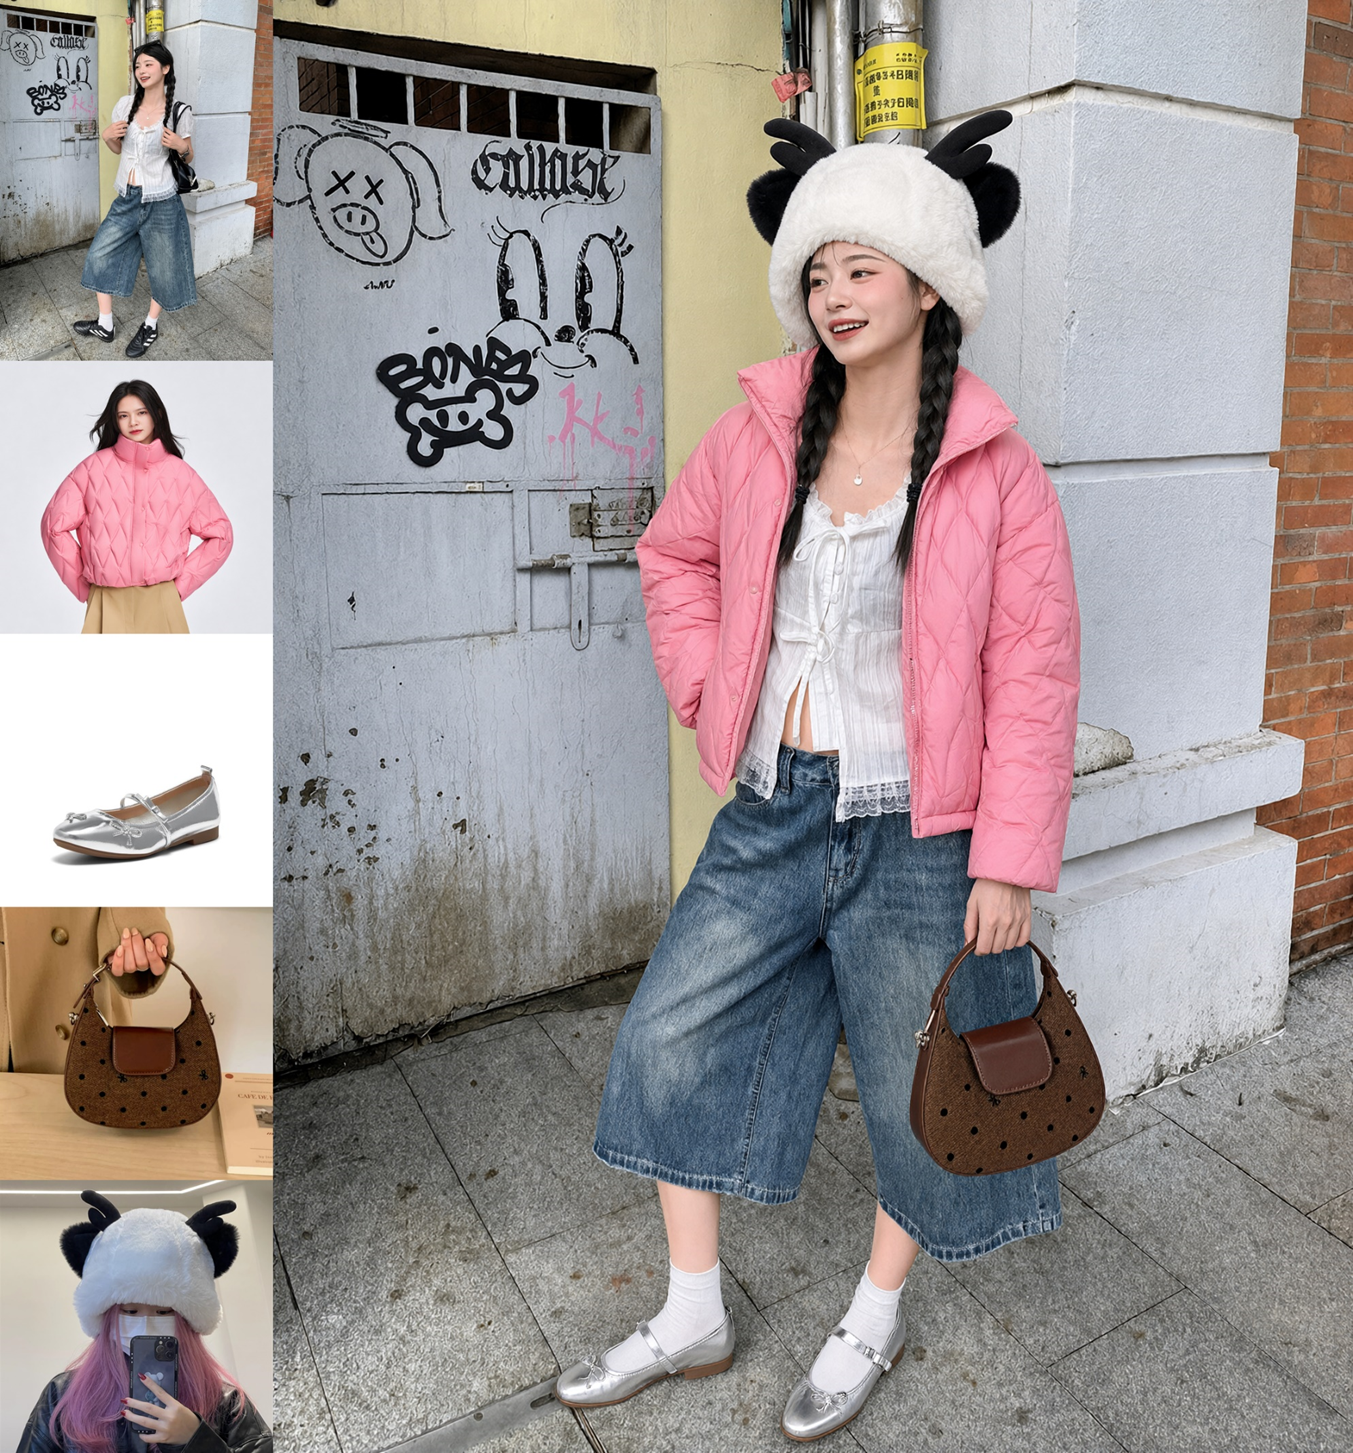
由五张参考图生成的完整造型
在室内设计中,模型可以用 10 张家具图片生成完整的房间布局。
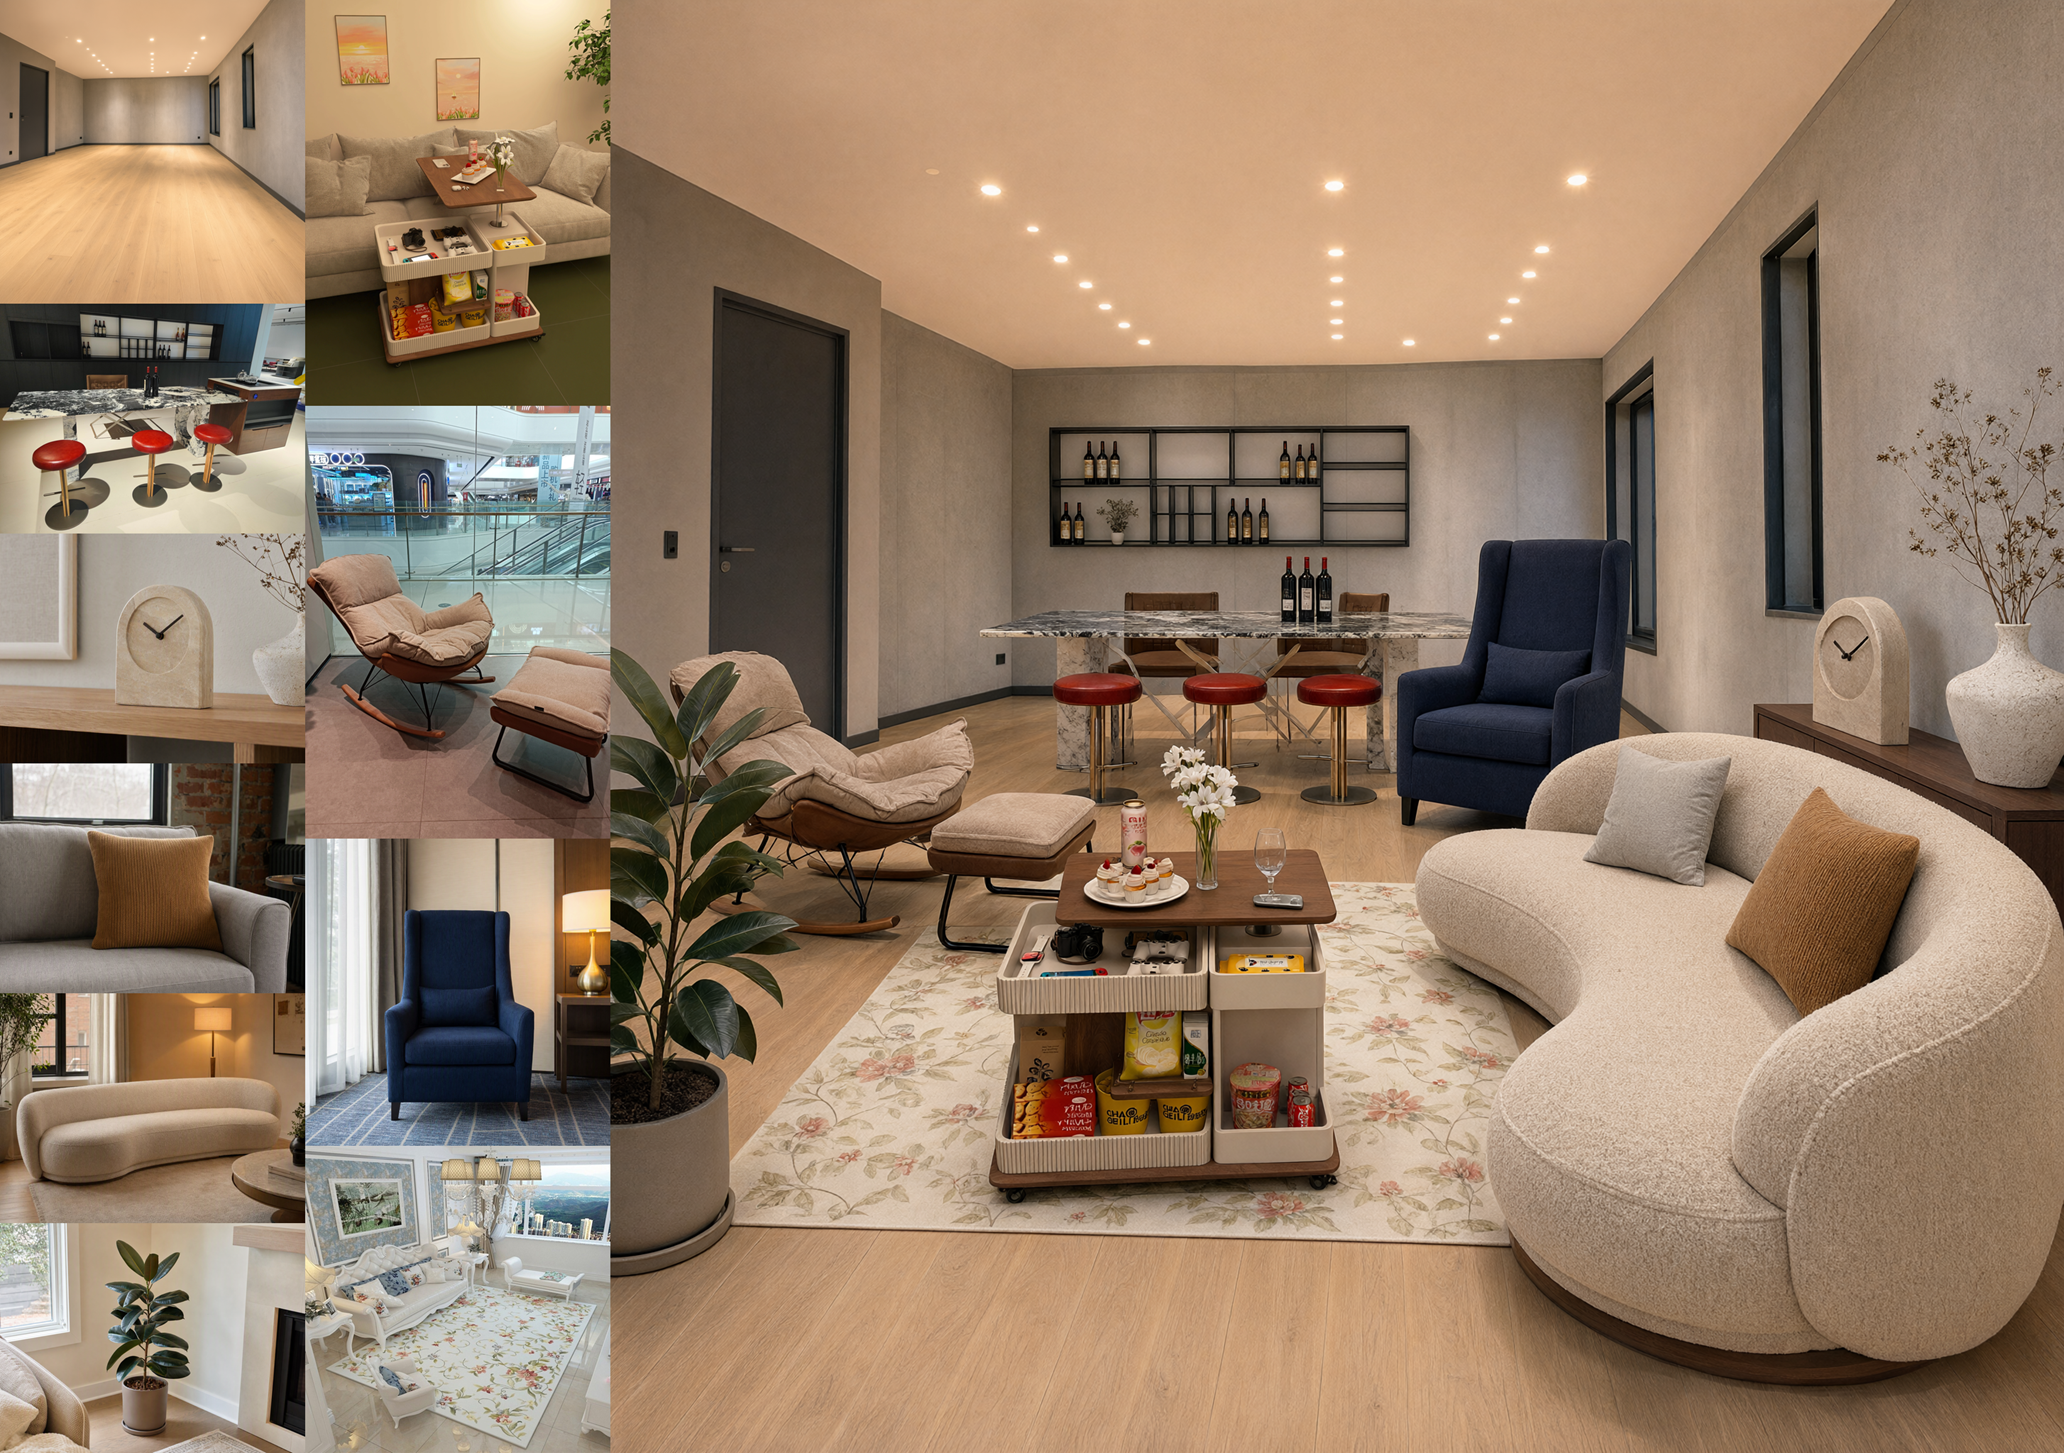
由十张家具参考图生成的室内场景
局部编辑:灵活选定区域
Qwen-Image-2.1 支持用圆圈、涂抹标注以及独立掩码来指定编辑发生的位置。
第一个例子用不同颜色的圆圈一次性标出三个区域:“去掉蓝色圆圈里的金属手表,把红色圆圈里的头发变成黑色,把绿色圆圈里的区域替换成灰色短袖亚麻睡衣。”左侧为标注后的输入,右侧为结果。
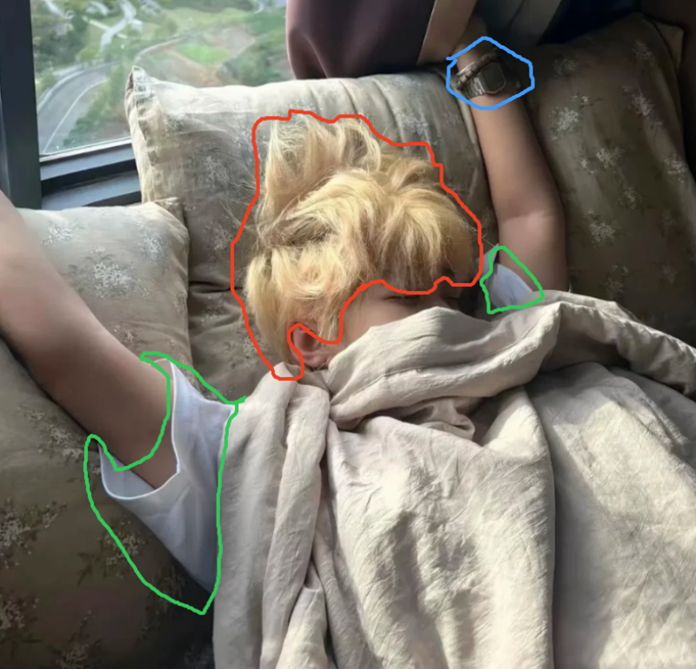
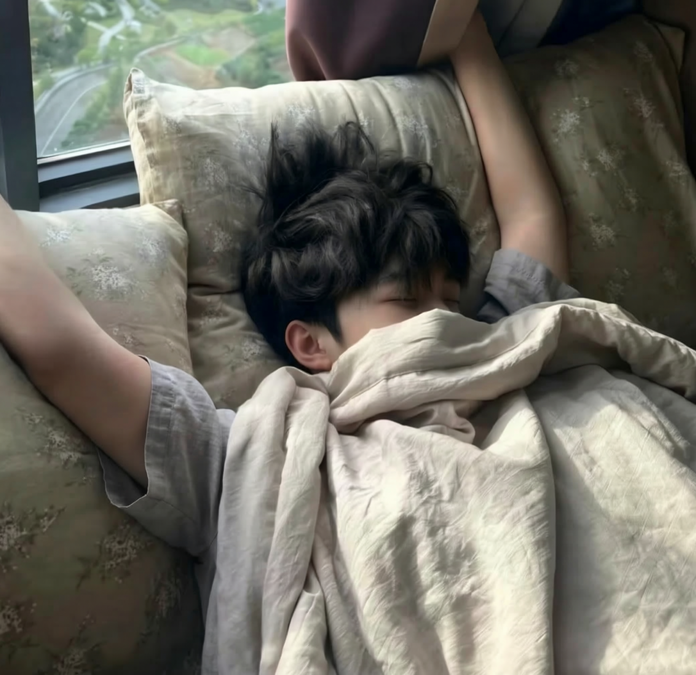
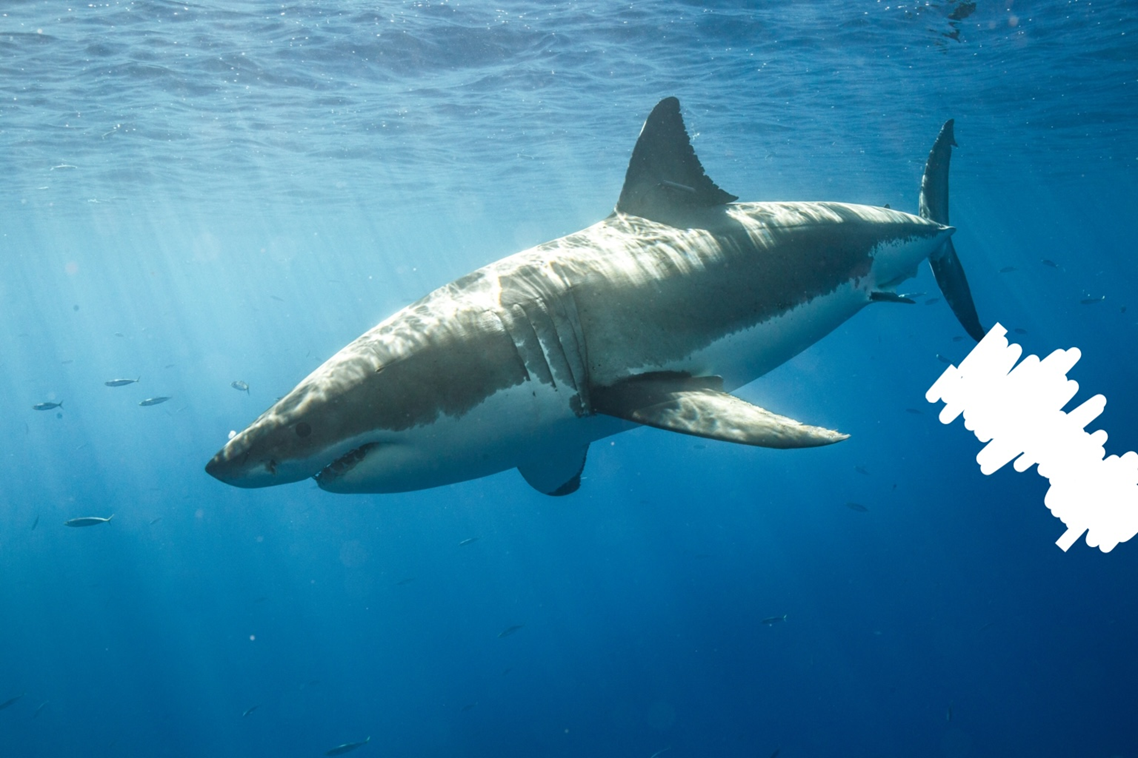
涂抹标注是另一种圈定区域的方式。在这个例子里,模型在输入图右侧白色标记区域中加入了一名潜水员。
圆圈与涂抹标注会遮挡部分原始内容。为了完整保留输入,Qwen-Image-2.1 也接受原图与独立掩码作为两张输入。下面的例子要求模型生成一个骑马的牛仔,输入就是这两张图。
模型对掩码指定区域进行编辑,得到如下结果:
掩码引导编辑结果:骑马的牛仔
局部编辑还支持连续创作。在保留场景其余部分的前提下逐步修改,编辑后的图像可以拼接成简单动画,下面的水豚葫芦兄弟示例即是如此。
保真度:保持人物与商品一致
保真度的提升集中在人像身份与商品一致性上。人像方面,模型能更好地保留面部特征,让同一个人的身份在多次编辑中更稳定。下面每一组都是左侧输入、右侧编辑结果。
商品编辑方面,模型力求保留文字、质感与形状,让商品在新图像中保持其标志性特征。
任务覆盖:全景图、信息图与分镜
Qwen-Image-2.1 支持范围广泛的编辑任务,包括全景图、信息图和分镜图生成,在不同应用中保持能力平衡。
例如,从这张自拍出发:
全景图生成的自拍输入
模型生成了如下全景图:
由自拍生成的全景图
随后可以在可视化工具中从不同视角浏览这张全景图。
信息图生成方面,一张模特照片可以扩展为细节丰富、信息密集的画面。
信息图生成的模特照片输入
由模特照片生成的复杂信息图
模型还能把角色三视图转成完整分镜,为叙事和视觉表达提供素材。
分镜生成的角色三视图参考
由角色参考图生成的完整分镜
真实质感与精细审美
Qwen-Image-2.1 进一步提升视觉质量,尤其关注文字排版与人像。文字渲染不仅考虑内容本身,也考虑字体风格、版面以及它们与整体构图的关系。以下示例展示了不同场景下的文字渲染效果。
人像方面,光影与细节的改进让生成图像外观更真实。
结语
凭借紧凑的 7B 视觉生成组件,Qwen-Image-2.1 把图像生成、透明度以及广泛的编辑能力汇聚到一个模型中。更快的推理速度、最多 10 张参考图、灵活的局部编辑,以及对人物与商品保真度的提升,使它成为设计、内容创作、电商和视觉叙事中实用的工具。
评论
社区整体情绪是惊喜与感谢,盛赞本地 7B 模型能达到这种图像生成水准,主要分歧落在许可证从宽松转向更严格,以及它是否真配得上超越自家闭源版本的期待;技术讨论则集中在图像生成为何比代码生成"看起来更成功"。
本地图像生成已经跑在本地代码生成前面
- 有从业者认为,本地文生图几秒出图、质量远超对本地模型的预期,而本地代码生成又慢又不出彩(较多人) > 本地出图几秒就有,质量远超我对本地模型的期待;写代码却慢得多,成果也远不如人(@fishfasell)
- 原因被归为失败模式不同:图像只要扫一眼一帧就能判断好坏,代码却要求几百个 token 按顺序全部正确,一行错就整体崩掉(较多人)
- 7B 规模就能渲染好中日韩文字,有人调侃这已经强过 Windows 的文字渲染(较多人)
- VAE 终于被修好,此前它拖累了该团队两年的模型表现(较多人)
许可证收紧是这次发布最扫兴的一笔
- 此前 Qwen 系列多用 Apache 等宽松许可,这次明显更严格,让期待延续传统的人失望(较多人) > 开源图像模型是好事,但许可证让人失望,而且它连自家那个已经有点老的闭源图像模型都没打过(@gunalx)
- 也有直接质疑能力高低的:新模型未能胜过已显老态的闭源 Qwen3 图像版本,削减了发布的意义(少数人)
感谢中国实验室持续把最强模型开源出来
- 有人认为若只靠美国实验室,用户就得为使用模型支付高昂的 API 费用(较多人)
- Qwen 的模型谱系在中国实验室中最多样,能与之相比的只有 Gemini/DeepMind(少数人)
能力之强本身也让人不安
- 7B 模型能到这个程度意味着影响巨大,且 Qwen 目前还没有加水印(少数人)
细节瑕疵:人物被泛化,风格彩蛋缺席
- 在复现《Cheers》卡司的例子中,原本鲜明的 Shelley Long 被画成了路人脸(少数人)
- 有人对《Bluey》例子很满意,唯独抱怨少了 Muffin 这个角色(少数人,玩笑)
有价值的补充
- 有人关心能否像
llama-server -m那样直接本地跑,而不是深度依赖 Python,并要求走最高效的推理路径。 - 图像评估是单帧、可直觉判断,代码评估是长序列、逐 token 严格校验,这一差异被用来解释为什么本地图像模型的体感成熟度远高于本地代码模型。