UTF-8000把UTF-8的编码范围继续往上扩,主张 ASCII ⊆ UTF-8 ⊆ UTF-8000,并强调没有引入任何特例,原有性质全部保留。项目提供了参考实现,可用 pipx 安装,还列出多组编码示例,其中22字节的码元以11111111、10111111、10111111、10110xxx开头。据其说明,这是个独立的有趣项目或提案,与 Unicode Consortium(统一码联盟)无关。
正文
无限的 UTF-8!ASCII ⊆ UTF-8 ⊆ UTF-8000。
没有引入特殊情形,所有属性都保留。
可通过 $ pipx install UTF-8000 安装参考实现试用。
UTF-8000 绝不经由或代表 Unicode 联盟认可,只是一个有趣的独立项目/提案。
TLDR / 示例
ASCII
10xxxxxxx
UTF-8
2110xxxxx``10xxxxxx
31110xxxx``10xxxxxx``10xxxxxx
411110xxx``10xxxxxx``10xxxxxx``10xxxxxx
UTF-8000
5111110xx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
61111110x``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
711111110``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
811111111``100xxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
911111111``1010xxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
1011111111``10110xxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx
...
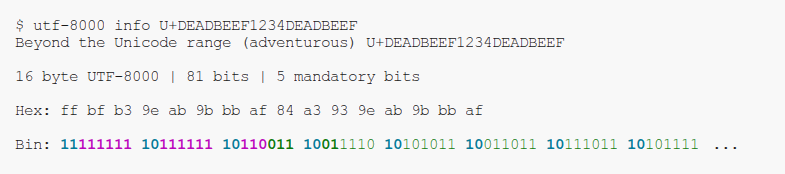
2211111111``10111111``10111111``10110xxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx``10xxxxxx...10xxxxxx
...
此处 22 字节码元示例并无特殊,只是典型展示 UTF-8000 多起始字节之力。
唯有两个特例,均承自 UTF-8:ASCII 原样;2 字节 UTF-8 有 4 个强制内容位查过长,更长码元皆 5 个。
Anatomy
以下是 tldr 中 22 字节码元的解剖图。
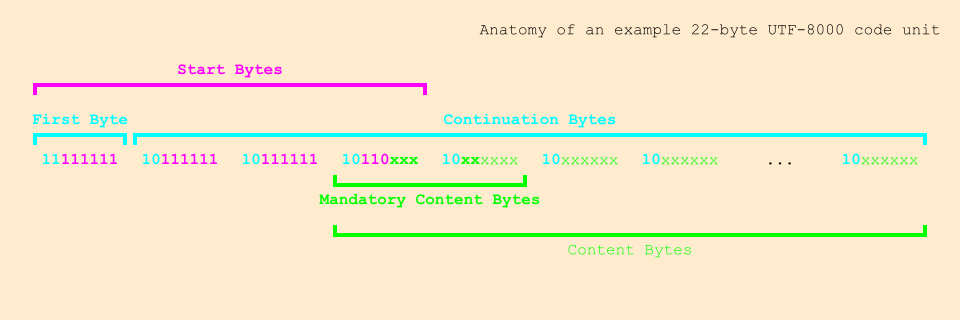
UTF-8000 规范主要贡献:厘清将 UTF-8 首字节最高位拆为自同步位与起始位,并明确在需时将起始位条带分布至连续字节,实现任意大码元。
第四字节有趣:它既是连续字节,又是起始字节、末起始字节,含内容位且仅部分强制内容位,横跨末起始字节与首非起始字节。
Glossary
术语按需求序:码点为非负整数。码元为编码单码点的 UTF-8000 字节序。首字节是码元首字节,自同步前缀 0(ASCII)或 11(多字节),必为起始字节但不等同。连续字节为首后字节,前缀 10。自同步前缀为每字节最高位,成树:0 ASCII首,10 连续,11 多字节首,提供字节级自同步,随机查找可判位。起始字节含起始位,位于码元头,可有多个;首起始字节即首字节。起始位为多字节起始字节中一元码 111...10(n-2 个 1 加 0)示长 n,提供自标点。内容字节含内容位。内容位存码点二进制:ASCII 7 位;n>1 有 5n+1 位(每字节 8 去 2 同步去 n-1 起始得 5n+1)。强制内容字节/位用于查过长:ASCII 0 个,2 字节 4 个,n>2 为 5 个。过长编码指可用更短码元却用长码元,禁止,如 2 字节 11000001``10000001 编码 A 无效。
Properties
Bit Counts
| 码元长度 | 内容位数 | 强制内容位数 |
| --- | --- | --- |
| n = 1 | 7 | 0 |
| n = 2 | 5n+1 ( = 11) | 4 |
| n > 2 | 5n+1 | 5 |
Why the Special Cases?
仅两特例承自 UTF-8:1 字节 ASCII(7 内容位不合 5n+1,0 强制位因最短);2 字节 UTF-8(4 强制位非 5)。UTF-8000 未添新特例,印证其为扩展正途。
Information Rate
ASCII 占 7/8=87.5%。n 字节占 (5n+1)/(8n) → 5/8=62.5%。
Self-Synchronization
承自 UTF-8,首与连续字节值不交,可随机定位。
Self-Punctuation
起始位序列提供自标点,读至终止 0 即知长。
Byte Map
扩 UTF-8 字节图,0xC0/0xC1 永不出(番茄红),因过长禁。ASCII 金黄,连续沙棕,余首字节标长。
strcmp(3) Ordering
自同步前缀与起始位序列随长单调增,内容位随码点单调增,故 strcmp 可直接比编码字节不解码。
No Endianness
以字节量子,无端序。
BOM Support
支持 BOM,或可多样 BOM 示最大期望长。与 UTF-16 不互斥。
Arbitrary Lengths, Sensible Limits
码元可任意长,实可限长。当 5n+1=2^N 时 n=(2^N-1)/5,N=4K 得整数:K=1 n=3(16位), K=2 n=51(256位)等。
Intuitive Derivation
从 UTF-8 扩展起始位至连续字节。
空白推导
n 空白字节,首字节最高位 0/1 分首/连续,但破 ASCII 兼。改自同步前缀 11 首、10 连续,起始位树仅多字节。终得 UTF-8000,模式如前示。
Encoding
基于 Python 参考实现。编码整数 n:n<0x80 存 ASCII;否则循环取低 6 位入数组,算需字节数 ⌈(bits-1)/5⌉,左填,加起始位(q,r = divmod(n_bytes-2,6)),冠自同步 11/10。例 n=0x0321C0FFEE8086 得 10 字节。
Decoding
Error Recovery
错型:1 期首遇续;2 期续遇首;3 早 EOF;4 过长(2字节禁 0xC0/0xC1,n>2 例 11100000``10010111``10010000);5 代理码点。恢复可最大子部或每字节一 �(Python 采每字节)。
The Main Decode Loop
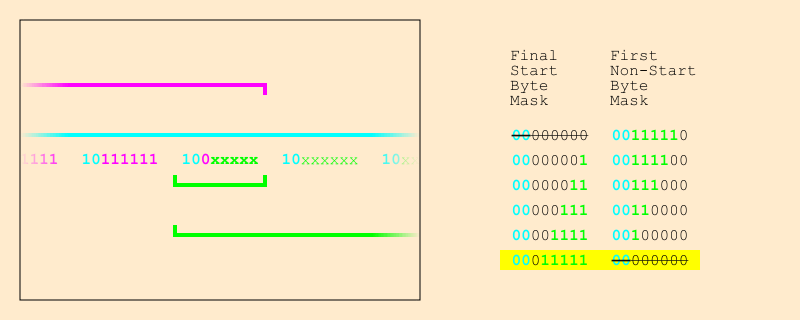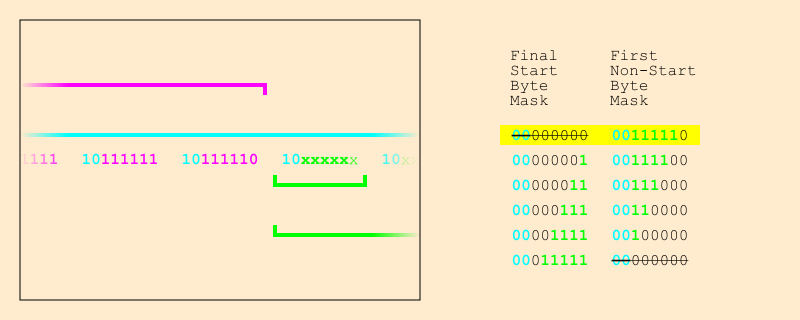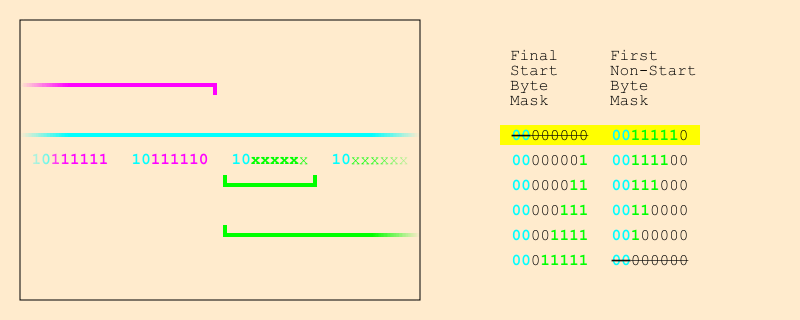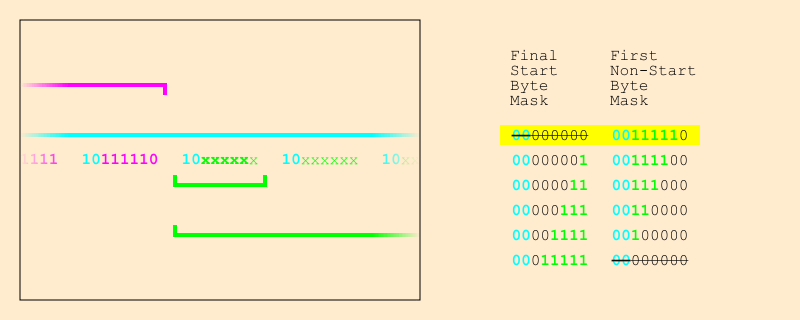
读首字节找最高零位 idx0。7 为 ASCII;6 为续错;5 为 2 字节特例查过长;否则通用:按起始位定预期长,多起始字节时循环读至终止 0。依 idx0 查过长,图示。
Further Ideas
有符号变体:ZigZag 编码
zigzag 映有符号至无符号:z≥0 为 2z;z<0 为 -2z-1。例 zigzag(-1)=1, zigzag(1)=2。分支无关 (z<<1)^(z>>31)。内容位同 UTF-8000 但表有符号,失 strcmp 序,需改比较。结论加 -z 标志好用。
UTF-16K
用 ASCVI-on-UTF-16 扩 UTF-16,禁 Plane 9/10。TLDR 示多 surrogate 对。比特:2字节16,4字节20,8字节(2对)31等。信息率 15/32=46.875%。自同步在双字节级。老 UTF-16 解析语义误但不语法错。
UTF-32K
扩 UTF-32 量子 32 位,有端序,效率低,非优先。
Rejected Alternatives
ASCVI
ASCII 变 6 位,信息率恒 75%,缺灵活。
Signed Variant: Two's Complement
过长检查移位,失 strcmp,劣 zigzag。
UTF-Infinity
起始位滚新字节,失自同步致命。
Perl utf8
限 13 字节不可无限。
UCS-X
复杂,UTF-∞-8 效率更高但繁。
Owl's Corrected UTF-8
无自同步。
Do Nothing
作者主发布。
Feedback
Ken Thompson
邮复:5,6 字节扩展已预见,7-8 字节稍怪需读全串知长,如 ipv50 无用。允公开。
Zachary Weinberg
赞自同步技,但 elim 过长对安全重。
Tom Bishop
指“正确”主观,utf8 可扩,码元标准定义异。作者辩并修。
Reference Implementation and Tools
UTF-8000
Python 实现 pipx install UTF-8000,令 utf-8000 info/encode/decode。
UTF-16K
类 pipx install UTF-16K。
Naming
候选 UTF-8000、UTF-8K、UTF-8 & Knuckles、VTF-8、STF-8,倾向 UTF-8K。
Logo
自设计罗马风鹰徽,非必要细节略。
Licensing
CC-BY-NC-SA-4.0 等,自由用。
评论
多数人质疑 UTF-8000 的实用性与对 UTF-8 原有特性的破坏,少数人赞赏其作为可编码任意大数的巧妙黑客实验并为外星语言或大型语言模型文本单元预留空间,社区亦以 WTF-8 等玩笑称呼表达娱乐态度。
认为扩展没有实用性且破坏了 UTF-8 的原有特性
- 多个评论指出新方案失去以 FF 字节识别无效文件、自同步及子串搜索等 UTF-8 优良性质,且作者未清晰交代动机,任意长度码点易引发缓冲区溢出与实现不兼容,违背 KISS 简洁原则,权威人士更直斥其如同用 ipv50 替换 ipv6。(较多人) > 这就像用 ipv50 替换 ipv6,实在没什么用(@achille)
认为这是有趣的黑客实验并为未来编码需求预留空间
- 不少读者承认这是酷炫的编码黑客技巧,可编码任意大整数,能为未来外星文明字形、自定义表情、神经网络向量或大型语言模型文本单元提供近乎无限空间,并戏称其更像 WTF-8 以表娱乐。(较多人) > 这更像 WTF-8(@Grimeton)
指出历史背景与限定字节数可部分缓解缺陷
- 有技术背景的读者补充 UTF-8 原本支持六字节编码,后人为匹配 UTF-16 限制为四字节;若硬性限定为八字节则仍能从首字节获知后续长度,避免流式解析混乱,说明适度扩展并非不可行。(少数人) > UTF-8 最初支持六字节编码,2003 年为匹配 UTF-16 约束才限制到四字节(@Sharlin)
有价值的补充
- UTF-8 的子串搜索可简化为字节串搜索,此特性比自同步更强,但 UTF-8000 已不具备(@lukasgelbmann)。
- 若将上限固定为八字节,理论上可编码约 4.47 万亿字符,足以覆盖可预见需求(@yyyk)。
- 作者已公平比较 UCS-X 等替代方案,仅命名记忆点稍弱(@lifthrasiir)。