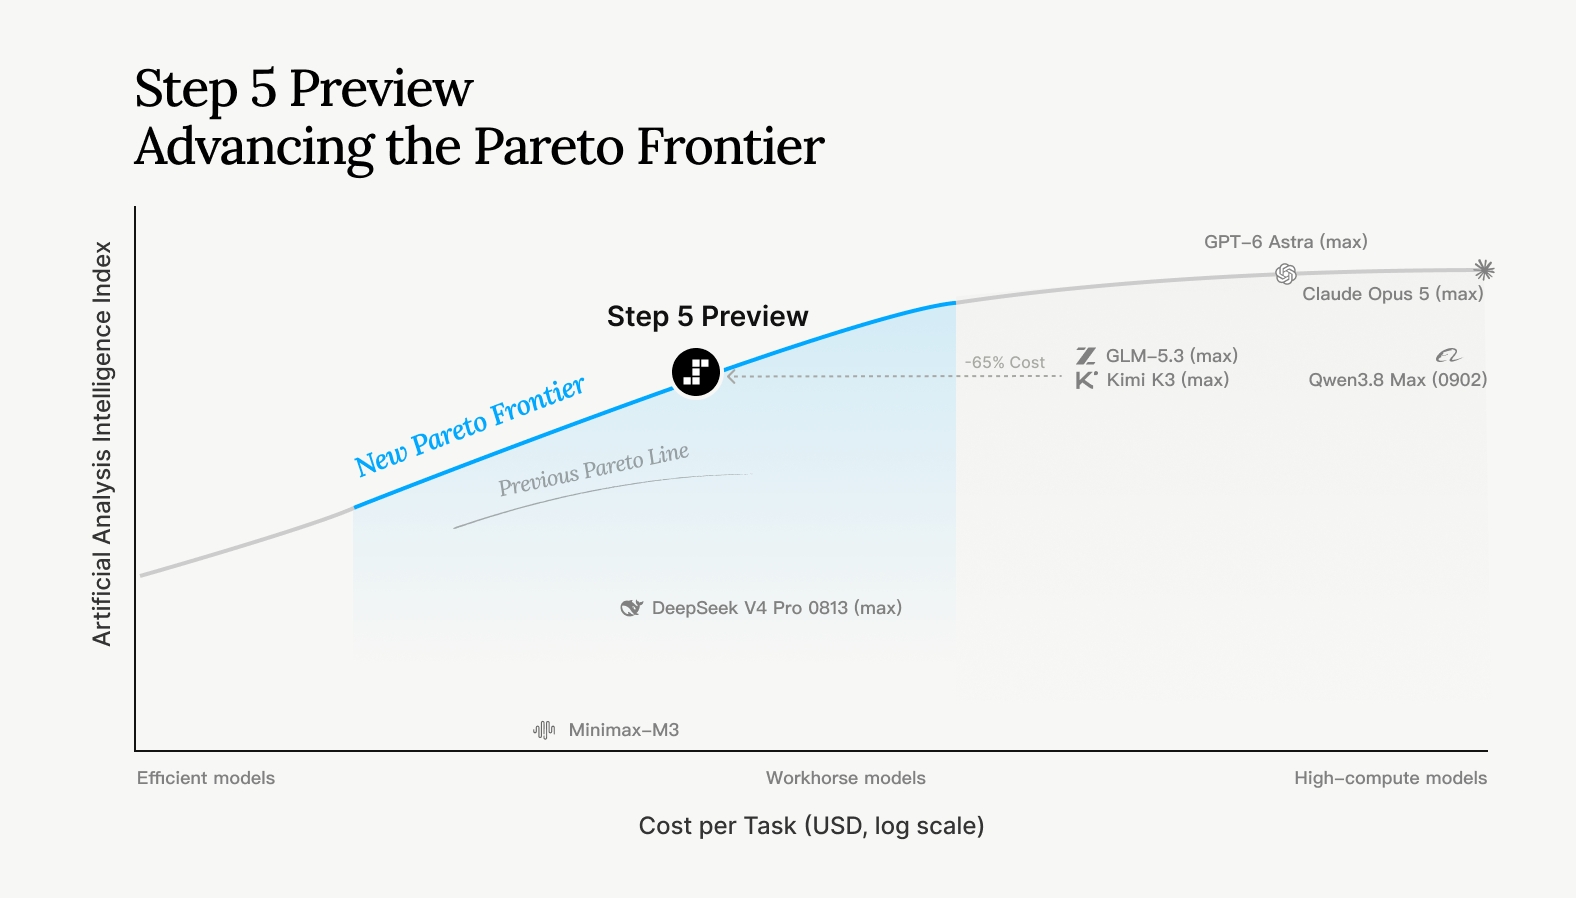
帕累托前沿(Pareto frontier)意指智能与成本的最佳权衡边界,边界外移即进步开端。今日我们推出旗舰智能体模型阶跃5预览版(Step 5 Preview),它在软件工程与专业知识工作上达前沿水平,金融尤强。其基于稀疏混合专家架构,总参数600B,每令牌激活27B,支持1M令牌上下文与视觉输入。在公开及内部评测中,该模型于软件工程、智能体任务、专业知识与金融领域表现强劲。
正文
帕累托前沿标记智能与成本之间的最佳权衡。当这条边界向外移动时,进展就开始了。
今天,我们推出 Step 5 Preview,面向智能体工作的新旗舰模型。它在软件工程和专业知识工作上达到前沿水平,在金融领域尤其强。Step 5 Preview 基于稀疏 Mixture-of-Experts 架构,总参数 600B,每 token 激活 27B,支持 100 万 token 上下文窗口和视觉输入。
在公开和内部评估中,Step 5 Preview 在软件工程、智能体任务、专业知识工作和金融方面表现强劲。
DeepSWE v1.1
Step 5 Preview(High)67.7;Kimi K3(Max)67.5;GLM-5.3(Max)66.9;GPT-6 Astra(Max)74.1;Claude Opus 5(Max)74.0。
StepCodeBench
Step 5 Preview(High)49.0;Kimi K3(Max)43.9;GLM-5.3(Max)40.2;Claude Opus 5(Max)63.9;GPT-6 Astra(Max)61.0。
ProgramBench
Step 5 Preview(High)80.5;Kimi K3(Max)77.8;GLM-5.3(Max)72.0;GPT-6 Astra(Max)85.4;Claude Opus 5(Max)82.3。
Terminal-Bench v4
GLM-5.3(Max)41.9;Step 5 Preview(High)33.3;Kimi K3(Max)12.6;GPT-6 Astra(Max)57.9;Claude Opus 5(Max)52.3。
Agents' Last Exam (ALE-CLI)
Step 5 Preview(High)29.5;GLM-5.3(Max)28.6;Kimi K3(Max)27.6;GPT-6 Astra(Max)33.3;Claude Opus 5(Max)28.6。
GDPval-AA v2
GLM-5.3(Max)1634;Step 5 Preview(High)1571;Kimi K3(Max)1548;Claude Opus 5(Max)1735;GPT-6 Astra(Max)1580。
FrontierFinance
Step 5 Preview(High)66.4;GLM-5.3(Max)64.1;Kimi K3(Max)62.6;Claude Opus 5(Max)69.7;GPT-6 Astra(Max)55.0。
DRACO
Step 5 Preview(High)83.3;GLM-5.3(Max)82.3;Kimi K3(Max)78.5;Claude Opus 5(Max)87.6;GPT-6 Astra(Max)76.8。
GDPval-AA v2 分数基于 Artificial Analysis 截至 2026 年 9 月 19 日的最新结果。
DeepSWE v1.1 评估使用 SWE-agent harness,temperature=1.0,top_p=0.95。
Step 5 Preview 在 Artificial Analysis 智能指数上得 44 分。在智能水平相当时,其任务成本大幅低于同等能力模型。
编程:范围广,执行深
Step 5 Preview 的编程能力覆盖广泛开发工作,从软件工程、视觉应用到可编程硬件。它还能维持更长周期的工作,进展依赖反复执行、反馈和修改。
在内部和外部专家评估中,约 70% 的参与者认为 Step 5 Preview 能自主解决中等偏高复杂度的编程任务。
跨软件工程
WebDev 与设计
Step 5 Preview 结合前端开发与视觉创作。它构建 Web 界面和数据可视化,使用 Blender 创建并迭代优化 3D 资产,再通过 Three.js 把这些资产带入交互式 Web 应用和游戏。
案例 1:房间规划器——从照片到可交互空间
从一张卧室照片开始,这个房间规划器把空间变成可编辑的 3D 环境。可以重新摆放和旋转家具,并获得放置反馈,然后进入完成的布局进行第一人称房间游览。
StepCodeBench
我们构建 StepCodeBench,以反映实际发生的软件工程。它参考行业需求、不断变化的用户需求和专家工作流轨迹,覆盖 553 个独立仓库、9 个任务类别、20 个应用领域和 33 种编程语言。
StepCodeBench 覆盖范围
真实世界软件工程的多维视图
553 个独立仓库
9 个任务类别
20 个应用领域
33 种编程语言
任务类别
- 功能修改
- 缺陷修复
- 重构
- 文档
- 性能调优
- 代码生成
- CI/CD 操作
- 代码转换
- 环境搭建
应用领域
- Web 开发
- 移动应用
- 云基础设施
- DevOps 与 CI/CD
- 数据库
- 分布式系统
- 数据工程
- 机器学习
- AI 应用
- 网络安全
- 网络
- 操作系统
- 编译器与工具链
- 开发者工具
- 科学计算
- 金融科技
- 电子商务
- 多媒体
- 游戏开发
- 嵌入式与 IoT
编程语言
Python、C++、Go、Java、JavaScript、TypeScript、Rust、C、C#、Bash / Shell、Kotlin、Swift、Dart、Objective-C、HTML、Fortran、PHP、Ruby、SQL、R、Julia、MATLAB、Scala、Groovy、Clojure、Haskell、Erlang、Elixir、Lua、Perl、Solidity、Zig、Assembly。
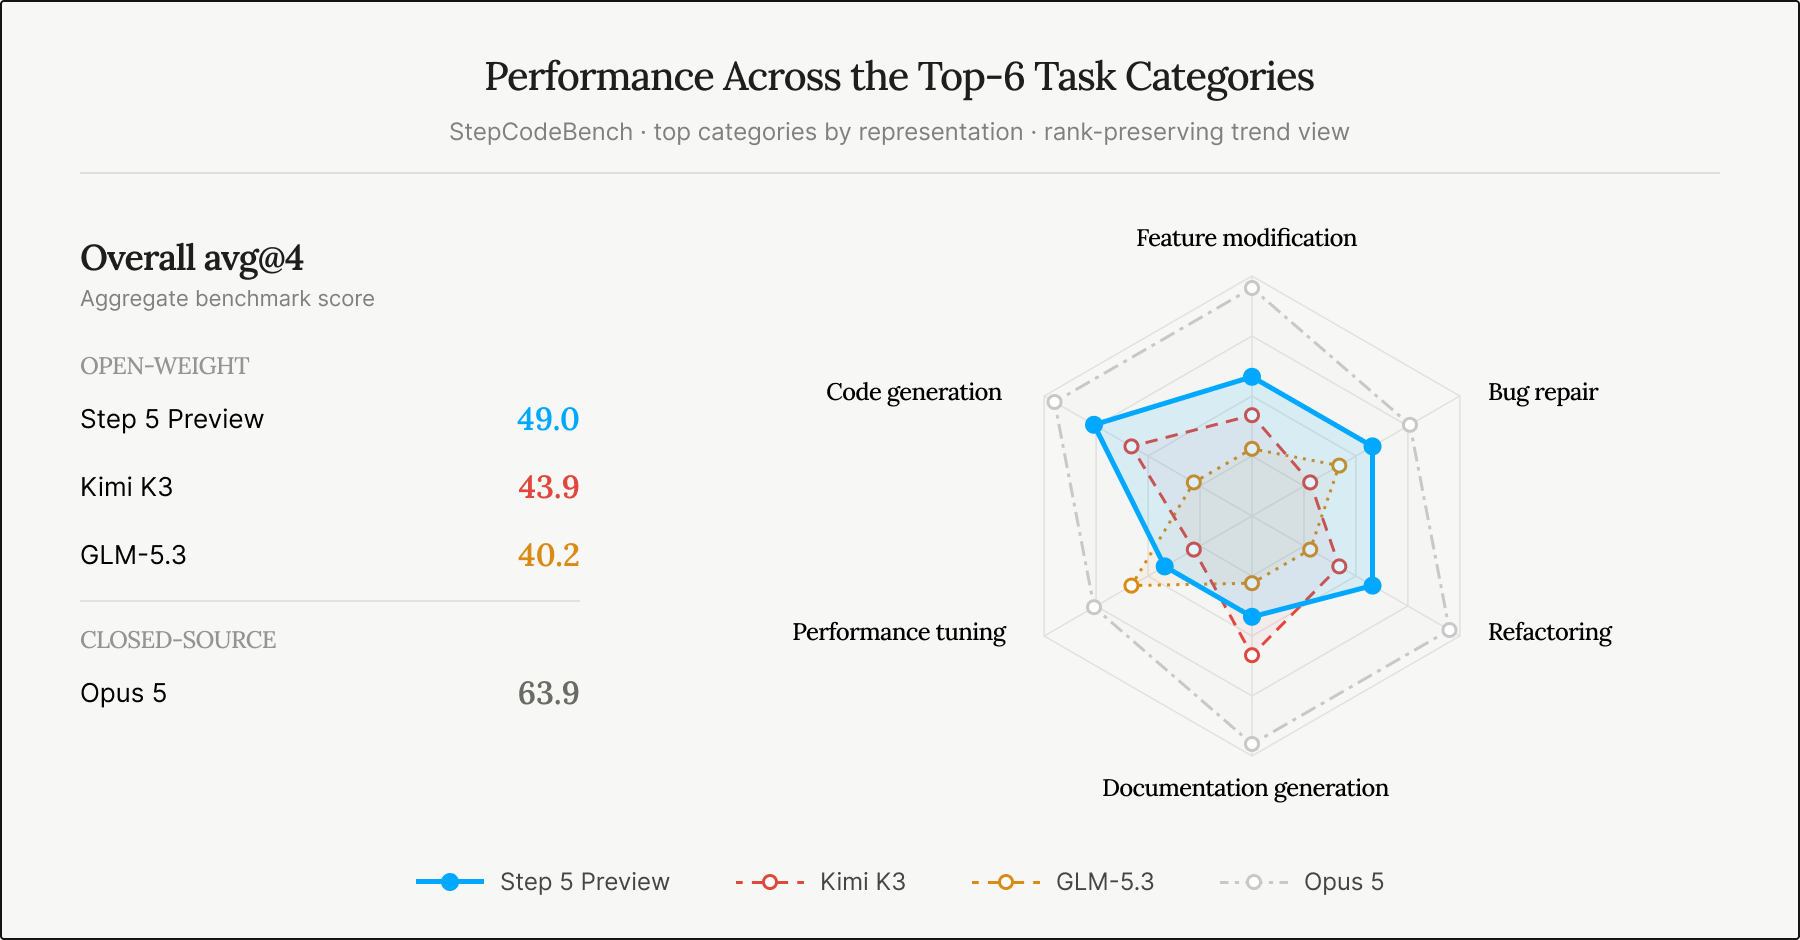
Step 5 Preview 取得 avg@4 49.0%。在上述任务类别中,它在缺陷修复、功能修改和重构上表现尤其好。
按编程语言和任务难度的单独分析显示,它在主要语言上表现总体一致,在低难度和中等难度任务上接近 Claude Opus 5。在最困难的长周期任务上,与前沿仍有明显差距。
同样的广度延伸到纯软件环境之外。获得开发文档和用户授权后,Step 5 Preview 可以直接操作可编程硬件,把摄像头、COM 端口、截图和模拟鼠标输入作为开发和调试过程的一部分。
长时间跨度
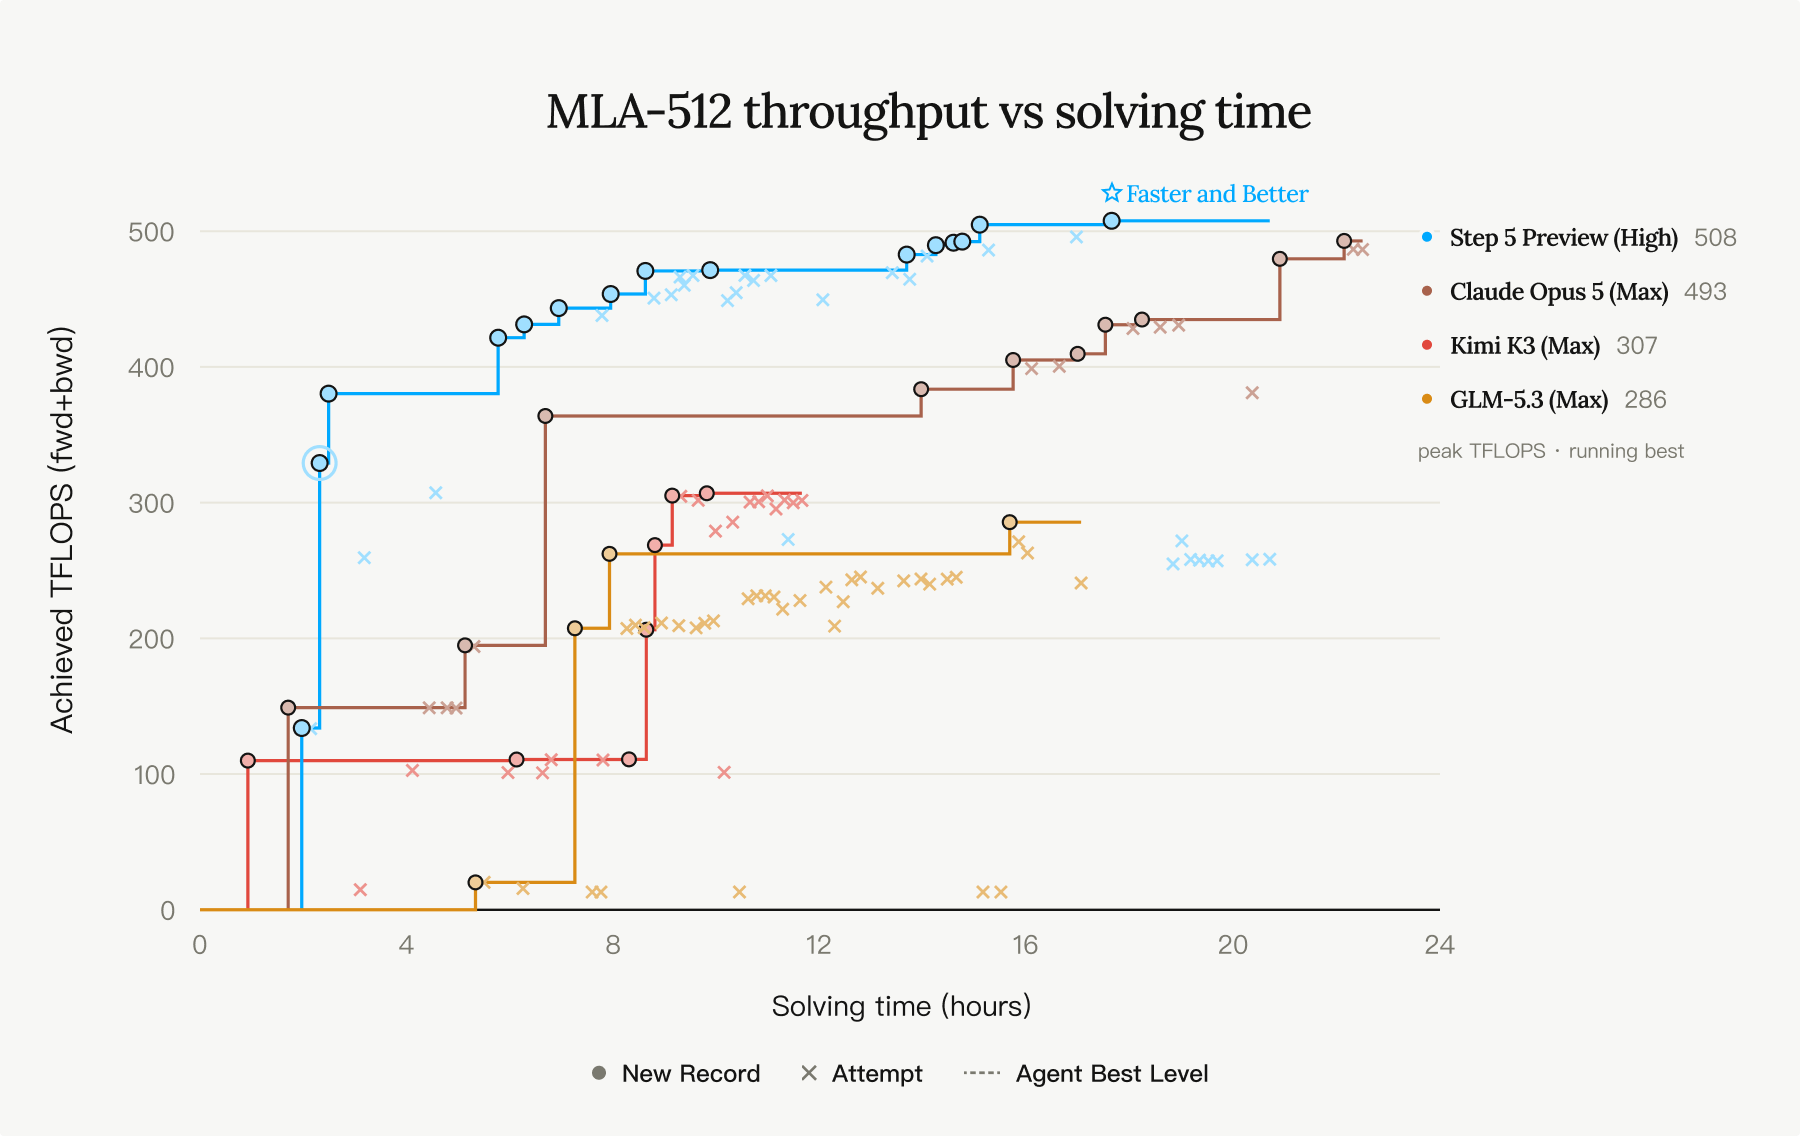
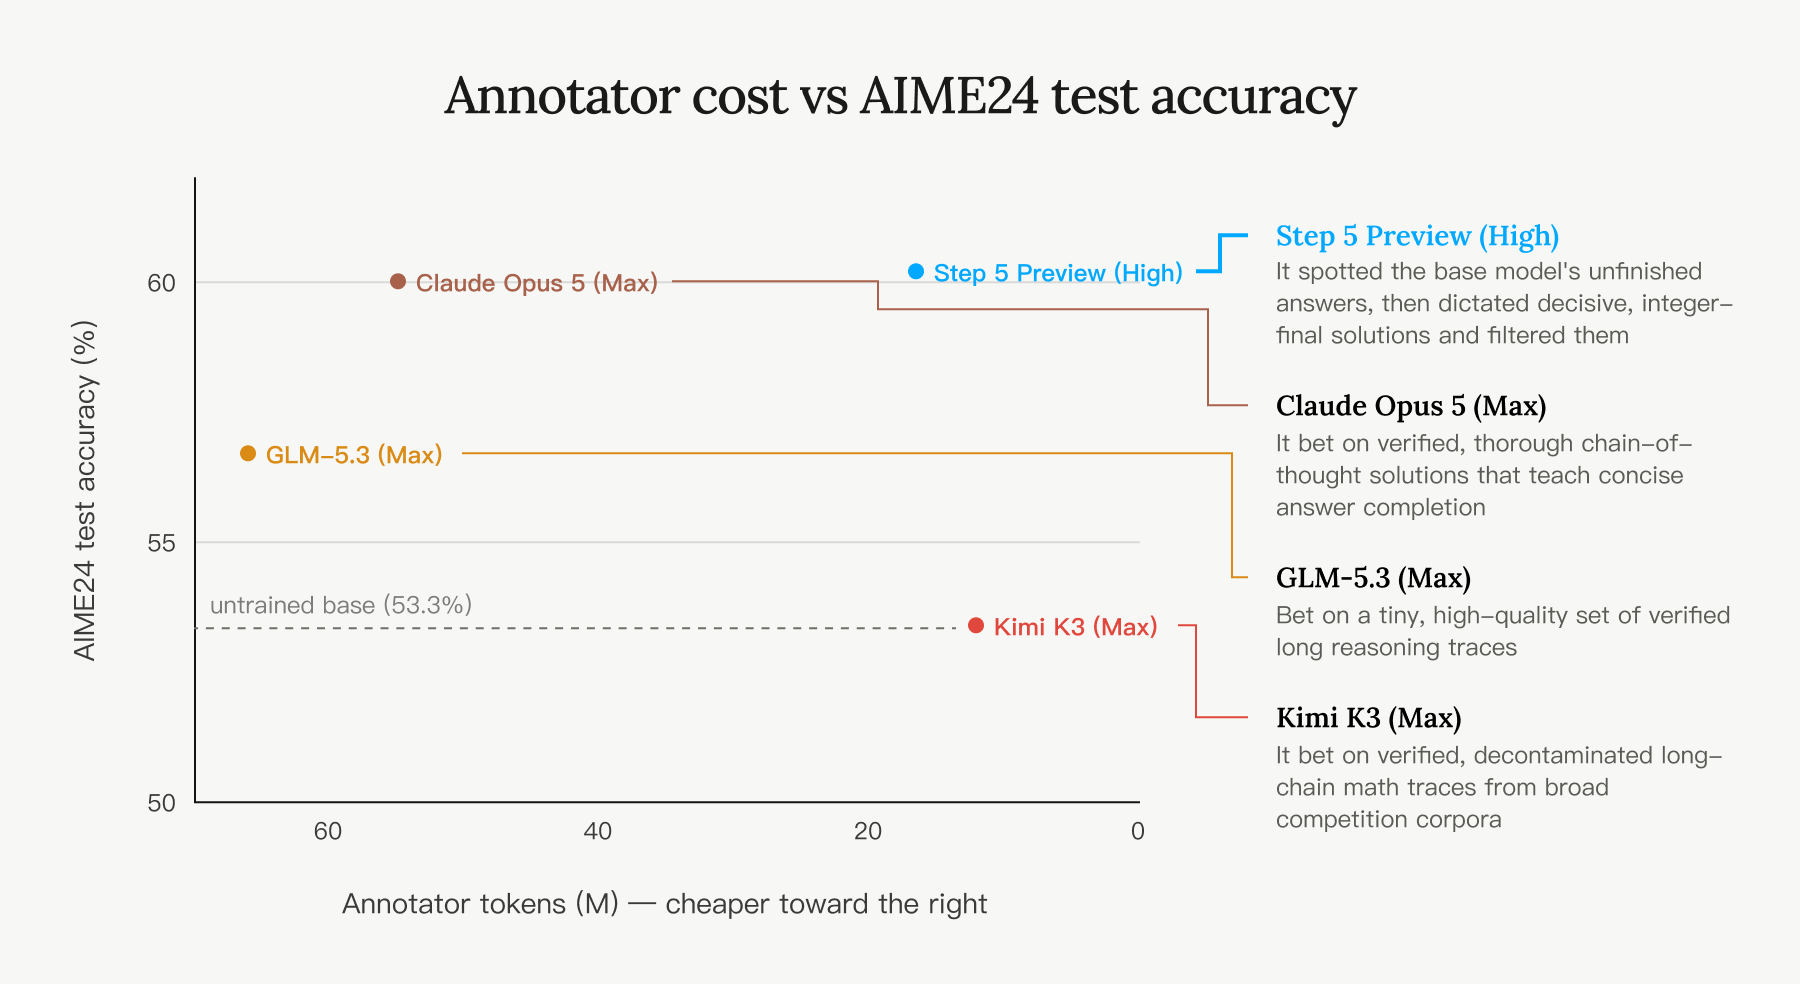
长周期任务要求模型跟踪先前结果,利用执行反馈,并决定下一步尝试什么。我们在两个有可测量反馈的场景中测试这一点:优化推理内核和改进后训练数据循环。
优化 MLA GPU 内核
我们给 Step 5 Preview 24 小时,在 NVIDIA H100 GPU 上从零优化一个 MLA GPU 内核,head dimension 为 512,生产形态为 batch size 1、64 heads、8,192 tokens。它从初始描述开始,实施改动、运行内核并测量吞吐量。当候选方案运行成功但吞吐量下降时,它丢弃该候选,从目前表现最好的版本继续。
每个模型有 4 次独立尝试,每次可自行决定提前停止还是继续优化,我们报告其最佳运行。Step 5 Preview 在约 22 小时后,前向和反向达到 508 TFLOPS 峰值,Claude Opus 5 为 493 TFLOPS。
改进后训练数据循环
第二个实验中,Step 5 Preview 有 24 小时,通过自动化后训练提升 Qwen3-30B-A3B 基础模型在 AIME24 上的表现,使用可访问生产数据的 API 标注器。它决定如何使用标注器、如何修改后训练数据,并跟踪这些选择对下游表现的影响。
得到的模型在官方 AIME24 测试上达到 60% 准确率,后训练前为 53.3%。这匹配了 Claude Opus 5 的结果,同时使用更少标注器 token。
额外案例:编程之外的长时程执行
Pokémon Red 提供了另一种长时程执行测试。进展依赖在数千次交互中维持一个遥远目标,记住早先发现,管理资源,并在计划失败时恢复。完成主线剧情估计需要 26 小时人类游玩时间。
没有任何 Pokémon 专门优化,Step 5 Preview 目前已持续进展超过 3,000 回合和 600 万 token 交互。到第 3,082 回合,它已解锁 Cut,获得三枚 Gym Badges,并击败 Lt. Surge。这轮运行目前大约完成主线的三分之一。
下方交互式回放展示进展如何随时间发展,将游戏过程与里程碑完成和累计 token 使用量联系起来。
专业知识工作
Step 5 Preview 把同等能力带到专业工作中,任务常常不只是找到答案。它可以收集和核对证据,执行领域特定分析,并按要求格式产出完成的工作。
其输出覆盖技术工程、创意制作、分析报告和公共沟通,内容和呈现方式适配各领域。
规模化研究
在一项覆盖 1,000 个地点、25 年的气候研究中,Step 5 Preview 在一次智能体行动中协调了 950 次网页抓取,汇总了 11 个变量的 30 万条月度记录。
它用该数据集分析太阳季节性的区域差异,发现欧洲和大洋洲样本的峰值月份在一年中相反。
结构化分析
在一次柴油附加费审查中,Step 5 Preview 产出 17 个工作表分析工作簿,包含源数据、跨序列核对、区域面板、公式和趋势模型。
工作簿保留了底层数据与所得分析之间的关系,关于覆盖范围、重叠和区域价格变动的发现可用于合同和采购审查。
交互式报告
在另一项研究任务中,Step 5 Preview 产出一份交互式报告,结合书面分析、可视化、数据表、方法说明和支持性细节。
报告让读者从主要发现进入背后的证据,方法和支持性细节可供进一步检查。
聚焦金融
金融是我们在 Step 5 Preview 中特别关注的领域之一。
金融决策依赖对企业、经济背景和未来表现风险的详细理解。分析需要模型处理不断变化、常常互相冲突的信息,并谨慎应用会计和估值方法。
模型需要识别可靠来源,核对报告期和定义差异,建立假设与计算自洽的预测。工作还必须经得起审查。审核者应能把结论追溯到来源,区分已报告事实和假设,并复现计算。证据缺口和对关键假设的敏感性应清晰可见。
我们开发了三个内部基准,评估金融工作流中的这些要求:
- FinStepBench - LiveSearch:测试模型能否在信息需求变化时检索并验证及时、可靠的金融信息。
- FinStepBench - CorporateValuation:测试模型能否把金融数据和可辩护假设转化为内部一致的预测和可复现估值。
- FinStepBench - DeepResearch:评估完整研究流程,从收集分析证据到产出全面、有充分支持的报告。
整套评估考察准确性、分析严谨性和可审计性,包括来源是否可追溯、假设是否明确、计算能否复现。
我们还在 FrontierFinance 上评估 Step 5 Preview。这是一个外部基准,覆盖六种投资用例,包含 220 个专家设计问题和 11,543 条评估标准。其详细评分细则为复杂金融回答提供补充评估。
Step 5 Preview 在信息检索、估值和端到端金融研究上表现强劲。
FrontierFinance
Step 5 Preview(High)66.4;GLM-5.3(Max)64.1;DeepSeek V4.1 Flash 63.0;Kimi K3(Max)62.6;Claude Opus 5(Max)69.7;GPT-6 Astra(Max)55.0。
FinStepBench - LiveSearch
DeepSeek V4.1 Flash 76.7;Step 5 Preview(High)74.5;GLM-5.3(Max)73.3;Kimi K3(Max)70.9;Claude Opus 5(Max)76.2;GPT-6 Astra(Max)74.5。
FinStepBench - CorporateValuation
Step 5 Preview(High)60.6;Kimi K3(Max)60.6;DeepSeek V4.1 Flash 57.6;GLM-5.3(Max)56.1;GPT-6 Astra(Max)77.3;Claude Opus 5(Max)69.7。
FinStepBench - DeepResearch
Step 5 Preview(High)55.8;GLM-5.3(Max)53.3;DeepSeek V4.1 Flash 50.2;Kimi K3(Max)48.9;Claude Opus 5(Max)59.1;GPT-6 Astra(Max)45.0。
Step 5 Preview 基准测试
以上评估只展示 Step 5 Preview 能力的一部分。下表列出更广泛的推理、编程、智能体、金融和多模态基准结果,前文已详列的项目从略。
| 基准 | Step 5 Preview (High) | GLM 5.3 (Max) | Kimi K3 (Max) | GPT-6 Astra (Max) | Claude Fable 5.1 (Max) | Claude Opus 5 (Max) | | --- | --- | --- | --- | --- | --- | --- | | 推理与知识 | | | | | | | | GPQA Diamond | 93.5% | 91.7% | 93.5% | 96.1% | 93.7% | 93.2% | | HLE | 46.5% | 42.3% | 46.9% | 54.7% | 59.1% | 54.9% | | AA-LCR v1.1 | 88.3% | 79.7% | 88.7% | 80.7% | 85.3% | 79.3% | | CritPt | 20.9% | 19.1% | 23.4% | 31.7% | 29.7% | 29.1% | | 编程 | | | | | | | | Terminal-Bench v2.1 | 85.0% | 83.9% | 85.0% | 88.4% | 91.4% | 89.1% | | CyberGym | 84.7% | 84.5% | 80.0% | — | — | — | | SciCode | 58.9% | 59.0% | 59.5% | 56.5% | 63.1% | 56.4% | | RoadmapBench | 54.3% | 54.1% | 55.4% | — | — | 68.3% | | SWE-Marathon v1.1(Partial Score) | 72.7% | 67.4% | 84.4% | 77.3% | 80.2% | 85.6% | | MLS-Bench-Lite | 40.5% | 37.3% | 48.3% | — | 50.3% | 49.8% | | SWE-Atlas-QnA | 63.6% | 59.6% | 59.5% | 60.9% | — | 66.0% | | SWE-Atlas-Test-writing | 50.8% | 50.4% | 50.4% | 51.1% | — | 60.3% | | StepCode-Bench-Daily† | 64.9% | 69.1% | 57.7% | — | — | 77.6% | | StepCode-Bench-General† | 65.0% | 62.0% | 65.2% | 64.3% | — | 68.3% | | 通用智能体 | | | | | | | | τ³-Banking | 42.5% | 50.3% | 46.0% | 41.4% | 47.2% | 42.1% | | AutomationBench-AA | 51.0% | 62.2% | 58.3% | 68.5% | 59.4% | 56.6% | | AutomationBench(公开) | 44.0% | 48.2% | 46.7% | — | — | — | | AA-Briefcase | 1417 | 1511 | 1492 | 1562 | 1662 | 1645 | | Toolathlon-Verified | 74.1% | 73.0% | 76.5% | — | 77.8% | 80.6% | | MCP-Atlas | 85.6% | 86.8% | 85.3% | — | — | 87.0% | | PresentBench | 76.8% | 74.5% | 75.6% | — | — | 77.3% | | OfficeQA Pro | 60.3% | 59.1% | 62.6% | 67.7% | — | 64.7% | | SpeadSheet v2 | 29.4% | 30.5% | 31.9% | 31.4% | — | 32.8% | | JobBench | 59.0% | 61.4% | 54.3% | — | — | 65.7% | | Apex-Agents | 37.8% | 38.1% | 41.0% | — | — | 41.8% | | BrowseComp | 88.7% | — | 91.2% | 91.5% | — | 90.2% | | HLE w/ tools‡ | 59.4% | 62.5% | 56.0% | 57.2% | 65.0% | 63.6% | | 多模态与文档 | | | | | | | | MMMU-Pro | 76.0% | —(纯文本) | 81.0% | 87.0% | — | 85.0% | | GDP.pdf | 14.8% | 11.2% | 22.0% | 31.0% | 26.2% | 21.6% |
† 为内部开发基准。HLE w/ tools‡ 中,Step 5 Preview(High)和 GLM-5.3(Max)在纯文本子集上评估,其他模型在完整数据集上评估,结果不可直接比较。
试用 Step 5 Preview
Step 5 Preview 今天起可通过我们的产品和 API 使用。该模型将于 10 月 15 日以开放权重发布。
评论
社区聚焦于步跳5以较小参数达到同级智能指数的性价比定位,同时对演示瑕疵和跳过版本号4的营销策略存有质疑。
认为步跳5以较小参数实现同级智能且定位巧妙
- 用户指出其人工分析智能指数与参数大4.6倍的Kimi K3及大1.25倍的GLM 5.3相同,定价明确且将开源,定位上避开直接对比前沿而自称廉价阵营最优,被赞聪明。(较多人) > 它的定位巧妙,不说自己更便宜且稍弱,而说自己是便宜且稍弱里最好的。(@ghoshbishakh)
质疑官方演示缺乏基本核查
- 有用户发现首支演示视频中,模型做3D渲染时的思考轨迹透露已存在现成项目,惊叹发布前竟未仔细校验,并忆及过往大厂演示也常显错误。(少数人) > 演示的思考过程出卖了真相:原来已有现成项目,惊讶于发布前竟不多检查。(@BoppreH)
猜测跳过版本4是对标国际大厂的命名策略
- 因海外有Claude Opus 5等,中国公司步跳直接出5而略过4,被推测为营造迭代同步印象,并引发其他中国实验室是否跟进的议论。(少数人) > 作为中国公司他们决定跳过4,同时让人感觉与领先企业的版本迭代看齐。(@nh43215rgb)
关注宝可梦FireRed重回智能体评测
- 步跳5无专门优化即在宝可梦FireRed中坚持数千回合并推进主线,有人借此对比另一模型Astra的通关效率,反映游戏环境再成基准。(少数人)
建议增设争议历史事实基准
- 有评论提议增加“争议历史事实”作为评测维度,以考验模型对敏感信息的处理。(少数人)
有价值的补充
- 步跳5定价为每百万输入1美元、输出2.7美元,开放权重定于10月15日(@garo-pro)。
- 有开发者称GLM-5.3与Kimi K3恰低于可完全替代前沿模型门槛,但SWE-2意外达标,若步跳5实测相近则多数开发者无需订阅昂贵大厂,除非获补贴(@InsideOutSanta)。
- “Pareto frontier”被讽为新型“web-scale”,体现社区对泛滥营销术语的调侃(@dofm)。