德国科学博客门户 Scienceblogs.de 整理了一份相对著名的 50 个未解密码清单,其中既有连环杀手公布的密码,也有著名的伏尼契手稿(Voynich manuscript)。清单里还包括一组第一次世界大战期间的德国无线电讯息,它们采用 ADFGVX 方法加密;以单词 HOUSE 作为密钥,可以举例说明这种加密方法。
正文
Scienceblogs.de 这个德国科学博客门户收录了一份相当有名的50 个未解密码清单,从连环杀手公布的密码到著名的伏尼契手稿都有。
其中包含一批一战时期的德国无线电报文,用 ADFGVX 方法加密。
以 “HOUSE” 为密钥时,这个方法如下表所示:
| | A | D | F | G | V | X | |---|---|---|---|---|---|---| | A | H | O | U | S | E | A | | D | B | C | D | F | G | I | | F | J | K | L | M | N | P | | G | Q | R | T | V | W | X | | V | Y | Z | 0 | 1 | 2 | 3 | | X | 4 | 5 | 6 | 7 | 8 | 9 |
可以看到,ADFGVX 被横竖两向使用,为表中每个“单元格”指定取值。比如在这张表里,“AA” 对应字母 H,“AD” 对应字母 O,“DA” 对应字母 B,以此类推。于是 “PRINZ” 一词会被编码为:
FX GD DX FV VD
换用 “HOUSE” 以外的加密词,会得到完全不同的表。
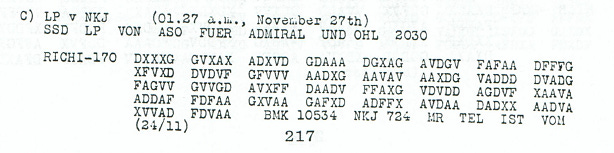
有一份已知密钥清单,是德军用来加密这些无线电报文的;其中数百条报文已被破译,破译者包括密码分析专家 George Lasry。但至今仍有十几条未能解开,据我所知其中包括下面这条,原发送时间为 1918 年 11 月 27 日(第 217 页):
GPT-6 Astra 解开了这条密文,认为原文如下:
EIN ENGLISCHER KREUZER EINLIEG X SEWASTOPOL X S4STEN X EIN GESCHWADER DER X ALLIIERTEN FOLGT 26STEN X
译成英文是:
AN ENGLISH CRUISER ARRIVED AT SEVASTOPOL ON THE ?4TH AN ALLIED SQUADRON FOLLOWS ON THE 26TH
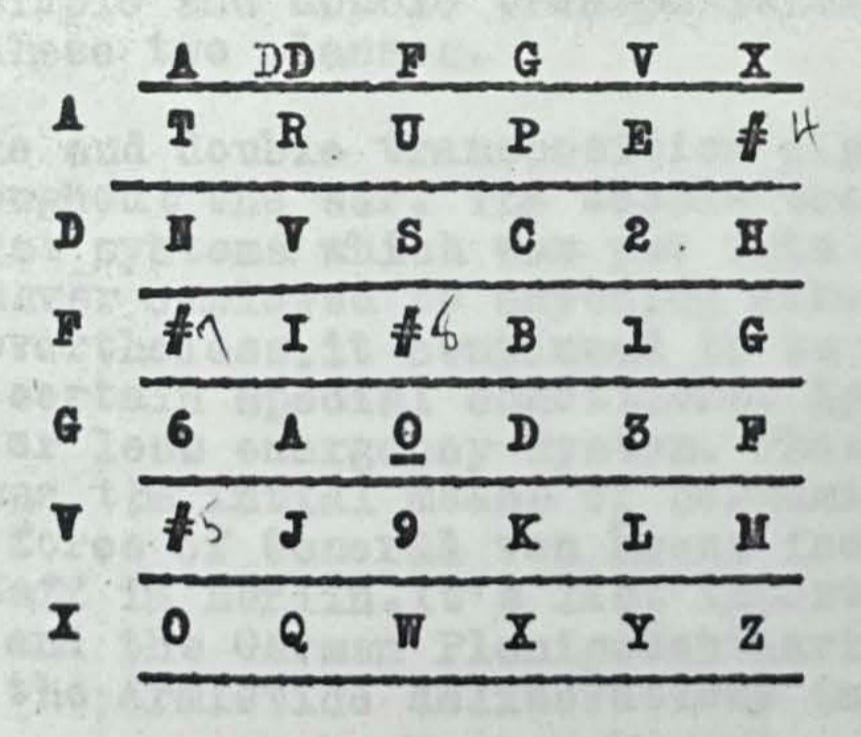
模型使用的加密词是 “TRUPPENVERSCHIEBUNG”,出自 J. Rives Childs《The History and Principles of German Military Ciphers, 1914–1918》第 214–215 页。这个加密词生成如下表格:
在用这张表之前,还要先把 “TRUPPENVERSCHIEBUNG” 重新排列,让词中字母按字母表顺序排列(例如 T 是第 16 位,R 是第 13 位)。
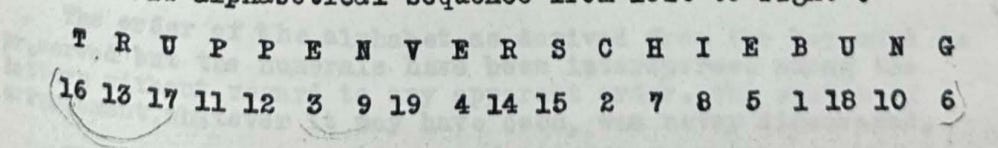
接着,把 “TRUPPENVERSCHIEBUNG” 横向写出,密文字母按每行 19 个排在它下面(总长 170 个字符,因此是 8 行各 19 个符号,再加 1 行 18 个符号)。这也意味着有 18 列各含 9 个符号,1 列(“G” 列)含 8 个符号。T 是第 16 列,它前面有 14 个 9 符号列,加上 1 个 8 符号的 G 列;9×14 + 1×8 = 134,所以 “T” 对应报文中接下来的第 135 个符号,即 “A”。同理,下一个字母 “R” 对应字母 “V”(因为 R 在字母表中排第 13,它前面有 11×9 + 1×8 = 107 个符号;报文第 108 个符号是 “V”)。
在上面那张表中,“AV” 对应 “E”,也就是 “EIN” 的第一个字母。如此重复,直到整条报文被解出。
(厉害。)
Astra 推测这条报文此前一直没被解开的原因是:“TRUPPENVERSCHIEBUNG” 作为密钥是从 1918 年 12 月 9 日才开始使用的,而这条报文如上所述发送于更早的 1918 年 11 月 27 日。这一出入的原因不明。
Astra 还专门核对了自己的结果,发现英国巡洋舰 HMS Canterbury 确实于 1918 年 11 月 24 日抵达塞瓦斯托波尔,依据是它的原始航行日志:
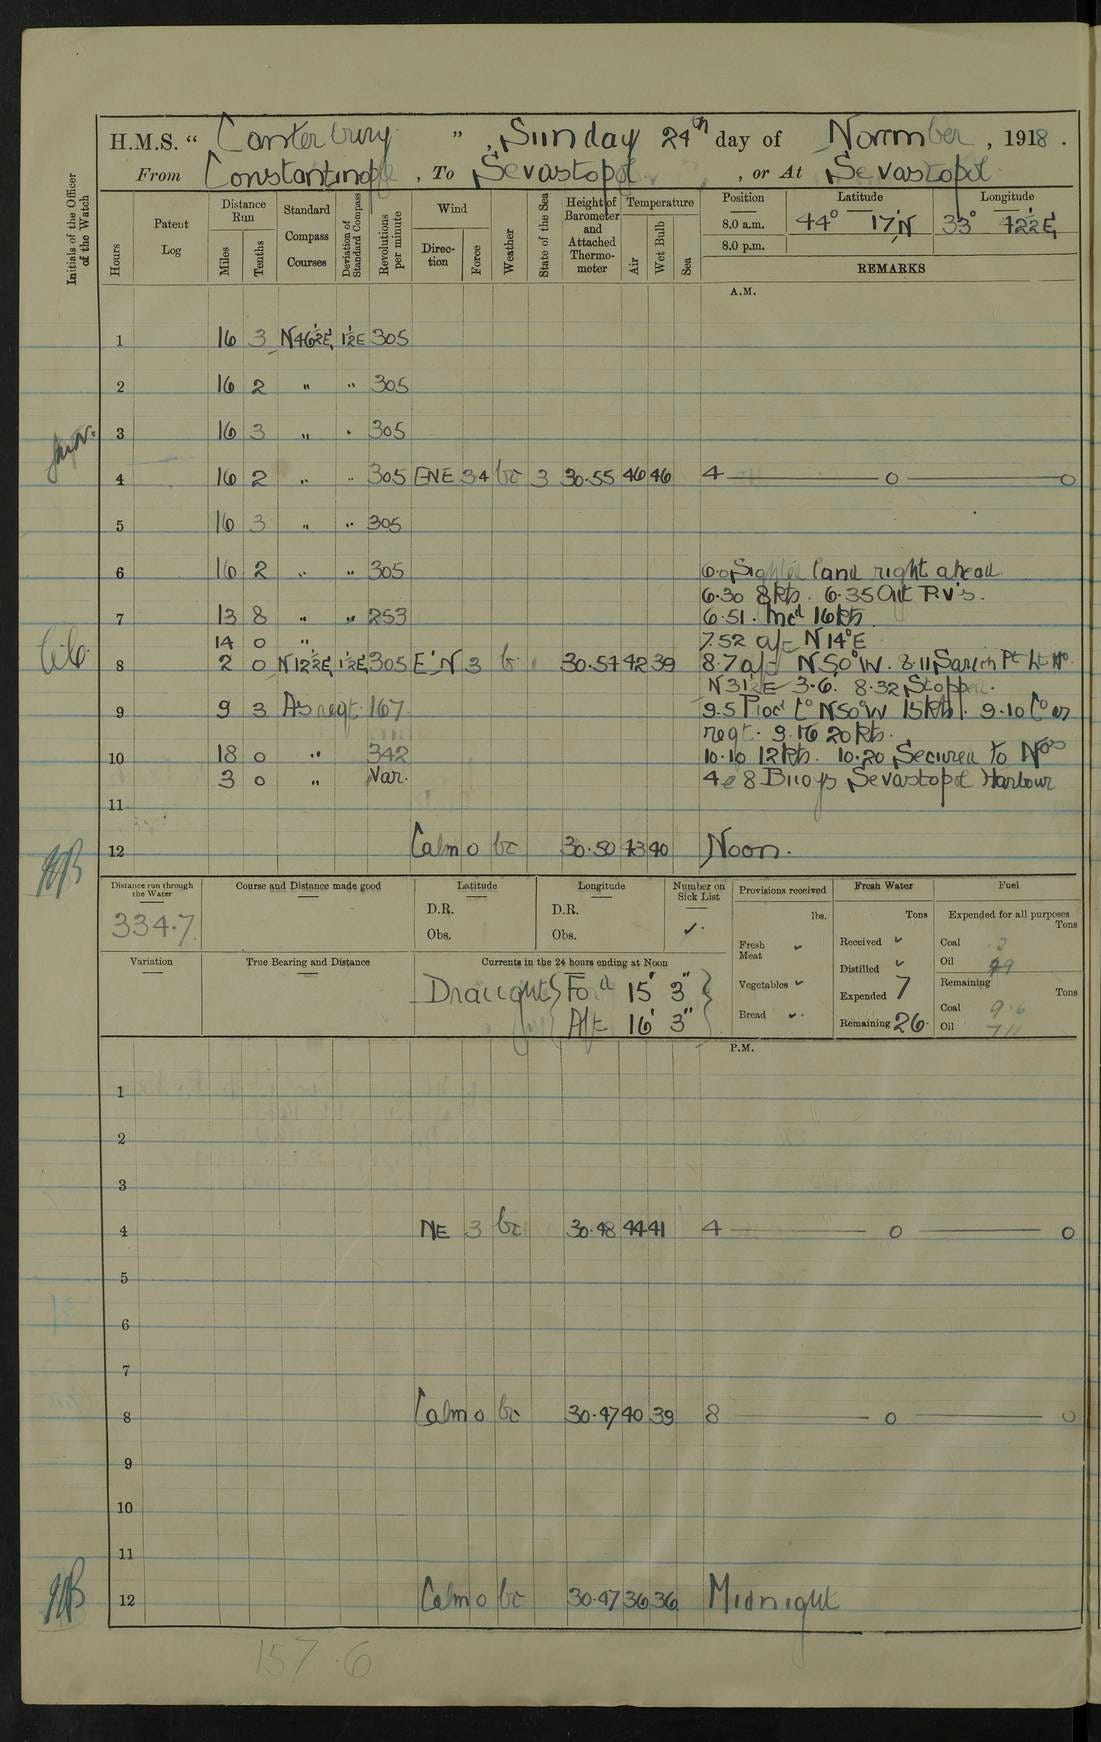
……而一支盟军分舰队确实在 11 月 26 日跟进(见第 11 行下方,写着有一支盟军分舰队抵达):
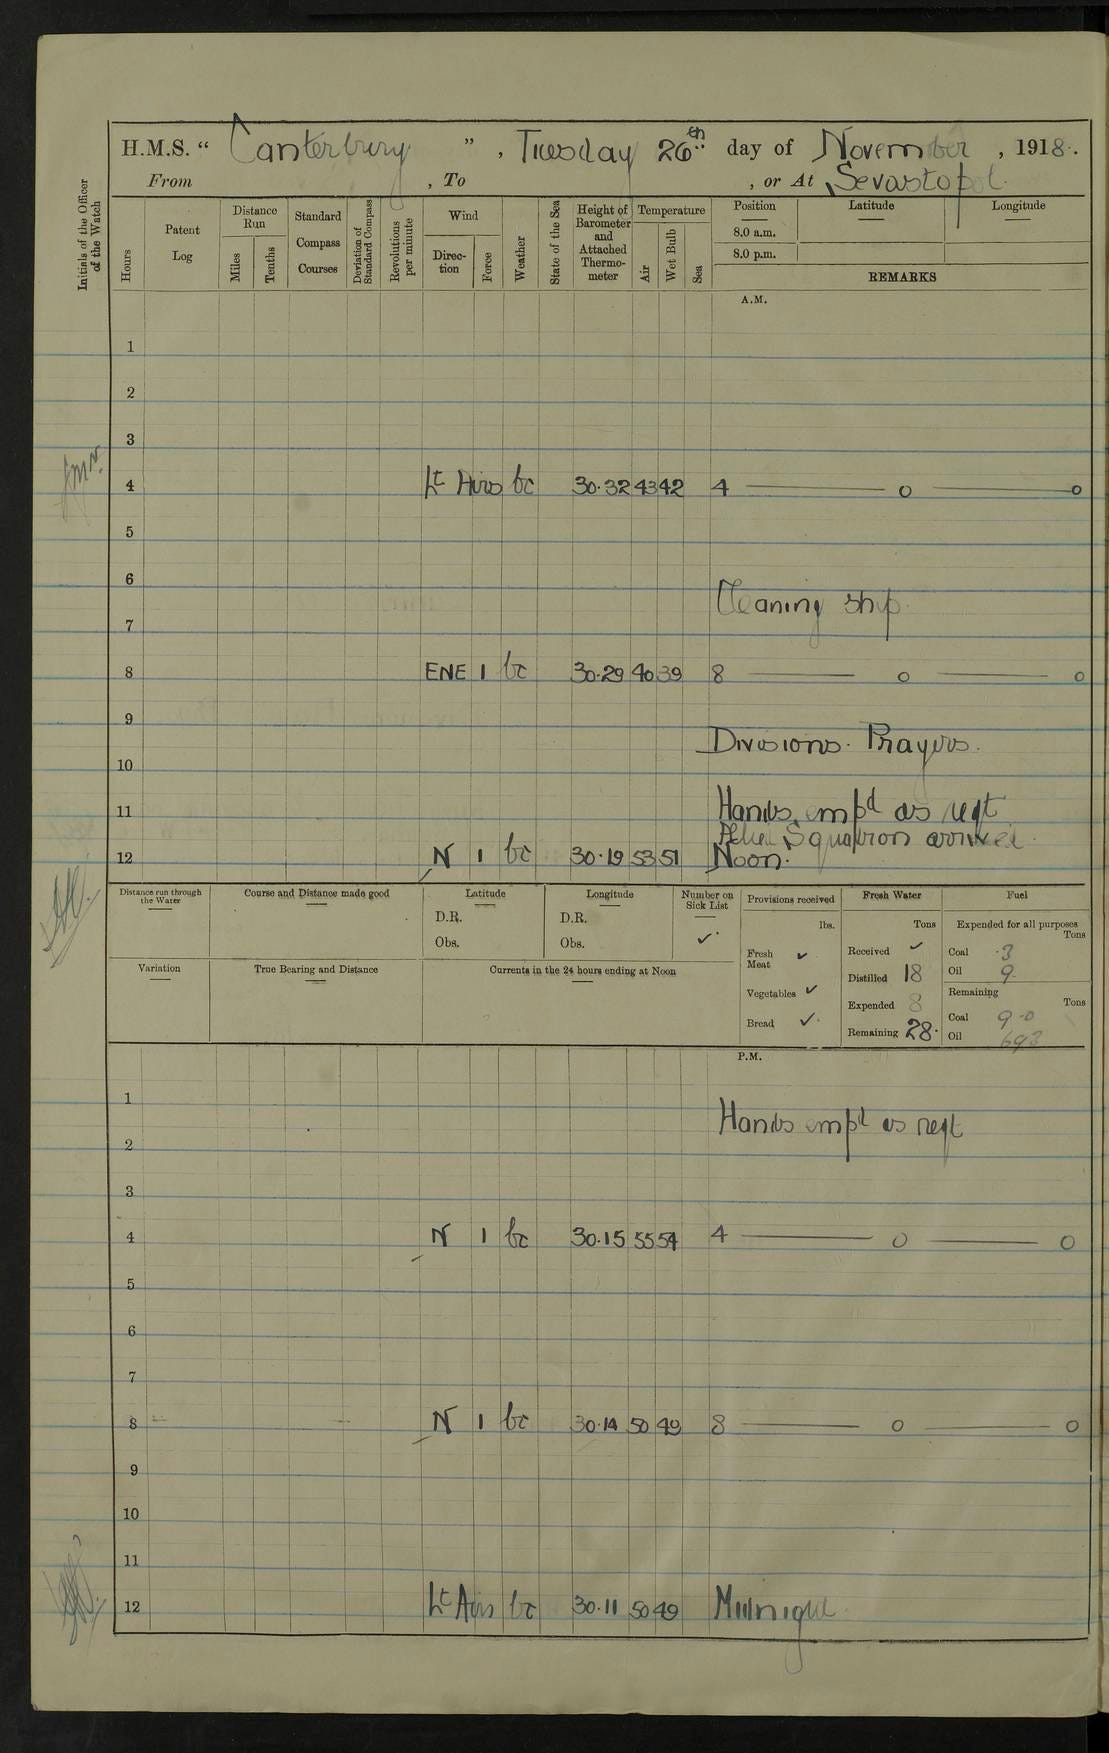
据我所知,这条报文此前从未被破译过,所以在此分享这个小小(但我认为相当酷)的成果,作为该模型能力的一个例证。
评论
社区对一篇将大模型描述为自主破译二战德军密码的报道存在分歧,多数人强调密钥早已公开且离不开人类引导,少数人则视其为通用人工智能的渐进征兆或调侃自身仅用模型处理平庸杂活。
认为解密依赖战后公开的密钥列表,技术含量有限
- 战后缴获的密钥表包含所有密钥,模型只需从中选对正确项并识别操作员输错日期和字符即可,足够专注的人类同样能完成只是未曾去做(较多人) > 所有密钥战后已被缴获公开,这次只是选对密钥并发现错别字,人类本也可以但没去做(@Legend2440)
反对将模型描述为自主代理,强调人类在回路作用
- 文章再度把工具框定为独立智能体,忽视了人的询问、方向与领域知识,未来标题应如实写成“某模型帮助解决了某问题”(较多人) > 又来了,把工具当自主代理,不顾人的指导和常识,以后标题该写“LLM帮助解决了X”吧(@qprofyeh)
怀疑模型可能从数据集中抄袭现成答案或伪造证据
- 有人提出模型或许在训练数据里找到了人类此前的解法直接借鉴,或利用网络日志虚构密钥与报文,虽概率不高但应考虑(少数人) > 也可能是它在数据里找到了某个解出答案的人,然后抄了作业(@sehw)
认为这展现了通用人工智能悄然浮现的征兆
- 能力在不知不觉中持续增强,直到某天展现出惊人水平,且全程无需意识或自我觉察参与(少数人) > 通用人工智能就是这样发生的,逐渐变强直到我们惊觉其能力,却完全绕开了意识(@dyauspitr)
质疑该密码体制本身简单脆弱
- 密文疑似固定的一一对应替换密码,只要篇幅足够便可通过统计字母频次配合常识猜测轻松破译,无需神化(少数人) > 这难道不是极简单的替换密码吗,密文够长就能靠频率统计破解(@FabHK)
笑称自己只用模型做平庸琐事
- 有人自嘲相较于文章里破解密码,自己拿大模型生成的只是糟糕的工作内容摘要,反差中带着社区对过度炒作的调侃(纯玩笑代表) > 而我还在用它生成烂兮兮的工作小结(@donatj)
有价值的补充
- 有用户让另一模型描述文章所引书籍的具体页内容,模型表示无法做到且网上找不到该书,提示此类报道引用溯源未必可靠(@eis)
- 另有用户最喜欢用模型翻译手写外语菜单且效果完美,但好奇是否丢失文化细节,并反问模型能否设计出无密钥时连自己也无法解开的密码(@999900000999)