本站首篇专题文章将探讨x86模拟中一个持续存在的问题,它影响所有被模拟的应用程序,这归结为需要模拟x86总存储排序内存模型(x86-TSO)。在ARM定义的弱排序内存模型(weak ordering memory model)上模拟该内存模型存在多方面问题,涉及多种情况。文章将梳理遇到的所有问题以及相应的解决方式,有些情况下则无法解决。
正文
本站首篇专题文章讨论 x86 模拟中影响所有被模拟应用的问题:模拟 x86 总存储排序内存模型(x86-TSO)。
究竟什么是 x86-TSO?
内存模型规定内存访问相互行为的规则。我们关注 ARM 弱一致性模型与 x86 的 TSO 模型,二者是谱系两端:ARM 最宽松以利优化,x86 最严格强一致。需注意一致性与原子性相关但不等同。
x86 TSO 下,程序员可假设存储对所有处理器立即可见,加载时此前存储逻辑已完成,符合直觉。
ARM 弱模型默认加载存储不跨处理器强一致,存储不立即可见,加载可能看不到更新。旧 ARMv7 用内存屏障保序,性能损耗大。ARM 后引入 load-acquire 与 store-release 指令(类 C++ memoryorderacquire/release),构成 RCsc 模型,免去旧架构昂贵屏障。
ARMv8.0-a 的起步
模拟 x86-TSO 时,我们将 x86 加载转 ARM load-acquire,存储转 store-release,比必要更严格。但 ARMv8.0-a 仅有这些指令,开销极大。
微基准显示,五款 CPU 中三款用 acquire-load 性能大降;AmpereOne 的 release-store 极低,M1 的 Acquire/LRCPC 也低于基线。AmpereOne 从未为此设计,每秒数百万条下性能糟;Cortex-X4/X925 表现好,Oryon-3 弱化了其重要性。
我们该何去何从?
ARMv8.3 强制的 LRCPC-load 新增 RCpc 模型,正合 x86 模拟所需。图中多数平台 LRCPC 加载性能匹敌常规加载。
新扩展令内存性能基本解决,FEX 检测后改用 LRCPC-Load 而非 Acquire-Load。但 M1 例外:Apple 直接硬件支持 x86-TSO,切换后常规指令即符要求,LRCPC 只是别名,微测无开销。FEX 在 Asahi Linux 检测到此特性也启用“免费”提升。线程级 TSO 切换有轻微影响,但模拟下原生 ARM 代码占比近 0%,无关紧要。
我们认为 TSO 模式是高性能模拟最佳路径。官方 FEATLRCPC 扩展已三版打补丁: - FEATLRCPC:基础 GPR TSO 加载 - FEATLRCPC2:小偏移立即数 TSO 加载 - FEATLRCPC3:基础向量与栈基 TSO 加载存储
即便如此,仍有不如硬件 TSO 切换的边界情况,预计后续扩展。
我原以为访问内存是件容易的事?
之前测试顺从硬件对齐取基线。x86 应用不在乎对齐,随意跨缓存行,导致 split-locks(拆分锁)。x86 保证缓存行内加载存储原子且一致;跨缓存行则非原子可撕裂。
ARMv8.0 要求自然对齐(如 8 字节访问须偏移 0,8,16…),否则触发对齐错误。FEX JIT 对可能出错的指令设补丁点(NOP),捕获错误后从 load-acquire/store-release 改为基础加载存储,包裹数据内存屏障(DMB)后继续。
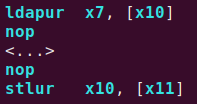
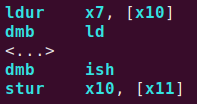
此前 fancy 指令此时退回经典内存屏障。新数据图显示未对齐访问惩罚。
AmpereOne
对齐与未对齐加载性能近同,或因 DMB 惩罚被其他瓶颈掩。存储侧即便对齐也极差(图表几不可见),未对齐再遭 ~8.5% 击,而常规存储 ~28GB/s。结论:Ampere 优化服务器负载,非游戏硬件。
Cortex-X4
常见于骁龙 8 Gen 3 掌机。对齐加载/存储约 11.5GB/s 与 6.7GB/s。未对齐因 DMB 惩罚,加载存储均跌约 50%。
Cortex-X925
DGX Spark 的 X925,带宽 273GB/s 远高于前代 76.8GB/s。结果与 X4 类似,未对齐惩罚相近,存储恢复略快。
Oryon-3
高通新核。对齐 LRCPC 加载匹敌常规;release-store 为常规 68% 带宽。未对齐加载罚 ~70%,存储仅 ~43%,但快于 Cortex 对齐。宣传“全一致 96KB L1”暗示未对齐影响应更小,实际不然。
Apple M1
硬件直支持 TSO,启用后对齐未对齐几乎一致,存储仅 ~5% 损。无需 DMB 回填。TSO 模式启用时整体有罚(常规存储 76%),但绝对值快得多。
总结未对齐的 LRCPC/release 访问
厂商支持 FEAT_LSE2 扩展,放宽 acquire/LRCPC/release 及 RMW 原子对齐至 16 字节内。但 x86 常跨全缓存行,仅 RMW 尝试避跨行,故该扩展对 x86 模拟仅边际收益,跨 16 字节仍报错。
哦不,这些原子指令是什么?
x86 支持原子 RMW。ARMv8.1-a 起有对应指令,下表直接映射:
| x86 | ARMv8.1-a | | --- | --- | | LOCK DEC | ldaddal | | LOCK INC | ldaddal | | LOCK NEG | ??? | | LOCK NOT | ldeoral | | LOCK ADC | ldaddal | | LOCK ADD | ldaddal | | LOCK AND | ldclral | | LOCK OR | ldsetal | | LOCK SBB | ldaddal | | LOCK SUB | ldaddal | | LOCK XADD | ldaddal | | LOCK XOR | ldeoral | | LOCK BTC | ldclralb | | LOCK BTR | ldeoralb | | LOCK BTS | ldsetalb | | LOCK CMPXCHG | casal | | CMPXCHG8B | caspal | | CMPXCHG16B | caspal |
映射清晰但未对齐同样拖累 RMW。图表示单原子指令在缓存行内。x86 Zen 全内延迟 1.44ns;跨 64 字节达 ~660ns(458x),即 split-lock。ARM 自然对齐最优慢 x86 ~3x。跨 16/64 字节在 ARM 等价,FEX 当 split-lock。
FEX 模拟 split-lock 慢因 FEAT_LSE2 仅放宽至 16 字节,跨边界仍错,每次走内核->用户信号->内核极慢。Oryon-3 的“一致缓存行”令行内原子匹敌自然对齐,仅跨行慢。M1 有 TSO 但未实现全行未对齐原子,跨 16 字节仍慢。Cortex-X4 在 Valve Steam Frame 因内核补丁处理未对齐原子,延迟 ~209ns 远快于 X925 1060ns。FEX 因硬件限 split-lock 模拟可能撕裂,不完美。
你说 split-lock 是强制要求的?
高效模拟难。朴素全局互斥漏掉非参与对齐原子致撕裂(如链表)。内核暂停所有共享内存进程方案性能不可行。
ARM 事务内存扩展(TME)可解但已弃用。我们提议 128 位 CASP 指令允许跨边界各 64 位半部不报对齐错,因 x86 仅最多 64 位未对齐原子,两半可包容。CASP 可安全失败重试,利用 LL/SC 保前进,近 x86 行为。
等等,未缓存内存也需要工作?
“未缓存”指 Vulkan 无 VKMEMORYHOSTCACHEDBIT,通常获 COHERENT,CPU/GPU 直连一致。CPU 映射多 Write-back(缓存)或 Write-Combine(未缓存)。PCIe GPU 需未缓存传数据,UMA 系统可用缓存一致内存。
Snapdragon UMA 缓存基准:Oryon-3 带宽更高,均数十 GB/s。未缓存结果(对数):WC 存储匹敌缓存;但 WC 加载极差,LRCPC 更糟;存储带宽比 Zen 差最高 816x,致《Hollow Knight: Silksong》等低于 1FPS。
LRCPC 扩展只解加载不解决 WC 存储 TSO 语义,FEX 只能禁用 TSO 缓解,PCIe GPU 体验差。UMA 系统可令驱动全用缓存缓冲避开(NVIDIA Tegra、Adreno 等),FEX 有 Turnip 补丁;Asahi 因硬件 TSO 天然避坑。
展望更光明的未来
从 ARMv8.0 起硬件逐年巨进。虽边界未全解,生态承诺改善。望未来笑看今困,享永不移植 ARM 的 x86 游戏。
评论
多数读者称赞苹果通过芯片级内存排序解决 x86 模拟的方案及组织能力,少数人质疑文章弱内存序更利优化的前提,并有技术补充介绍翻译框架。
认为苹果芯片与垂直整合能力领先行业
- 指出苹果六年前即在芯片中加入 x86 兼容内存排序模式来原生解决模拟问题,并有人赞叹其跨团队垂直整合组织能力之强(较多人) > 苹果六年前就给芯片加了 x86 兼容内存排序模式,这再次说明苹果芯片领先行业(@modeless)
认为弱内存排序未必更利优化
- 指出文章开头重复了 ARM 宽松、x86 严格限制优化的说法,但引用外部论点表明弱排序未必真有明显收益(少数人) > 文章开头说弱序利于硬件优化,但我看过有说服力的论证说弱排序其实没那么大好处(@pdw)
有价值的补充
- Fex 是 x86 到 ARM 的翻译框架,类似 Rosetta2 与 Prism;Valve 赞助其开发以支撑 Steam Frame 运行 x86 游戏,其分支也被 Crossover Beta 用来替代 Rosetta2(@dagmx)