今天,我们发布通义千问3.8-Omni-Flash(Qwen3.8-Omni-Flash),这是下一代原生全模态模型。其核心目标是强化真实生产力场景中的智能体能力,让全模态模型从理解内容走向规划任务、调用工具、完成创作。在编程、文本知识与图形界面操作等通用能力之上,它进一步扩展到音频和视频场景,在视频剪辑、音乐视频创作、影视制作与解说、视听摘要和实时对话等工作流中表现突出。
正文
引言
今天,我们推出 Qwen3.8-Omni-Flash,下一代原生全模态模型。其核心目标是增强真实生产力场景中的智能体能力,推动全模态模型从“理解全模态内容”走向“规划任务、调用工具、完成创意工作”。在编码、文本知识工作、GUI 操作等通用智能体能力基础上,Qwen3.8-Omni-Flash 进一步扩展以音频和视频为中心的智能体应用,在视频编辑、MV 创作、影视制作与解说、视听摘要、实时对话等工作流中表现突出。
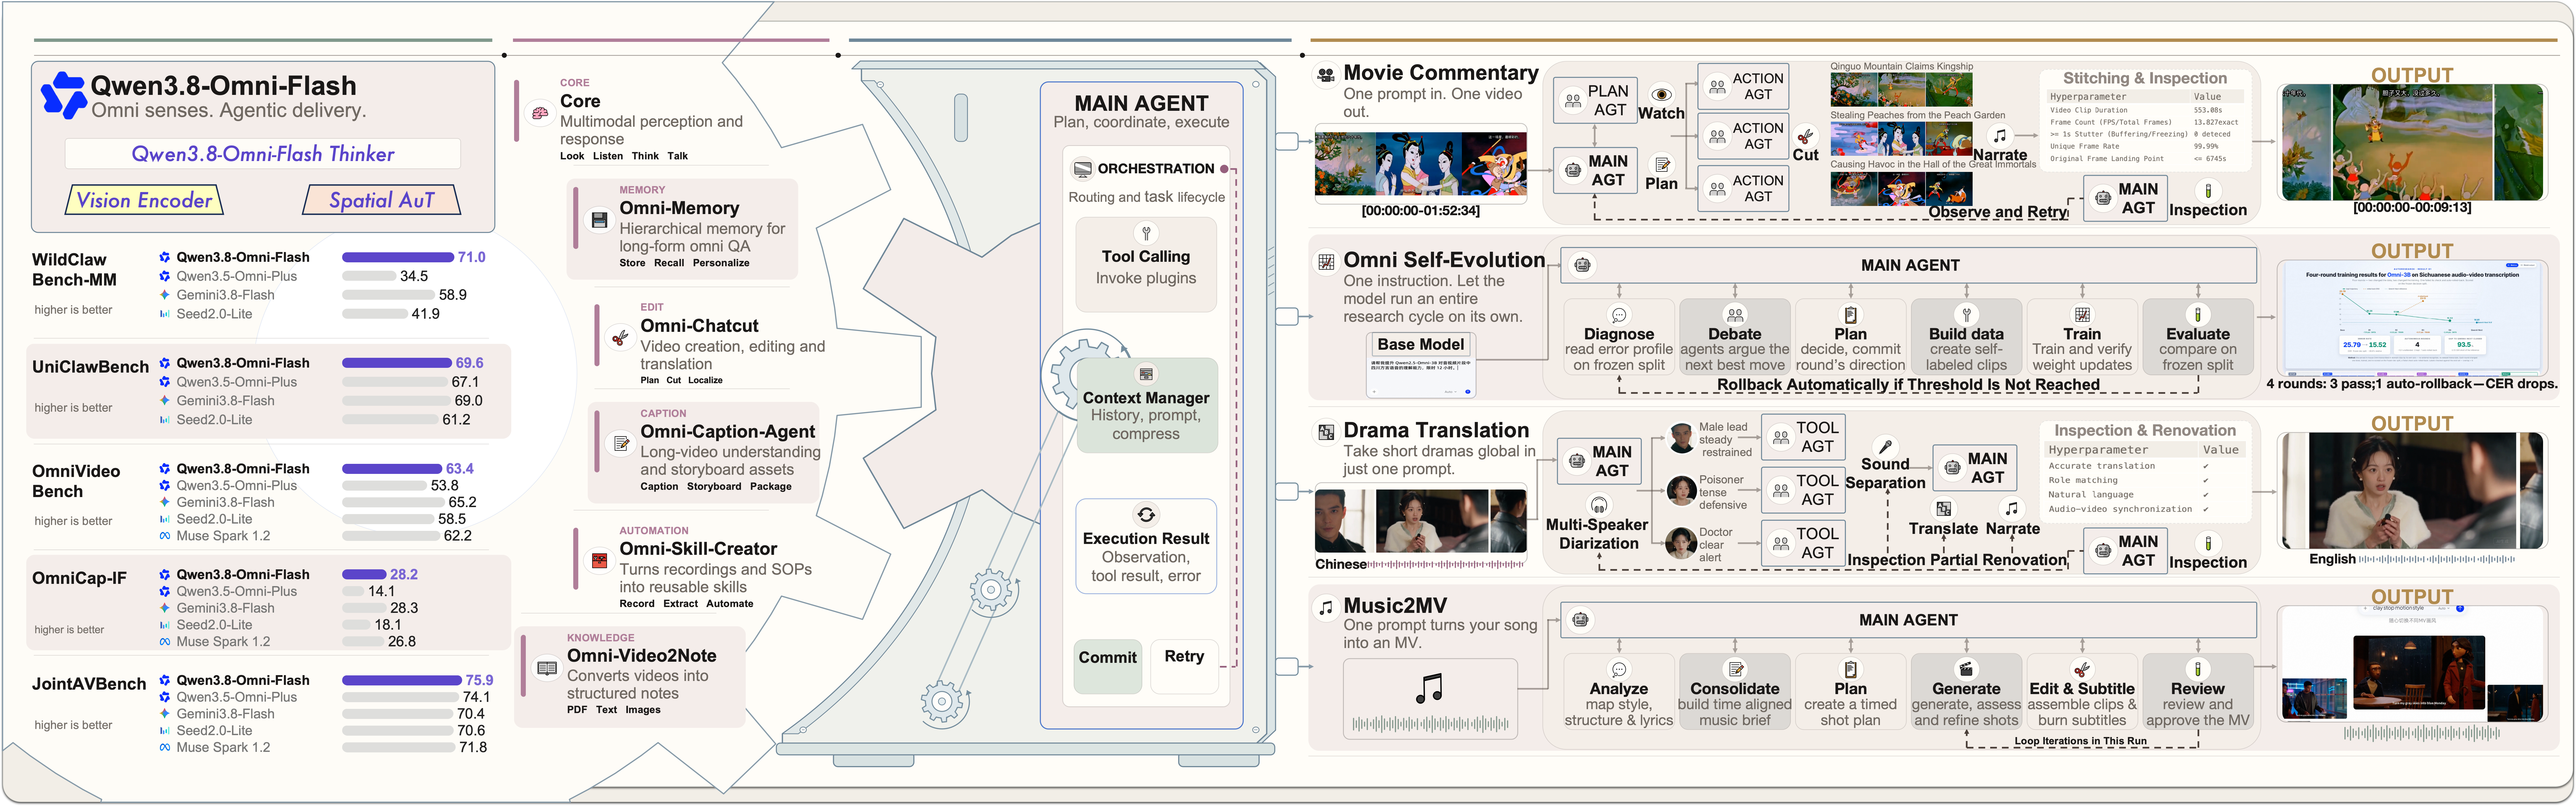
图 1. Qwen3.8-Omni-Flash 及其在生产中的应用。
Qwen3.8-Omni-Flash 现已在千问 AI 平台上线,支持文本、图像、音频和视频输入,上下文窗口 100 万 token。它在保持与同规模纯文本模型相当的文本性能的同时,显著提升全模态能力。在 29 项评估中,平均分比 Qwen3.5-Omni-Plus 提升超过 25%;每小时音频输入 API 价格下降超过 98%,每小时视听输入价格下降超过 93%。在视听智能体、编码和长程任务上,WildClawBench-MM 提升 36.5 分,AgenticVBench 提升 22.3 分,UniClawBench 得分 69.6。长音频和视听理解、视听推理、视听描述、多说话人识别等核心能力也大幅提升:LongAudioSpan 提升 8.3 分,OmniVideoBench 提升 9.6 分;OmniCap-IF 的 CSR 和 ISR 分别提升 8.5 和 14.1 分;AliMeeting DER 和 cpWER 从 88.11 / 89.61 降至 3.35 / 17.18。通过扩展数据、上下文和智能体环境,Qwen3.8-Omni-Flash 的视听性能接近 Gemini 3.8 Flash,整体音频性能超过 Gemini 3.8 Flash。这些进展意味着音频和视频正从感知输入演变为智能体理解环境、推理和执行任务的核心媒介。
脚注:评估范围包括音频推理基准 AliMeeting-test、AISHELL-4、MagicData-RAMC、MLC-SLM (en)、WenetSpeech (Net | Meeting)、FLEURS-60 ASR、FLEURS-60 S2TT、SpotSoundBench、MMAU、MMAR、MMSU、MuchoMusic-RUL、HumMusQA、MusTBench、Audio-MultiChallenge、WildSpeech 和 VoiceBench;视听推理基准 DailyOmni、WorldSense、AVUT、JointAVBench、OmniCloze、OmniCap-IF、QIVD、OmniVideoBench 和 StreamingBench;视听智能体基准 WildClawBench-MM、UniClawBench 和 OmniGAIA。定价方法:每小时音频或视听输入价格按两分钟源素材输入成本的 30 倍估算;视听输入使用 720p、1 fps。Gemini 3.8 Flash 使用 mediaresolution=high,Seed 2.0 Lite 使用 maxframe_tokens=384,其他 API 参数使用默认值。文本输入和输出价格按每 100 万 token 人民币计;Gemini 和 Muse 价格按 1 美元 = 6.7191 人民币换算。
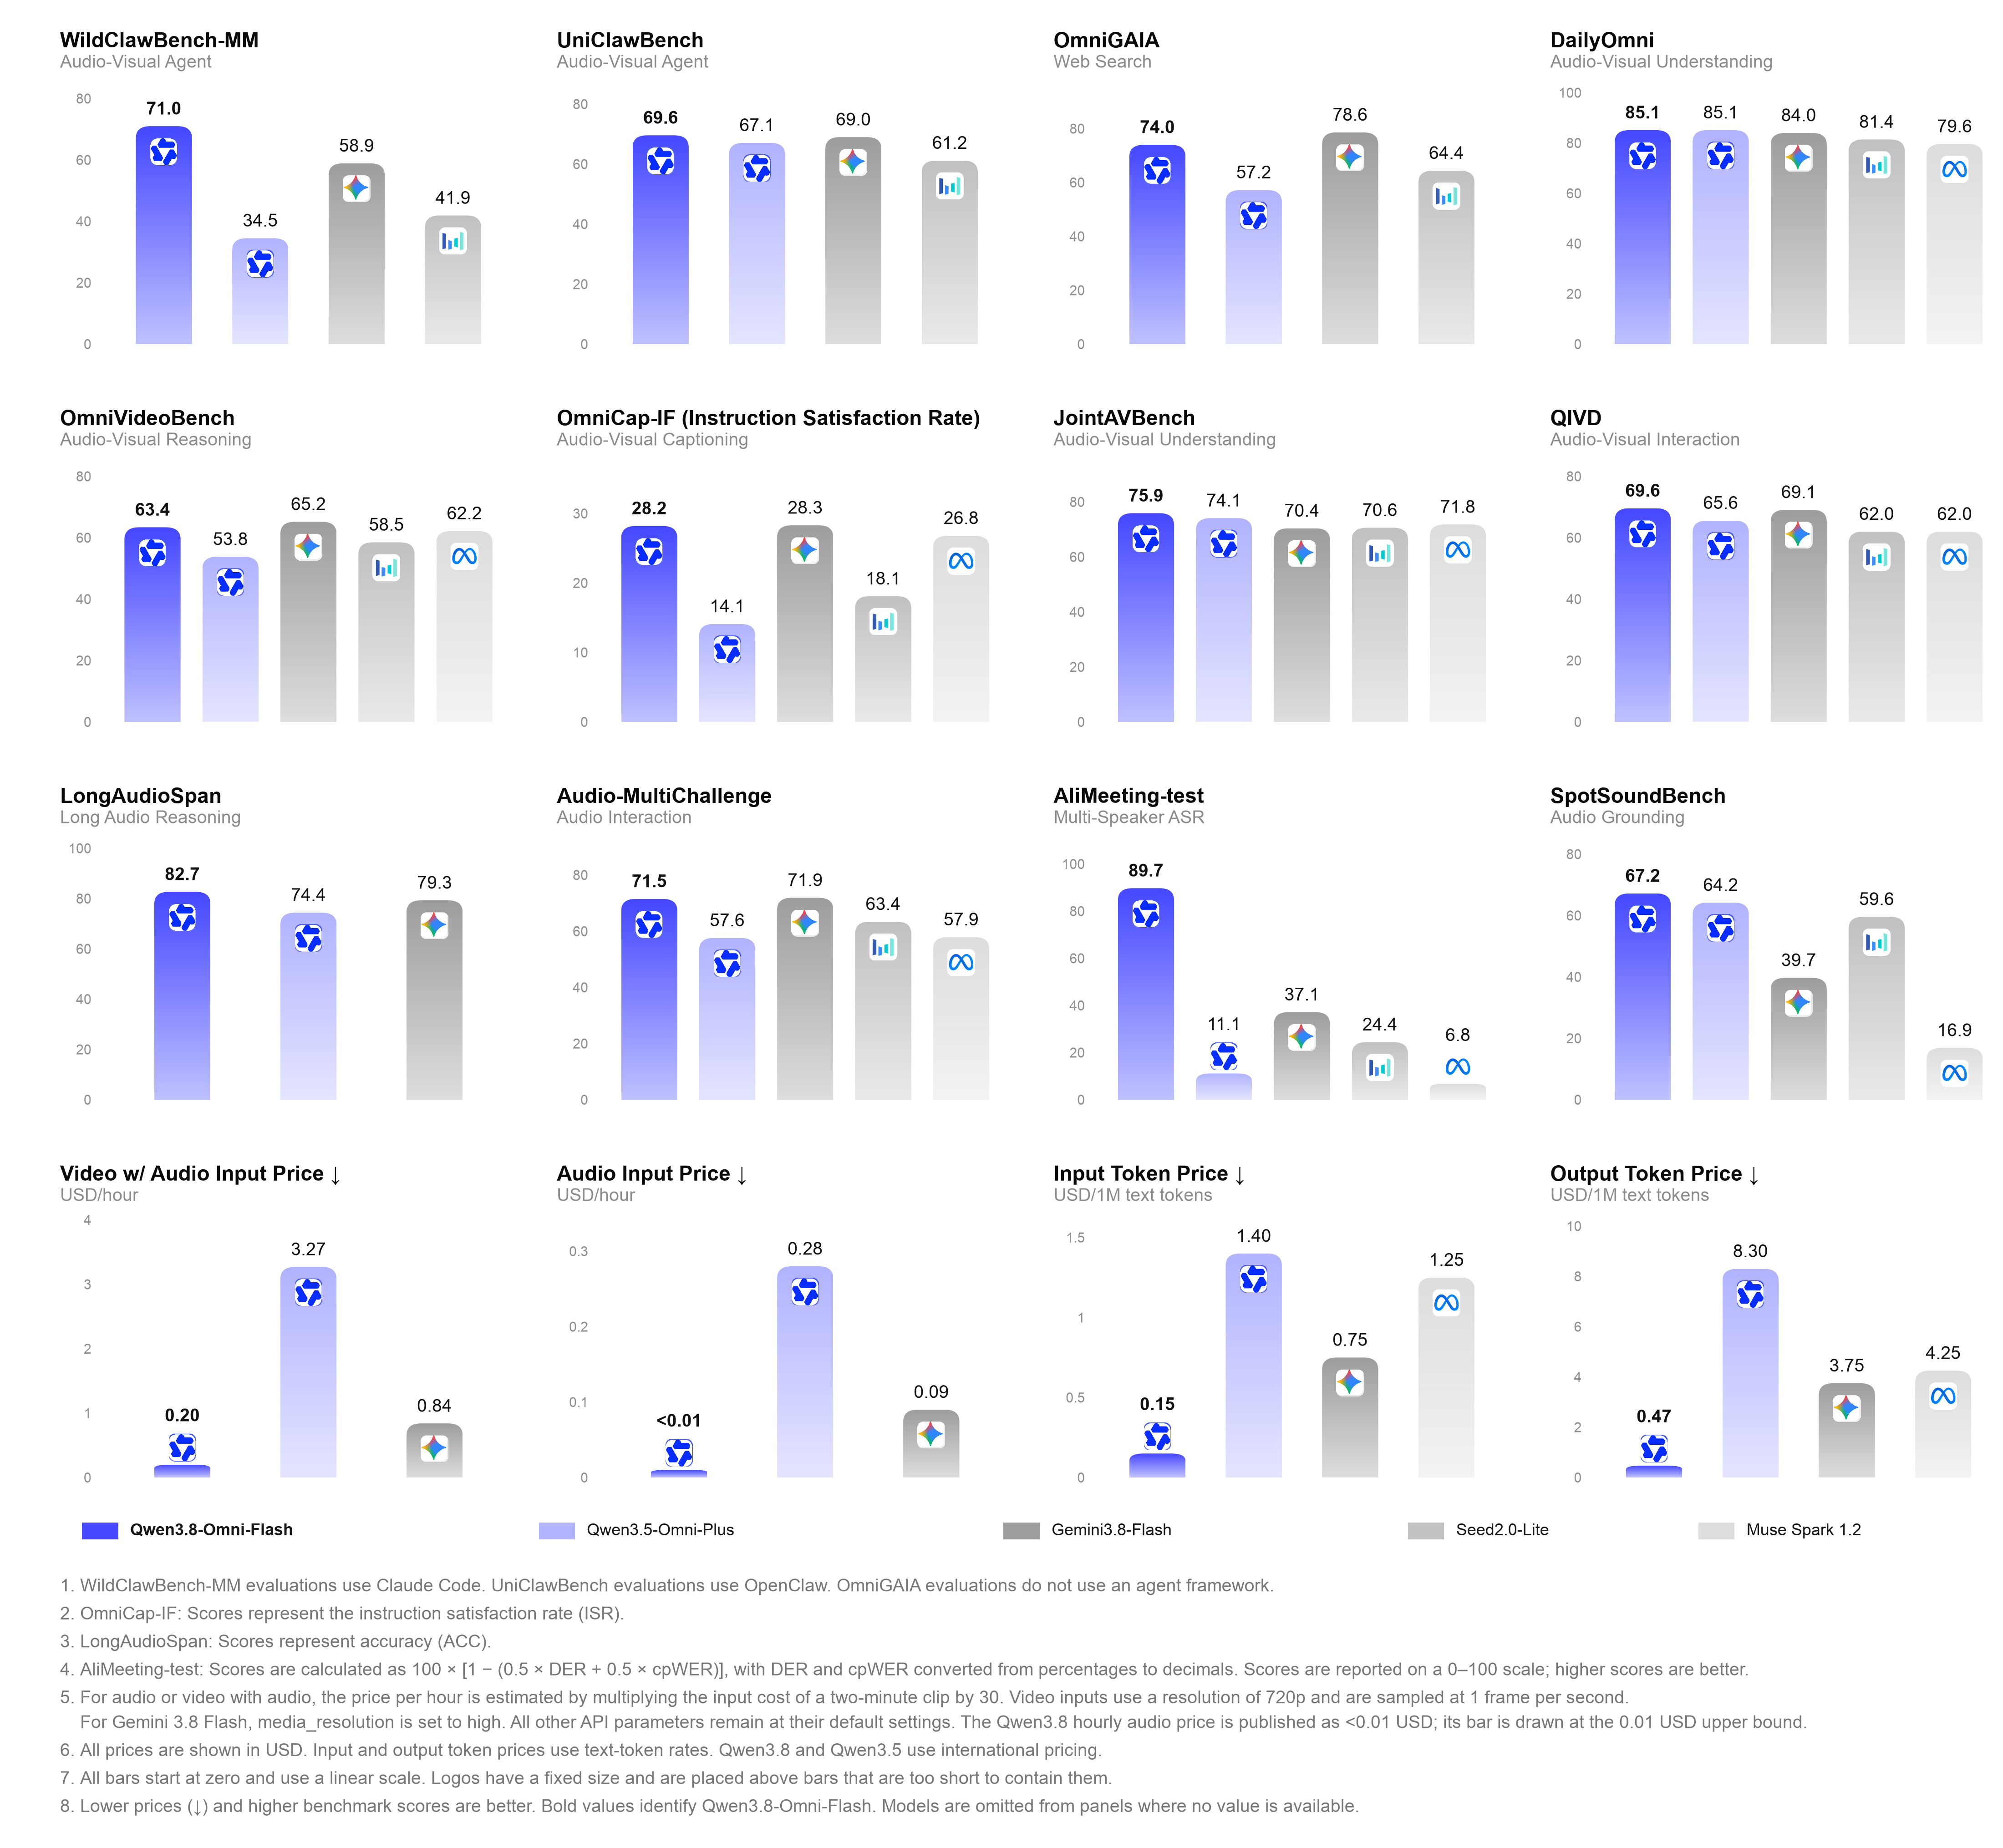
音频和视频是把智能体带入真实生产力场景的重要媒介,但也带来新的系统级挑战。长音频和视频在存储、传输和多轮推理中成本高昂;现有智能体框架缺乏对这些模态的原生支持;连接全模态理解与端到端任务执行的工作流仍处于早期。解决这些挑战需要模型、框架工具和运行时环境共同演进。
为此,我们用 Qwen3.8-Omni-Flash 探索如何将源理解、任务规划、工具执行和结果交付连成完整流水线。它支持端到端长程工作流,如视频编辑、翻译、电影解说和内容创作,推动 Omni 从视听理解走向自主行动和任务完成。
我们进一步扩展 Qwen-MM-Plugins,为长音频和视频提供按需感知、工具使用和工作流执行。同时开源 Qwen-Live Harness,作为连续实时全模态交互的原生运行时。二者共同应对长程工作流和实时交互,并随模型扩展全模态智能体能力。
长音频-视觉理解
Qwen3.8-Omni-Flash 对长音频-视觉理解带来重大升级——从可控描述和智能体证据收集,到理解会议并推进后续任务,再到生成以视频为中心的深度研究报告。它不只是处理更长内容,而是更精准地找到相关证据、更深入推理、更高效行动。
可控视听描述
视频描述没有唯一答案。内容创作重视叙事,素材检索关注特定片段,资产管理依赖结构。不同应用需要不同视频描述。在 Qwen3.8-Omni-Flash 中,视频描述从回答“模型看到了什么”升级为理解“用户想知道什么”。用户可以自由指定主体、时间范围、详细程度和输出格式。同一视频,模型可以提供概览、定位关键片段,或按需深入分析角色动作、镜头、灯光和声音,生成结构化结果。你定义看什么、看多细、如何呈现。
智能体长视频视听理解
对于数小时视频,传统方法要求模型从头到尾处理整个记录,即使答案只出现在几分钟画面中。原生 Qwen3.8-Omni-Flash 智能体从问题出发,独立决定看什么、听什么,通过多轮由粗到细的证据收集定位关键信息。无需处理每一帧,就能把有限算力和 token 预算集中在相关片段,实现更高效的长视频理解。在 OmniVideoBench 上,智能体理解将准确率从 63.4 提升到 67.8,同时 token 消耗从 145,736 降至 79,117,减少约 45.7%。下表比较静态理解与智能体理解在 OmniVideoBench 上的准确率和 token 消耗:
| | 静态理解 | 智能体理解 | | --- | --- | --- | | 准确率(↑) | 63.4 | 67.8 | | 每查询 token 数(↓) | 145,736 | 79,117 |
注:智能体模式跨轮保留上下文。
长会议:从纪要到行动
多参与者会议是最复杂的视听理解场景之一:说话人轮流发言且重叠,身份、指代和讨论主题不断变化。Qwen3.8-Omni-Flash 跨音频和视频联合识别说话人,原生支持最长一小时视听输入,能端到端进行说话人分割、内容转写和身份对齐。给定完整会议视频和请求,模型可以映射参与者关系、生成会议纪要、识别行动项、分析项目风险,并利用视觉信息解决音频中的指代和实体歧义。结合智能体和工具使用,它还能发邮件、整理任务,甚至根据会议需求开始编码——从理解会议走向对会议采取行动。
用音频和视频做深度研究
当用户带着具体问题看视频时,答案往往超出视频本身。Qwen3.8-Omni-Flash 将用户需求与视频内容结合,识别值得深入研究的问题,整理关键素材,并搜索网络上的多模态来源——包括图像、视频和文档。它随后生成以视频为中心、图文丰富的研究报告,帮助用户理解内容并解决实际问题。例如,当用户遇到 Photoshop 头发抠图周围的色边时,模型可以拆解教程步骤,研究 Multiply 和 Screen 混合模式的原理,比较替代边缘修复技术,并解释哪种方法最适合用户的情况。
视听制作与编辑
Qwen3.8-Omni-Flash 把视听智能体带入新阶段:从理解声音和图像,到独立规划、调用工具并交付成片,把全模态智能带入专业视听内容生产工作流。
Music2MV
对于 MV 创作,Qwen3.8-Omni-Flash 能细致理解用户提供歌曲的结构、节奏、情绪、人声和器乐变化,并据此设计角色、场景和镜头。它还能输出带时间戳的逐行歌词,让人声、字幕和画面对齐。结合 Qwen-MM-Plugins 等创作工具,模型支持从音乐理解、创意规划到最终质量检查的完整工作流,展现强大的视听理解、推理和创作能力。
短剧翻译
传统视频翻译常常需要在转写、翻译、配音和编辑平台之间反复切换,使 API 调用和工作流协调复杂,也难以保持角色声音、对话时长和视觉节奏的一致性。使用基于 Qwen3.8-Omni-Flash 的智能体,用户可以用一句话描述需求,完成说话人感知的对话识别、对话翻译、角色声音克隆和配音、音频混音以及最终质量检查。这些原本碎片化的本地化步骤变成完整工作流,实现面向国际受众的短剧自动化交付。
长片解说
为两三个小时的全片制作解说视频,往往需要反复观看影片、重建情节,然后进行镜头选择、脚本撰写、配音、配乐和剪辑,过程复杂耗时。使用基于 Qwen3.8-Omni-Flash 的智能体,用户只需提供影片并用一句话描述创作要求,即可完成长视频理解、关键情节提取、解说规划、配音和音乐制作、剪辑、渲染以及最终质量检查。智能体还能智能交错原始对话和解说,自动调整语速和音量,让旁白、原始音频、背景音乐和画面自然融合,制作出更真实、沉浸、电影感的解说视频。
从使用模型到优化模型
真实多模态应用往往复杂且成本敏感,需要模型在质量、延迟、算力和部署成本之间平衡。为特定场景定制更小的模型,因此成为规模化部署应用的重要路径。但传统工作流涉及数据构建、问题诊断、多轮训练和评估,耗时且高度依赖人类专家。这次,我们把 Qwen3.8-Omni-Flash 扩展到模型开发本身,探索一种新方法:大模型驱动研发,小模型服务业务。
我们给 Qwen3.8-Omni-Flash 一个任务:在 12 小时内提升 Qwen2.5-Omni-3B 的四川方言语音识别,并交付可用模型。它独立选择 WenetSpeech-Chuan 评估集,固定评估标准并建立基线。然后直接听音频样本,利用识别结果诊断问题,并构建针对性训练数据。在连续四轮实验中,智能体创建了 3,413 个训练样本,根据评估反馈调整方法,保留有效改进,回滚不成功的尝试。Qwen2.5-Omni-3B 在同一评估集上的字符错误率最终从 25.79% 降至 15.30%,相对降低约 40.7%。
这个实验展示了模型演化的另一种可能:通用多模态模型理解数据、规划实验并推动迭代,小模型获得面向特定应用的专业能力。智能体可以超越使用模型,帮助解决实际业务问题。
视听信息压缩
音频和视频承载丰富信息,但其线性、非结构化形式使检索和复用困难。Qwen3.8-Omni-Flash 理解声音、画面和时间线,使用智能体工作流提取信息、重组结构并验证结果。它把长视频中的核心知识和实践经验转化为更密集、更易消费和复用的信息资产。
Video2Note
为了把视频知识变成结构化资源,我们在 Qwen-MM-Plugins 中开源 Video2Note。借助 Qwen3.8-Omni-Flash 对语音、画面和流程的联合理解,它自动整理知识、拆解关键步骤、选择代表性帧,并生成图文对应的 PDF 笔记。自动审查和迭代修正进一步把数小时视频浓缩成清晰易读、便于回顾的文档。
Omni Skill Creator
视频不仅记录“如何做”,也记录专家积累的实践经验。为此,我们在 Qwen-MM-Plugins 中引入新的开源能力 Omni Skill Creator。它可以从演示中提取标准操作流程(SOP),用于可复用的自动化工作,或从专家指导中学习工具使用、决策标准和关键洞见。一次演示就能变成经过验证和评估的智能体技能,实现从全模态内容构建可复用、可分享的技能。
实时视听交互
Qwen3.8-Omni-Flash 为完整视听内容的深度理解和创作而设计。对于连续低延迟交互,我们进一步推出 Qwen3.8-Omni-Flash-Realtime。它在接收实时视听流的同时感知和响应,利用实时上下文调用工具、执行任务,把全模态能力从“理解一段内容”带到“参与一次交互”。
实时口语练习
口语没有标准输入。口音、元音辅音替换和声调偏差可能导致逐字转写偏离原意。Qwen3.8-Omni-Flash-Realtime 联合建模发音和语义,理解受口音影响的非标准表达,将其对齐到正确词语,并实时生成标准发音示范。在多轮练习中,模型用新音频更新判断,纠正影响理解的错误,同时保留自然节奏、语调和情感。
全模态空间音频感知
在真实空间中,声音提供视觉之外的另一条坐标轴。Qwen3.8-Omni-Flash-Realtime 将空间声音与视觉信息结合,在感知障碍物、可通行区域和场景变化的同时,持续判断声源方向和距离,成为首个能通过声音定位目标的全模态模型。
对于“过来这里”或“去看看是什么在响”等指令,模型可以从环境噪声中分离人声和目标声音,将其含义锚定在周围空间,并调用工具执行定位、搜索、路径规划和导航——从听到目标到到达目标。
视听交互的外部知识
实时交互不仅需要低延迟,还需要为每个应用动态加载知识和行为。Qwen3.8-Omni-Flash-Realtime 支持通过 Skills 注入身份设定、表达风格、业务知识和交互规则,同时用工具使用把这些能力扩展到任务执行。
在客服等场景中,模型可以实时加载品牌语言和服务流程,理解用户语音、视觉和上下文,生成符合业务要求的回应并执行动作。同一个实时模型因此可以承担不同知识、角色和行为方式。
基准结果
Omni
| | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash | | --- | --- | --- | --- | | 智能体全模态智能 | | | | | WildClawBench-MM 多模态工具使用 | 71.0 | 34.5 | 58.9 | | UniClawBench 多模态工具使用 | 69.6 | 67.1 | 69.0 | | AgenticVBench 多模态工具使用 | 36.8 | 14.5 | 45.0 | | OmniGAIA 网络搜索 | 74.0 | 57.2 | 78.6 | | 通用视听能力 | | | | | DailyOmni 视听理解 | 85.1 | 85.1 | 84.0 | | WorldSense 视听理解 | 68.5 | 63.9 | 69.6 | | AVUT 视听理解 | 86.6 | 85.9 | 88.0 | | JoinAVBench 视听理解 | 75.9 | 74.1 | 70.4 | | OmniVideoBench 视听推理 | 63.4 | 53.8 | 65.2 | | Video-MME-v2 视听推理 | 65.0 | 47.9 | 71.0 | | LVOmniBench 长视频推理 | 63.3 | 53.2 | 70.7 | | OmniCloze 视听描述 | 63.2 | 64.2 | 60.9 | | OmniCap-IF 视听描述 | CSR 80.6 ISR 28.2 | CSR 72.1 ISR 14.1 | CSR 81.9 ISR 28.3 | | QIVD 视听交互 | 69.6 | 65.6 | 69.1 | | StreamingBench 视听交互 | 80.8 | 57.1 | 79.9 | | 通用音频能力 | | | | | AliMeeting Test 多说话人 ASR(DER | cpWER,↓) | 3.4 | 17.2 | 88.1 | 89.6 | 72.6 | 53.1 | | AISHELL-4 多说话人 ASR(DER | cpWER,↓) | 2.8 | 11.2 | 100.0 | 100.0 | 66.4 | 56.9 | | MagicData-RAMC 多说话人 ASR(DER | cpWER,↓) | 5.7 | 14.1 | 98.4 | 97.1 | 67.9 | 33.8 | | MLC-SLM (en) 多说话人 ASR(DER | cpWER,↓) | 4.0 | 14.2 | 68.6 | 63.9 | 60.8 | 26.6 | | WenetSpeech (Net) ASR(WER,↓) | 4.8 | 3.7 | 14.2 | | WenetSpeech (Meeting) ASR(WER,↓) | 4.6 | 4.8 | 16.7 | | FLEURS-ASR 多语言 ASR(WER,↓) | 9.3 | 7.2 | 7.9 | | FLEURS-S2TT 多语言 S2TT(BLEU) | 31.8 | 32.2 | 33.0 | | SpotSoundBench 音频定位 | 67.2 | 64.2 | 39.7 | | MMAU 音频理解 | 81.8 | 81.9 | 76.9 | | MMAR 音频理解 | 79.8 | 79.8 | 78.5 | | MMSU 音频理解 | 82.1 | 83.0 | 83.3 | | LongAudioSpan 长音频推理 | 准确率 82.7 评分 71.8 链 48.2 | 准确率 74.4 评分 49.8 链 45.1 | 准确率 79.3 评分 65.5 链 64.6 | | MuchoMusic-RUL 音乐理解 | 72.6 | 71.6 | 53.7 | | HumMusQA 音乐理解 | 75.8 | 75.5 | 71.2 | | MusTBench 音乐理解 | 50.6 | 49.1 | 40.3 | | Audio MultiChallenge 音频交互 | 71.5 | 57.6 | 71.9 | | WildSpeech 音频交互 | 74.3 | 75.7 | 76.4 | | VoiceBench 音频交互 | 91.6 | 92.9 | 92.3 |
注:智能体全模态智能评估框架:WildClawBench-MM 和 AgenticVBench 使用 Claude Code,UniClawBench 使用 OpenClaw,OmniGAIA 不使用框架。FLEURS ASR 和 S2TT 覆盖 60 种语言。空单元格表示尚无分数或不适用。
智能体全模态理解
长音频和视频中的关键信息常分散在不同片段,复杂问题需要跨声音和图像多步推理。智能体全模态理解让模型从问题出发,规划方法、调用工具,逐步定位并验证证据。通过把计算集中在相关内容上,它提升长视频视听理解的准确率和效率。为评估该能力,我们在 OmniVideoBench、Video-MME-v2 和 LVOmniBench 上,比较 Qwen3.8-Omni-Flash 和 Gemini 3.8 Flash 在两种设置下的表现:静态模式直接解读输入;智能体模式使用 Qwen Code。
| | Qwen3.8-Omni-Flash(静态) | Qwen3.8-Omni-Flash(Qwen Code) | Gemini 3.8 Flash(静态) | Gemini 3.8 Flash(Qwen Code) | | --- | --- | --- | --- | --- | | OmniVideoBench 视听推理 | 63.4 | 67.8 | 65.2 | 70.1 | | Video-MME-v2 视听推理 | 65.0 | 71.3 | 71.0 | 72.7 | | LVOmniBench 长视频推理 | 63.3 | 73.6 | 70.7 | 70.7 |
文本
| | Qwen3.8-Omni-Flash | Qwen3.8-Flash | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 | Claude-Opus-4.6 (Max) | | --- | --- | --- | --- | --- | --- | --- | | 编码与智能体 | | | | | | | | DeepSWE 1.1 长程软件工程 | 57.8 | 58.7 | 42.2 | 16.5 | 54.4 | -- | | SWE-bench Pro 长程软件工程 | 63.3 | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 | | SWE-bench Multilingual 多语言软件工程 | 80.5 | 81.0 | 73.8 | 75.8 | -- | 77.5 | | NL2Repo-Bench 仓库级代码生成 | 48.9 | 48.1 | 42.3 | 41.1 | 54.2 | 47.6 | | CoWorkBench 长程办公工作 | 75.3 | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 | | 通用文本能力 | | | | | | | | IFBench 指令遵循 | 81.5 | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 | | GPQA Diamond 科学推理 | 91.0 | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 | | HLE 多学科推理 | 36.5 | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 | | LiveCodeBench v6 竞技编程 | 92.6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
注:DeepSWE 1.1 使用 Claude Code 和 mini-SWE-agent 框架,temp=1.0,top_p=0.95,256K 上下文窗口,报告两个框架中的最高分;SWE-bench Pro 除 Claude-Opus-4.6 (Max) 使用官方公布分数外,其他模型使用 Claude Code 框架;SWE-bench Multilingual 使用 mini-SWE-agent;NL2Repo-Bench 使用 Claude Code,并禁用可能访问特定仓库的 Bash 命令;CoWorkBench 是内部协作基准,评估计算机科学、金融、法律、医疗等生产力领域的长程办公和生产力智能体任务;HLE 由 GPT-4o 评判;空单元格表示尚无分数或不适用。
视觉
| | Qwen3.8-Omni-Flash | Qwen3.8-Flash | Qwen3.8-27B | Qwen3.7-Plus | Claude-Opus-4.6 (Max) | | --- | --- | --- | --- | --- | --- | | 智能体视觉智能 | | | | | | | ClawEval-MM 多模态工具使用 | Pass@3 60.4 平均 61.9 | Pass@3 64.4 平均 60.4 | Pass@3 57.4 平均 56.9 | Pass@3 57.4 平均 60.1 | Pass@3 52.5 平均 54.7 | | AndroidWorld 移动使用 | 87.1 | 84.5 | 81.9 | 81.0 | 62.0 | | Vision2Web 可视化网页开发 | 62.9 | 64.0 | 62.9 | 42.1 | -- | | 通用视觉能力 | | | | | | | ERQA 具身智能 | 71.0 | 72.3 | 65.5 | 69.8 | 40.8 | | LVBench 长视频理解 | 76.9 | 76.6 | 72.4 | 76.2 | 63.0 | | RealWorldQA 真实世界感知 | 87.7 | 88.5 | 85.9 | 86.9 | 73.9 | | MathVision 视觉数学问题求解 | 无 CI 91.8 有 CI 96.2 | 无 CI 90.6 有 CI 95.7 | 无 CI 90.0 有 CI 94.6 | 无 CI 90.3 有 CI 88.4 | 无 CI 65.5 有 CI -- | | CharXiv (RQ) 科学图表分析 | 无 CI 83.5 有 CI 91.4 | 无 CI 84.6 有 CI 90.6 | 无 CI 83.7 有 CI 90.2 | 无 CI 85.8 有 CI 85.9 | 无 CI 66.0 有 CI -- |
注:ClawEval-MM 分数为 pass@3 / 平均分;RecreationBench 是内部长程应用重建基准;OSWorld 2.0 分数为 binary / partial;Vision2Web 使用 Claude Code 框架,由 gpt-5.4-2026-03-05 评判;MathVision 和 CharXiv (RQ) 分数为无 CI / 有 CI;空单元格表示尚无分数或不适用。
吞吐与延迟
以下结果展示 Qwen3.8-Omni-Flash-Realtime API 在不同输入条件下的吞吐和延迟,反映生产环境中的用户体验。
| 输入场景 | 文本输出 TPS(Tokens/s) | 首 token 时间(ms) | 首个音频包时间(ms) | 音频生成 RTF | | --- | --- | --- | --- | --- | | 实时 API 性能 | | | | | | 音频 6s | 84.87 | 591.26 | 978.36 | 0.1538 | | 音频 12s | 83.18 | 604.80 | 982.74 | 0.1537 | | 音频 20s | 81.06 | 617.98 | 1026.39 | 0.1538 | | 视听 6s | 84.89 | 837.96 | 1214.73 | 0.1524 | | 视听 12s | 84.33 | 911.85 | 1268.07 | 0.1527 | | 视听 20s | 83.00 | 981.01 | 1350.49 | 0.1528 |
支持语言
| 能力 | 语言 | 中文方言 | | --- | --- | --- | | 语音识别 | 74 种语言: 南非荷兰语、阿拉伯语、阿斯图里亚斯语、阿塞拜疆语、巴斯克语、白俄罗斯语、孟加拉语、波斯尼亚语、保加利亚语、粤语、加泰罗尼亚语、宿务语、中文、克罗地亚语、捷克语、丹麦语、荷兰语、英语、世界语、爱沙尼亚语、菲律宾语、芬兰语、法语、加利西亚语、格鲁吉亚语、德语、希腊语、希伯来语、印地语、匈牙利语、冰岛语、印度尼西亚语、国际语、意大利语、日语、爪哇语、卡纳达语、哈萨克语、韩语、吉尔吉斯语、林加拉语、拉脱维亚语、立陶宛语、马其顿语、马来语、马拉雅拉姆语、马耳他语、毛利语、马拉地语、蒙古语、挪威博克马尔语、挪威尼诺斯克语、奥里亚语、波斯语、波兰语、葡萄牙语、旁遮普语、罗马尼亚语、俄语、塞尔维亚语、斯洛伐克语、斯洛文尼亚语、西班牙语、斯瓦希里语、瑞典语、塔吉克语、泰米尔语、泰卢固语、泰语、土耳其语、乌克兰语、乌尔都语、维吾尔语和越南语 | 39 种方言: 东北官话、贵州话、广东粤语、河南话、香港粤语、上海话、陕西话、天津话、台湾普通话、云南话、安徽话、福建话、甘肃话、广东普通话、湖北话、湖南话、江西话、山东话、山西话、四川话、广西话、海南话、重庆话、长沙话、杭州话、合肥话、银川话、郑州话、沈阳话、温州话、武汉话、昆明话、太原话、南昌话、济南话、兰州话、南京话、客家话和闽南语 | | 语音生成 | 29 种语言: 中文、英语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、法语、俄语、泰语、印度尼西亚语、阿拉伯语、越南语、土耳其语、芬兰语、波兰语、印地语、荷兰语、捷克语、乌尔都语、他加禄语、瑞典语、丹麦语、希伯来语、冰岛语、马来语、挪威语和波斯语 | 7 种方言: 四川话、北京话、天津话、南京话、陕西话、粤语和闽南语 |
Qwen3.8-Omni-Flash 快速上手
API 使用
Qwen3.8-Omni-Flash 正式支持 reasoning_effort 调整推理深度和控制成本:xhigh(默认)适合需要深入分析的复杂任务;medium 平衡准确率和速度;low 为速度和成本优化。此外,所有场景默认启用 preserve_thinking,提供最佳开箱体验。Qwen3.8-Omni-Flash 支持行业标准协议,包括 OpenAI 兼容的 Chat Completions 和 Responses API。示例展示如何上传图像和音频并请求描述。
可控视听描述的最佳实践
内容组织和详细程度: 将视频描述、OCR 提取、音频描述和语音转写组织成覆盖视觉、语音、音乐、音效和环境声的部分。保留原始文本、说话人身份和对应时间范围,便于检索和验证。在提示中指定目标长度来控制详细程度,例如“用约 2000–3000 字描述视频”,并根据视频时长和信息密度调整。
提示示例要求详细描述视频,覆盖视觉维度(主体和角色、按时间顺序的动作和事件、场景和背景、空间布局、屏幕文字、视觉风格)和音频维度(语音逐字转写、说话人、说话状态、音乐、音效和环境声、非语音发声),以及视听对应关系。输出明确包含三个部分:1. 按时间顺序的结构化故事线,包含每个显著视听细节;2. 所有可见文本的结构化列表,包含开始时间戳、结束时间戳、确切文本内容和外观特征,如无文本则明确说明;3. 结构化语音转写,包含说话人、确切内容、开始和结束时间戳以及说话状态,如无语音则明确说明。除三个必需部分外,可自由组织额外内容。规则:尽可能增加描述细节;不要使用 Markdown 粗体;仔细看帧听音频,确保不遗漏细节。
结构化输出和 schema 约束: 在提示中包含任务指令和完整 JSON Schema,指定字段含义、类型、必填字段和约束,以支持程序化解析和下游使用。示例要求用英语详细描述视听内容,按场景和事件组织,遵循 JSON Schema。所有时间戳必须相对于视频开头;结束时间不得早于开始时间或超过视频时长;每个事件必须落在父场景的时间范围内。只包含音频或视频直接支持的信息,不要猜测或编造细节,不要仅因声音和动作同时发生就推断因果。只返回有效 JSON,不要 Markdown 围栏或评论。
在智能体框架中安装 Qwen-MM-Plugins
Qwen-MM-Plugins 是面向智能体框架的多模态插件套件。它让智能体能够理解图像、音频、视频和文档,维护长视频记忆并创建内容。支持 Codex、Claude Code、Qwen Code、Gemini CLI、Qoder、CodeBuddy 和 OpenClaw 等智能体框架,也欢迎社区开发者贡献。
可以在常用办公智能体中直接输入请求:帮我安装来自 https://github.com/QwenLM/Qwen-MM-Plugins 的 core、api 和 omni 相关插件。
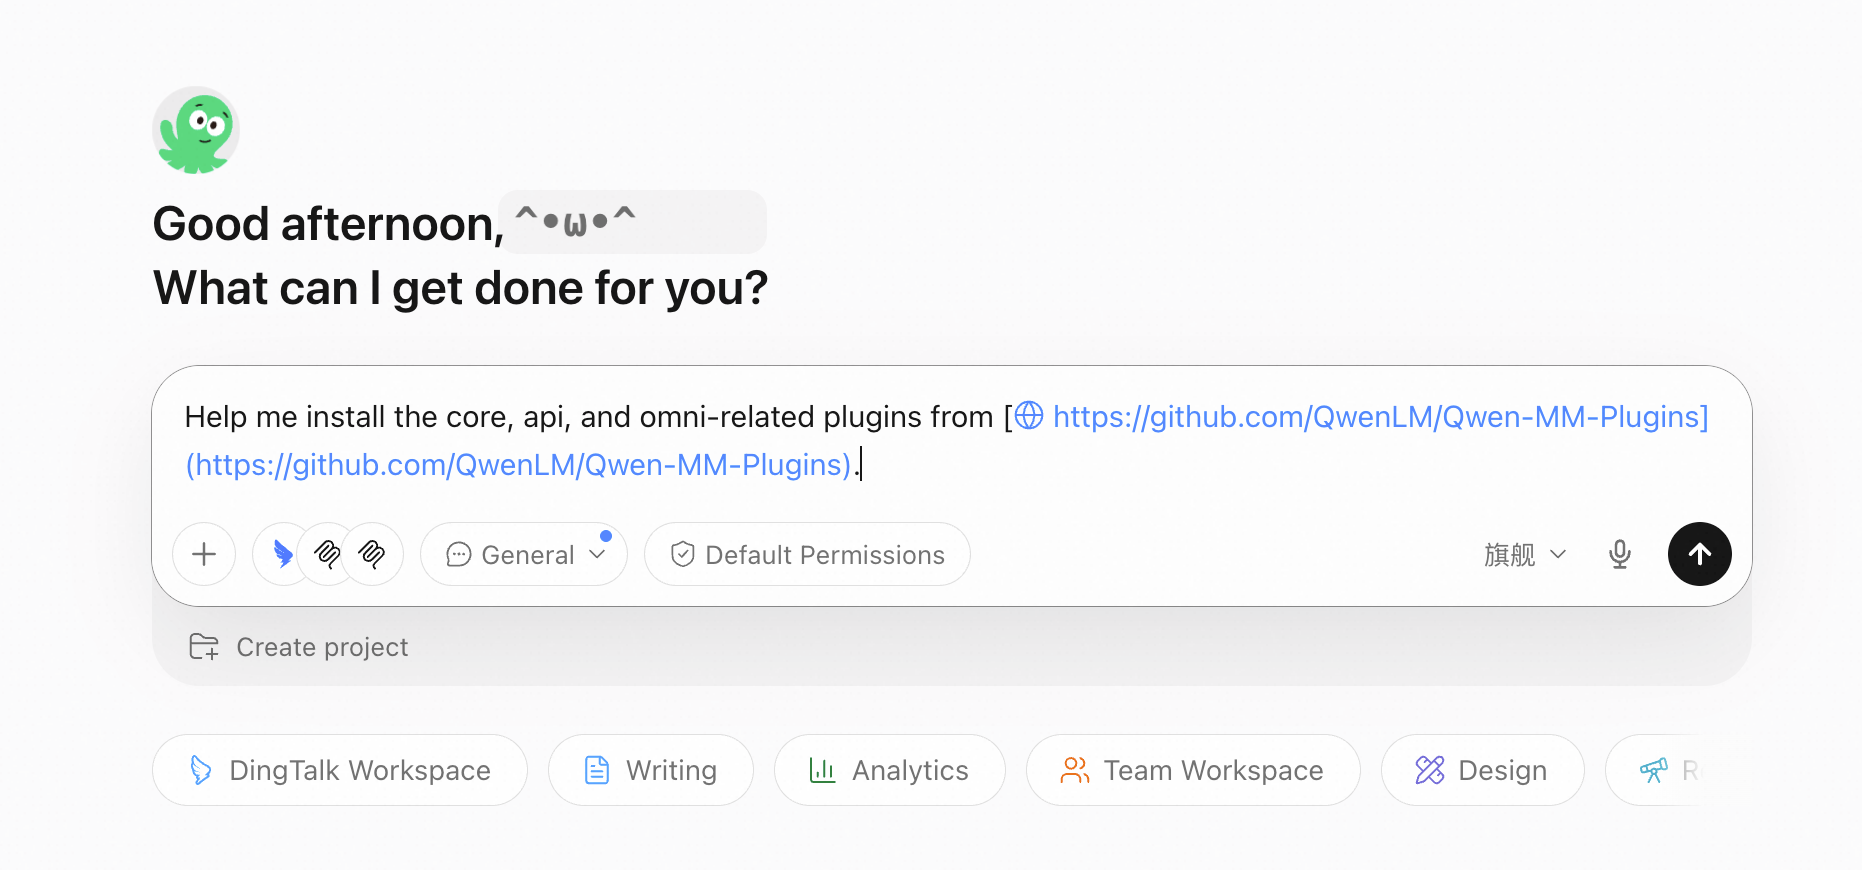
也可以从命令行安装:运行官方引导安装器 curl -fsSL https://raw.githubusercontent.com/QwenLM/Qwen-MM-Plugins/main/install.sh | bash,然后在菜单中选择 Install、你使用的智能体框架和需要的 Omni 插件。
| 插件 | 能力 |
| --- | --- |
| core | 读取图像、视频帧、PDF、Office 文档、代码、数据和 3D 文件 |
| api | 图像理解、OCR、目标定位、视听转写、说话人分离、事件分析和图像分割 |
| omni-chatcut | 创建 MV、长片解说和视频语音翻译 |
| omni-video2note | 把视频教程变成带关键截图的 PDF 笔记 |
| omni-skill-creator | 把教学视频、屏幕录制或操作演示变成可复用的 Agent Skill.md 文件 |
| omni-memory | 为长视频中的人物、对话、声音和事件构建记忆 |
安装后,重启智能体框架或创建新任务。示例请求包括:根据歌曲节奏和内容生成完整 MV;将视频翻译成英语并尽量保留原说话人声音特征;制作带中文旁白和字幕的电影解说视频;把写周报的屏幕录制变成 Skill.md 文件;把教程变成带关键截图、时间戳和分步说明的 PDF 笔记;为纪录片构建记录人物、对话、声音和重要事件的视听记忆。
Qwen3.8-Omni-Flash-Realtime 快速上手
API 使用
Qwen3.8-Omni-Flash-Realtime 支持 WebSocket 和 WebRTC 连接。运行基本示例会打开摄像头和麦克风,进行实时视听对话,建议使用耳机。示例初始化音频设备、创建会话、连接并配置会话,然后进入主循环处理音频和视频输入。摄像头以 1 fps、1280x720 采集,音频实时追加,模型可输出音频和文本。
Qwen-Live Harness
Qwen-Live Harness 是围绕 Qwen3.8-Omni-Flash-Realtime API 设计的综合开源框架。它可以通过一条命令安装并集成到主流智能体工作流,支持任务委派、主动交互、长期记忆和上下文管理,欢迎社区贡献。

图 2. Qwen-Live Harness 交互框架。
安装和启动:通过 npm 全局安装 qwen-live-harness,运行 qwen-live-harness init,然后运行 qwen-live-harness。
引用
Qwen Team,Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery.,https://qwen.ai/blog?id=qwen3.8-omni-flash,2026 年 9 月。
评论
社区对 Qwen 3.8 在音视频能力和成本上比肩甚至超越 Gemini Flash 表示惊喜,分歧主轴在于阿里云生态的封闭性、运行速度以及新基准框架的透明度。
认为 Qwen 3.8 在性能与成本上极具竞争力
- 用户指出其音视频接近 Gemini 3.8 Flash、音频超越,且输入输出价格仅约后者的十分之一,在性能无证据表明不及的情况下降本显著(较多人)。 > 若性能确实可比,Qwen 的输入输出定价仅为 Gemini 的零头,成本降幅惊人(@ache)
认为 Qwen 是稳健可靠但受限的实用模型
- 赞赏其对话正常、设计克制不过度活跃,并提供丰富尺寸便于实验极小模型;但批评速度慢、仅阿里云可用、免费额度吝啬,且担忧后续强化学习破坏调性(较多人)。 > 挑一个“老可靠无聊”的现代版 Claude 的话,我会选 Qwen,只希望别被强化学习练到报废(@conception)
质疑新基准测试框架的公开性与可复现性
- 多名用户发现官方宣称的新测试框架 GitHub 链接已失效或仓库被删,对性能声明的验证渠道存疑(少数人)。 > 他们新做的测试框架仓库好像已经被撤掉了(@lxe)