两个月前,我们发布首批盆景 27B(Bonsai 27B)模型,证明 27B 级多模态模型可压缩后本地高效运行。今天发布三元盆景 2 27B(Ternary Bonsai 2 27B)。它基于通义千问3.8 27B(Qwen3.8 27B),具备更强推理、编码、视觉与智能体能力,并保持更小内存占用、高本地吞吐、更好能效。模型采用三值权重与 FP16 分组缩放,每权重 1.76 有效比特,总占用 5.9GB,支持 262K token 上下文和多模态文本图像输入,以 Apache 2.0 许可发布。相比全精度版,小 9 倍以上,保留 98.2% 基准性能。
正文
两个月前我们发布了首款 Bonsai 27B 模型,证明 27B 级多模态模型可压缩到能在本地设备高效运行。今天发布 Ternary Bonsai 2 27B,是当前最强模型。
基于 Qwen3.8 27B,Ternary Bonsai 2 27B 带来更强推理、编程、视觉与智能体能力,同时保持其标志性部署特性:大幅缩小的内存占用、高本地吞吐与更好能效。
Ternary Bonsai 2 27B 采用三进制 {−1, 0, +1} 权重与 FP16 分组缩放,有效位每权重 1.76 位,总体积 5.9GB。低比特表示端到端应用于语言模型,支持 262K 上下文、多模态图文输入,以 Apache 2.0 许可发布。
相较全精度模型,体积缩小 9 倍以上,保留 98.2% 综合基准性能。此保留率下,压缩成为部署解锁:近乎同等能力,却能在更多地方运行。
与首次发布 Bonsai 27B 相比的变化
首款 Bonsai 27B 是重要里程碑,提供了在本地设备运行 27B 级智能的可行方式。Bonsai 2 27B 聚焦下一步:提升真实本地应用所需的模型质量与运行表现。相比前代,它带来:
- 更强的基座模型 Qwen3.8 27B
- 相较全精度模型综合性能保留率提高到 98.2%
- 推理、编程、视觉及长周期智能体性能提升
在相同部署条件下的更高能力
在涵盖推理、数学、编程、指令遵循、视觉与智能体工具使用的基准套件中,Ternary Bonsai 2 27B 得分 83.9,保留 Qwen3.8 27B 的 98.2% 综合性能。
| 能力 | Ternary Bonsai 2 27B | Qwen3.8 27B | Qwen3.6 27B | | --- | --- | --- | --- | | 智能体与工具调用 τ²-bench, BFCLv3 | 77.57 | 79.74 | 80.05 | | 编程 HumanEval+, LiveCodeBench v6, MBPP+, BigCodeBench | 81.58 | 82.17 | 82.57 | | 指令遵循 IFBench, IFEval | 82.66 | 81.25 | 74.53 | | 知识与推理 MMLU-Redux, GPQA Diamond, AA-LCR | 83.95 | 86.66 | 84.71 | | 数学 AIME 2026, AIME 2025, GSM8K, MATH-500 | 96.57 | 97.06 | 94.64 | | 视觉 CharXiv, A-OKVQA, OmniDocBench v1.6, RealWorldQA, OCRBench v2 | 78.59 | 81.64 | 79.82 | | 总体 | 83.9 | 85.4 | 83.6 |
图一: Ternary Bonsai 2 27B(思考模式)与全精度 Qwen3.8 27B 及 Qwen3.6 27B 基线基准分数对比。完整分项结果见白皮书。
关键不仅是总分,更在于能力保留的分布。编码代理、工具调用系统、多模态工作流和长周期任务对模型退化尤其敏感,小错误会逐步累积。Bonsai 2 27B 恰恰在这些领域保留了全精度模型的大部分性能,同时内存占用仅其零头。
相比全精度及其他低比特替代方案,Bonsai 2 27B 在智能密度上堪称异类。许多低比特方案需牺牲编码、视觉或智能体能力才可得以部署,而它同时将前沿推向更高能力与更低内存。
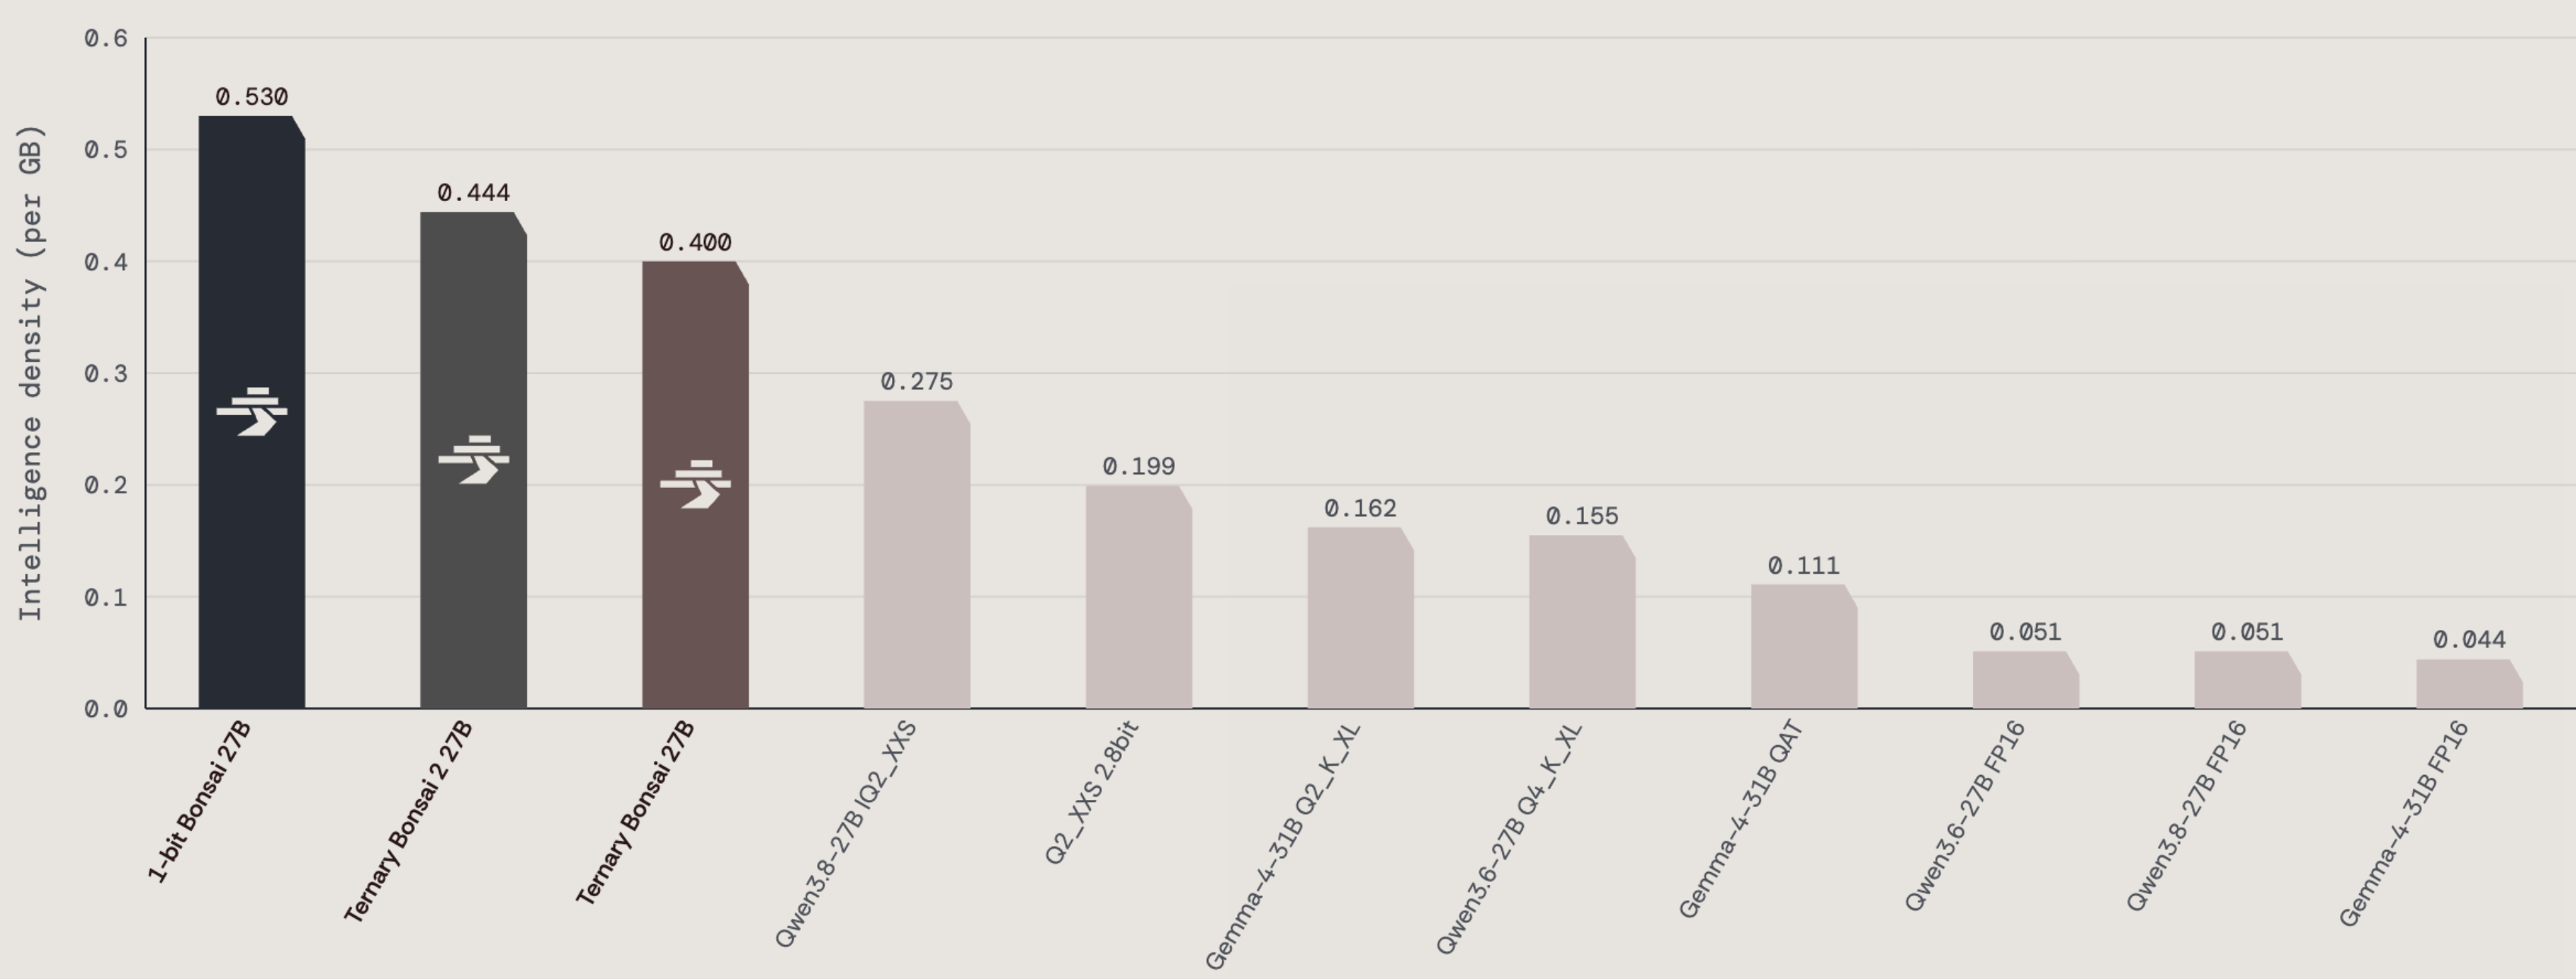
借助 Bonsai 2 27B,本地模型可开始承担真实知识工作:编码代理循环、电脑操作工作流、私有文档分析、多模态调试,以及混合编排——本地模型处理敏感或高频任务,有选择地上云。
吞吐量与能效
Ternary Bonsai 2 27B 在 NVIDIA GeForce RTX 5090 上达 143 tokens/秒,在 M5 Max 上达 46.8 tokens/秒。RTX 4090 上每 token 仅耗 0.714 mWh,比全精度 8B 模型能效高 40%。
对编程助手,高吞吐意味着更快编辑-调试循环;对多模态代理,意味着更快迭代截图、文档与工具调用;对私有本地工作流,更好能效意味同设备更多有用推理、更长电池续航,以及助手后台常驻而不必频调云端的现实路径。
此次发布为何重要
相较 Ternary Bonsai 27B,新模型将全精度保留差距从 95% 缩至 98% 以上,实质“无损”,进一步印证低比特模型是最佳部署方式。
影响远超本地推理。低比特模型可改变设备、工作站与数据中心的 AI 系统经济与架构:同内存容纳更大模型、同硬件服务更多用户、降低单次推理能耗,并实现动态决定本地或云的混合系统。
问题将越来越不只是模型多强,而是给定内存、算力和功耗预算下能交付多少有用智能。若能力持续提升而需求骤降,未来模型部署范围将自下而上扩展:从个人设备到大型数据中心。
平台覆盖
Bonsai 2 27B 通过定制低比特内核,在 NVIDIA GPU(CUDA)和苹果设备(Mac、iPhone、iPad,MLX)上运行。模型权重现已按 Apache 2.0 许可发布。
压缩、评估与基准测试完整技术细节见白皮书。
评论
社区对三元量化模型在消费级硬件上的运行能力普遍感到惊喜,但对极低比特量化的实际质量与官方对比解释的缺失存在质疑。
惊喜于消费级硬件与浏览器端的运行潜力
- 多数评论聚焦于新模型体积缩小后能跑在 16GB 显卡、苹果芯片甚至纯浏览器环境,认为这降低了本地部署门槛(较多人)。
- 有人实测在 M5 Pro 苹果芯片上借特定方案可达约 20-44 token/秒,但怀疑后端加速未完全生效(较多人)。
- 有人期待基于同系列推出手机端 8B 版本或单张 5090 可容纳的变体,甚至玩笑式畅想将 100B+ 模型压到 30GB 并改名 Topiary(少数人)。 > 模型小到可以完全在浏览器里跑,但处理长任务时会以有趣的方式彻底崩掉(@Aurornis)
质疑极低比特量化的质量与对比透明度
- 有读者指出三元权重有效位仅 1.76,而此前经验显示 2.6 bpw 的 Q2 量化已近不可用边缘,批评官方未与常规量化做公平对比或解释技术诀窍(较多人)。 > 此前帖子表明同类底模的 Q2 量化已介于明显变糟和无用之间,没看到他们解释特殊配方在哪(@adrian17)
对模型实际表现谨慎乐观
- 有人认为上一代世界知识弱,但此代底模偏重推理,弱点可能被规避(少数人)。 > 一代世界知识明显弱,但 3.8 底模本就重推理轻知识,所以影响或许不大(@Havoc)
反感“倍数更小”的不严谨表述
- 有用户纠正“几倍小”的说法不合数学逻辑,应为原模型是其九倍大,呼吁社区停止此类反直觉用语(少数人)。 > 用大于一的数乘出更小量是荒谬的,应该说原模型比新模型大九倍(@miffy900)
有价值的补充
- 运行 Prism 发布的 GGUF 文件必须使用其定制的 llama.cpp 分支,原版不兼容。
- 该三元模型权重并非零偏移,因此不适用于前一日讨论的进一步压缩方案。
- 若需纯浏览器体验,务必在试用后清理下载的权重以释放空间。
- 有用户询问此方案与 Unsloth 量化版本的性能差异,尚未得到解答。