深度求索V4.1 Flash(DeepSeek-V4.1 Flash)发布时作者以为只是后训练迭代,用后速度近420 Tokens/s,崔(Cui)称DeepSeek-V4 Pro将下线,颇感事大。技术报告出炉才觉应称DeepSeek-V5 Flash。论文标题表明其意在将KVCache压缩推至极致,因长程Agent工作流令上下文增长、工具调用致prefill压力大,KVCache于HBM与外部SSD存储高致无法Scaling,遂做架构优化重在压缩与Prefill计算。
正文
摘要
DeepSeek-V4.1 Flash发布时,曾以为只是后训练迭代版本,实际使用中发现速度接近420 Tokens/s,随后得知DeepSeek-V4 Pro模型将全部下线,直到技术报告《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》完全发布,才意识到它应该被称为DeepSeek-V5 Flash。
正如论文标题所示,该模型目的是将KVCache压缩推至极致。主要原因是长程Agent工作流使上下文越来越长,各种工具调用带来巨大prefill计算压力,HBM和外置SSD中KVCache的存储压力极高,导致无法扩展。因此在模型架构上做了一系列优化,尤其是KVCache压缩和Prefill计算优化。
- Prefill计算优化:借鉴YOCO,整个模型40层,Prefill只需20层,因此Prefill激活参数仅8B,Decode激活参数16B。
- KVCache压缩:工程上分为多个维度:类似GQA的头数压缩、类似CSA的块压缩、本文CSA2的跨层压缩,同时优化Sparse Attention的indexer计算,以及数值精度优化如FP4 KVCache。
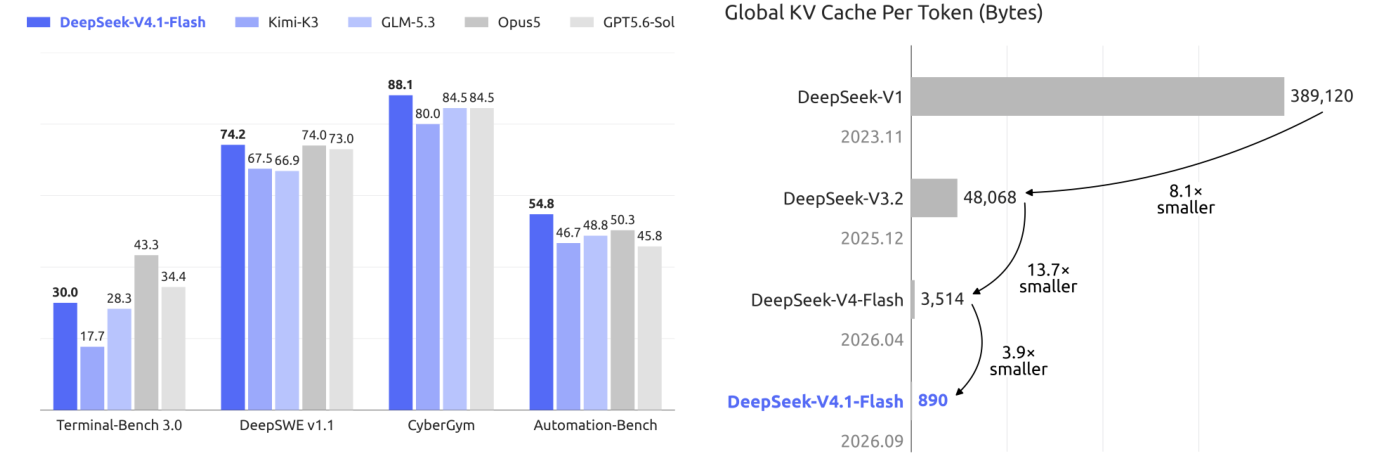
最终在保持模型高质量任务完成的前提下,KVCache进一步压缩4倍:
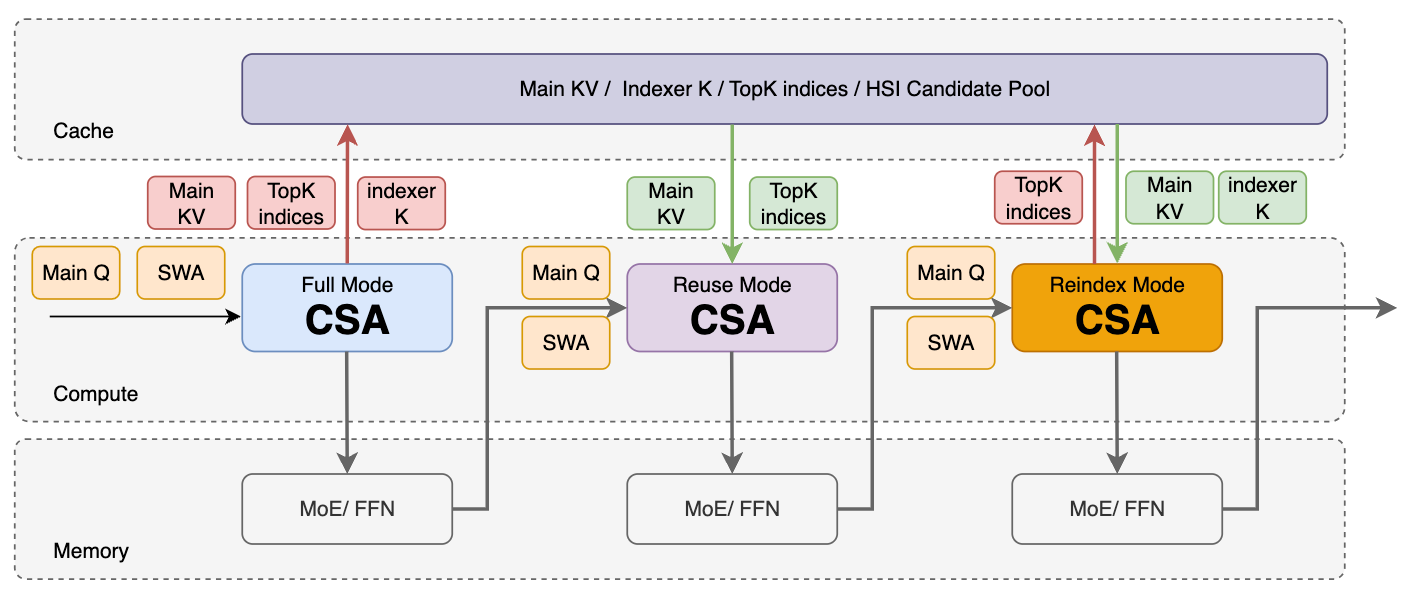
此外,论文原文对CED的描述较复杂,若以KVCache为中心结合计算机架构视角重绘图,则一目了然。它可视为一种递归Transformer架构,在递归过程中修改Q并复用KV。
接下来按技术报告章节详细解读,本文为系列第一篇,分析模型架构,关键内容在第3章。
1. 概述
1.1 为何需要KVCache压缩
近年来长程Agent使超长上下文处理成为重要负载。支持此类负载需高效处理长序列,并持久存储、复用、传输大型KVCache,这带来计算、存储、通信挑战。DeepSeek-V4架构结合全上下文Sparse Attention与局部窗口SWA,虽降低了长序列计算成本,但持久存储和数据移动成为瓶颈。长上下文中Global KV Cache占主导,为前缀复用持久化,重度占用主机内存和SSD容量,并对互联带宽要求高,限制服务吞吐,增加部署成本。
因此进一步降低KV缓存占用对缓解瓶颈至关重要。DeepSeek-V4.1-Flash是为更激进KVCache压缩设计的多模态混合专家模型,参数规模552B,原生支持多模态输入,上下文最长100万token。采用因果编码器-解码器(CED)架构,解码器的Global KVCache由编码器的最后隐藏状态投影得到。该设计使模型在Prefill阶段每token激活8B参数,Decode阶段16B,对输入主导的Agent场景尤其划算。虽模型远大于V4-Flash,同等序列长度下,其运行时KVCache存储仅后者的约1/4,持久化KVCache仅约1/8,且整体性能更优。
这些压缩来自模型架构、缓存精度、部署策略的联合优化。基于以SWA为骨干、CSA/HCA增强的DSv4,团队放弃类似HCA的块高压缩比结构,优化CSA形成CSA2,从三个维度压缩KV Cache: - 通道维度:用512维潜向量共享各注意力头所需的key和value表示; - 序列维度:编码器通过通道学习权重将2个相邻位置合并为1个缓存条目,解码器保留逐位置条目; - 层维度:多层共享同一global KV,全网络仅保留3份Encoder缓存和1份Decoder缓存。
结合FP4量化,每token的global main KV和Indexer存储增长约890字节。
1.2 模型架构概览
整体模型架构如下:
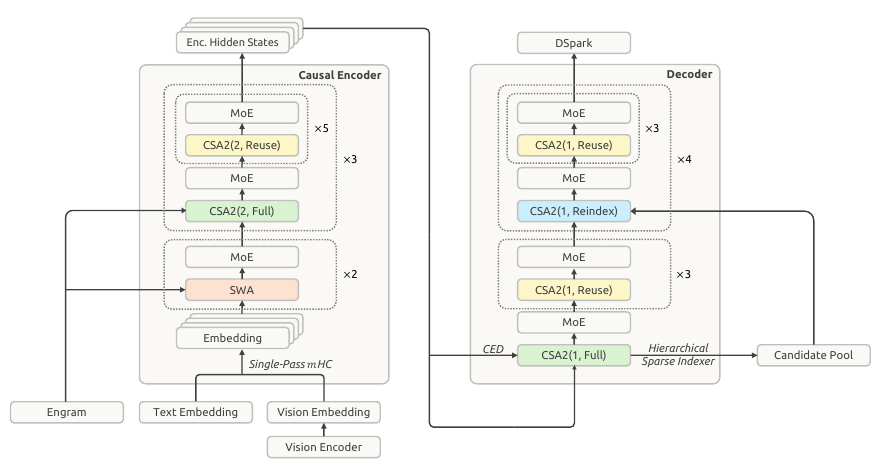
论文称主干参数约,Engram参数约,prefill和decode每token激活参数分别约和。核心是用CED减少长上下文Prefill计算,CSA2减少注意力和KV缓存开销,并结合Engram条件记忆与DSpark投机解码。
模型总层数,隐藏维度,词表大小。每层含注意力和MoE,通过mHC残差连接组织。注意力分Encoder和Decoder两模块,形成CED架构。关键为解码器global KV来自编码器末端表示,后续解码器层共享这些KV,因此长提示大部分位置只需经过前20层。
CSA2采用局部滑动窗口+全局稀疏检索+跨层KVCache复用机制。滑动窗口大小128,注意力用Q头,共享维KV潜变量,其中RoPE维、NoPE维。Q用秩为的低压投影,输出投影分组成,每组秩。相关参数:隐藏维度5120,总层40(前20 Encoder后20 Decoder),MTP层3(DSpark三SWA-128块),词表129280,头数64,headdim 512,ropeheaddim 64,qlorarank 1280,olorarank/ogroups 1024/8,windowsize 128。CSA2 compressratios [0,0, 2×18, 1×20, 0,0,0](Encoder层压缩比2,Decoder层1),kvsourcelayers [2,8,14,20],indexsourcelayers [2,8,14,20,24,28,32,36],indexnheads/indexheaddim 32/128,indextopk 512,candidatesourcelayer 20,candidatetopkblocks/candidateblocksize 2048/8。RoPE原序列长65536,factor 16,theta 10000/160000。MoE 384专家激活6,moeinterdim 2304,scorefunc sqrtsoftplus。mHC hcmult 4,hcsinkhorniters 20。Engram层[1,14],两张表行数约3.84亿,maxngramsize 4/heads 8,headdim 256,vocab 16M。DSpark blocksize 5,targetlayer [37,38,39],专家128。视觉ViT 32层 dim1024,patch14,downsampleratio 3(9倍token减),maxtoken 1024。
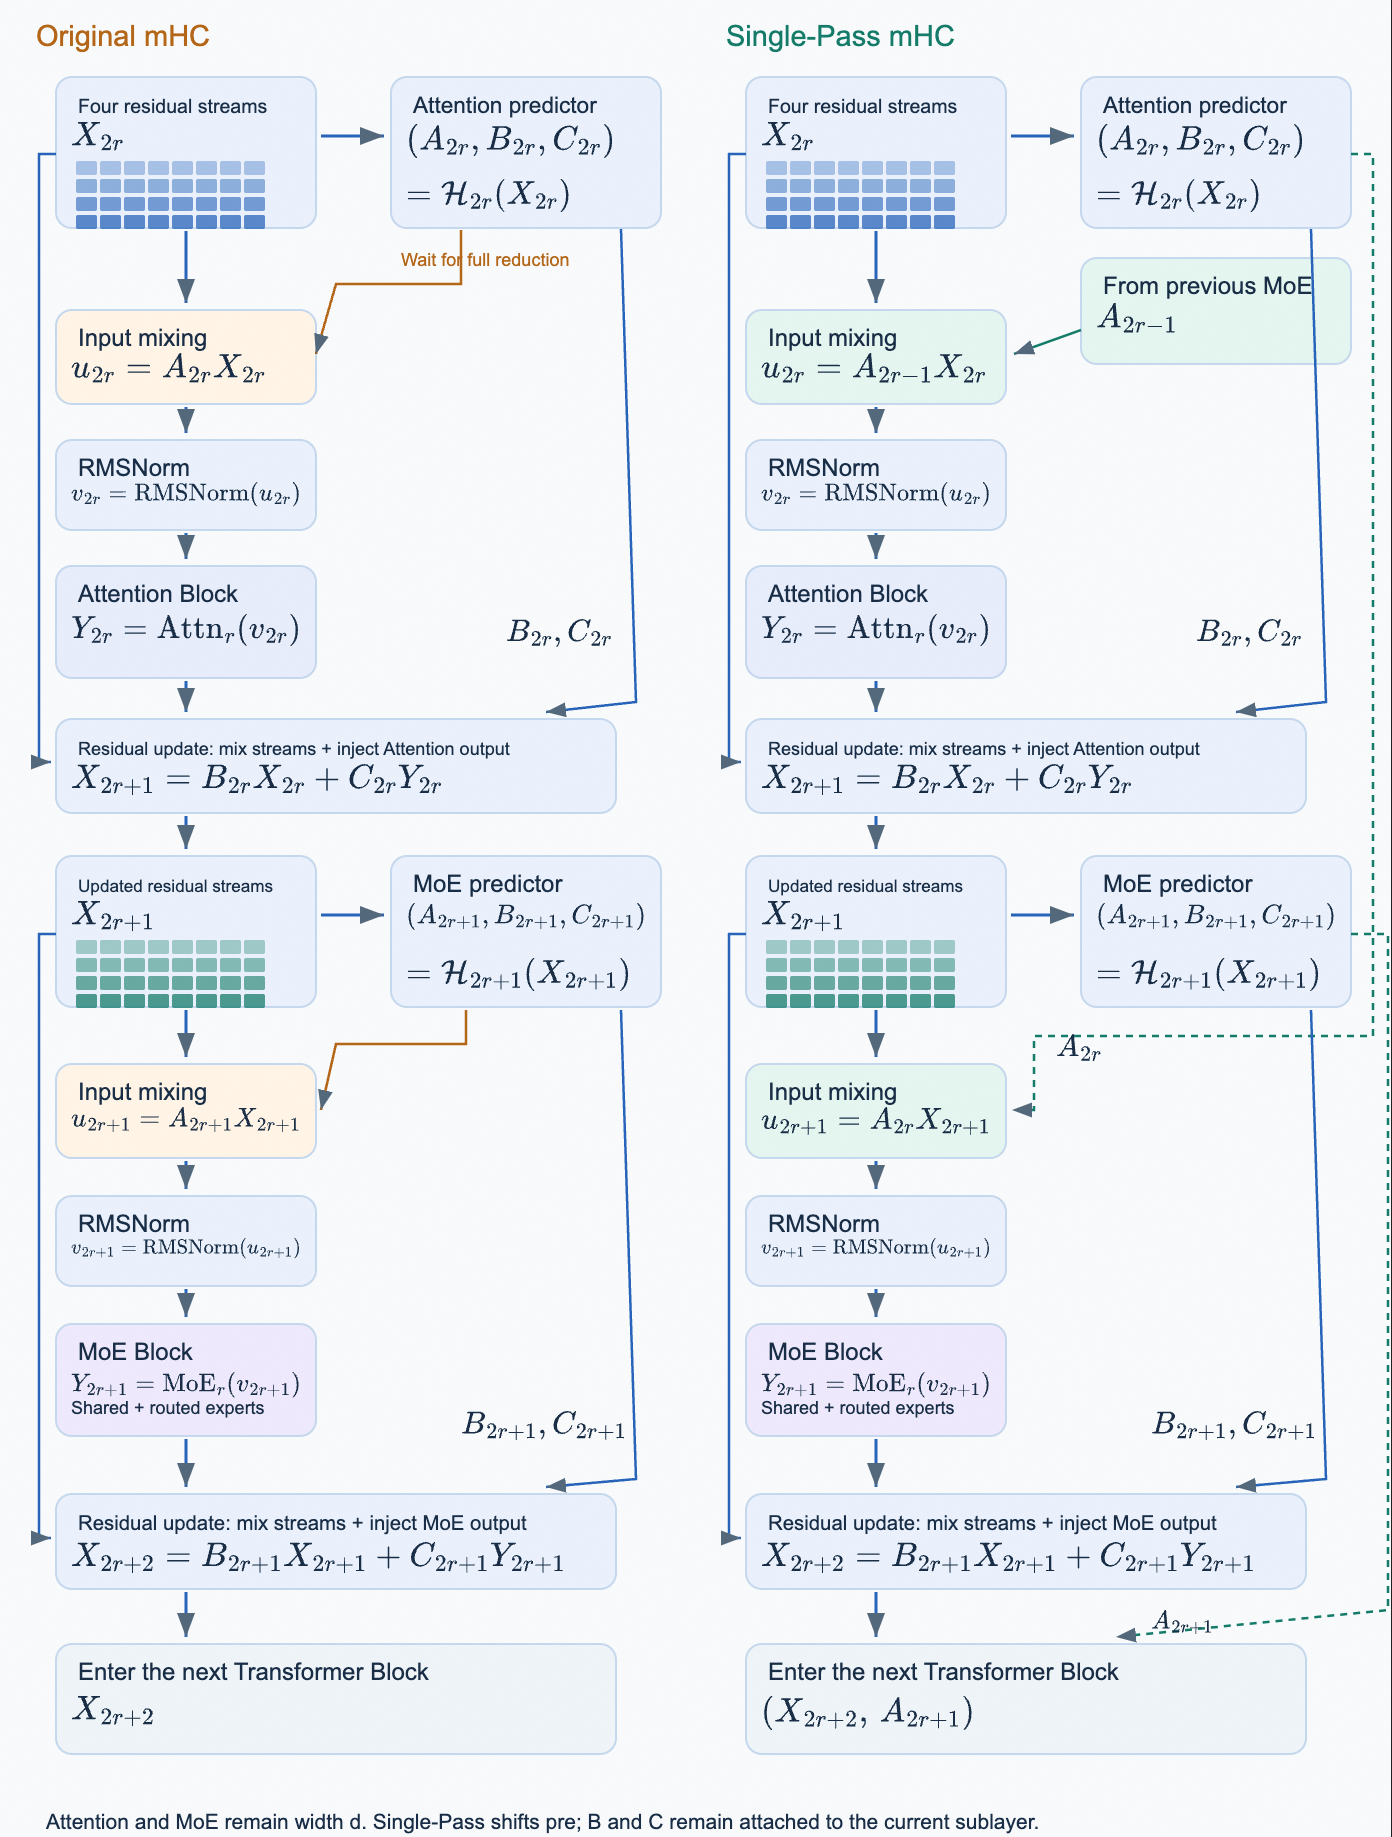
其中: - mHC:每token维护残差流,通过Sinkhorn迭代约束近似双随机矩阵。Single-Pass用前子层产生的输入混合系数释放依赖,利于核融合。 - DSpark:额外SWA-128草稿块,每层小MoE(128专家Top-3),读主干层入口4残差流均值,并行算草稿位置,配合Markov头与置信头。 - 视觉分支:ViT处理后经pixel-unshuffle降为1/9 token,MLP映射插入文本,单图最多1024视觉token。
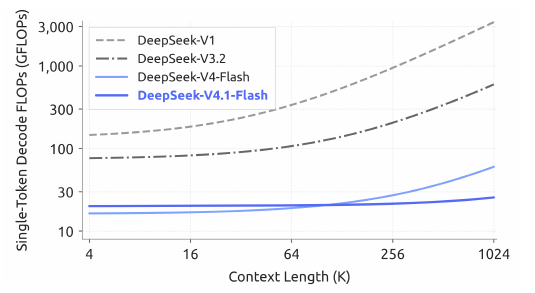
关于CED和CSA2第2章详述。随Context增长,DeepSeek V4.1 Flash计算在1M内近乎线性增长,开销远小于前代。
2. 模型架构
2.1 多模态架构
视觉路径:细粒度patch网格编码,相邻特征重排为更少宽向量,投影入语言主干。visionpatchsize=14,visiondownsampleratio=3。
处理流程如下图,ViT在高分辨率特征上完成图像内交互,经空间重排压缩投影送入LLM。
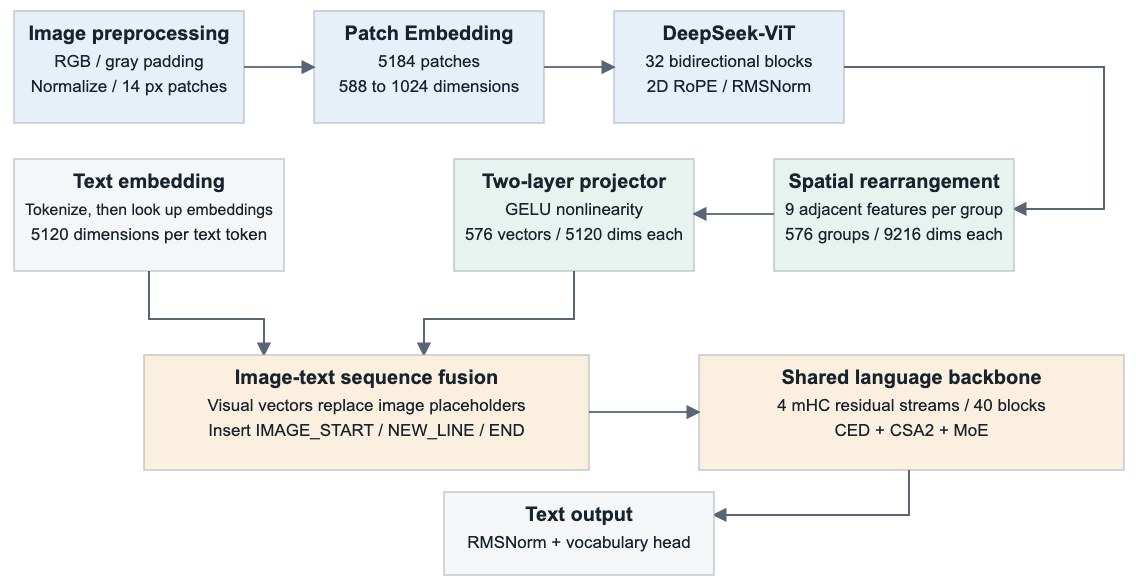
以1008x1008图为例:预处理保留2D布局;分块;线性投影;32层ViT双向处理保留所有patch;空间重排非重叠分组;两层MLP投影;插入行列分隔符;与文本交织;mHC扩4残差流;40层CED/CSA2/MoE输出。
图像预处理不做事OCR,直接RGB解码,小图缩放,对齐14倍数并灰填充,检查不超1024 token预算。视觉网格token数受visionmaxn_token=1024约束,如1344x1344图会缩放到约994 token。常见屏幕分辨率缩到968 token。归一化后分块。
Patch Embedding:块内像素平铺共享线性层,为兼容Muon优化器替换卷积。
DeepSeek-ViT:32层,RMSNorm+注意力+SwiGLU,末层RMSNorm。注意力16头每头64维,2D RoPE旋QK不旋V。
空间重排:9相邻特征载同一宽向量,3x3下采样。
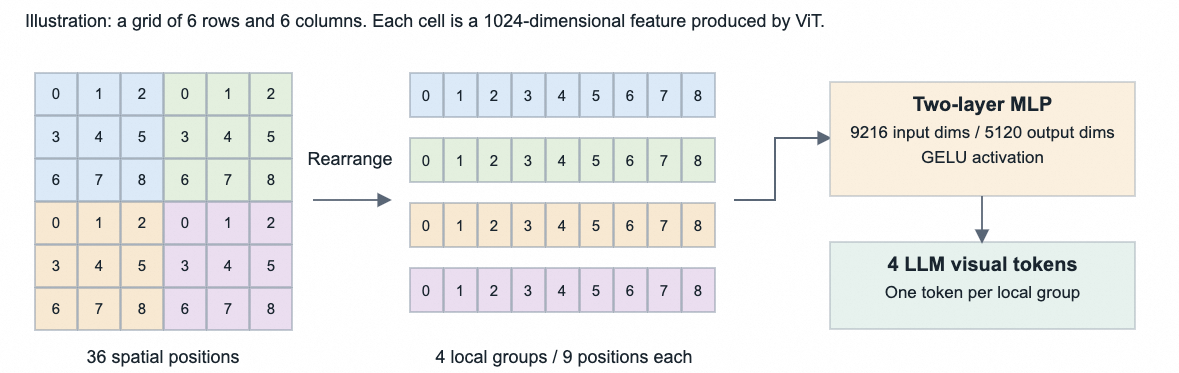
2层MLP对齐隐藏维5120。图像token跨度内补标记:
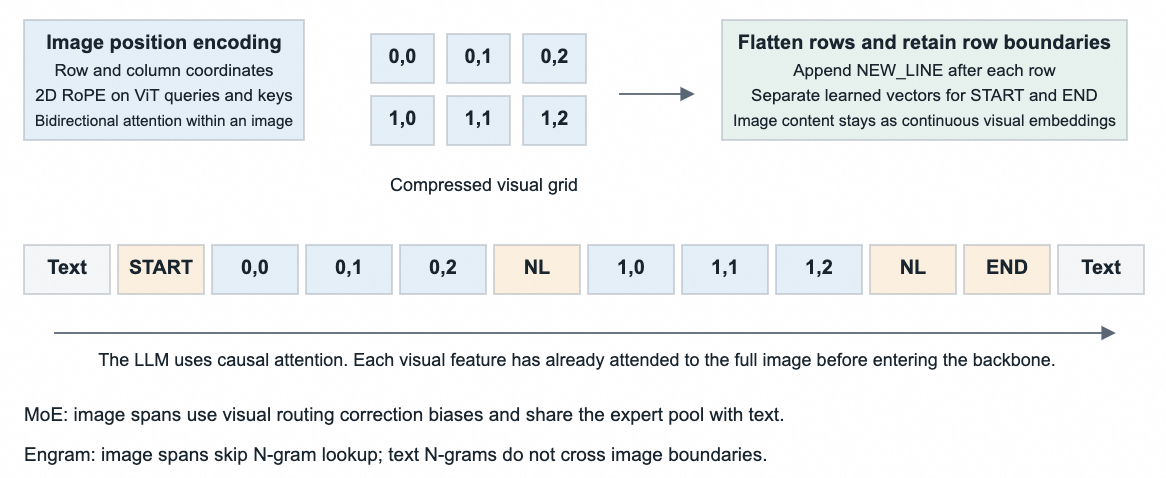
送入主干后,有多模态MoE无辅助损失负载均衡:为文本和图像token分别维护每专家修正偏置,路由用对应模态偏置,保留原分数加权和,步后独立更新,平衡各模态内专家使用。
2.2 因果编码器-解码器(CED)
2.2.1 为何需要CED
Agent工作流频繁工具调用产生大量prefill请求,KV Cache未命中时计算开销重。
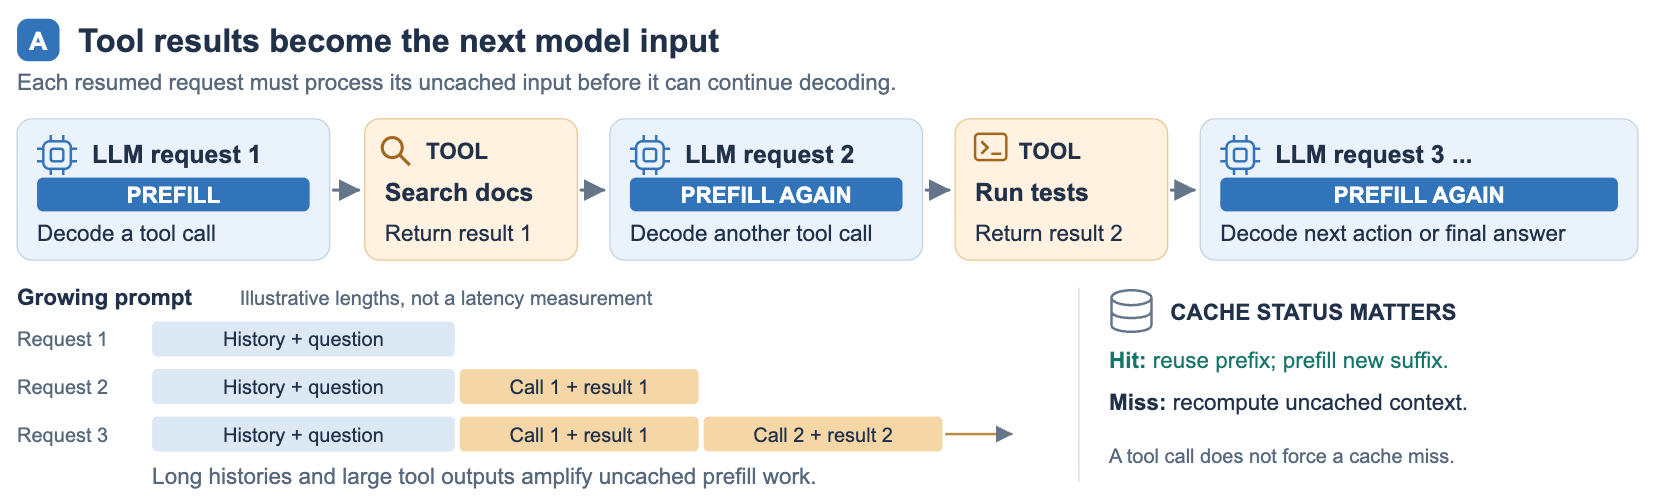
作者提出受YoCo启发的CED。YoCo让上半层直接共享下半层产生的KV Cache减少prefill计算。
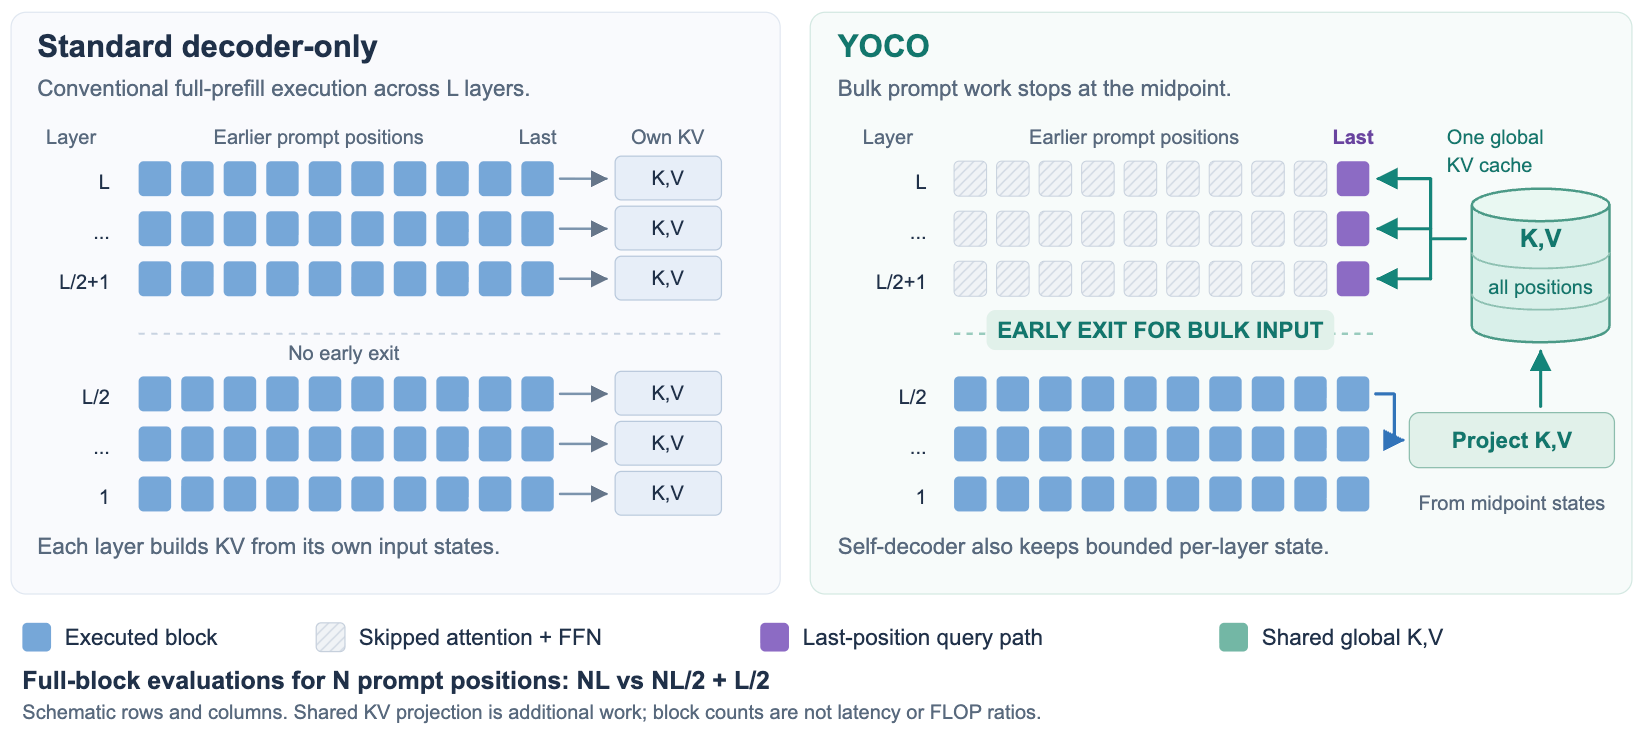
YoCo分离历史记忆生产与消费:下半建记忆,上半读记忆不再存逐层KV。
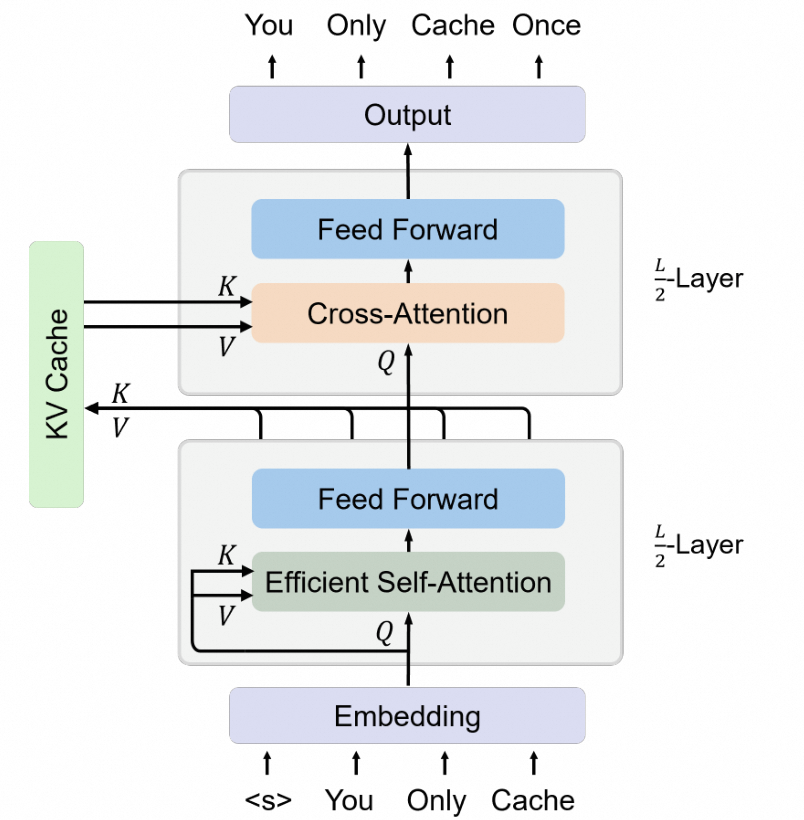
Decoder-Only每层的KV计算是低效根因。SWA每层和KV;拆分模型前半ESA产global KV后半标准Attn读;最终YoCo后半KV从第层隐藏态投影。类似KV-Mirror有腾讯WeLM等。
2.2.2 CED具体实现
CED在YoCo上改进,增加KV Cache总容量和生成计算深度,prefill计算减半且性能持平。
全局注意力中,CED将底层Transformer作因果编码器,上层(解码器)KV不直接来自自身隐藏态,而是由第层隐藏态经层依赖投影权重得到。这使得prefill只需算前半层即得上层global KV。
CED分Causal-Encoder和Decoder各20层。YoCo称Self/Cross-Decoder。CED前半高效自注意力,后半用自身Q读前半共享KV。CED前半两层SWA,后18层CSA2(结合SWA的压缩稀疏注意力),Global KV来自Sparse Attention,Local KV来自SWA,拼接与Q算分。
SWA在所有层保持逐层计算:任一层local KV直接来自当前层隐藏态,增加local KV生成计算深度,但需SWA重放:prefill阶段Decoder算SWA KV需额外处理token(窗口大小)。多轮短prompt时开销不可忽略。据前人SWA有效感受野远小于理论值,引入Decoder SWA有界重放:仅算prefill提示最后个token的SWA。
- 为何SWA增加local KV生成计算深度?全局KV来自编码器边界表示,后续层加不同Q但不改历史全局KV源;而每层加基于SWA的local KV保留“每层从自身输入生成KV”路径,这些近期位置KV含更深计算。
- 为何需有界重放?CED早退prefill后历史位置未过Decoder,缺深层Local KV。SWA仅存最近位置,但深层表示依赖窗外语序,精确恢复需回溯约。若每工具调用仅加几十词却需数千位置过Decoder,省下的计算被重放消耗。据PowerAttention约2K窗6层后信息衰减弱,故仅重放最后位置近似恢复。
- 为何重要?Agent多轮中新内容短,但精确恢复跨度不随新增长度缩。有界重放限制为最近位置过Decoder。
总体序列长,CED将prefill复杂度从降至,近乎减半。冷启prefill编码器处理所有位置,解码器仅尾位置,主工作量为,对比全计算,时比近。如提示长,全计算约token层,CED约其。
2.3 CSA2
2.3.1 为何需要CSA2
长上下文服务需控KV存储和注意力计算,可沿三个乘法关系维度降: - 条目大小维:GQA减KV头,MLA共享潜表示 - 序列维:每token压一entry,如CSA/HCA - 层维:某些层复用他层缓存和选择结果
层维工作有CLA、IndexCache、YOIO、HySparse等,但仅复用索引不省主KV,全层共享路由限性能,混合仍保留全注意力,均未覆盖三维。
DeepSeek过往:MLA压条目大小;V3.2 DSA减注意力计算;V4加序列维CSA(4:1)/HCA(128:1);CSA2推至层维。CSA2联合三维:跨层共享主KV和Indexer K,层复用Top-K索引,解耦缓存共享与索引复用,结合简化压缩器和分层稀疏Indexer。
与CSA细微差:CSA2轻量Indexer用Q/K评主KV选TopK,每Q同时注选定entry和层内SWA KV。Compressor含压缩比1(不压Main KV供Decoder)。Causal-Encoder压比减entry数;Decoder用1保留逐token寻址,结合CED跨层共享不存独立长序列主KV,腾出空间细粒度。CSA2简化Compressor/Indexer:去重叠和绝对位置嵌入;Indexer K由主KV投影得,替CSA从隐藏态独立压缩。
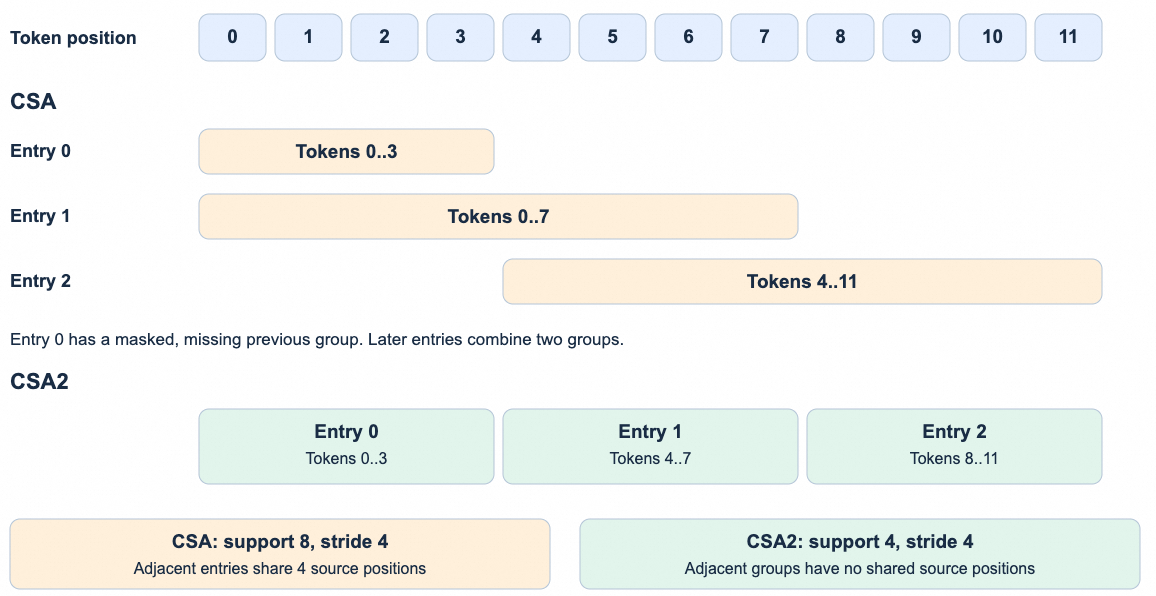
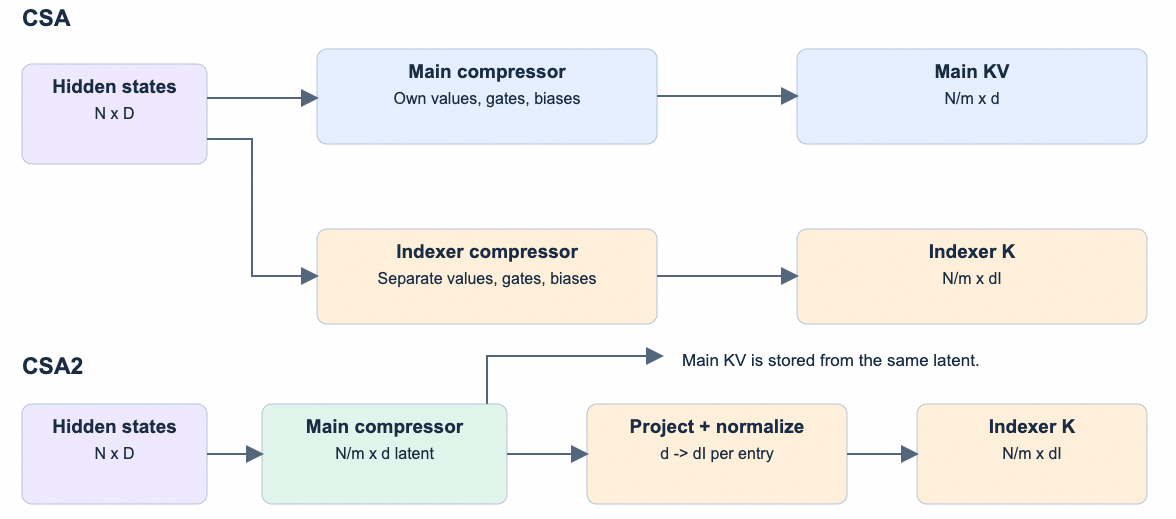
2.3.2 跨层KV和索引复用
CSA2在CSA基础加层维数据复用。从计算机架构看,注意力块为计算组件,MoE/FFN存储,KV相关为缓存,跨层复用即数据局部性处理。
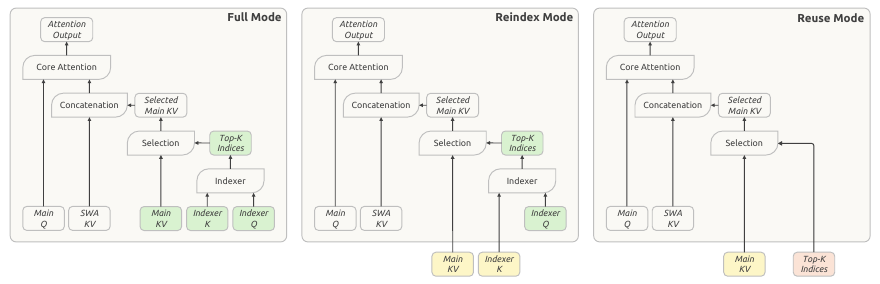
三模式: - Full模式:本层算主KV、Indexer Q,投影得Indexer K跑Indexer产新TopK,执行完整CSA2。 - Reindex模式:复用近期主KV和Indexer K,算自身Indexer Q重评分产新TopK,稀疏选择层间变而主KV/Indexer K共享。 - Reuse模式:复用近期主KV和最新TopK,不算Indexer Q,执行注意力。
共享主KV/Indexer K减存储,复用TopK免额外Indexer计算。Reindex允选择层间变。
2.3.3 CED与CSA2结合
Causal-Encoder:2层标准SWA块+三宏Encoder块,Engram注入第二SWA块前和最后Encoder块前。
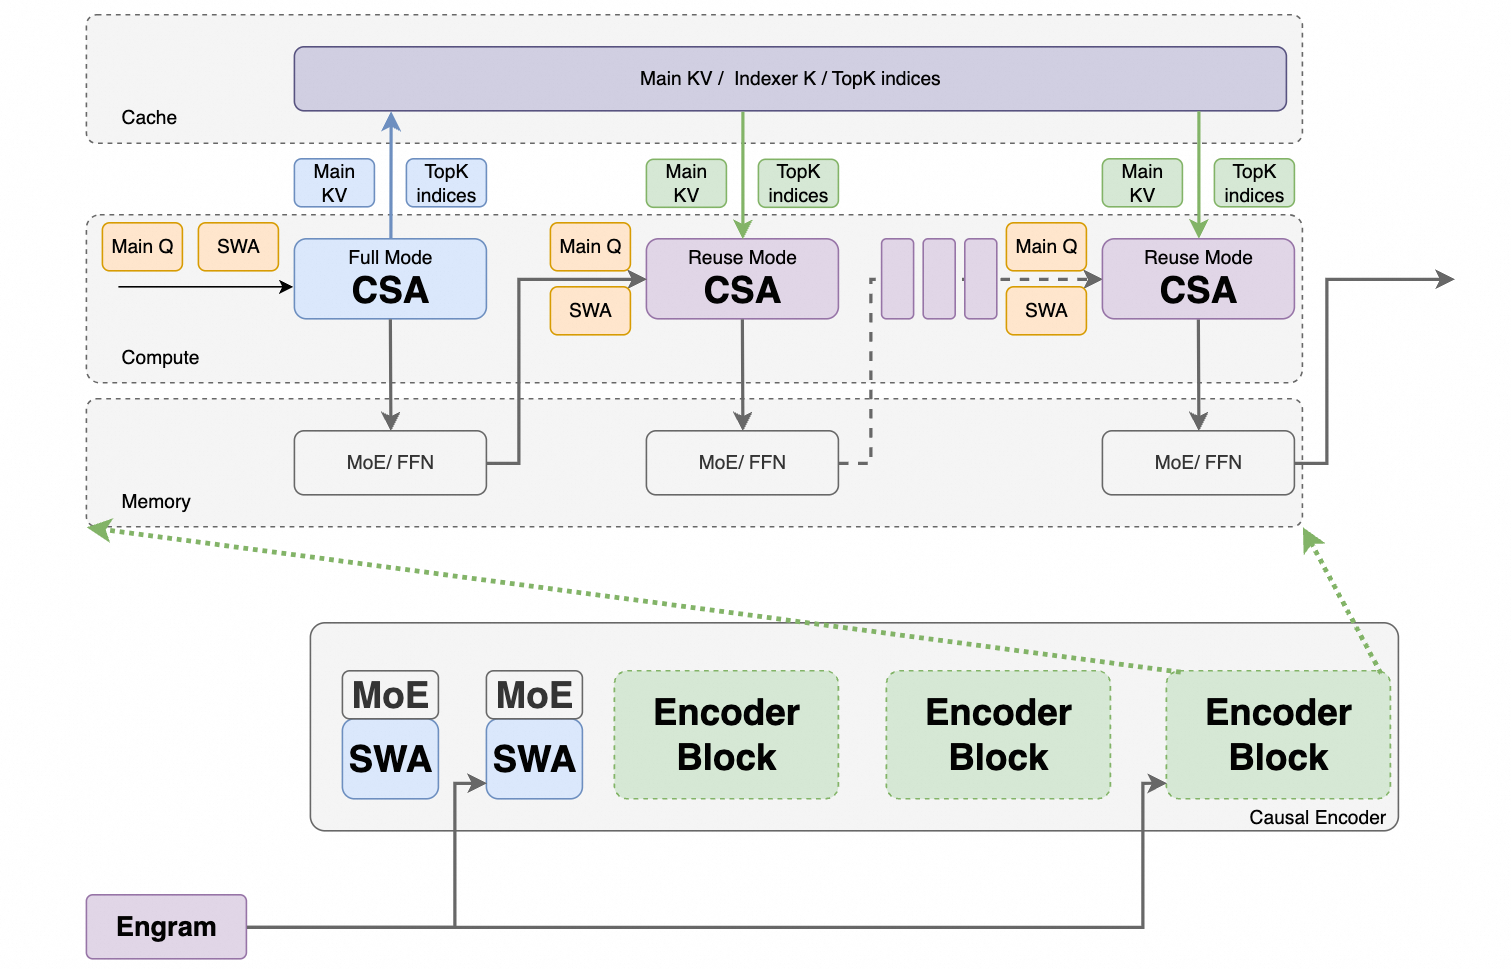
Encoder块为6层结构,首层Full模式CSA2,后5层Reuse模式CSA2。可视为通过每层改Q实现的递归Transformer结构。
- 为何1层Full+5层Reuse为整体块?首层Full写主KV和TopK,后5层Reuse全复用,仅改Q。
- 前两层SWA+Engram作用:首层SWA提供局部上下文,Engram注入短模式记忆,二层整合二者。首层SWA窗,读位置集;Engram读2-4-gram哈希查表编码短语规律,受首层SWA上下文门控;二层SWA读增强表示,整合局部信息,感受野扩至。故CSA2从第三层输入含token嵌入/两层局部计算/Engram记忆。
Decoder看为5 Decoder块:
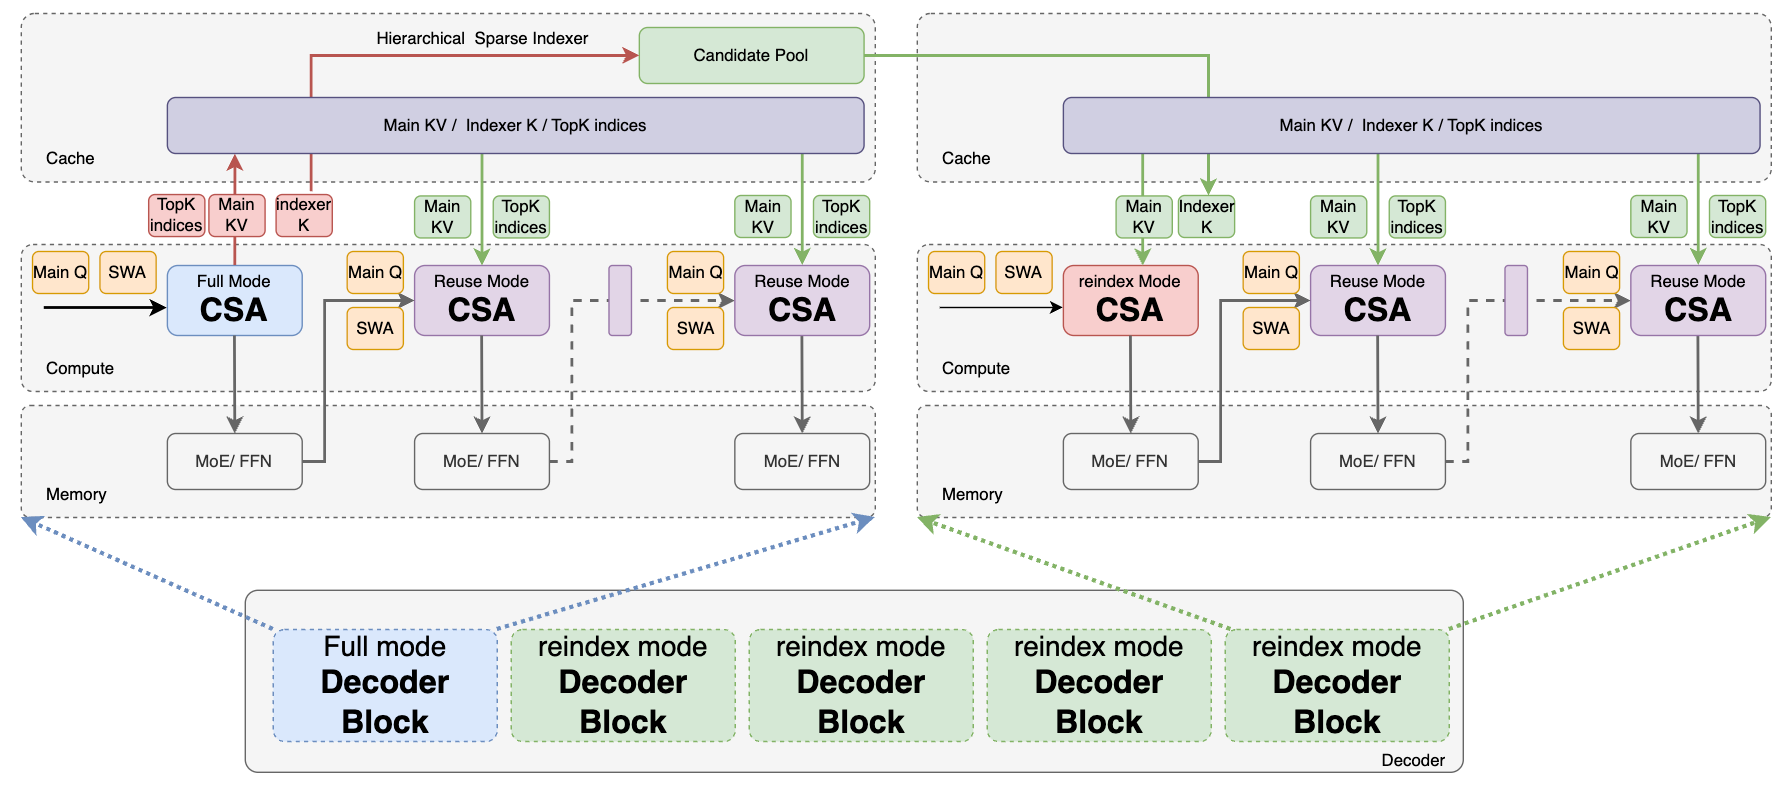
首块首CSA2为Full模式(Full Mode Decoder Block),后4块Reindex模式。Decoder所有CSA2压缩比1,仅用Reindex。Full层算自身主KV/Indexer K/TopK,引分层稀疏Indexer(HSI)建块级候选池供后续Reindex。Reindex块内首层Reindex CSA2算自身Indexer Q在候选池选TopK。
2.3.4 分层稀疏索引器(HSI)
跨层索引复用减Indexer评估,但剩余仍须评所有可见上下文。HISA用块粗滤+token细滤。
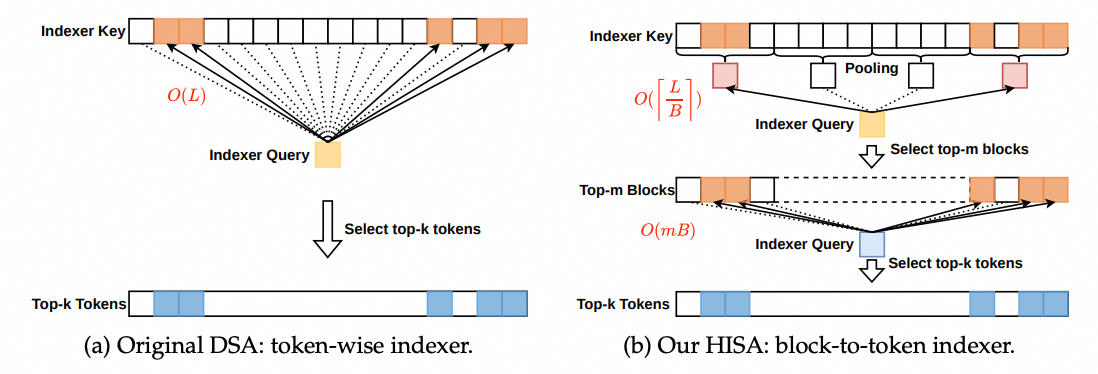
分块约,第块,块数。块维持Indexer均值作辅助。阶段一评分块均值留高分的展开候选集;阶段二算原分选最终。
DeepSeek发现Decoder浅层Indexer信息可限深层的候选,引HSI仅用于CED解码器。Full模式层建候选池为后续搜索域,池大小固定时每层每查询成本与上下文长无关为常数。该机制训练感知,后训练引入:训练推理候选限制同。
HSI原理:Full CSA2评所有可见主KV位置产自身TopK;同时块级选:每块取内部位置最大索引分,选最高分若干块,收集位置成大于最终TopK的候选池(如2048块x8=16384位)。后续Reindex仅评候选位选自身TopK;Reuse不新索引。与HISA不同在HSI从浅层完整分取块最大,后续共享,且避均值稀释。
Full层产候选池:candidateblocksize=8,candidatetopkblocks=2048,topk=512。首层算全分,块最大归约选块,含最新可见位块强制选。扩为位图成候选池。论文称训练感知但未披露后训练法。推测用混合损失使深层Indexer在限制域学。
2.4 高效架构扩展
2.4.1 单通mHC
mHC维持残差流。
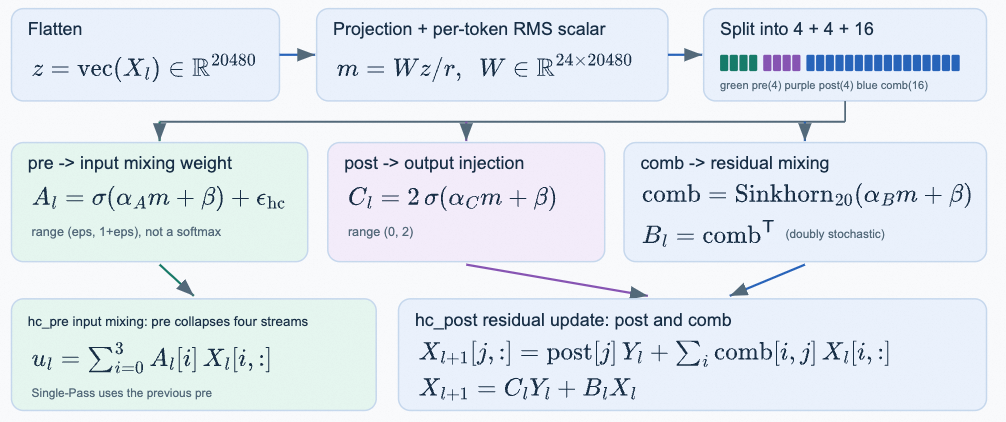
每token流由系数更新,原计算有依赖。Single-Pass mHC将输入混合系数移前一块,用前块产系数消依赖:
2.4.2 Engram
DeepSeek-V4.1-Flash中n-gram扩至{2,3,4}略去短因果卷积,用动量更新与Sinkhorn平衡。
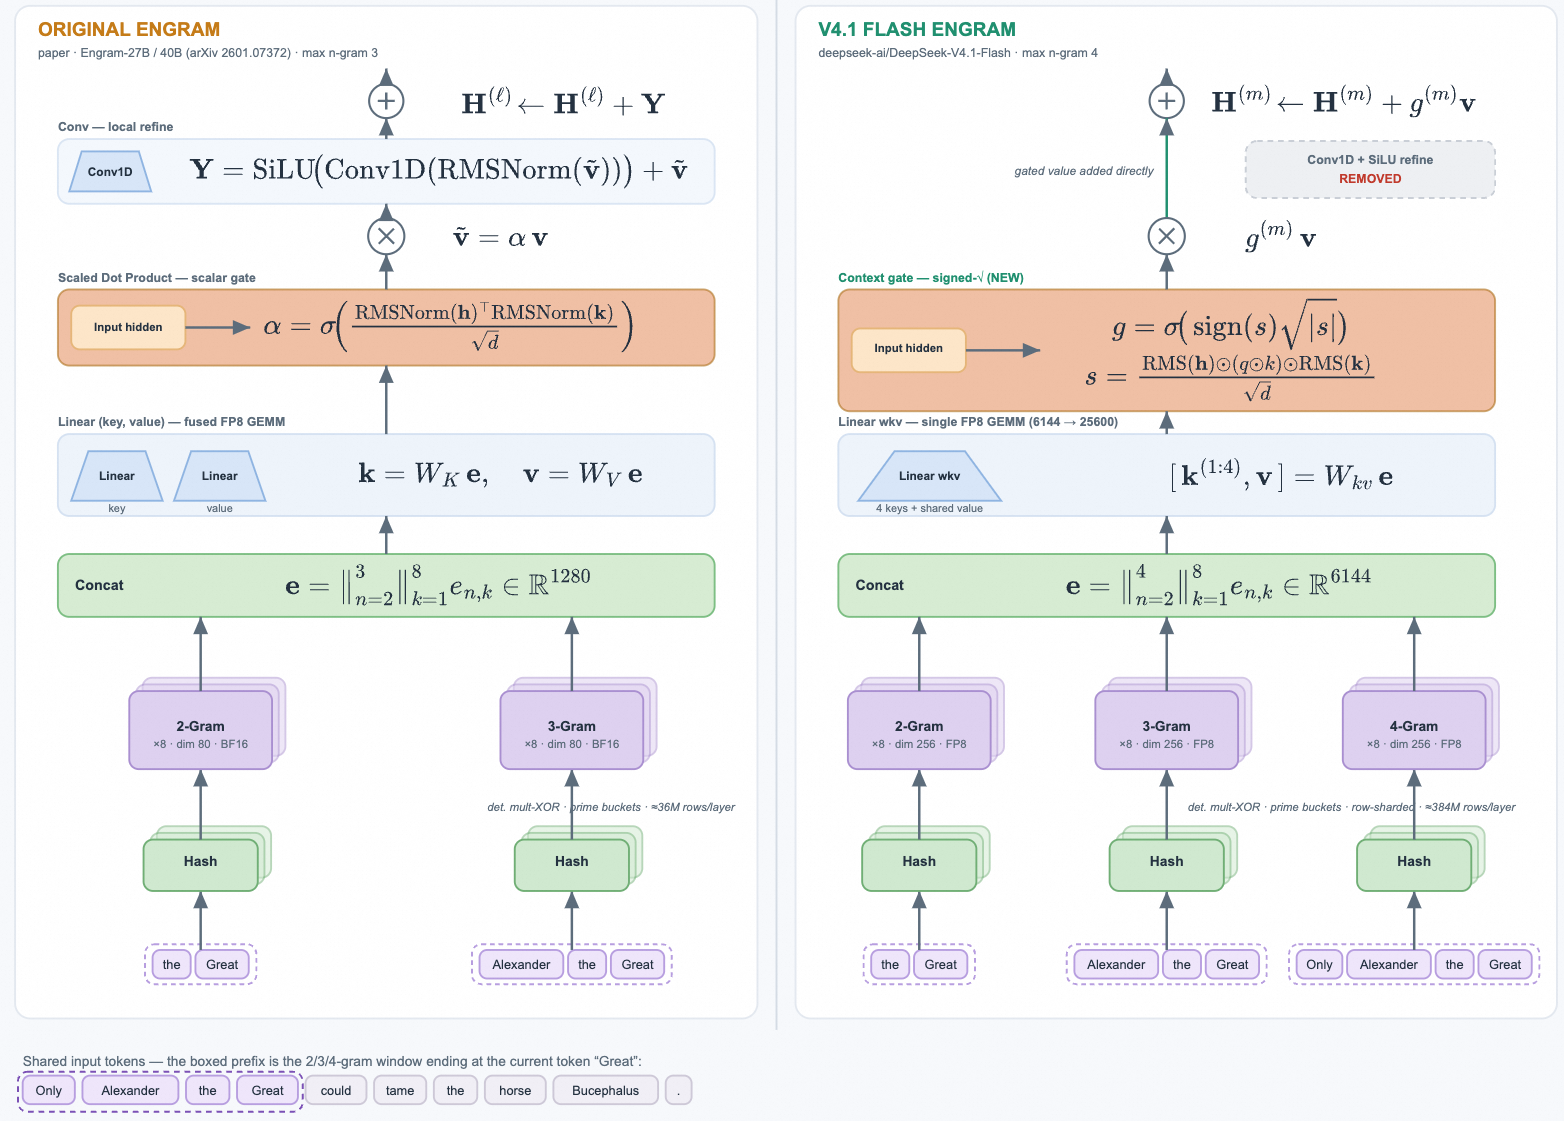
196B Engram参数分两模块,每层N-gram阶{2,3,4}各8哈希头总维2048,每头索引约16M表,FP8精度。置于层1和14,推理时确定性寻址经后台RDMA预取,首模块预取与首Transformer块计算重叠。
2.4.3 DSpark
草稿模型三Transformer块,滑动窗128,一次前算5草稿位基础分,轻量Markov头模依赖。专用阶段引,仅训DSpark冻主干;后训练连同主干但梯度不传主干,加速推理与RL/OPD轨迹生成。
2.4.4 FP4主KV缓存
DeepSeek-V4已用QAT于FP4 Indexer Q/K。此处主KV用FP4,采OCP MXFP4格式减存储非加速矩阵乘,注意前反量化为精格式。
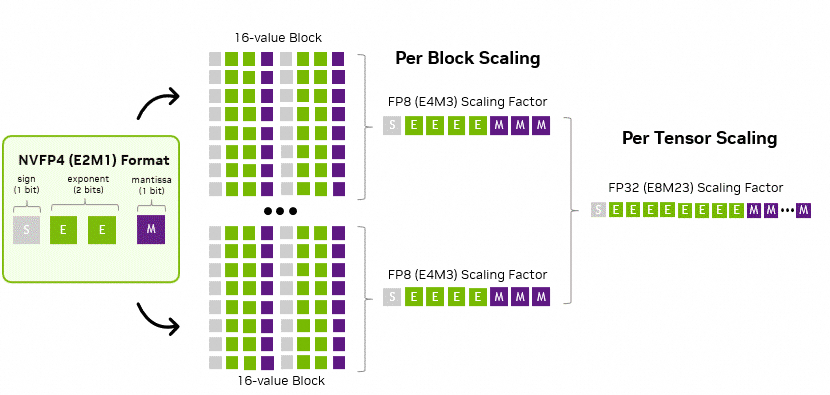
选E2M1,每16通道享E4M3缩放因子,略去二级全局缩放 simplified。主KV动态范围够(最大量级远高缓存),训练最大RMSNorm权约1,KV潜变量L2范数约,RoPE保范数,量化无测精度降。后训练引QAT,RoPE与非RoPE同格式,KV缓存量化为RoPE后。SWA KV敏感留FP8。较V4 FP8主KV,HBM和SSD存储均近减半。
3. 为何能省KV
3.1 为何KV是890B
优化分:FP4主KV省半,CED减prefill计算,关键CSA2跨层共享(Reuse/Reindex全复用Full主KV)。
每layer两类KV状态:Global KV(main KV MLA潜向量+indexer K),Local KV(SWA最近窗)。HBM驻Global KV。参数:层40,main KV通道512,indexer K通道128,SWA窗128,源层如[2,8,14,20]等,压比Encoder2/Decoder1。FP4量化,单entry字节=(负载+scale)。Main KV entry(512ch): 288B;Index K(128ch): 68B。压比层每token存bytes/entry*1/ratio。源层Encoder(2,8,14)比2,Decoder(20)比1。
| 模块 | 层 | 贡献 | 每token字节 | | --- | --- | --- | --- | | Encoder 2,8,14 Main KV | 2 | 288 | 432 | | Encoder 2,8,14 Indexer K | 2 | 68 | 102 | | Decoder 20 Main KV | 1 | 288 | 288 | | Decoder 20 Indexer K | 1 | 68 | 68 | | 总和 | | | 890 B/token |
对比V4-Flash 43层独立全局缓存(CSA+HCA),每entry 584B+CSA Indexer 16B等,原3514 B/token;跨层复用崩为4源变652;序列压缩放松4->2/1变1630;FP4主KV 584->288变890。
3.2 计算机架构视角
将Transformer块作计算机:提缓存命中率需跨层复用KV。整块(1 Full+B Reuse)为递归Transformer,MoE为页表。一层CSA2作小计算机,三模式即三缓存命中态。
一层CSA2分三级:计算(主Q/SWA KV新算)、缓存(主KV/Indexer K/TopK/HSI池跨层共享)、存储(MoE/FFN大容)。主Q/SWA不入缓存;主KV/Indexer K/TopK可缓存。
| 模式 | 主KV | Indexer K | TopK | | --- | --- | --- | --- | | Full | 写 | 写 | 写 | | Reindex | 读 | 读 | 写重算 | | Reuse | 读 | 无访 | 读 |
Full=未命中写分配;Reindex=数据命中地址重算;Reuse=全命中仅新操作数。Indexer如AGU/TLB产地址,主注意力如数据路径。HSI候选池如TLB限制,两层TopK如二级页表。三模式如三时钟域:query寄存器级、address L1级、content L2/L3级刷新。
3.3 跨层KV共享数学原理
3.3.1 注意力三类自由度
稀疏注意力读出由三变量输入定:内容(压缩历史向量,key=value=,决相似度与读出负载),地址(TopK选定归一位置集),查询(层自身参算,决权重方向)。输出为选定内容凸组合。
内容:最贵,全局扫;地址:离散,中成本;查询:连续,最廉,局部投影。单向依赖:地址依内容评分,查询依地址定权。故复用只能自上而下:可复用内容+地址(Reuse),或复用内容重选地址(Reindex),不可改内容复用旧地址。
| 模式 | 内容 | 地址 | 查询 | | --- | --- | --- | --- | | Full | 新 | 新全扫 | 新 | | Reindex | 复用 | 池内新 | 新 | | Reuse | 复用 | 复用 | 新 |
3.3.2 Reuse模式基于查询扰动
固定层,输入隐藏态,主注意力需主Q、主KV内容、TopK集、局部SWA KV。主Q层算;主KV仅源层压缩器生;TopK仅索引源层生;SWA层算。
Reuse层内容和选择取较早源层,对自身隐藏态偏导零。读出自变量仅查询变量+独立SWA。故层间适配数学上缩为仅查改写:,为可学扰动。
3.3.2.1 主注意力可为固定字典读出
候选集,重用缓存向量栈,key=value故输出为字典向量凸组合,锁在固定凸多面体。
3.3.2.2 改写Q等价基线分布指数倾斜
,扰动做指数倾斜后重归一。配置下倾斜限至多维子空间。
3.3.2.3 覆盖范围
字典向量基权,均值映射像集为上界,但实模不保全达。
3.3.2.4 仅改写Q表现力
- 保注意力单纯形,可集中单顶点或软插;2. 全可微零重检索;3. 几何对齐key=value增权拉输出;4. 全局局部比由Q分配。另可学Q-aware参数将下层KV空间映射回上层实现复用,缺陷转序列维。
3.3.2.5 Reuse与Full差
Full三层自由度独立:查询、键值内容(移顶点)、选择集(离散)。Reuse冻后二。严格包含,差距:召回上限(内容不在不可达)、顶点不动(输出钉凸包内)、倾斜几何不可换。
3.3.3 Full/Reindex/Reuse协同
层维三模式粗到细刷新:Full锚定重建KV跑Indexer;Reindex保内容池内重选;Reuse仅Q投影SWA无写。Decoder中HSI:Full(层20)定义内容/候选池(16384)/自身Top512;Reindex(24,28,32,36)池内重选各Top512;Reuse跟最近索引层发布仅改写Q。
评论
讨论整体偏乐观,几乎没有人反对长上下文加速这件事本身,焦点在于 KV 缓存压缩、前缀缓存与自动上下文压缩叠加后,长会话的边际成本正迅速塌缩;唯一的不和谐音是有人发现博客页面打不开。
认为缓存压缩让长上下文查询接近免费
- 把 KV 缓存压缩和前缀缓存放在一起看,效果是重复或相近的查询成本趋近于零,这是被点名的最大亮点(少数人) > KV 缓存压缩和前缀缓存让查询几乎免费。(@arikrahman)
认为自动上下文压缩才是长会话真正好用的关键
- 开启自动增量式上下文压缩后,体感提升超出预期:有效会话长度被拉到 5M,而模型实际运行在 300k–400k 区间,速度和智力都没有掉下来(少数人)
- 400 tok/s 的预览版被形容为「离谱」,可以放任它一整天反复压缩、持续攻几个硬问题,这种工作流过去不成立(少数人) > 我就让它在一天里反复压缩,啃掉几个硬骨头。(@mmastrac)
有价值的补充
- 前缀缓存与 KV 缓存压缩是两件事,前者省的是重复前缀的算力,后者省的是显存与带宽,二者叠加才会出现「相近查询近乎免费」的效果。
- 「有效会话长度」和模型真实上下文是两码事:压缩器可以把会话撑到 5M 量级,但模型实际处理的是被压缩后的 300k–400k,说明瓶颈已从窗口大小转移到压缩质量与信息保真度。
- 高吞吐(400 tok/s)本身不是炫技,它让「反复压缩—重试」这种高 token 消耗的策略变得经济可行。