作者读到杰森·戈尔曼(Jason Gorman)的文章,其中提到从90%可靠性提升到99%,难度与达到90%时一样大;从99%再到99.9%同样如此。这让他感触颇深,因为日常工作中遇到的停机越来越多:GitHub挂了,CI挂了,AI挂了,Slack也挂了。停机正在变得司空见惯,他越来越频繁地访问服务状态页面,面对满屏的颜色和数字:100%?99.72%?99.09%?98.98%?
正文
我读 Jason Gorman 的文章时,他提到:
从 90% 提升到 99% 可靠的路,和当初爬到 90% 一样难。而从 99% 到 99.9% 同样又要难上一倍。
这让我很在意,因为我日常工作中遇到“宕机”越来越频繁。GitHub 挂了、CI 挂了、AI 挂了、Slack 挂了。宕机正变得司空见惯!我越来越多地去翻服务商的状态页,面对一墙的颜色和数字,比如这样:
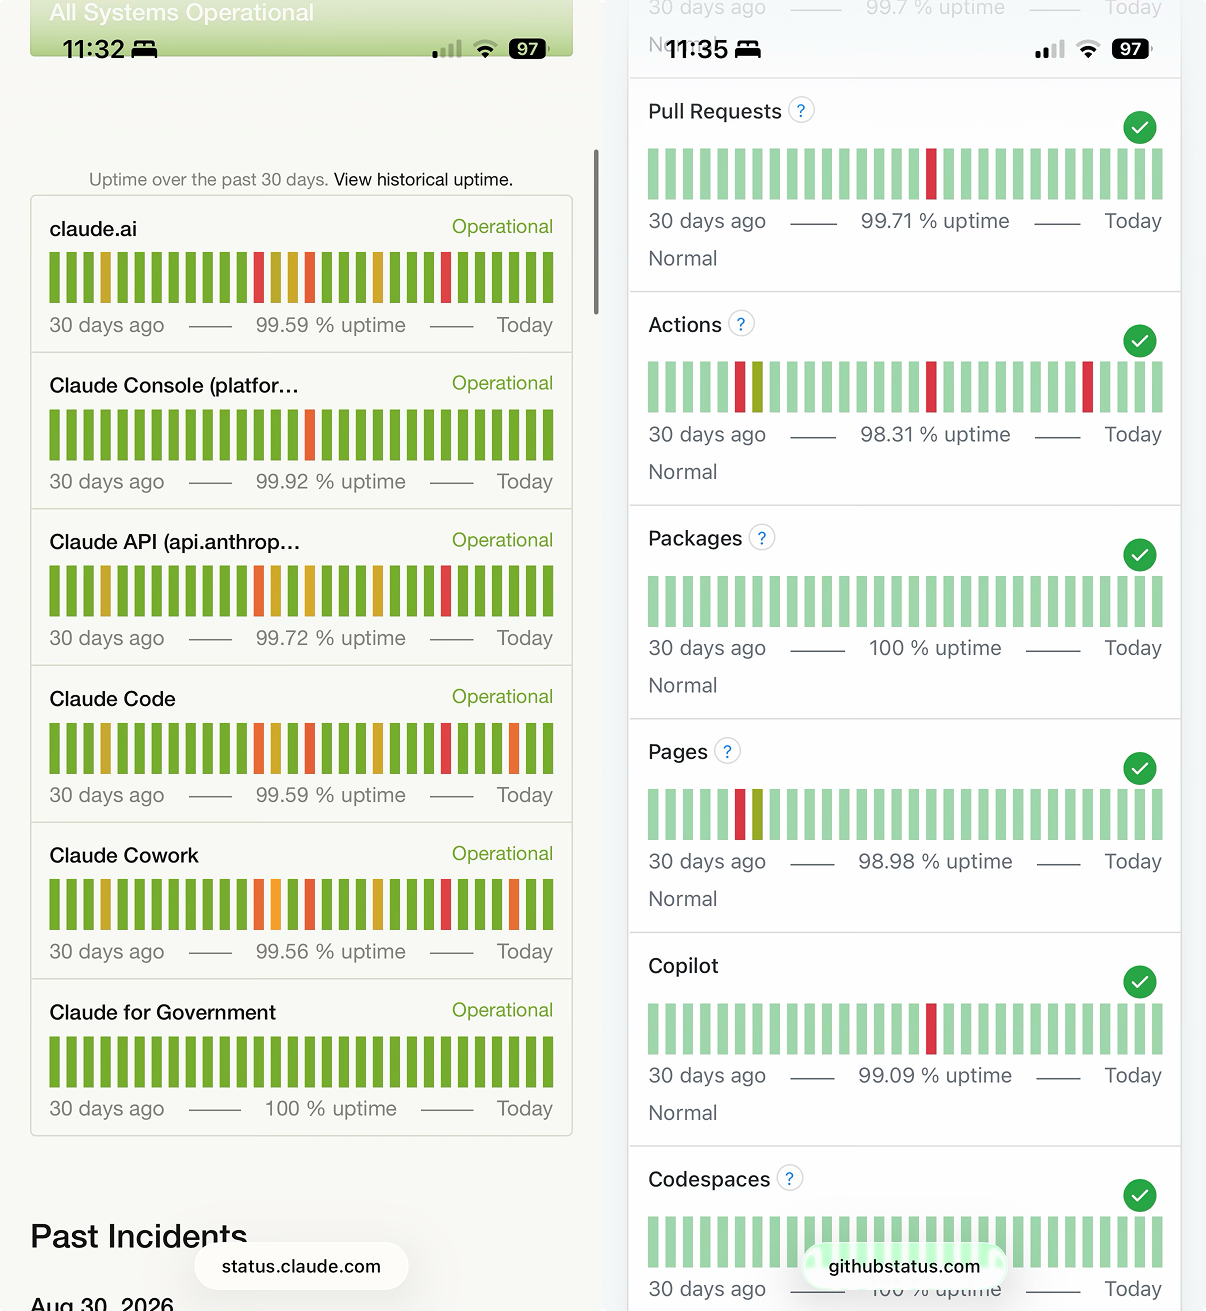
100%?99.72%?99.09%?98.98%?这些看起来没多大区别,也不算糟?在学校里这些都算 A。然后我得提醒自己 Jason 的观点,重新解读这些数字,更像是在读地震震级。6.2 和 7.8 看着差不太多,其实量级差巨大。正常运行百分比也是类似问题:99.9% 和 99.99% 看着差不多,但后者的停机时间相差足有十倍!
搞基础架构的人懂这个。他们甚至有行话:两个九、三个九、四个九。他们凭直觉就能理解差异,因为他们天天跟这些数字打交道。但状态页的受众不再只是基础架构的人了,越来越变成所有人。
我明白数学上很直白,正常时间百分比对业内是个好指标。但对那些不在乎用标准、可靠、合规方式衡量基础设施可靠性的人来说,这是个糟糕的界面。状态页就是理解服务可靠性的公开界面,我只想知道:“老兄,你最近宕了多久?感觉挺久的……”
所以不如——我就随口一提——与其写「GitHub Actions:98.31% 正常运行时间」,不如说「GitHub Actions:过去 30 天受影响 12 小时(98.31% 正常运行时间)」。前者要求你理解接近 100% 的数字的非线性意义,后者只需要你知道一小时是啥。
评论
社区普遍反感将低可用性美化为“每月仅几小时受影响”的话术,强调停机的真实成本与发生时段才是核心;分歧在于可靠性标准是否该松动,以及百分比、几个9与绝对时长哪种披露更有意义。
认为用“每月几小时停机”表述是在粉饰太平
- 把 98% 说成“12小时受影响”弱化了频繁短中断或关键时段瘫痪的破坏,真实代价是开发者生产力与收入流失(较多人) > 我们不该把停机旋转成“每月就几个小时”,那些时间耗费的是真金白银(@hx8)
认为停机的影响取决于发生时段与关键功能是否可用
- 百分比不反映停机在凌晨还是黑五,也不区分系统活着但核心功能挂掉;对分布式系统单一数字含糊(较多人) > 服务哪怕只有五成在线率,只要刚好是我需要时在线,也比工作时间全面瘫痪强(@wang_li)
认为“几个9”或百分比仍是必要且易懂的行业标准
- 几个9是内部评估和外行沟通的黄金标准,不同行业容错差异大,改口可能给服务商降级掩盖的借口(较多人) > “四个9”已是公认的质量图腾,改变表述恐无意中重置可靠性期望底线(@jdauriemma)
认为多数业务并不需要极端高的可靠性
- 三个9对大多数应用足够,追求五个9成本高收益低,除非失败代价极大或时段敏感;GitHub因面向工程师的营销属性例外(少数人) > 通常你需要的可靠性没想象中高,每年八小时停机对多数用途已经不错(@dmurray)
认为停机度量本身缺乏统一定义与准确汇总
- 行业未统一“停机”“降级”定义,多云交织下真实可用性难量化,厂商常选择性报告(较多人)
认为厂商公布指标主要为广告规避风险而非透明
- 企业无动力做难看披露,数字不被外行理解反而是特性,用于满足SLA和防御欺诈指控(较多人)
有价值的补充
- 可用 -log10(1-p) 公式将任意可用性平滑映射为“几个9”数值,便于跨精度比较(@jerf、@tyho)
- 电力行业 IEEE 指标值得借鉴:SAIDI 年均中断分钟数、SAIFI 中断次数、CAIDI 恢复时长,比单一百分比更贴用户感知(@procflora)
- Google 的“窗口化用户在线率”放弃单一数字,分视角暴露数据,更适合分布式系统(@teraflop)
- 用对数坐标绘制停机时长能直观呈现非线性差异(@swiftcoder)