过去一个月,我一直在 Z486兼容核心(z486_MiSTer)上加功能提升性能,主要玩 1990 年代前半段游戏。向前几年想探索 3D 显卡的到来。第一个让我印象深刻的是巫毒(Voodoo)显卡,游戏是极品飞车 II SE(Need for Speed II SE)。平滑纹理、雾效和速度像新一代 PC 游戏。既有 Z486处理器(z486 CPU),能否在 FPGA 上重现?成果 ZSST核心(zSST)为 3dfx公司(3dfx)巫毒卡(Voodoo Graphics/SST-1)的 SystemVerilog 实现。结合 Z486处理器(z486 CPU)与硬件构成 Z486扩展(z486 XL):赛灵思(Xilinx)KV260 上运行带巫毒显卡的 DOS PC。古墓丽影(Tomb Raider)用原 3dfx 渲染器运行。
正文
过去一个月我主要在 z486_MiSTer 上加功能、提升性能,跑的多是 1990 年代前半期的游戏。再往前看几年,我想试试 3D 显卡的出现。给我留下深刻印象的第一块显卡是 Voodoo,出自《极品飞车 II SE》。平滑的贴图、雾效和整体速度,让人感觉进入了新一代 PC 游戏。既然已经有了 z486 CPU,我能不能在 FPGA 上重现这种体验?
这个尝试的结果是 zSST,一个用 SystemVerilog 实现的 3dfx Voodoo Graphics(即 SST-1)。把它和我的 z486 CPU 及周边 PC 硬件结合起来,就构成了 z486 XL:一台在 Xilinx KV260 板卡可编程逻辑里运行的、带 Voodoo 显卡的 DOS 电脑。《古墓丽影》现在能用原始的 3dfx 渲染器运行了。
zSST 实现了 Voodoo 大部分核心特性:预处理三角形、纹理过滤与 mipmap、深度和 alpha 测试、雾效、混合、抖动、帧缓冲访问和缓冲区交换。它同时支持定点数和浮点数配置接口。硬件游戏测试目前集中在《古墓丽影》,更广泛的兼容性和后续 Voodoo 世代留待以后。
CPU 和渲染器在 KV260 上以 100 MHz 运行。这块板子有足够的逻辑单元、DSP 块、片上内存和 DDR 带宽来容纳整个设计。DE10-Nano 放不下这个显卡扩展。KV260 用的是板载 DDR,没有外接 SDRAM 模块。
从编程模型入手
好在参考资料很多。3dfx 在 2000 年 12 月被 NVIDIA 收购核心图形资产之前,于 1999 年公开了 Glide 源码。现存的 Glide 源码和 SST-1 规范说明了软件如何准备三角形、配置像素管线,以及管理纹理和帧缓冲。
规范是一个行为目标,而不是电路图。它说明了软件写某个寄存器时应该发生什么,但把很多实现选择留给了开发者。86Box 为复杂的渲染行为提供了有用参考。更早的 MAME Voodoo 工作也是这段保存历史的一部分。SpinalVoodoo 提供了特别有用的 Glide 跟踪记录和参考截图用于测试。
从三角形到 3D:每时钟一个像素
Voodoo Graphics 把三角形变成像素,把大量 3D 工作留给主机 CPU。它的命令接口出奇地精简:五个主要命令寄存器驱动加速器。
| 寄存器 | 动作 |
| --- | --- |
| triangleCMD | 开始渲染一个预处理过的三角形。 |
| ftriangleCMD | 通过浮点配置接口启动三角形渲染。 |
| nopCMD | 冲刷管线;可选重置统计计数器。 |
| fastfillCMD | 清除一块裁剪过的矩形区域的颜色和/或深度数据。 |
| swapbufferCMD | 切换显示缓冲区,立即切换或与垂直回扫同步。 |
两个三角形命令启动的是同一条渲染管线。其他寄存器存放坐标、梯度和渲染状态,而内存映射区域用于上传纹理和直接访问帧缓冲。主要的绘图图元就是一个预处理好的三角形。
对游戏开发者,Glide 提供了更友好的接口,如 void grDrawTriangle(const GrVertex *a, const GrVertex *b, const GrVertex *c);。在这个调用之前,主机 CPU 要变换 3D 几何、计算顶点光照、裁剪并投影到屏幕上。然后 Glide 准备屏幕空间三角形及其参数梯度(即用于表面插值的增量),并写入三角形命令启动渲染。与后来 GeForce 256 等 GPU 不同,SST-1 没有硬件几何变换和光照引擎。
加速器仍有大量工作。光栅化器找出三角形内部哪些像素中心,并插值出它们的颜色、深度和纹理坐标。纹理单元获取并过滤纹素;帧缓冲单元合并颜色、做可见性测试和雾效、与现有图像混合,并写入结果。
一个像素要经过多个阶段才能完成,而新像素可以不断进入。原卡把这项工作分给两颗 ASIC:FBI(帧缓冲接口)和 TREX(纹理映射单元,通常叫 TMU)。在 50 MHz 图形时钟下,标称峰值是一时钟一个带纹理、深度测试的像素:每秒 5000 万像素。
每时钟一个像素并不是说一个像素在一时钟内完成,而是不同级可以同时处理不同像素:当一个像素在做纹理时,更早的可以混合、另一个可以写出。一旦管线填满,只要内存跟得上,理想情况下每时钟就能接收并完成一个像素。
这正是固定功能管线的魅力。软件渲染器每个像素要执行很多指令;专用硬件让这些工作在稳定的像素流上重叠进行。Voodoo 让贴图丰富的 3D 游戏以流畅的 30 FPS 或更高帧率活了起来——这是它大受欢迎的重要原因。
构建像素管线
相比 x86 CPU,算术路径相当规整。我们跟着一个像素,从插值参数经过纹理和颜色操作到帧缓冲,先看看数字是怎么表示的。
浮点接口背后的定点数
浮点运算是现代 GPU 编程的核心。SST-1 处于一个有趣的过渡期:软件可以提交浮点值,但渲染机制主要在定点数(带隐含缩放因子的整数)上运行。
| 配置值 | 定点寄存器格式 | | --- | --- | | 屏幕 X 和 Y | 12.4 | | 红、绿、蓝、alpha | 12.12 | | 深度 Z | 20.12 | | 纹理 S/W 和 T/W | 14.18 | | 倒数 W | 2.30 |
这里 12.4 指小数点前有 12 位(含符号位),小数点后 4 位。所以屏幕坐标 10.5 存为整数 168:乘 16 编码,除 16 还原。这些小数位让光栅化器能处理像素中心之间的顶点。
fvertex、fstart 和浮点梯度寄存器接受 IEEE 单精度值。SST-1 把它们转成内部定点表示,zSST 也遵循这个约定。三角形准备好后,沿扫描线前进基本就是对每个插值参数加上预计算的增量。大量逐像素工作变成了简单的整数加法。
一个像素对应四个纹素
为了透视校正贴图,TMU 插值 S/W、T/W 和 1/W,再把前两个除以第三个来恢复纹理坐标。这样当地面或墙面后退时,纹理能保持正确透视。TMU 还会选择一个 mip 层级:对覆盖表面面积较大的像素,使用更小的纹理版本,减少远处的走样和闪烁。
然后双线性过滤把采样位置周围的四个相邻纹素(纹理的像素)结合起来。先水平混合上面一对,再水平混合下面一对,最后在这两个结果间做垂直混合。小数位置决定权重,产生纹素颜色间的平滑过渡,而不是从一个跳到下一个。
四次纹理读取产生一个过滤后的采样。
在 zSST 中,一个四级前端把透视和 LOD(细节层级)计算流水化。地址生成和缓存查找提供纹素,两个带寄存器的解码级把存储格式转成用于过滤和纹理合并的颜色。基于调色板和 NCC 编码的纹理需要不同解码规则,但最终都汇入同一条像素流。
颜色、测试、雾效与混合
一旦纹理和帧缓冲数据就绪,zSST 的 FBI 像素路径使用六个带寄存器的级:
| 级 | 主要工作 | | --- | --- | | F0 | 选择数据源,检查色度键,准备 Z/W 深度值。 | | F1 | 应用颜色和 alpha 合并函数。 | | F2a | 测试 alpha/深度,查找雾因子。 | | F2b | 应用雾效。 | | F3 | 重建目标颜色并执行 alpha 混合。 | | F4 | 转换到帧缓冲精度,抖动,应用写掩码。 |
这些级的边界是为了满足 FPGA 时钟目标而选的。SST-1 规范描述了操作,但没透露原 ASIC 的确切管线寄存器。比如把雾查找和雾应用分开,能让长算术路径不挤进单时钟,同时保留每时钟接收一个像素的能力。
结果写入后台缓冲。然后与回扫同步的缓冲交换显示完成后的图像,而不会在扫描输出中途切换缓冲。原版 Voodoo 只是个纯 3D 扩展卡,不活动时直通普通 VGA 卡的输出。z486 XL 在 FPGA 系统内部做类似选择,在 PC 的 VGA 输出和 zSST 的显示输出间切换。
难点:从内存喂数据
zSST 像素管线的实现相对直白,至少和 z486 的 CPU 管线比起来是。但怎么喂饱它难得多。双线性采样需要来自不同地址的四个纹素。一个带深度测试、混合的像素还需要现有深度和颜色,然后再写回新值。逐个访问很快会毁掉吞吐量。我花在内存系统设计、调优和调试上的时间,比算术管线还多。
原卡如何提供像素
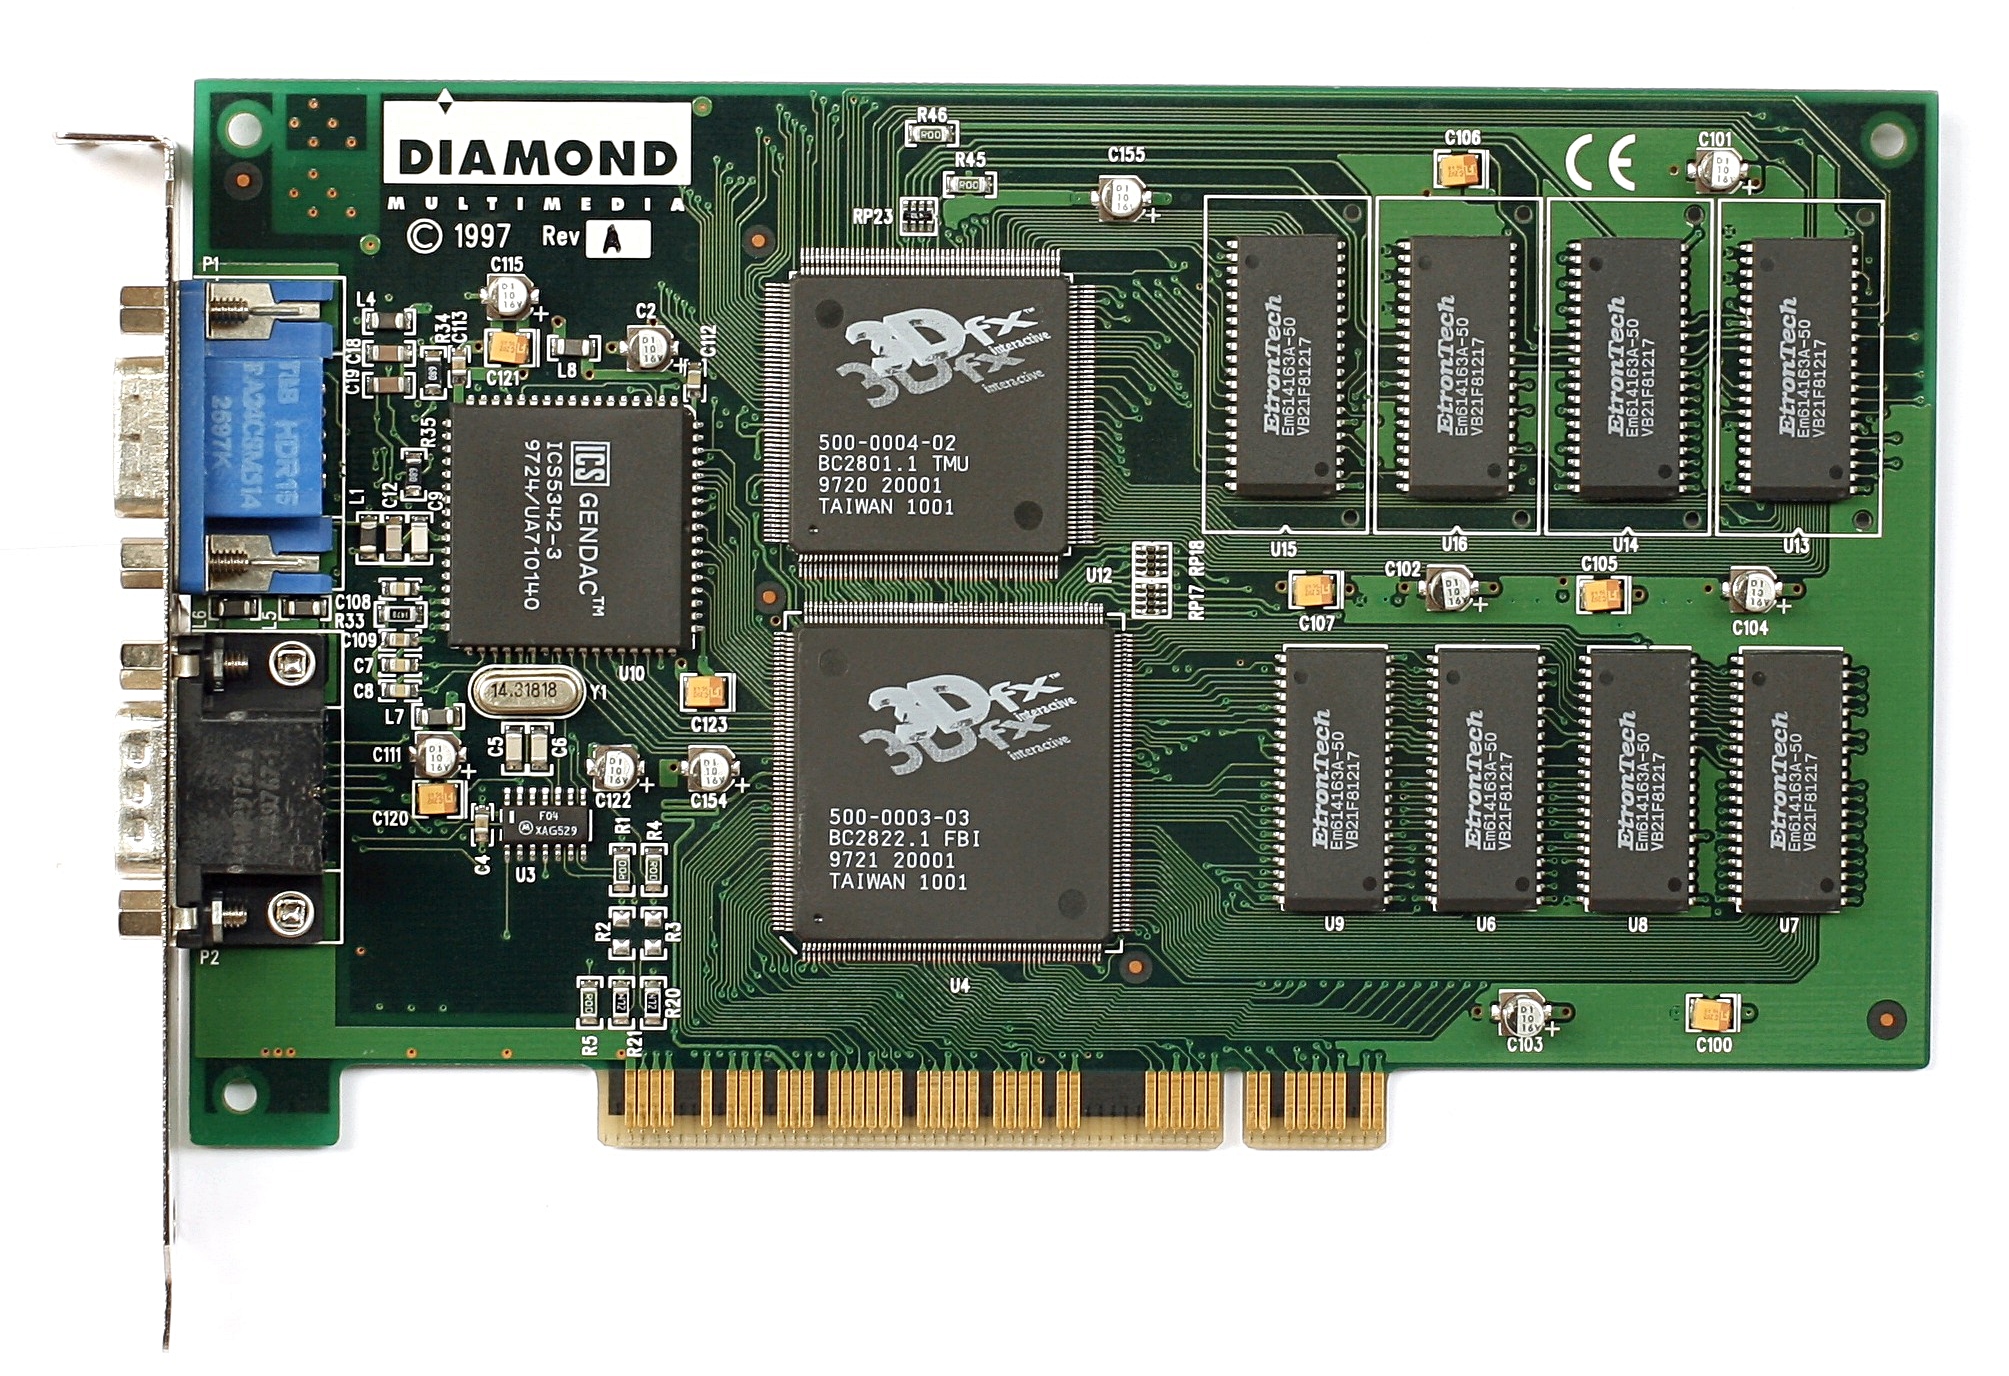
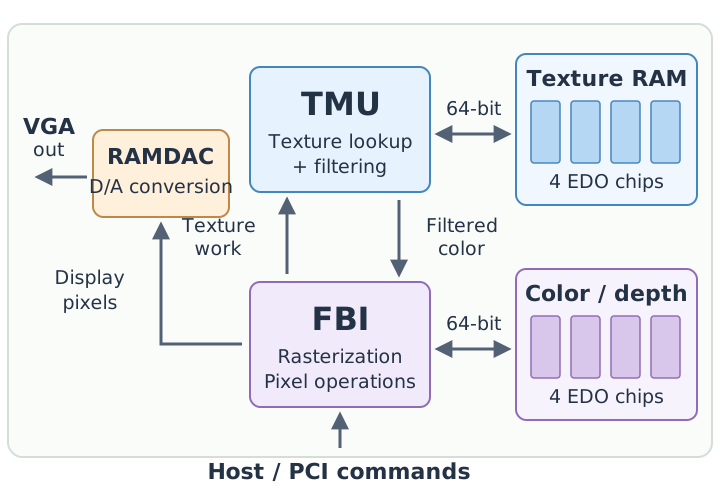
这种分工在 Diamond Monster 3D 上肉眼可见。上面那颗 3dfx 芯片是 TMU,下面的是 FBI,各自右边有四颗 EDO RAM 芯片。上面一组存纹理;下面一组存颜色和深度/alpha 缓冲。
FBI 和 TMU 各有专用的 64 位内存通道。纹理侧用四路交织,让存储体读取独立地址,并行提供双线性过滤所需的四个邻居。规范(第 13 页)承诺能达到和点采样相同的吞吐量,且无需存重复纹素。
但如果两个相邻纹素落进同一颗芯片怎么办?诀窍是把纹素按重复的二维模式分布,而不是把图像切成四大块。给偶数/奇数列和行各自组合分配一个存储体,原因就清楚了:
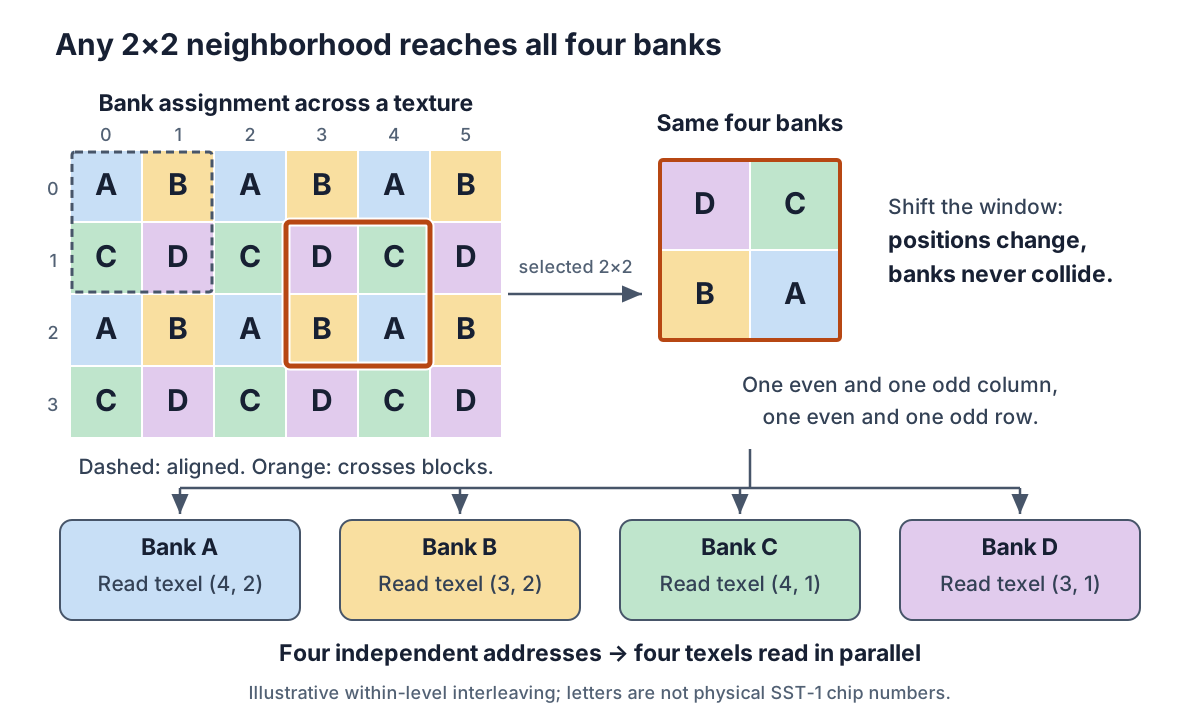
移动采样点改变的是存储体的位置,而不是数量。坐标是(列,行);字母表示原理,不是 SST-1 物理芯片编号。
每个 2×2 窗口都包含 A、B、C、D——哪怕是跨水平和垂直块边界的橙色窗口。连续两列奇偶相反,连续两行也是。四种组合恰好各出现一次,所以每个存储体无冲突地提供一个纹素。
纹理边缘和小 mip 层级要稍加注意。SST-1 用 2 的幂次纹理尺寸,所以环绕能保持尺寸≥2 时的交替模式。在钳制边缘,或只有一纹素宽/高的 mip 层级,有些采样会复用同一纹素。核心认知不变:快速双线性过滤取决于内存排布,让算术单元能一次性拿到所有输入。
FBI 对颜色和深度/alpha 内存用了类似思路。它的交织通道峰值是一时钟一个渲染像素,清除时两像素。相邻像素一起处理,把读写开销摊到一条扫描线上。Fabien Sanglard 的双像素解析对这种行为做了有用的重建,尽管编程指南没记录确切的 ASIC 存储体调度。
在 50 MHz,每条 64 位通道理论带宽 400 MB/s:总共 800 MB/s,但分给不同任务。TMU 不能借 FBI 的空闲带宽,反之亦然。这些专用总线和精心排布的存储体让我想起在 SNESTang 等项目中探索的 NES 和 SNES 时代设计:充分利用内存意味着围绕每个值确切需要的时机和位置来设计。
FPGA SoC 上有什么变化
Voodoo 的内存布局解释了它怎么让管线不空转,但我不能把那设计直接搬上 KV260。这块板子内存带宽大得多,却没有连到任何渲染单元的专用 EDO 内存。FPGA 通过 Zynq 处理系统的 AXI 端口访问共享 DDR。Linux、FPGA 里的 PC 和显示扫描输出都在抢这块内存。目标一样——喂饱像素管线——但实现方式必须变。
原版 SST-1 有专用纹理和帧缓冲总线。zSST 共享渲染端口,并用缓冲来容忍 DDR 延迟。
我们的 KV260 测量说明了为什么光有带宽不够。100 MHz 的 128 位端口理论带宽 1.6 GB/s。只有一个未完成请求时,4 KiB 读取达 1,370 MiB/s,但 64 字节读取只有 189 MiB/s。首个数据通常约 280 ns 才到——100 MHz 下约 28 个时钟——偶尔等得更久。长突发能摊薄延迟;小请求需要并发。
渲染器若等每次小读取完再发下一次,大部分时间就闲着。zSST 需要足够多的在途独立工作来覆盖这些等待。
缓存、重放与重排序缓冲
喂饱管线既要减少 DDR 访问,也要少花时间等。第一步是缓存。邻近屏幕像素常采样纹理的重叠部分,所以刚取的纹素可从片上 RAM 复用。zSST 纹理缓存为 8 KiB、64 字节一行;每次获取还顺带读入后续像素可能需要的相邻纹素。
缓存未命中仍要很多时钟,但独立的纹理采样不必等它。zSST 最多允许八个缓存行获取在途,用重放队列暂存缺数据的采样,数据到了再重试。同时,纹素已在缓存里的采样可以继续。预取为未来读取抢了先。
这样后面的缓存命中可以在前面的未命中之前完成。一个 64 项的重排序缓冲(ROB)收集这些结果,按原序放出。这原理在 CPU 里很常见:长等的时候做有用功,然后恢复顺序再传下游。
帧缓冲侧用独立的 4 KiB 颜色和深度/alpha 读缓存,写组合器把相邻 16 位更新打包成 128 位请求。这里顺序很重要:混合或深度测试可能需要前面像素改了但还没写进 DDR 的值。转发直接提供这个挂起值。帧缓冲更新按顺序生效,需要已完成工作的状态改变会等它排空。内存请求可以重叠,但后面的像素必须看到前面像素的效果。
缓存复用邻近数据;队列重叠内存请求;有序回收保住结果。
FBI 和 TMU 共享渲染器的 128 位 AXI 端口 HP2。PC 用 HP0,显示扫描输出用 HP3,即便三者最终共享 DDR,请求队列也是分开的。
评估结果
我把渲染器从完整 PC 中分开测。仿真基准测试通过 zSST 前端发命令,驱动 TMU、FBI、共享仲裁器和 DDR 时序模型。读数据至少 26 时钟后到,有确定性的变动和偶尔更长延迟;写也限速。全渲染器测试允许 32 个在途读。
在 100 MHz,zSST 处理带纹理三角形达 7850 万像素/秒(MPix/s),带深度测试和混合为 7280 万。Voodoo 1 在原生 50 MHz 的公开估计,对类似特性集是 43 和 37 MPix/s。这不是严格对等基准:三角形负载不同,原估计还含雾效、mipmap 和高氏着色。我没有 Voodoo 1 跑相同测试。对比只显示大致填充率范围,不是对原卡测出的加速比。
高填充率不自动等于高游戏 FPS。在板子上,《古墓丽影》第二关约 20 秒产生 237 次显示缓冲交换——约每秒 12 次,按交换而非引擎 FPS 计数器算的。初步测量指向 CPU 瓶颈:它仍要跑游戏、准备几何和提交命令。共享 DDR 争用可能也有关。整机还有不少可优化。
对非 Voodoo 游戏,当前 100 MHz z486 XL 跑最高画质 Doom 为 38.5 FPS,Quake 1.06 为 8.1 FPS。比 85 MHz DE10-Nano 构建快约 20%——Doom 约 23%,Quake 约 19%。UltraRAM 里 512 KiB 写回式 L2 缓存帮 CPU 更好利用 DDR。
在集成的 XCK26 构建中,zSST 约占 29,500 LUT、28,100 触发器、14 个 RAMB36、8 个 RAMB18 和 97 个 DSP slice。合并的 PC 和图形设计在 100 MHz 满足时序。
收尾
最有成就感的是看到原始 Glide 软件驱动我在 RTL 里造的硬件。我原以为渲染算术是最难的;高效喂数据反而更费工。Voodoo 精心交织的 EDO 和 zSST 的缓存与队列,在不同约束下解决了同一问题:快速像素管线只有有事干时才管用。
zSST 和 z486 XL 都开源。如果你有 KV260,z486 XL SD 镜像提供了启动自己 DOS 磁盘镜像所需的 Linux 支持和应用。
评论
讨论围绕硬件复刻与老显卡展开,气氛偏怀旧和技术追问,并没有尖锐对立;分歧主要在于"年代准确"该被追到什么程度、当年硬件自身的局限要不要被正视,另有少数人对演示材料缺失和疑似 AI 行文表示不满。原帖评论未附评分,以下按讨论中的呼应程度标注认可度。
认为 FPGA 复刻的意义在于硬件级精确,而不是软件模拟
- 把设备逻辑直接映射到现场可编程门阵列,能绕开软件模拟常有的时序问题,得到"精确"的硬件复制品;对老机器感兴趣的人值得一试(较多人) > 不是用软件模拟设备,而是把真正的设备逻辑映射到 FPGA 上,才能做到"精确"的复制。(@jumploops)
追问复刻能否承接超出原机规格的软件与外设
- 有人关心 FPGA 486 是否支持多出来的 Pentium 指令,因为 1996 年的《古墓丽影》当年标称需要 Pentium,演示版在自己 486 上直接拒绝运行(较多人) > 那个演示版在我的 486 上拒绝运行,这个 FPGA 486 会支持额外的 Pentium 指令吗?(@wk_end)
- 也有人想要 31kHz 的 VGA 输出,好在"超级站"里凑出一台年代准确的 PC,或者跑起当年的 VRML 演示(少数人)
怀旧老显卡时,挫败感往往和兴奋感一样真实
- 割了两个夏天草才攒出 Voodoo 3 PCI,结果想玩的几乎都跑不起来,为让《奥秘》启动耗掉整个夏天也没成功;副作用是此后买东西前的调研变得强迫式,但那张卡仍被记着好(较多人) > 那份买方悔恨真的给我留下阴影,从那以后我买任何东西前的调研都到了偏执的程度。(@monster_truck)
- 也有人只是感叹 Voodoo 上的《雷神之锤》当年震撼,今天再看已不惊艳(少数人)
对演示缺失与疑似 AI 行文的不满
- 没有任何示例视频让人难以忍受,这是对项目展示方式的直接抱怨(少数人)
- 有人从"规格是行为目标,而不是电路图"这类句子里嗅到 LLM 的味道,但声明不是抱怨,因为 AI 确实在带来明显提升(少数人)
有价值的补充
- MiSTer 的 HDMI 不耐热插拔:开机状态下反复拔插会烧坏输出,能 SSH 进去却完全没有画面,这个教训来自亲身踩坑。
- GPU 在概念上就是为图形运算特化的处理器,有自己的指令集和内存,想通这一点后自己动手实现一款就不再遥远;近年低层 GPU 内部结构与编程的文章数量明显增多。
- 有人提出并求证:Voodoo 缺少早期深度测试,因此完全被遮挡的三角形照样会走一遍纹理流程。