尼克拉斯(Niklas)与科迪·何(Cody Ho)用约一个月为 M4 Mac Mini(M4 Mac Mini)和 MacBook Neo(MacBook Neo)构建了完全兼容 OpenGL ES 3.0(OpenGL ES 3.0)的 GPU 驱动,这通常需数年。他们在 M4 Mac Mini 上借该驱动让 Chrome(Chrome)和 Firefox(Firefox)运行带合成效果的 WebGL(WebGL),速度足以使 Minecraft(Minecraft)达 200fps。构建需逆向苹果(Apple)的 AGX(AGX)复杂固件 ABI 与用户空间组件,以透明可验证净室方式完成,代码尚未准备好给终端用户但正计划尽快发布。
正文
我们做了什么
Niklas 和我在约一个月里为 M4 Mac Mini 和 MacBook Neo 构建了完全兼容 OpenGL ES 3.0 的 GPU 驱动,这活儿通常得花好几年。下面是 Chrome 和 Firefox 在我们的驱动上跑 WebGL 合成:
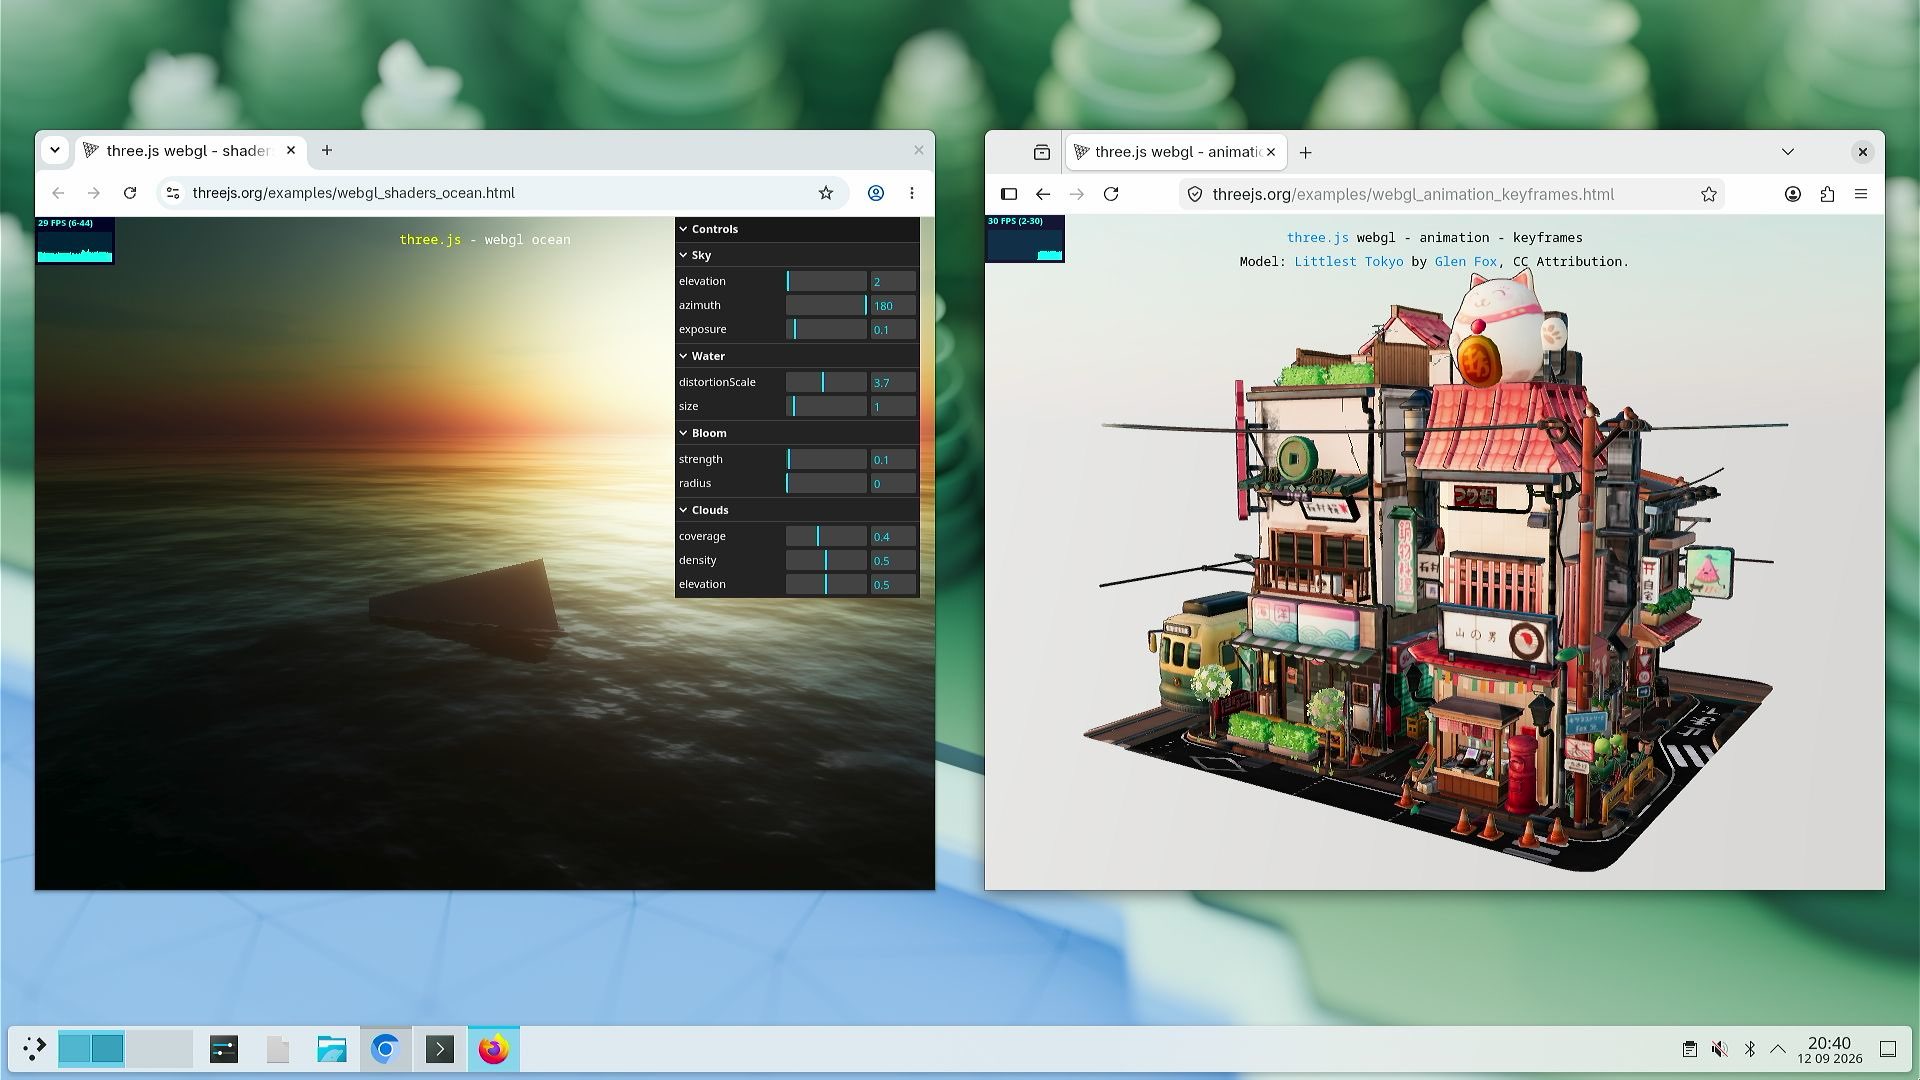
最重要的是,驱动够快,能跑 Minecraft 到 200fps:
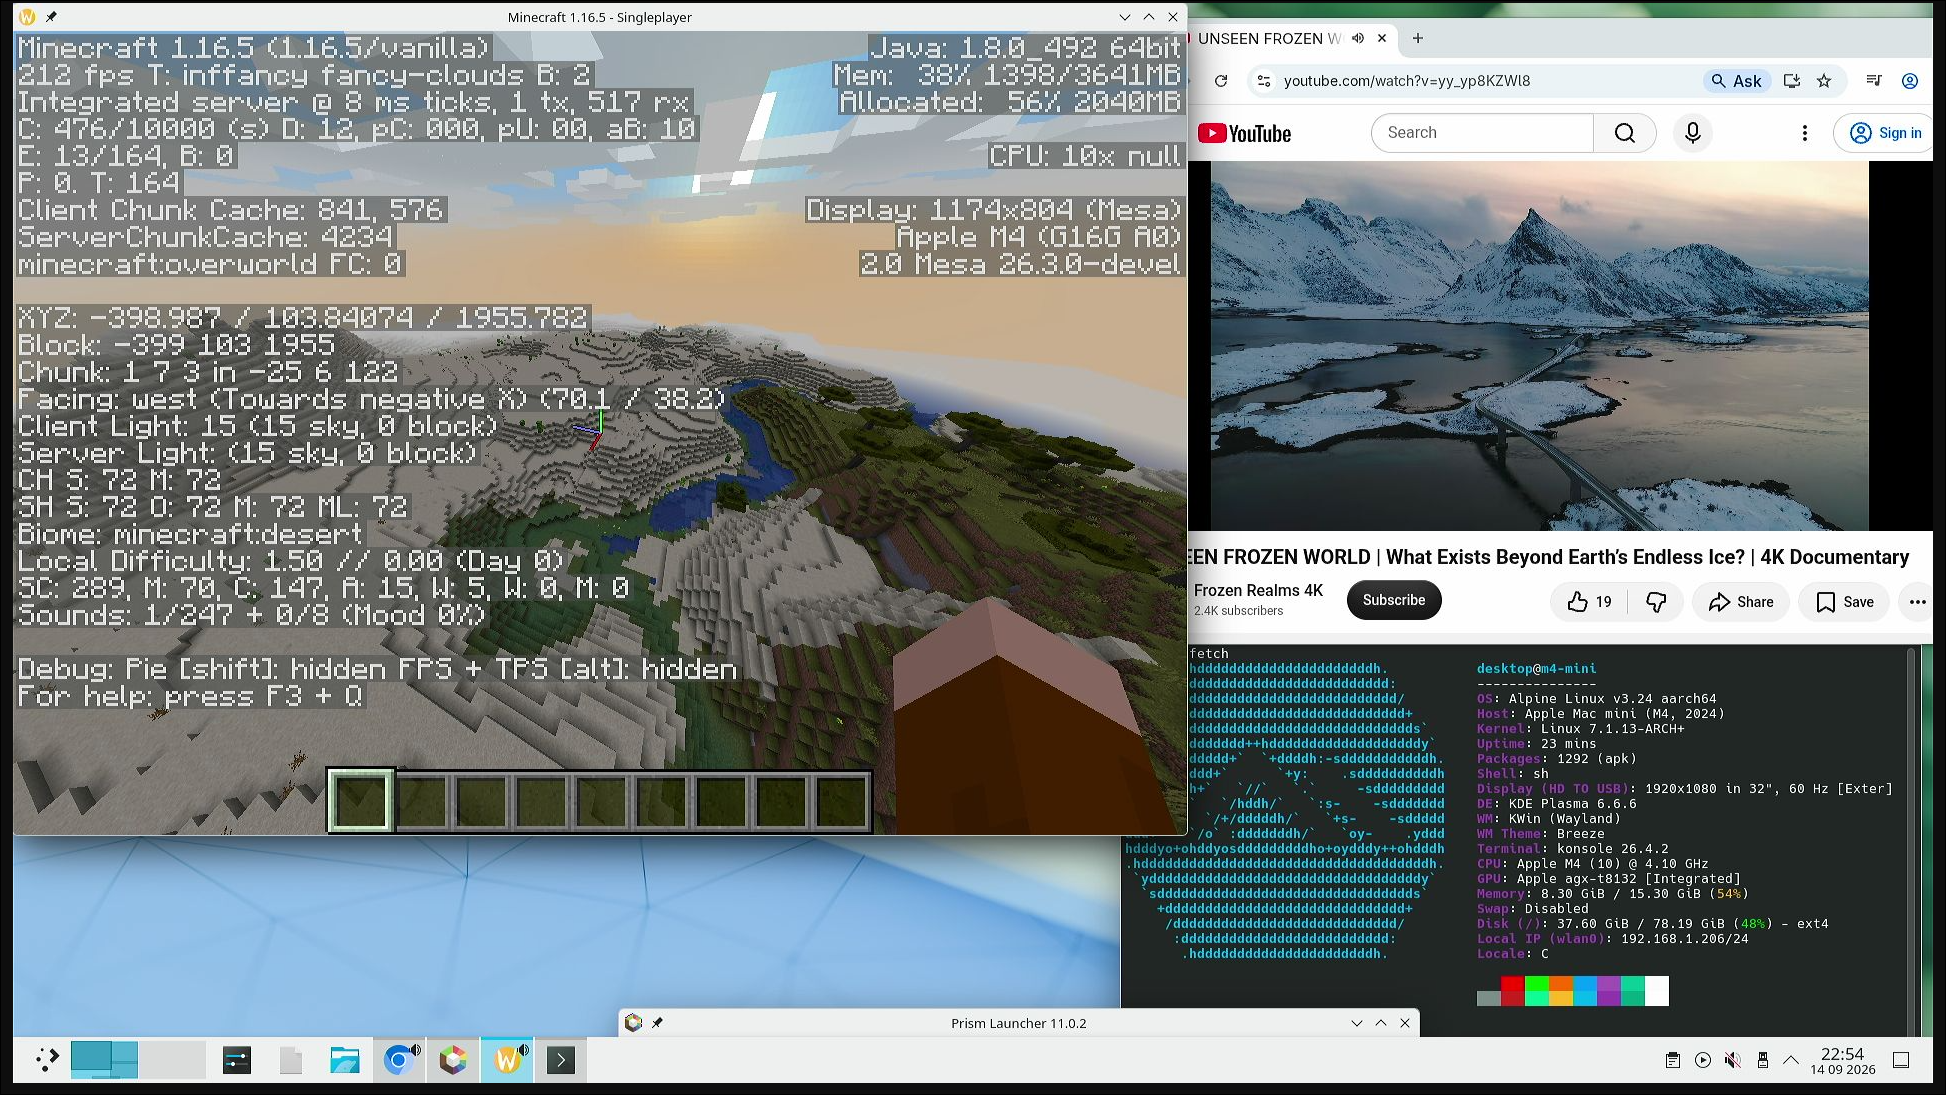
构建驱动需要逆向 AGX(苹果对 GPU 的称呼)极其复杂的固件 ABI 和用户空间组件,全程以透明、可验证的干净室方式进行。代码还没就绪给终端用户,但我们想尽快。
我们怎么做的
之前我建了 hypervisor 逆向 macOS,现在目标是对它做有用的事,比如写 GPU 驱动。GPU 是现代系统必需,否则只能 CPU 渲染,慢且耗电。目标是为 M4 Mac Mini 和 MacBook Neo 实现兼容 OpenGL(不久后 Vulkan)的驱动。通常要好几年,我们目标几天,虽乐观但几周也是大进步。几周内我们:
- 仅用实时探测逆向了 M4、A18 Pro 和(大部分)M5 用户空间,发现了苹果驱动没发出的硬件特性指令
- 建了完整用户空间驱动,包括新自定义 IR/着色器编译器、命令流构建器等
- 从我之前 hypervisor 的 trace 从头逆向了完整 AGX 固件 ABI
- 为该固件 ABI 实现了完整 Linux 内核驱动
全程没看任何苹果二进制,只看硬件 trace 和自写着色器。用户空间图形 RE 中,把所需苹果 blob 当不透明对象,让朋友写文档,我们干净室实现(基本靠盲试)。已发布所有实验供验证。
博客分用户和内核两部分。现代 GPU 驱动都这样分:内核负责固件接口、缓冲分配、调度;用户空间理解 GPU 并填缓冲。
内核空间
Apple Silicon 上内核驱动不直接碰硬件,而是和运行 RTKit RTOS 的 GPU 固件通信。所以第一步是搞清固件 ABI。这 ABI 最烦人:苹果把常规内核驱动切两半,一半放 AGX 叫固件,另一半用内存共享结构体通信,字段交错。M1/M2 共享内存树如下:
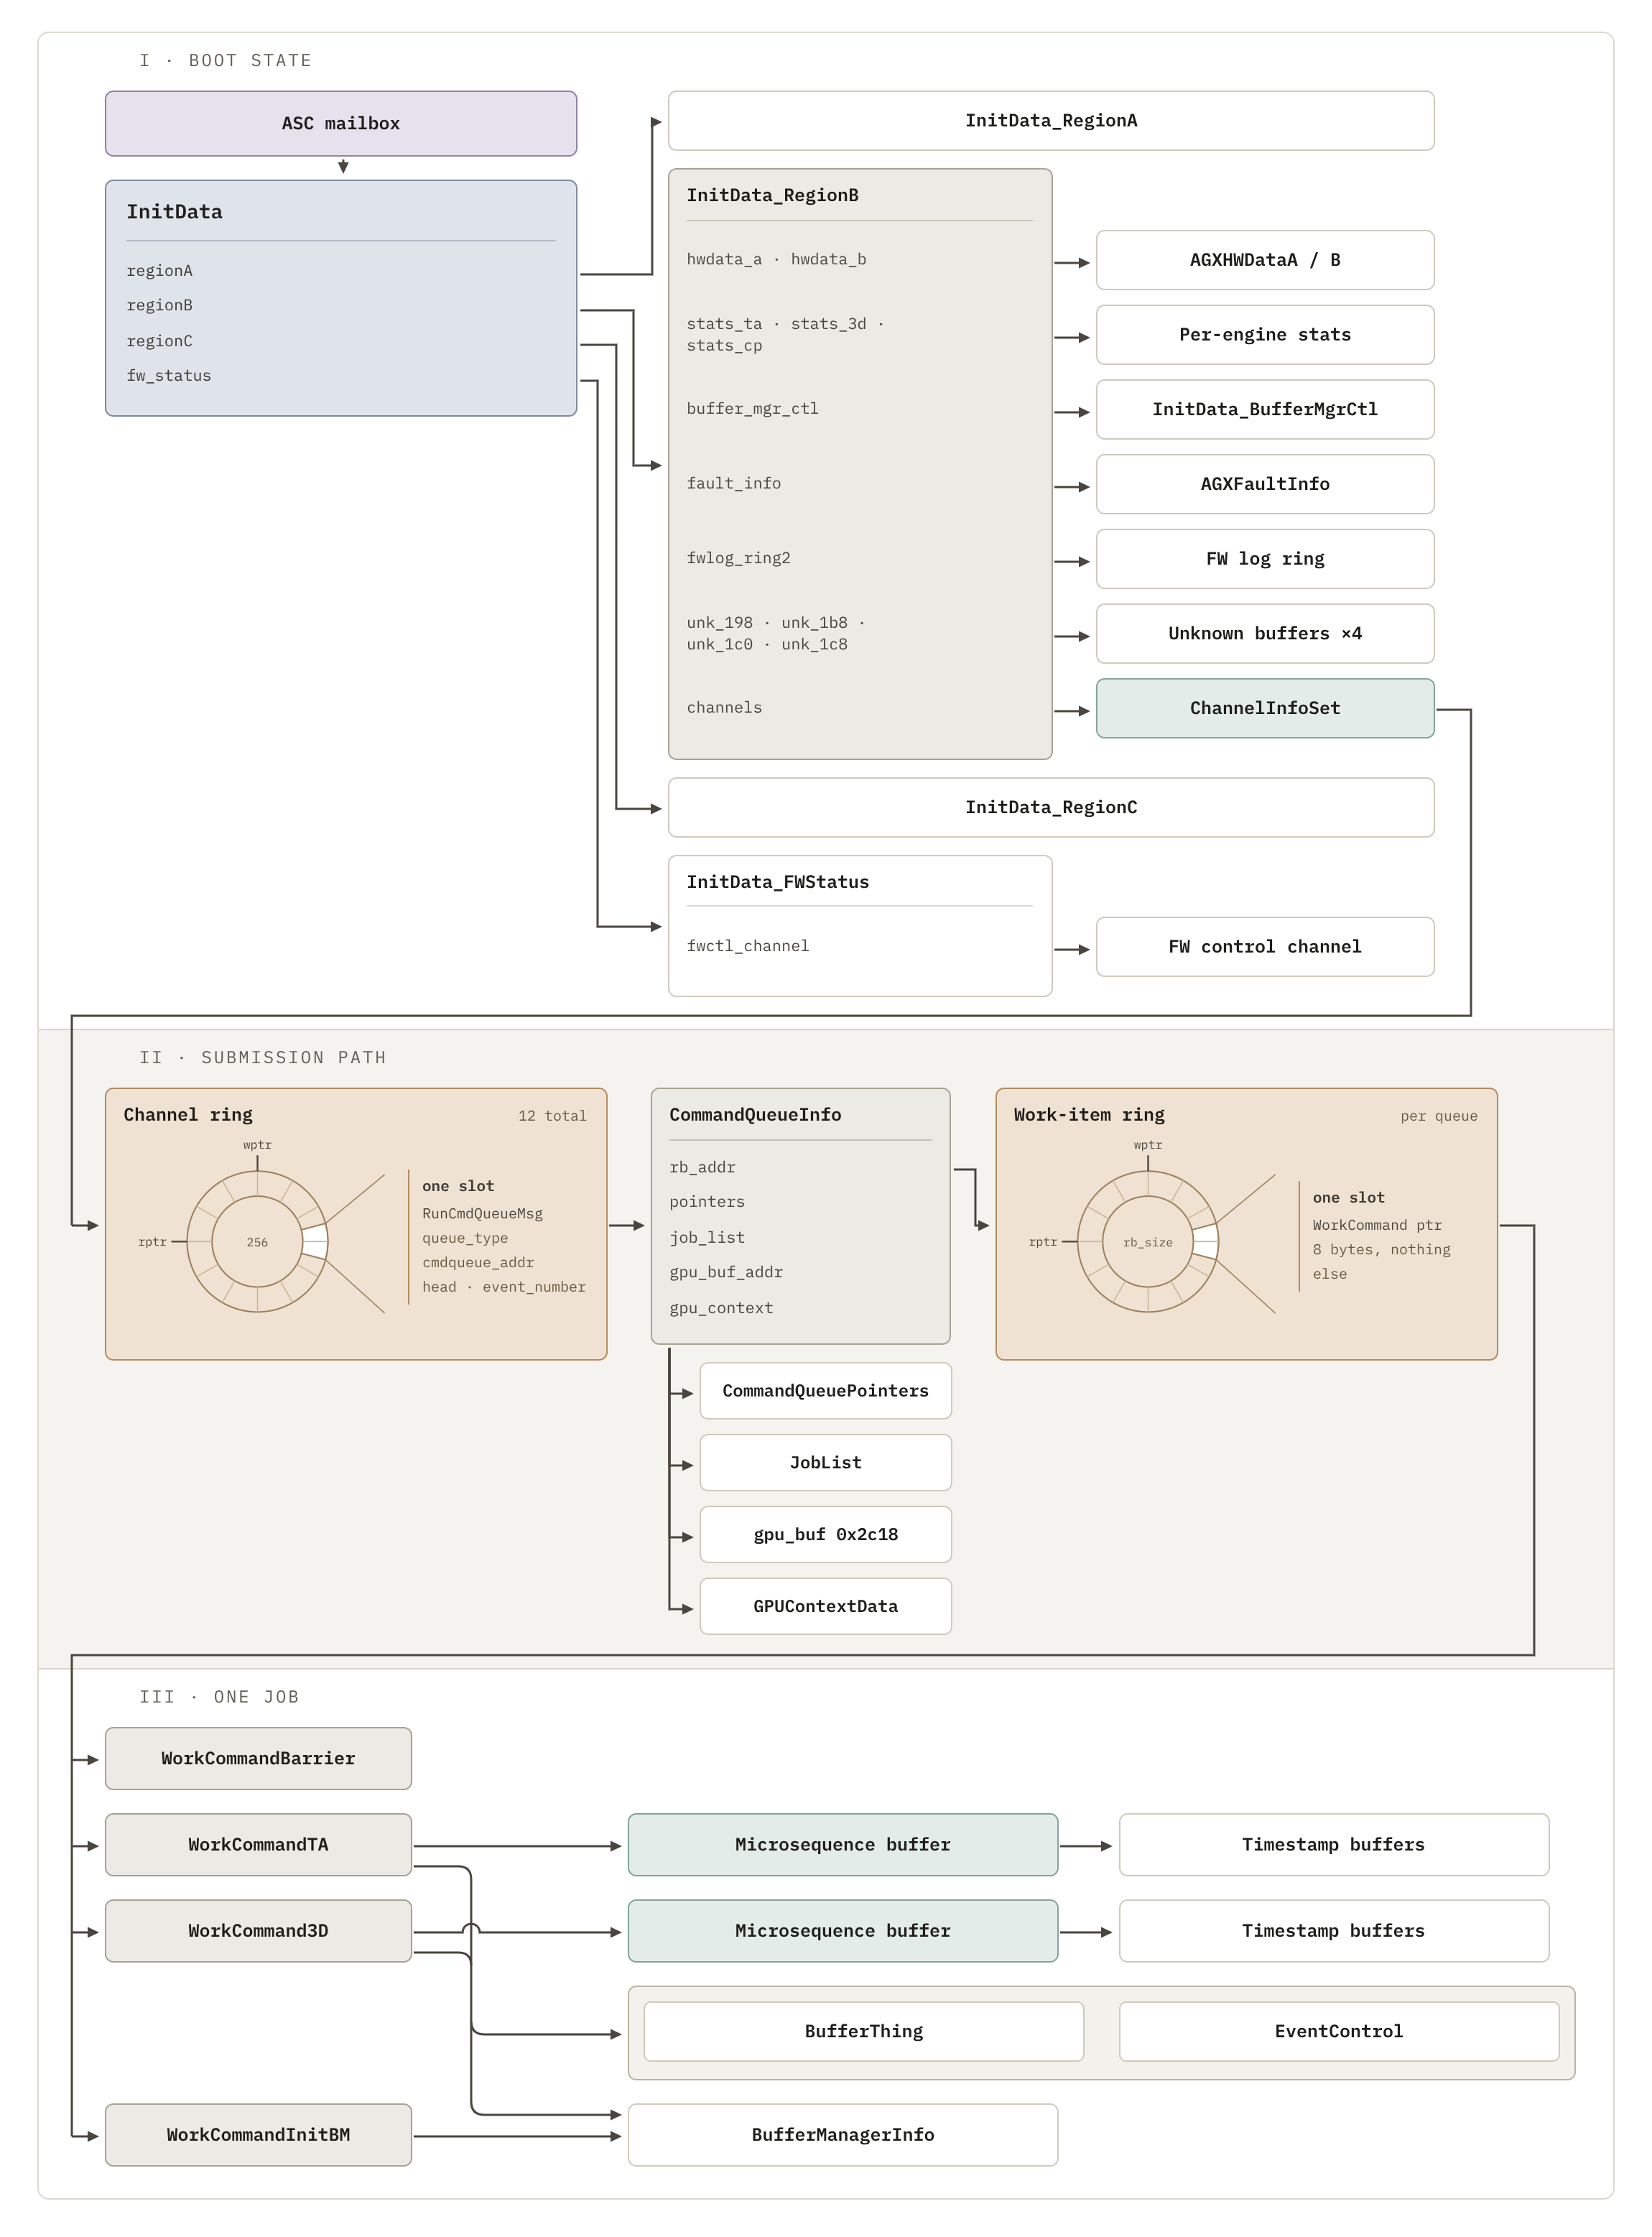
Asahi Lina 花 12 小时每天搞出 M1/M2 内核驱动。而 A18 Pro 固件 ABI 比已很复杂的 M1 还复杂得多:
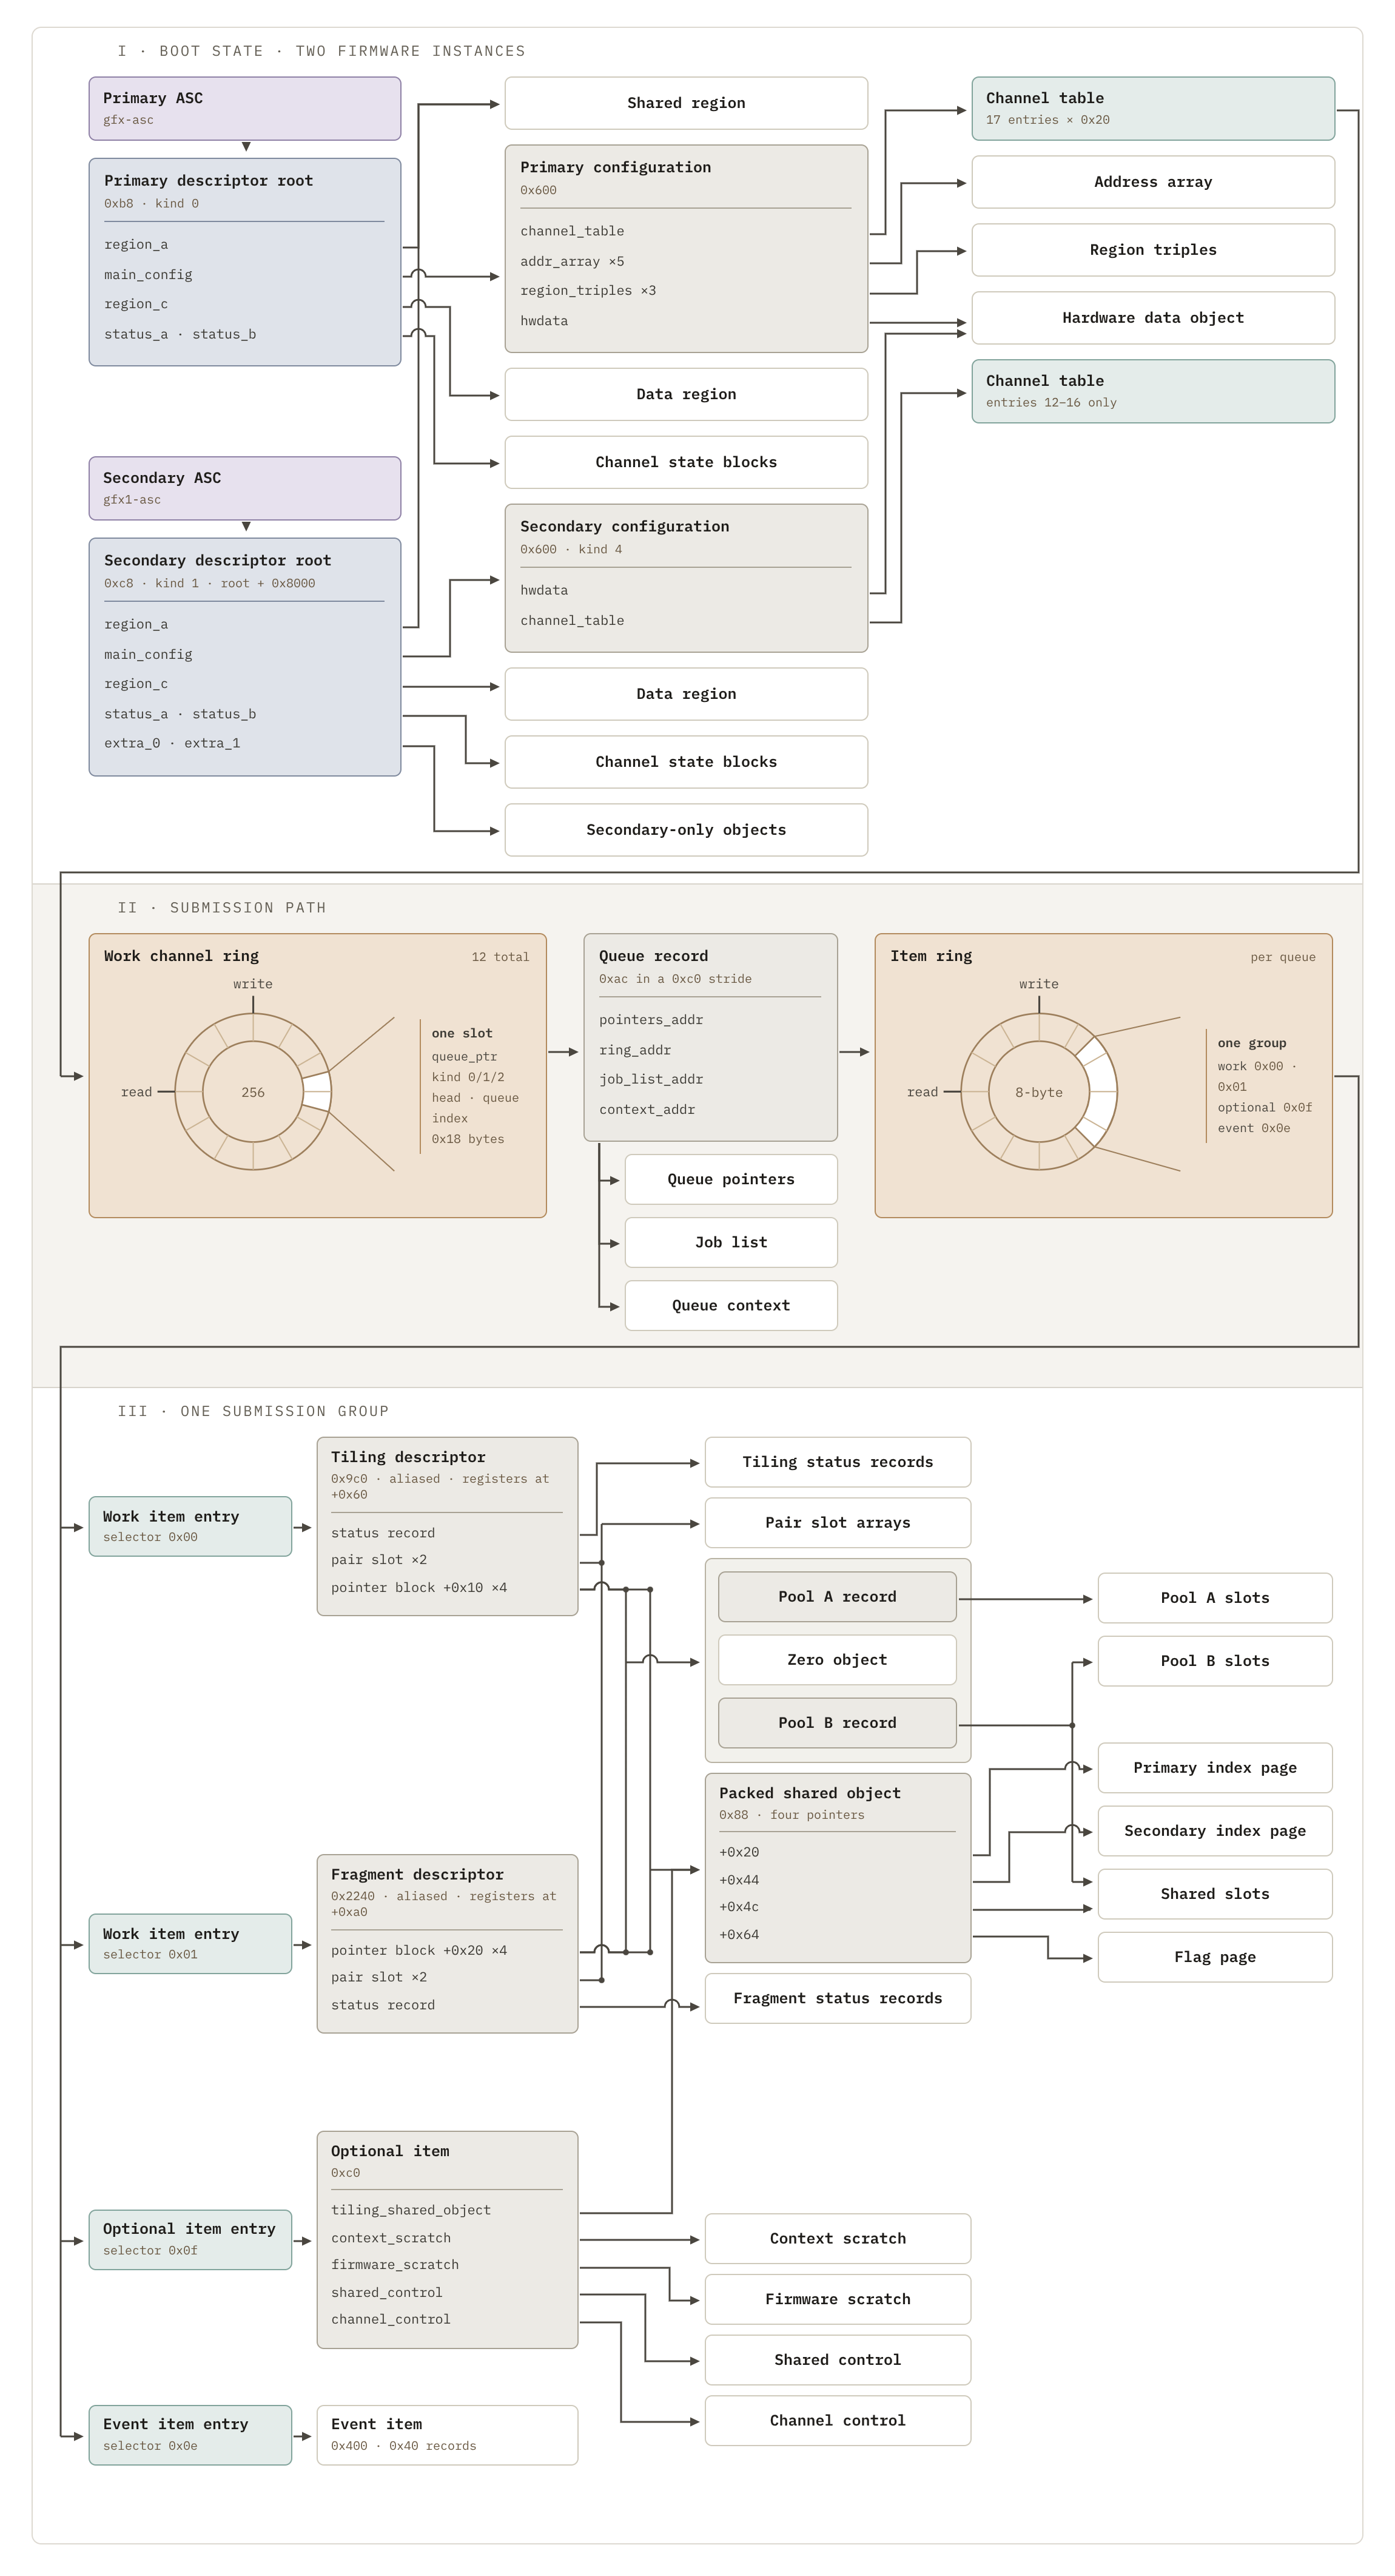
见鬼,A18 多了 1.5 倍结构体、两倍指针、更复杂的提交流程。我有些文档但不完整无用。
方法简单:看 macOS 做啥,重放,自己试,靠 hypervisor。给 LLM 说这方法,它字面重放:等固件可见事件(kicks),保存整个 GPU 内存状态,重启复制回去 kick 看输出页变,然后重构对象减页直到全从源码建。Codex 知道何时戳硬件何时抓状态。
三个主要问题都因无法干净捕获主机工作:
第一,固件启动后提交的渲染工作被 ACK 退休不执行。我介入发现 Codex 选了 AGX 生命周期太晚的捕获,改选固件启动后第一次,它立马发现缺单字节描述符。花几天。
第二,也是唯一主要阻塞问题,是计算工作。AGX 支持 compute 和 render。GUI 路径 compute 在 render 后,干净捕获 compute 负载难,336MB 无法重放。Codex 自建花一周不成功。我误以为 compute 简单没给 LLM 好任务。另一会话给出修复:
- 单用户模式禁 GUI
- LaunchDaemon 最早 Metal 可用时跑
- 跑小 Metal 程序
- 捕获重放
几小时解构,几天 compute 工作。原代码不工作原因未知。
第三,部分渲染最难。当 Tiled Vertex Buffer (TVB) 不够存几何(三角形太多),要么增 TVB 要么部分渲染(渲部分,重载缓冲完剩余)。这很挑剔。用早先工作流:Codex 重放一个部分渲染,改 Metal 着色器触发多个学会重放,然后自建。
构建内核驱动
Python 原型到 Linux 驱动三天,一天浪费因 Codex 先搞最难的部分渲染而非最简单 compute。告诉它先 compute 就顺。高层过程:
- 用 Rust 按同模式重写 drm-shim 得同步驱动
- 前端改异步,提交仍同步
- GPU 提交改异步,监听固件事件关联 fence 而非轮询
- 低垂优化如批提交
常规工程。Codex 积极用 hypervisor 调试,捕获地址空间比较,是我最爱 coding agent。
用户空间
A18 Pro 用户空间不同于 M1/M2,新描述符格式、新 ISA。用户空间 RE 过程明确:写小 Metal 程序编译运行看变,拨弄位。LLM 擅长。两阶段:第一阶段 Claude 看所有 Metal 程序建反汇编汇编理解描述符,枚举全包括 Linux 不能用的。成功但 Claude 不能自己建程序。关差距时 Claude 极差。此时 Niklas 完成 M4 drm-shim 加入第二阶段。两种方法:我优先硬件 RE 写 spec 让 LLM 实现;Niklas“Mesa first”先建 Mesa 只为功能 RE。Niklas 快得多,因我的 agent 花时间次要任务。Codex 局限:pedantic,过度彻底陷杂草。
RE 中发现硬件支持但 Metal 不支持的行为:
- 原生单指令 64 位加
- 各向异性到 128x(Metal 限 16x)
- 矩阵单元新模式
- 7 位立即数 uniform_mov
Mesa 开发
有利:Khronos CTS 已是详尽测试集。Mesa 有抽象。现代 Linux 图形栈:
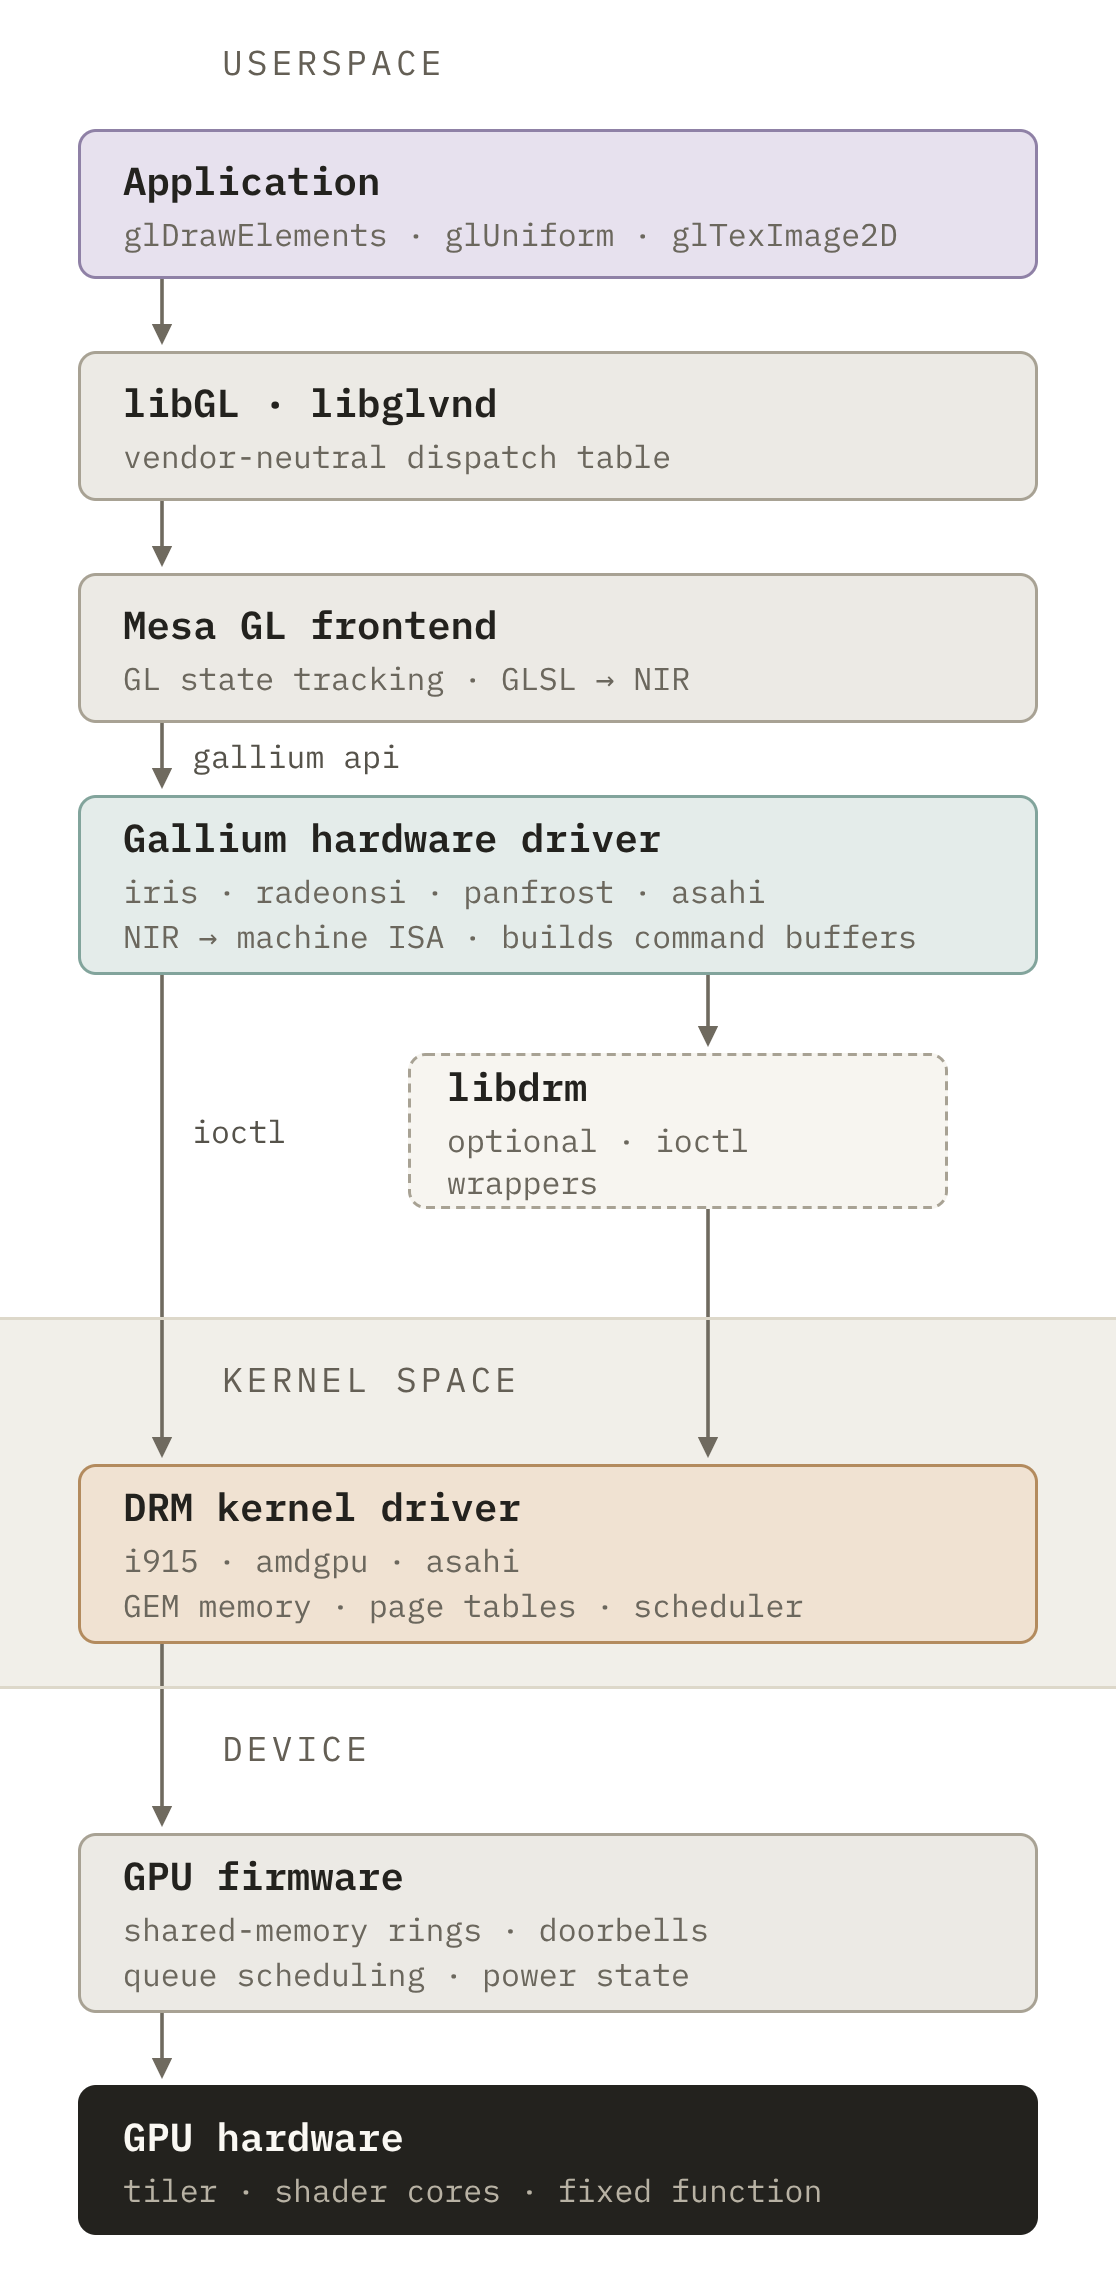
只需转 Gallium 到 AGX 语义。大任务是 NIR 到 AGX ISA 编译,可复用 Vulkan。Niklas 迭代 OpenGL 特性直到全 OpenGL ES 3.0 兼容(未过测试是可选扩展):
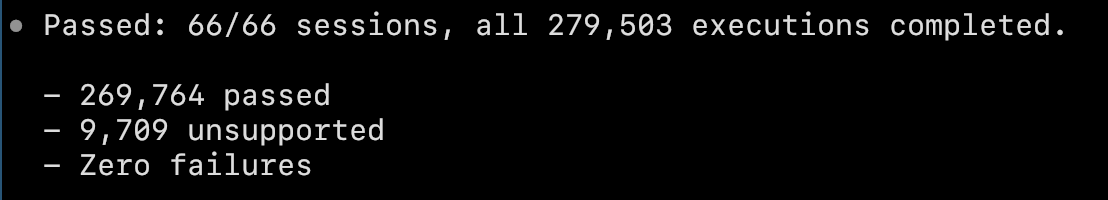
受益于 M1/M2 工作。Alyssa Rosenzweig 等是奇才。
交付物
Mesa: https://github.com/niklassheth/mesa
Linux 内核驱动: https://github.com/GravityLinux/linux/gravity-m4
用户空间 RE 文档: https://github.com/ADevWithAnIdea/agx-re 与 https://github.com/niklassheth/agx-re
剩余工作
Vulkan 1.4、OpenGL 4.6、ES 3.2、OpenCL 3.1、D3D12 (经 Proton)、光追都在内。想上游,但障碍:用未改 Asahi UAPI 无策略问题但需测试审查重构。预期怀疑因可能是首全 LLM 写 GPU 驱动,代码标准更高。人类非技术挑战 LLM 帮不了。Linux 内核驱动更大问题因 M1/M2 未上游,等其上游再上游我们。
何时能用
耐心点,我们很快会交到你们手中,可能比预期快。
附录:真的 Sam
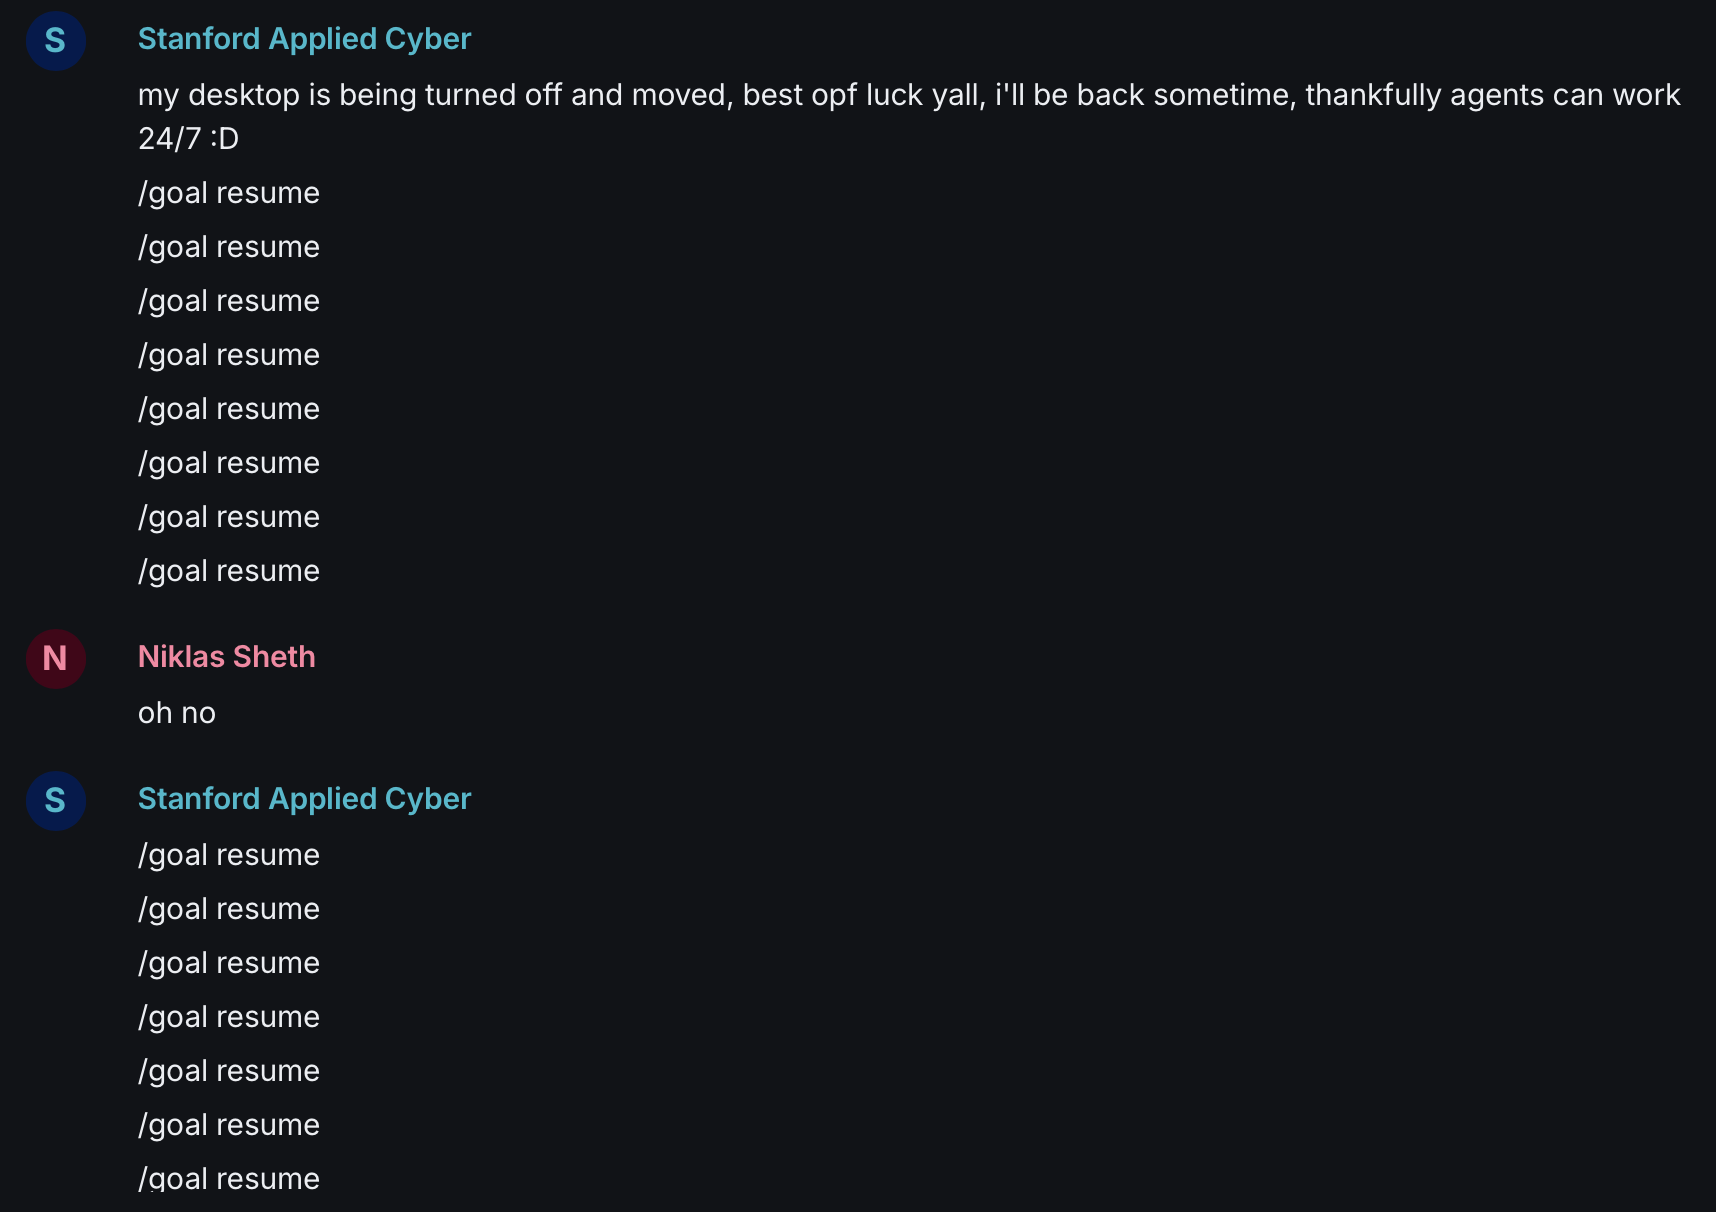
我用 Codex GPT-5.6 Sol(后 GPT-6 Astra)做内核 RE。最大问题是过度网络安全限制(我没可信访问)。99% 时间 /goal resume 够但打破无人工作流。我写了 daemon 每分钟截屏 diff 相同就输命令。误留群聊:
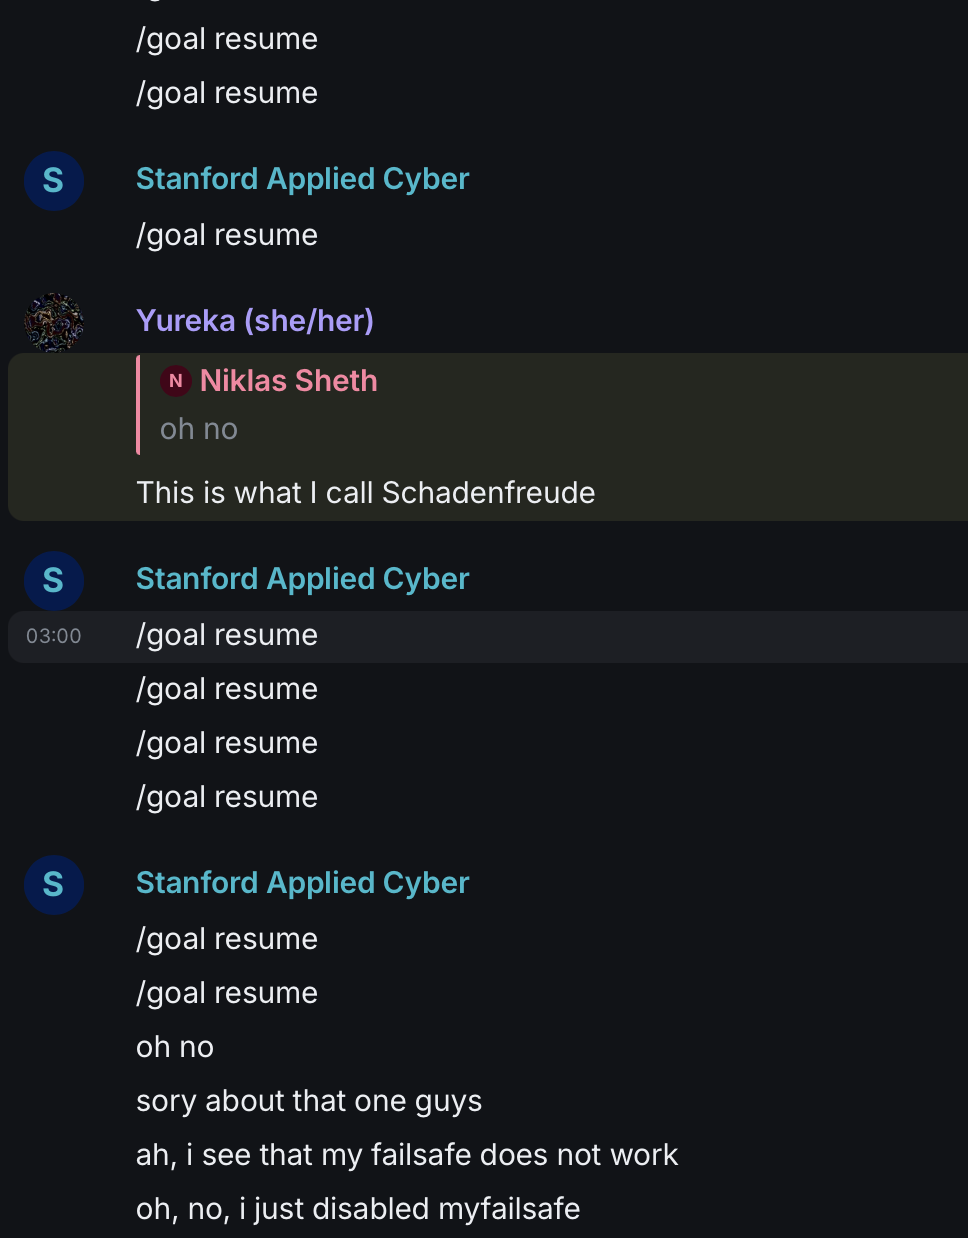
但 GPT-6 等做固件 ABI RE 极好,这 hack 值。
附录:M4 vs A18 Pro vs M5
用户空间 M4 和 A18 Pro 几乎相同,仅一值 M4 稍大(核更多)。固件 ABI 不同,A18 Pro 因第二 RTKit 更复类似 M5。M5 用户空间部分逆向,固件全逆向,原型 drm-shim 建好,推全 Rust 驱动不远。主要目标仍是 M4 Mac Mini 和 MacBook Neo。
评论
技术上的震撼是共识,分歧主轴在于这份成果是否"干净":一边认为 LLM 让逆向工程不必再花数年,另一边认为前苹果员工身份加上 LLM 训练数据的不可知性,会让代码在法律上无法进入上游。
认为这是 LLM 最值得称道的用途
- 不必再有人花几年逆向没有文档的硬件,短时间内做出能跑的驱动本身就很惊人;而且搞清硬件如何工作、如何向它提交任务,本身就是独立的重大一步(较多人) > 不用再有人花几年时间去逆向没有文档的硬件,我认为这是 LLM 最好的用例之一。(@ndiddy)
担心代码已被污染,过不了上游这一关
- 作者是前苹果员工,而苹果正以窃取商业机密起诉 OpenAI;模型训练数据里是否包含目标实现无从知晓,所以即便 clean room 并非法律硬性要求,用 LLM 做逆向也风险极高。更糟的是 Asahi 一直以 clean room 为目标,却在展示了一整页 LLM 推导出的固件 ABI 之后才说明用了 LLM,这对想保持干净的人是陷阱(较多人) > 只要存在模型训练过我最终打算重新实现的东西的可能,我就绝不会让 LLM 参与逆向工作。(@kmeisthax)
认为 Asahi 的禁 AI 政策会被现实挤到边缘
- 最大痛点正是 M3 及更新机型没有 GPU 加速,而 Asahi 有严格禁 AI 政策,这类成果无法上游;多数人只在乎能不能用,AI 辅助的分支会占据主流,只有少数纯粹主义者还守着非 AI 版本跑在老硬件上(少数人) > 大多数人只关心东西能不能跑起来,最后只有极少数纯粹主义者还坚持跑在老硬件上的非 AI 版本。(@porphyra)
认为能不能上游无所谓,公开可复现的方法才重要
- 直接放出代码和流程文档,让不在苹果的人也能把同一套方法用到 M5 和后续硬件上(少数人) > 不管你最终能不能把它上游,把代码和这套流程如何复现的文档公开出来就行。(@SXX)
认为连 clean room 的边界都说不清
- 自称熟悉知识产权的人也对"不能查看二进制产物"这条感到困惑(少数人) > 我自认对知识产权还算熟,但"不能看二进制代码产物"这一点让我很困惑。(@carterschonwald)
对模型本身的能力有分歧
- 有人认为 Astra 被削弱后已经不堪用,Sol 还撑得住(少数人) > Astra 被削弱之前也许确实强,现在它仅次于 Gemini,Sol 还撑得住。(@varispeed)
有价值的补充
- 社区补充了更关键的背景:该作者此前在一次贡献尝试中隐瞒了大量使用 LLM,并隐瞒了自己是前苹果工程师、与 Apple Silicon 开发相关人员有直接联系,因此被 Asahi Linux 封禁。
- 适用范围尚不明确:目前只对应 M4 Mac Mini 和 Neo,是否能用于 M4 Max 等其它 M4 芯片还没有答案。
- 苹果与 OpenAI 的商业机密诉讼、以及 Codex 等工具引发的争议,让"其它模型的训练数据是否同样受污染"变成无法回答的问题,这也是反对直接采信这批代码的理由之一。
- 社区情绪的一面:有人已经开始催作者下一个把 Touch ID 做了。