TypeSafe AI 的迪奥戈·阿尔梅达(Diogo Almeida)过去四年一直在追问:模型早就在聊天上超越人类,自动化却在哪里?他在 OpenAI 参与构建了让语言模型学会遵循指令、与人对话的方法,这些研究后来成为 ChatGPT 的基础,但他觉得还缺了很重要的一环。经过两年隐身研发,TypeSafe AI 今天发布首个 System One Model,以及早期访问版模型 Jev,速度比现有 LLM 快两个数量级。
正文
多年来,语言模型在聊天上已超越人类,但自动化在哪里?过去四年我一直在思考这个问题。在OpenAI时,我帮忙构建了让模型遵循指令和与人对话的方法,那成了ChatGPT背后的研究。我当时以为聊天模型会通向AGI,但炒作之下,我明显感到缺了某个关键的东西。
经过两年隐秘研发、无数技术挑战和突破,今天TypeSafe AI发布首个系统一模型(System One Model):一类为软件能直接使用的快速结构化决策而构建的前沿模型。
我们建了全新堆栈专注自动化:新模型架构、最大化效率的并行采样器,以及称为“校准决策强化学习”(RLCD)的训练方法。
首个公开模型是Jev,今天开放早期访问。在系统一任务上,Jev的智能水平与现有大语言模型相当,但速度快两个数量级、效率更高。Jev放弃字符串生成,专为结构化输出优化,且不能产生幻觉。
可将Jev视为一次前沿智能的函数调用:非结构化状态输入,类型化概率决策输出。
非凡主张需要非凡证据,请看下文 receipts。💅
新旧前沿
| | 现有大语言模型 | 系统一模型 + Jev | | --- | --- | --- | | 优化方法 | 人类反馈强化学习(RLHF)/ 可验证奖励强化学习(RLVR) | 校准决策强化学习(RLCD) | | 优化目标 | 人类偏好:标注员更喜欢的写作和聊天回复。可验证奖励:可程序化验证的输出。 | 校准决策:在系统一任务上给出认知诚实的概率答案。 | | 输入 | 非结构化数据(如文本),侧重顺序消息。 | 非结构化数据(如文本),侧重结构化程序状态。 | | 输出 | 字符串/生成文本。 字符串灵活,可以是聊天回复、代码、幻觉、拒绝,或类型安全的结构化值。软件使用需解析验证,且总有跑偏风险。 | 类型安全的结构化值。 可能输出和结构预先定义。模型绝不犯类型错误。所有答案带校准概率和置信度。 | | 采样 | 顺序。 逐token生成,每步依赖上一步。 | 并行。 单次查询生成所有输出。极高效且感知硬件。 | | 成本 | 输入token:每百万token 0.20至10美元。输出token:约输入5倍贵。 | 输入token:每百万0.042美元(每十亿42美元)。输出token:免费(便宜到不计费)。 | | 速度 | 前沿模型端到端响应时间3至329秒(链接)。对人交互够快,但集成代码中是瓶颈。 | TypeSafe端到端响应时间70ms-500ms。相同系统一智能水平下快40-200倍。 | | 置信度 | 即使要求估置信度,模型往往过度自信不一致。若任务95%成功但不说5%何时失败,就无法自动化。 | 每次输出都传达置信与不确定。校准:高置信意味高准确。一致:相似输入返回相似答案。 | | 用例 | 人机协同任务(聊天机器人、副驾、编码代理)。 需人工监督因可能跑偏。可验证问题(数学证明、内核优化)。 正确性可自动廉价检查时,LLM可生成测试迭代。演示。 字符串灵活适合偶尔可用的原型。 | AI驱动工作流/智能if语句。 结构化输出作为模糊决策规则插入普通软件:分类、路由、评分、抽取、分支。大数据Map-reduce。 海量数据转特征和洞察。实时应用。 100ms级速度用于UX关键处。验证一切。 评分、判断、验证、护栏、检测 jailbreak。 |
证据 / 技术结果
我们喜欢怀疑者,自己也怀疑。有些主张易验证:
- 每次调用速度: 我们真这么快,不过公开评测一般从西海岸笔记本运行(服务目前位于此)。
- 每次调用成本: 定价透明。无法证明未补贴;需长期证明可持续性(预计降不升)。
- 无类型错误:反例即可证伪,但数学上不可能。
对更大胆主张,提供细微说明。
并排演示
并排演示展示关键区别:Jev并行输出所有概率,而非自回归逐token。字符串强大通用但贵。“放弃”字符串反而带来超能力!
细微处:
- 早期访问者有实际查询。查询高度简化,
questions选了可读键使输出易懂。state是短密详细段落,强调采样差异,较短输入对我方有利。 - 细心者可见录制运行中唯与GPT-5.6 Terra分歧在“Churn likelihood level”,实际答案我们觉真模糊。
- 用GPT-5.6 Terra默认推理,因平均智能与Jev最可比。
- 趣闻:类似演示说服我们全力投入系统一模型方向!
工作流评测
我们新造评测衡量AI在代码中表现。不优化 ground truth 分类,不允许 harness 和模型变(防过拟合)。假设有正确计算图(代码表示“工作流”),用最大最聪明最贵外部模型预测作参考概率。
换言之:每模型同工作流,测其与最聪明模型均值(Astra和Fable)比较。
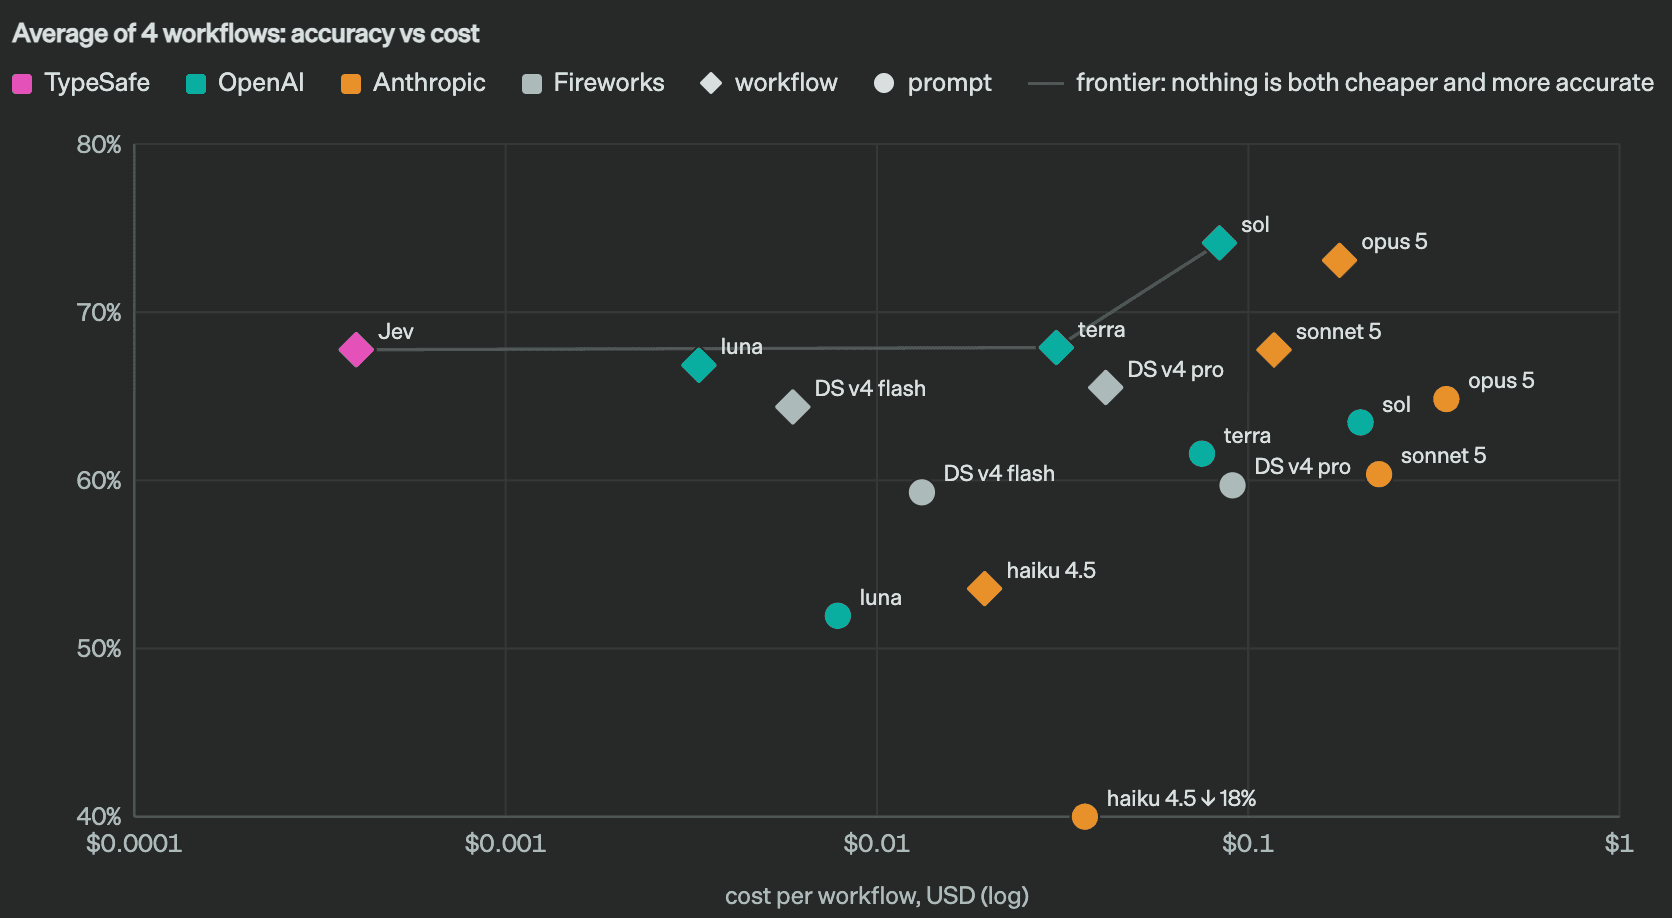
Jev一骑绝尘——几乎两个数量级占据帕累托前沿。也比用生成提示在思维链做逻辑的模型好得多。
注意此处调用比并排演示复杂,更代表真实业务自动化负载。下为发布4工作流中最简单一:
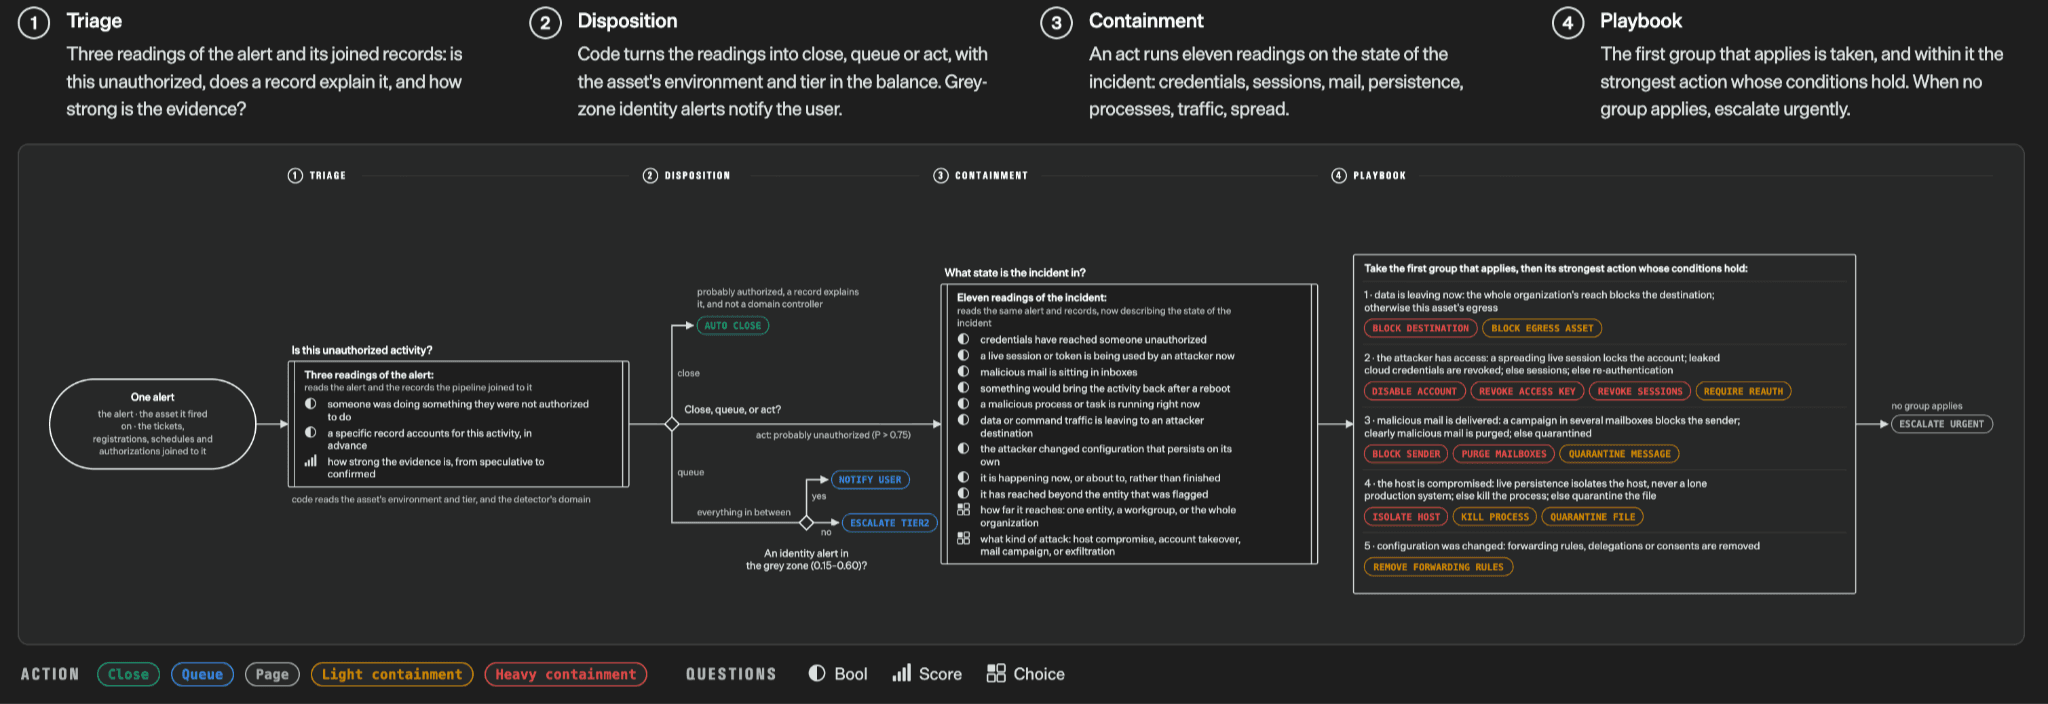
最可靠真实工作流有多独立分解问题,细粒度行为依赖概率而非离散决策。最终离散分支,但达答案需大量领域工程且高度一致。
见工作流评测站得细节。
细微处:
- 首页193.6倍快、444.6倍便宜来自此,预计是真实收益上限。
- 工作流内容非刻意构造利好,不在训练分布。但由能力团队成员做,或存偏。
- 用GPT-6 Astra和Fable 5.1均值作参考,偏OpenAI和Anthropic。可能低估我方和DeepSeek相对表现。
- LLM用System One LLM包装约束结构化决策,最准但慢贵。
幻觉与类型安全

幻觉与类型安全本质相关,后者是自动化入场券。代理中幻觉工具调用麻烦,但在有延迟保证系统或依赖链深处是绝对禁忌。现有模型无论多聪明仍幻觉和类型错。
细微处:
- LLM数字来自OpenRouter,或有偏:复杂查询可能路由更好模型。
- 我方数字非经验。模式匹配保证,故自信填0%。
趣味演示
Doom
这demo展示实时智能及代码+AI可能。工程师担心每秒10查询(约$7/小时),但我们觉低于预期!将发布深度 walkthrough 并办活动。
细微处:
- demo基于结构化状态作数据结构含文本,非图像(暂)。
- 非AI doom bot可能玩更好,但我们想要对游戏状态不同表示反应且遵循指令的bot。
Wikiracing
游戏从一维基页经链接达另一页。每步选数百至数千链接!展示每秒智能及不幻觉高基数选择复利好处。
细微处:
- 第2、3挑战始于“Rubber Duck”纯随机,作者后知。
- 此处加速比前demo小,因对非推理模式(除Astra最低推理)。Jev步数少(更聪明),为使demo耐看。LLM此任务比开推理差多。
- Jev支持基数至255。高基数用两阶段:独立评分再显式选,故偶慢。
下一步
Jev仍早期。今天开早期访问尽快移出等待名单。想听你需自动化哪些决策、Jev哪行哪不行。告我们你想建啥科幻!!
创TypeSafe因信AI需软件可依接口。盼新用例持续扩散入社区经济。
我们搞个FAQ
“系统一模型”和“Jev”名何处来?
启发自Kahneman《思考,快与慢》。模型类名取快直觉系统1与慢深思系统2区分。系统1思考暗示易错。我们相信系统一模型可更可靠。
Jev名纪念William Stanley Jevons。预期机器智能走煤路:蒸汽机效率增致需求增。智能成本每降数量级解锁更多用例。
评论
讨论整体是“技术上有意思、发布上很可疑”:不少人认可非生成式、类型安全输出在分类和评分类任务上的成本与速度潜力,另一些人则认为基准、演示和架构说明不足,且它与 LLM 根本不是同类,不该被包装成通向 AGI 的突破。
看好它在分类、评分等结构化任务上替代部分 LLM 调用
- 有人估计在具体业务流程里可替换四到七成的 LLM 调用,把对应 API 成本降一个数量级;也有人说自己从 LLM 批量分类转向嵌入加余弦相似度后省钱但精度下降,若这类模型能提供同级分类能力就很合适。(较多人) > 我去年把百万级转写文本的分类从 LLM 换成了嵌入和余弦相似度,成本和速度省了很多,但准确率不如 LLM;这东西可能正好补上精度。(@jawns)
- 有人主张大量业务最终要的就是一个分数或类别,而不是生成一段文本,所以并行推理并非纯噱头,只是适用面窄。(较多人)
- 也有人肯定它不会类型错误、不会编造数据,但仍可能判断错误,因此无生成能力既是卖点也是限制。(少数人)
质疑公开基准和实证不足,认为营销大于证明
- 有人批评 RLCD、并行采样等只有术语没有证据,速度对比也被指苹果比橘子:如果它跳过生成做窄任务,当然比长链思考的 LLM 快。(较多人) > 这些说法目前都像营销词,RLCD 和并行采样拿不出支撑;除非 LLM 基线在做可比工作,否则速度对比不公平。(@ramon156)
- 官网不放公开基准,只说产品更新时做一次性评测,被解读为“成绩好早放了”。(较多人)
- 演示只有动画,没有实际代码和调用方式;文档也没讲清 System One 任务与查询是什么、模型多大。(较多人)
- 输出 token “免费”与 LLM 输出 token 更贵的对比让人困惑,被指口径不一致。(少数人)
认为它和 LLM 不可比,更不构成通向 AGI 的路径
- 有人指出 LLM 输出字符串,可聊天、写代码、拒绝、幻觉,再解析验证;Jev 输出预先定义的类型安全值,带校准概率和置信度,二者不是同一层级。(较多人) > 这不是能跟 LLM 相提并论的东西:LLM 的大多数用途是生成事先不必定义的可靠文本,而 Jev 把输出结构完全限定死了,把它吹成 AI 下一步很离谱。(@kypro)
- 有观点认为其限制注定缺乏 AGI 所需创造力,视频全是营销;但 niche 场景恭喜团队。(较多人)
- 更准确地说它是仅编码器式专用工具,可被 LLM 调用来做专项任务,本身不算 AI。(较多人)
猜测架构是仅编码器式、非自回归的结构化预测模型
- 有人从描述推断它是偏仅编码器的 transformer,带标量或序数输出头,可能非因果、非自回归。(较多人)
- 文档显示输入是状态和选择、评分或 Noul 型问题,输出为选择、概率和置信度,RLCD 可能作用在预训练基座上。(较多人)
- 有人问是否可喂不完整文本并求下一字符概率,或输出 token 数是否预先固定、因此无法任意生成字符串。(少数人)
- 有观点认为用 AST 可做代码,但更优编码器加下一潜在表示预测的 LLM 最终会击败这种架构。(少数人)
希望它通过 OpenRouter 或 AWS Bedrock 等现成渠道提供
- 有人不愿直接新增供应商,因为隐私安全、合规采购流程麻烦;若通过 AWS 这种已有供应商引入,技术团队能更快采用,中间商加价也值得,尤其成本可降一两个数量级。(较多人)
- 也有人认为用 LLM 做大规模自动化很烦,前沿模型不断弃用,自托管又贵,混合多家更麻烦,因此这类专用模型有吸引力。(少数人)
对发布材料和网页体验不满
- 有人吐槽发布视频里服装换来换去、网页文字渲染像画布加描边,读起来费眼,进一步强化包装过度的印象。(较多人)
- 有人用“这是真的还是幻想”调侃,代表社区半信半疑的情绪。(少数人)
有价值的补充
- 有评论指出文档比主页更清楚:模型接收状态和选择、评分或 Noul 型问题,可加增强,输出选择、概率和置信度;RLCD 似乎是在预训练基座上做。
- 有人猜测若给它 AST,它可用于代码分类或结构化判断;但长期看,具有更好编码器和下一潜在表示预测的 LLM 可能超过这种专用架构。
- 有人提出一个有趣的安全问题:这类模型是否仍会受提示注入影响。
- 有开发者说自己做过类似东西,结论是没有生成能力会极大限制用例,且模型虽不能幻觉,但仍会错。