我们正在开源 dbt图表(dbt Charts),一种仪表板声明式语言,让聊天构建的仪表板也能受治理。数据 AI 已来,自助分析实现,有数据连接者一下午聊出报告,结果惊艳。但摩擦快现:智能体默认把报告变 HTML 等文件堆及 React 或 Streamlit 应用,溯源跨多语言文件,审计慢且改动耗智能体时间 tokens。BI 工具则将 copilots 绑到 UI 优先应用,使 AI 在受治理但窄轨上,智能体仅能做 UI 暴露的事。
正文
我们开源了 dbt Charts,一种用于看板的声明式语言,让通过 agent 聊天做出来的看板也能被治理。
数据 AI 已经到来,长期承诺的自助分析终于发生。任何有数据连接的人,一下午就能聊出一个报表,最初的结果很惊艳。
但摩擦很快出现。默认情况下,agent 会把一个简单报表变成一堆文件:HTML、CSS、JavaScript、几个图表库,一旦要上线还得加上 React 或 Streamlit 应用。想把结果追溯到源头,得穿过多种语言和文件,人审计慢,agent 每次改动都要花时间和 token。
BI 工具走了另一条路,把 copilot 绑到 UI 优先的应用上。这样 AI 留在治理轨道上,但轨道很窄:agent 只能做 UI 暴露出来的事。
所以今天你要么选代码的混乱自由,要么选 BI 工具的狭窄控制。我们做了第三种选择。
拆解 BI
dbt Labs 创始人 Tristan Handy 最近在《BI 的第二次拆解》中写道:
我入行时,BI 工具是全家桶。所有事情都在一个产品里发生:数据摄入、转换、计算、缓存、语义、可视化、身份。BI 工具就是数据栈。MicroStrategy、Cognos 等不只是可视化工具,而是集成的数据平台。
然后现代数据栈发生了。大约 2015 到 2022 年,这些基础设施层被抽出来,变成专用基础设施。计算去了 Big 5,摄入去了 Fivetran,转换去了 dbt。BI 工具剩下:可视化、交互式分析界面、语义定义(有时)、身份与访问管理,以及 Web 托管。
拆解后留下的是今天的 BI 工具,图表是其中最大一块。它们留在 UI 里有充分理由:对多数人来说,点击比写 YAML 快。但越来越多图表不会由人来做。随着前端和一切的用户越来越是聊天 agent,这个偏好会翻转。Agent 精通代码、SQL 和 Git,在别人的 UI 里很笨拙。所以图表需要搬到 agent 工作的地方:代码里。
图表走出 BI 工具
今天我们迈出拆解 BI 的下一步:开源 dbt Charts,把图表从 BI 工具里拿出来,放进代码,具体说是一种新的结构化 YAML 语言,可以用一个可审计的 YAML 文件声明完整交互式看板。和 agent 自由聊天,做出来的东西有代码的自由,同时容易读。
在 dbt Charts 中,SQL 仍是声明想看到什么数据的语言,我们把它包在 YAML 里,声明想怎么看。
我们花很长时间把语言提炼成少数核心、可扩展的元素:表达深,易组织,易读。YAML 包的不止 SQL。Markdown 承载文字,Jinja 像在 dbt 里一样承载变量和宏。
一个小例子:一个变量(UI 筛选器)、一个查询和一张图。variables 里的 status 指向 main.documents.status;queries 里的 docgrowth 按月统计文档数,并用 filter 应用 status;charts 里的 growth 是面积图,x 为 month,y 为 numdocs;rows 只放 growth。这个文件就是整个看板。CLI 把任何看板文件渲染成静态 SVG,或 HTML、PNG、PDF,甚至终端,在本地或 CI 中运行,并把一文件夹看板作为站点服务。dct render charts/documents.yml --format svg 可换成 html、png、pdf、terminal,dct serve 启动站点。
这些元素很深:今天有 1100 多个配置项,覆盖十六种图表类型,以及由它们构建的组合图表。像任何好语言一样,它能表达复杂布局和视觉效果。
你很少手动设置这些选项。样式会级联:图表从看板继承,看板从主题继承,换主题只需一行。看板也可以 extends 另一个看板,所以一套公司风格或标准报告写一次,处处继承。看板保持简短,主题化保持便宜。
与 dbt 深度集成
不一定要和 dbt 项目一起用 dbt Charts,但一起用时能解锁很多。图表层直接坐在转换层上,集成越深,改两者越容易。
用 dbt Charts 时,charts/ 目录和 models/ 在同一个 Git 仓库里,所以模型和它的图表改动在同一个分支发布,同一次 CI 运行,并在到达生产前失败。
查询通过 ref() 访问模型,由 manifest 解析,所以重命名模型或缺失列会让造成问题的 PR 失败,在 dbt run 重建仓库之前:dbt parse && dct validate charts/。计划支持 dbt Semantic Layer,看板可以直接使用项目定义的指标,而不用重写 SQL。可关注 dbt-labs/dbt-charts#1。
为聊天而建
Agent 可能很盲,紧密反馈循环最有效。dbt Charts 给了它:严格校验 YAML 和 SQL,以及大量可视化检查,在任何看到看板前标记问题。
渲染时可能警告: WARN-BAR-BAND-WIDTH-TOO-NARROW 182 bands x 2 series across 640px Fix: roll up to a coarser grain.
WARN-TABLE-COLUMNS-OVERFLOW Table needs 980px but only 640px is available. Fix: drop columns or widen the slot.
一个美丽、连贯的报表系统
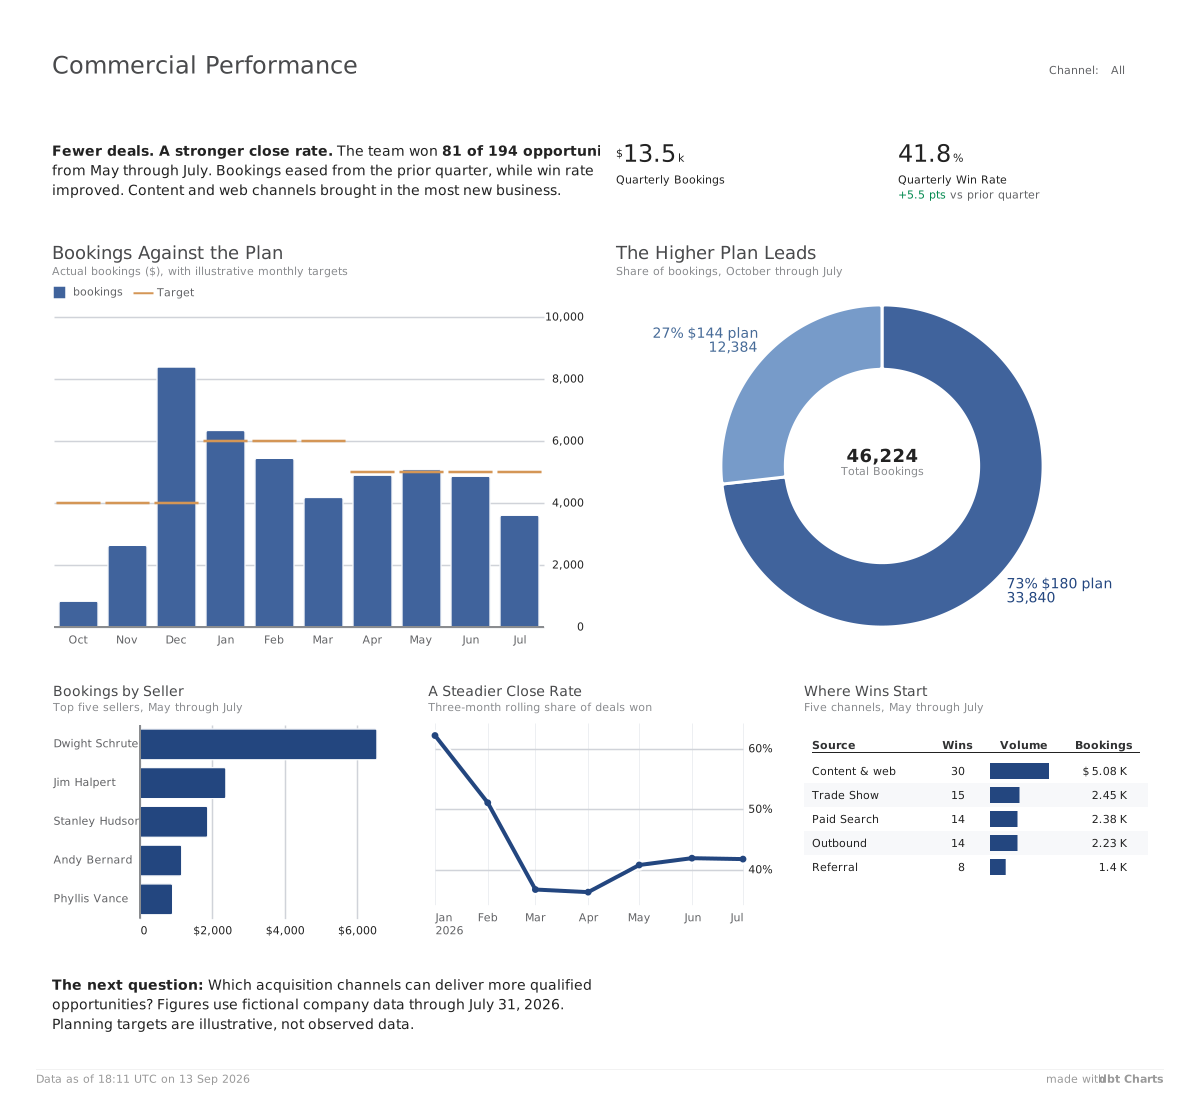
我们希望 dbt Charts 像 dbt 一样,成为其数据栈层的开放标准语言。我们为人和 AI 一起构建的未来设计,希望它看起来像那个未来,而不是另一个看板网格。我们请来数据图形设计师、作者和历史学家 RJ Andrews 设计图表。他对这门手艺历史的把握,让结果感觉新:越过看板时代,回到人们用心画图表的样子。
许多工具用卡片和方框作弊,假装对齐,代价是视觉噪音和空间损失。我们推敲了每张图表的间距、尺寸和布局,单独看和与邻居一起看。
结果是一套连贯的图表系统,比当前 BI 高一个层次。
除了开源语言,今天还公测 dbtCharts.com:一个托管平台,承担 BI 的其余部分。图表被抽走后,剩下主要是托管、访问控制和 UI。这些按性质也许无法拆解,或至少不该拆,所以平台在开源语言之上处理它们。
平台连接你的仓库,加入对话式分析、做最后润色的可视化编辑器、版本历史,以及面向用户和组的权限分享,所以看看板的人不需要仓库登录。
当然,这些图表是为聊天而建。平台有一流的对话式分析:像 Claude 或 ChatGPT,但有对仓库的授权只读访问,内置专家分析师的技能和工具。通过聊天用图表探索,随时点进去微调并保存看板。
因为建立在开放语言上,无论来自聊天、可视化编辑器还是代码,每个改动都落到 Git 仓库中同一份 YAML。没有锁定:同一看板能在你笔记本、CI 和平台上运行,团队可以自助,手边有 agent,而不会创建第二个隐藏数据栈。
试用 beta
dbt Charts 语言在 Apache 2.0 许可下开源,你可以在本地编写、渲染、服务看板,无需创建账号。自己安装,或给编码 agent 一行:
终端:uv tool install dbt-charts
Claude / AI:用 dbt Charts 给这个做图表。开始:uv tool install dbt-charts && dct skills intro
- 代码:github.com/dbt-labs/dbt-charts
- 文档:docs.dbtCharts.com
- 托管 BI:dbtCharts.com
- 社区:dbt Community Slack 的 #dbt-charts
dbt Charts 是 pre-1.0,仍在变化。语法变化时,看板在解析时迁移,所以今天写的看板会继续渲染。试用,告诉我们缺什么,加入 Slack 的 #dbt-charts 讨论,帮我们构建开放数据基础设施一直在等的图表层。
评论
社区对 dbt Charts 以代码声明仪表板的可审计性总体欢迎,但不少人质疑其用 YAML 作为方言的创新性与技术合理性,并指出 Vega-Lite 等已有类似方案。
认为用声明式代码解决 AI 仪表板难审计问题是正道
- 人工智能代理常产出自由格式图表,难以审查与扩展;以类似 Markdown 的 YAML 方言描述仪表板,可读、可维护且能确定性复现,顺应开放 BI 趋势。(认可度:较多人) > 在大量随意生成的图表垃圾中它像一座灯塔,能确定性地复现同样仪表板。(@mollifier14)
质疑其创新性并指出现成替代工具
- 商业智能早已解耦,人工智能可生成任意格式报告,YAML 本身并非革新;Vega-Lite、Evidence、Observable Framework 等已实现仪表板即代码,部分人更偏好 Markdown 加 JS 的方案。(认可度:较多人) > 它整洁但假装比实际更创新,商业智能已经解耦,人工智能生成 Excel 或 Power BI 报告早已可行。(@dgudkov)
反对将 YAML 用作领域特定语言
- YAML 并非真正编程语言,条件与变量绑定在其中极为笨拙;既然有语言模型应生成真正的计算语言,且 YAML 隐藏数据关联会徒增 ETL 负担。(认可度:少数人) > 重申一遍:YAML 不是编程语言,有语言模型本应做得更好,而非定义一种 YAML 加模板的所谓语言。(@carterschonwald)
认为统一生成式 UI 规范终将被模型进步淘汰
- 模型会越来越快且更少错误,直接使用基础库单步生成界面更为灵活,这类“一统规范”长远看毫无价值。(认可度:少数人) > 所有人都想搞出统治生成式 UI 的万能规范,但惨痛教训会咬人,模型单步生成原始库的能力将让这些作废。(@ramesh31)
有价值的补充
- 将邮件视为 BI 问题加以提取与多视图展示,反映知识工作工具“解耦 BI”的延伸趋势(@nzoschke)。
- 数据可视化极易出错,专业数据设计师的介入仍不可取代(@dgudkov)。
- 先前评估基于 YAML 的 OLAP 工具时发现不少陷阱,图表层不可见数据关联会迫使大量本可避免的 ETL(@carterschonwald)。