从RustConf回来的路上,作者分享了在Unconf上关于async应用调试和基准测试的讨论成果。Tokio运行时的性能表现并没有硬性规则,答案往往是“视情况而定”——工作负载的性能取决于同时运行的其他任务,这也是许多问题只在生产环境才显现的原因。编写高性能的async应用,实际上是在公平性与批处理、竞争与隔离之间寻求平衡。
正文
高性能 Tokio 应用的准则
编写在 Tokio 运行时上表现良好的代码很少有硬性规则,很多问题的答案都是"看情况"。工作负载的性能取决于那一刻运行时上还在跑什么。这就是为什么很多问题只在生产环境才出现!写出高性能的异步应用需要在公平与批处理、竞争与隔离之间取得平衡。
这篇文章阐述一些通用原则,并尽可能覆盖例外情况。假设读者对 Tokio 的工作窃取运行时有基本了解;附录中有一个高层概述。
通用原则
首先确定你是否真的有这个问题
如果你开始在一个 Tokio 应用里找各种问题,你肯定能找到。我见过的几乎每个实际应用中,poll(代码在 .await 点之间让出回运行时的时间)都远超过 Alice Ryhl 在她那篇出色的文章 What is Blocking? 中建议的 10-100 微秒。这些问题可能影响、也可能不影响你真正关心的应用指标或行为(参见:有时候长 poll 是可以的)。重要的是从你想改善的真实指标倒推。比如,一个应用可能有完全无害的长 poll,"修复"它们并不会对面向用户的指标产生可测量的影响。
我遇到过的问题中,绝大多数是应用代码本身的问题,通常是分布式系统多个组件之间的交互问题(而不是 Tokio 本身的问题)。dial9 给了 Tokio 很大的可见性;它发现 Tokio 问题的时候,至少同样频繁地明确展示了其实根本 没有 Tokio 问题(这让人们有信心去别处找原因)。当然,有时候确实是 Tokio 的问题。
在 Tokio 的指标中,最有用的是最近添加的 schedule latency histogram。调度延迟是指任务准备好运行(比如 socket 有数据了)到 Tokio 实际 poll 这个 future 之间的时间。虽然这不能告诉你原因是什么,但调度延迟是 Tokio 与代码之间不良交互最常见的症状。
延迟要拆分,吞吐要批处理
为了优化延迟更频繁地让出
在大量请求中实现低延迟需要连接之间的公平性。
以 Redis(或其他支持请求管道的应用)为例。一个 naive 的实现会在有更多数据时直接从连接读取。当请求被管道化时,整个管道请求(或大部分)会进入内存缓冲区。当你从缓冲区读取帧时,每个都会是 Poll::Ready(不需要回到网络)。这既造成了长 poll,也造成了客户端之间的不公平。
对吞吐量的影响通常较小:处理的请求数量相同。然而延迟变化显著,因为一个完整的管道可能在另一个后面等待。在每个请求后显式让出可以将这个例子中的延迟降低大约 10 倍。做得更好的方法是只在连续几次立即就绪的读取后才让出。
``` async fn handleconn(&mut self) -> crate::Result<()> { while !self.shutdown.isshutdown() { let frame = tokio::select! { res = self.connection.read_frame() => res?, _ = self.shutdown.recv() => { return Ok(()); } };
    execute_command(&self.db, &mut self.connection, frame).await?;

    // 为了提高公平性:
    // tokio::task::yield_now().await;
}
} ```
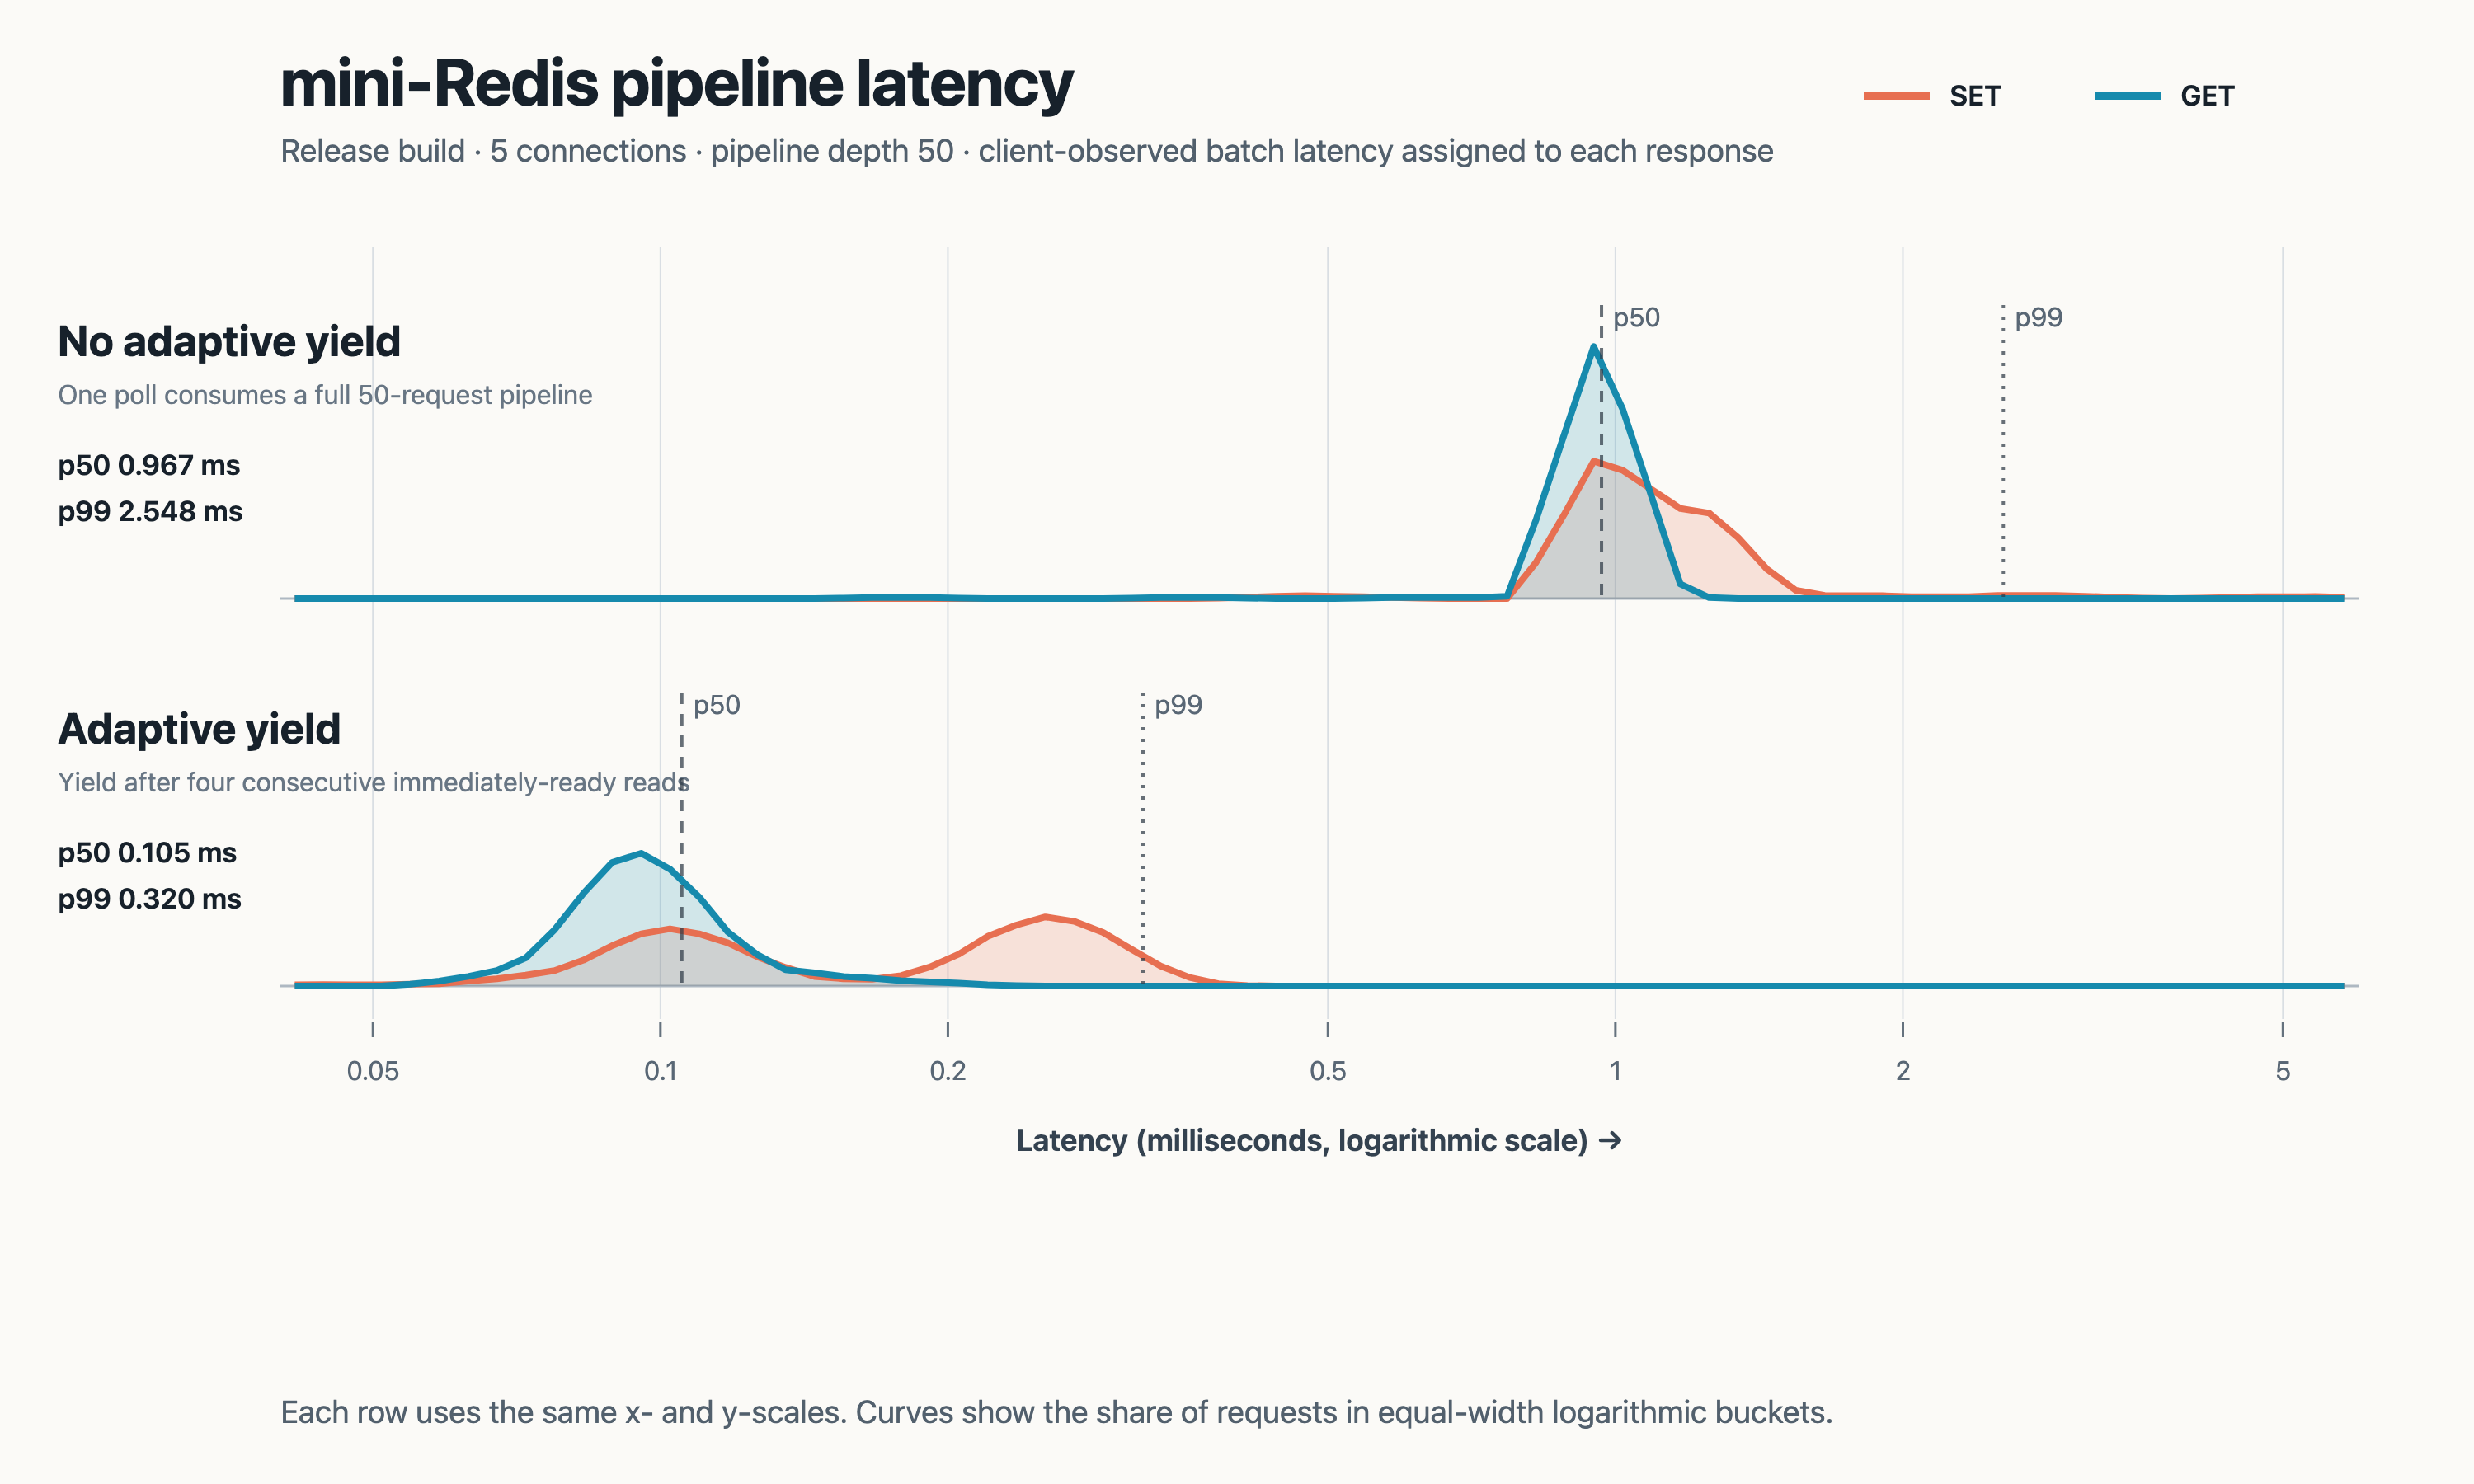
在四次连续立即就绪读取后让出,使管道请求公平得多,同时没有完全放弃批处理。
批处理工作以摊薄开销
公平性不是免费的。每一次运行时事件——切换任务、poll、在 worker 之间移动、切换线程——你能做的有用工作越多,应用就越高效。
tokio::fs 可能是最好的例子。我有时甚至会说"tokio::fs 是有害的"。没有 io_uring 的情况下,Tokio 在阻塞线程池上运行每个文件系统操作。每次调用 spawn_blocking 也有开销,而且每个运行时都有一个共享的阻塞池。
如果你知道要执行一系列文件系统操作——或任何阻塞工作——将它们批处理成最大的合理阻塞段。在某些情况下,专用 OS 线程更合适。
这个原则适用于任何与 Tokio 交互的地方。如果你知道要把工作发送到全局队列,批处理也可以摊薄那个协调开销。
即使快如 spawn 一个任务也不是免费的!spawn 一个任务是便宜的,但如果你 spawn 了成百上千个任务,每一个都代表运行时必须单独处理的工作。每一个都增加了被调度延迟影响的机会,增加了运行时需要处理的独立 poll,以及更多的总体开销。当你 spawn 一个任务时,考虑你实际调度了多少工作:把一个 10 微秒的工作单元放到自己的任务上可能是反效果的。dial9 或 tokio-metrics 这样的工具可以帮助你追踪任务的生命周期。
警惕全局资源
Tokio 运行时在 worker 上调度工作:这些 dedicated 线程 poll 就绪的任务。Worker 可以跨核扩展,但某些运行时资源仍然需要共享协调。
阻塞池目前是一个全局资源。在足够高的频率下,向阻塞队列推入工作会成为瓶颈,spawn_blocking 会在火焰图中变得可见。我曾在 32 核机器上大约每秒 50,000 个阻塞任务时看到过负面性能影响;你的情况会有所不同。spawn_blocking 不是所有阻塞或 CPU 密集型代码的万能解药。对于短小的有界工作,让 Tokio 的 worker 和工作窃取来处理可能更快,但——一如既往——"看情况"。
Tokio 也有一个全局任务队列。当本地 worker 队列溢出时(通常很少见),或者当工作是从运行时 worker 外部调度时(这在某些应用中可能很常见),任务会到达那里。比如,一个 channel 的 sender 运行在一个非 Tokio 线程上。
对 Mutex 极度谨慎
让整个运行时 stall 的最简单方法之一是在一个被竞争的 mutex 上阻塞 worker。
像存储在 mutex 或读写锁后面的指标注册表特别容易出现这个问题。如果一次 flush 在做昂贵工作时持有锁,每个 Tokio worker 最终都可能调度一个试图记录指标的任务,然后在同一个锁上阻塞。窃取变得不可能,因为每个 worker 都卡住了!
在异步应用中保持关键区段极短(比如一次 hashmap 更新)。RWLock 几乎从来不是正确的选择,因为它们仍然会在原子操作上产生竞争,即使在读路径上。不要在 flush、执行 I/O 或 await 另一个 future 时持有锁。
tokio::sync::Mutex 用一个问题换另一个问题:Tokio Mutex 锁定代价高得多,容易出现 FutureLock 这样的微妙问题,而且真的只在关键区段持续多毫秒时才合适。
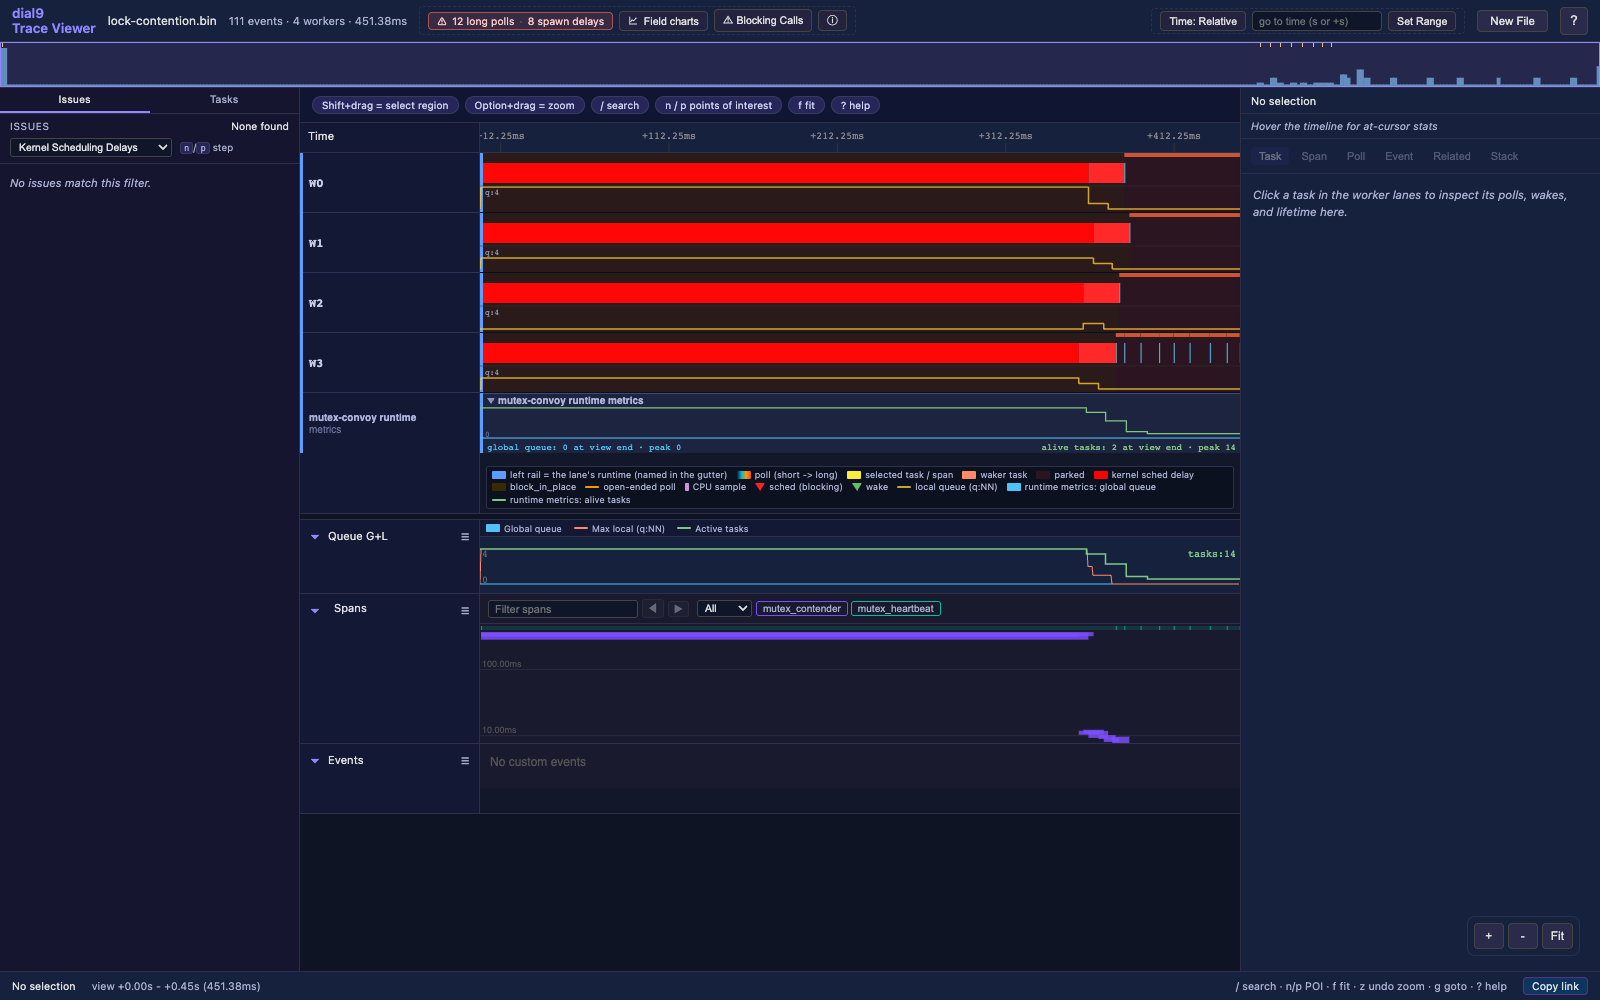
一个被竞争的阻塞 mutex 同时 stall 了所有四个运行时 worker。
限制并行度——通常如此
Tokio 可以愉快地 spawn 远超你系统其余部分能处理的任务数。因为工作负载展开了一个无界数量的任务,不小心向 S3 打开 3,000 个并发连接是很常见的。
答案很无聊:限制并发。花哨的自适应算法有时是合适的,但一个 Semaphore 通常就够了。
让 Tokio worker 与其他线程隔离
Tokio 的设计依赖 worker 快速唤醒。然而,如果操作系统负载很高,内核在 Tokio 尝试唤醒 worker 后调度它可能需要 10-20 毫秒或更久。如果你的 P99 延迟是几毫秒量级,这就是灾难。我曾在亚马逊从 Java 迁移到 Rust 的增量过程中观察到这一点,两个进程运行在同一台主机上,Rust 进程逐渐承担更多工作。
Java 进程做的工作越少,Rust 进程就越快,即使它处理了更多工作。当其他应用使用大量线程时,这个效应更强。
最基本的解决方案是使用 cgroups 或相关 API 将 Tokio worker 和其他代码固定到不同的 CPU 核。
同样的问题可能来自其他 Rust 线程。tracing_appender 等后台线程有时可能做超过 100 毫秒的工作而不让出 CPU。如果 Tokio 尝试在这段时间内唤醒一个 worker,那个 worker 可能被延迟,直到内核抢占另一个线程。
如果你看到这种情况发生,解决方案相同:将非关键的后台工作固定到自己的核,把 Tokio worker 移到其他核。你很少需要把所有核都用于 Tokio,保留一些核给其他工作往往会改善延迟。
当你更了解情况时的技巧
本节的模式通常不是正确的做法,但有时它们正是一个工作负载需要的。
有时候阻塞执行器是可以的
在一个理想化的异步应用中,所有工作都以小爆发的方式发生,频繁让出回到 Tokio。现实世界并不总是这样工作,而且小爆发不一定是运行软件最快的方式。批处理工作可能更高效。
实际上,长 poll 并不总是问题。在轻负载下,Tokio 的工作窃取可以补偿当一个 worker 被占用时间比平常长的情况。这在两种情况下开始崩溃:
- Tokio 运行时负载很重,没有多余的 worker 容量。
- 操作系统负载很重,解锁 worker 经常被延迟。
在这两种情况下,窃取工作都需要更长时间。如果工作没有被足够快地窃取,核心的运行时维护——比如驱动 I/O——可能无法足够频繁地进行以保持低延迟。
重要提示! 如果你正在使用 tokio::join! 和 tokio::select! 等利用任务内并发的功能,这条建议不适用。在单个任务内,没有工作窃取;如果你阻塞了执行器,在那个任务上运行的其他任何东西都无法取得进展。这有时表现为意外的超时和通常很差的延迟。
使用多个运行时按优先级隔离工作负载
最强的隔离来自将工作分配到不同的运行时,并将这些运行时固定到专用核。许多网络服务既有延迟敏感的工作,也有较低优先级的后台工作。把它们放在不同的运行时上会在两者之间创建一个调度边界。
你也可以在运行时线程启动时设置 OS 级别的 niceness。参见 dial9 的 multiple-runtime example 和 Tokio 的 on_thread_start 钩子。
在 TokioConf 上,大多数演讲给人的总体印象是人们最终迁移到了至少两个运行时的方案。
自旋以保持控制
这是一个追求微秒级延迟的非常高级的策略。我不建议一开始就使用这个,但它肯定可行。
每次你让出回到 Tokio 调度器——或者 Tokio 停放一个 worker 线程并让给操作系统——你就为那个工作在被唤醒时可能被延迟创造了机会。
对于极端延迟敏感的工作,一个选择是在等待下一块有用工作时故意自旋一小段预设时间,也许 50 微秒,而不是让出。这会消耗一个核,可能损害相邻的工作负载,所以对大多数应用来说可能是错误的。然而,在仔细控制的条件下,这可能是正确的权衡。
附录:Tokio 的心智模型,四点概括
- Rust future 在 await 点之间逐步取得进展。这些活跃段被称为 poll,源自
Future::poll方法。 - 当 future 没有被 poll 时,它们处于空闲状态,等待执行器再次运行它们。一个好的执行器只在有工作要做时才 poll 一个 future。
- Tokio 运行 N 个 worker,通常每个可用核一个。每个 worker 有一个本地队列。当队列溢出或工作无法添加到本地队列时,任务进入全局队列。
- 当一个 worker 的队列积压时,另一个 worker 可以从它那里窃取工作——如果运行时检测到不平衡且另一个 worker 有容量的话。
评论
高性能网络编程圈子里实用主义倾向明显,大家集中讨论Rust Tokio等框架的性能瓶颈和替代工具。
高性能服务器普遍受困于元工作开销
业界大多数服务器应用把大量CPU时间浪费在epoll进入退出这类元工作上,这本应是显而易见的风险,但对作者们来说往往出人意料。Tokio框架虽然提供了一些好的原则,但这些原则仍然鲜为人知且容易被无意间违背(高赞)。
agentic coding可实现细粒度追踪检测
这类工具特别适合在代码中添加极其细致的追踪检测能力,帮助开发者定位性能瓶颈(较多人)。
有价值的补充
- 如果已经需要深入调优Tokio,可以考虑绕过内核网络栈,直接使用ef_vi/DPDK配合SPDK来获得更底层的控制
- 追求极致性能时,线程忙轮询、CPU核心绑定以及SPSC/MPSC环形缓冲区是更彻底的解决方案