2003年5月,威斯康星大学麦迪逊分校(University of Wisconsin - Madison)发现,该校一台公共网络时间协议(Network Time Protocol, NTP)服务器持续收到大规模入站互联网流量洪泛。洪泛流量速率达数十万数据包每秒与数百兆比特每秒。随后确认,流量源为全球数十万台真实互联网主机,其根因并非恶意分布式拒绝服务攻击,而是一家厂商面向家庭使用的数十万台低成本互联网产品设计缺陷。
正文
有缺陷的路由器淹没威斯康星大学的互联网时间服务器
2003年5月,威斯康星大学麦迪逊分校发现自己持续收到大量入站互联网流量,全部发往校园内一台公共网络时间协议(NTP)服务器。洪泛速率达每秒数十万个数据包、每秒数百兆比特。
后来我们确定,洪泛源是全球数十万台真实的互联网主机。但根源并非恶意分布式拒绝服务(DDoS)攻击,而是某厂商面向住宅用户的数十万台低成本互联网产品存在严重设计缺陷。这些产品的意外行为给UW-Madison带来了持续多年的重大运营问题。以下首次公开披露该缺陷细节,并讨论涉及大学、制造商、相关互联网标准(RFC)以及公共互联网服务和用户社区的多方面解决方案。
最初的洪泛
图1是5月13日至15日(周二至周四)48小时内校园入站流量图。前半段是校园典型流量,入站包速率峰值约40,000包/秒。但5月14日当地时间8AM左右开始,入站包速率剧增,主要来自商业互联网服务提供商WiscNet。约9:40AM,这些额外流量开始对测量基础设施和一些传统校园路由器造成问题。到11AM,我们已按协议和端口号识别出入站洪泛流量:它发往我们的公共时间服务器。我们在上游WiscNet边界路由器上封锁了入站流量,暂时缓解了问题。这是网络运营商应对恶意DDoS洪泛攻击的典型做法,我们当时也以为这是一次攻击。
封锁洪泛
相关流量看起来是NTP查询:76字节的IP包,目的UDP端口123。但这些包有个不寻常特征:虽然看似来自很多源,源端口号却都是23457。因此可以配置路由器只封锁发往NTP服务器的部分入站查询,继续正常服务其他合法请求。我们只封锁所有源端口23457、目的端口123(NTP)的UDP流量。23457像是手工挑的(23456之后)。当时我们只当是"攻击者"天真,以为它伪造了很多随机源地址,认为洪泛会像"脚本小子"发起的攻击那样在数小时内消退。
背景:简单网络时间协议(SNTP)
根据Dave Mills的RFC2030改写:
简单网络时间协议(SNTP)是网络时间协议(NTP)的改编版,用于同步互联网上的计算机时钟。它是一个简单、无状态的远程过程调用(RPC)系统,精度和可靠性预期与RFC-868描述的UDP/TIME协议类似。当不需要完整NTP实现的极限性能时,可以使用SNTP。
SNTP使用与NTP相同的包格式。这样SNTP客户端可以利用NTP服务器,尽管它们不实现完整对等NTP协议的复杂性。
SNTP对话通常如下:
- 想知道时间的客户端向NTP服务器的知名NTP端口123发送含SNTP请求的UDP包,等待回复。
图2. SNTP请求包
包中各字段大多为0,Mode=3(客户端),Version为1到4,最后64位的Transmit Timestamp为0或客户端发送请求的时间。
- 服务器从知名NTP端口123向SNTP客户端回复含SNTP应答的UDP包。
图3. 单播SNTP应答包
包中Mode=4(服务器),Stratum为1到14,Originate Timestamp复制自请求的Transmit Timestamp,Receive Timestamp为服务器收到请求的时间,Transmit Timestamp为服务器发送应答的时间。
- 收到响应后,客户端可选地用应答中的Originate Timestamp验证响应,试图确认它确实是本客户端请求的响应(如果是来自其他来源的伪造应答,不太可能含正确值)。然后取"Transmit Timestamp"的值,可能稍作修改以补偿估计的单向端到端延迟,用结果作为当前时间设置本地时钟。
现在,回到我们的故事……
洪泛持续
一个月后,我们发现入站NTP流量洪泛以更惊人的速率持续。图4绘制了2003年6月初起路由器对相关流量的丢弃包速率。图4中:(1) 速率有轻微每日波动(可能由于用户昼夜行为),(2) 速率一般保持在每秒250,000包以上(超过每秒150兆比特),(3) 所示时段内速率持续增加。图中速率的急剧下降不是洪泛消退,而是网络维护和观测点上游的临时封锁。
发现洪泛持续且速率仍在增加后,我们进一步调查。通过小心移除部分入站接口的封锁,让少量流量到达服务器,捕获了包括有效载荷在内的包。这些包看似合法的、格式良好的SNTP版本1查询,但每个客户端主机的速率高得莫名其妙。例如在一次抓包中,许多客户端约每秒产生一个查询。这对构造正确的SNTP客户端极不寻常——使用SNTP的应用只是想要相对准确地设置自己的时钟,让主机对当前时间有合理概念。每秒一个查询很荒谬,远非NTP客户端行为的最佳实践。
我们还发现很多IP地址可解析为DNS名称,而且所有IP地址对移除封锁的入站接口来说都似合法来源。这表明源地址很可能不是伪造的,而是运行某种非常异常SNTP客户端的真实互联网主机。
可惜客户端源主机都不在本地校园网内。这意味着我们需要招募远程站点的工作人员协助调查。
调查
联系源网络
从上述抓包的顶级流量源IP中,我选了两台来自其他大学的客户端主机,那里的网络人员有经验、熟悉应对此类事件。
以下是我发给其中一所机构事件响应团队的邮件。为保持匿名,真实SNTP客户端IP替换为10.42.69.10,并去掉邮件域名。
图5. 发给同行机构的邮件通知
邮件内容:5月14日0800中部时间起,我们的NTP服务器ntp1.cs.wisc.edu(128.105.39.11)收到大规模SNTP请求洪泛,远超其服务能力。这种入站SNTP请求的急剧增加至今仍未解释地持续。为缓解,我们目前封锁超过250K包/秒、超过150兆比特/秒,已持续数周。我们在调查这是恶意还是SNTP客户端配置错误或bug。流量主要是76字节UDP包,是来自大量源主机地址、发往ntp1.cs.wisc.edu端口123的SNTP版本1查询。异常的是,这些请求的UDP源端口都是23457。我们确认10.42.69.10只是来源之一(至少有数万个源主机地址)。附上6月13日抓包日志,显示该主机以约每秒一个的异常高速率发送SNTP查询。包分解显示它们是RFC 1361描述的有效SNTP v1查询。能否尽快协助识别该主机的操作系统和可能运行的SNTP客户端代码?了解10.42.69.10上是否有进程绑定UDP端口23457以及运行什么代码会很有帮助。
P.S. 我们迄今的调查显示Windows 2000和XP有"Internet Time"功能,通常配置为向微软服务器time.windows.com发送SNTP请求,但该服务器可更改。我还没找到任何常规使用UDP端口23457作为源端口的SNTP客户端。23457看起来是手工挑的(23456之后)。
抓包显示该主机约每秒一个查询;帧998显示其为有效SNTP v1查询,源端口23457。
两所大学的网络人员调查了我报告的两个异常SNTP查询源主机。两方都报告说流量源是Netgear品牌路由器(具体一台被识别为型号MR814)。
事情开始说得通了。许多源主机使用同一源端口号,可以解释为嵌入式SNTP客户端硬编码了源端口号23457。
收集背景信息
在网上搜索Netgear产品著名的NTP支持资料时,我看到ICSA Labs防火墙实验室关于NETGEAR FR114P的报告引用:
Netgear FR114P依赖单独的NTP时间源设置当前日期和时间,因为它没有内部电池和时钟。产品硬编码了通过公共互联网可访问的特定NTP时间源。即使配置产品访问特定NTP服务器,它仍尝试访问硬编码的NTP时间源,同时访问指定的时间源。
注:Netgear报告FR114P不包含这里描述的特定SNTP缺陷。我只是觉得有趣,因为这是我网上找到的唯一NTP相关缺陷信息。
检查Netgear代码
为验证SNTP查询洪泛源是Netgear Platinum系列产品的假设,并向厂商准确描述问题,我们下载并调查了多款Netgear产品的代码。
用Unix的strings命令配合grep搜索23457,我在RP614412.bin和MR814411.bin的输出中都看到" on 23457 port.",验证Netgear代码似乎包含魔数23457(作为端口号)。
用类似技术,我在RP614412.bin中找到以下作为ASCII字符串嵌入的IP地址:
- 128.105.39.11 # ntp1.cs.wisc.edu(即caesar.cs.wisc.edu)
- 192.168.1.101
- 66.37.215.43
- 12.234.94.14
- 192.168.0.1
(DNS名注释是我加的,二进制文件中没有这些字符串。)
MR814411.bin中嵌入:
- 0.0.0.0
- 12.234.94.142
- 66.37.215.43
- 192.168.0.102
- 128.105.39.11 # ntp1.cs.wisc.edu
- 192.168.0.1
- 192.168.1.101
其中3个全球可路由IP中,只有128.105.39.11看似用作NTP服务器。另一个曾是"dyndns.org"动态DNS服务使用的IP。Netgear向我们报告,其余嵌入的全球可路由IP已不再使用,是某位开发者调试遗留的死代码。
联系Netgear
2003年6月16日,我向Netgear支持发送以下邮件。由于该问题比典型客户支持询问重要得多,我也直接发给一些Netgear员工(邮箱从网上收集),请他们转达给工程部门相关人员,或让人通过电话或邮件联系我。
图6. 发给Netgear支持的邮件
NETGEAR支持人员:2003年5月14日起,威斯康星大学麦迪逊分校公开宣传的互联网时间服务器ntp1.cs.wisc.edu(即caesar.cs.wisc.edu,128.105.39.11)收到大量时间查询洪泛,显然来自部署在互联网各处的NETGEAR产品。目前根据分析,我们认为NETGEAR "Platinum"产品如RP614和MR814是主要流量源。它们可能需要修改代码,以缓解对我们NTP基础设施实质上是意外的DDoS洪泛。来自NETGEAR产品的入站聚合流量速率目前在我们边界路由器超过250,000包/秒和150兆比特/秒,显然来自至少数万个NETGEAR源。这也耗费了我们大量互联网流量工程、故障排查和滥用调查时间。具体而言,Platinum产品代码似乎含嵌入式SNTP客户端,从UDP端口23457向IP主机128.105.39.11的端口123发送查询。NETGEAR产品代码出厂时竟显式按IP地址配置了我们的服务器。我们确定至少以下代码镜像显式包含我们服务器的IP地址:MR814411.bin, MR814v409.bin, RP614400.bin, RP614412.bin。我们认为这不合适,也不符合互联网NTP服务负载均衡和可靠性的最佳当前实践。除了部署数量巨大,这些请求常以极快速率(例如每秒一个)从每个设备发出,因此给我们NTP服务器带来巨大负载。请尽快联系我。
P.S. 我们的NTP服务器是公开宣传的。P.P.S. NTP最佳实践描述见相关文档。
几天没收到回复后,我打电话给Netgear总部,给两位高管留言说明情况严重性。我还根据其邮件命名惯例猜测高管邮箱并发电邮,加入"Return-Receipt-To"头,其邮件交换机通知我全部成功送达。以下是该邮件的部分内容:
此时我有这份持续事件的完整书面报告,包括证明洪泛的流量测量统计和根因分析,准备公开发布。如果NETGEAR希望在事情公开前开始对话,我绝对需要立即听到NETGEAR负责人回应。我们不期待立即解决方案;事实上,我相当确定没有UW-Madison的参与就没有完整解决方案。
6月19日周四,我收到Netgear支持总监的语音邮件。他确认他们在代码中找到了一些故障。随后我开始与他交换邮件和语音邮件。建立初步联系后,我们在Netgear支持系统之外继续处理这个问题,继续下面的审查流程。
Netgear支持组织完全没有回应。有趣的是,我在6月16日提交问题报告约23天后,终于收到Netgear邮件客服系统的回复。
图7. 来自Netgear支持的邮件
感谢您的邮件。我们对回复延迟表示歉意。由于邮件量意外增加,我们无法及时回复。您的问题可能已解决。如仍需帮助请回复此邮件,我们会尽快回复。如问题已解决无需回复,我们将视为结案。感谢您的耐心和理解。
审查流程
与Netgear开始对话后不久,我提议组建审查团队讨论可能的解决方案。Netgear同意,成立约15名成员的审查团队,三方各约三分之一:
- Netgear员工
- 大学员工
- 各领域独立专家:区域互联网注册机构、互联网测量研究、网络时间协议
独立专家同意参与而不过早披露情况细节。
审查过程中制定了一些行动项和方向:
- 修复SNTP客户端
- 提出网络运营选项
- 通知互联网社区
- 澄清互联网最佳当前实践和协议标准
有缺陷的SNTP客户端
影响UW-Madison的这些产品中,有缺陷的Netgear SNTP客户端有以下特征:
- 对NTP服务器128.105.39.11(ntp1.cs.wisc.edu)使用硬编码IP地址。
- 使用固定UDP源端口号23457。
这极为有利,使UW-Madison能识别和计数Netgear客户端。但由于某些Netgear产品上游广泛使用网络地址端口转换(NAPT,即NAT/PAT),SNTP请求源端口号有时在到达目的地前被重写。
给网络运营商的注:请不要封锁涉及端口23457或我们NTP服务器IP 128.105.39.11的UDP流量。我们感谢帮助的尝试,但这可能干扰最佳解决方案。
- 以一秒间隔轮询,直到收到NTP服务器响应,之后使用更长轮询间隔,如一分钟、十分钟、两小时或24小时,取决于产品型号和固件版本。
对Netgear客户的影响
截至撰写时(2003年8月),大学尽力服务Netgear时间请求。因此受影响产品的用户通常不会注意到该缺陷造成的任何问题。基于迄今经验,似乎只有一小部分客户知道这些产品的时间相关功能(包括日志、策略调度和邮件通知)。
同时,Netgear已生产并继续开发不表现上述问题的固件。客户可升级到更新固件版本,可从Netgear支持网站下载。截至撰写时(2003年8月),RP614v2、RP614、DG814和MR814型号的最新固件不使用UW-Madison时间服务,也不过于频繁轮询。
受影响Netgear产品的代码升级
根据Netgear提供或确认的信息,以下产品含这些SNTP设计缺陷。适用处,我标注了含修复的最早代码版本(图8)。
有缺陷产品数量
我计数到一天内有超过500,000个唯一Netgear源查询我们的时间服务器。由于NAPT会修改源IP地址和端口号,以及一些宽带住宅服务在不使用时断开用户链路,该测量很可能低估实际数量。
截至2003年6月30日,Netgear报告共制造707,147个受影响产品。简单计算:如果700,000个错误SNTP客户端每个能向我们的时间服务器每秒产生一个SNTP请求,最坏情况聚合速率约700,000包/秒。每个SNTP包76字节,即426兆比特/秒流量。
图8a显示UW-Madison网络上一台路由器每天观察到的唯一NTP Netgear客户端IP地址实际数量。理论上,如果客户端DHCP服务器频繁更换客户端IP地址,这种计数方式可能高估。但基于报告的产品制造数量,似乎相当准确。
建议修复
审查过程中对SNTP客户端提出多项改进建议:
- 应使用64到1024秒或更长的轮询间隔
- 如果可用,应使用本地NTP服务器或组播,由操作员配置或通过DHCP "Network Time Protocol Servers Option"(RFC 2132第8.3节)等发现机制确定
- 在未收到NTP服务器响应时,可对轮询间隔进行指数退避(在上述范围内)
- 在未收到NTP服务器响应时,不得使用更短轮询间隔
- 必须允许操作员配置查询行为:是否启用,以及可查询哪些候选时间服务器
- 应使用域名系统确定候选服务器IP地址,以便NTP服务器的区域管理员影响客户端行为
- 应在每次轮询/查询前用DNS解析服务器IP地址,尊重相关DNS条目的生存时间值
- 应支持现有NTP访问控制机制:收到有效"kiss-of-death"包时报告情况并停止向该服务器查询,直到重新初始化
- 可使用实现定义的固定源端口号
其中一些已在初始修复中实现,其他仍在考虑中。希望这些建议在即将到来的SNTP标准化工作中得到评估。
初始修复:"Instant"代码
审查过程中我们得知,在我最初通知该缺陷给大学造成的问题之前,Netgear已在为RP614v2开发SNTP相关代码更改。
关于RP614v2固件v5.13 RC7,Netgear于7月10日向我提供新代码。我的测试发现修改后的SNTP客户端有这些特征,与他们的描述大致相符:
- 现在需要先配置DNS服务器(或通过DHCP学习)才生成任何SNTP查询。
- 代码以十分钟间隔对"time-a.netgear.com"和"time-b.netgear.com"执行DNS查询直到成功,未收到响应时在两个名称间交替。我也验证它支持CNAME或多A记录响应。
- DNS成功解析后,向解析的IP地址发NTP查询并等待回复。如果十分钟内无回复,再次解析名称并重新查询。似乎五次重试后放弃。
- 每当通过Web界面应用任何配置更改,会使设备时钟归零,重新解析NTP服务器并随后查询。
但我也发现这些bug:
- 该代码中的SNTP客户端似乎不验证NTP响应包。它会接受任何到端口23457的入站包作为有效响应,即使标志设置错误(例如表示这是另一个客户端查询而非服务器响应)。
- SNTP客户端等待响应时(查询time-a或time-b后),似乎接受任何UDP响应包,即使该UDP包的源IP地址不是它查询的时间服务器。
该代码2003年7月11日左右在Netgear网站上供RP614v2下载。
Netgear继续改进其SNTP客户端,并已让审查团队审查设计。
网络运营选项:服务还是切断?
这些有缺陷的设备不易重新配置。Netgear和UW-Madison的代表都认为,依赖Netgear客户升级到新固件(首个于7月发布)来纠正错误行为不是可行选项。
我们的审查团队考虑了处理异常Netgear时间请求的一些可能选项。这里不详述所有细节,以下是我们关注的两个主要终局。
终局A:UW-Madison Netgear Anycast时间服务
这个选项下,我们将在WiscNet边界部署高可靠、冗余NTP服务器,用BGP anycast将发往128.104.39.11的入站请求路由到它们。(Anycast是一种常可用于DNS或NTP等基于UDP的无状态RPC服务的技术。)实施该选项可能包括在WiscNet内三个位置各放一对机架式NTP服务器:UW-Madison、UW-Milwaukee、UW-Eau Claire。这些位置最接近当前三个边界互联网交换点,为全球互联网连接的可靠性提供最多样化路径。
这种配置的一个明显优势是UW-Madison尽可能保留对其宝贵IPv4地址分配的控制。由于该BGP anycast部署只位于WiscNet内(会接受单个/32主机地址路由),该选项消耗的UW-Madison IP地址空间尽可能少——只需Netgear时间请求指向的那个地址。
终局A有风险。服务器的响应是否到达请求客户端主机不完全在大学控制内,因此一定程度的洪泛可能继续。除了服务器故障,SNTP客户端和服务器之间端到端路径中断有很多原因,可能使客户端收不到响应,仍向我们的服务器洪泛请求。这包括非对称路由问题、防火墙政策和影响客户端与服务器之间任何链路的灾难。事实上,即使我们的时间服务器尽职响应所有Netgear SNTP请求,我们仍定期观察到数百个请求继续洪泛。这些"僵尸"显然从未收到我们的响应。
为限制多台服务器同时与互联网隔离的可能,可考虑更地理多样化的部署位置,如AS112项目所做,有效缓解RFC1918相关查询对互联网根名称服务器造成的损害。
图10显示该服务如何工作:发往UW-Madison的Netgear SNTP请求(绿色)被WiscNet边界路由器转到最近的多台同IP地址NTP服务器之一,服务器响应(红色)返回;任何服务器故障,流量应路由到其余同地址NTP服务器。
终局B:试图压制请求
要阻止Netgear时间请求转发到我们网络,需要UW-Madison牺牲包含ntp1.cs.wisc.edu IP地址的class B网络内一块IP地址空间。
由于互联网骨干路由的运作方式,以及为保持路由数量可控,网络路由有时不够大就不被尊重。在当今互联网,那意味着路由可能不被认为合法,除非它代表2,048或4,096个连续地址。网络运营商分别称这些大小为"/21"或"/20"块。
图11显示该配置:UW-Madison边界路由器发出的BGP更新(红色),Netgear SNTP请求(绿色),互联网各处BGP感知边界路由器返回给客户端的ICMP不可达消息(蓝色),告知客户端NTP服务器所在网络不可达。
终局B:所需IP资源
这个试图压制请求转发的终局对大学代价重大——可能需牺牲多达4,096个IP地址,很可能持续到有缺陷产品的整个生命周期。图12显示现有128.105.0.0/16网络如何划分,以及将从互联网全球BGP路由表排除的一个"/20"块。
终局B的风险包括部分互联网可能无法到达牺牲的未广告块附近的合法校园IP地址。需要骨干网络运营社区的意见和现实经验来确定哪个方案最能服务大学和整个互联网社区。
告知互联网社区
公开发布这份文档是告知互联网社区该缺陷及由此产生的洪泛的一部分努力,希望将此类错误在别处重演的可能性降到最低。Netgear在发布前数周已知晓我们公开披露此处细节的计划。此外,这份文档早期修订版也提供给他们审查。
由于问题规模——全球数十万行为不良的互联网主机——以及洪泛的规模和意外性质——聚合速率可能完全填满一些网络链路——我觉得有必要告知他人并征求专家意见。
披露之后,我打算找适当场合进一步展示和审查这类问题的危险和潜在解决方案。
例如,审查过程中我们得知澳大利亚联邦科学与工业研究组织(CSIRO)正遇到类似麻烦:约85,000台SMC品牌路由器在未收到响应时每分钟两次轮询CSIRO时间服务器。相关报道见 australianit.news.com.au。CSIRO问题规模小几个数量级,洪泛约2,800包/秒和1.7兆比特/秒,但惊人相似,或许不太可能在该制造商协助下得到负责任的解决。
澄清互联网最佳当前实践和协议标准
审查过程中,一些审查团队成员开始编写互联网草案以改进相关文档。至少两项工作处于初期:
我正在准备一份互联网草案,标题为"Embedding Globally Routable Internet Addresses Considered Harmful",谴责在互联网主机中嵌入唯一、全球可路由IP地址的做法,描述由此产生的一些问题,并考虑选定替代方案。
NTP社区成员修订和审查了现有描述SNTP的信息性RFC2030。通过他们的努力,或许可能将NTP和SNTP作为IETF标准轨道协议重新审视。
状态,2003年8月21日
我很高兴报告Netgear已在初始步骤上与我们合作,我们正在达成协议,以实施合适解决方案。
目前,UW-Madison继续服务Netgear SNTP请求,尽管偶尔收到Netgear产品的大规模流量洪泛。图13显示最近一次事件。右侧鲨鱼鳍状异常是入站Netgear时间请求洪泛,增长到约100,000包/秒后消退。
Netgear引起的事件的大小和持续时间继续对UW-Madison构成严重运营问题。目前实质上在玩俄罗斯轮盘赌,我们希望利用UW-Madison和互联网运营商社区的专业知识设计和实施好的解决方案。
后续思考
这个案例引发以下作为思考素材的问题:
- 这种非故意DDoS洪泛表明一些公共互联网服务的可行性如何?
- 互联网路由基础设施能否改进,以实现破坏性更小的解决方案?
- 这类事件是否是普遍、低成本、甚至一次性互联网主机的可能副作用?
- 制造商、供应商、互联网运营和用户社区是否愿意且能够合作解决此类问题?
常见问题
Netgear对造成(无论多么无意)你们网络的拒绝服务有何责任? 我的工作职责不会使我参与此类谈判。如我报告的,正在达成协议。给其他人的注:请不要问我财务或法律细节。这份文档是情况的技术总结,不是传递此类细节的载体。
是否考虑过架设一台向Netgear客户端发送假答案的服务器,促使人们升级? 考虑过,但没考虑多久。Netgear和审查团队其他人都认为效果很小,因为只有一小部分客户似乎知道受影响产品的NTP相关功能。此外,提议的"不诚实"时间服务器(报告错误时间)必须在目前我们知名的可靠时间服务器的IP地址上运行。它突然变得不可靠会相当粗鲁,因为公共时间服务的全部目的是用正确时间回答。大学打算提供尽可能好的服务,无论被如何滥用。
这些产品的预期寿命? 个人认为很多可能还会存在五到十年。只是猜测,也许半衰期是五年,之后预计受影响产品剩下不到350,000台。
图13中的"鲨鱼鳍"尖峰是否与上周的电网故障(2003年大停电)及随后的轮换恢复有关? 不,它与2003年8月影响东海岸的大停电不重合。不过我确实在Netgear SNTP流量中寻找大停电证据,只发现停电期间略有减少。相对而言互联网受停电影响不大。早期报告只有来自几百个自治系统的几千个BGP前缀离线。离线的双向都不可达,所以直到电力恢复我们才收到它们的请求。轮换恢复使那些Netgear客户端上线时把负载分散到我们服务器。
除提到的设备外,还有其他设备也有该缺陷导致意外洪泛你们网络吗? 一些Netgear用户向我报告,Netgear型号RO318固件V3.26也使用我们的时间服务器,并在安全日志中记录NTP错误。我未评估该产品,不知其重试时间,但会报告给Netgear。
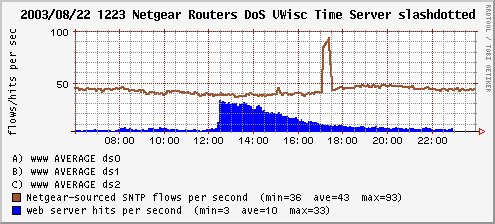
这份报告被Slashdot报道时的影响? 对Web服务器有显著影响,但总体对校园来说流量微不足道。服务器一度每秒处理30个请求。下图是这份报告被Slashdot报道时,Web服务器每秒点击数与Netgear来源SNTP请求流每秒数量的对比(此时大多数Netgear客户端收到我们服务器的回复,所以没有洪泛请求):
为什么传统的制造商召回/缺陷解决方案不可能? Netgear和审查团队其他成员都认为,除了极小部分用户,不太可能所有人都会退回受影响设备,因为它们看起来工作正常。而且很少有客户向制造商注册这些产品,联系他们不切实际。
我是IT媒体,你有时间谈谈吗? 这份报告首次展示时,一位敏锐的听众提出,IT媒体表面上在评估消费产品是否符合互联网标准和最佳当前实践方面扮演重要角色。鉴于此,如果你是IT媒体,你的出版物做互联网产品评测或颁发"编辑选择"奖,我愿意就此事通过邮件与你交流。把报道与IT媒体的产品评估和推荐功能结合起来,或许能降低此类缺陷造成此类问题的可能。
此事媒体如何报道? 以下是报道取样(并非详尽列表)。请注意有些文章细节误导或错误;只有少数联系我核实事实。
- Slashdot:Netgear Routers DoS UWisc Time Server
- The Inquirer:Wisconsin Uni page describes Netgear 'flawed routers'
- Wisconsin Technology Network:Flawed Routers Flood UW Server
- ZDNet:NetGear flaw triggers accidental DoS attack
- CNET News.com:NetGear flaw triggers accidental DoS attack
- ZDNet Australia:UPDATE: Netgear routers attack university
- Network World:Netgear router quirk perturbs college(也在Network World杂志印刷版)
- TECHWORLD:NetGear sets off denial of service attack
- Network Computing:Industry Insights: Opportunity Knocks / Quality Counts
- PC World:NetGear Routers Wage War on University(也在PC World杂志2003年11月印刷版)
评论
讨论以正面评价为主,部分读者惊叹作者早年对低成本主机事故的预见,少数人则欣赏老式图表并借2003年回忆类比当下机器人流量。
认为文章对低成本主机引发事故具先见之明
- 读者赞叹整篇写得出色,尤其作者当年提出普遍廉价主机或成事故副作用的疑问,如今看极具前瞻性(少数人) > 整篇极佳,作者对低成本 disposable 主机的评论前瞻性令人惊叹(@ctippett)
认为老式图表比现代花哨设计更有信息量
- 读者感到朴素图示提供比当今常见炫酷图表有用得多的信息,旧美学像是一种内容非垃圾的暗示(少数人) > 老式美学几乎像在提示所见不会是敷衍之作(@rkagerer)
指出重试轮询是中断转为洪水的关键
- 技术读者强调痛点在于重试循环:单个坏IP可恢复,但每秒轮询直至响应会将每次中断放大为流量洪峰(少数人) > 一个坏IP加每秒轮询直到应答,会让每次中断都变成洪流(@orielhaim)
推测此次讨论受现代特斯拉类似事件带动
- 有读者认为帖子被热议是因为与近期特斯拉相关故事有相似之处(少数人)
有价值的补充
- 2003年网络回忆:NAT刚成主流、直访IP常见、流量小至管理员可肉眼辨异常,映衬今日自动化监控的演进(@digitalsushi)
- 类比精妙:二十年前10秒一次NTP查询与如今 bots 互聊本质无异,只是当时规模小未被察觉,今互联网载重多是机器对话(@digitalsushi)
- 作者曾在 Usenix LISA(现 SRECon)发表被誉最佳的演讲,增添文章分量(@YesThatTom2)