1970年代,浮点运算混乱,制造商有十几种不兼容算术标准,浮点系统侧重硬件简单而非数学严谨导致数值稳定问题。1980年英特尔(Intel)推出8087浮点协处理器(8087 floating-point coprocessor),力求准确。它可装入国际商业机器(IBM) PC,使浮点运算快达100倍,并成为当今多数计算机浮点标准。8087以微码实现指令,某逆向小组近期进展,正检查其FSCALE(Floating-point Scale)指令微码,该指令按2的幂缩放数快于乘法,原以为极简单。
正文
20 世纪 70 年代,浮点运算一片混乱。计算机制造商有十几种互不兼容的算术标准,而且浮点系统围绕硬件简单性设计,而非数学严谨性,带来数值稳定性问题。1980 年英特尔推出 8087 浮点协处理器芯片,力求尽可能精确,即便在极端情况下也是如此,局面由此改变。8087 可以装进 IBM PC,使电子表格、CAD 等应用的浮点运算速度提高最多 100 倍,因而大受欢迎。更重要的是,8087 成为当今大多数计算机采用的浮点标准。
8087 用称为微程序的复杂底层代码实现指令。我所在的 Opcode Collective 小组正在逆向工程这些微程序,最近取得了一些进展。这次我分析 8087 的 FSCALE 指令的微程序,说明它如何工作。FSCALE(Floating-point Scale)提供把数值乘以 2 的幂的快捷方法,比乘法快得多。我本以为 FSCALE 简单到几乎不值一提,应该很容易理解和讲解。剧透一下:它一点也不简单。FSCALE 用了 140 多条微指令和三层子程序调用,处理许多特殊情况。但 FSCALE 微程序展示了 8087 许多有趣的部分,比如移位器、加法器和指数转换器,还揭示出一个隐藏功能。
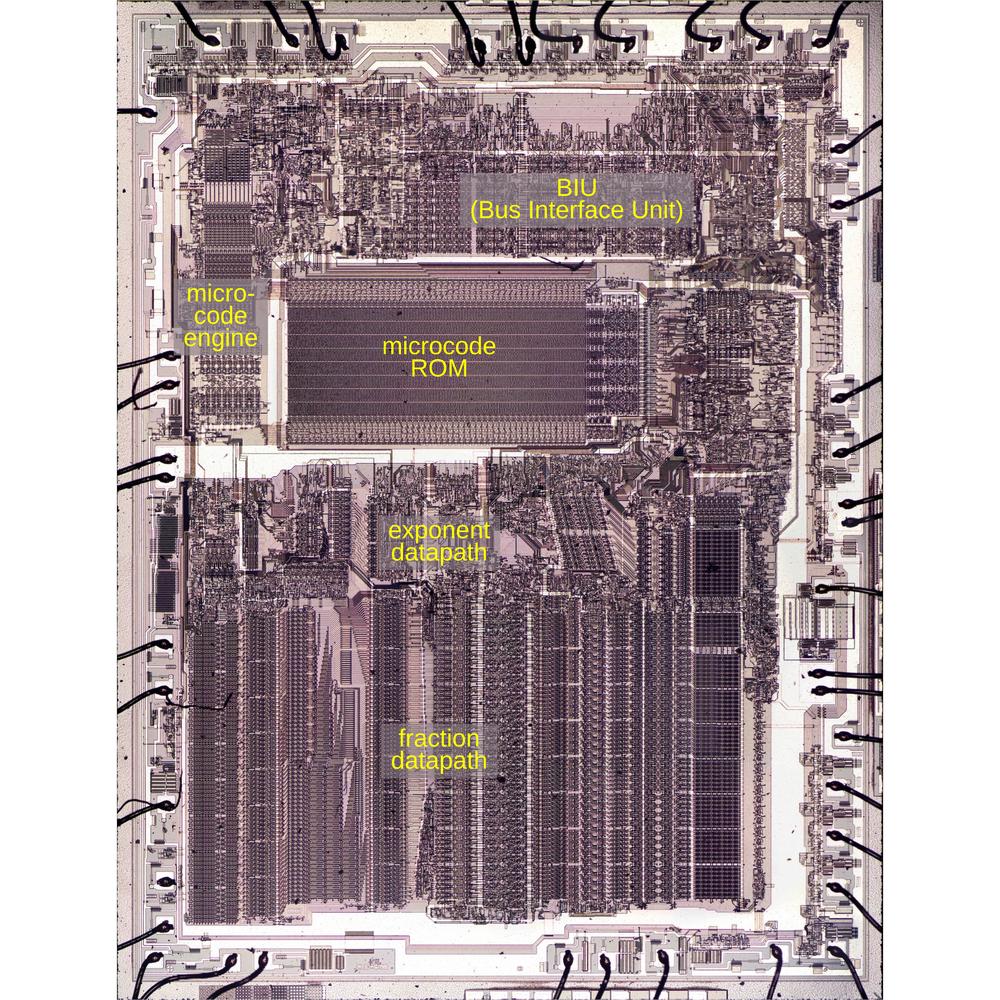
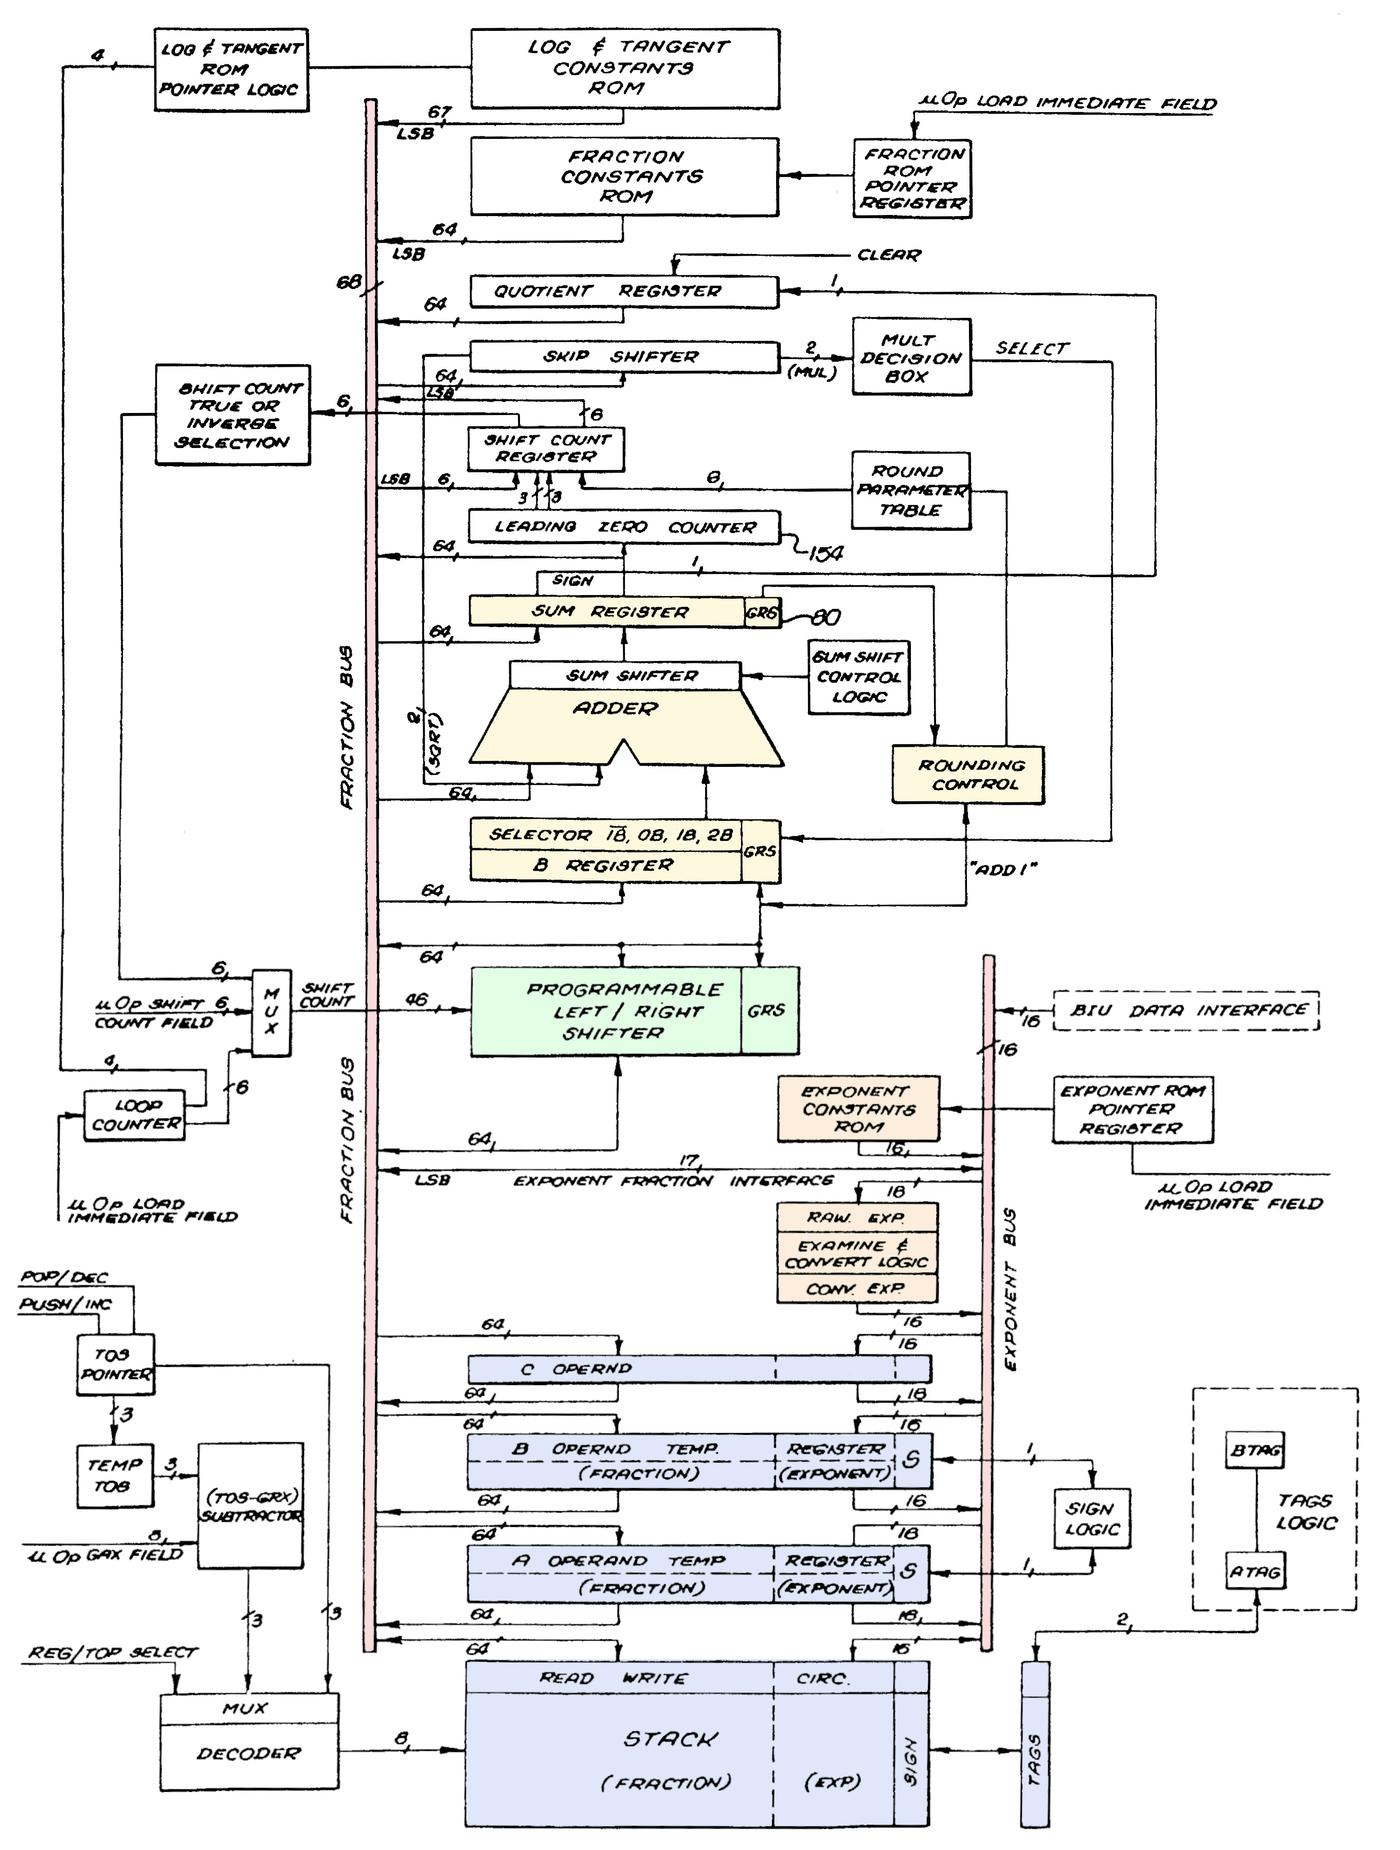
为了研究微程序,我打开一颗 8087 芯片,用显微镜拍了高分辨率图像。巨大的微程序 ROM 位于中央,存放控制芯片的 1648 条微指令。左侧的微程序引擎逐步执行微程序,处理跳转和子程序调用。芯片下半部是“数据通路”,即执行浮点计算的电路,分为处理指数的 16 位数据通路和处理有效数字(也叫小数部分)的 64 位数据通路。
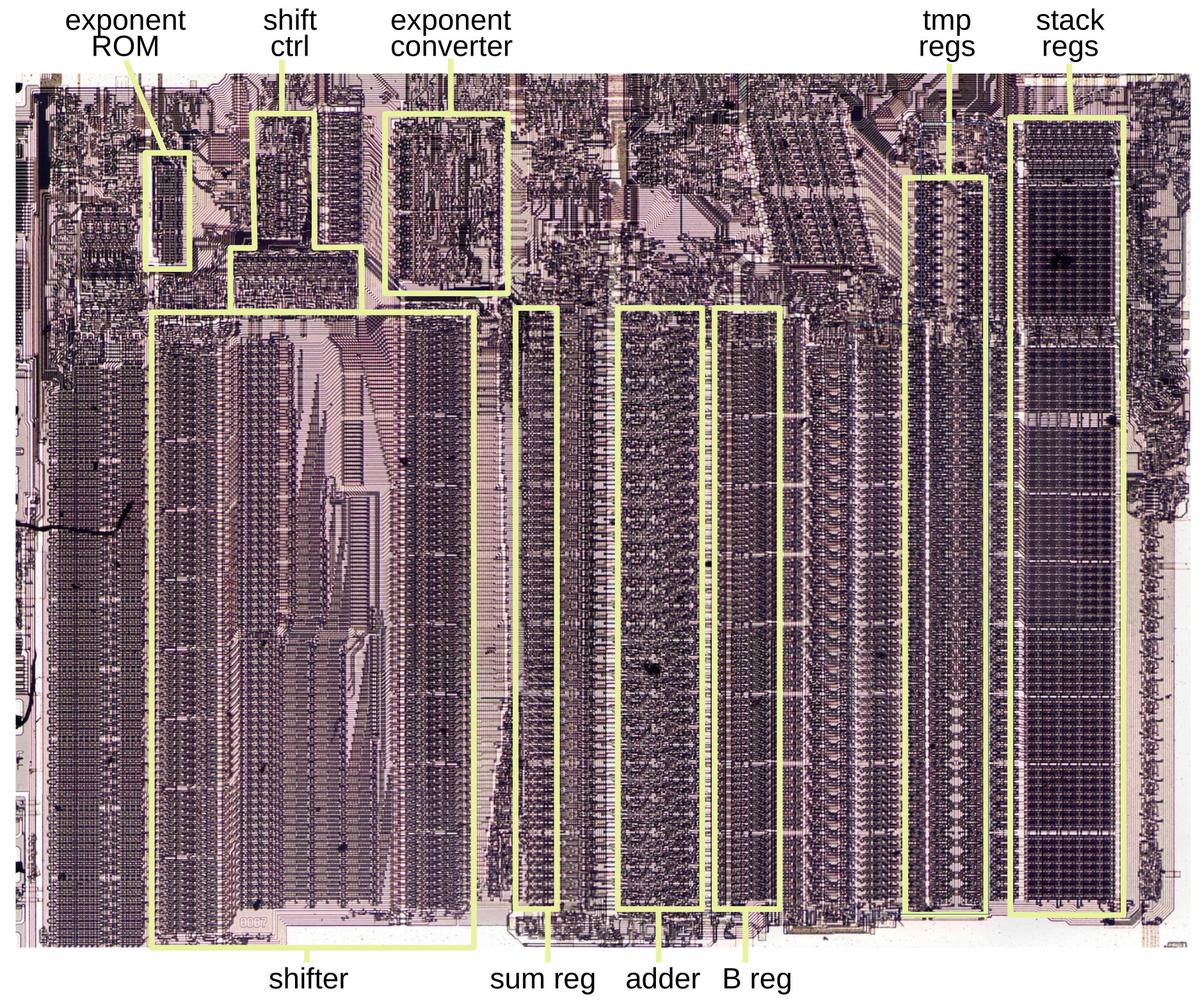
放大芯片底部可以看到数据通路电路,下图标出了与 FSCALE 相关的部分。指数 ROM 存放各种常量。指数转换器是专门电路,检查指数、检测特殊值并在不同指数格式间转换。移位器是个大部件,可以把 64 位数值左右移动任意位数。加法器是 8087 计算的核心;乘、除、开方都在循环中使用它。B 寄存器保存加法器的一个输入,另一个输入可以有多个来源。和寄存器保存加法器输出。八个栈寄存器和临时寄存器存放浮点数。
8087 的细节
要使用 8087,程序员把数值存入八个内部寄存器,它们组织成栈。每个寄存器保存一个 80 位浮点数。为提高性能,寄存器栈中每个值都带一个“标签”,对程序员基本不可见。标签把值标记为 valid(有效)、special(特殊)、zero(零)或 empty(空)。正常的浮点值标记为 valid。如果值是无穷大、NaN(Not a Number)或非正规化值,就标记为 special。零值标记为 zero。寄存器为空(比如值已弹出栈)就标记为 empty。
8087 还有内部使用的临时寄存器:tmpA、tmpB 和 tmpC。与栈寄存器一样,tmpA 和 tmpB 是 80 位寄存器,另加两个标签位。tmpC 则只保存 64 位有效数字。
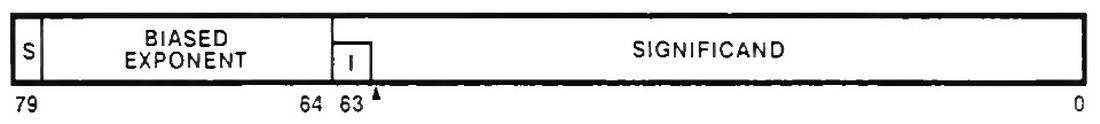
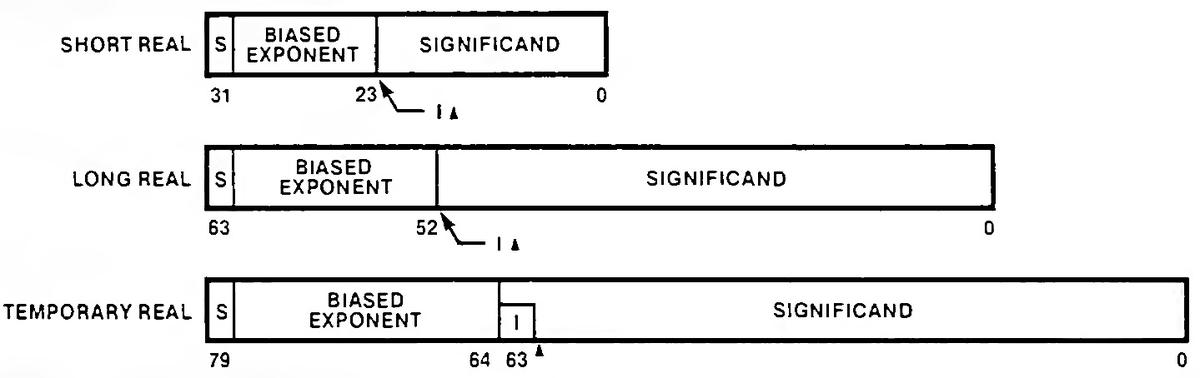
8087 支持多种数据类型:各种大小的浮点数、整数和二进制编码十进制。但内部一律以 80 位浮点数“临时实数”存储;下面只考虑临时实数值。一个数由三部分组成:符号位、15 位指数和 64 位有效数字。多数情况下,浮点数表示为 sign × significand × 2^exponent。有效数字是形如 1.bbb... 的 64 位二进制数:前导 1,然后是二进制小数点(相当于十进制小数点)和其余位。浮点数之所以有用,是因为借助指数(范围 -16382 到 16383),它的覆盖范围从极小到极大。一个重要细节是,指数存储时加上了 16383 的“偏置”,因此存储的指数始终为正,即便实际指数为负。
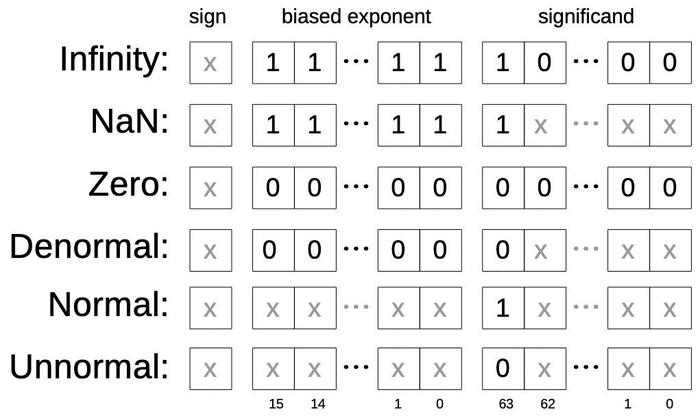
8087 支持几种用特殊指数表示的特殊值,如下图所示。零和无穷大都有正负之分。NaN 代表没有意义的值,比如 0/0 或 sqrt(-1);NaN 有很多种表示,不只是一个值。8087 还支持非正规化值和未正规化值,它们是非常小的值,有效数字没有前导 1。
8087 有复杂的异常系统,六种异常用来表示算术运算是否出了问题。最严重的是“非法操作”,表示运算没有意义,比如 0/0 或 ∞-∞,也包括访问空寄存器(栈上溢或下溢)或对 NaN 值做运算。还有结果太大而无法存储的上溢异常、结果太小的下溢异常、除零异常(0/0 除外)。非正规化操作数异常表示结果太小,无法作为正常值存储,但可以存为非正规化值。最后是精度异常,表示一个值无法精确表示、必须舍入(精度异常非常常见,连 1/10 都会触发)。
8087 对每种异常都提供精细控制,由控制寄存器中的位指定。如果异常未屏蔽,8087 会向 8086 处理器发中断,由软件处理,比如终止程序或记录错误。如果异常被屏蔽,8087 会尽力继续执行:非法结果用 NaN 取代,上溢或除零用无穷大取代,精度异常则进行舍入。屏蔽异常的用意是让计算继续,得出尽可能准确的结果;多数情况下这正是程序员想要的。
这些特性让 8087 灵活而精确,也让微程序复杂得多,因为各种特殊情况的组合都要妥善处理。
执行一条 8087 指令可能需要数百个内部步骤,这些步骤由微指令实现的微程序完成。微程序 ROM 存放实现 8087 指令集的 1648 条微指令。我正与 Opcode Collective 合作逆向微指令,弄清全部微程序。
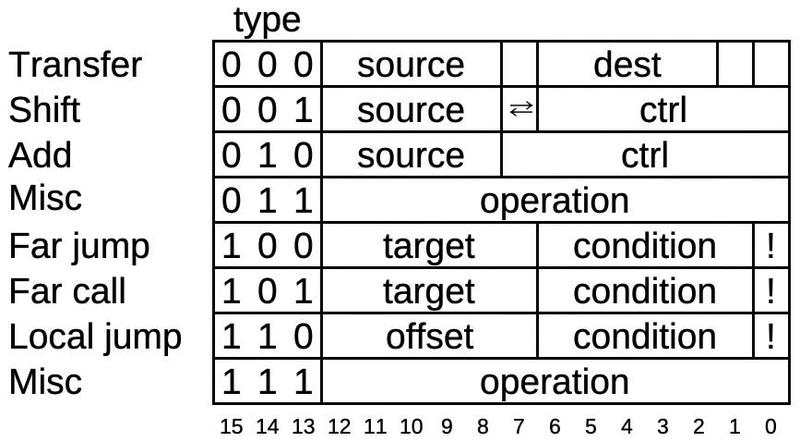
8087 微指令很复杂,有很多边角情况和临时功能,这里只给个简化概览。每条微指令 16 位,如下图所示。前三位指定微指令类型,决定其余位的含义。第一种是传送操作,把数据从一个内部寄存器移到另一个,两个字段分别指定源和目的,剩下三位用于各种特殊情况。第二种是移位操作,用桶形移位器把值左移或右移。第三种控制加法器(也可做减法)。杂项指令包括栈指针操作、标签修改、异常和子程序返回。远跳转和远调用微指令跳转或调用固定列表中的目标微地址。条件字段允许依据多种条件进行条件跳转/调用/返回,最后一位对条件取反。局部跳转是跳到附近微指令的相对跳转。
FSCALE 微程序
8087 开始执行指令时,指令译码电路确定该指令微程序的起始地址。这个 11 位地址装入微程序引擎,开始执行微程序。FSCALE 的微程序从十进制地址 748 开始。
FSCALE 的思路很直接:要把浮点数乘以 2^N(N 为整数),只需给数的指数加上 N,比完整浮点乘法快得多。然而 FSCALE 的微程序出人意料地复杂,用了好几个微程序子程序。简言之,它先检查参数是否为零,再处理其他特殊参数;把缩放参数转成整数并与指数相加;最后处理上溢或下溢。
说得更细一点:例程先把栈顶(st(0))的第一个参数移到临时寄存器 tmpA。如果参数是零,例程立即返回(因此用任何东西缩放 0——哪怕 NaN——结果都是 0)。接着把栈上第二个值(第二个参数)移到 tmpB。同样,如果这个值为 0,代码返回,于是用 0 缩放任何值都保持原值不变。然后选择一个常量;选择常量和用它是两条独立微指令(8087 分别有存 16 位指数常量和 67 位有效数字常量的 ROM,这里是指数常量)。正常情况下,执行跳到地址 #0763,跳过对子程序 SPECIAL_TMPS 的调用。
``` FSCALE:
0748 st(0) -> tmpA 从栈顶取输入参数
0749 若 tmpA:tag ZERO 则跳 #0776 为 0 则退出
0750 stackPtr++
0751 st(0) -> tmpB 从 stack(1) 取缩放参数
0752 stackPtr--
0753 若 tmpB:tag ZERO 则跳 #0776 为 0 则退出
0754 expconst 0x403e 常量 403e:转换为整数所需的指数移位
0755 若 tmp 非 empty/special/div 则跳 #0763
0756 call SPECIAL_TMPS 特殊处理
0757 若 flag 则跳 #0762
0758 若 tmpB:tag 非 SPECIAL 则跳 #0761
0759 except:invalid 非法异常,用 NaN
0760 NaN -> tmpA
0761 若 intr 则跳 #0776
0762 若 expConv[0] 则跳 #0775 若 expConv 置位则返回 tmpA,否则继续
0763 tmpB:exp -> Breg 常规路径
0764 tmpB:sign,exp -> expConv ExpConv 将检测 tmpB 的符号
0765 expConst -> tmpC 常量 403e
0766 adder: tmpC - Breg cin=1 403e-exp 即把 tmpB 转成整数所需的移位量
0767 sumreg:frac -> shiftcount 存入移位器控制
0768 shift tmpB:frac R count byte bit 执行移位
0769 shift R -> Breg Breg 保存整数形式的缩放参数
0770 若 neg 则跳 #0777 负的 Breg 需单独处理
0771 adder: tmpA:exp + Breg cin=0 把缩放量加到指数
0772 sumreg:frac -> expConv 结果送入 expConv 检查
0773 sumreg:frac -> tmpA:exp 用和更新指数
0774 若 exp 非 normal 则 call NONNORMAL_RESULT 处理上溢/下溢
0775 tmpA -> st(0) 结果写回栈
0776 RNI 完成:运行下一条指令
0777 adder: tmpA:exp - Breg cin=1 减去 Breg
0778 jmp #0772 继续处理
```
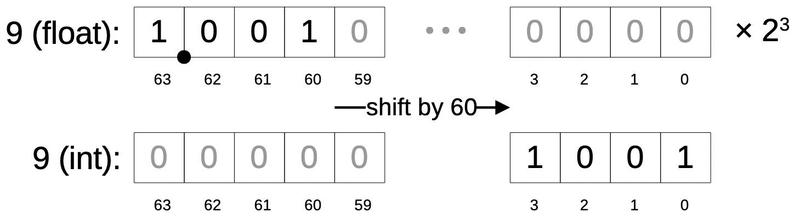
在 #0763,第二个参数从浮点数转成整数,需要几步。例如参数是 9,浮点表示为 1.001×2^3。有效数字位 1000 是“左对齐”的,但作为整数需要用右移把它们“右对齐”。一般来说,如果指数是 n,有效数字要右移 63-n 位。但指数偏置了 16383,所以有效数字必须右移 63-(exp-16383) 位,即 0x403e-exp 位。(这解释了微程序前面出现的常量 0x403e。)
微程序中,减法要几步完成。在 #0763,第二个参数的指数移入 B 寄存器——加法器的一个输入(与 tmpB 完全不同)。接着,符号和指数移入指数转换器,这个电路会检测溢出等。然后,常量 0x403e(在 #0754 选好的)移入 tmpC 寄存器。在 #0766,加法器被激活,从常量里减去指数。加法器把结果放进和寄存器,这个值再复制到移位计数寄存器,控制移位器。它表示第二个参数需要移多少位才能转成整数。在 #0768,移位器按所需位数移位,同时使用位移动和字节移动部分。与加法器一样,激活移位器和读取结果是两条独立微指令;结果放入 B 寄存器。
FSCALE 的核心部分最终在 #0771 执行,把第二个参数加到第一个参数的指数上。加法器被激活,把 B 寄存器值(缩放量)加到指数上,更新后的值存入 tmpA 的指数。(缩放因子为负时则走 #0777 路径做减法。)这个值同时送入指数转换器,检查指数是否上溢或下溢;如果溢出,就调用子程序 NONNORMAL_RESULT。正常情况下,更新后的值从 tmpA 复制到栈顶寄存器 st(0)。最后,RNI(Run Next Instruction)表示微程序例程结束,指令完成。因此,即便在最直接的情况下,FSCALE 也要用大约 22 条微指令。
处理空或特殊参数
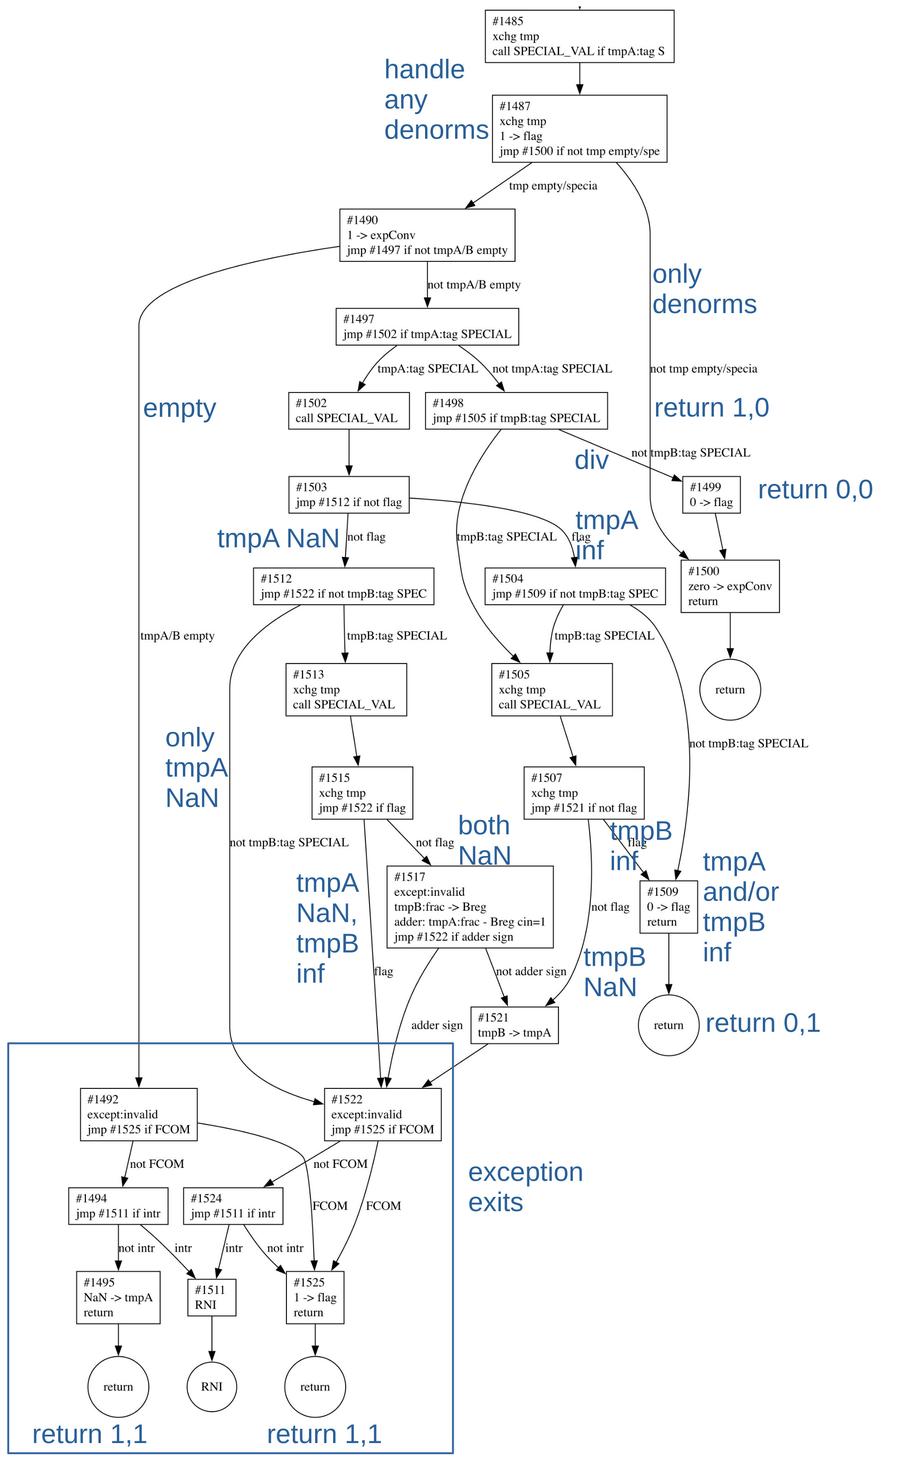
如果参数访问空的栈位置(即栈下溢)或是特殊值(无穷大、非正规数、NaN)会怎样?这些情况由一个微子程序处理,我叫它 SPECIAL_TMPS,因为它处理 tmpA 和/或 tmpB 中的特殊值。这是个通用例程,基本算术运算、FSCALE、FTST(测试)和 FPREM(部分余数)都会用。
SPECIAL_TMPS 的控制流相当曲折,因为如果一个参数为空而另一个是非正规数,代码必须排定优先级。这里只做简短总结。子程序先把任何非正规数转成未正规数,然后检查是否访问空栈位置,若是则触发异常或中断。接着再检查两个参数:如果任一是 NaN,就触发异常或中断;否则返回一个状态,说明参数类型。
出乎意料的是,如果两个参数都是 NaN,代码会比较两个 NaN 值并返回较大的那个。这种行为看起来很怪,但这是有文档记载的特性。你可能以为 NaN 是一个值,其实它是个庞大的家族。当初的想法是,程序员可以用不同的 NaN 值标记问题出现的位置。比如在未初始化数组的每个位置放不同的 NaN,就能知道访问了哪个位置。出于某种原因,8087 设计者决定:两个不同 NaN 做运算时,结果取较大的那个。因此微程序需要代码检测两个操作数是否都是 NaN 并计算较大者,用减法做比较(#1518)。
``` SPECIAL_TMPS (J5):
1484 若 tmpA:tag SPECIAL 则 call SPECIAL_VAL 处理 tmpA/tmpB 中的特殊值
1485 xchg tmp
1486 若 tmpA:tag SPECIAL 则 call SPECIAL_VAL 处理 tmpB 特殊值
1487 xchg tmp
1488 1 -> flag 默认 flag=1
1489 若 tmp 非 empty/special/div 则跳 #1500 tmp 正常则 0 -> expConv
1490 1 -> expConv
1491 若 tmpA/B 非 empty 则跳 #1497
1492 except:invalid 任一为空则非法
1493 若为比较指令则跳 #1525 比较指令不产生 NaN
1494 若 intr 则跳 #1511 中断未屏蔽则返回
1495 NaN -> tmpA 中断被屏蔽则用 NaN
1496 return
1497 若 tmpA:tag SPECIAL 则跳 #1502 特殊情况
1498 若 tmpB:tag SPECIAL 则跳 #1505
1499 0 -> flag 除法常规路径:
1500 zero -> expConv 返回 flag 0, expConv 0
1501 return
1502 call SPECIAL_VAL TmpA 特殊
1503 若非 flag 则跳 #1512 若为 NaN 则跳转,否则继续(无穷大)
1504 若 tmpB:tag 非 SPECIAL 则跳 #1509
1505 xchg tmp TmpB 特殊
1506 call SPECIAL_VAL
1507 xchg tmp
1508 若非 flag 则跳 #1521 若为 NaN 则跳转,无穷大则返回
1509 0 -> flag 清 flag,返回
1510 return
1511 RNI 带中断结束指令
1512 若 tmpB:tag 非 SPECIAL 则跳 #1522 TmpA 是 NaN,检查 tmpB
1513 xchg tmp
1514 call SPECIAL_VAL 检查 tmpB
1515 xchg tmp
1516 若 flag 则跳 #1522 tmpB 非 NaN 则跳转
1517 except:invalid 非法异常
1518 tmpB:frac -> Breg 两个参数都是 NaN,取较大者
1519 adder: tmpA:frac - Breg cin=1
1520 若加法器符号则跳 #1522 看 tmpA < tmpB
1521 tmpB -> tmpA 取较大者
1522 except:invalid 非法异常
1523 若为比较指令则跳 #1525 比较指令不产生中断
1524 若 intr 则跳 #1511 带中断结束指令
1525 1 -> flag 带 flag 返回
1526 return J5 结束
```
这个子程序大量使用辅助子程序 SPECIAL_VAL,它处理单个参数:把非正规参数转成未正规参数,视情况触发异常或中断,并标记输入是否为无穷大。
#1485 处交换 tmpA 和 tmpB 的微指令,其硬件很有意思。它并不真的在两个寄存器间搬移值,而是翻转一个触发器,交换 tmpA 和 tmpB 的含义:触发器置位时,对 tmpA 的引用就指向 tmpB,反之亦然。(这是微处理器的标准技巧;英特尔 8080 的 XCHG 指令用类似方式交换 DE 和 HL 寄存器,Z80 也在 EX 和 EXX 指令中用同样手法交换主寄存器组和辅助寄存器组。)
处理非正规结果
拿一个很大的数去放大,可能上溢;拿一个很小的数去缩小,可能得到非正规化数或下溢。这会触发上溢、非正规或下溢异常,未屏蔽时还会中断。而且 8087 支持四种舍入模式:舍入到最近的有效值、向下舍入(朝 -∞)、向上舍入(朝 +∞)、朝零舍掉。根据舍入模式,上溢可能得到 ∞,也可能得到最大可表示浮点数;下溢可能得到零,也可能得到最小可表示浮点数。无穷大还分仿射和投影模式,可以是带符号或无符号。因此 FSCALE 微程序要处理结果的许多特殊情况。
下面是处理 tmpA 中非正规结果的子程序。一条有趣的微指令是 update overflow/underflow exceptions,它会在适当时触发异常。大多数异常由微指令直接触发(比如 #0346 的 except:precision)。但上溢和下溢异常,微程序把任务交给硬件:8087 的“指数转换器”电路根据选定的浮点精度检查指数,判断是否存在上溢或下溢。微指令则根据这些值设置上溢和下溢标志。一个复杂任务就这样靠指数转换器的硬件支持,由一条微指令完成。
``` NONNORMAL_RESULT (J16):
0318 若 tmpA:tag ZERO 则 return 处理非正规结果
0319 update overflow/underflow exceptions 若指数转换器指示则触发异常
0320 expconst 0x6000 中断偏置常量 0x6000
0321 若非 intr 则跳 #0329
0322 expConst -> Breg 中断路径
0323 若 neg 则跳 #0326
0324 adder: tmpA:exp + Breg cin=0 下溢加上偏置
0325 jmp #0327
0326 adder: tmpA:exp - Breg cin=1 上溢减去偏置
0327 sumreg:frac -> tmpA:exp 新指数写入 tmpA
0328 return 有中断,结束
0329 若 neg 则跳 #0344 屏蔽异常
0330 tmpA:exp -> Breg 下溢
0331 adder: 1 - Breg cin=1 非正规数需移位数
0332 call CREATE_DENORM 创建非正规数
0333 adder: zero + Breg cin=0, roundmode 加零以舍入
0334 call ADJUST_PRECISION 按指定精度调整
0335 若和寄存器为零则跳 #0340 为零则视情况返回 +/- 零
0336 zero -> tmpA:exp 非正规数:指数为 0
0337 sumreg:frac -> tmpA:frac 保存非正规数的小数
0338 special -> tmpA tag 非正规数标记为 special
0339 return
0340 tmpA sign -> sign latch 返回 +/- 零
0341 zero -> tmpA
0342 sign latch -> tmpA sign
0343 return
0344 NaN/Inf -> tmpA:exp 上溢:可能返回无穷大
0345 tmpA:frac -> tmpB:frac 把 tmpA 小数存入 tmpB
0346 except:precision 设置精度异常
0347 Inf -> tmpA:frac 小数置为无穷大
0348 special -> tmpA tag 无穷大标记为 special
0349 若非朝零舍入则 return 向上舍入则返回无穷大
0350 1 -> Breg 返回最大浮点数:向下调整
0351 adder: tmpA:exp - Breg cin=1
0352 sumreg:frac -> tmpA:exp 指数=7fff-1=7ffe
0353 adder: zero - Breg cin=1
0354 sumreg:frac -> tmpA:frac 小数 0-1 = ff...ff
0355 norm -> tmpA tag 正常值
0356 若 tmpB:frac[63] 则 return 除非是未正规数,返回最大浮点数
0357 tmpB:frac -> tmpA:frac 返回原 tmpA 小数
0358 return
```
如果上溢或下溢未屏蔽并产生中断,8087 的行为很有意思。它的用意是让中断处理程序知道指数本来应该是多少。但正确值太大或太小,装不进指数字段(这正是异常发生的原因),于是解决办法是加上或减去常量 0x6000,得到一个能装下的指数。中断处理程序再减掉或加上这个常量,就能得到正确指数。#0322 到 #0328 执行这个加或减。
对于已屏蔽的下溢,子程序 CREATE_DENORM 会生成一个非正规值,再由 ADJUST_PRECISION 按指定精度舍入。如果值小到连非正规数都装不下,就视情况返回 +0 或 -0。
对于已屏蔽的上溢,8087 根据指定舍入模式返回无穷大或最大可表示浮点数。无穷大的指数全为 1、有效数字是 1000...,这些值由晶体管直接送上总线。最大浮点数则是算出来的:从无穷大的指数减 1,从零有效数字减 1。
辅助子程序:创建非正规数
8087 有一个颇具争议的特性:非正规数,即比“常规”浮点数更小的数。浮点数的有效数字首位是 1,但如果已经用了最小指数还要更小的数怎么办?8087 允许打破有效数字以 1 开头的规则,产生更小的非正规化数。非正规数大幅扩展了范围,最小可以再小 2^63 倍。但非正规数精度较低,因为高位被“浪费”了;而且与非正规数有关的计算往往明显更慢,因为需要特殊处理。
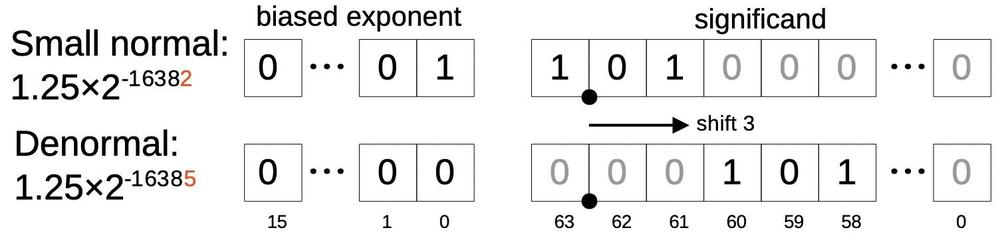
上图是一个指数已最小的正常数(-16382,偏置后为 1)。把它除以 8(即缩放 -3)会产生非正规数,因为指数不能再减小了。于是有效数字右移 3 位,指数换成特殊值 0,表示这是非正规数。
在 8087 中,非正规数由一个微程序子程序创建,我叫它 CREATE_DENORM,许多算术运算都用它,不止 FSCALE。该子程序接收一个正常数和一个移位量,通过移位(如上例)生成非正规化数。下面的微程序用指数转换器检查移位量是否达到或超过 64;若是,移位后什么都不剩,返回零。否则把值右移,非正规数存入 B 寄存器。
``` CREATE_DENORM (J20):
0522 sumreg:frac -> expConv 创建非正规数
0523 sumreg:frac -> shiftcount 移位数
0524 若 exponent[6:14] == 0 则跳 #0528 小于 64 则跳转
0525 zero -> Breg 没有位留下,用零
0526 shift tmpA:frac L 0 bytes, 0 bits 穿过移位器?
0527 jmp #0532
0528 shift tmpA:frac R count byte bit 按要求右移
0529 shift R -> Breg 结果送入 Breg
0530 shift tmpA:frac L ~count byte bit 再移回来做粘滞位检测
0531 NOP 等待移位器
0532 rounding(h) -> Breg[grs] 把三个舍入位存入 Breg
0533 return
```
但为什么之后又把值左移(#0530)?目的是取得舍入位。8087 的一条原则是舍入必须正确,这比看起来难得多。要决定如何向上舍入,需要跟踪多得不可能的位。比如计算 1+0 再向上舍入,得 1;但计算 1+2^-10000 再向上舍入,会得到比 1 略大的浮点数。问题是在舍入前如何区分两者,又不存几千位。
诀窍是 8087 保留三个用于舍入的位:“保护”位、“舍入”位和“粘滞”位。把有效数字右边看作一条“尾巴”,保护位是尾巴的最高位,接着是舍入位。粘滞位很特别:它是尾巴所有剩余位的或,表示其中是否有任何一位为 1。于是 1+2^-10000 的粘滞位被置位,而 1+0 没有,两者就能以不同方式向上舍入。为生成粘滞位,8087 用一个非常大的 64 位或非门并行检测尾巴各位。
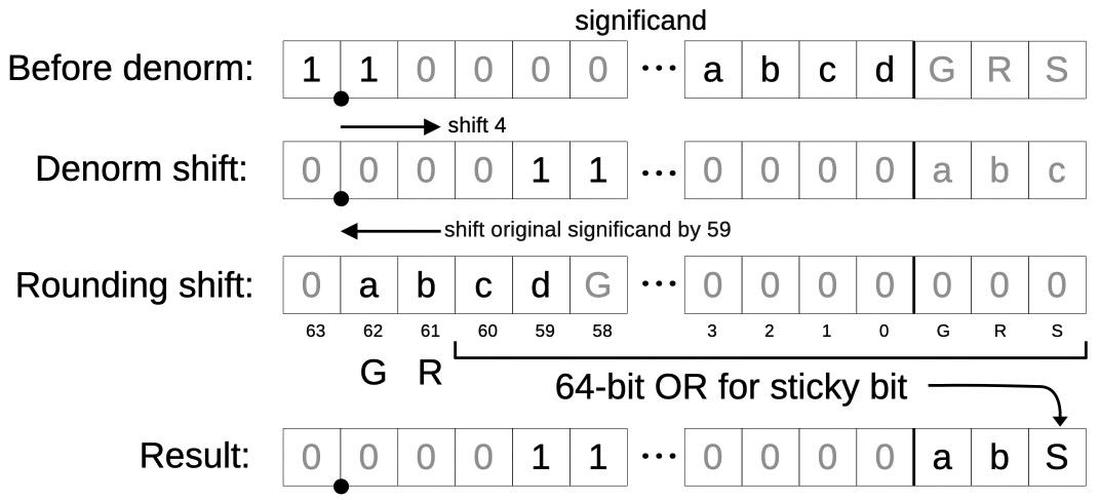
当一个数右移(比如创建非正规数)时,右边的位会丢失。为生成舍入位,程序把值向“左”移,保留最终会被丢弃的尾巴位,同时丢弃最终有效数字中的位。最高两位变成保护位和舍入位,其余位相或生成粘滞位。上图就是一例:假设值要右移 4 位,尾巴位 abcd(至少 d)会在移位中丢失。把原有效数字右移 59 位(4 的补数)来计算舍入位:第 62 位 a 成为新保护位,第 61 位 b 成为新舍入位,剩余 64 位相或成为新粘滞位。(旧有的保护、舍入、粘滞位也会或进来,不会丢失。)把第一次移位的有效数字与第二次移位得到的舍入位合并,就得到所需结果。
辅助子程序:调整精度
虽然 8087 支持三种长度的浮点数,但所有计算都用 80 位“临时实数”进行。指令结束时,结果才转成所需长度(因此用较短浮点数,大多数指令并不会更快)。有个我称为 ADJUST_PRECISION 的微程序子程序,按控制字指定的精度、用指定舍入模式转换结果。大多数算术指令都用它。
第一条代码路径处理临时实数(64 位精度)。控制字指定四种舍入模式之一。但对特定有效数字,实际只有两种动作:向下舍入(截断)或向上舍入(截断后加 1)。这个决定由复杂逻辑电路做出,电路检查舍入位、舍入模式和符号,确定该向上还是向下。这简化了微程序,却让硬件更复杂。微程序执行条件返回:若有效数字不需要向上舍入就直接返回;否则给有效数字加 0 并置进位输入,使其加 1。然后检查是否溢出,若溢出就用无穷大替换,并设置特殊标志。
``` ADJUST_PRECISION (J11):
0299 若非 precision64 则跳 #0306
0300 若非向上舍入则 return,并更新 CC1 更新条件码,可能返回
0301 adder: sumreg:frac + 0 cin=1 加 1 以向上舍入
0302 若非 sumreg[64] 则 return
0303 Inf -> sumreg:frac,sign 溢出则返回无穷大
0304 2count++ 设置特殊标志
0305 return
0306 23/52 -> shiftcount 短或长实数:取相应移位量
0307 shift sumreg:frac,rnd L count byte bit sticky 移位生成舍入位
0308 NOP 等待移位器完成
0309 rounding(H) -> sumreg[grs] 存入舍入位
0310 shift sumreg:frac R ~count byte bit 右移丢弃多余位
0311 shift R -> sumreg:frac
0312 若非向上舍入则跳 #0314,并更新 CC1 更新条件码
0313 adder: sumreg:frac + 0 cin=1 视情况向上舍入
0314 shift sumreg:frac L ~count byte bit 左移回正
0315 shift L -> sumreg:frac,sign
0316 若非 sumreg[64] 则 return 未溢出则返回
0317 jmp #0303 返回无穷大
```
返回较小精度(短实数或长实数)时,代码更复杂,因为有效数字必须缩短。首先 #0306 按控制字指定的精度把 23 或 52 装入移位器,然后把值左移,像上一节那样产生舍入位。接着把值右移,缩短到目标长度。和之前一样,视是否需要向上舍入来给有效数字加 1 或不变。最后把值左移回去,使有效数字最高位在左边。同样,如果向上舍入导致溢出,就返回无穷大。
一个奇怪之处是,带“向上舍入”条件的跳转还有一个副作用:更新 8087 程序员可见的条件码寄存器 CC1,表示结果被向上还是向下舍入。也就是说,8087 有额外电路检测这一特定条件并把值装入条件码锁存器。奇怪的是,8087 文档没有描述这个条件码动作;英特尔直到 1987 年的 387SX 浮点芯片才记录下来。
结论
浮点技术的历史远比 8087 悠久。例如 IBM System/360 大型机(1964 年)就支持 32 位和 64 位浮点数。1977 年 AMD 推出 Am9511 浮点芯片,支持 16 位和 32 位浮点数以及超越函数。8087 的革命性在于它精心设计、力求数学上尽可能精确,这主要归功于数值专家 William Kahan。(8087 促成了 IEEE 754 标准,如今几乎所有计算机都在用,终结了互不兼容浮点标准的无政府状态。)
8087 最终变得极其复杂:三种浮点数长度、四种整数长度、四种舍入模式、无穷大模式、一堆可屏蔽或不可屏蔽的异常、非正规化和未正规化数、带符号和无符号无穷大、带符号零,还有整整一个 NaN 家族。这些特性组合起来产生许多边角情况。8087 既靠专门电路,也靠纷繁复杂的微程序来应付这种复杂性。
8087 有多复杂?对于没有 8087 芯片的用户,英特尔出售过 8087 Support Library,能精确模拟 8087 的指令(但慢得多)。这个模拟器占 16K 字节的 8086 代码,而在当时一个完整的 BASIC 解释器才 8K。换个角度看,8087 的硬件大幅减少了所需软件:8087 本身只用 3.3K 微程序,而模拟器用 8086 代码要 16K。
评论
讨论围绕 8087 协处理器展开,不少人质疑 x87 架构怪异、对编译器极不友好,也有人盛赞其带来的巨幅提速与非对称并行设计巧思。
认为 x87 架构怪异且对编译器极不友好
- 指出其设计思路类似科学计算器,与现代 CPU 工作逻辑脱节,导致编译适配痛苦,软硬件层面都倾向规避并改用 SIMD;80位寄存器宽度也显得来源不明(较多人) > 这架构简直像为惠普逆波兰计算器设计的,让编译器生成代码苦不堪言,大家能躲就躲改用 SIMD 了(@cogman10)
认为 8087 的性能提升与并行设计极具价值
- 亲历者表示百倍数学提速绝非夸张,且在旧机器上体验过 3 秒对 300 秒的悬殊差距;其指令流可与 x86 交错形成非对称多处理器,让浮点与整数代码真正并行(较多人) > 8087 指令能和 x86 交织在一起,等于构成了双芯片并行工作的异步多处理系统(@garganzol)
有价值的补充
- 从单一缩放指令扩展到 140 条微指令的实现方式,使特殊情形处理机制变得更加直观具体(@finn888)
- 本文作者现身帖子,表示可解答关于 8087 的疑问(@kens)