2026年6月中下旬,Read the Docs 遭到其历史上规模最大、最复杂的分布式拒绝服务(DDoS)攻击。峰值时,其基础设施每分钟被超过550万次请求冲击,约为正常基线流量的100倍。事件持续近十天,考验了基础设施、边缘防御和应急响应流程。与以往更简单的流量洪水不同,这次攻击更分散,能快速适应防御措施,并刻意攻击绕过缓存的区域。
正文
2026年6月中下旬,Read the Docs 遭遇了史上规模最大、最复杂的分布式拒绝服务(DDoS)攻击。峰值时段,我们的基础设施每分钟承受超过 550 万次请求,大约是正常基线的 100 倍。
事件持续近十天,考验了我们的基础设施、边缘防御和应急响应流程。与过去简单的流量洪峰不同,这次攻击分布更广,能快速适应防御,并有意攻击绕过缓存的区域。
等运维小队终于能正常作息后,我们想拆解这类攻击的构成,解释为何现有速率限制只能部分缓解攻势,以及哪些策略真正帮我们(基本)维持了服务可用。
DDoS 攻击的演变
Read the Docs 历来对抓取托管文档的爬虫和机器人很宽容,基于 IP 的速率限制解决了大多数滥用问题。约两年前,随着 AI 爬虫泛滥,问题显著增加,其他开发者基础设施社区也遇到类似状况。将 AI 生成的爬虫接入代理网络变得轻而易举。我们的防御轻松适应了这一点,但 6 月的攻击比以往任何一次都大了 10 倍以上。
此次攻击的主要特征包括:
- 海量规模:峰值时我们每分钟收到 550 万次请求,而正常日均峰值不到每分钟 10 万次。
- 全球分布:恶意请求来自全球数百个网络(ASN)中的数百万独立 IP,包括住宅 IP 段以及大小托管服务商。
- 请求头与 TLS 随机化:攻击者系统性地随机化 HTTP 请求头和 TLS 连接参数,以规避基于签名的过滤器(JA3/JA4)。
- 自动化 CDN 防御的局限:Read the Docs 使用 Cloudflare,其自动 DDoS 防护挡住了部分来自“已知僵尸网络”的流量,但很大部分攻击绕过首层检测,触及我们的速率限制和 WAF 规则。
- 缓存规避:攻击者找到并刻意针对导致缓存未命中的 URL,比如带唯一路径的不存在页面(404)以及临时重定向(302)。
- 自适应行为:当我们实施封锁或限流时,僵尸网络会调整请求速率,轮换目标路径并分散到更广的 IP 池,探查防御边界。
规模与广度
以前见过的小型 DDoS 或大型分布式爬虫通常在某些方面集中:来自少数国家、少数 IP 段或少数浏览器签名。这次攻击真正全球化,同时来自每个国家,这对按 Cloudflare 节点施行的限流规则来说是噩梦。很难制定规则在限制分布式攻击时,又不误伤从单一 IP 或子网以合理速率抓取的合法机器人。
攻击者曾集中攻击重定向,用足以让水平扩展基础设施丢请求的量,压垮了一个硬编码的 Nginx 重定向(一个简单的 rewrite 正则指令)。这种 Nginx 重定向本可轻松处理每秒数千请求。
除了遍布全球,攻击还同时打击多个 Read the Docs 资产。公共社区文档和商业托管文档都被攻击,我们还看到攻击者试图搞垮需要登录的作者仪表盘。
我们本可启用 Cloudflare 的“Under Attack Mode”,给每个访客(无论合法与否)发 JavaScript 挑战,但不想这么做。这会搞坏所有 API 集成,给数十万真实文档读者带来摩擦。相反,我们依靠速率限制和定向挑战,结合更多缓存并将更多功能推到边缘。
适应我们的防御
Read the Docs 重度使用 Cloudflare 做缓存和限流,没有它我们扛不住这次攻击。我们有几十条通过 Terraform 管理的限流规则,基于 IP、数千主机名和数十万子域名、ASN、浏览器指纹及组合来保护基础设施。
攻击始于少数域名,攻击者发现了未被边缘缓存、由 Python 后端而非 Nginx 服务的临时重定向(302)。几分钟内运维因短暂中断被呼叫(用户未必察觉,因为缓存文档仍在服务),约半小时内我们将这些重定向移到 Cloudflare 边缘服务。以为结束了,结果攻击者在随后一周半里换着主机和服务尝试不同战术。
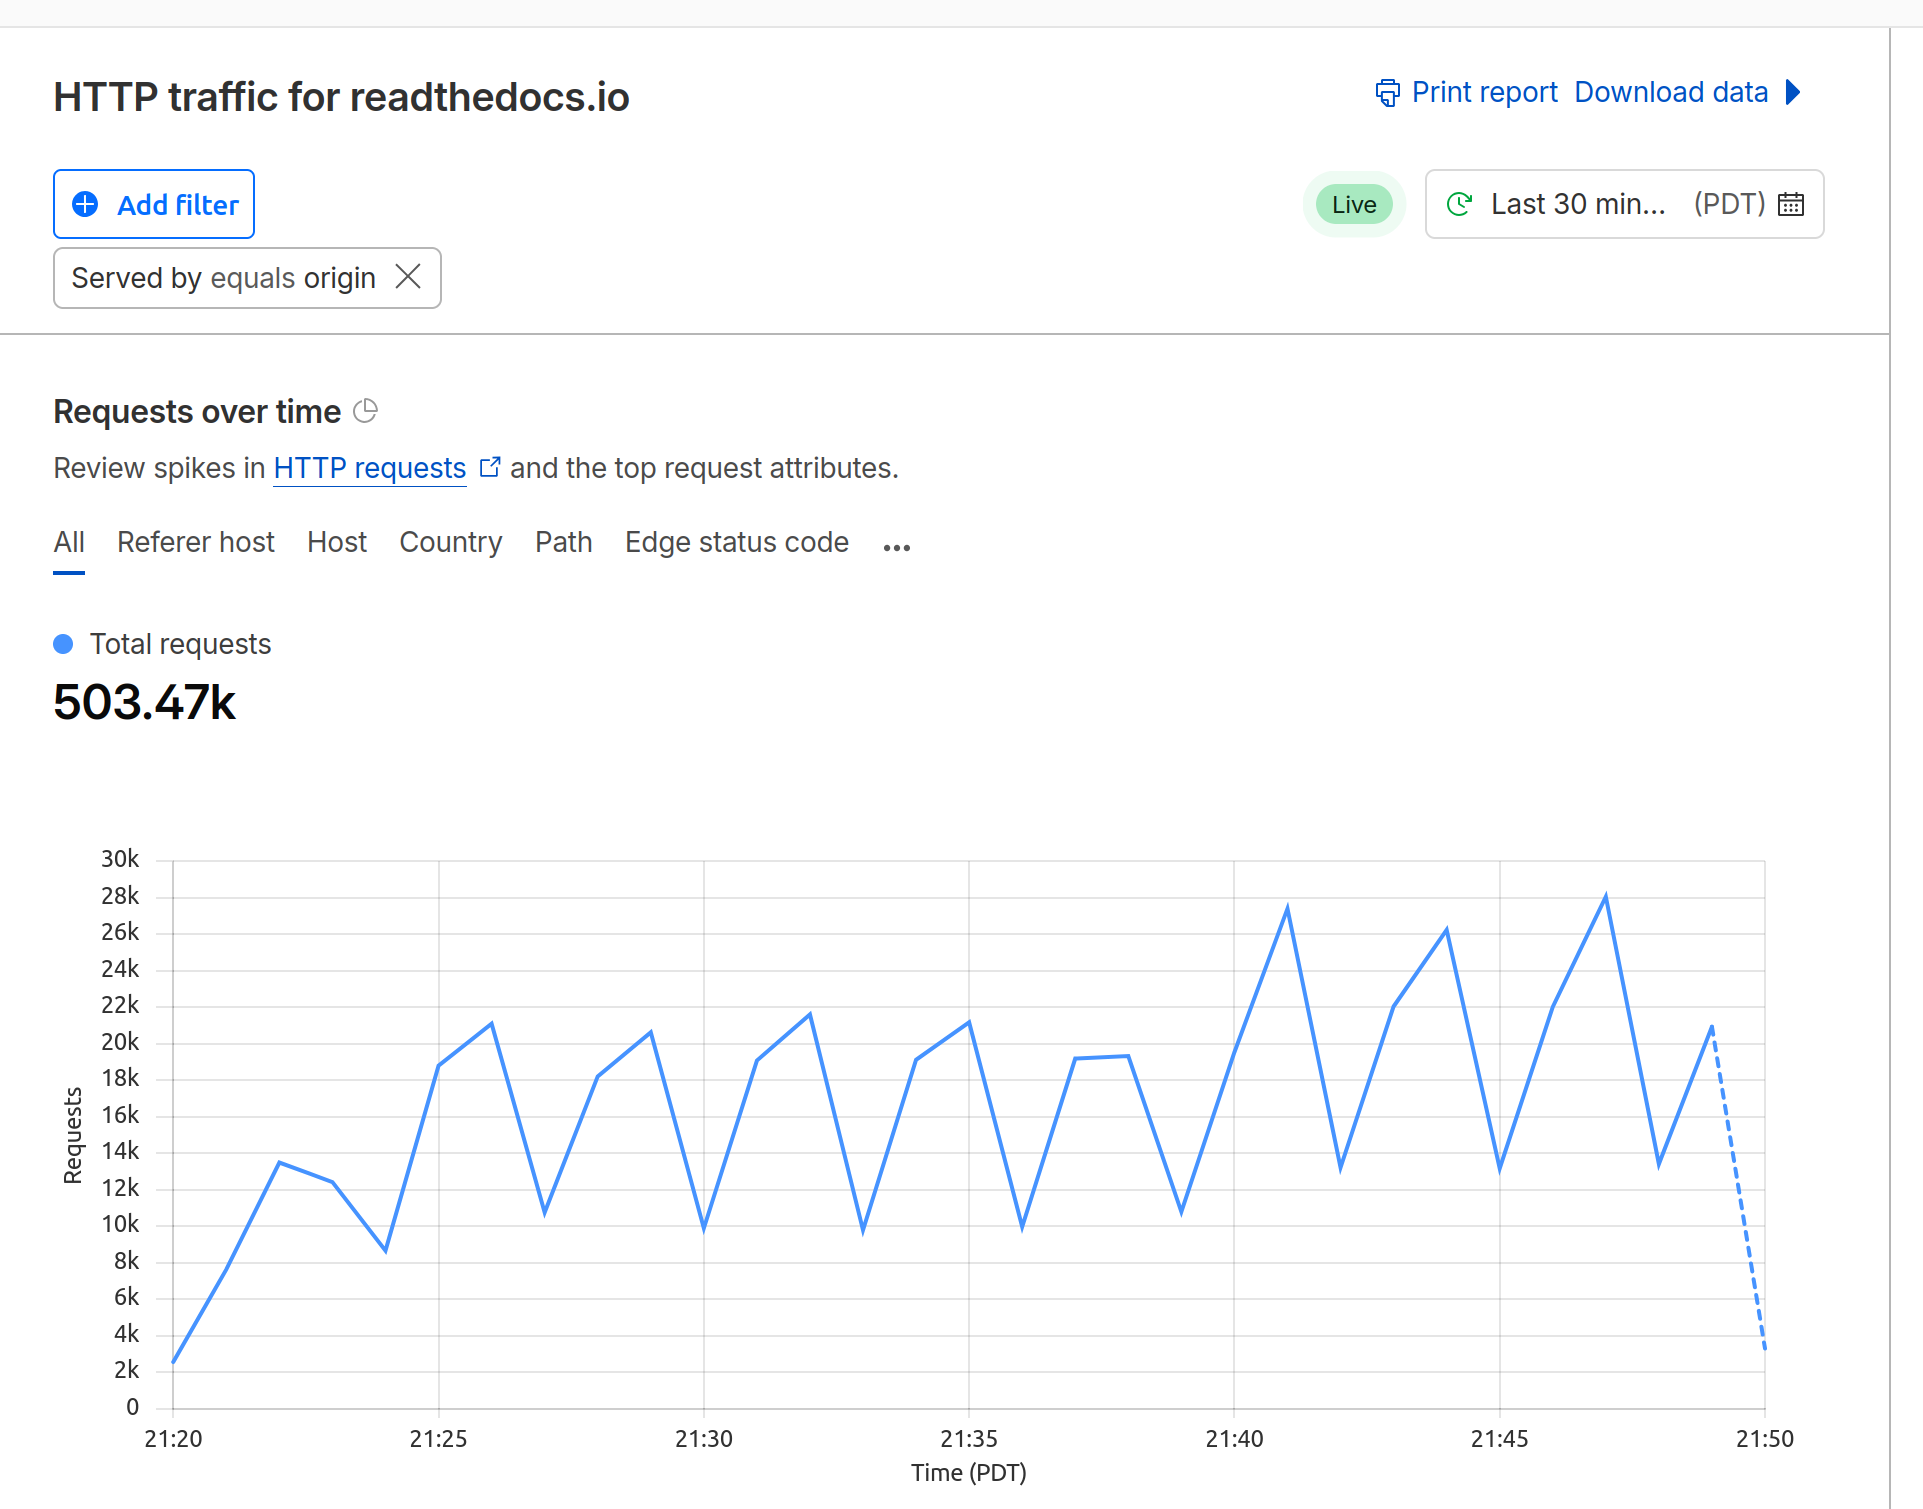
攻击者会加大请求量探测我们的限流阈值,然后退避等待限流窗口过期。这叫溜溜球模式,旨在最大化自动扩展基础设施的财务成本并造成间歇性服务降级。攻击者知道我们运行着带限流的 WAF,也知道如何尽管有防御仍造成最大破坏。
防御海量 DDoS 攻击
防御每分钟数百万请求的洪流需要深度防御:边缘缓存、WAF、速率限制、本地缓存和请求指纹。最快的请求是由 CDN 或 WAF 处理的。
边缘缓存
第一道防线(且我们已重度使用)是合适的 CDN,确保尽量少请求命中源站。对 Read the Docs 这种文档不常变的站点,我们激进缓存,但在新文档推送到 git 重建时会清除特定站点缓存。CDN 也让偏远地区的人更快取文档。
但攻击者通过 CDN 响应速度很快发现哪些请求被缓存。这意味着只要找到几个未缓存请求就是攻击角度。我们仍在找更多未缓存路径,但即使给重定向和 200 响应设置极短缓存(用 Cache-Control 头)也有助于防御。

速率限制与指纹
既然不想给所有用户 JS 挑战,我们用定向速率限制规则,结合机器人概率分数和每 IP 限流,挑战可疑流量,放行合法用户和规矩机器人。解过 JS 挑战的人都知道很麻烦。我们决定放些恶意流量进来,优先不挑战真实用户。但限流仍必要。
防御重点须从请求来自哪(IP、国家)转向请求长什么样:
- 密码套件与 TLS 异常:自动爬虫客户端的 TLS 连接常与浏览器不同。Cloudflare 机器人检测有专用工具检测这些。
- 过多错误请求:合法用户和好机器人几乎总收到 200,而非重定向或 404。200 总被缓存,很少出问题。当我们看到过多昂贵请求(如重定向或 404),就开始限制浏览器指纹、ASN 甚至特定域名。加这些我们称为“惩罚区”的规则,可能对自动缓解随时间变化的攻击起了最大作用。
- 协议不一致:恶意工具常声明现代 User-Agent 却用旧 HTTP/1.1。不过这次攻击全是 HTTP/2 和 HTTP/3,这招没用。
- 客户端指纹:用相同 TLS 套件的 Golang 或 Python requests 模块会有相同 JA4 指纹。这指纹针对工具而非用户。但攻击者随机化 TLS 参数,这也不管用。
- IP 段分类:我们仍在将更多 IP 段分类设限。像 Read the Docs 这种接收大量自动流量且允许机器人的服务,知道会收很多来自 Amazon、Google Cloud、Azure 等主流云 ASN 的流量。它们该比住宅或小型托管商有更高限额。
给用户逃生舱
我们决定始终给真实用户逃生舱。Read the Docs 极少直接封锁特定 IP 或 UA,最严不过是 JS 挑战,用户解了挑战后约一天内不太会被再挑战。
经验教训与关键收获
2026年6月的 DDoS 攻击强化了运维高流量基础设施的几条关键认知:
- IP 封锁对分布式攻击已过时:僵尸网络用代理让简单 IP 封锁无效。防御需在 IP 之外(ASN、主机名等)设更广限流。
- 激进缓存:缓存一切,无论是静态文件、404 还是临时重定向。哪怕几分钟短缓存也能防基础设施被利用。CDN 和多数框架默认设置不适合我们。
- 保护缓存未命中面:攻击者主动搜不可缓存路径(动态重定向、搜索端点、404)。尽可能缓存,不行就尽量在边缘处理。
- 定向挑战优于粗暴手段:结合机器人启发式与限流,能在最小影响合法用户下缓解攻击。
- 基础设施即代码必不可少:通过 Terraform 管理边缘和 WAF 规则,让我们能快速安全审查、测试、版本控制和部署复杂过滤规则。
攻击 IP 段仍有低水平后台流量,但基础设施比攻击前强很多。随着 AI 工具和代理网络让这类攻击更廉价易得,它们不再只针对大企业,已成任何高曝光公共服务的基本现实。运维队能睡整觉了,但视此为延长休战而非攻击终结。
评论
社区对文档托管站遭遇异常流量事件成因分歧明显,多数人推测是配置失误的自主 AI 爬虫造成伪 DDoS,少数人赞赏其温和的用户挑战策略或呼吁法律追责,其间也夹杂将其视作免费负载测试的调侃。
怀疑是自主 AI 爬虫配置失误造成的伪 DDoS
- 文档内容多为静态易缓存,常规攻击需极大成本,更可能是新一代具备自我修复能力的抓取器因过于自主而误伤,或存在恶意实验室意图干扰对手训练数据(较多人)。 > 新一代爬虫都很自主且能自我修复,也许是某实验室的数据抓取器配置得太激进而意外演变成流量冲击。(@Onavo)
认可文档站温和的用户保护策略
- 赞赏其坚持用脚本挑战而非直接封禁地址或地域,认为这避免了无辜用户被牵连,是专业且顾及用户体验的做法(高赞)。 > 终于看到了不让用户干瞪眼的专业响应,受够了那些动辄屏蔽整片大陆的笨拙手段。(@ACCount37)
质疑防护模式未启用及实际效用
- 有人不解为何未采用现成的攻击应对模式来临时拦截非接口流量,也有人指出攻击具有适应性,此类挑战机制未必能有效缓解(较多人)。 > 鉴于攻击本身的适应性,很想知道挑战机制面对这种障碍时究竟会如何被绕过。(@fn-mote)
呼吁通过法律途径追责源头制造商
- 建议追查流量源并起诉设备生产方,利用侵权或计算机法施压,指出制造商的用户协议无法对抗受害方(少数人)。 > 被攻击方并非设备用户协议的签约方,因此制造商的免责条款毫无用处,应当直接起诉。(@Animats)
有价值的补充
- 从网络架构看,困惑为何服务商不在上游层面通过丢弃异常包来化解威胁,推测背后可能涉及利益驱动而非技术不可行(@gopher_space)。