最近几周发生了很多事。OpenAI 的 GPT-6 Astra 是当前大家关注的焦点,尤其是它的性能、循环Transformer(looped transformer)的循环深度,以及它是否隐藏了推理轨迹(即思维链)的传闻。上周这款模型高调发布,我用过几天,是我目前用过最好的模型,尤其在3D渲染和动画任务上表现出众。
正文
最近几周发生的事不少。大家眼下最关心的自然是 OpenAI 发布的 GPT-6 Astra:它的性能、looped transformer/recurrent depth 的传闻,以及它是否在“隐藏”推理轨迹。我下面先谈一点对 Astra 的印象,再详细解释 looped transformer 是什么,然后回到它是否与隐藏思维链有关。
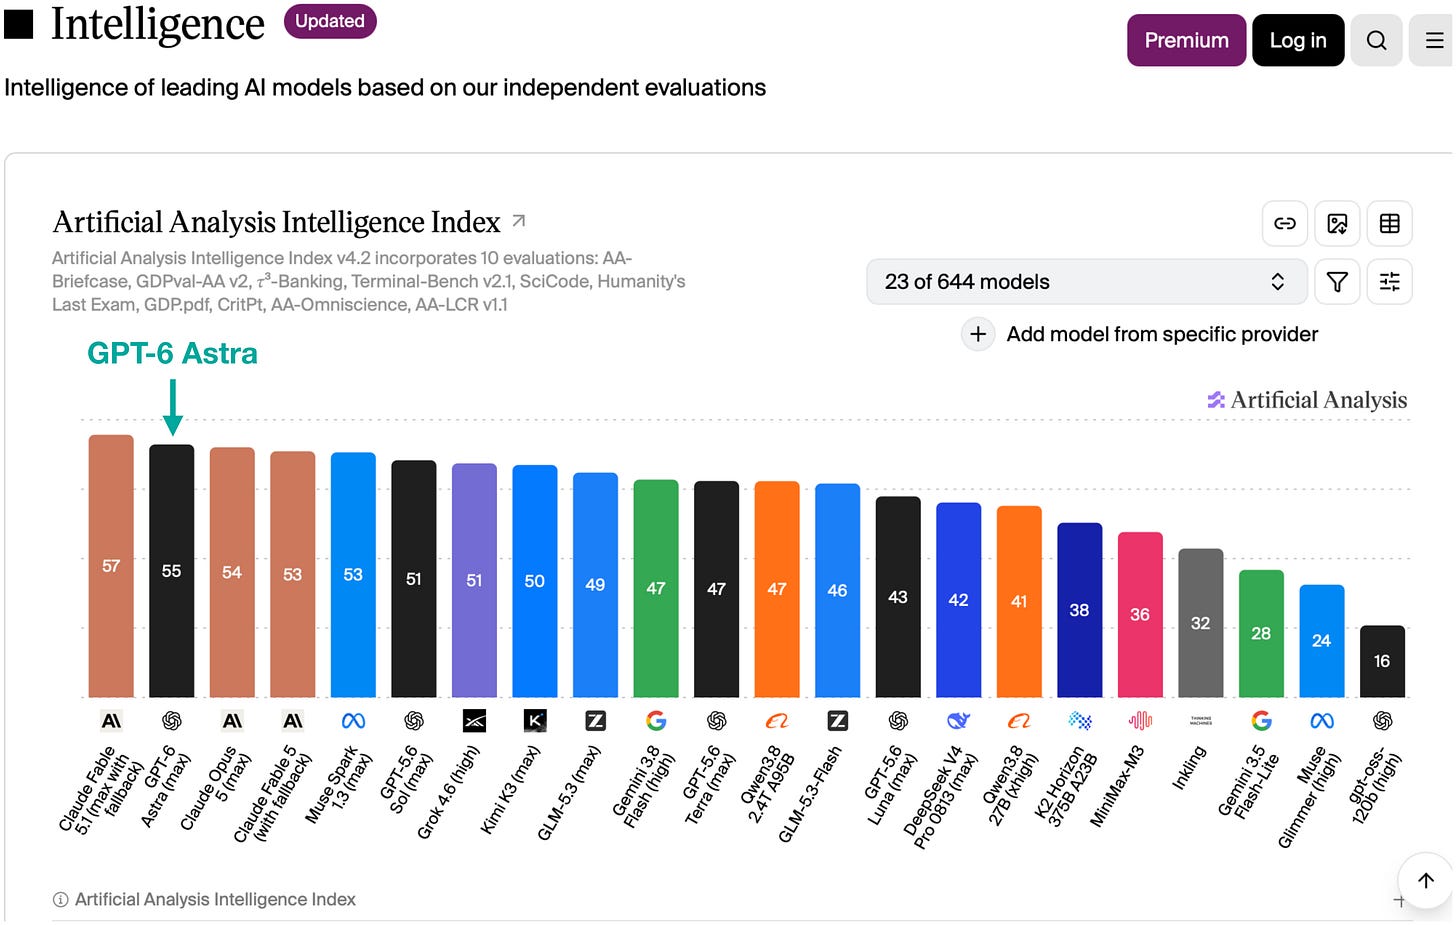
上周 Astra 高调发布,我用了几天。它是我目前用过的模型里最好的,尤其擅长 3D 渲染和动画;相比 GPT-5.6 Sol,它在写作、数学、编码等几乎所有类别上都有大幅提升,但图形相关任务上的提升最明显。基准测试也体现了这一点:Astra 在 ARC-AGI-3 上拿到 99.9%,而 GPT-5.6 Sol 只有 7.8%;不过数学、编码和 computer use 的基准更接近真实使用。在 Artificial Analysis 的 Coding Agent Index 和综合 Intelligence Index 上,Astra 都处在前沿,但没有形成压倒性差距。这套独立基准相对可信,不过要注意 harness 的影响:模型训练时通常围绕某个主要 harness 优化,共用 harness 的比较会更公平,但反过来看,它也可能低估 Astra 在自己主 harness 上的真实表现。
Astra 在图像、渲染等与 GUI 打交道的任务上尤其强,能通过 Codex/ChatGPT 操作本地软件,这就是 computer use。这大概是它对比其他模型最亮眼的地方,社交平台上也有大量演示。举个例子,我让 Astra Medium 和 High 在浏览器版 MS Paint 里用鼠标重画我的一张照片,它不仅能画,更重要的是会操作电脑里的工具。它当然不是第一个能在 harness 里使用图形界面的模型,但过去这类能力的成熟度一般不高。LLM 毕竟是文本模型,写作、编码和 CLI 是更容易摘取的果实;但很多软件没有 CLI,与其等别人改造接口,不如让模型学会用 GUI。这和类人机器人有点像:在专用流水线上未必最高效,但胜在通用。所以未来几个月或几年,模型和 agent harness 层都会重点打磨 computer use。
这也和 OpenAI 购买大量 Mac Mini、Mac Studio 做强化学习的报道吻合。这些 Mac 不用于真正训练模型,而是作为训练环境,让模型学习操作 macOS 和其中的工具。基本流程是:
- 给模型一个任务,例如“打开某个应用并做某件事”;
- 由 harness 向模型提供 macOS 界面截图;
- 模型预测鼠标、键盘动作;
- 由 harness 在 Mac 上执行动作;
- 执行后再把新的界面截图给模型;
- 重复直到任务成功或失败;
- 用成功/失败信号和验证器作为训练反馈,原理类似 RLVR。
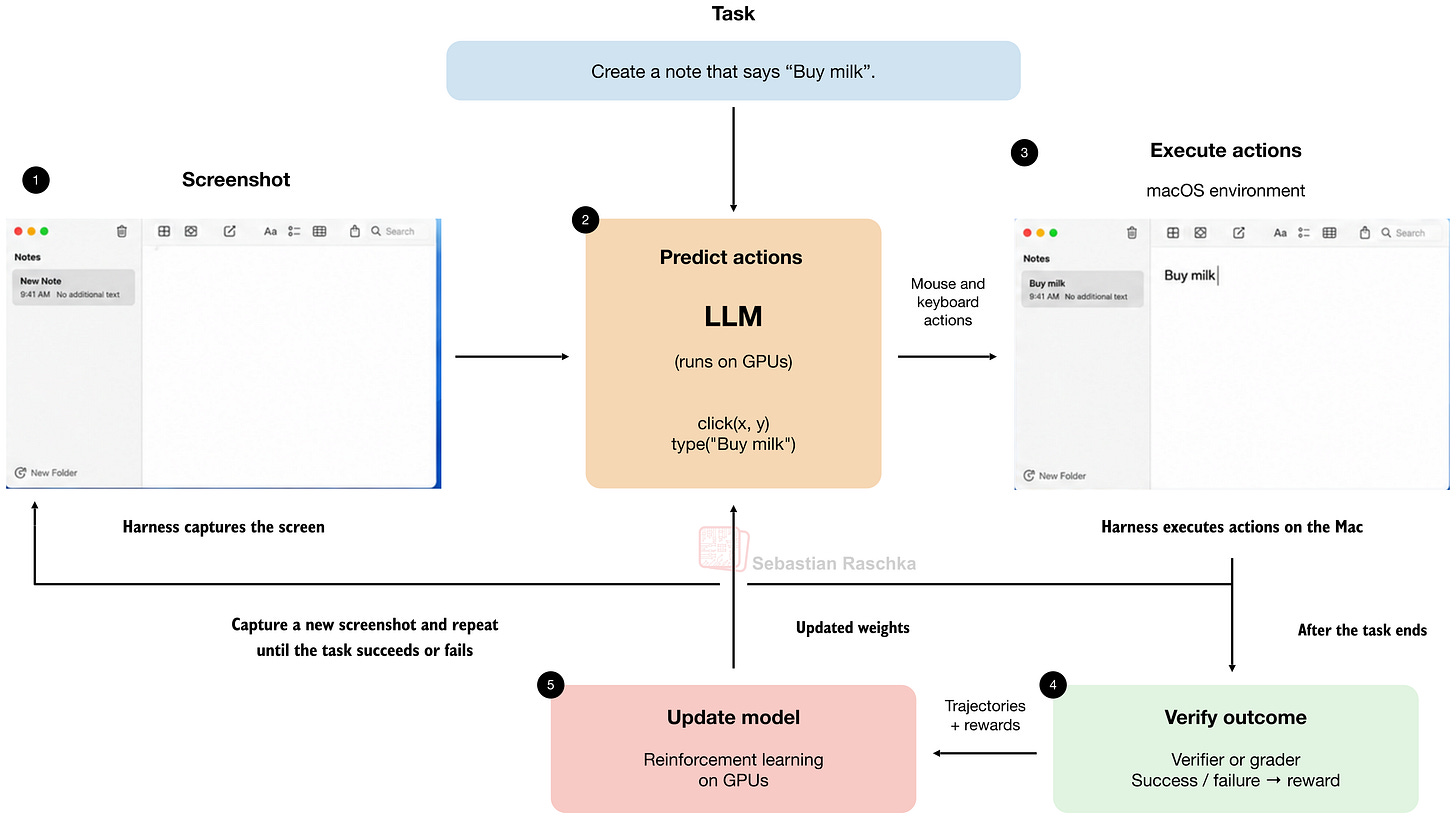
这里 Mac 本身基本只是环境,模型大概在 NVIDIA GPU 上通过 API 驱动这些 Mac。NVIDIA CEO 也提过,GPT-6 Astra 是在约 10 万块 Grace Blackwell GPU 上训练的。这类 computer use 训练并没有根本改变范式:Astra 仍然是推理模型,使用 RLVR,生成中间推理轨迹。
Astra 正式发布前两天,The Information 报道说它用了“recurrent depth”或“looped transformers”。我先解释 looped transformer 是什么,再回过来看它是否掩盖了思维链。
先约定几个词:transformer block 指包含注意力、前馈模块、归一化和残差连接的单位;stack 是一串 transformer block;block application 指把输入过一次 block。
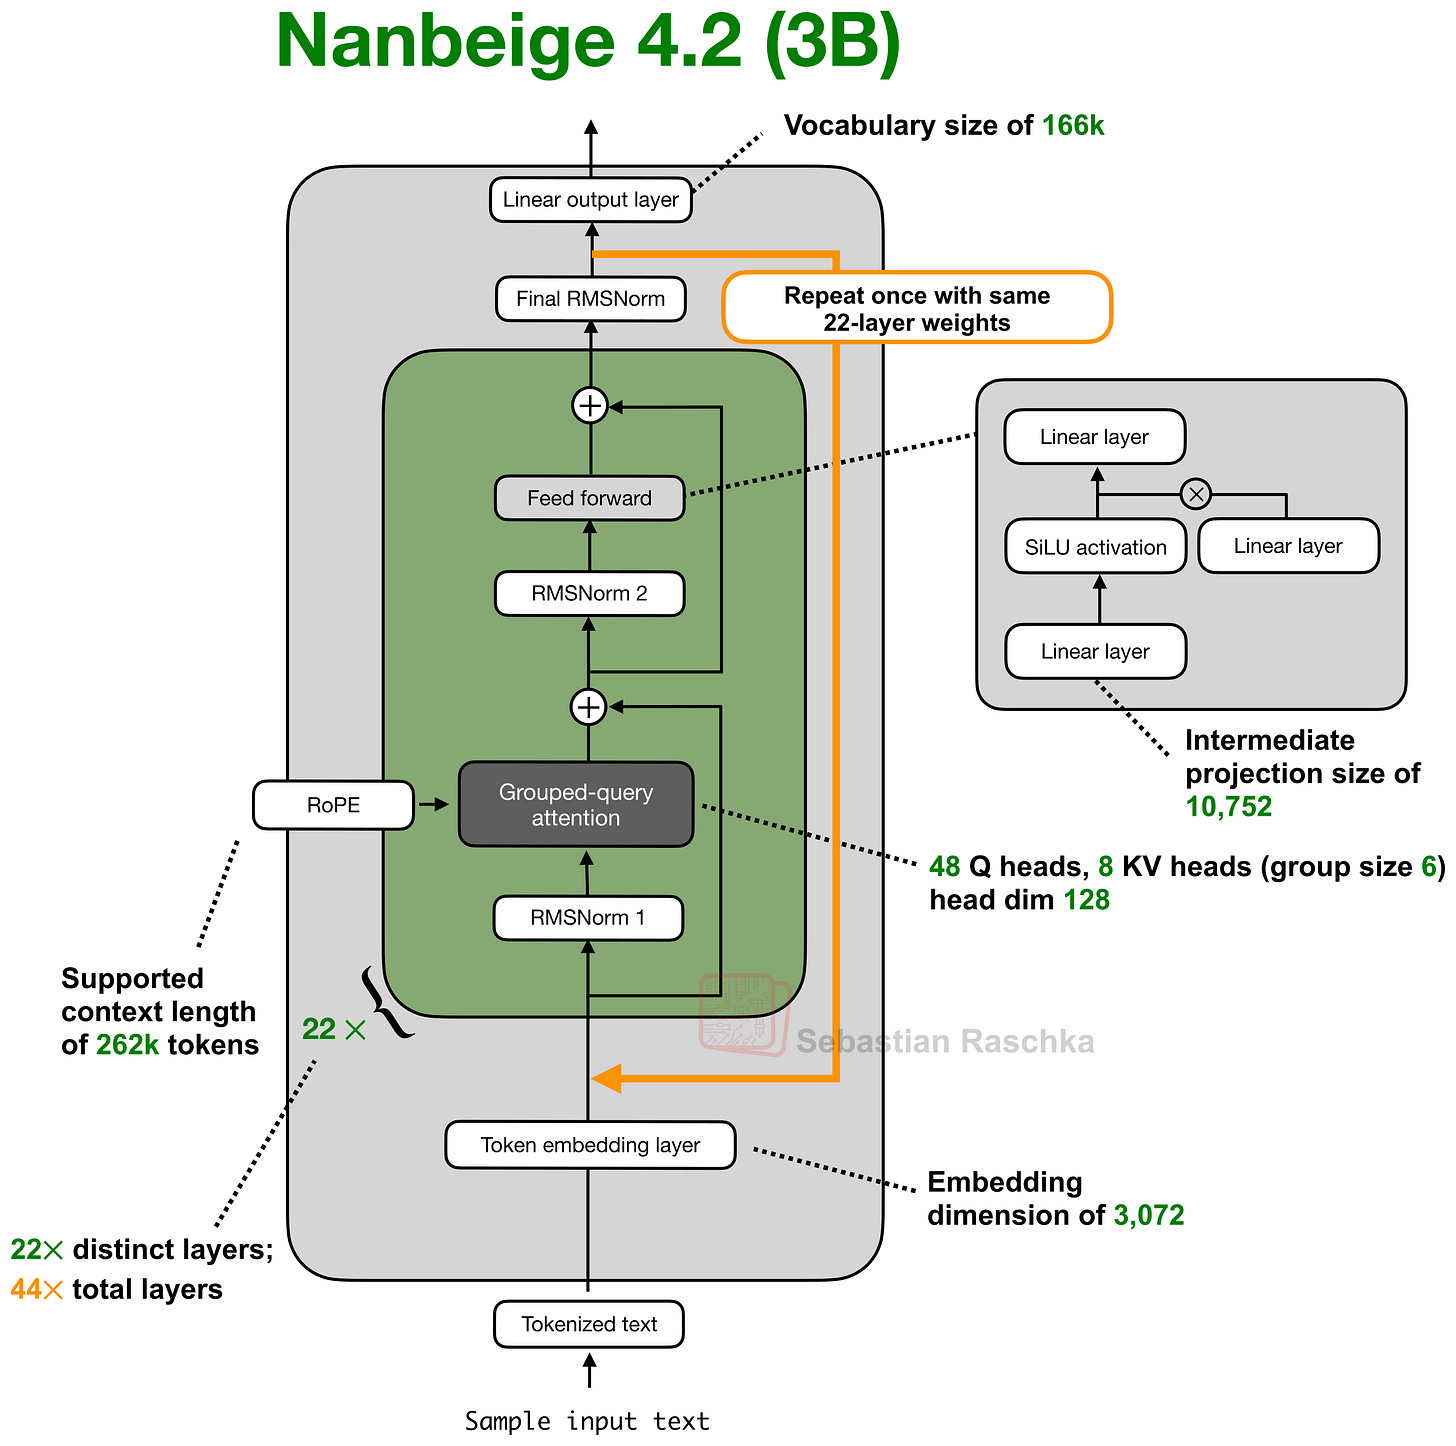
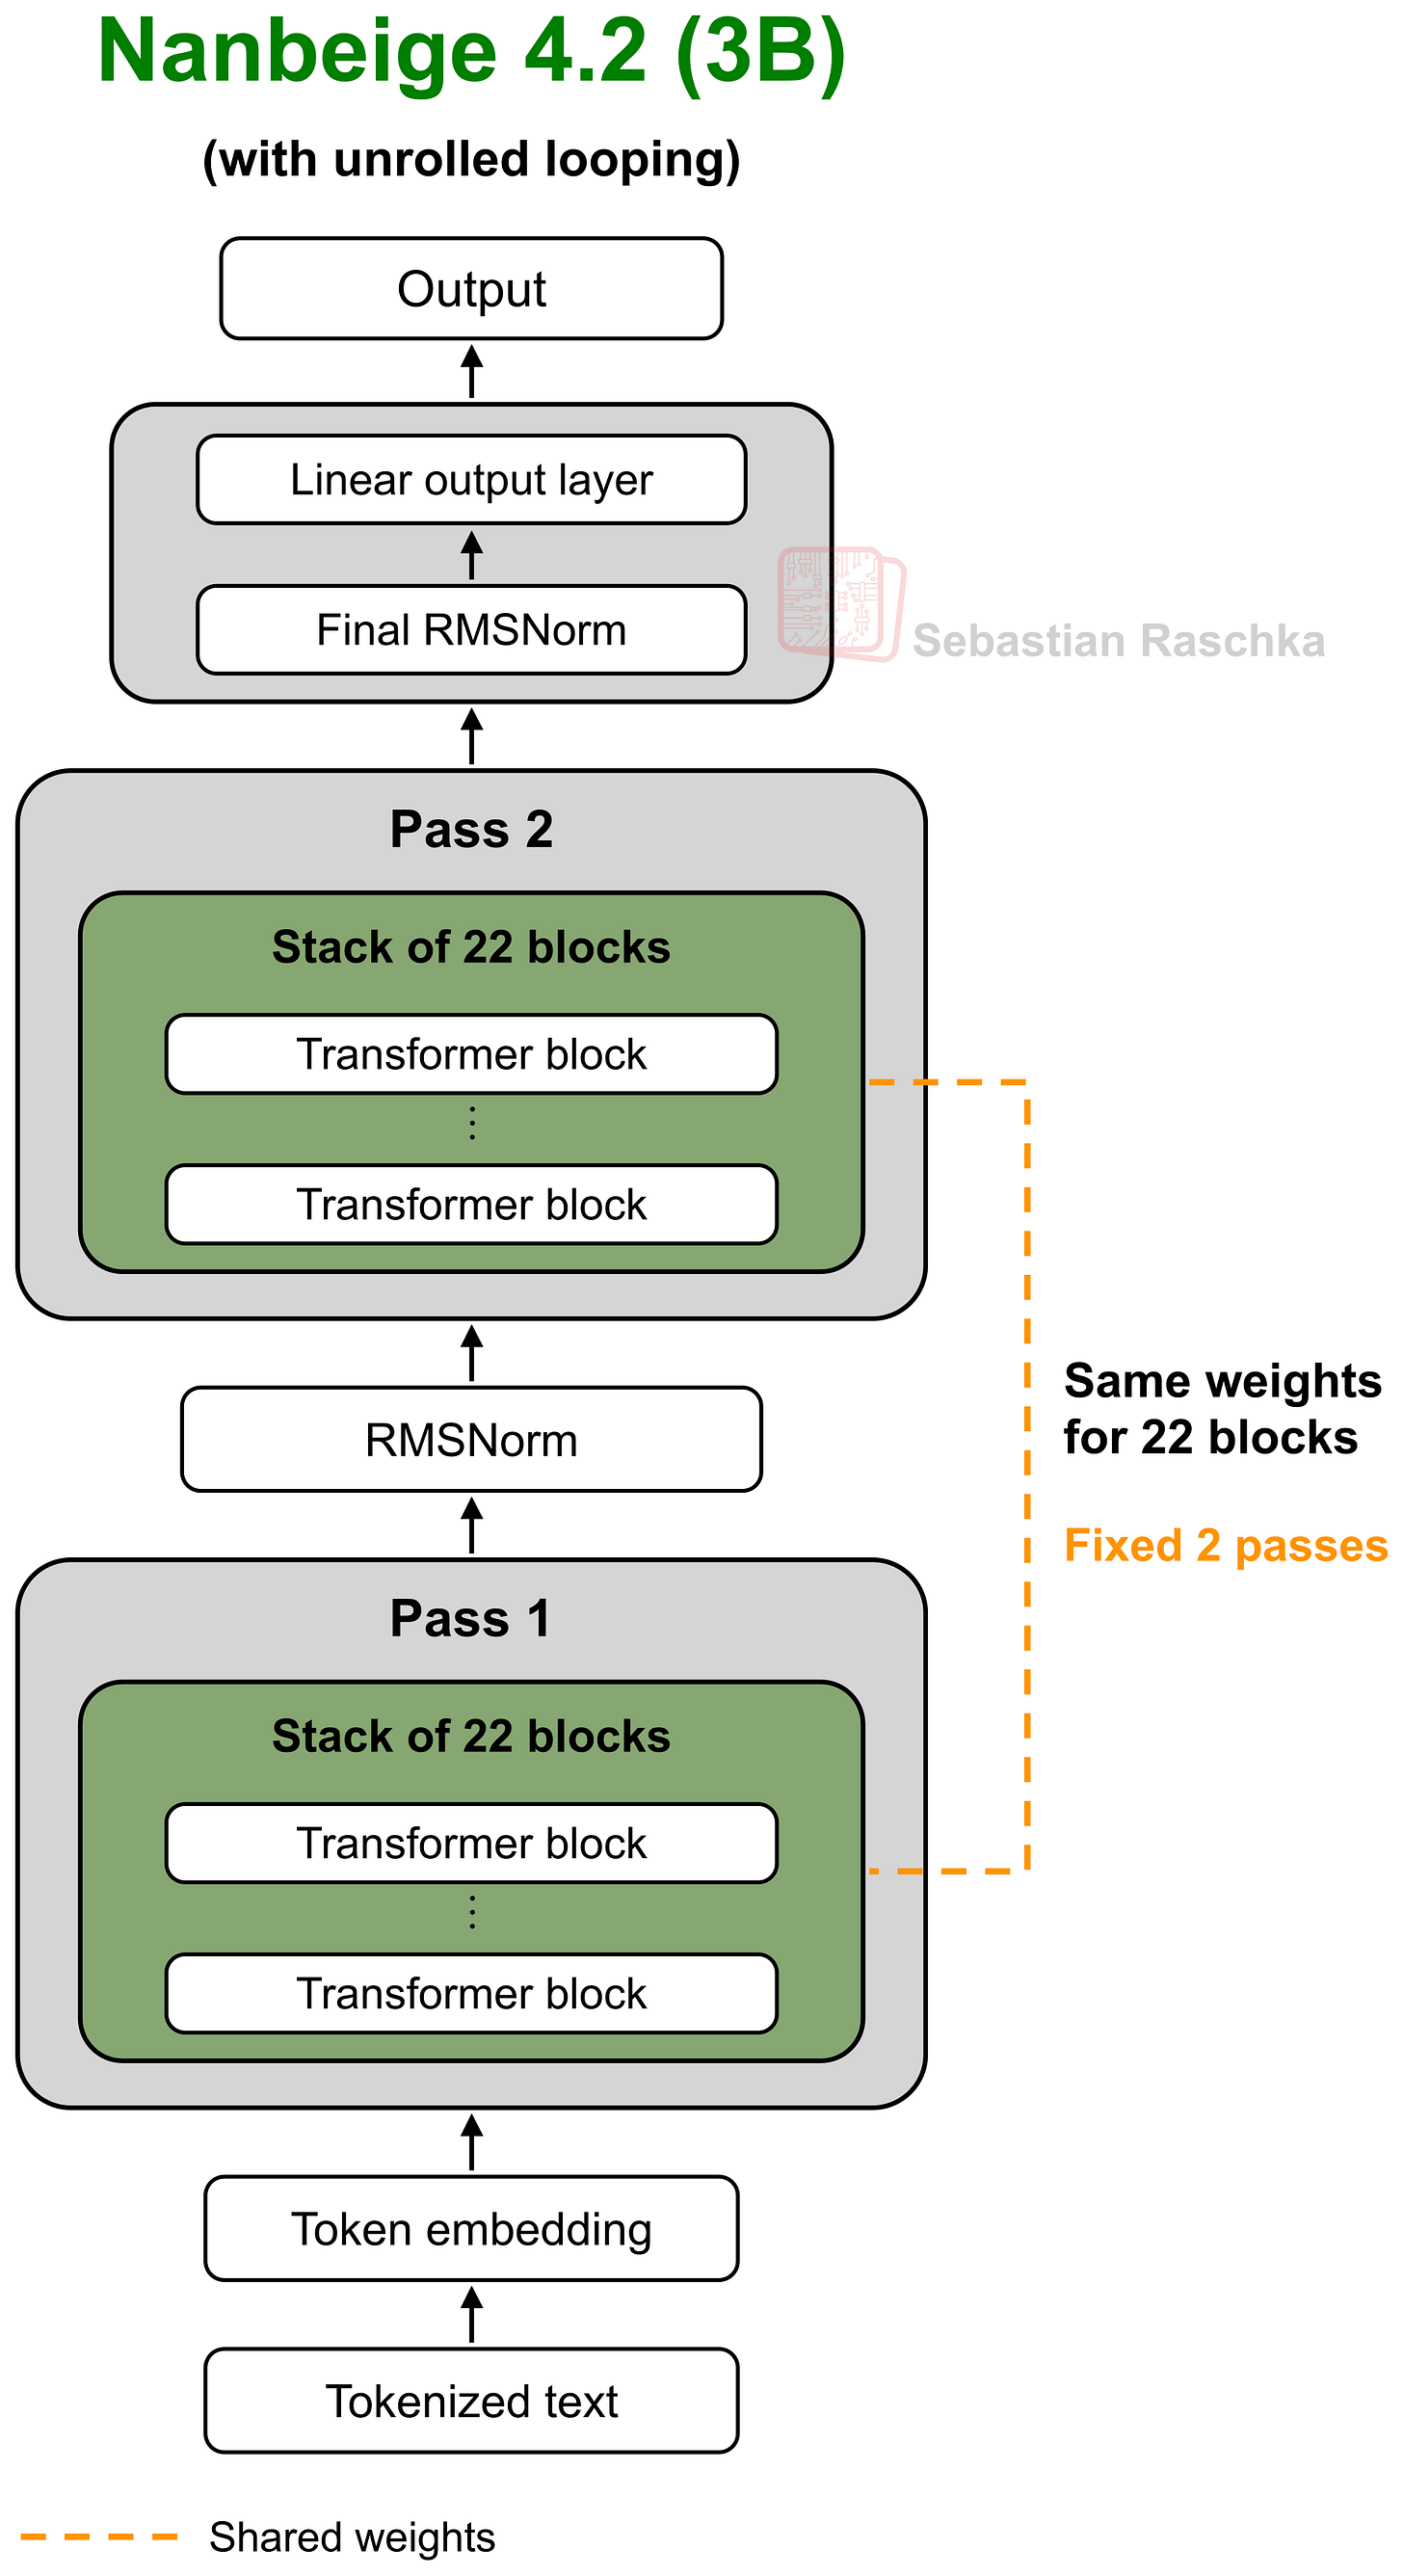
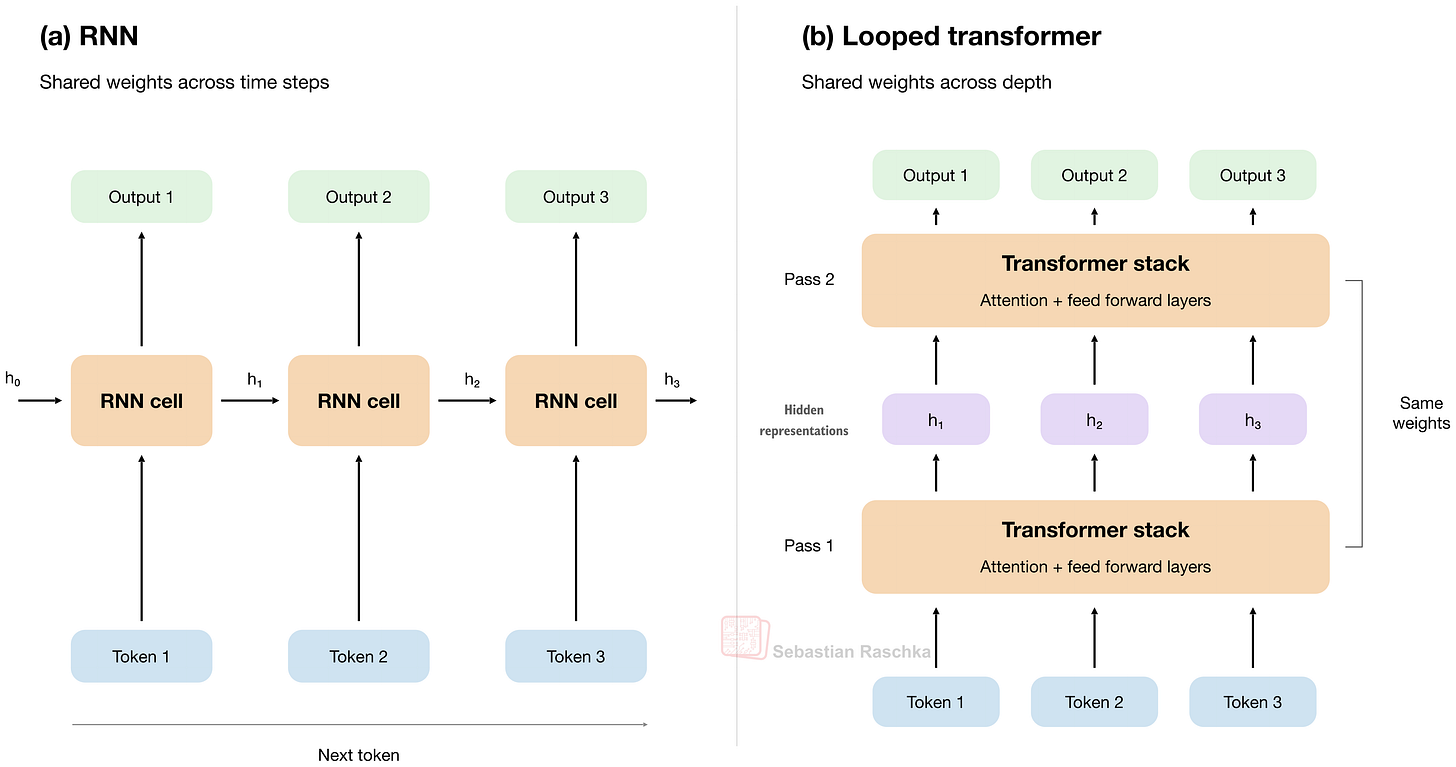
Looped transformer 的核心是把中间表示多次送进同一组 transformer block,而不是只过一遍;与单纯增加层数相比,它的特殊之处在于不同轮次共享同一套权重。这个想法并不新,2018 年的 Universal Transformers 论文里就出现过。先用较简单的 Nanbeige4.2-3B 看。它的结构看起来接近普通 transformer,但有一条回到 stack 开头的循环路径。输入文本先分词并转成 embedding,然后经过 22 个各有权重的 block;随后隐藏状态再次进入这同样的 22 个 block。展开后相当于 44 次 block application,但和普通 44 层模型不同,第二遍完全复用第一遍的权重。于是有效深度从 22 变成了 44,却没有新增一套 transformer 权重。
如果把计算展开,结构如下:第 23 次 block application 用 block 1 的权重,第 24 次用 block 2 的权重,依此类推。
为什么只用两轮,而不是三轮四轮?Nanbeige 论文说这是效率最高的配置:从两轮增加到三轮还能再提高一些性能,但多出来的计算成本不划算。这样做的意义,本质上是用“重复利用层”来替代“增加层”。一个 22 层 block 重复两次的模型,其 transformer block 参数大约只有普通 44 层模型的一半,因此权重存储更小。当然这里没算 embedding 和 output 层,它们通常也很大;在 Nanbeige 4.2 3B 里,这两层约占全部 30 亿参数的四分之一,若在两者间共享参数还能降到八分之一。
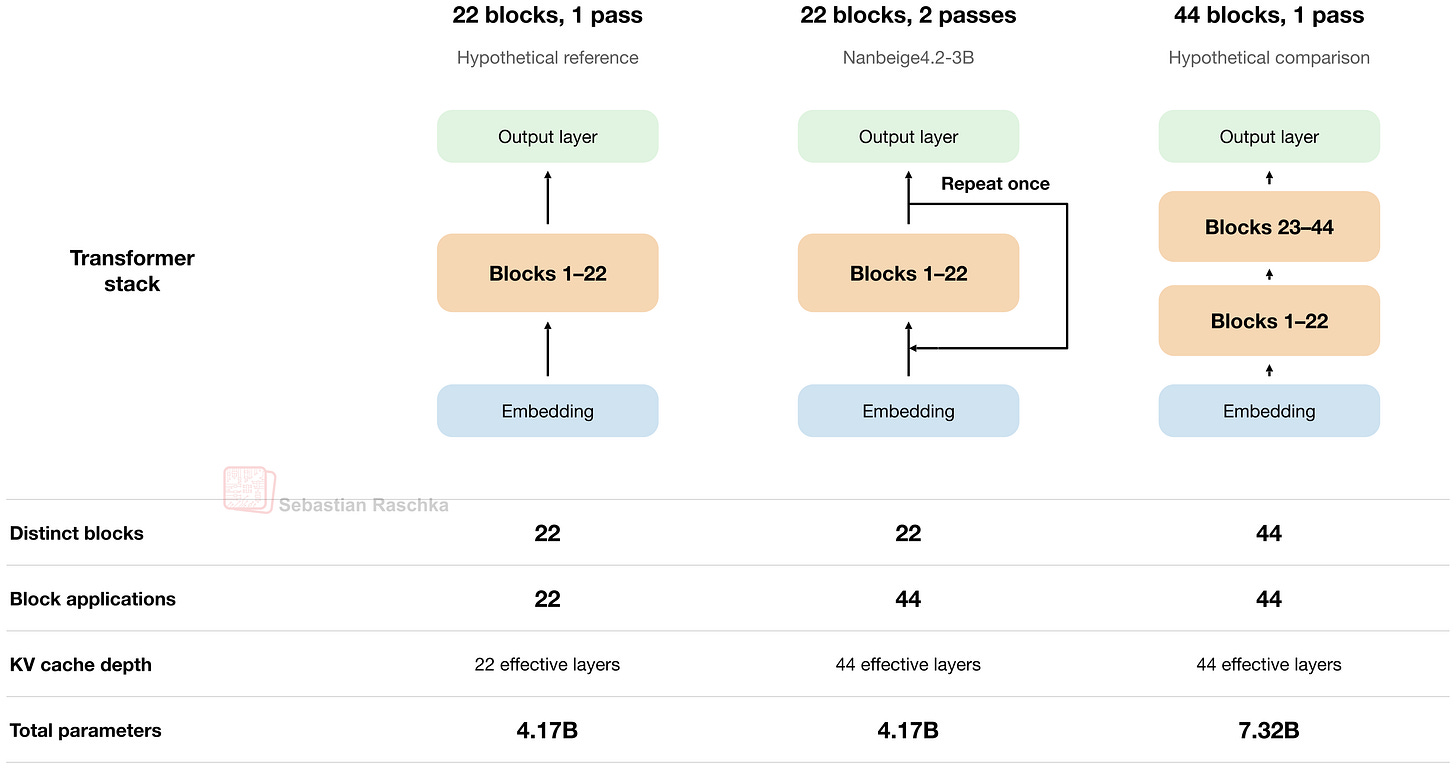
但注意,循环并不会减少计算量:前向仍要跑 44 次 block application,训练时梯度也要穿过两个重复的 stack,费用和跑 44 个独立 block 差不多。KV cache 同样不会减少,因为第二遍进入 block 时中间状态已经变了,生成的 key 和 value 自然不同,必须为两遍分别维护 cache。所以循环只省权重存储,不省推理时的 KV cache。Nanbeige 实验过在两遍之间共享 KV cache,确实把 cache 减半,但模型表现下降,因此最后发布的是不共享版本。Nanbeige 论文还提到两个取舍:循环架构从零训练优于把预训练模型做 upcycling;两轮是最佳取舍,更多轮只带来很小的增益,但训练更慢、优化也更不稳定。
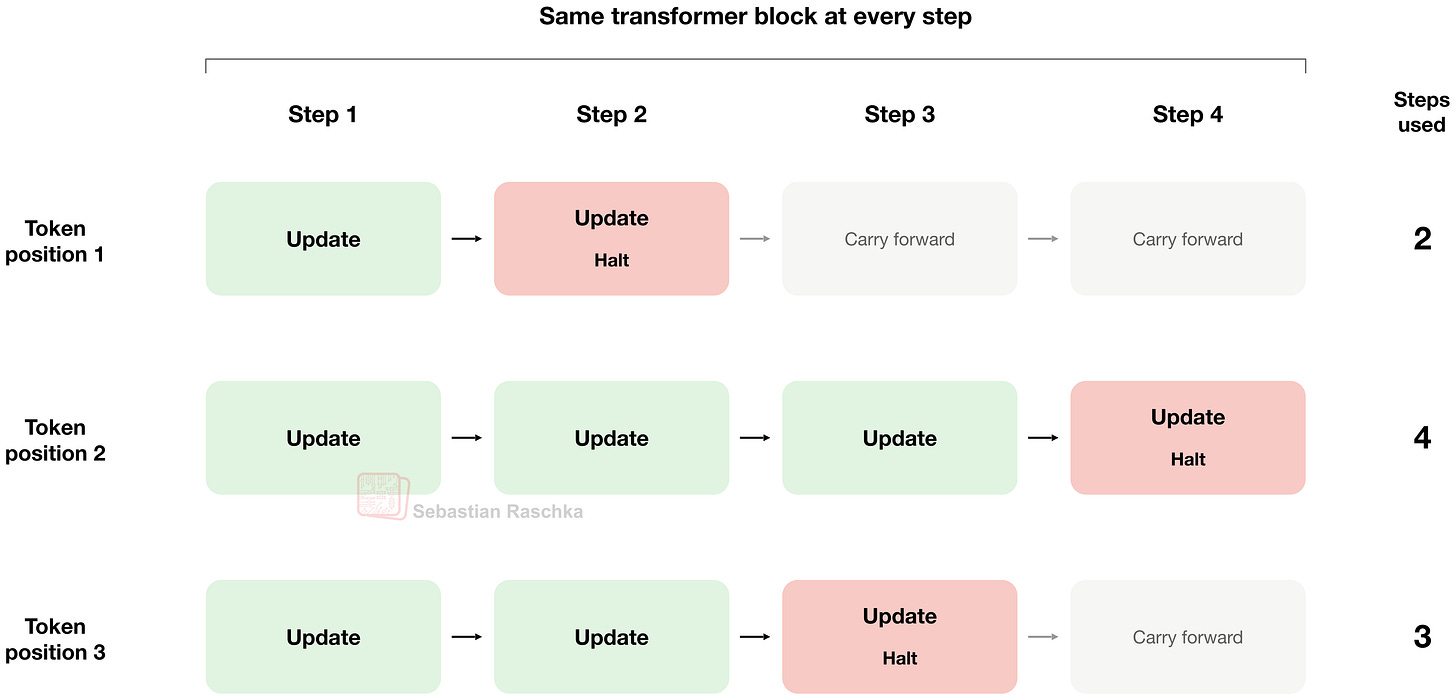
Universal Transformer 则更极端:它重复应用同一个 transformer block,而不是一个 block stack。步数可以固定,也可以使用 adaptive halting:某个位置的 token 可能只过一两次,另一个 token 则过三四次,让模型把额外计算分给真正受益的 token。循环次数由一个小的训练函数决定:模型对每个位置、每一步输出一个 halting probability,累积概率超过阈值就停止,同时还有最大循环次数作为兜底。
字节跳动的 Ouro 是更极端的例子:Ouro-Thinking 2.6B 把同一组 48 个 block 应用四次,等于 192 次 block application,但只保存 48 套权重;再用一个可学习的 exit gate 决定从哪一轮输出,思路接近 adaptive halting。不过实际发布的 Hugging Face 实现会先算完所有配置的轮次再选输出,所以循环数在实现上基本固定为 4。
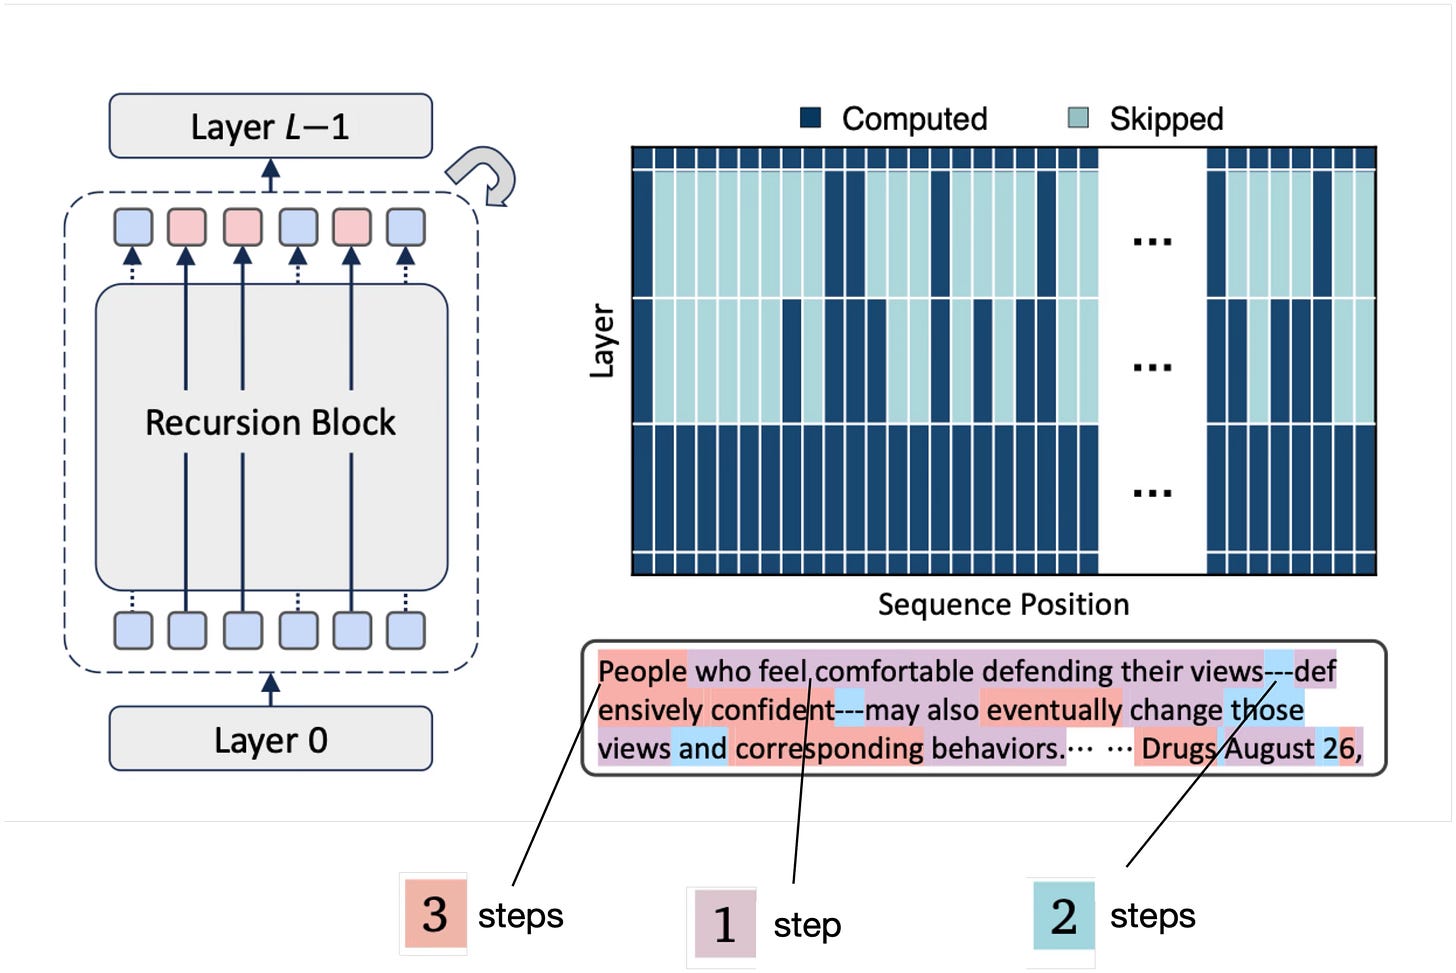
另一个变体是 Mixture-of-Recursions。它很像升级版 Universal Transformer:单独的 token 可以一次或多次经过同一组 block,创新点在于通过一个小型 router 按 token 决定循环次数。router 查看的是带上下文的 token 表示,所以同一个词并不会总走相同轮数,比如之前出现过“People”这个词,它不一定每次都要循环三次。论文探索了两种路由方式:expert-choice routing 让每个循环步选择哪些 token 继续处理,token-choice routing 则在一开始就给每个 token 分配 1、2 或 3 次路径。无论哪种,不同轮次都共享 transformer 权重。
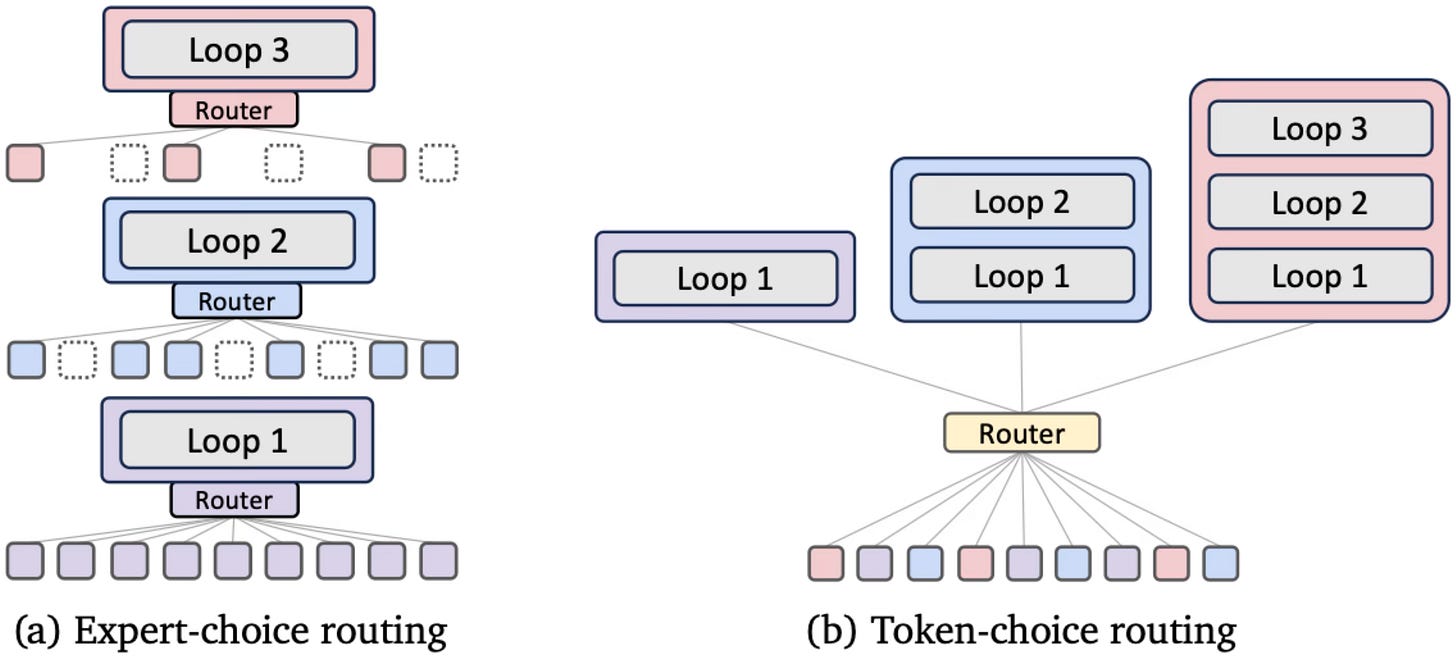
论文实验显示,在最小模型规模上,普通 transformer 最好;模型变大后,Mixture-of-Recursions 往往能追上甚至更好,尤其是在较小训练预算下。等训练预算很大时,几条曲线又很接近。所以优势取决于模型规模和训练算力。另一个细节是,相同训练算力不等于相同 token 数,MoR 因为跳过部分计算,在同样预算里能处理更多 token。
这个结果也提醒我们,looped transformer 在固定算力预算下是否能带来更好的模型,取决于规模;只看很小的 135M 模型会得出相反的结论。
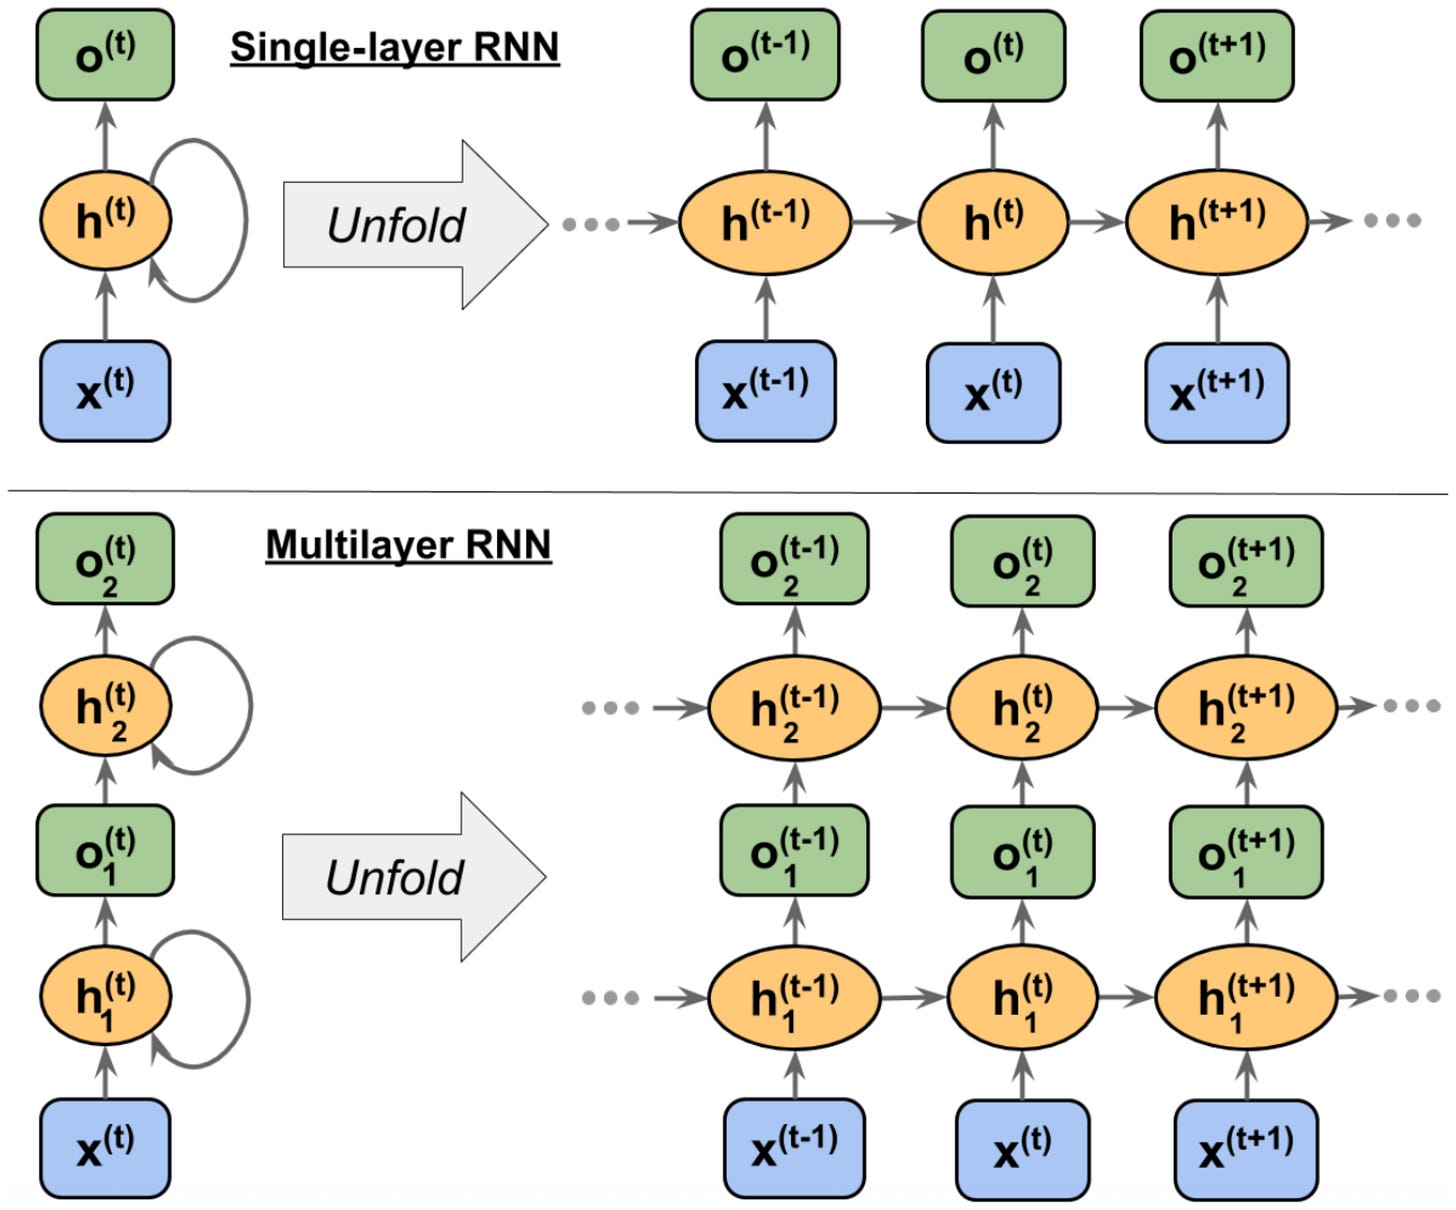
循环深度这个想法其实并不陌生。RNN 本来就是在不同时间步重复使用同一层权重,这几乎是“recurrent depth”的原始版本。区别在于,RNN 的循环发生在时间轴上:处理序列时逐 token 推进,把前一步的 hidden state 带到下一步;而 looped transformer 的循环发生在一个 token 自己的表示上,即让这个 token 在深度方向多次经过同一组 transformer block,同时仍通过注意力在 token 间交换信息。更简单的理解是:looped transformer 相当于复用 transformer block,像把模型加大但共享权重。
那么 GPT-6 Astra 真的用了 looped transformer 吗?目前这还是未经官方证实的传闻。如果模型开放权重,我们可以自己确认;现在只能依据报道推断。不过我认为它很可能用了:一是已有上述报道;二是这项技术在过去研究中有潜力;三是 OpenAI 首席科学家说过,包括 Astra 在内的前沿模型,其计算图深度在 GPT-4 的两倍以内。但这不能直接证明就是 looped transformer,也可能只是普通层数翻倍。Astra 的成功更可能来自更好的训练配方和数据;looped transformer 可能有帮助,但 The Information 或许高估了它的作用。
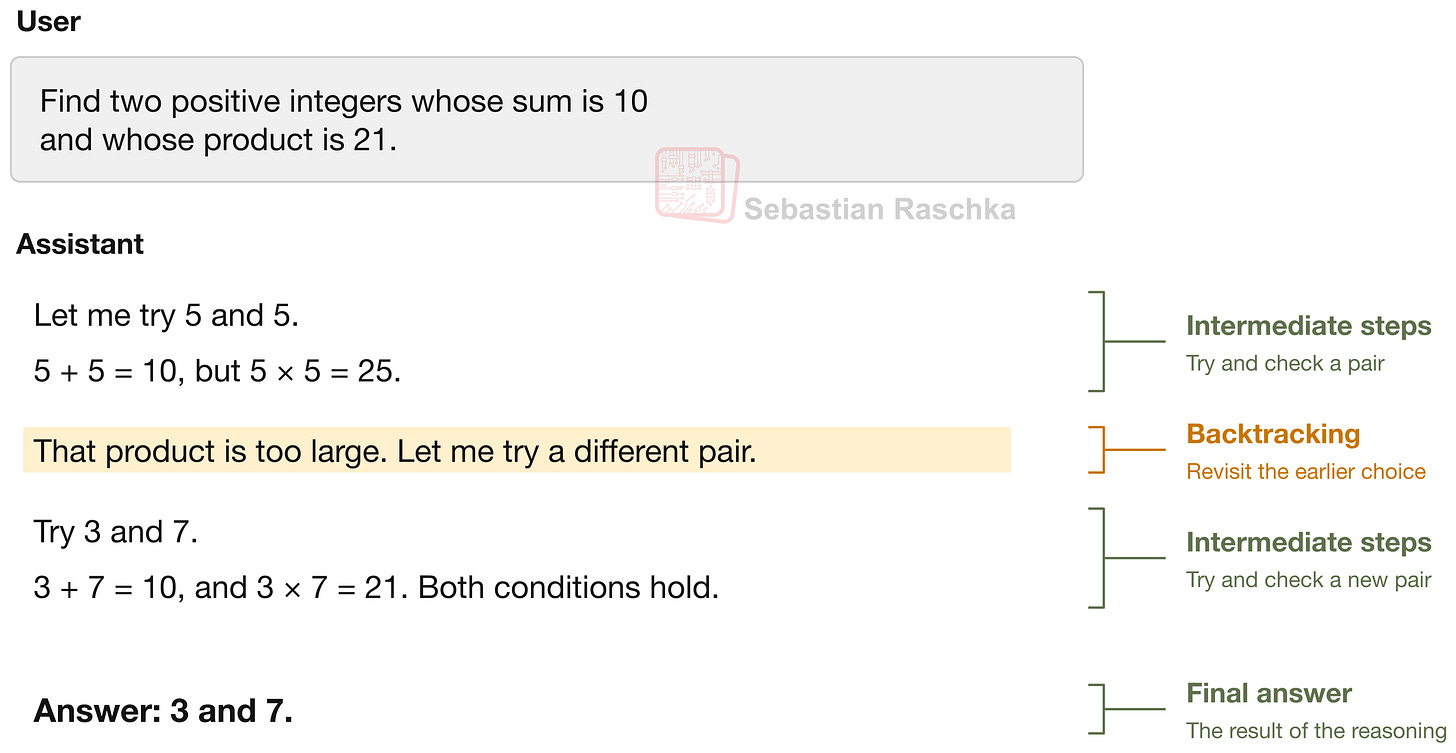
接下来看隐藏推理轨迹的担忧。OpenAI 从 o1 开始就向用户隐藏了大部分推理轨迹,所以对终端用户来说差别不大;这个讨论主要影响开发者。我不认为 looped transformer 是隐藏思维链的重要原因。推理模型通常会先产生中间步骤,再给出最终答案。举例说,如果问“两个数之和为 10、积为 21 是多少”,模型会先试 5 和 5:和对了,积却是 25;接着再试 3 和 7,同时检查两个条件。中间还会出现回溯,即发现错误后回到较早的选择,换一个方向继续。模型仍然是一个 token 一个 token 地生成,这些中间步骤就像草稿纸,在最终答案之前提供额外计算;最终答案本身常常比推理轨迹短得多。
推理轨迹里的额外 token 会增加计算,looped transformer 也在内部增加计算。一种说法是,模型如果内部已经做了更多计算,就不再需要那么多外部思考 token。从基准看,GPT-6 Astra 在不同 effort 水平下的总 token 数并不一定比 GPT-5.6 Sol 少;但在固定准确率下,Astra 确实用了更少 token。这是否影响可解释性?不一定。更少 token 可能只是说明模型更少犯错、更少回溯,第一次就能做对。之前的模型也一样:GPT-5.6 Sol 比 Luna 用了很多 token,却不代表 Sol 更不可解释。Luna 在相近性能下大约多用 80% 的 token。更合理的解释是,更强、更大、训练更好的模型能更高效地解题,这里的“高效”就是 token 更少。另外要记得,推理轨迹本身并不保证忠实反映模型内部实际发生了什么。真正值得担心的,可能是 looped transformer 是否会更频繁地生成“伪造”推理轨迹来误导用户;目前没有强证据支持这一点。Astra 的 system card 确实提到推理轨迹的可监测性比 Sol 有回落,主要和更短、信息更少的轨迹有关,但这不能证明是 looping 造成的。
我分享上述看法几个小时后,OpenAI 首席科学家 Jakub Pachocki 发了一段澄清:
“我想阻止因混乱报道而出现竞相进入不可监测状态的情况。包括 Astra 在内的当前前沿模型,其计算图深度在 GPT-4 的两倍以内。OpenAI 从最早的推理模型起,就一直努力保留并利用思维链监控。我们非常重视这项技术,因为它能让我们看到模型对齐如何从训练分布中泛化。我确实认为它很脆弱,并且不幸地在朝负面方向发展;但原因与架构变化无关,我很快会写。不过我们仍可以加强它,这也是当前研究计划的核心目标。”
这里的“混乱报道”应当是指 The Information 的说法,暗示循环架构本身与思维链变化没有直接关系。
与 looped transformer 相关的论文里,最近有几篇值得注意。
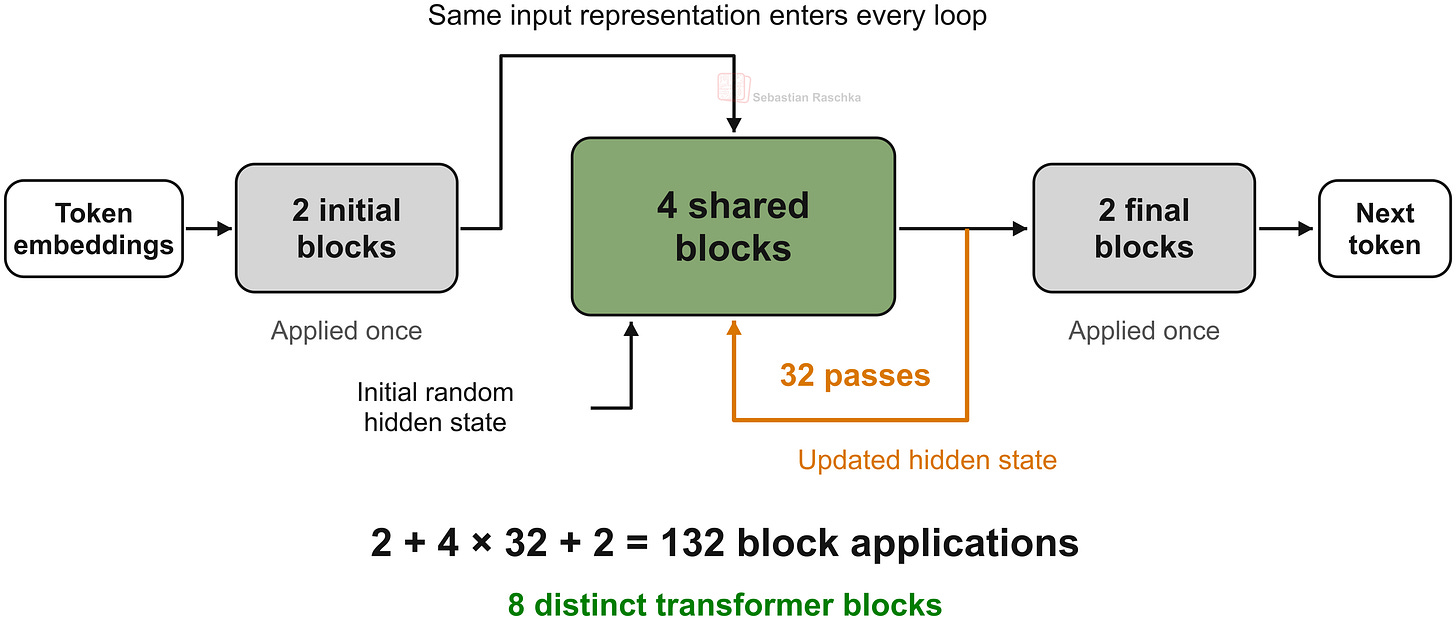
《Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach》训练了一个 3.5B 参数、800B token 的模型。它不像 Universal Transformer 那样重复单个 block,而是像 Nanbeige 那样重复一个 block stack,不过这个共享的 4-block stack 被夹在两个初始 block 和两个最终 block 之间。与 Nanbeige 的另一个区别是:每轮循环,共享 stack 除了接收上一轮的 hidden state,还会再次接收初始 block 的输出;两者拼接后经过一个线性投影,再进入共享 block。这样每次循环都能看到同一份初始输入。训练时循环次数随机采样,使模型适应推理时不同的计算量;推理时可以选择固定预算,比如 8、32 或 64 轮,也可以按每个 token 的下一 token 概率分布做自适应停止:若连续两轮输出分布的 KL 散度低于阈值,说明结果已经很接近,就停止循环。效果因任务而异:HellaSwag 大约 8 轮后就基本饱和,GSM8K 和 HumanEval 则还需要更多轮。虽然论文题目叫“latent reasoning”,模型仍然可以生成文本思维链;循环只是给每个输出 token 之前增加了额外计算。
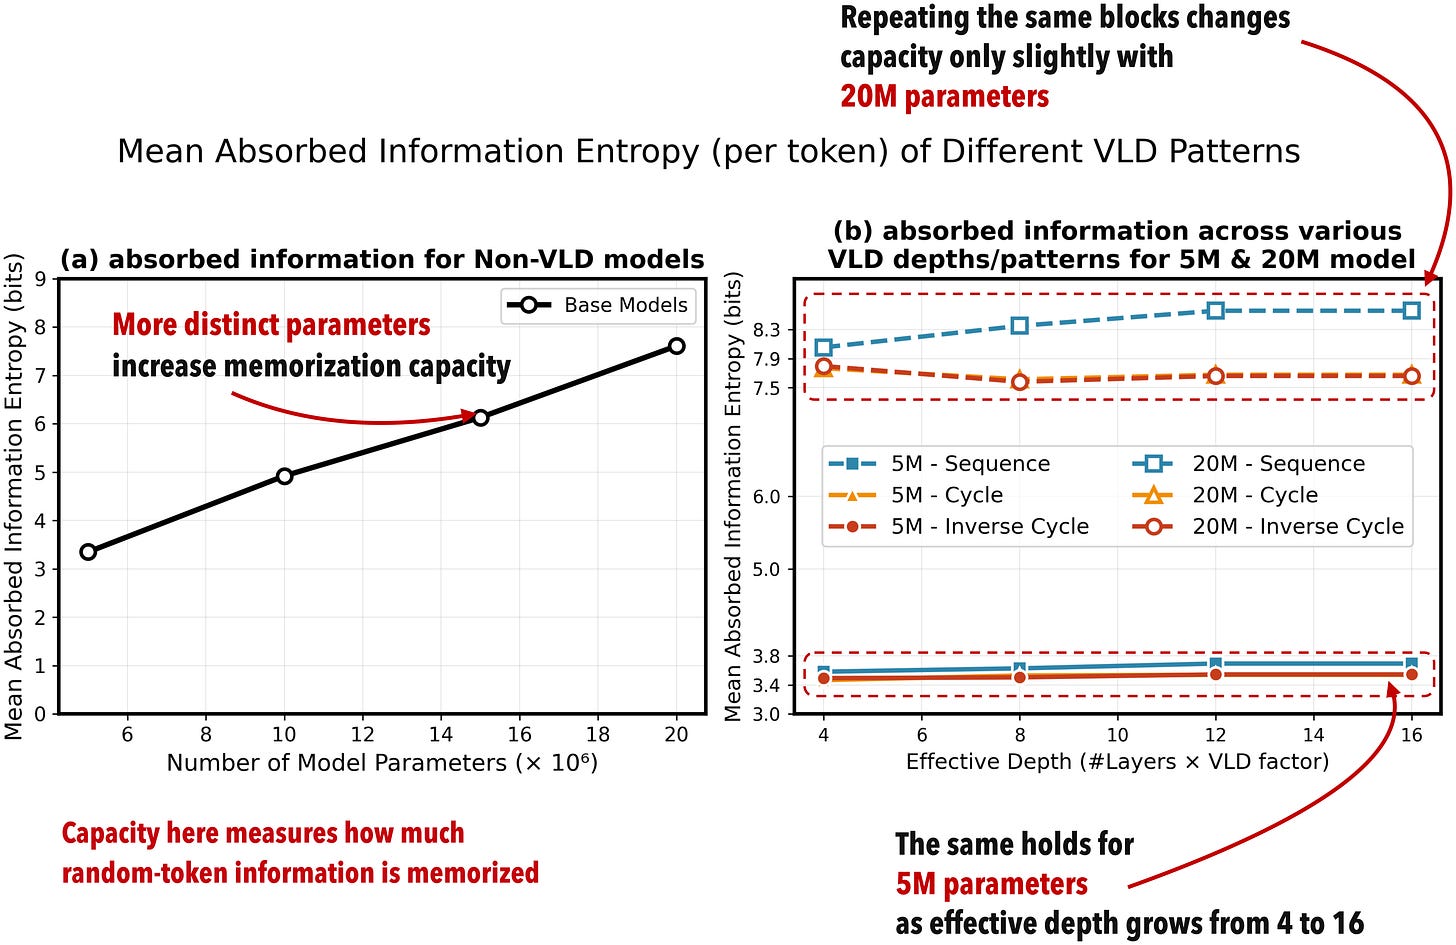
《Beyond Parameters: Exploring Virtual Logic Depth for Scaling Laws》则把“存储信息”和“使用信息解题”分开测量。在记忆实验中,固定参数数量时,循环次数几乎不改变模型能存储的信息量;增加不同参数数量才会提高存储容量。所以 looping 更像是计算机制,而不是存储机制。在单独的推理实验中,复用 block 确实能在不增加参数的情况下提高多步数学题的表现。这说明额外计算本身能帮助解题;当然,普通大模型也能改善推理,只是它同时增加了参数。
新出的 SMELT 则回答了一个更具体的成本问题:在每 token 计算量、非 embedding 参数数量和 KV cache 都大致可比的情况下,looped transformer 是否还值得?研究者采用 MoE 架构,把中间一半 block 应用两次,同时缩小 hidden dimension 以补偿额外计算,再用增加 expert 来补回参数数;调整注意力头配置以保持 KV cache 近似。实验一路扩到 54B 非 embedding 参数。根据拟合的 scaling curve,在研究的计算量范围内,SMELT 达到相同 validation loss 大约可节省 6.8% 到 18% 的训练算力。因此答案大致是肯定的:同样的计算预算下,循环能带来略好的模型。
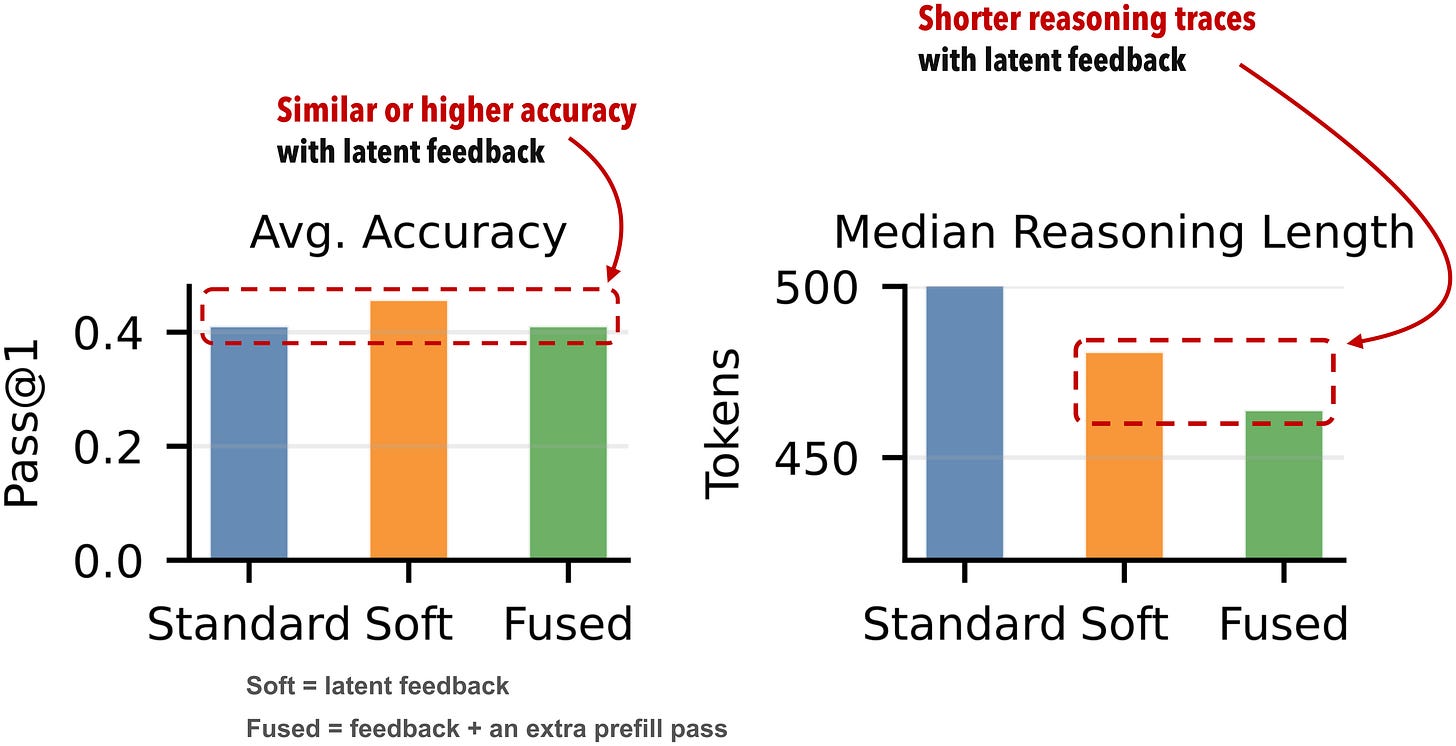
最后一篇是《Full-bandwidth transformer》,研究的是跨 token 位置的循环。它在每个解码步把上一个 token 的最终 hidden state 与新采样 token 的 embedding 通过一个可学习 gate 合并,再作为下一轮 forward 的输入。也就是说,下一个 token 的计算可以在 stack 底部看到前一个 token 的最终表示,这一点有点像 latent reasoning。在 1B 基础模型上,这种 latent feedback 让模型在 MATH500 上输出更短的推理轨迹,同时保持或提高准确率;但指令微调后,缩短效果消失了。作者没有进一步测试“用普通方式加更多 transformer block”是否也会产生同样的缩短效应,因此还不能把更短的轨迹直接归因于循环结构本身。
回到最开头的问题:Astra 确实是一款很强的模型,尤其 computer use 方面进步很大。我认为这会成为接下来几个月开源和专有 harness 共同的重点。开源在 computer use 上尤其重要,“能力越大责任越大”,在给 harness 访问主电脑之前,最好先能审计它的行为。此外,Astra 很可能用了某种 looped transformer 变体;这能让模型在同一计算预算下获得更好的性能。更好的性能确实可能表现为更短的推理链,但这并不是新趋势。更强的模型犯错更少、回溯更少,也可以在架构内部利用更多计算,而不必把思维链当草稿纸。人类的数学考试也是这样:准备充分的好学生通常很少需要草稿纸,也较少返工。
评论
社区对 GPT-6 Astra 的“循环深度”架构是否导致隐藏推理与监控难题存在明显分歧,同时对其实际产品风格变化褒贬不一。
认为循环深度只是复用权重的常规堆叠,内部仍可监控
- 指出所谓神秘技巧实为多层变压器权重复用以省显存,仍逐 token 生成,与常规架构无本质差异;用户看不到轨迹是出于防蒸馏顾虑而非架构不可监控(认可度:少数人)。 > 循环深度不过是用同一套权重叠更多层省显卡,思维链监控对 OpenAI 内部依然可行(@libraryofbabel)
认为循环深度实质隐藏推理且大幅降低可监控性
- 第三方基准表明同等能力下该架构让模型更少依赖显式思维链,若推理轨迹被喂回模型而不输出则按定义隐藏;近期评测显示多跳无思维链推理能力跃升(认可度:较多人)。 > 近期第三方基准显示同等能力下循环深度本就预测了更低的思维链可监控性(@cubefox)
认为 Astra 体验不稳定且偏离 OpenAI 原有商务稳重路线
- 用户反馈模型语气古怪令人不信任,代理行为中过度自主访问文件,且发布后突然变更弱;原本 OpenAI 卖点是无聊可靠,如今却像激进的竞品(认可度:较多人)。 > OpenAI 一向是商务无聊路线,如今变得像 Claude 般激进是走错方向(@iJohnDoe)
认为 Astra 是涡轮增效的小模型而非重量级单次模型
- 类比称其用循环将推理存为 KV 缓存重跑而不生成文本,效率更高且因免语言转换丢维度可能更聪明(认可度:少数人)。 > 这好比涡轮增压四缸机而非大 V8,推理不发声而是存起来重跑(@tsunamifury)
有价值的补充
- 自 o1 时代起实验室因担忧模型被蒸馏已不再向用户开放未总结的推理轨迹。
- 将 KV 缓存转化为自然语言会丢失部分维度(尤其空间维度),纯向量循环或能保留更多信息。
- 有读者推荐关注真正理解论文的研究者所做的无废话架构分析与基准。