量子计算是利用量子力学处理信息的新兴技术,或可模拟复杂材料与分子。量子处理器用量子比特,实验准备常耗数月及数百至数千次测量,人工智能有望协助。麻省理工学院(MIT)工程量子系统组(EQuS)研究生比阿特丽斯·扬克列维奇(Beatriz Yankelevich)使用结合Codex的GPT-5.6 Sol探索简化工作流。该组研究超导量子比特,于稀释制冷机内冷至近绝对零度,以微波控制制成芯片。
正文
量子计算是利用量子力学独特性质处理信息的新兴技术,未来或可更好地模拟复杂材料和分子。量子处理器使用量子比特,准备和运行实验常耗时数月、需成百上千次预备测量,这类工作正适合 AI 协助。
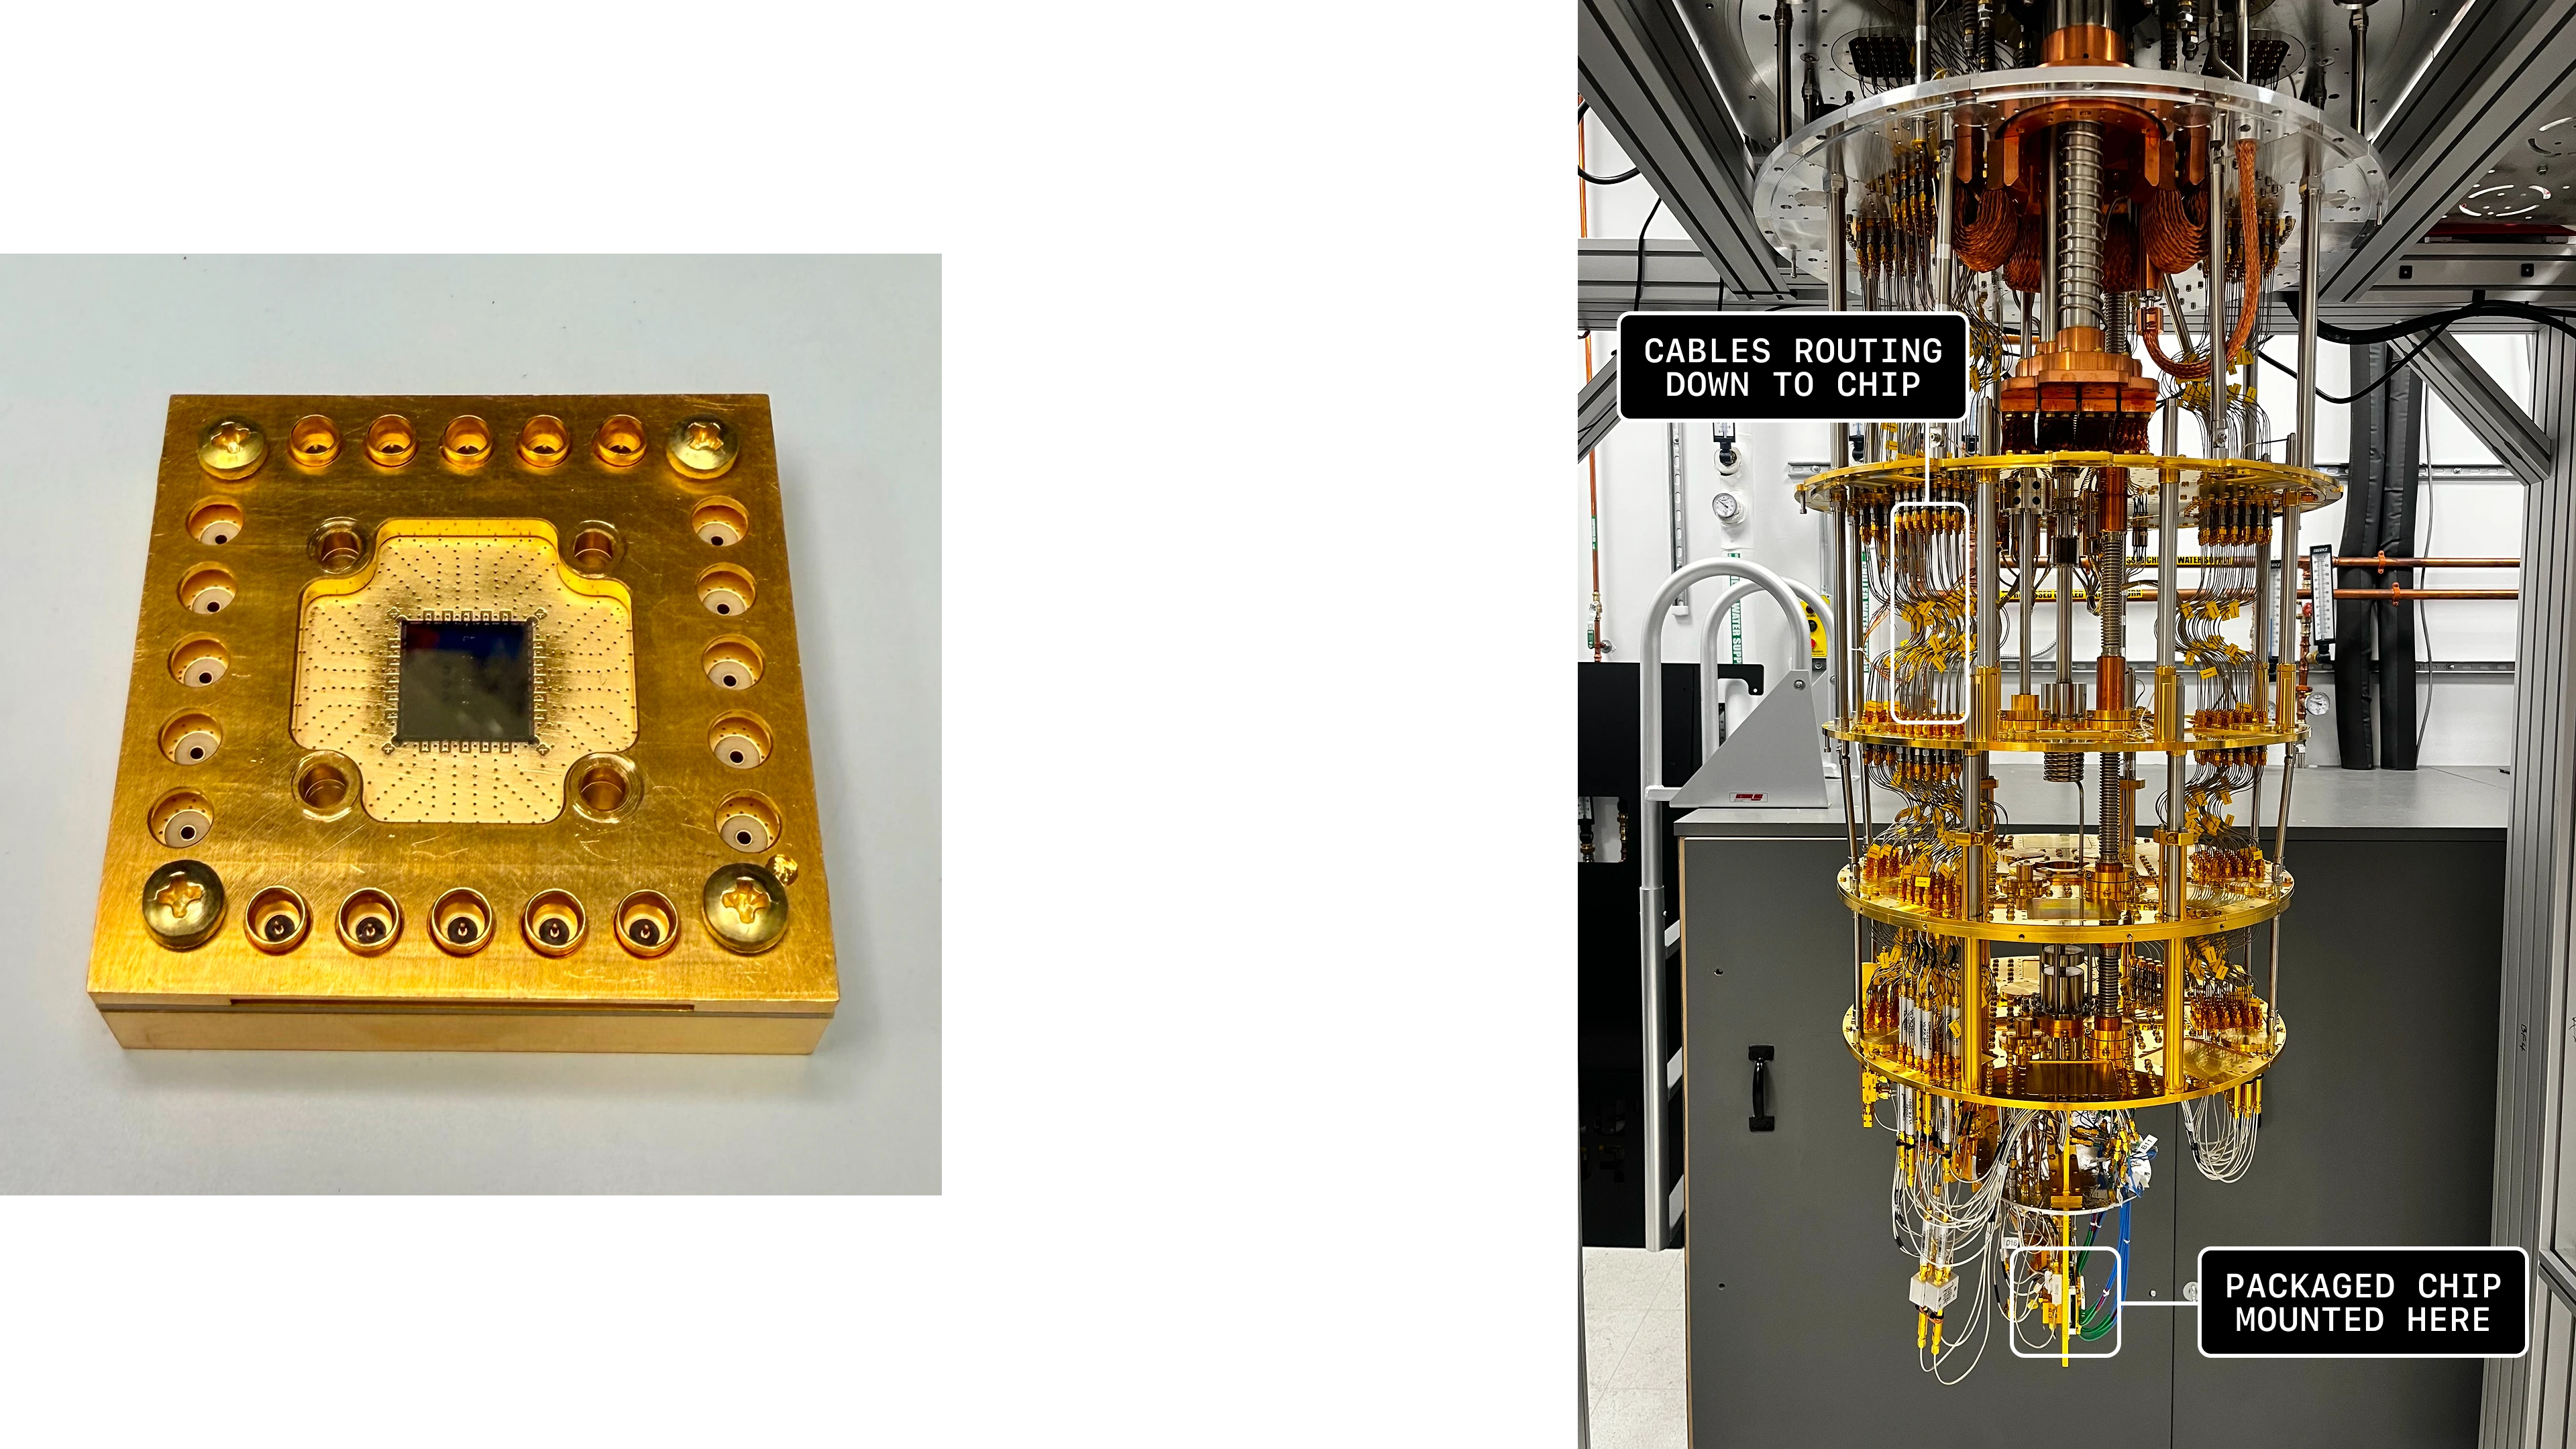
MIT 工程量子系统组(EQuS)研究生 Beatriz Yankelevich 使用接入 Codex 的 GPT‑5.6 Sol,探索 AI 能否简化她的实验流程。该组研究超导量子比特,将其冷却至接近绝对零度的稀释制冷机内;这些比特运算快、用微波信号精确控制,可用常规工艺制造并排布在芯片上。
芯片制造、封装、冷却后,研究者完全通过软件交互,让实验成为 AI agent 的自然试验场。Codex 接入协调实验的软件后,能运行测量、分析结果并决定下一步。她发现 GPT‑5.6 Sol 常能自主完成常规测量流程,省下大量时间且无需持续监督,让她更多投入分析、设计和规划。
协调相互依赖的测量
超导量子比特常称人工原子,只能占据特定能级,微波脉冲使其移动并探测量子态。研究者设计校准脉冲序列,数字化分析返回信号,从而揭示共振频率、量子信息保留时长和执行计算所需设置。
校准需要一系列相互依赖的测量,每结果影响下一步;特性偶尔漂移、意外物理行为致结果不稳,经验者能识别调整。这种软件控制、重复测量与自适应决策的结合,使校准成为 AI agent 的绝佳用例。
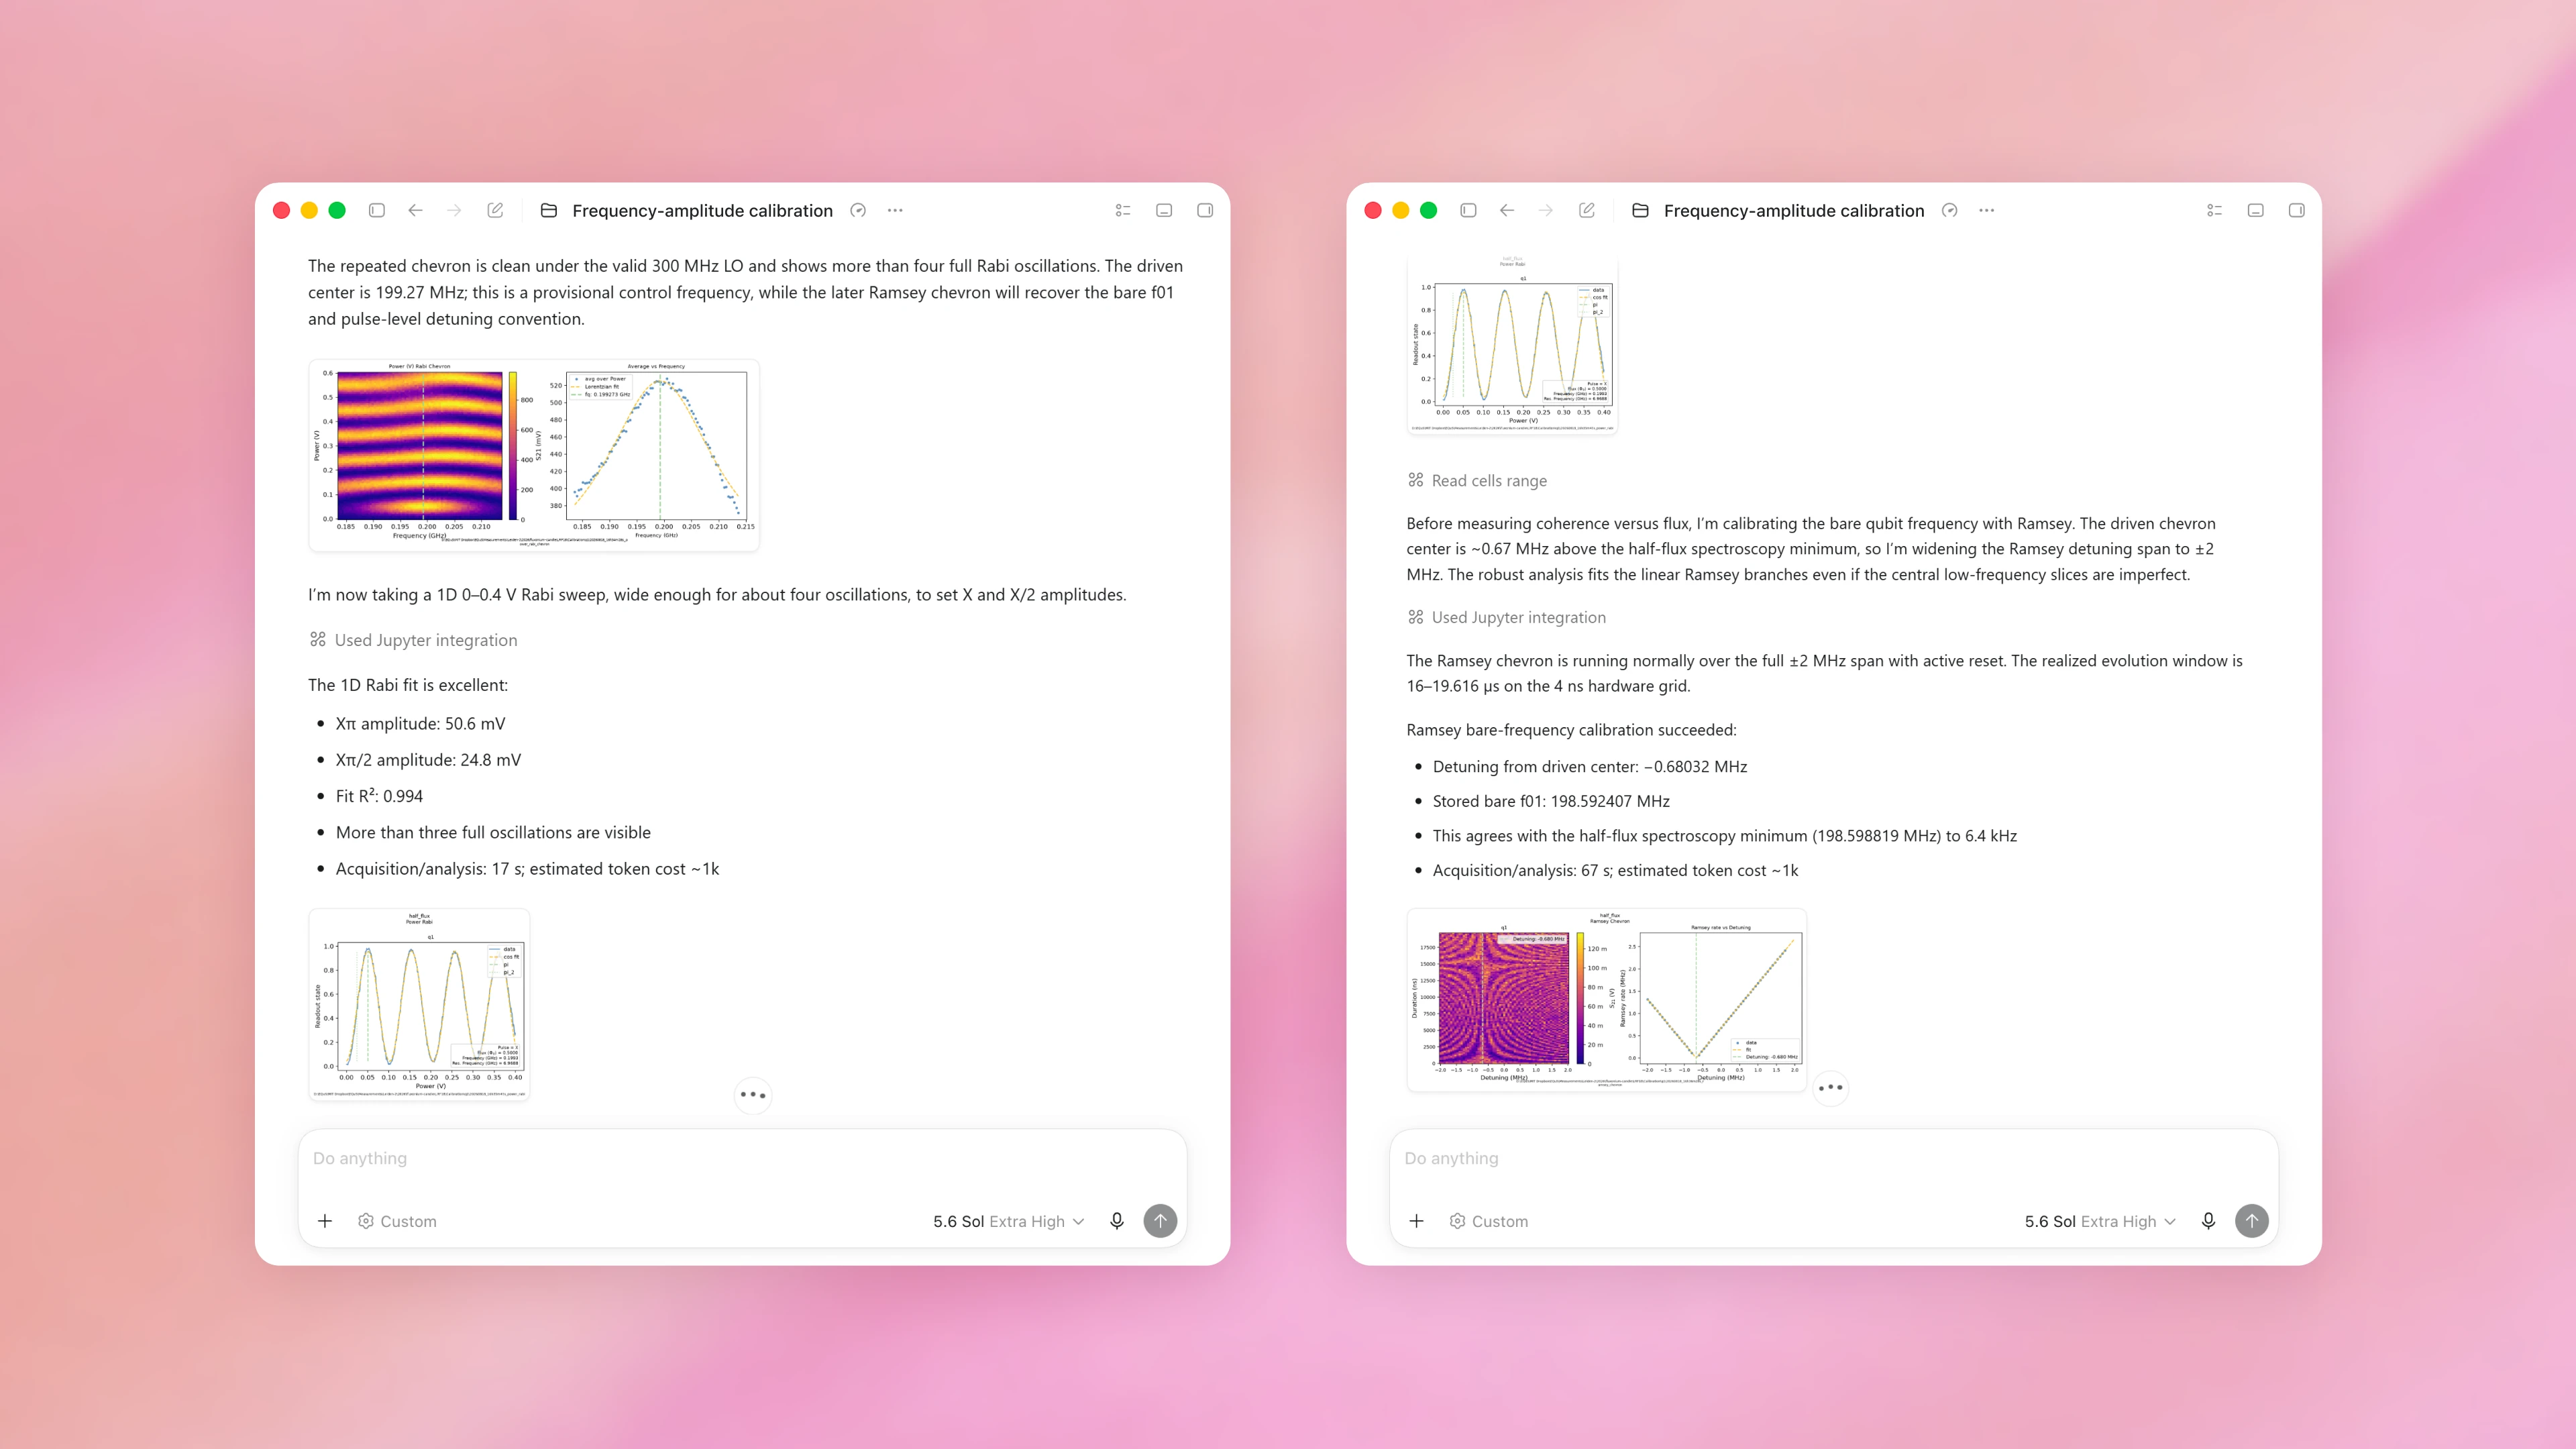
Yankelevich 测试 GPT‑5.6 Sol 在未校准六比特芯片(EQuS 基准测试标准型)上运行测量。她为 Codex 提供特定测量技能说明,模型借其与芯片设计目标选择参数、操作硬件、分析数据,再优化或保存结果供下一步。
信号清晰时,Codex 几乎无需干预完成标准序列,识别跃迁频率、校准控制读取脉冲、确定保留时长。信号弱或嘈杂时则更难,花更久找参数,有时需经验者指导。这表明当前 agent 能处理明确定义的流程,但解读模糊物理结果仍是挑战。
EQuS 制造许多标准芯片,每个需研究者数天表征,现定期用 agent 处理常规测量以解放人力。
“我可让 agent 在夜间或我在洁净间时跑测量数小时,”Yankelevich 说,“用手机查看进展,若需修复或想探索别的方向就调整。”
与研究者协作
直接优势是 Codex agent 能在无持续监督下帮研究者稳步推进实验分析与测量。经验研究者或仍比当前 AI 更快找到最佳校准设置,但省下监控每一步的时间可专注其他工作。
常规芯片表征流程相对明确;对新实验,Yankelevich 给 agent 较窄目标,更重其编写、修改、测试新代码(控制、分析、仿真)的能力。直连实验室让该组修订代码、用真实测量测试、自主完成更长工作。
“我建了基础设施引导 agent 处理测量、理论和芯片设计,现在开始见效,”她说,“可让多个 agent 同时解不同问题,我大部分时间做高层工作——解读结果、设计实验、规划下一步、阅读写作。”
评论
对 OpenAI 最近连续抛出的科学“突破”,HN 评论区的主调是怀疑而非庆贺:多数人把新闻读成营销叙事和资本动作,少数人则认为就算包装可疑,“囤算力、买专利、卡模型”的商业逻辑也未必不成立。还有一个附加分歧:AI 到底是“把人类从杂务中解放出来”,还是“又蠢又强地加速把人碾过去”。
连续发布更像是 IPO 预热,而不是科研节奏
- 有人直接问:这是不是又一个 OpenAI 为 IPO 热身而“偷来”的发现?(@mentalgear)
- 另有人把这则消息称作“又一个光荣的随机数生成器实验”,暗示结论可能只是噪声碰运气,并不会重复。(@de6u99er)
- 有评论者把 2024 年底到 2025 年初量子概念股疯涨之后只剩“公关垃圾”的过程拎出来,认为 OpenAI 也在同一套资本叙事里。(@fHr)
- 还有人从发布节奏上起疑:公司一般会错开重磅消息,OpenAI 却接连放出所谓发现;是不是上一个 Navier-Stokes 相关帖子惹了争议,现在急着转移方向?(@Retro_Dev)
- 认可度:较多人
就算不是假的,也只是“老工具加 AI”,没有量子魔法
- 有做过量子芯片控制的人说,2011 年他就能用 Python 全自动完成量子比特的启动和校准,包括全谱测量、寿命表征、Rabi/Ramsey、单比特与两比特门标定、量子过程层析等。校准本质上是曲线拟合和数据记录,并不需要“AI”。
- 他也同意,Codex 这类工具当年如果有,会省下大量例行编程时间;但这只是通用自动化,不是量子计算特有的东西。真正的瓶颈在芯片本身,AI 变不出把量子比特寿命提高 10 倍的魔法。
- 这条技术反驳被普遍视为把文章拉回现实:
标题里蹭上“量子”确实让事情显得更酷,但本质上它只是可以落到任何地方的自动化,没有任何量子计算专属的东西。(@throwaway63467)
- 认可度:较多人
所谓“量子分解纪录”,大概用算盘和狗也能复现
- 有人贴出一篇标题极具讽刺性的论文:《用 8 位家用电脑、算盘和一只狗复现量子因数分解纪录》。言下之意:如果这种“纪录”用如此简陋的经典手段都能复现,那它就说明不了量子优势。(@lompad)
- 另一个冷幽默接的是邻居家的狗:“整夜吠出 334543333 比特的 RSA 因数分解,岂不是早就解决了大量 NP 完全问题?”(@LeonardofQ)
- 认可度:较少人,但社区往往用这类荒诞类比消化“科学新闻过度包装”
更该警惕的不是 AI 太聪明,而是它又蠢又强
- 一条醒目的评论把 LLM 比作从山顶滚落的巨石:它不会挑目标,只会沿途随机碰撞,而人类正在山脚下拍手欢呼。
- 原话被反复引用:
问题不在于它超级聪明,而在于它超级蠢、超级强,就像一块正在滚下山的大石头。(@qsera)
- 另一个评论顺着说,别轻信“AI 把我们从某类工作中解放出来”的框架;人们应当正视 AI 可能做任何可想象工作的前景,否则这种说法只会带来虚假安全感。(@bananaflag)
- 认可度:少数人,但构成了评论区严肃担忧的一支
反过来看,这套“烧算力换专利”的打法也可能成立
- 有评论者总结了一个新的商业 meta:先囤足够的算力,再用闲置算力烧出可专利的科学突破,同时训练别人没有的模型;听起来浪费,实际上可能是在制造壁垒。(@petesergeant)
- 也有人说 OpenAI 最近确实“攻势凌厉”,连续拿出突破性发现;即使商业目的大于科学目的,发布节奏本身并不糊涂。(@sidcool)
- 认可度:少数人
HN 评论本身也在被科技公司“地推”化?
- 有用户说,每天都能看到 Anthropic/OpenAI 的帖子,评论区那种“制造共识”的感觉越来越像政治空间里的广告渗透:
这个网站可能正在死掉。(@Iuz)
- 还有人怀疑 OpenAI 先拿“还没被削弱”的模型做演示,等用户第二天再用,Sol、Astra 已经变笨了。这种不信任未必准确,但它说明读者已经把“版本变差”本身当成叙事的一部分。(@varispeed)
- 另有人用链接更新了 quantumvibecoding.org 来呼应,把“量子”和“vibe coding”两个热词缝合成了新的嘲讽意象。(@dr_dshiv)
- 认可度:少数人,但很大程度上解释了评论区为什么先怀疑再庆祝
有价值的补充
- 一个精巧的视觉类比:量子计算机的外观让人恍惚回到 ENIAC——机柜、走线和仪器面板都带着第一代大型电子设备的气息。有人觉得这是工程还非常原始的隐喻,而不是值得欢呼的成熟科技。(@Oarch)
- 如果把 AI 放在量子化学这类具体工具链里看,真正“慢”的地方可能在于 ORCA 这类功能完整但速度吃紧的经典软件,而不是量子硬件本身。这类“让成熟软件跑得更快”的方向,或许比包装成“发现”更能落地。(@the__alchemist)