今天发布水星 2.5(Mercury 2.5),较水星 2(Mercury 2)质量大幅提升,仍具低延迟低成本。自 Mercury 2 发布,数千开发者使用,数十企业投产,用量增超一个数量级,服务搜索语音编码等低延迟负载。这些负载比基准提供更清晰信号,据反馈与故障案例优化评估训练,Mercury 2.5 为此循环首果。
正文
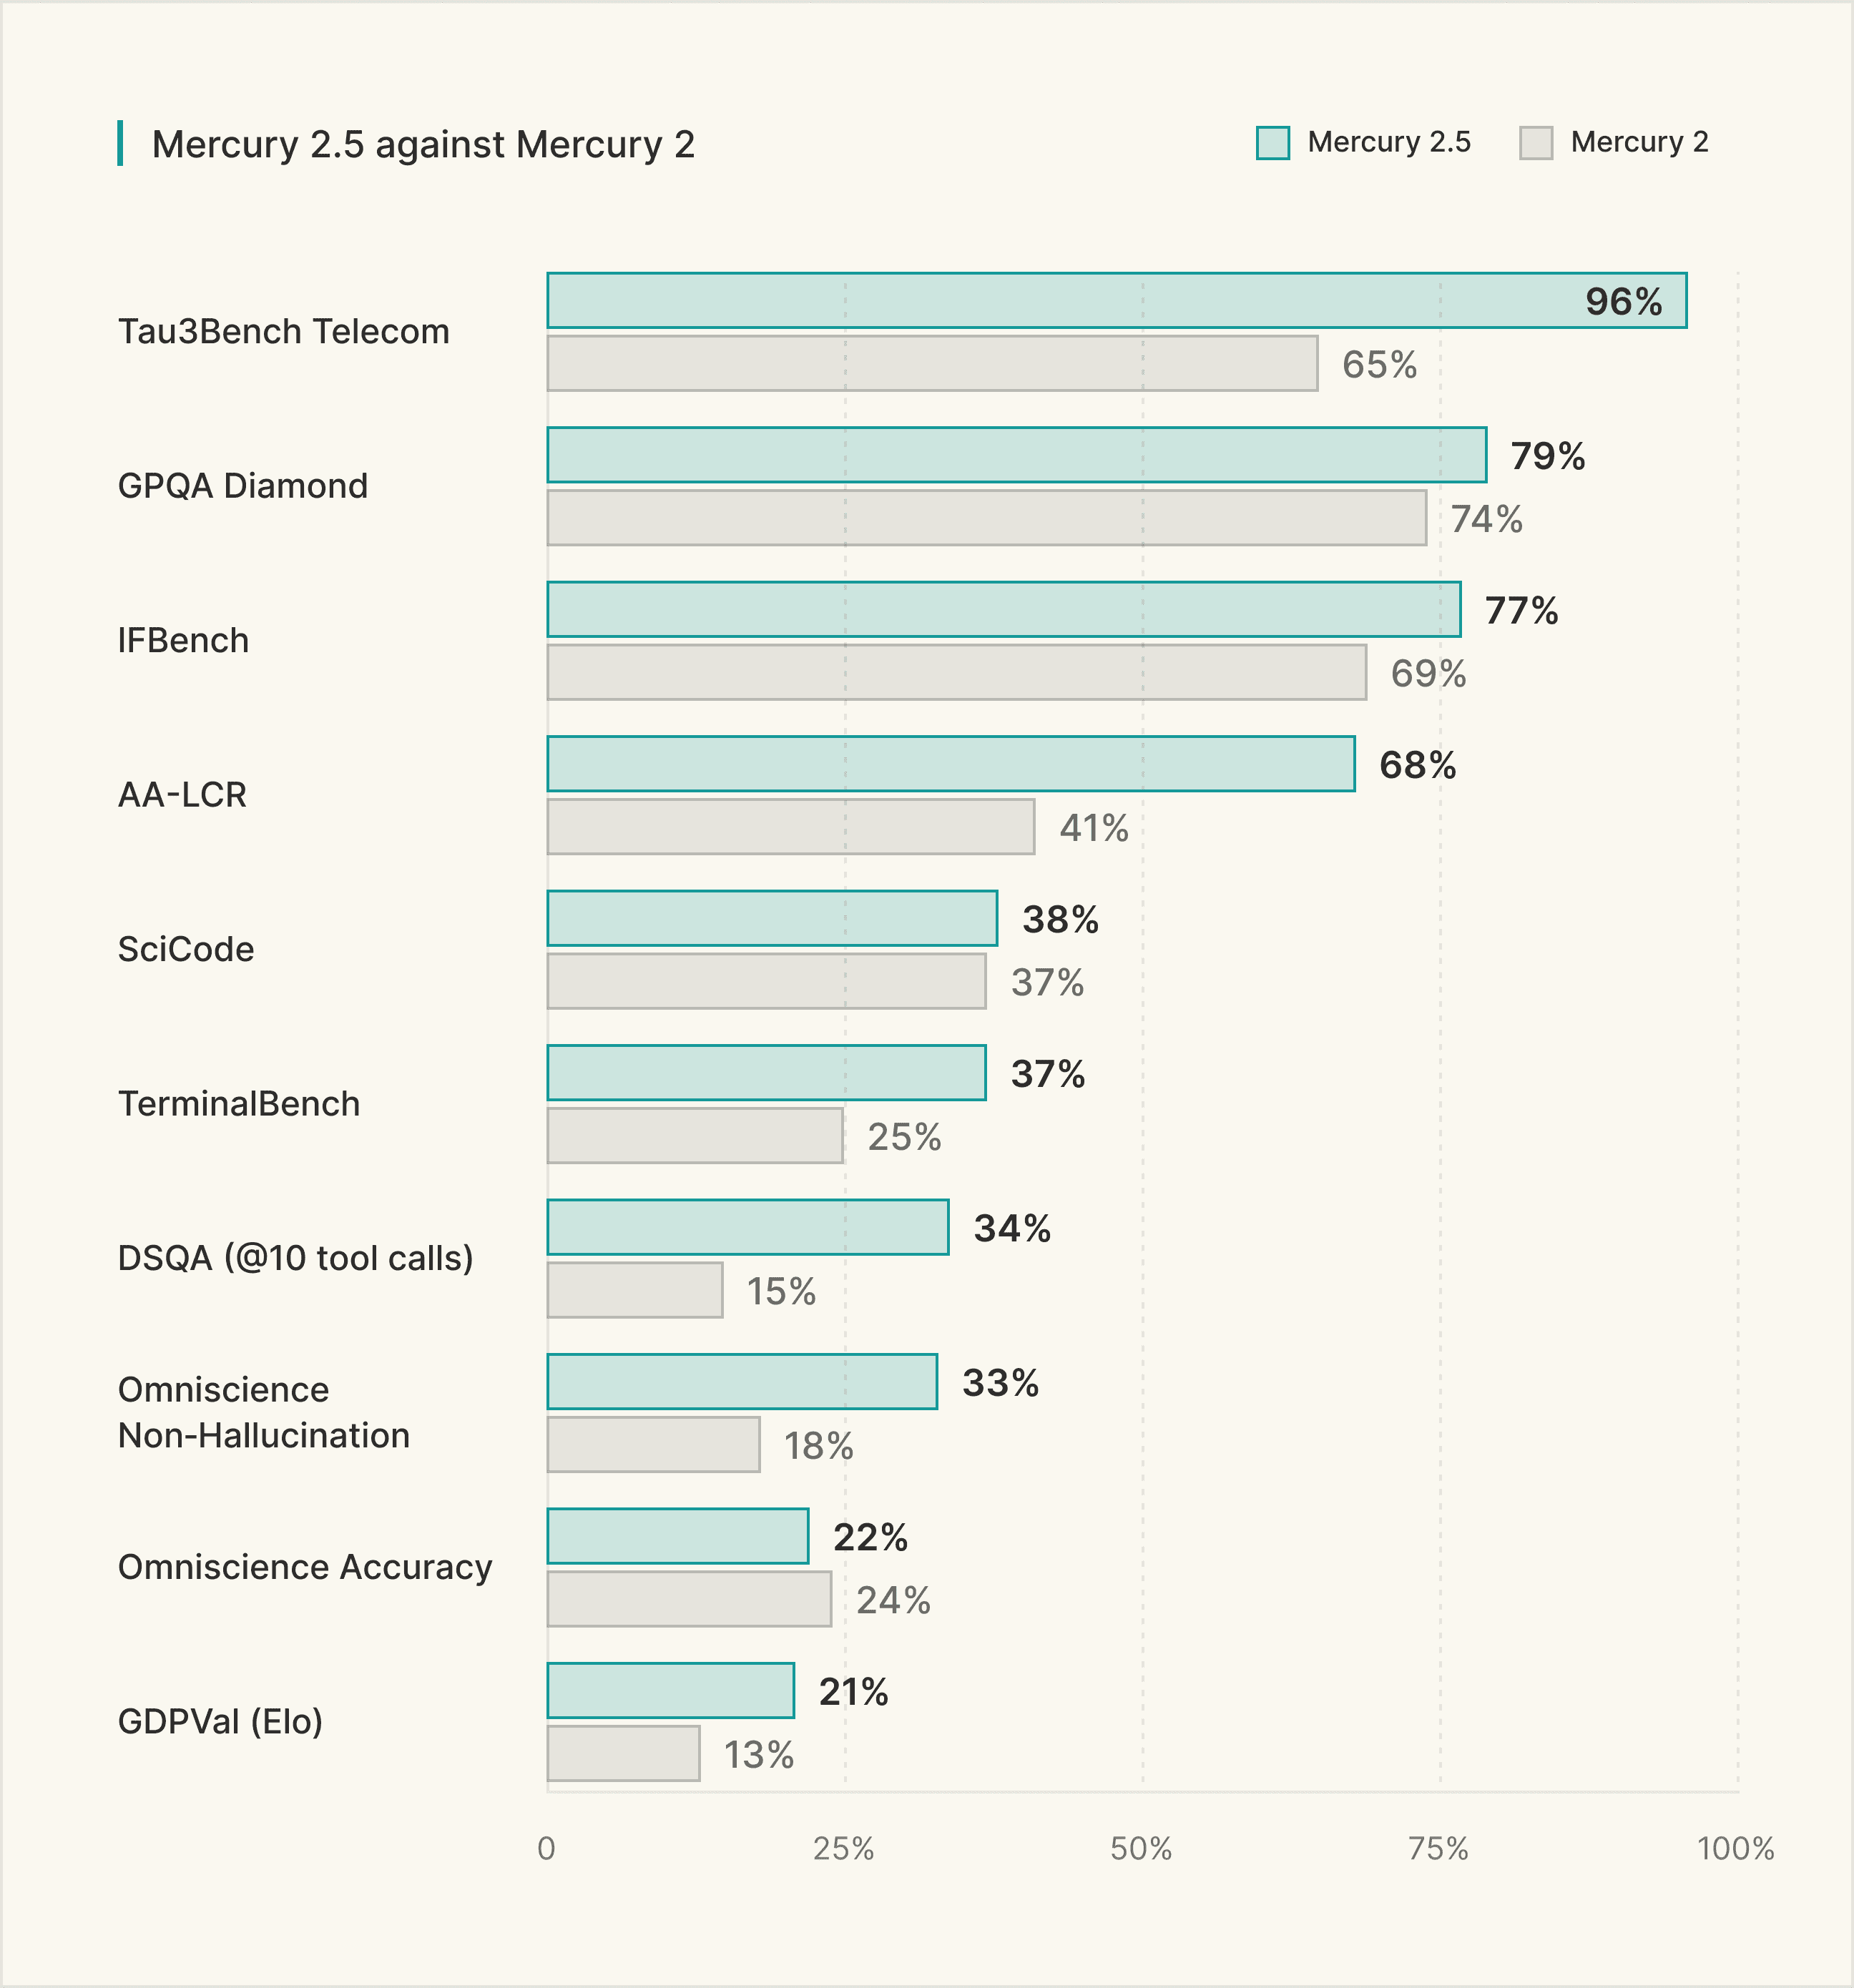
今天我们发布 Mercury 2.5,这是我们迄今能力最强的生产模型。相比 Mercury 2,质量大幅提升,同时保持了低延迟、低成本的推理表现。
自 Mercury 2 发布以来,数千名开发者用它构建应用,数十家企业将其投入生产,使用量增长超过一个数量级。它目前支撑着搜索、语音和编程产品中延迟敏感的工作负载。
这些工作负载比单纯基准测试给了我们更明确的信号。我们利用客户反馈和生产故障案例来优化评估并聚焦训练。Mercury 2.5 就是这一闭环的首个成果。
有哪些变化
Mercury 2.5 是市面上能力最强的扩散大语言模型(diffusion LLM)。据我们所知,它也是有史以来训练过的最大扩散语言模型。
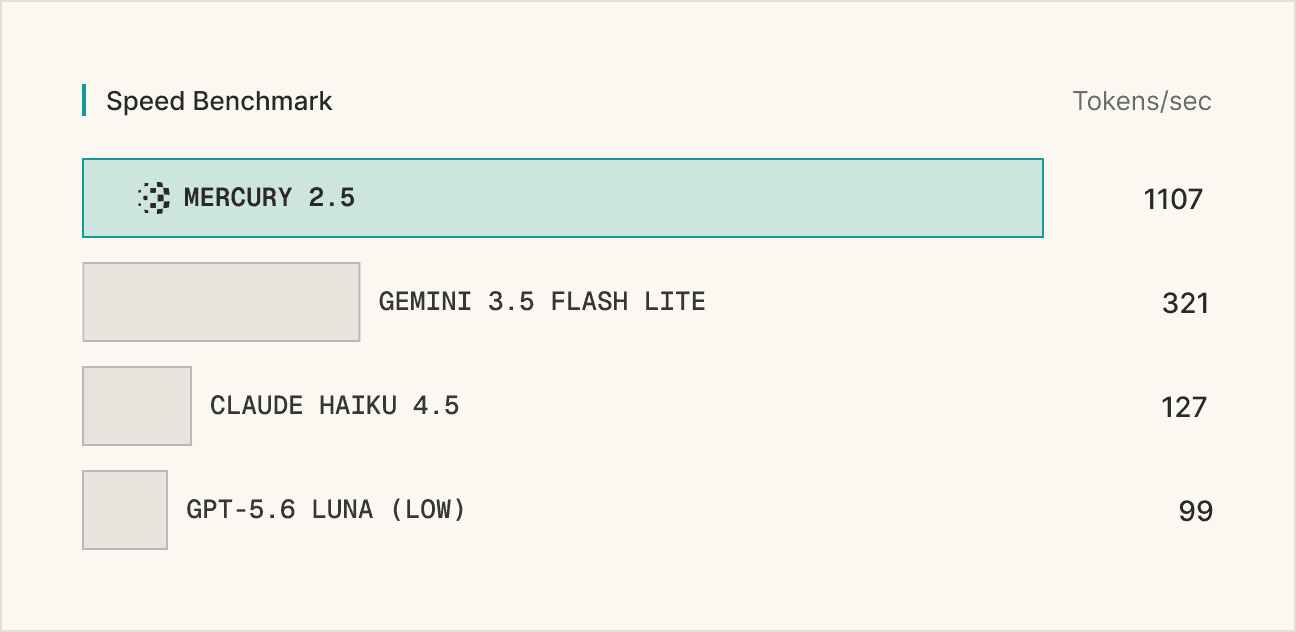
- 质量: 相比 Mercury 2 智能水平提升 40%,可比肩 GPT-5.6 Luna (Low)、Gemini 3.5 Flash-Lite、Claude Haiku 4.5 等成本优化的前沿模型。
- 速度: 在常见 NVIDIA GPU 上每秒生成 1,107 token。
- 上下文: 260K token。
- 价格: 每百万输入 0.20 美元、输出 0.75 美元。发布期享八折优惠,分别为 0.04 美元和 0.15 美元。
- 能力: 可调推理、并行工具调用以及符合 schema 的 JSON。
自 Mercury 2 发布以来,我们见证了 Inception 在 NVIDIA AI 基础设施上进一步推动基于扩散的语言模型。Mercury 2.5 在智能水平提升的同时保持了速度和低成本,反映出新架构在 NVIDIA 平台上迅速成熟为生产系统的能力。
—— Shruti Koparkar,NVIDIA 加速计算集团产品高级经理
生产环境中的 Mercury
搜索代理与 RAG 流水线
一次搜索请求可能触发数十次模型调用:规划搜索、改写查询、重排结果、结构化事实、总结来源并核查答案。Mercury 让这些调用足够快,能保持在单次用户交互内完成。多家领先的搜索基础设施公司已在生产中使用。

语音代理与交互式应用
在语音场景里,延迟不是基础设施细节,而是拨叫方听到的停顿。OpenCall 构建处理实时客户来电的 AI 电话代理。在其生产负载中,Mercury 将模型响应延迟中位数降到接近 170 毫秒。
改用 Mercury 后,我们的 P99 响应时间从几分钟降到仅 1 秒,P50 从 0.4 秒降到 0.2 以内——比见过的任何供应商都快得多,且这包含了推理。
—— Oliver Silverstein,OpenCall 联合创始人兼 CEO
编程子代理与助手
编程代理已将任务拆分给不同模型。有的负责规划或写代码,其他则搜索、运行工具、路由请求、总结状态或压缩长会话。这些支撑性调用反复发生,延迟与成本迅速叠加。
Augment Code 用 Mercury 做上下文压缩、模型路由和 MCP 工具搜索。将压缩迁移到 Mercury 后,延迟降低 82%(从约 150 秒降至 27 秒),成本降 90%,且质量不变。工具搜索摘要返回时间不到 1 秒。
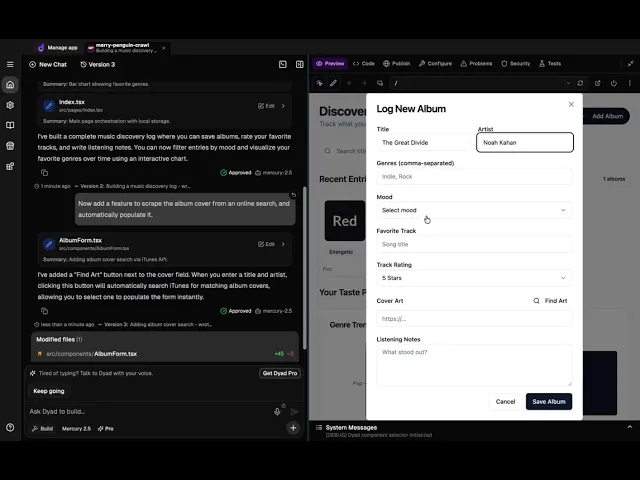
同样的速度也适用于开发 Web 应用。看 Mercury 2.5 如何通过几个提示词在下方演示中生成可用的音乐发现日志 Web 应用。
Mercury Voice 与 Mercury Router 预览
随 Mercury 2.5 一同发布的还有 Mercury Voice 和 Mercury Router 的预览。
- Mercury Voice 的首 token 延迟(TTFT)低于 170 毫秒,是专为延迟预算极严的语音代理优化的 dLLM。
- Mercury Router 用 dLLM 理解输入提示,并将其路由至在质量、速度和成本上组合最优的模型(开源与闭源均可)。
开始使用
Mercury 模型可通过 Inception API、Baseten 和 OpenRouter 获取。企业部署支持专用算力、自动扩缩容、合规管控和可配置的数据留存。
在聊天界面试用 Mercury 2.5,或用 1 亿免费 token 试用 API,参阅 API 文档。
- Baseten 客户: 通过现有 Baseten 配置部署 Mercury 2.5。
- Y Combinator 企业:领取 50 万美元部署权益。
- 评估语音场景的 Mercury? 我们将配合测试工作负载适配性,并在您的服务约束下验证性能。联系我们。
下一步
我们已开始训练下一个模型,它将是有史以来最大的一次,目标在未来几个月发布。新模型将在能力上实现飞跃,同时不放弃扩散模型的速度和 token 效率。这需要在模型训练、推理、评估与基础设施上取得进展。
评论
社区对 Inception 的 Mercury 2.5 扩散模型整体好奇且部分认可其速度优势,但在实际智能水平和对比基准的诚实性上存在分歧,少数人因“广泛可用 GPU”措辞误以为会开放权重而感到失落。
认为模型速度和成本优势明显,适合实时或低延迟场景
- 扩散架构带来高吞吐,可缓解多模型系统中的裁判延迟,价格低廉使其在通用聊天和逻辑内容生成上具备吸引力,也可能成为大厂收购目标以整合扩散子代理。(较多人)
- 引用一句中文意译: > 每秒上千 token 的速度能大幅缓解多模型裁判带来的延迟痛点(@irthomasthomas)
质疑基准对比误导且实际能力有限
- 官方仅与旧版轻量模型比速度、仅与自身前代比智能,这种选择性对比有误导性;未掌握工具调用和代理编码,在自定义环境下表现更差,怀疑实用价值低。(少数人)
- 引用: > 这种对比方式非常误导,我怀疑这模型基本没用(@ltbarcly3)
对未开放权重感到失望
- 看到“广泛可用的 GPU”表述曾期待开放权重,实际未发布感到惋惜。(少数人)
- 引用: > 看到广泛可用 GPU 还以为会开放权重,结果可惜没有(@Sphax)
有价值的补充
- Inception 主攻低延迟语音应用,其扩散架构在编码领域也在推进,但 Mercury 2.5 定位并非前沿模型,而是成本优化型。
- 用户可通过 API 平台设置关闭“为所有人改进模型”来避免提交内容被用于训练。
- 在需要多模型协作的仲裁环节,Mercury 系列因高速度成为候选,前代已验证可行性。
- 有测试称智能较前代提升四成,可比肩若干成本优化前沿轻量模型,但需第三方验证。